加载中
检索增强生成(Retrieval Augmented Generation,RAG)是一种技术,它可以帮助您处理大型文档,方法是将其拆分成更小的片段,并且只将与每个问题最相关的片段提供给Claude。RAG不是让模型处理整份800页的财务报告,而是让您只提取与回答特定查询相关的部分。
大型文档的问题
当您有一份庞大的文档,并希望向Claude询问关于它的具体问题时,您会面临一个根本性的挑战:如何在不超出限制或降低性能的情况下,将正确的信息传递给Claude?
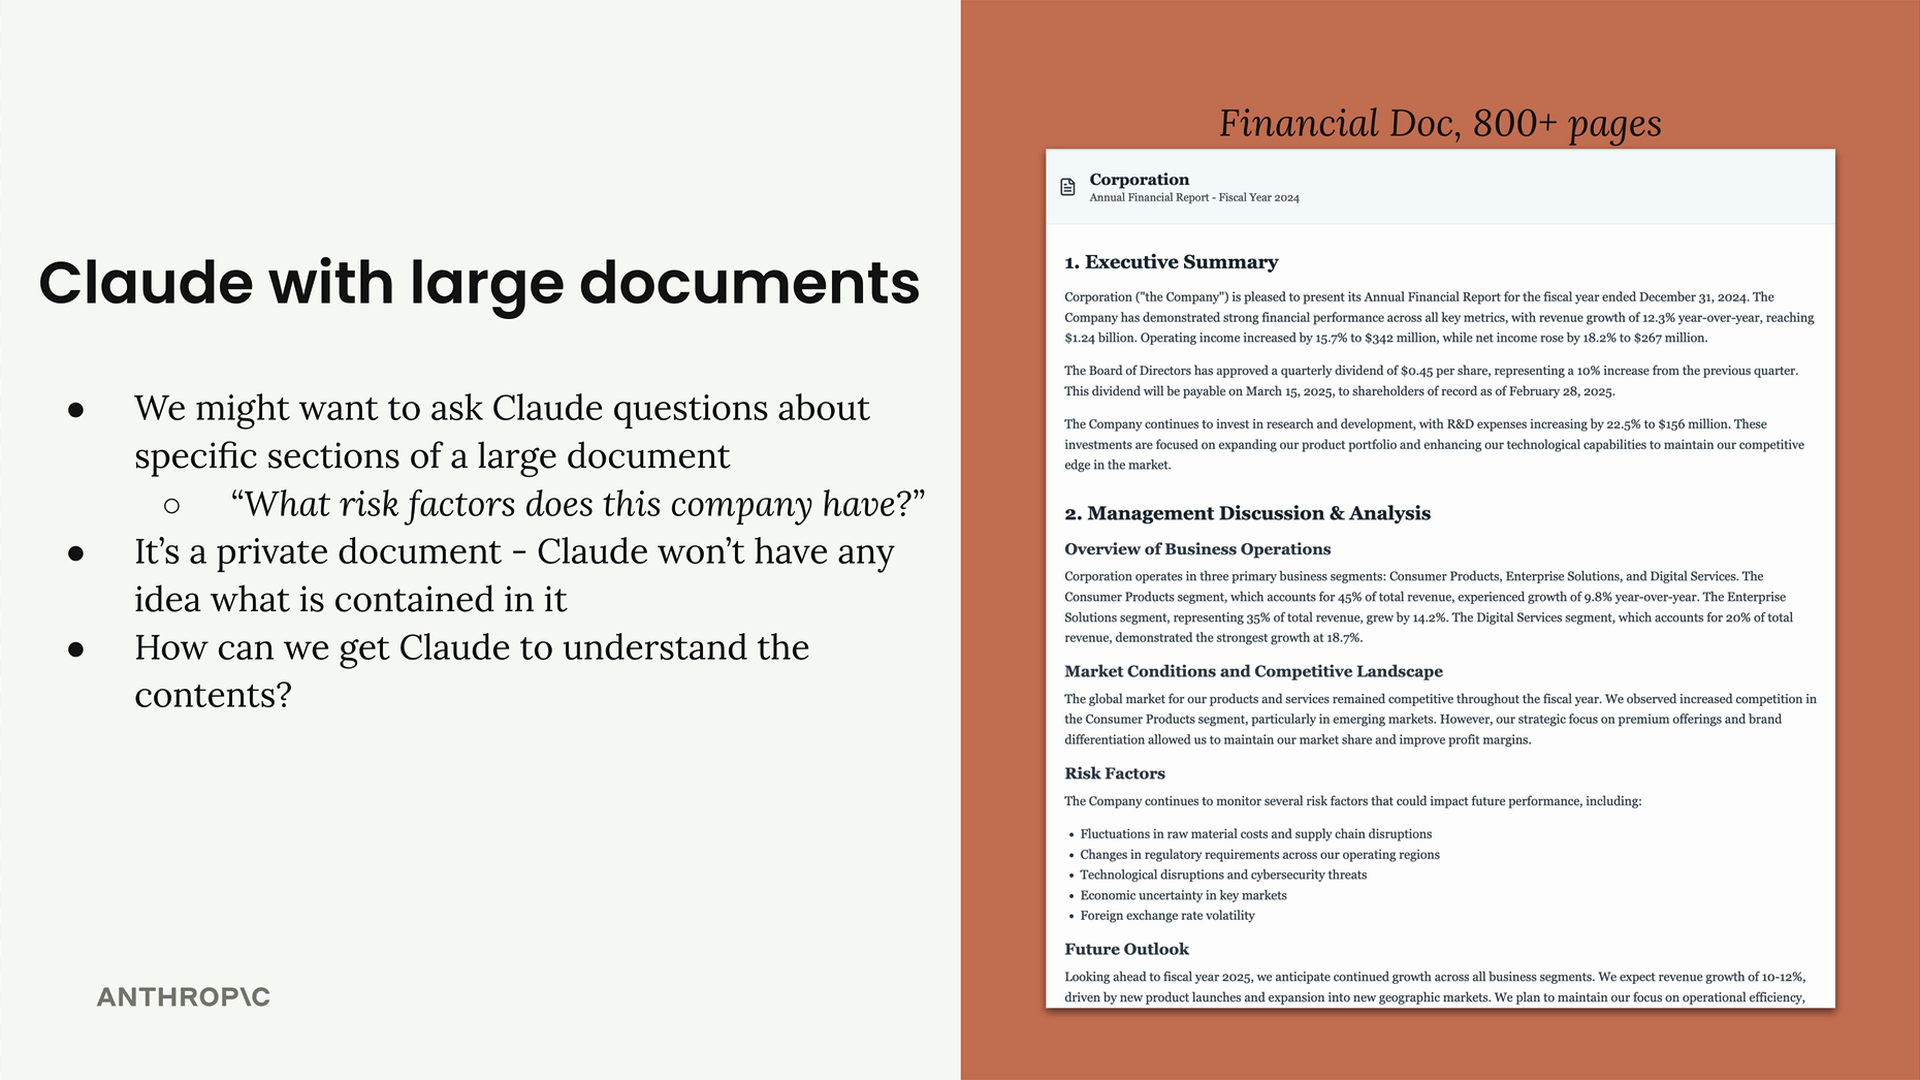
以"这家公司有哪些风险因素?"这样的问题为例,这是针对一份冗长财务文档提出的问题。该文档中包含答案,但Claude需要访问相关内容才能帮助您。
方案一:在提示中包含所有内容
最直接的方法是从文档中提取所有文本,并将其全部塞进单个提示中:
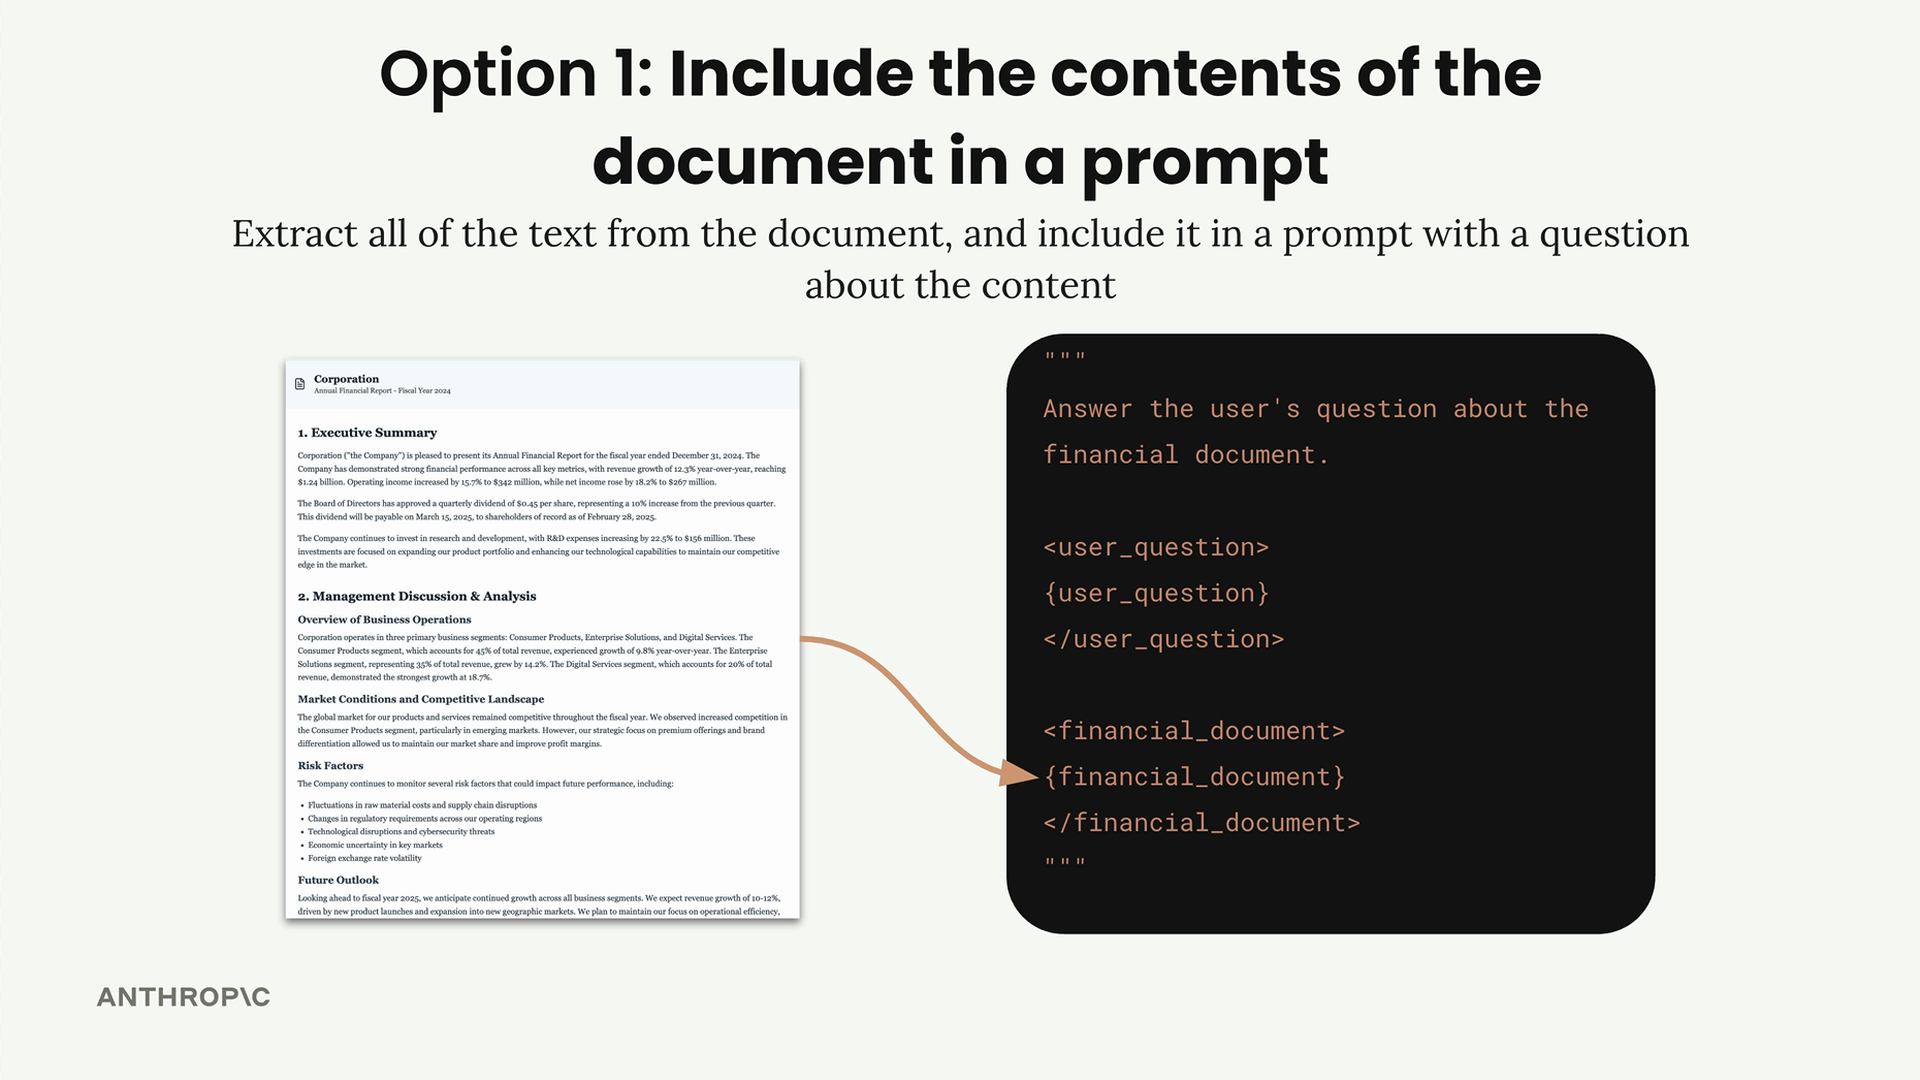
这种方法存在严重的局限性:
- 严格的令牌限制意味着非常长的文档根本无法容纳
- 提示过长时,Claude的效果会变差
- 更大的提示花费更多的钱,处理时间也更长
- 当需要筛选的信息过多时,性能会下降
方案二:将文档拆分成片段
RAG采用更智能的方法:预先将文档处理成可管理的片段,然后只为每个问题检索相关的片段。
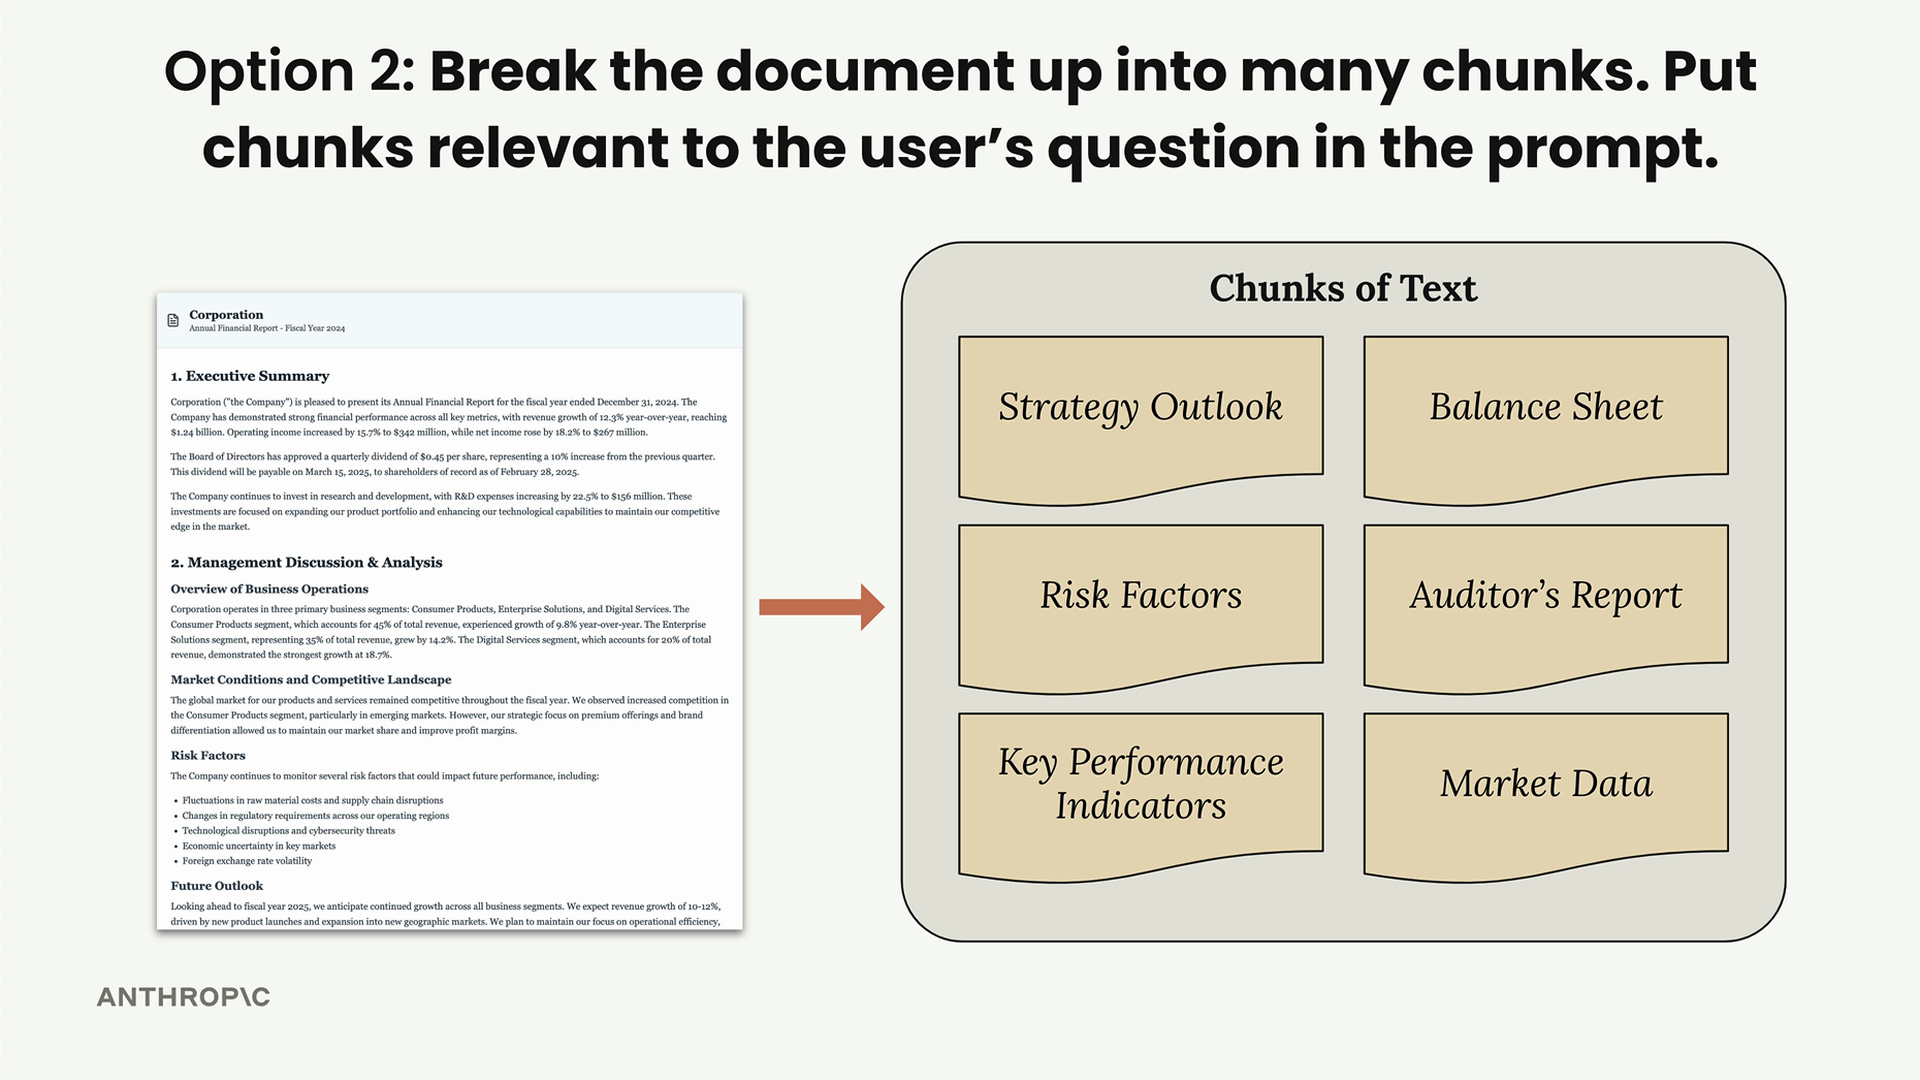
它的工作原理如下:
- 将文档拆分成更小的片段(战略展望、风险因素、资产负债表等)
- 当用户提出问题时,分析他们在寻找什么
- 找到与其问题最相关的片段
- 在发送给Claude的提示中只包含那些相关的片段
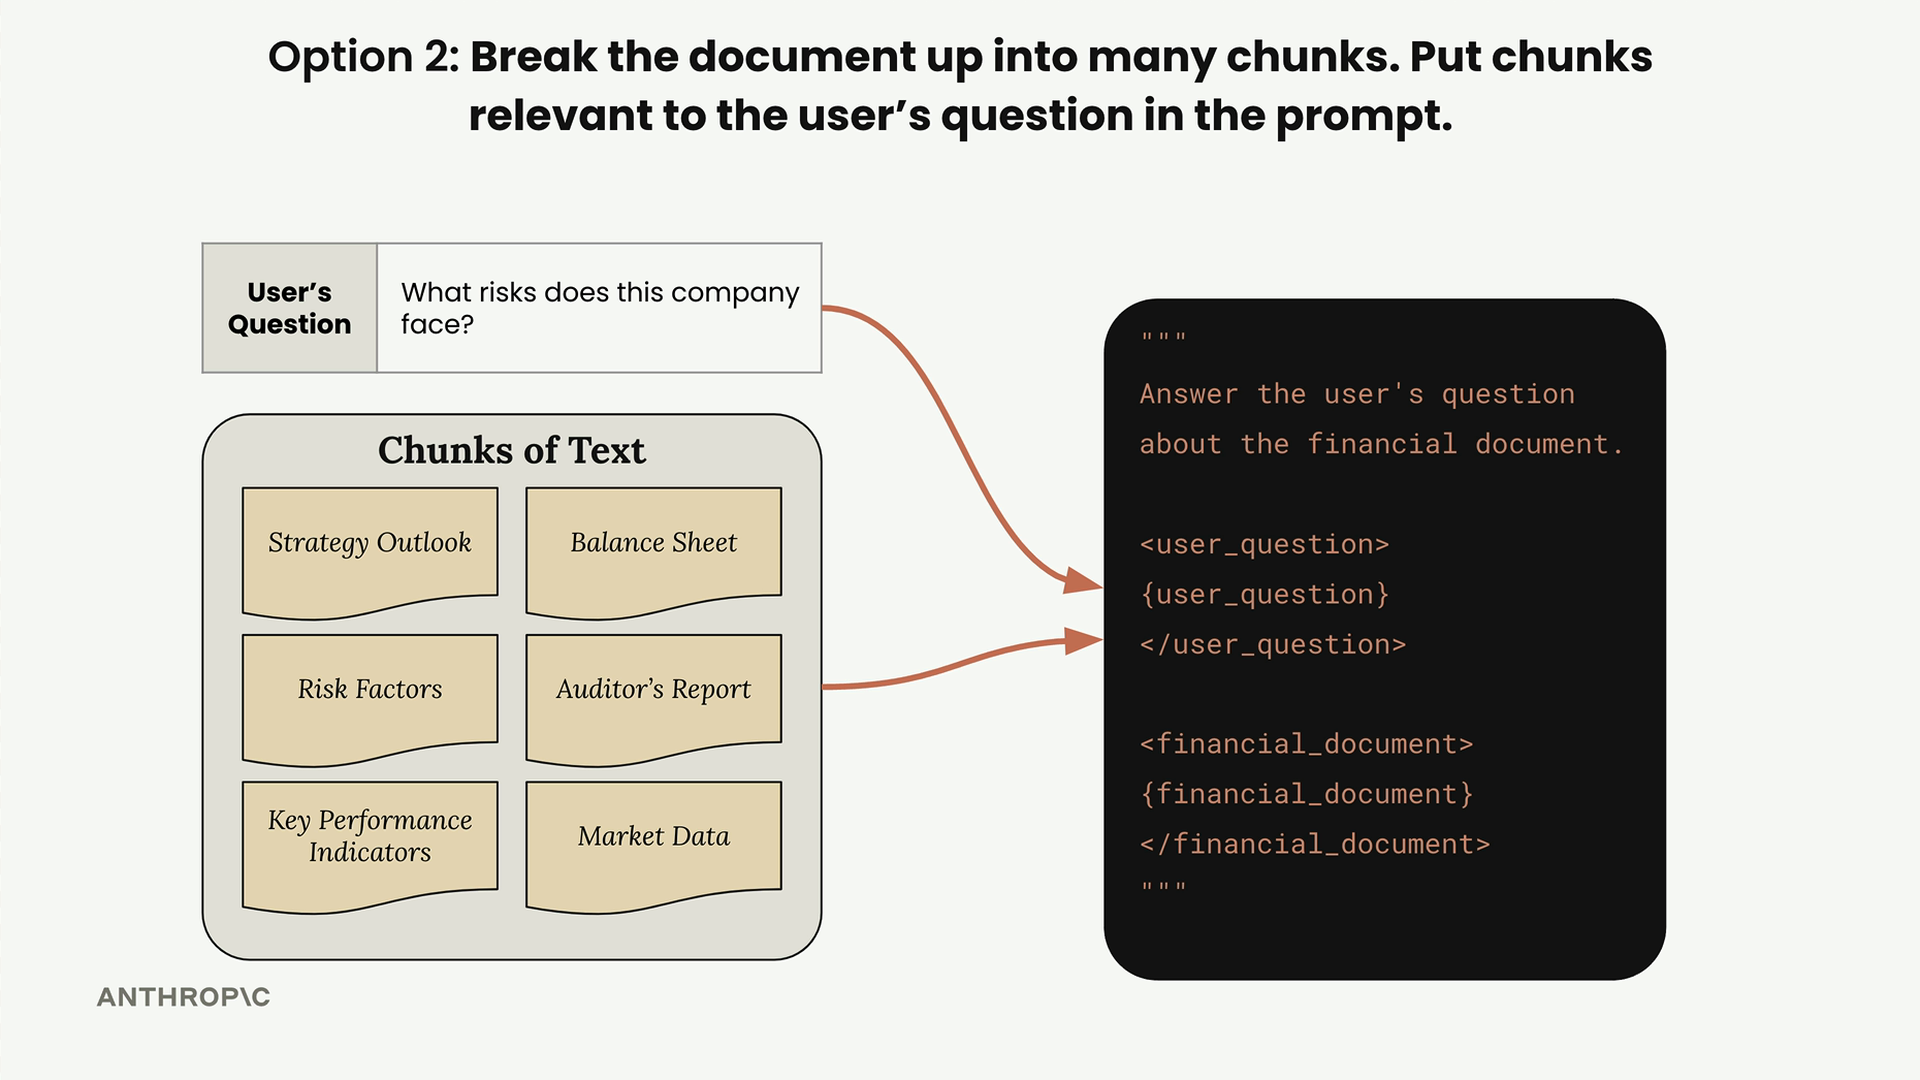
对于关于公司风险的问题,系统会识别并检索"风险因素"片段,从而为Claude提供聚焦且相关的上下文,而不是整份文档。
RAG的优势
- Claude可以只专注于最相关的内容
- 可扩展到非常大的文档和多份文档
- 可跨文档集合工作,而不仅限于单个文件
- 更小的提示意味着更快的处理速度和更低的成本
RAG的挑战
RAG引入了您需要管理的复杂性:
- 需要一个预处理步骤来对文档进行分块
- 需要一个搜索机制来查找相关片段
- 检索到的片段可能不包含所有必要的上下文
- 对文本进行分块的方式有很多种——哪种方法效果最好?
您可以按等份、按标题和章节、按语义含义或其他策略对文档进行分块。每种方法都有其权衡取舍,您需要根据自己的具体使用场景加以评估。
何时使用RAG
当您处理的是大型文档或文档集合,且用户提出的具体问题只需要内容的一部分即可回答时,RAG就能发挥出色的作用。当您需要扩展到单个提示无法容纳的规模、希望获得更快的响应速度,或者需要在大量查询中管理成本时,预处理的复杂性就物有所值了。
关键在于分析实现分块、搜索和检索所带来的技术开销,对于您的具体应用而言是否合理。有时,简单的"把所有内容都塞进一个提示"的方法就已经够用了——而在其他情况下,RAG则成为让您的系统实用且高性能所必不可少的手段。