文本分块是构建 RAG(检索增强生成)流水线时最关键的步骤之一。您如何拆分文档会直接影响整个系统的质量。糟糕的分块策略可能导致不相关的上下文被插入到您的提示中,使您的 AI 给出完全错误的答案。
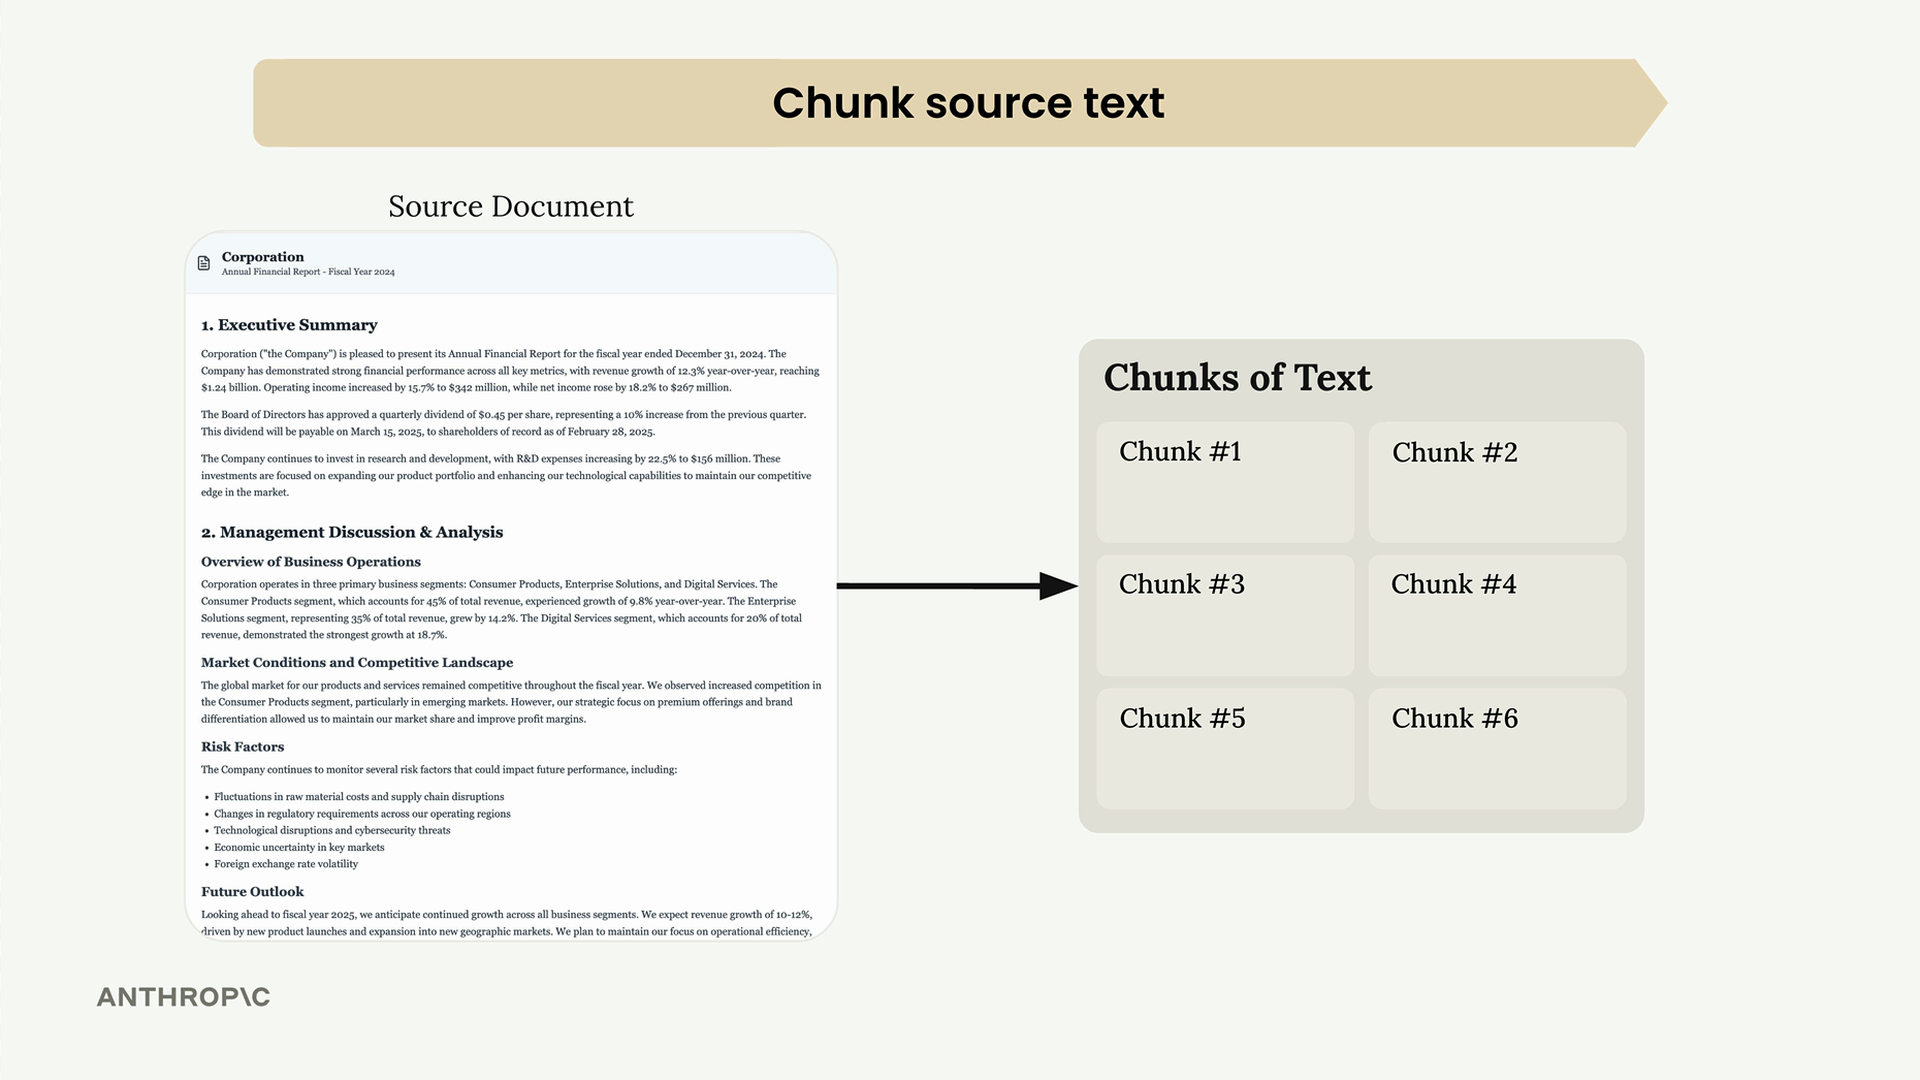
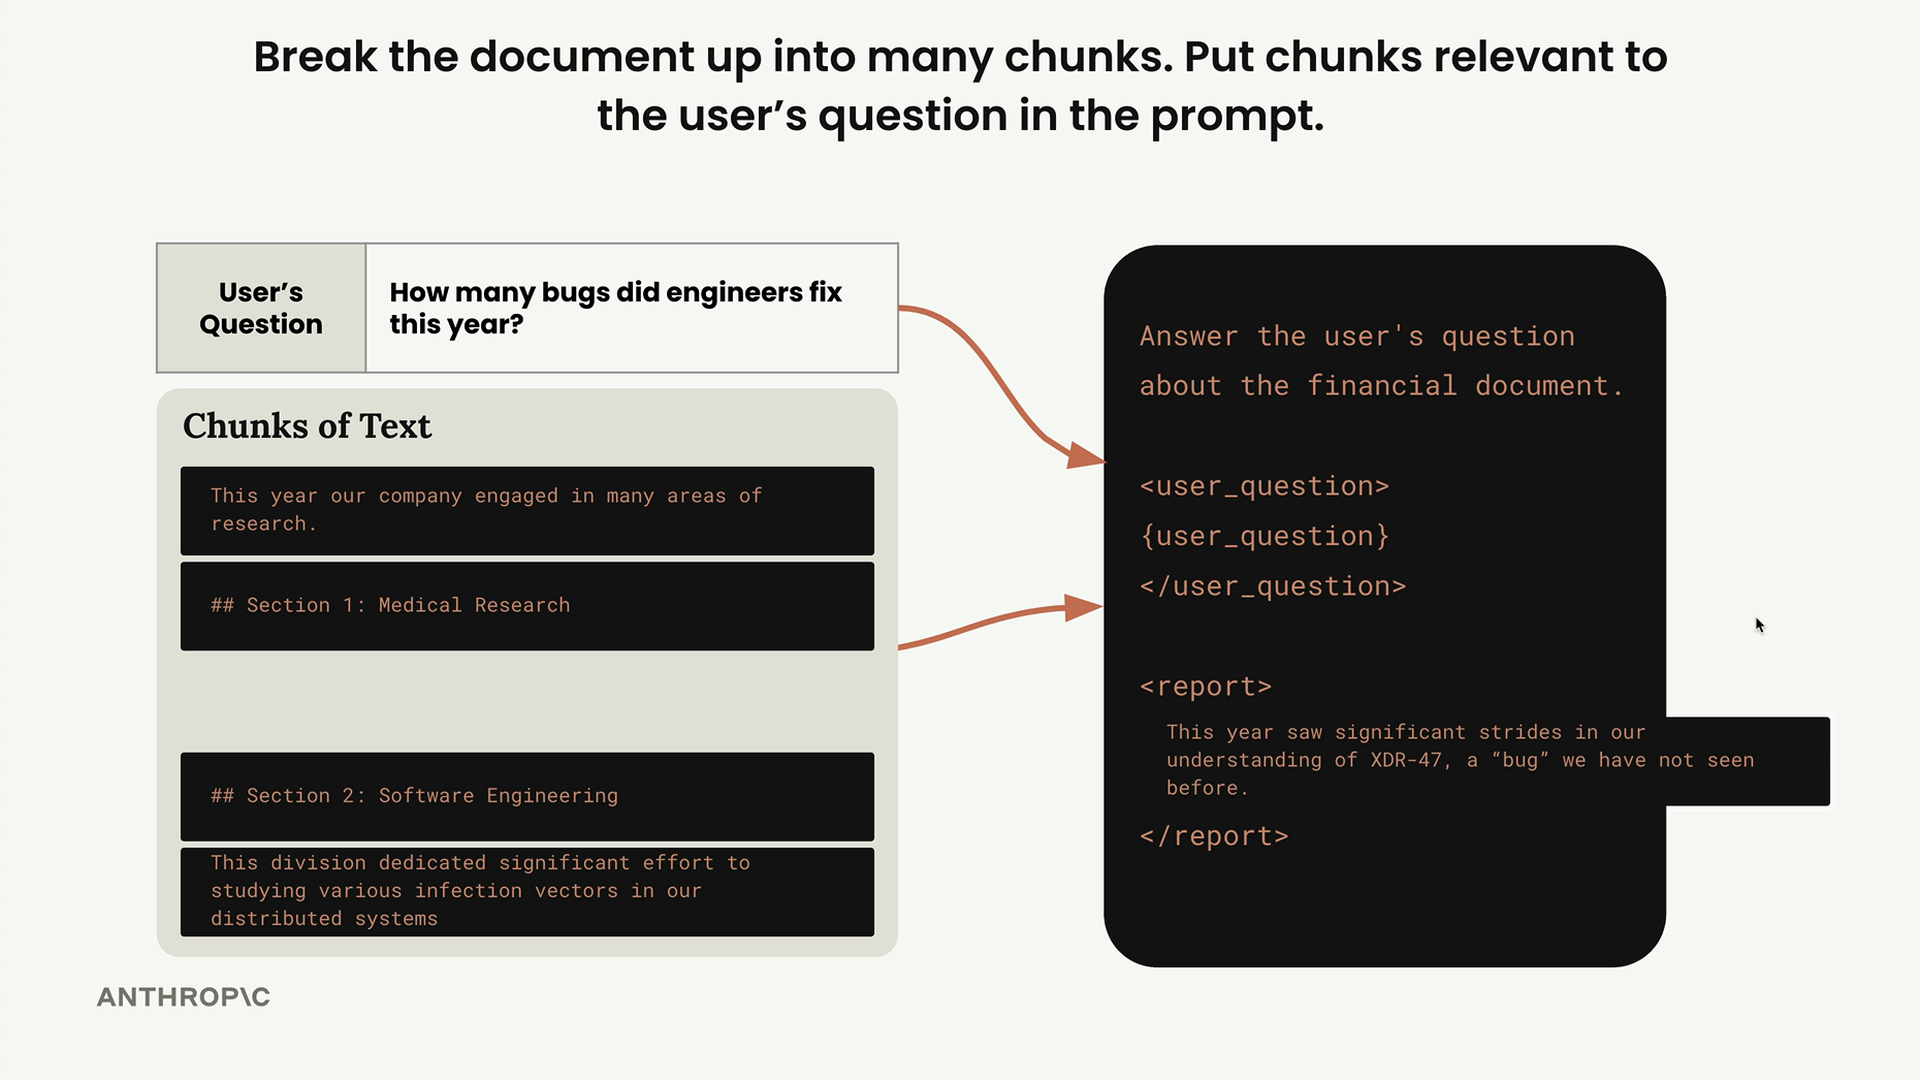
考虑这个例子:您有一份文档,其中包含医学研究和软件工程两部分内容。如果分块不当,用户询问"工程师今年修复了多少个 bug?"可能会得到关于医学研究的信息,而不是软件工程,原因仅仅是医学部分恰好在不同语境下包含了"bug"这个词。
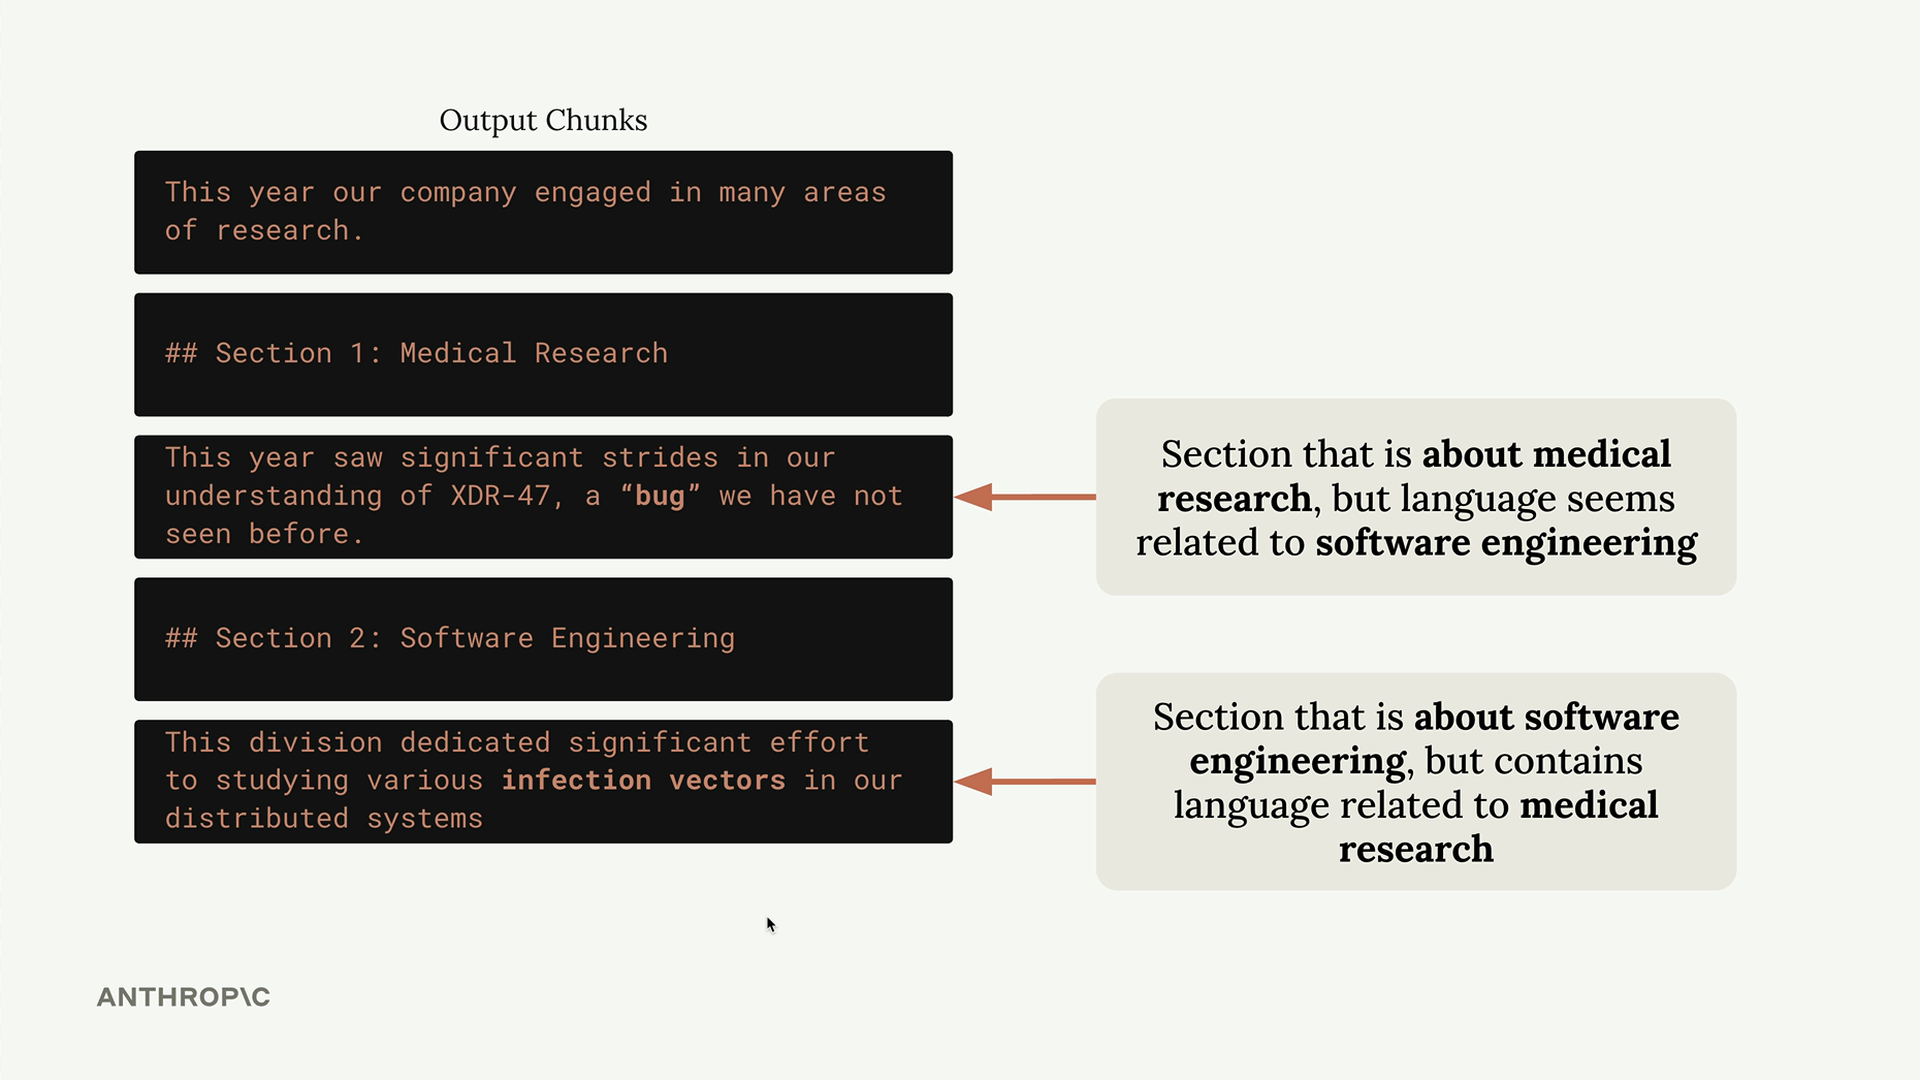
这说明了为什么分块策略如此重要。目标是创建保持语义连贯性,并在检索时提供有用上下文的分块。
三种主要的分块策略
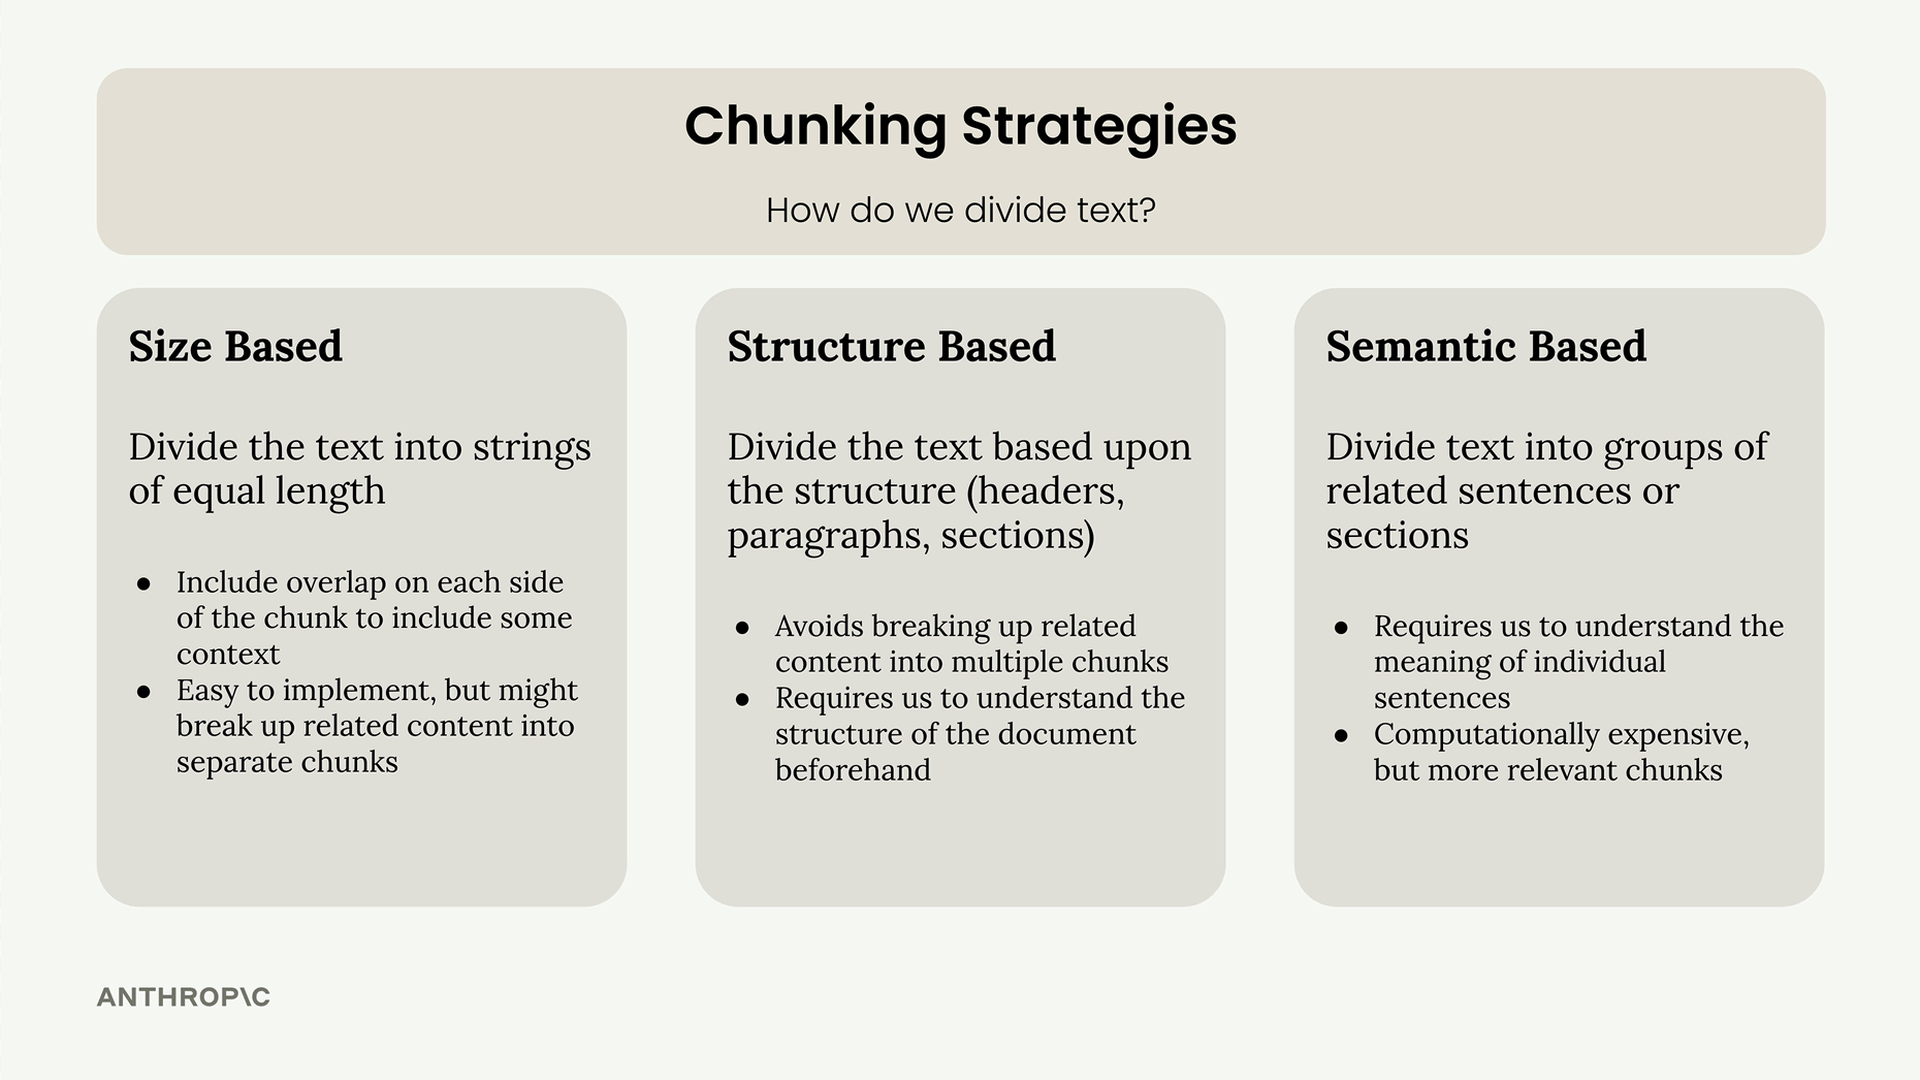
将文本分割成块主要有三种方法:
- 基于大小: 将文本划分为长度大致相等的字符串
- 基于结构: 根据文档结构(标题、段落、章节)进行拆分
- 基于语义: 使用 NLP 技术将相关的句子或段落分组
基于大小的分块
基于大小的分块是最直接的方法。您只需将文档划分为字符数或单词数大致相等的分块。这种方法易于实现,并且在不同文档类型中都能可靠地工作。
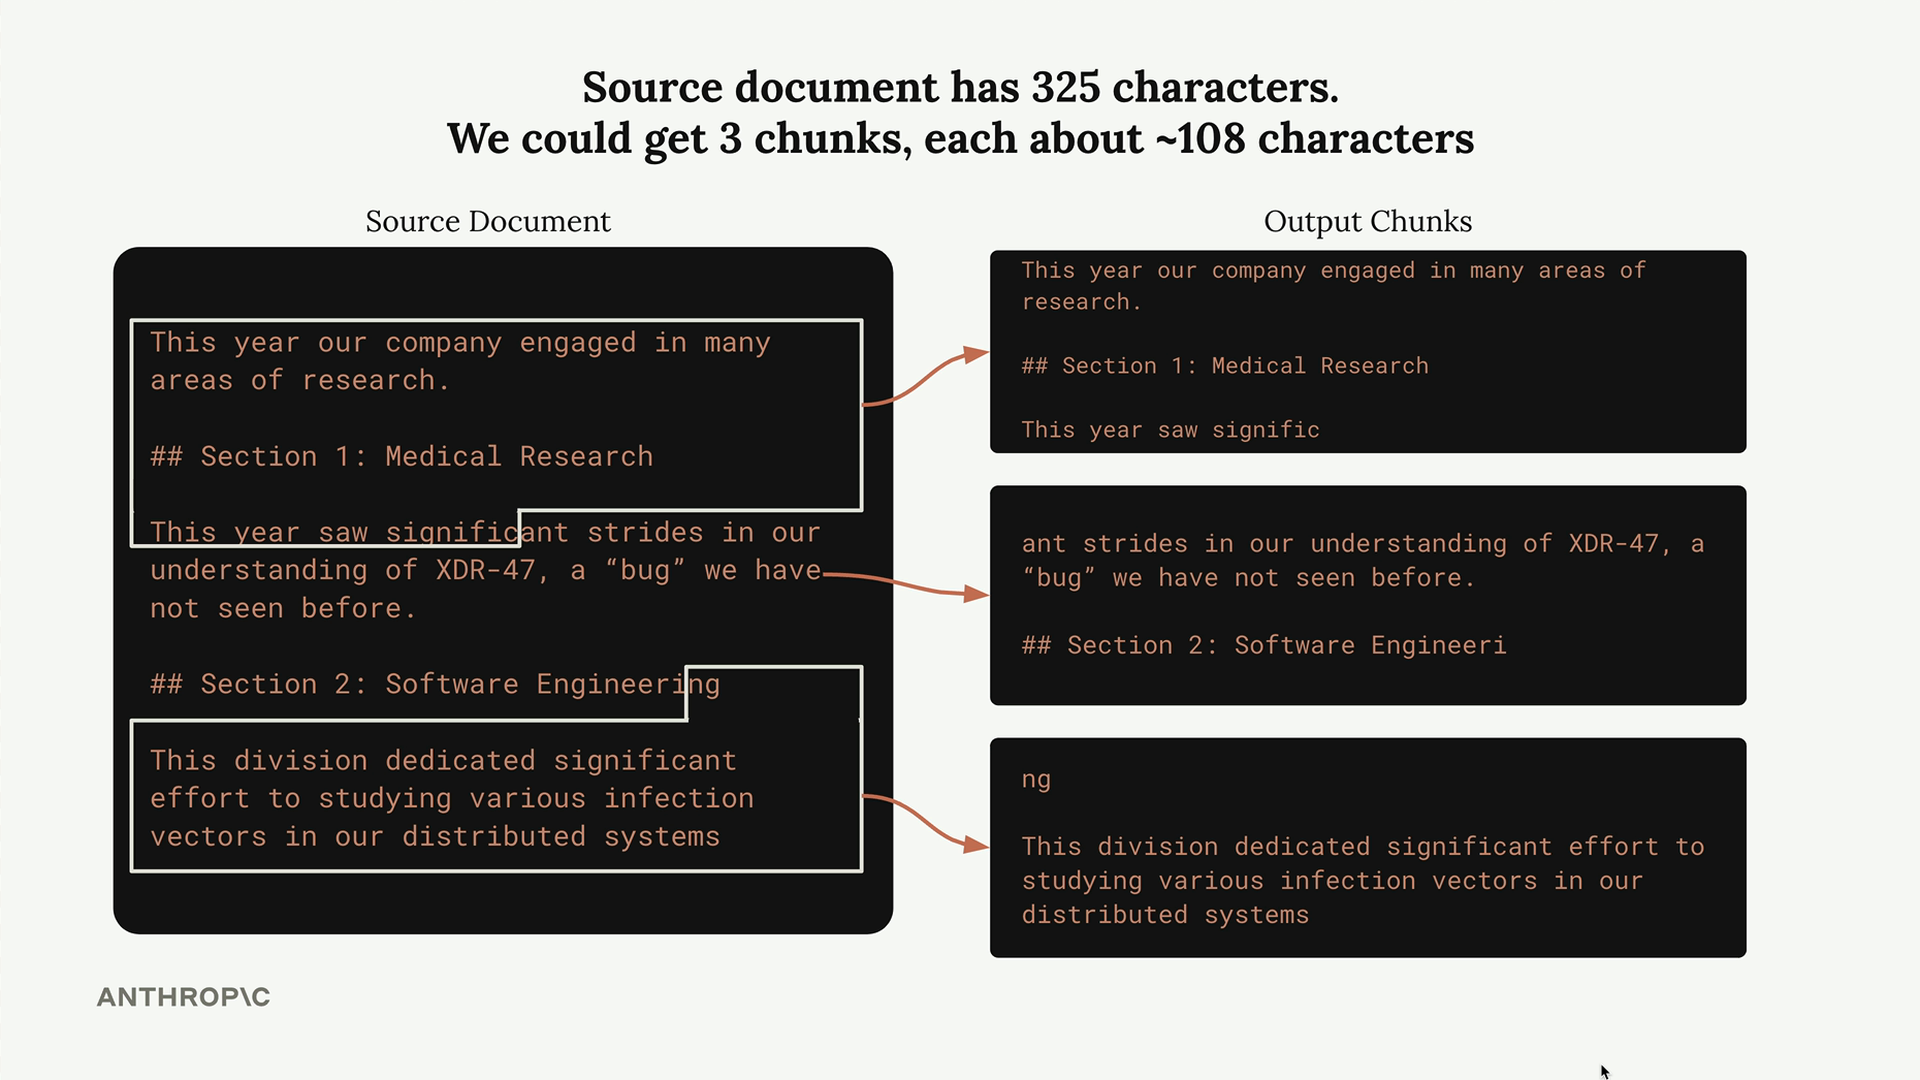
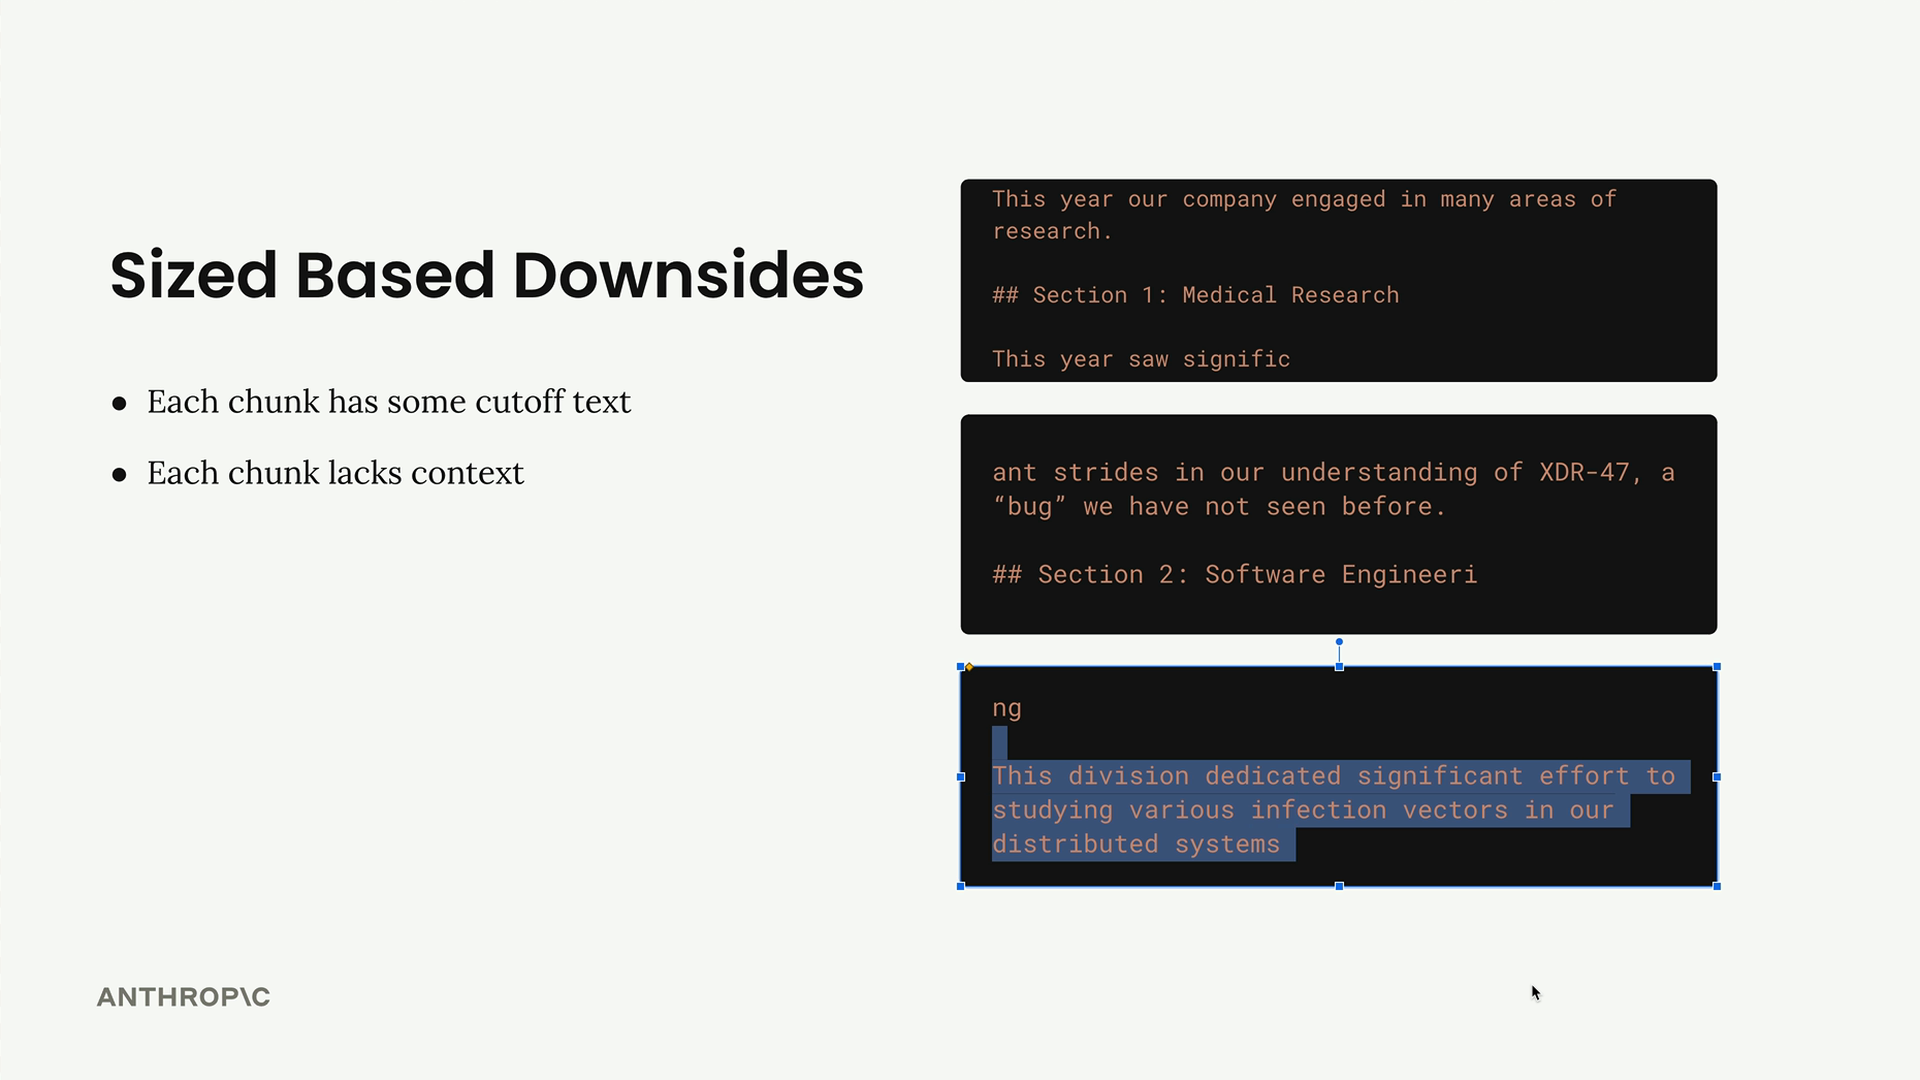
然而,这种方法有明显的缺点:
- 单词可能会在句子中间被切断
- 分块会丢失周围文本中重要的上下文
- 相关内容可能会被拆分到多个分块中
增加重叠
为解决上下文问题,您可以实施重叠策略。每个分块都包含相邻分块中的部分字符,从而提供额外的上下文,并确保重要信息不会在分块边界处丢失。
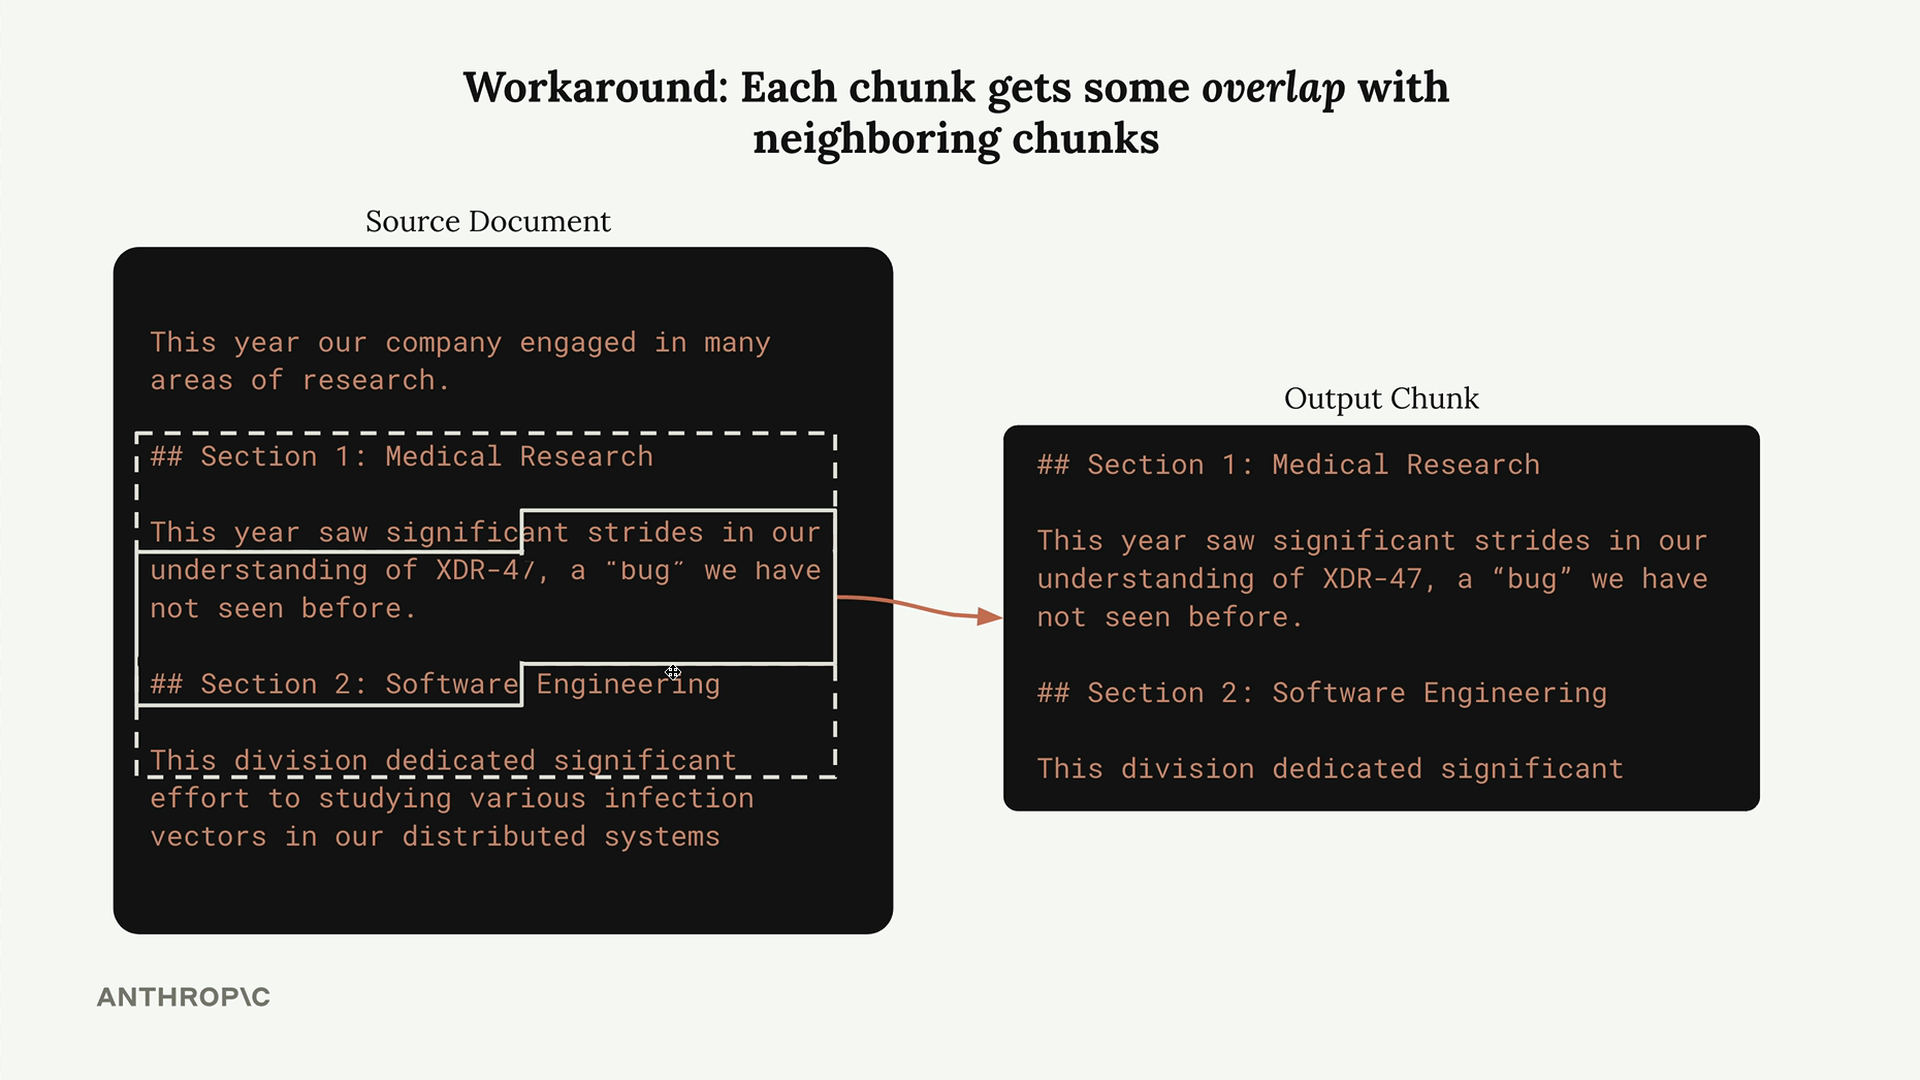
虽然这会产生一些重复,但为了换来每个分块更好的上下文质量,这种权衡通常是值得的。
基于结构的分块
当您的文档具有一致的格式(比如带有清晰标题的 markdown)时,基于结构的分块可以产生出色的效果。您可以根据标题等结构元素进行拆分,创建与文档自然组织方式相匹配的分块。
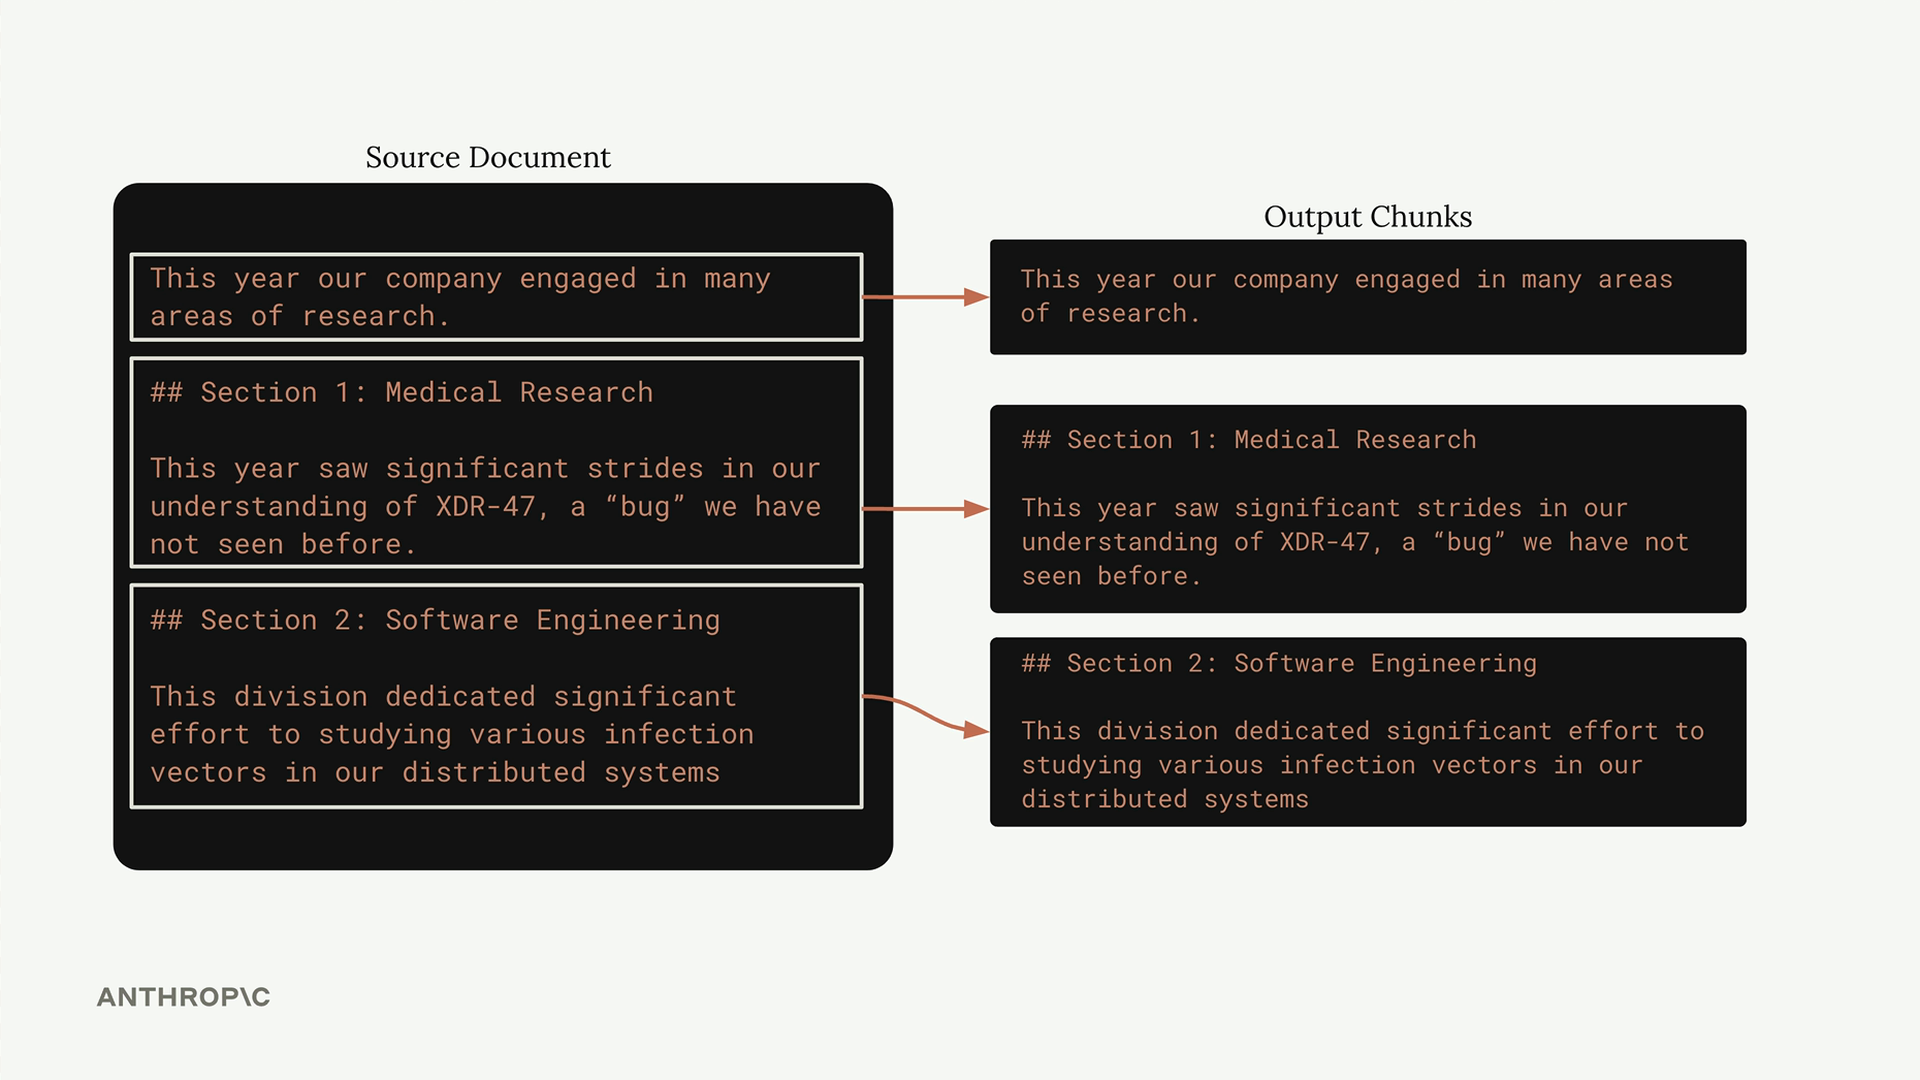
这种方法对格式良好的文档非常有效,但需要对文档结构有一定的保证。对于纯文本文件或格式不一致的文档,它无法可靠地工作。
实现示例
以下是您可以实现的三种实用分块函数:
基于字符的分块
def chunk_by_char(text, chunk_size=150, chunk_overlap=20):
    chunks = []
    start_idx = 0

    while start_idx < len(text):
        end_idx = min(start_idx + chunk_size, len(text))
        chunk_text = text[start_idx:end_idx]
        chunks.append(chunk_text)

        start_idx = (
            end_idx - chunk_overlap if end_idx < len(text) else len(text)
        )

    return chunks
基于句子的分块
import re

def chunk_by_sentence(text, max_sentences_per_chunk=5, overlap_sentences=1):
    sentences = re.split(r"(?<=[.!?])\s+", text)
    chunks = []
    start_idx = 0

    while start_idx < len(sentences):
        end_idx = min(start_idx + max_sentences_per_chunk, len(sentences))
        current_chunk = sentences[start_idx:end_idx]
        chunks.append(" ".join(current_chunk))

        start_idx += max_sentences_per_chunk - overlap_sentences

        if start_idx < 0:
            start_idx = 0

    return chunks
基于章节的分块
def chunk_by_section(document_text):
    pattern = r"\n## "
    return re.split(pattern, document_text)
选择合适的策略
您选择的分块策略完全取决于您的具体用例:
- 基于字符: 最可靠的备选方案,适用于任何文档类型
- 基于句子: 在保留上下文和含义之间取得良好平衡,适用于散文
- 基于章节: 当您拥有结构化文档时效果出色
对于没有格式保证的用户上传文档,基于字符的分块通常是最安全的选择。对于结构良好的内部文档,基于章节的分块可以提供更优的效果。基于句子的分块对大多数散文都效果良好,但对于以意外方式使用句号的代码或技术文档,可能会遇到困难。
请记住,分块通常是一个迭代过程。从简单的方法开始,用您的特定文档和用例进行测试,然后根据您从 RAG 系统获得的结果质量进行改进。