在构建RAG管道时,您会很快发现仅靠语义搜索并不总能返回最佳结果。有时您需要精确的关键词匹配,而语义搜索可能会遗漏这些内容。解决方案是使用一种称为BM25的技术,将语义搜索与词法搜索相结合。
仅靠语义搜索的问题
假设您要在文档中搜索一个特定的事件编号,例如"INC-2023-Q4-011"。虽然这个确切的术语在相关章节中多次出现,但语义搜索可能会返回看似语义相似但实际上不包含您所需特定信息的无关章节。
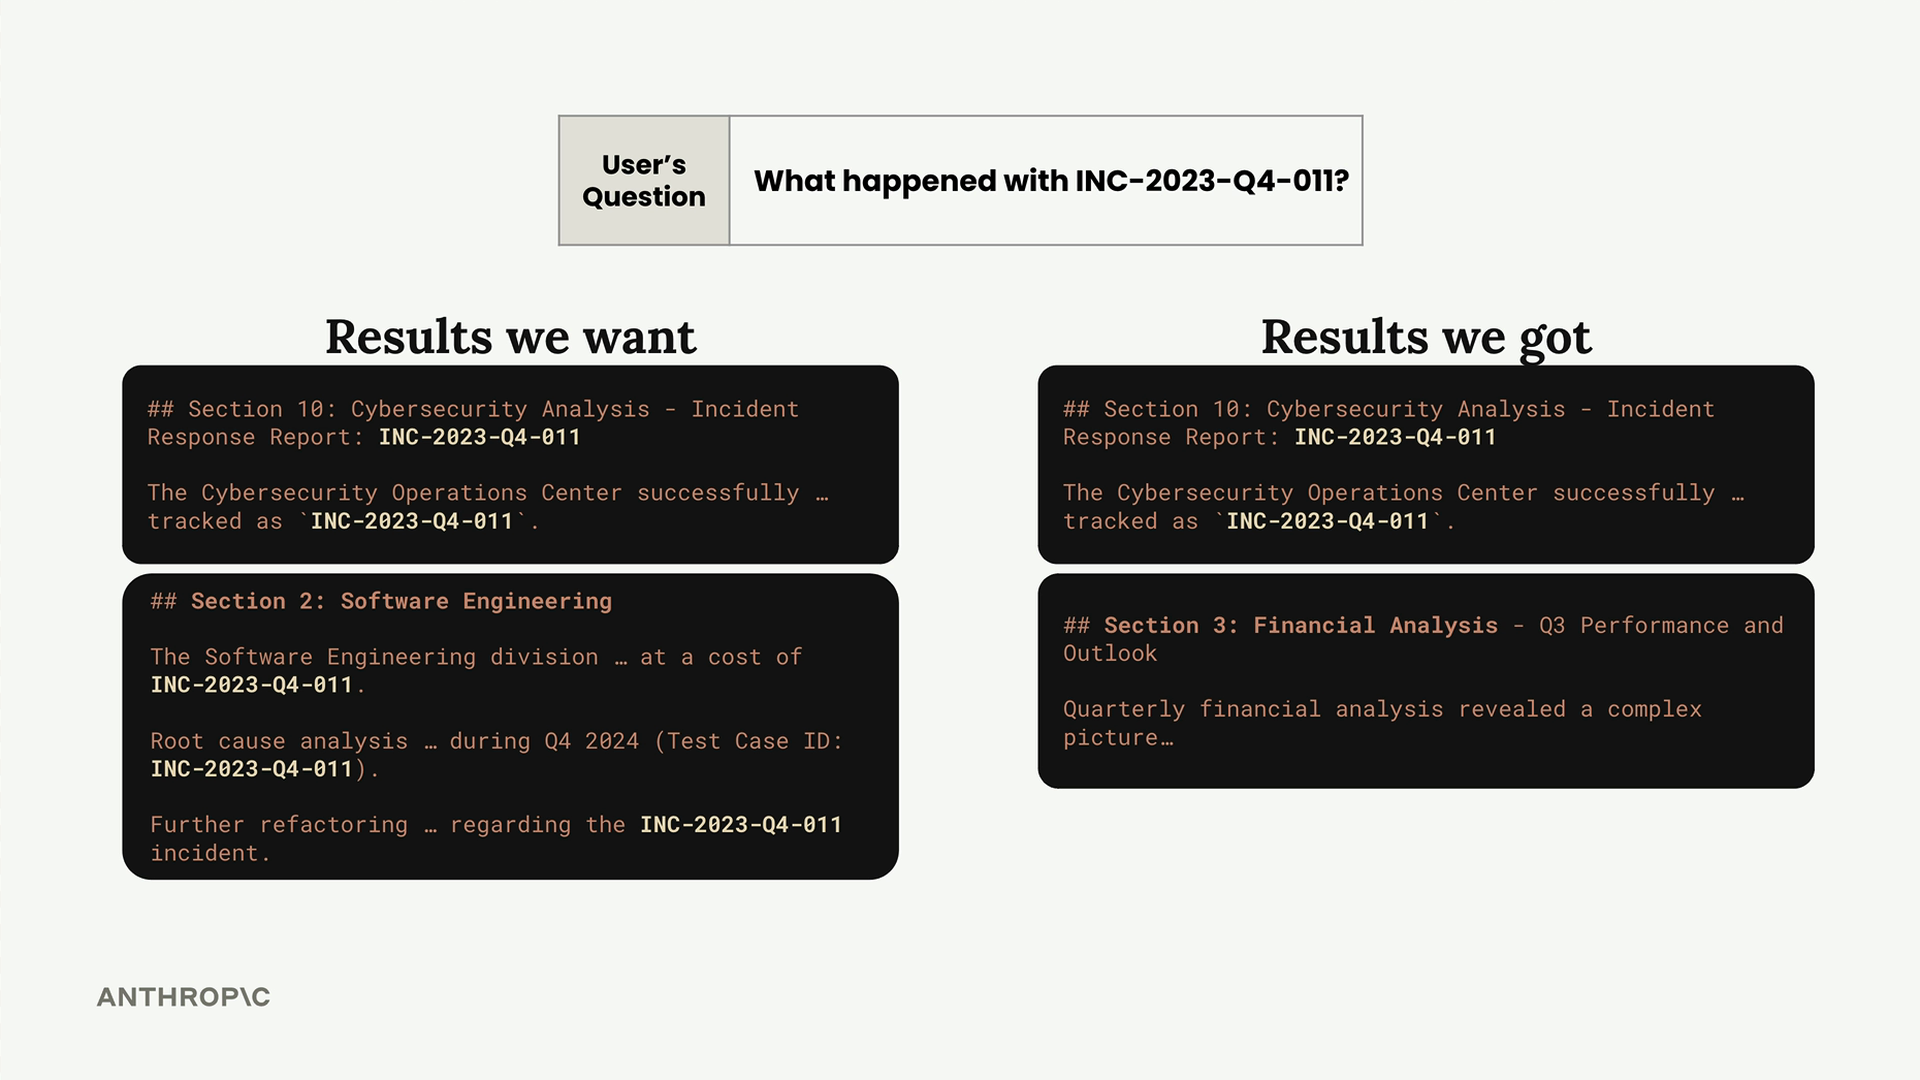
出现这种情况是因为语义搜索关注的是含义而非精确的文本匹配。当您需要精确的关键词匹配时,就需要一种不同的方法。
混合搜索策略
解决方案是并行运行语义搜索和词法搜索,然后合并结果。这样可以两全其美:
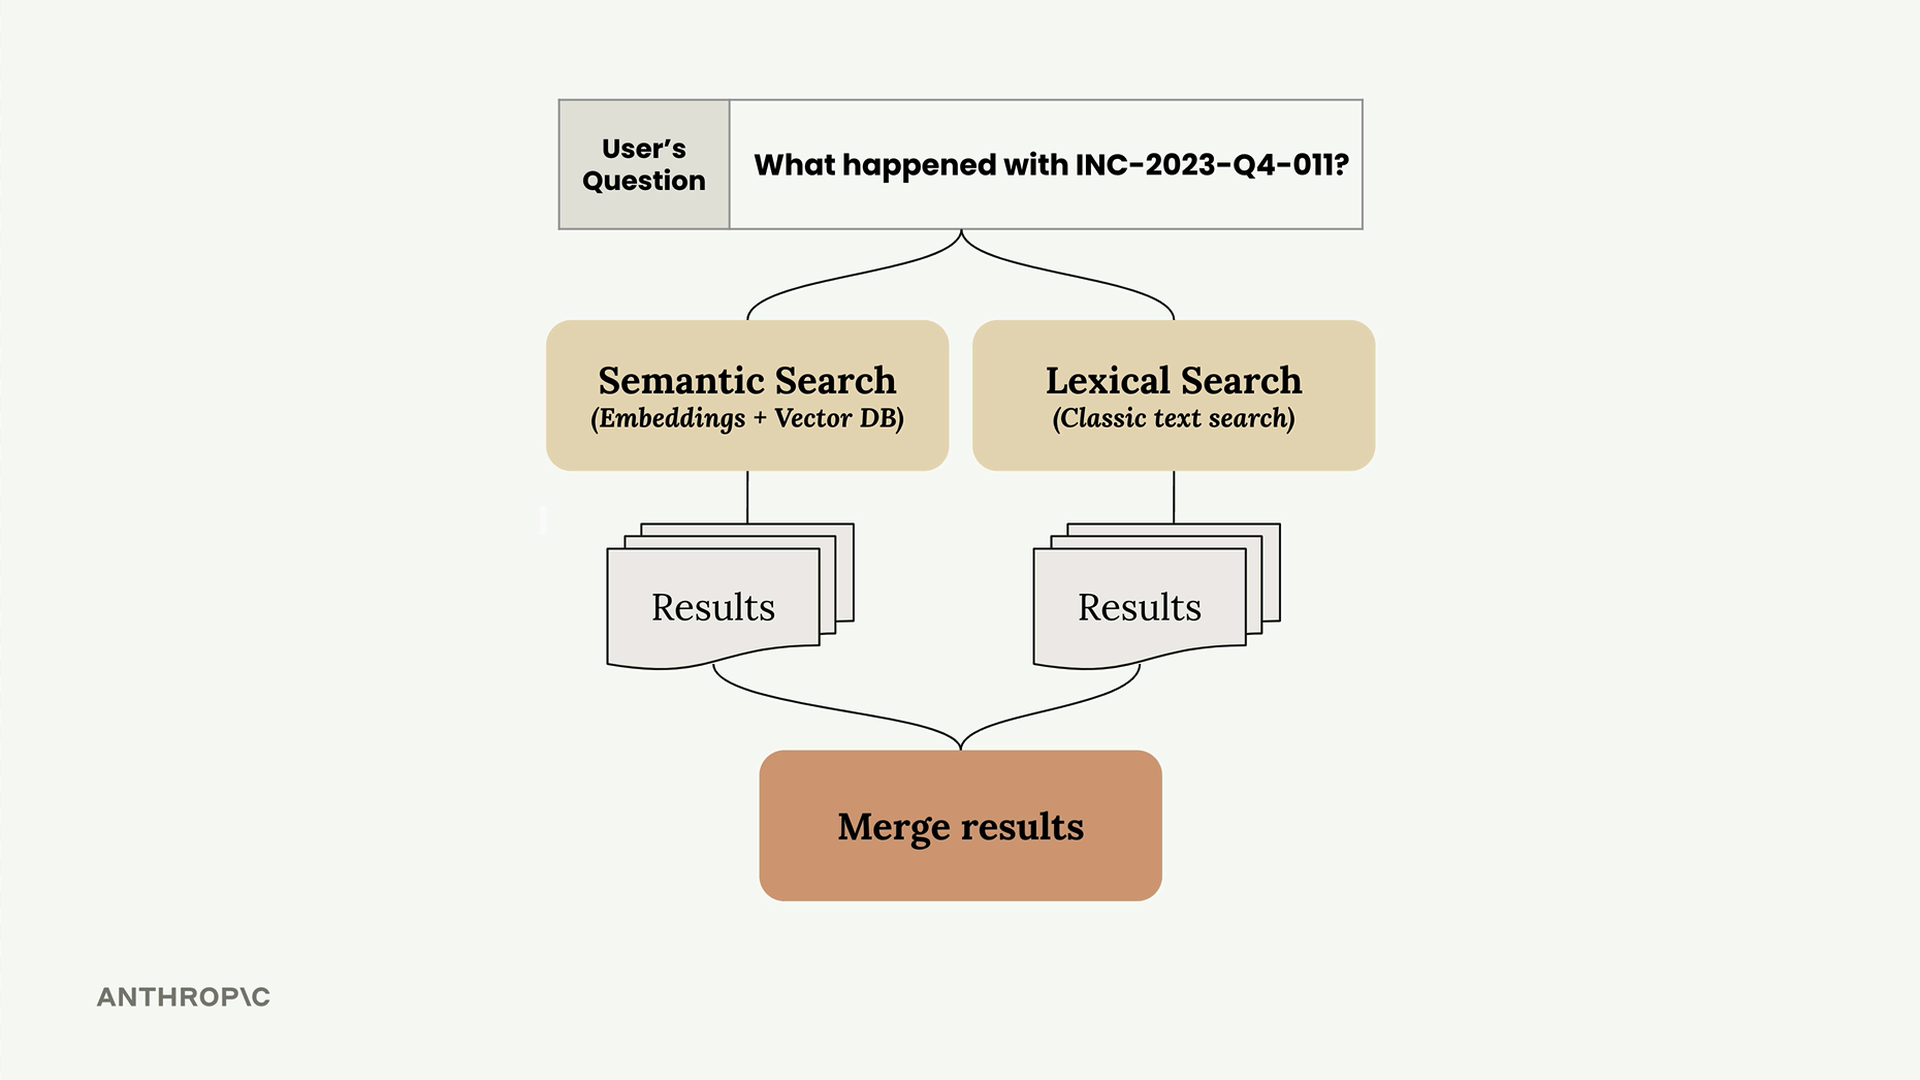
- 语义搜索 - 使用embeddings查找概念相关的内容
- 词法搜索 - 使用经典文本搜索查找精确的关键词匹配
- 合并结果 - 结合两种方法以获得更好的整体相关性
BM25的工作原理
BM25(Best Match 25)是RAG管道中用于词法搜索的一种流行算法。以下是它处理搜索查询的方式:
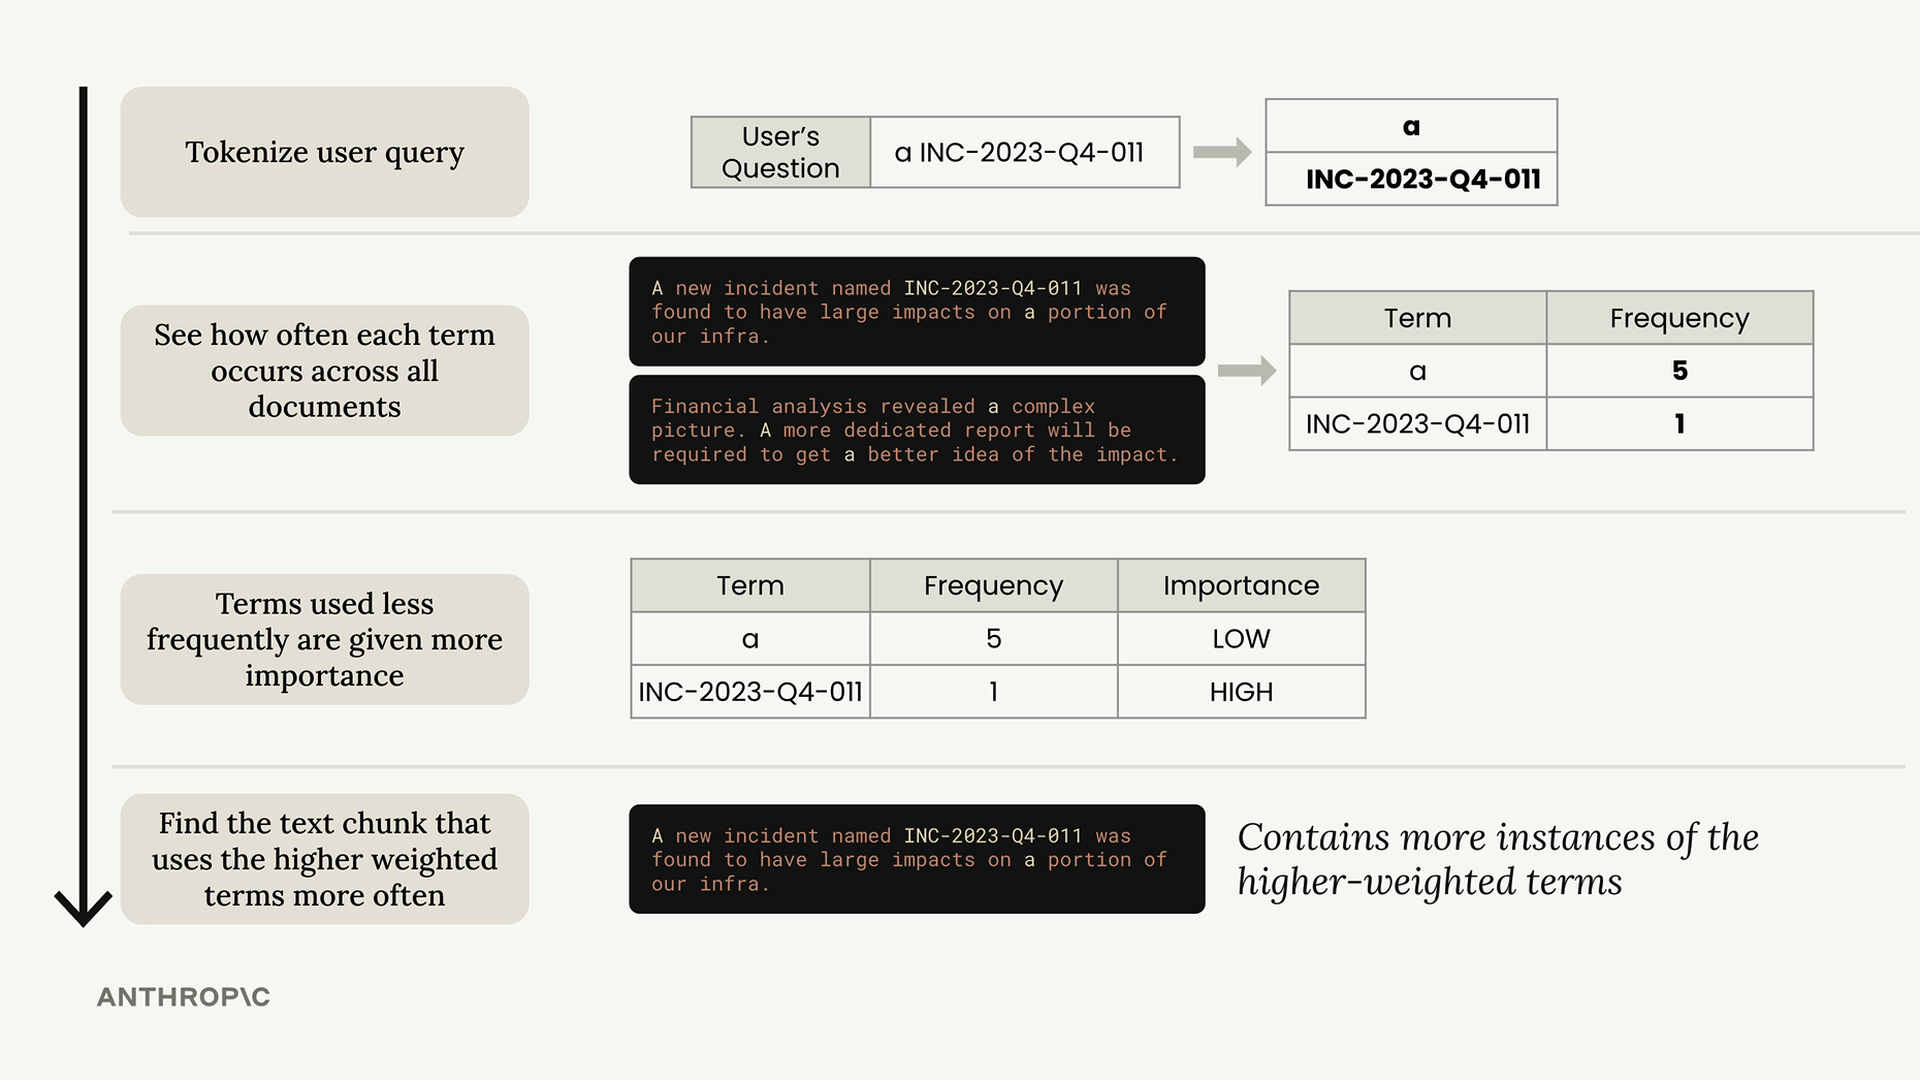
该算法遵循以下关键步骤:
- 对查询进行分词 - 将用户的问题拆分为单独的词项
- 统计词频 - 查看每个词项在所有文档中出现的频率
- 按稀有度加权词项 - 使用频率较低的词项获得更高的重要性分数
- 对文档评分 - 查找包含更多高权重词项实例的文本块
其中的关键洞察是,像"INC-2023-Q4-011"这样的稀有词项对搜索相关性的重要性,要远高于像"a"或"the"这样的常见词。
实现BM25搜索
以下是如何设置BM25搜索系统:
# 创建一个 BM25 存储
store = BM25Index()

# 将文档添加到存储中
for chunk in chunks:
    store.add_document({"content": chunk})

# 搜索存储
results = store.search("What happened with INC-2023-Q4-011?", 3)BM25的实现与您的向量存储保持着相似的API,具有add_document()和search()方法。这种一致性使得同时使用这两个系统变得很容易。
更好的搜索结果
当您对同一个在仅使用语义搜索时失败的查询运行BM25时,会得到更好的结果。该算法能正确地优先处理包含确切事件编号的章节,将它们排在比那些可能语义相关但不包含您所查找的特定术语的章节更靠前的位置。
现在,搜索结果能正确呈现实际讨论该事件的软件工程章节和网络安全章节,而不是返回像财务分析这样的无关内容。
后续步骤
既然您已经拥有了能够独立运行的语义搜索和词法搜索系统,下一步就是合并它们的结果。这种混合方法将为您带来embeddings的语义理解与关键词匹配的精确性相结合的效果,为您的RAG管道打造出更强大的搜索体验。