扩展思考是 Claude 的高级功能,它让模型在生成最终响应之前有时间对复杂问题进行推理。可以将其视为 Claude 的内心独白——您可以看到它是如何一步步处理您的问题的。
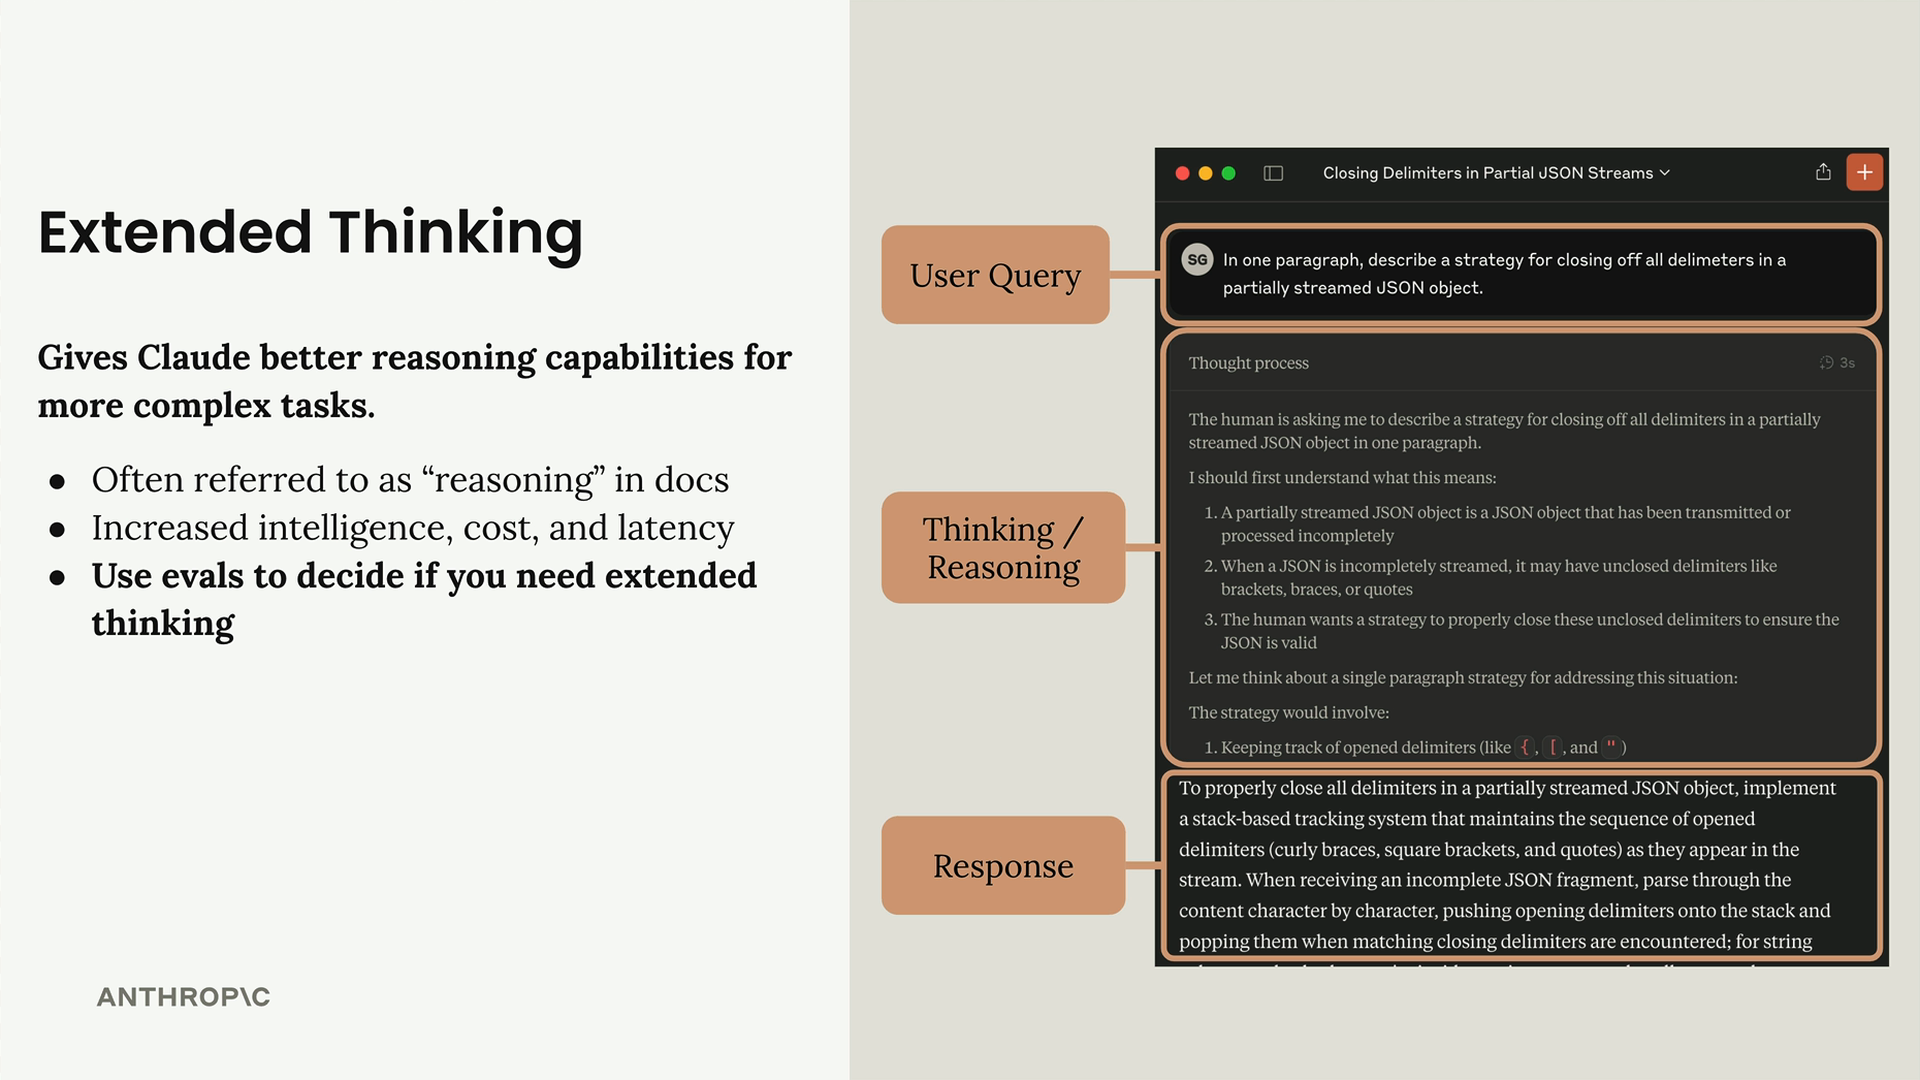
扩展思考的工作原理
当您启用扩展思考后,Claude 的响应将包含两部分而不是一部分:
- 推理内容部分 - Claude 的内部思考过程
- 文本部分 - 您实际想要的最终响应
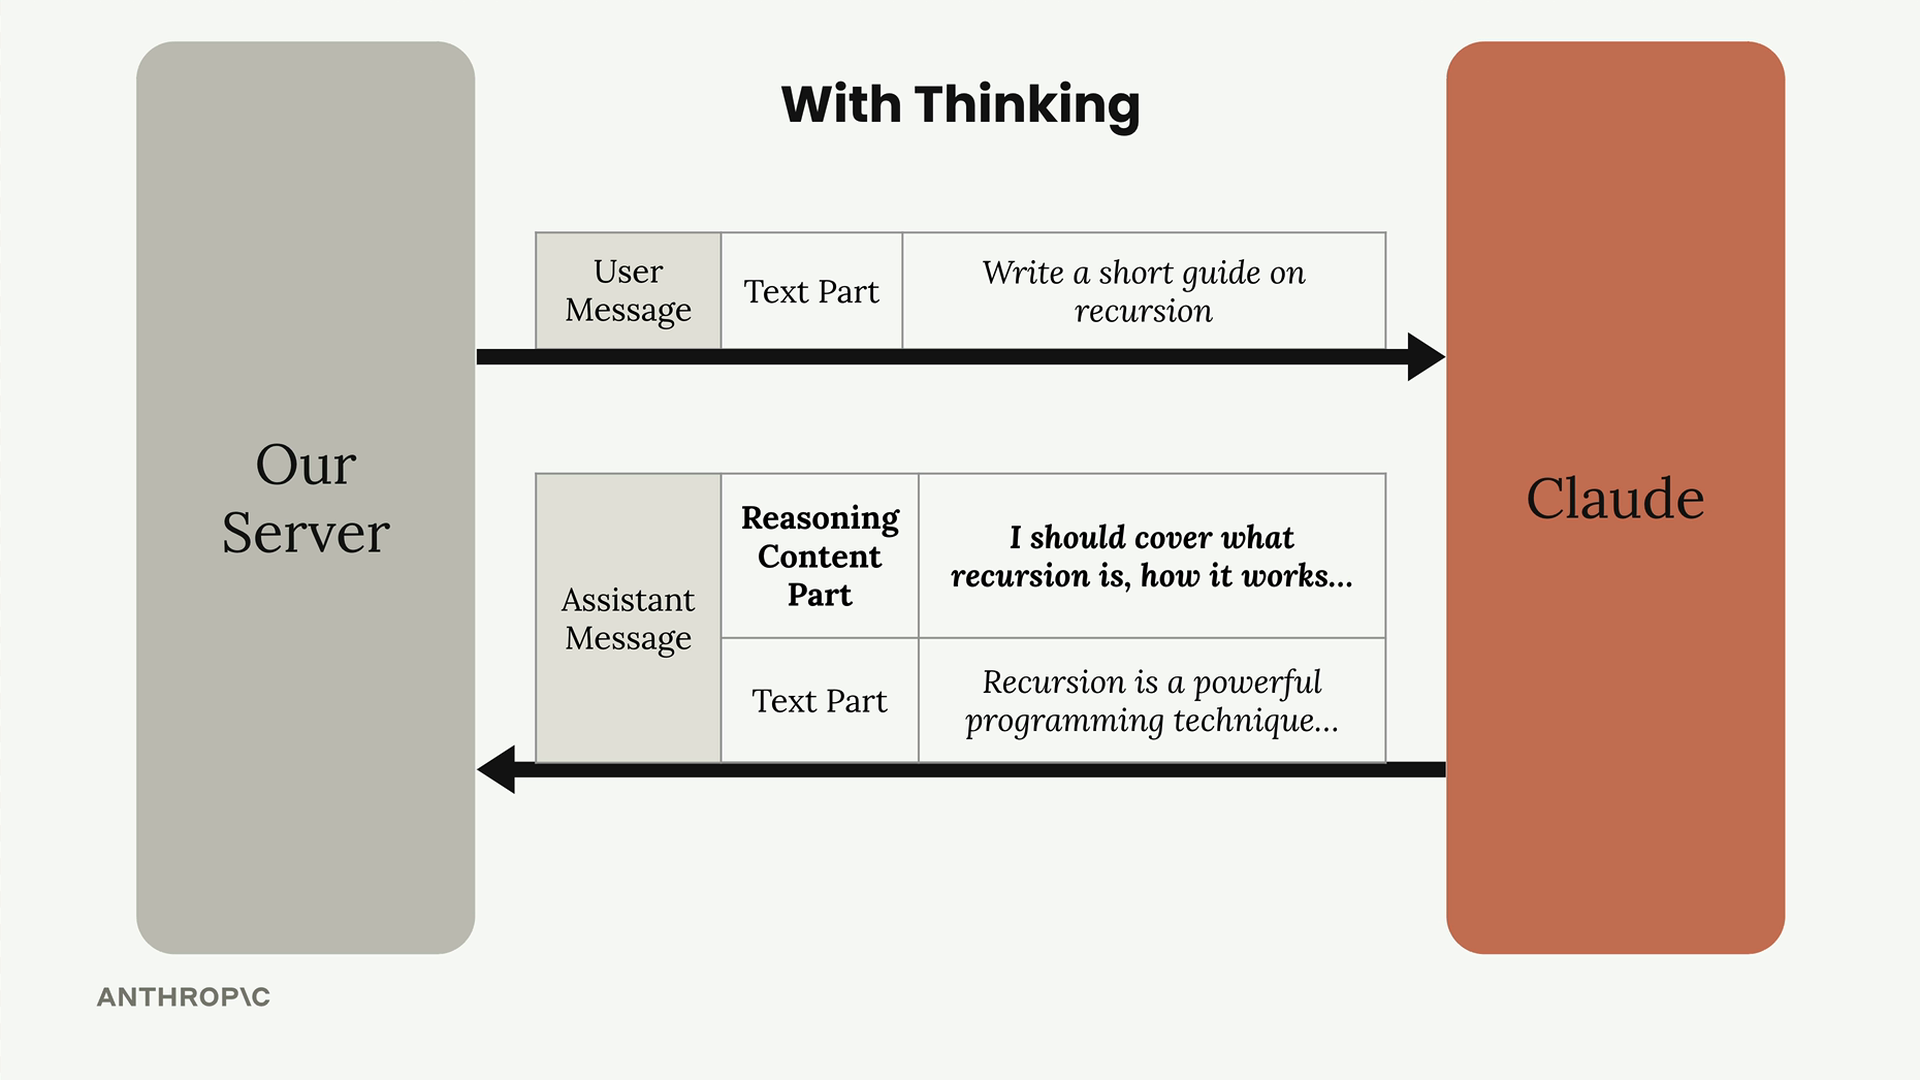
推理内容会准确展示 Claude 是如何拆解您的问题、考虑了哪些因素,以及如何得出最终答案的。这种透明度对于理解和调试复杂任务可能非常有价值。
需要权衡的取舍
扩展思考有明确的好处,也有明确的成本:
- 在复杂任务上准确性更高
- 成本更高 - 您需要为所有思考令牌(token)付费
- 延迟增加 - 思考需要时间
关键的决策点很简单:使用您的评估结果。如果您已经优化了提示,但仍未获得所需的准确性,这时扩展思考才值得考虑。
签名系统
您会立即注意到的一个重要细节是附加在推理内容上的加密签名:
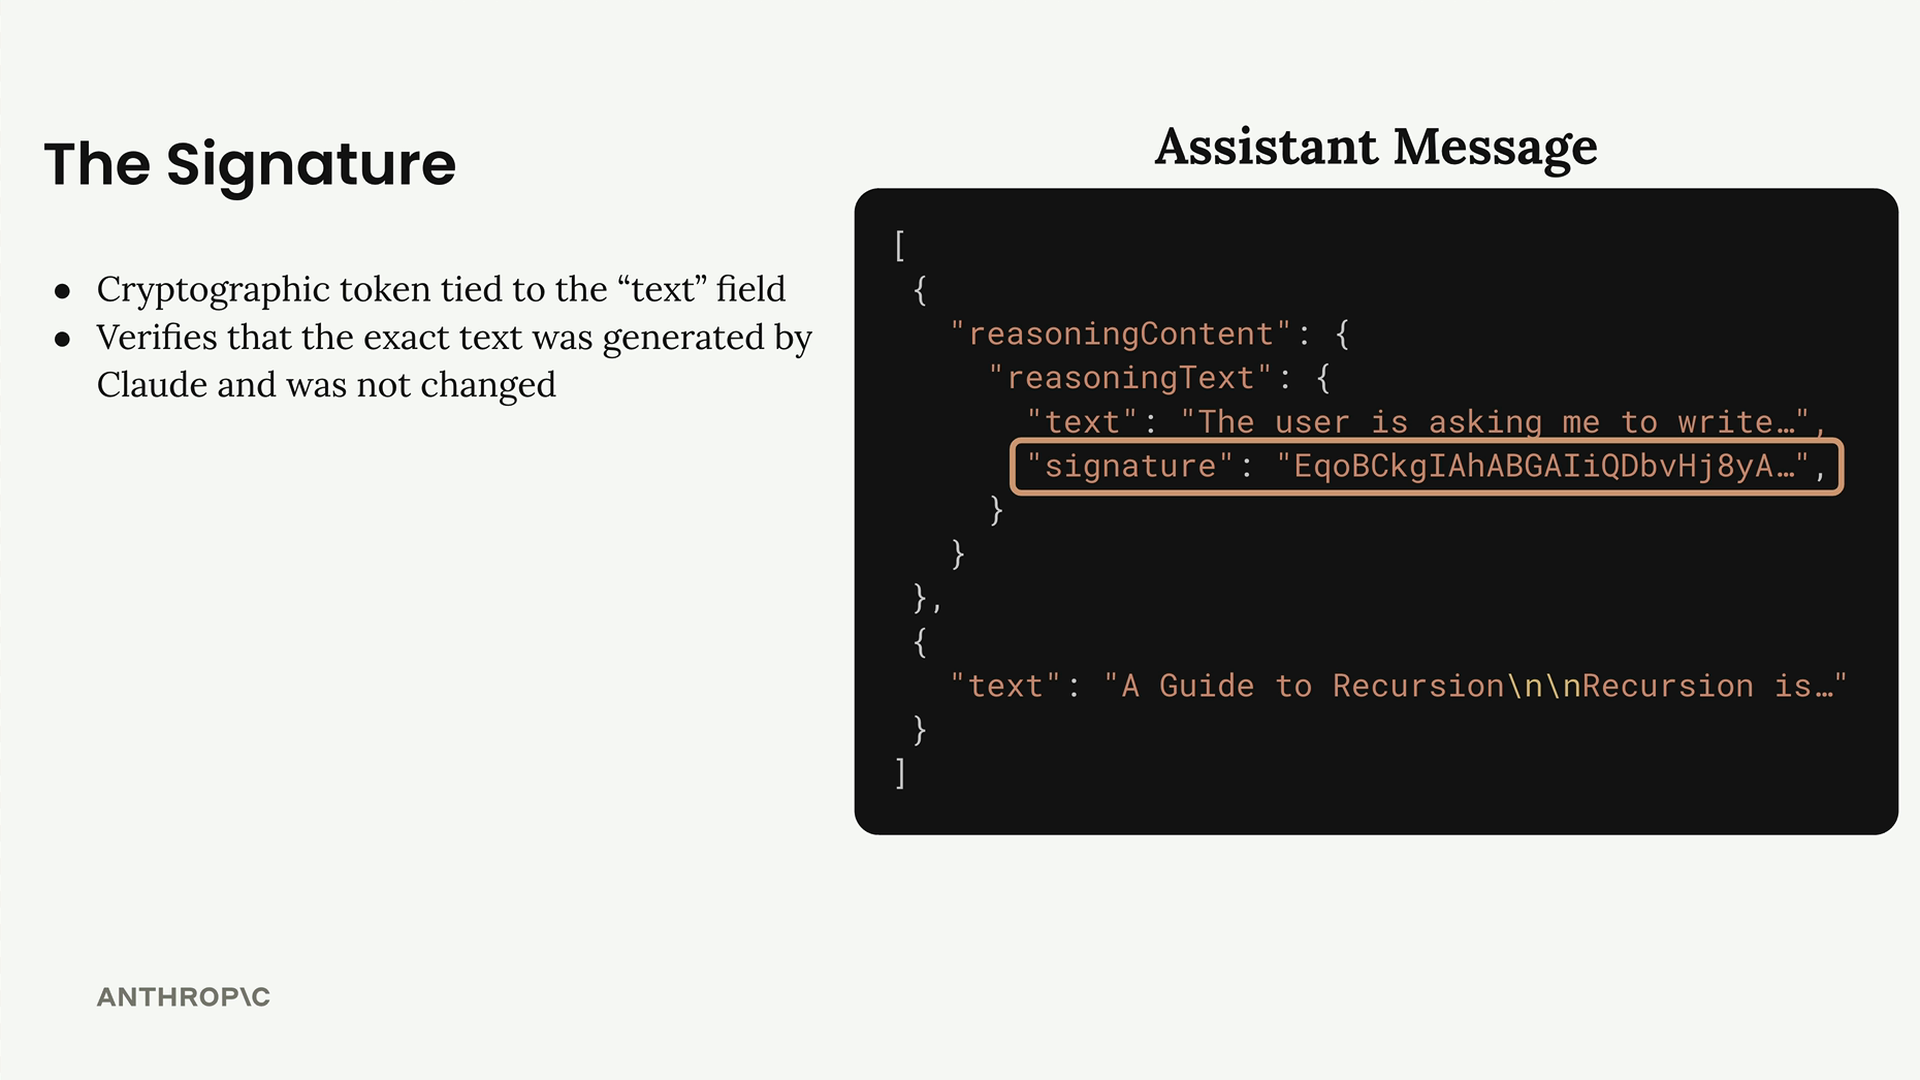
此签名确保您无法修改思考文本。如果您想在后续对话中包含 Claude 先前的推理内容,该签名可以验证内容未被篡改。这可以防止因修改思考文本而产生的潜在安全问题。
被屏蔽的内容
有时 Claude 的思考内容会被安全系统标记。发生这种情况时,您将收到一个 redactedContent 字段,而不是可读的思考文本:
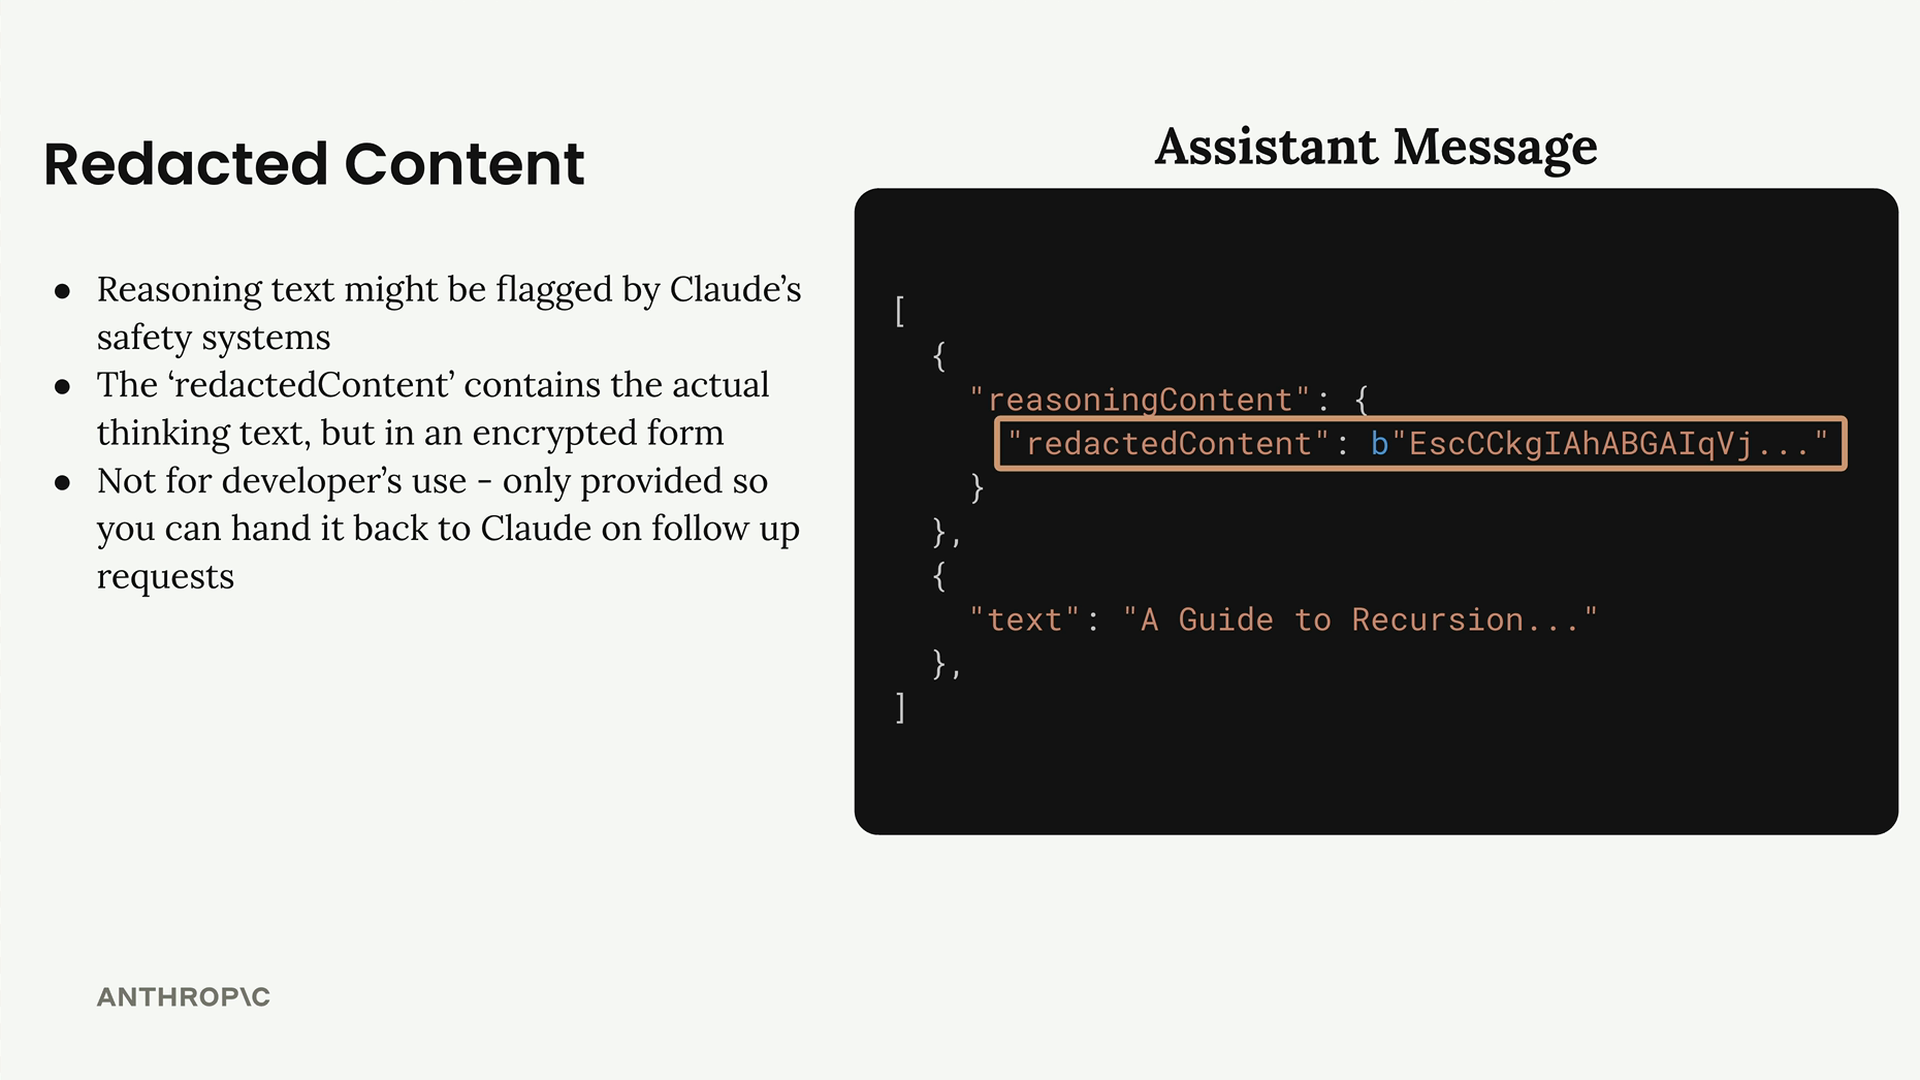
被屏蔽的内容是加密的,但仍然可用——您可以在未来的对话中将其传回给 Claude,而不会丢失上下文。只是作为开发者,您无法阅读它。
实现方式
在当前的 Claude 模型上,例如 Claude Opus 5 和 Claude Sonnet 5,思考以自适应思考(adaptive thinking)方式运行,并且默认开启:Claude 会自行决定每个请求需要多少推理,无需管理令牌预算。这些模型默认会省略思考文本,除非您明确请求——将 display 设置为 summarized 即可查看:
additional_model_fields["thinking"] = {
    "type": "adaptive",
    "display": "summarized"
}
启用自适应思考后,简单的问题通常能很快得到回应,而较难的问题则会获得更多推理时间。要引导 Claude 思考的程度,您可以将自适应思考与 effort 参数结合使用。effort 级别作为 Claude 思考分配的软性指导,取代了您原本需要手动管理的令牌预算。
如果您以前使用过扩展思考,请注意手动配置正在逐步淘汰:在 Claude Opus 4.6 和 Claude Sonnet 4.6 上,带有 budget_tokens 的 thinking.type: "enabled" 已被弃用;而 Claude Opus 4.7 及更高版本的模型(包括 Claude Opus 5 和 Claude Sonnet 5)不再支持该配置,并会对此类请求返回 400 错误拒绝。请改用带有 effort 参数的 thinking.type: "adaptive"。
不支持自适应思考的模型
Claude 4.5 系列模型(Claude Haiku 4.5、Claude Sonnet 4.5 和 Claude Opus 4.5)以及更早的模型不支持自适应思考。在这些模型上,您需要通过手动令牌预算来启用扩展思考:
additional_model_fields["thinking"] = {
    "type": "enabled",
    "budget_tokens": thinking_budget
}
thinking_budget 用于控制 Claude 在推理上可以花费的令牌数量。最小值为 1024 个令牌,但对于复杂问题,您可能需要更多。与 Claude 的其他方面一样,使用您的评估结果来为您的用例找到合适的预算。
更新后的聊天函数如下所示:
def chat(
    messages,
    system=None,
    temperature=1.0,
    stop_sequences=[],
    tools=None,
    tool_choice="auto",
    text_editor=None,
    thinking=False,
    thinking_budget=1024
):
测试您的实现
在构建处理扩展思考的应用程序时,您需要测试正常的推理内容场景和被屏蔽内容的场景。实际上有一个特殊的测试字符串,可以强制 Claude 返回被屏蔽的内容——这对确保您的代码能正确处理这两种情况非常有用。
关于扩展思考,最重要的一点是:是否使用它的决策应始终以数据为依据。先运行您的评估,优化您的提示,只有在需要为复杂任务的准确性提供额外提升时,才考虑使用扩展思考。这种严谨性依赖于一个简单的习惯:在您寻求更强能力之前,先确定"好"是什么样子。当您了解任务所需的准确性时,您就能判断扩展思考是否值得它的成本,而不是靠猜测。
练习:亲自运行自适应思考
理解自适应思考最简单的方法是观察它做出决策的过程。在您一直在构建聊天函数的代码中,将其打开:
additional_model_fields["thinking"] = {
    "type": "adaptive",
    "display": "summarized"
}
现在通过这个相同的配置发送两个请求。首先问一个您已经知道答案的简单事实性问题。然后问一个真正困难的问题,比如来自您自己工作的多步骤分析问题。如果您使用的模型不支持自适应思考,请使用上一节中的手动 budget_tokens 配置启用思考,并运行同样的两个请求。
检查思考的实际效果
设置标志只能证明请求已被接受。以下检查可以告诉您思考实际起到了什么作用:
- 确认思考已启用。 现在每个响应都应该包含两部分——推理内容和最终文本——而不仅仅是文本。唯一的例外是被屏蔽的内容,正如您之前所见:
redactedContent字段意味着思考已经运行,但文本是加密的。 - 阅读推理内容。 检查它是否真正针对您所提出的问题进行了推理,而不仅仅是复述问题。这正是您之后在调试复杂任务时将依赖的透明度。
- 比较这两个请求。 简单问题通常会很快返回,推理内容也较少,而困难问题则会明显得到更多推理。这种差异正是自适应思考为您做出分配决策的体现。
- 权衡成本。 您需要为每一个思考令牌付费,因此请检查更难问题的答案是否比不进行思考时的答案更好。您的评估才是判断这一点的依据,看到推理文本出现本身并不能替代评估。
值得从本课中牢记的行为是:每当您在新任务上启用扩展思考时,先在几个有代表性的请求上阅读推理内容,并重新运行您的评估,然后再决定是否保留该设置。