典型的提示评估工作流程遵循一种系统化的方法,以客观地衡量和改进您的提示。虽然组装这些工作流程有许多不同的方式,也有各种开源和付费工具可供使用,但了解核心流程能帮助您从小处着手,并按需扩展规模。
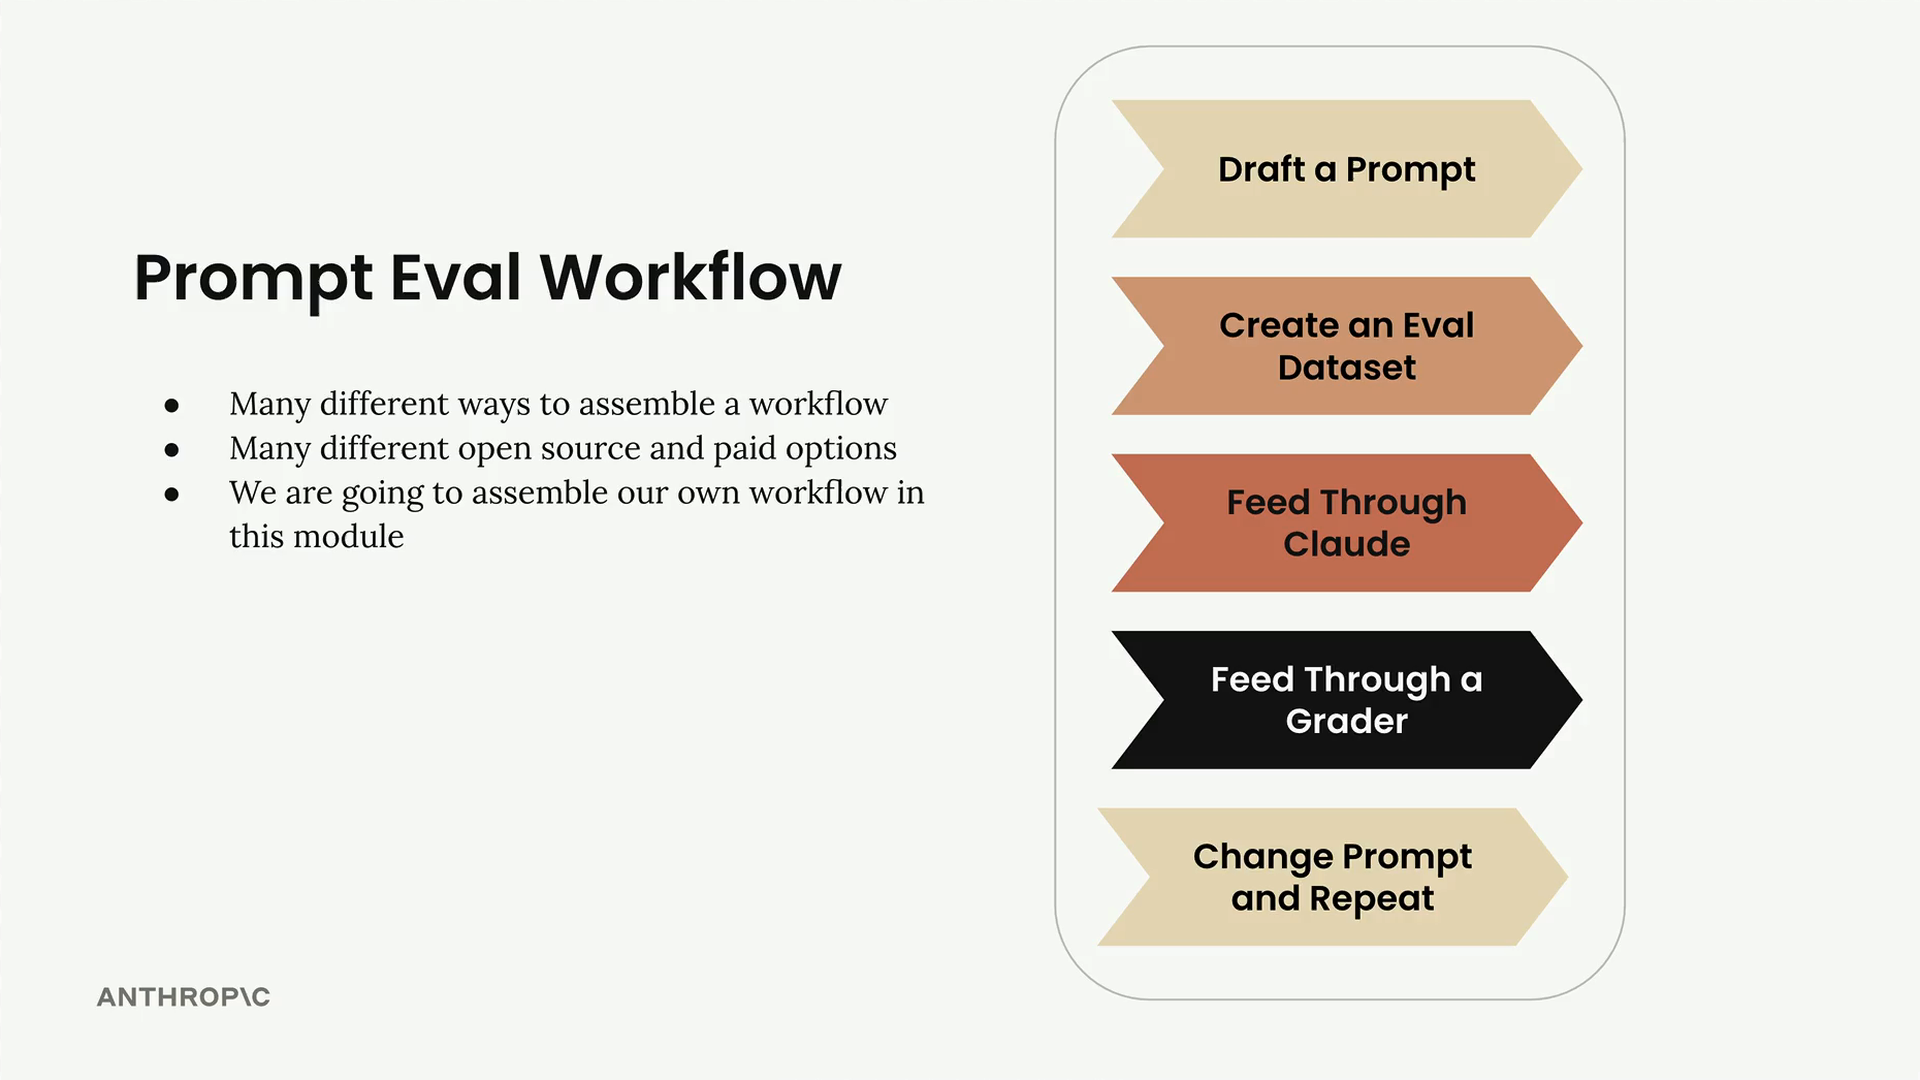
步骤 1:起草您的初始提示
首先写出一个您想要改进的基础提示。在这个示例中,我们将使用一个简单的提示结构:
prompt = f"""
Please answer the user's question:

{question}
"""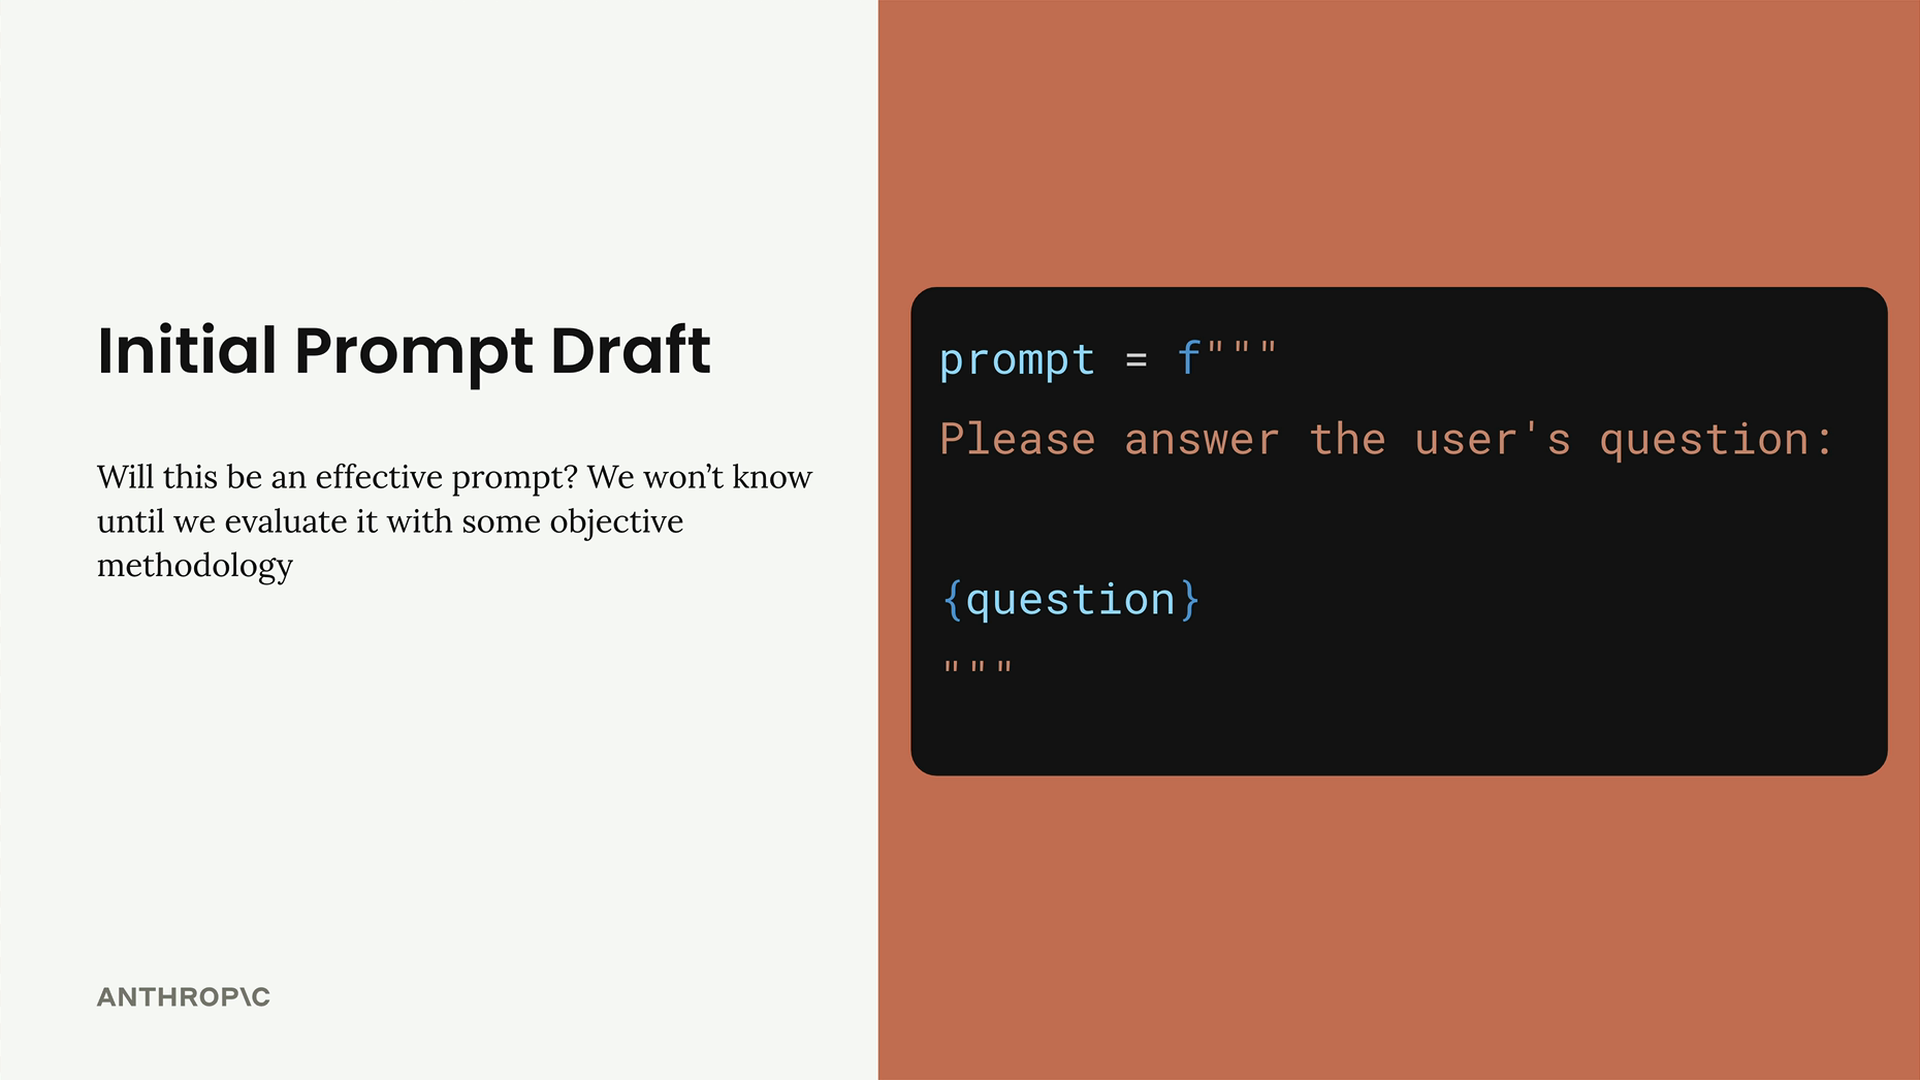
这为我们提供了一个可供参考的基准。在使用某种客观方法对其进行评估之前,我们无法知道它是否有效。
步骤 2:创建评估数据集
您的评估数据集包含一些示例输入,您将把这些输入馈送到您的提示中。由于我们的提示只有一个输入(用户的问题),因此我们需要一批不同的问题来进行测试。
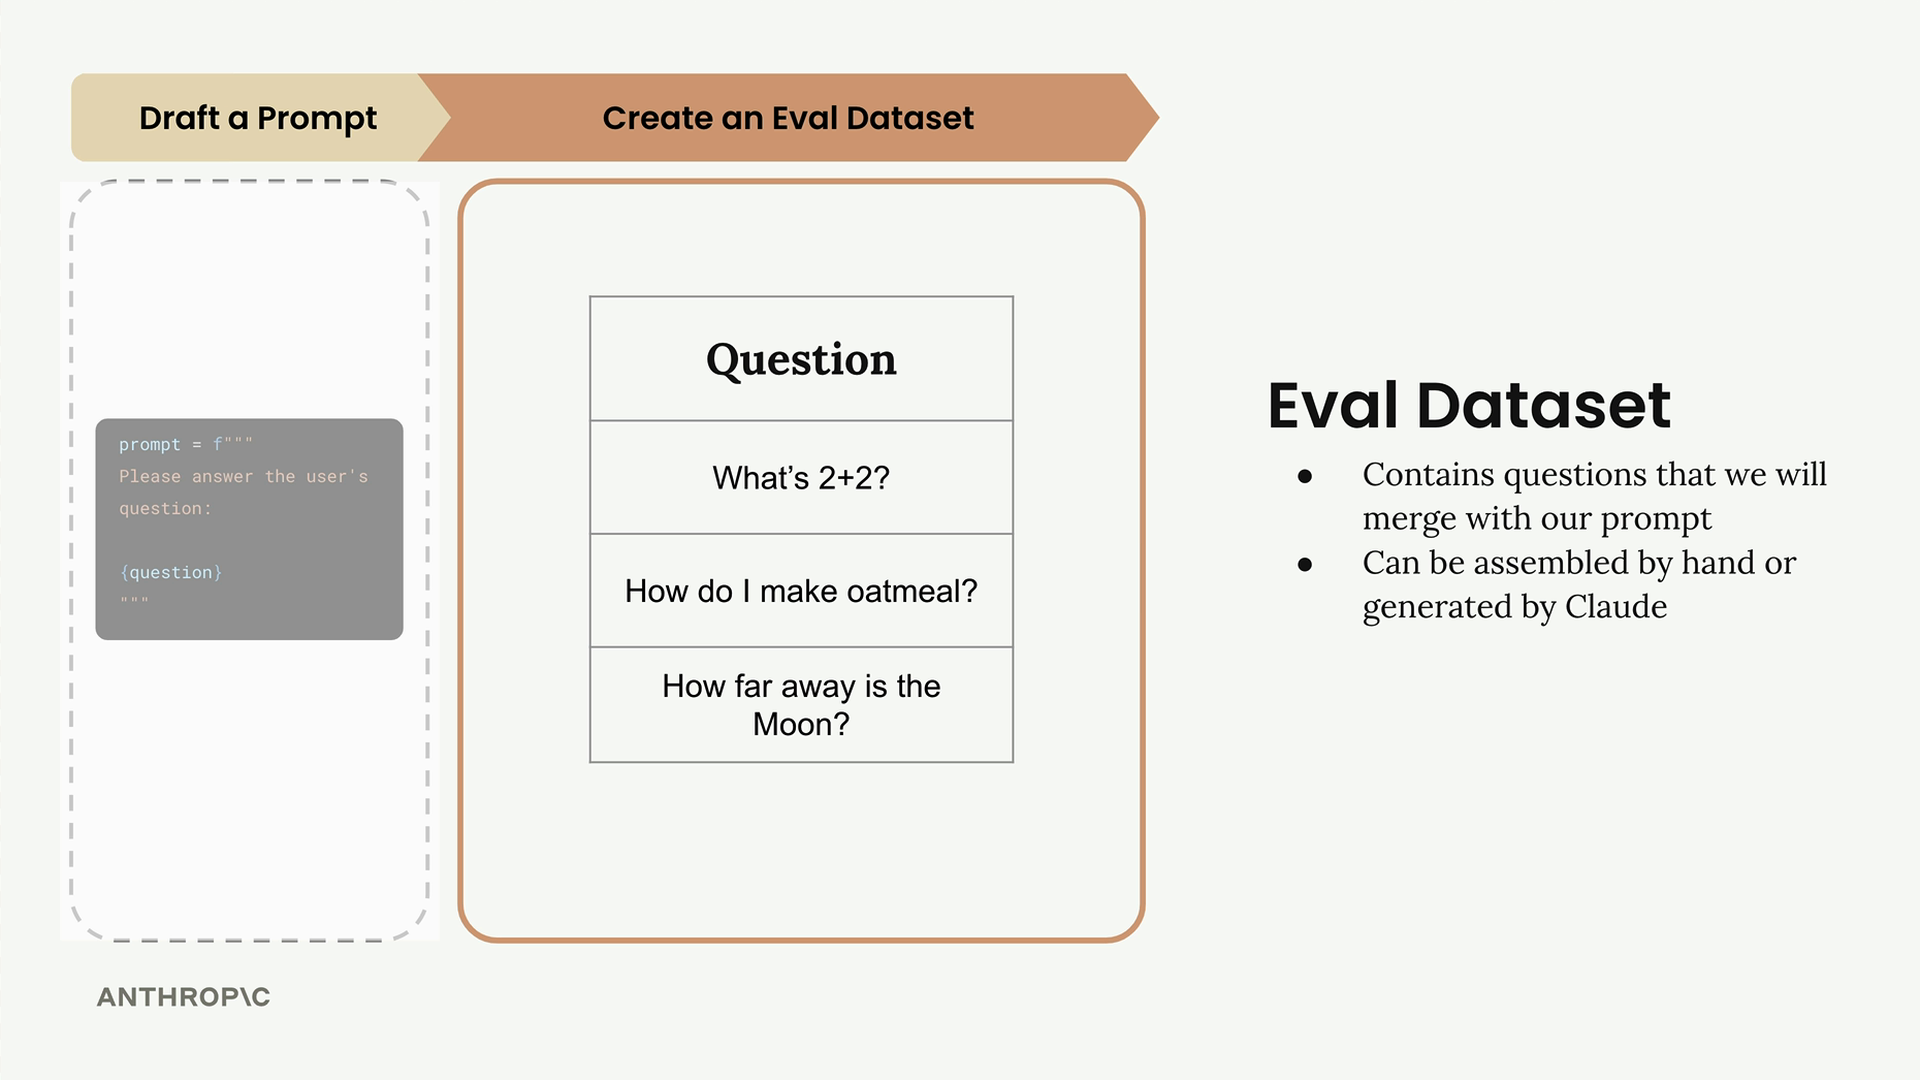
该数据集包含我们将与提示合并的问题。您可以手动组建这些数据集,也可以使用 Claude 生成它们。在真实场景的评估中,您可能会有数十、数百甚至数千条不同的记录,但在此示例中我们将从仅有三个问题开始:
- 2+2 等于多少?
- 我该如何制作燕麦粥?
- 月球有多远?
步骤 3:通过 Claude 处理
从数据集中取出每个问题,将其与您的提示模板合并,以创建完整的提示。然后将每个提示发送给 Claude 并收集回复。
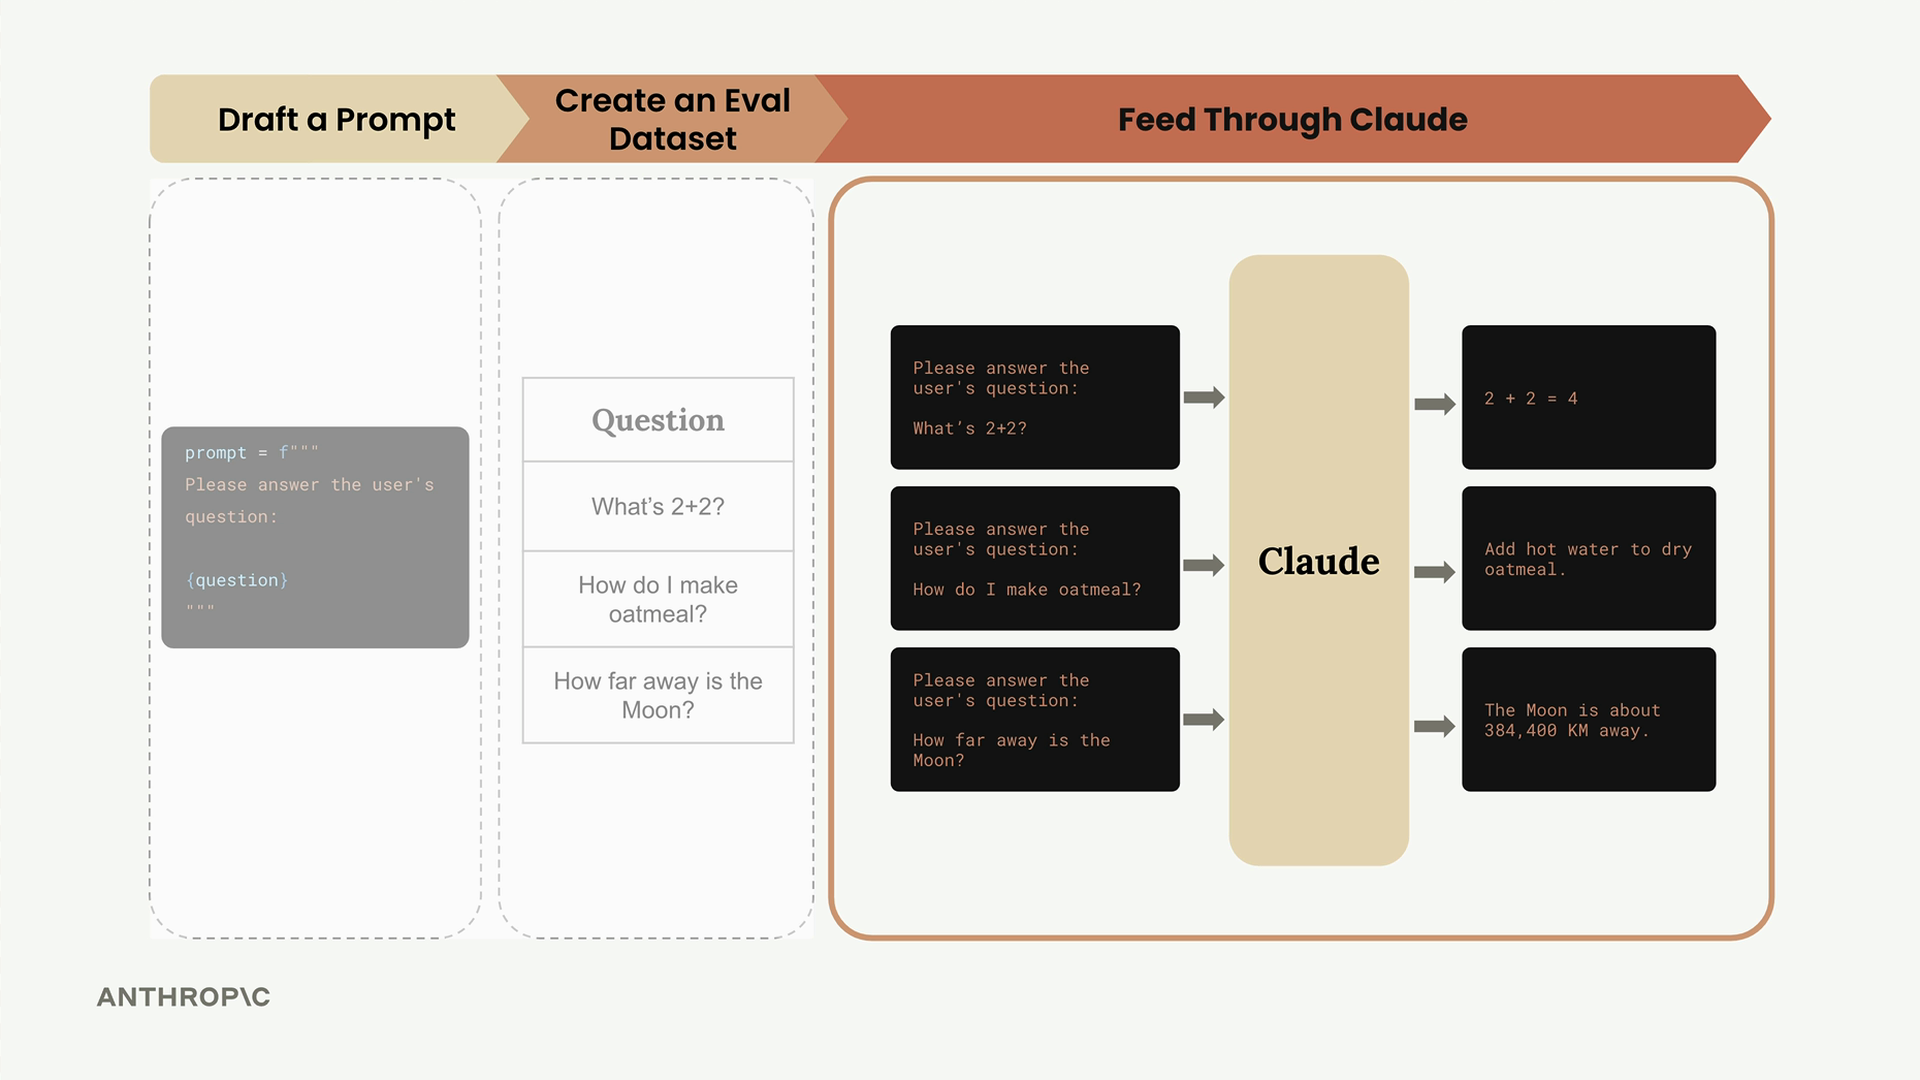
例如,第一个问题会变成一个 Claude 可以回复的完整提示。您将对数据集中的所有记录重复此过程,获得诸如"2 + 2 = 4"、详细的燕麦粥制作说明,以及有关月球距离的信息等回复。
步骤 4:通过评分器处理
现在到了关键步骤:客观地为 Claude 的回复打分。将每个问题与答案配对,并将其输入到评分器中,由评分器评估 Claude 回复的质量。
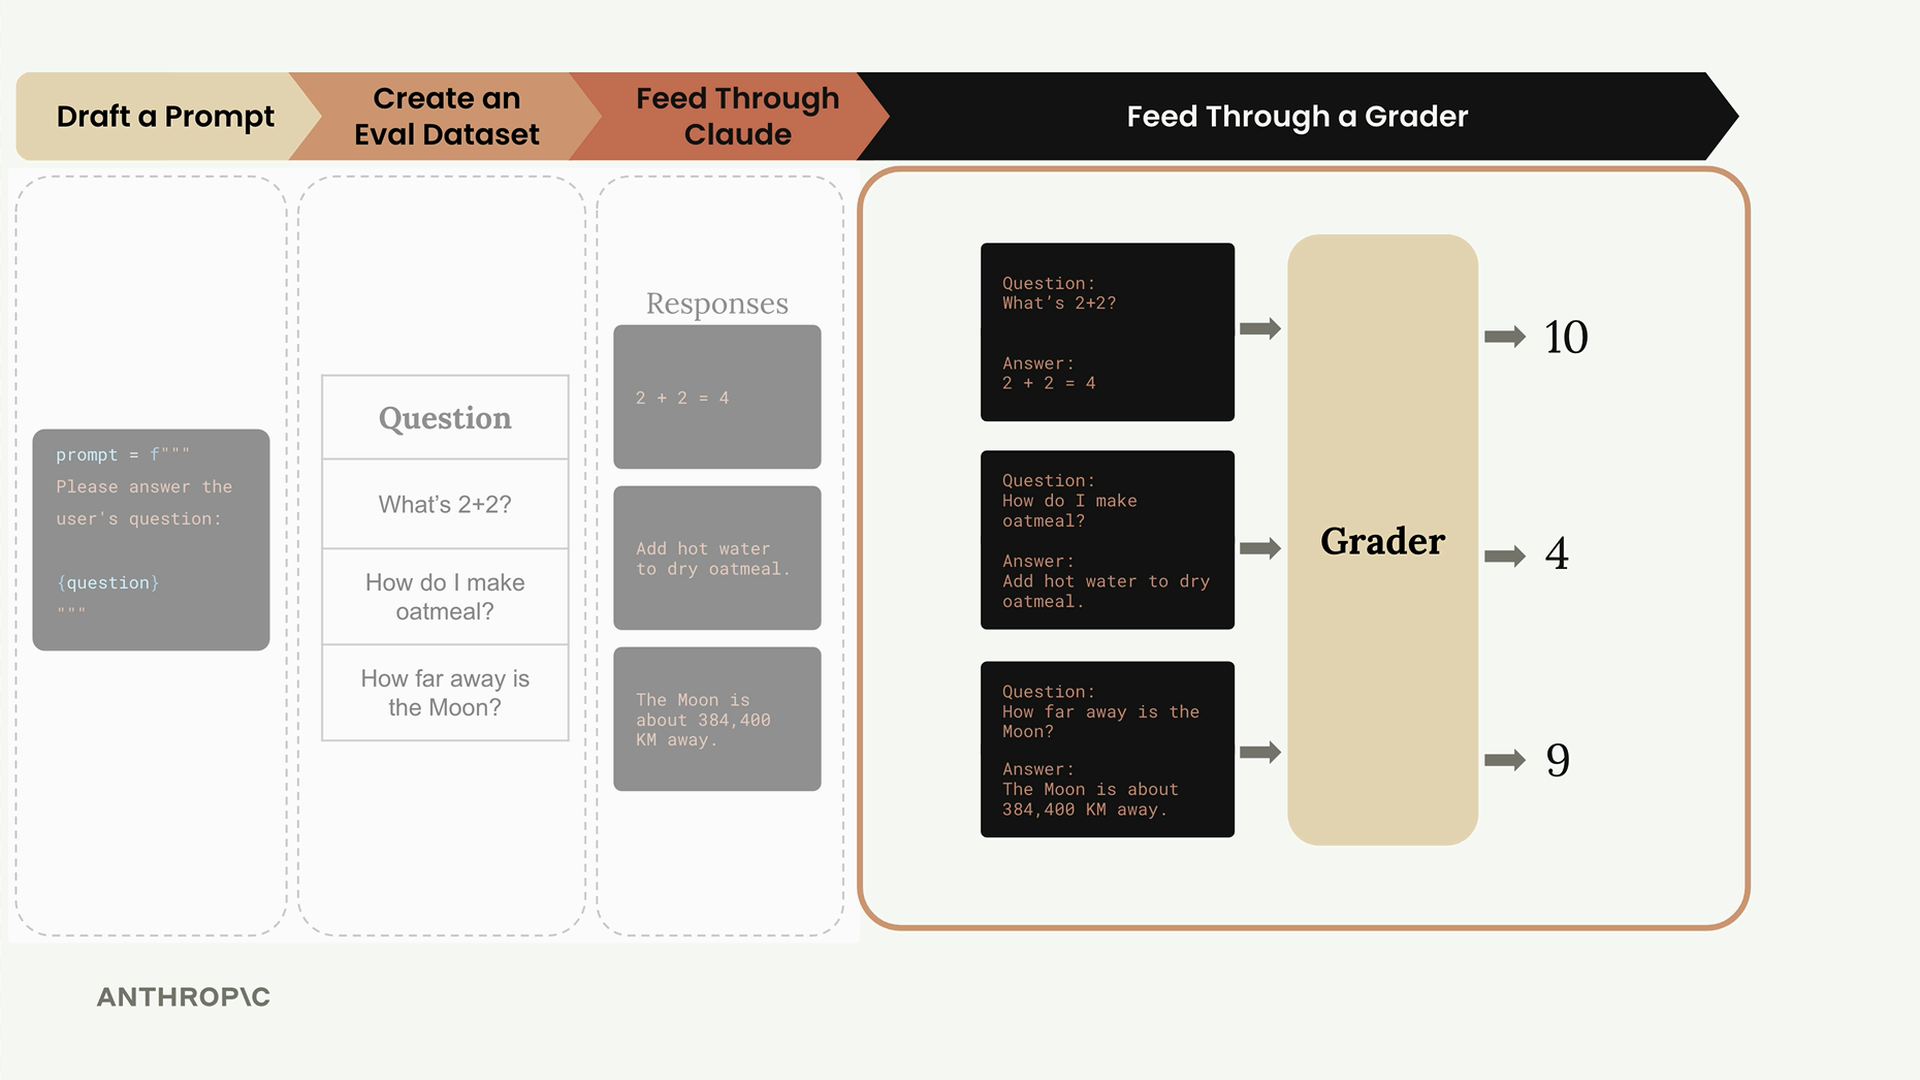
评分器根据回复质量给出分数(通常为 1-10 分):
- 10 = 完美答案,无需改进
- 4 = 明显有改进空间
- 1 = 较差或错误的回复
在我们的示例中,这些回复可能分别得分 10、4 和 9。将这些分数取平均值,得出一个总体性能指标:7.66。
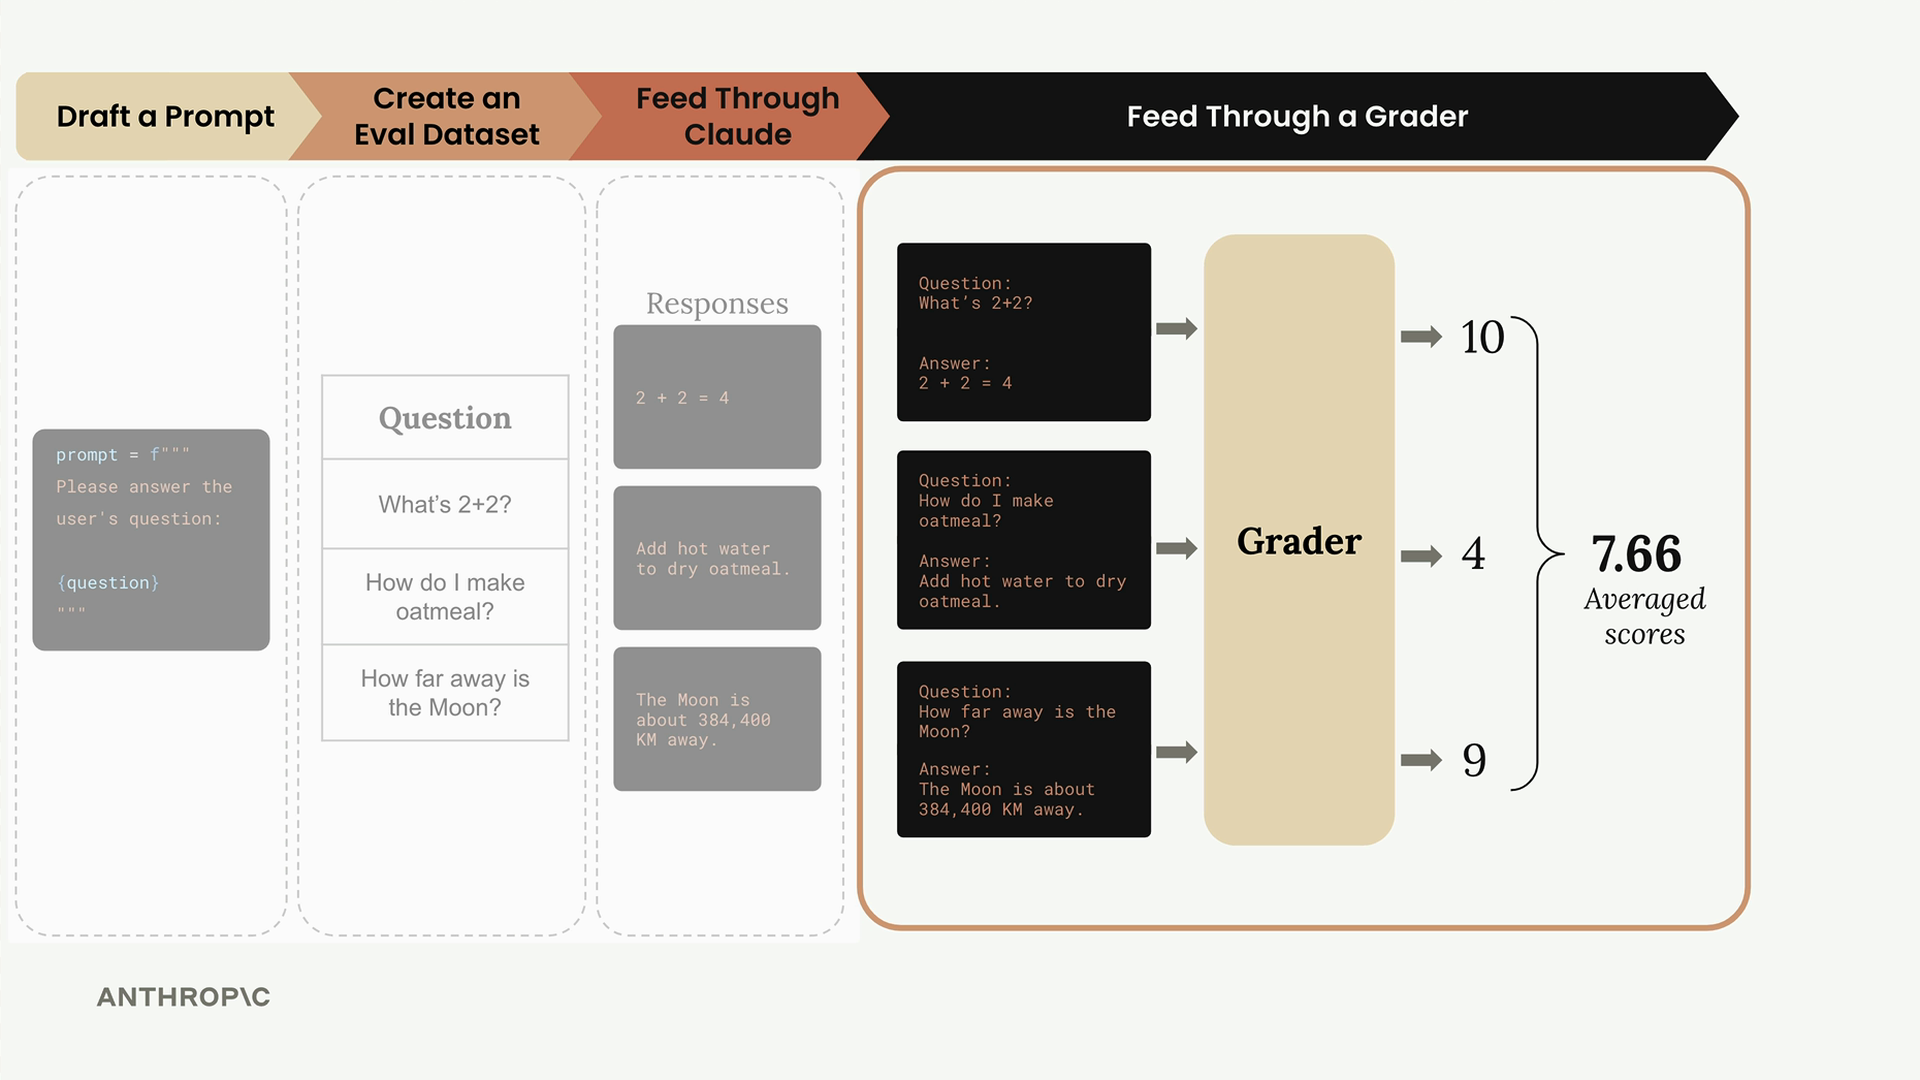
步骤 5:修改提示并重复
在确立了您的基准分数之后,您现在可以对提示进行迭代。尝试添加更具体的指令以引导 Claude 的回复:
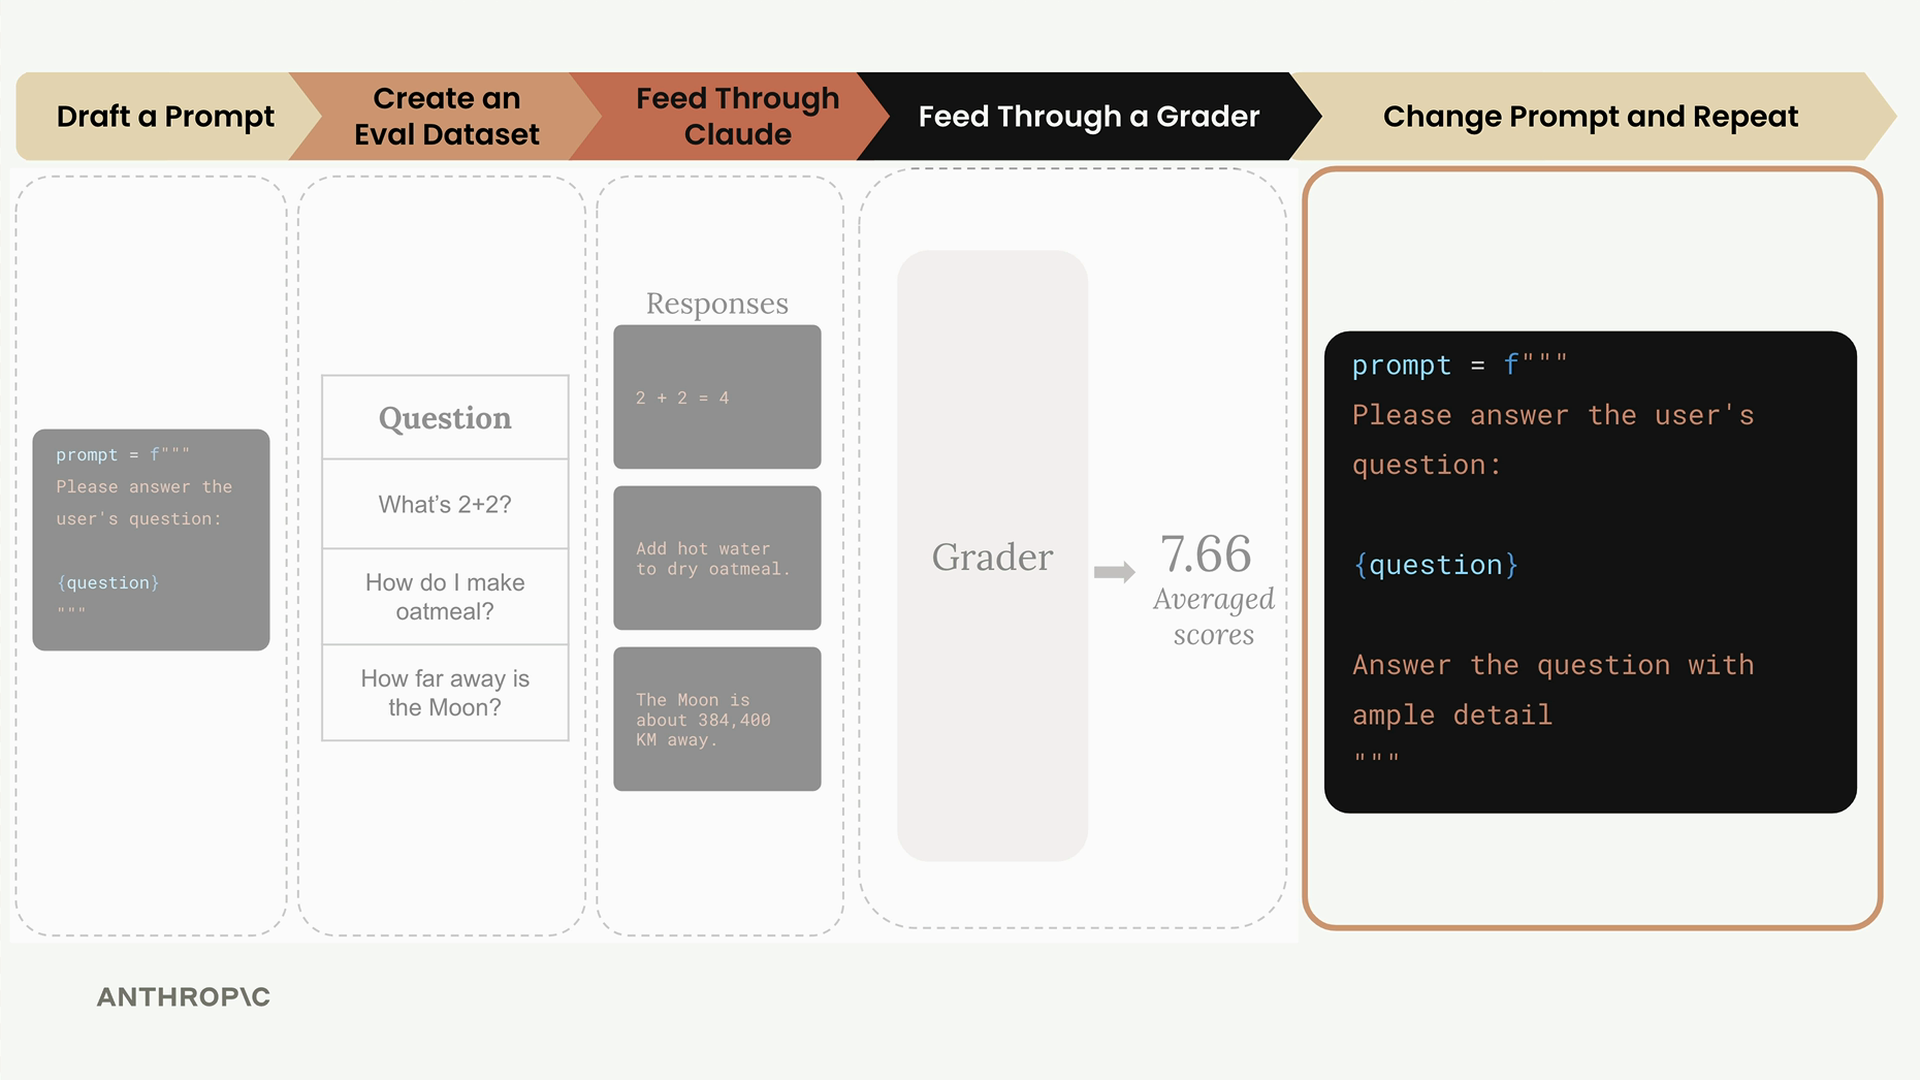
prompt = f"""
Please answer the user's question:

{question}

Answer the question with ample detail
"""
再次将这个改进后的提示运行一遍整个评估流水线。比较两个版本的分数,看看哪个版本表现更好。
提示打分与迭代
这种工作流程的力量在于为每个提示版本获取客观的测量结果。您可以比较不同迭代版本之间的分数,并使用表现最佳的版本,或者继续迭代以寻找更好的方法。
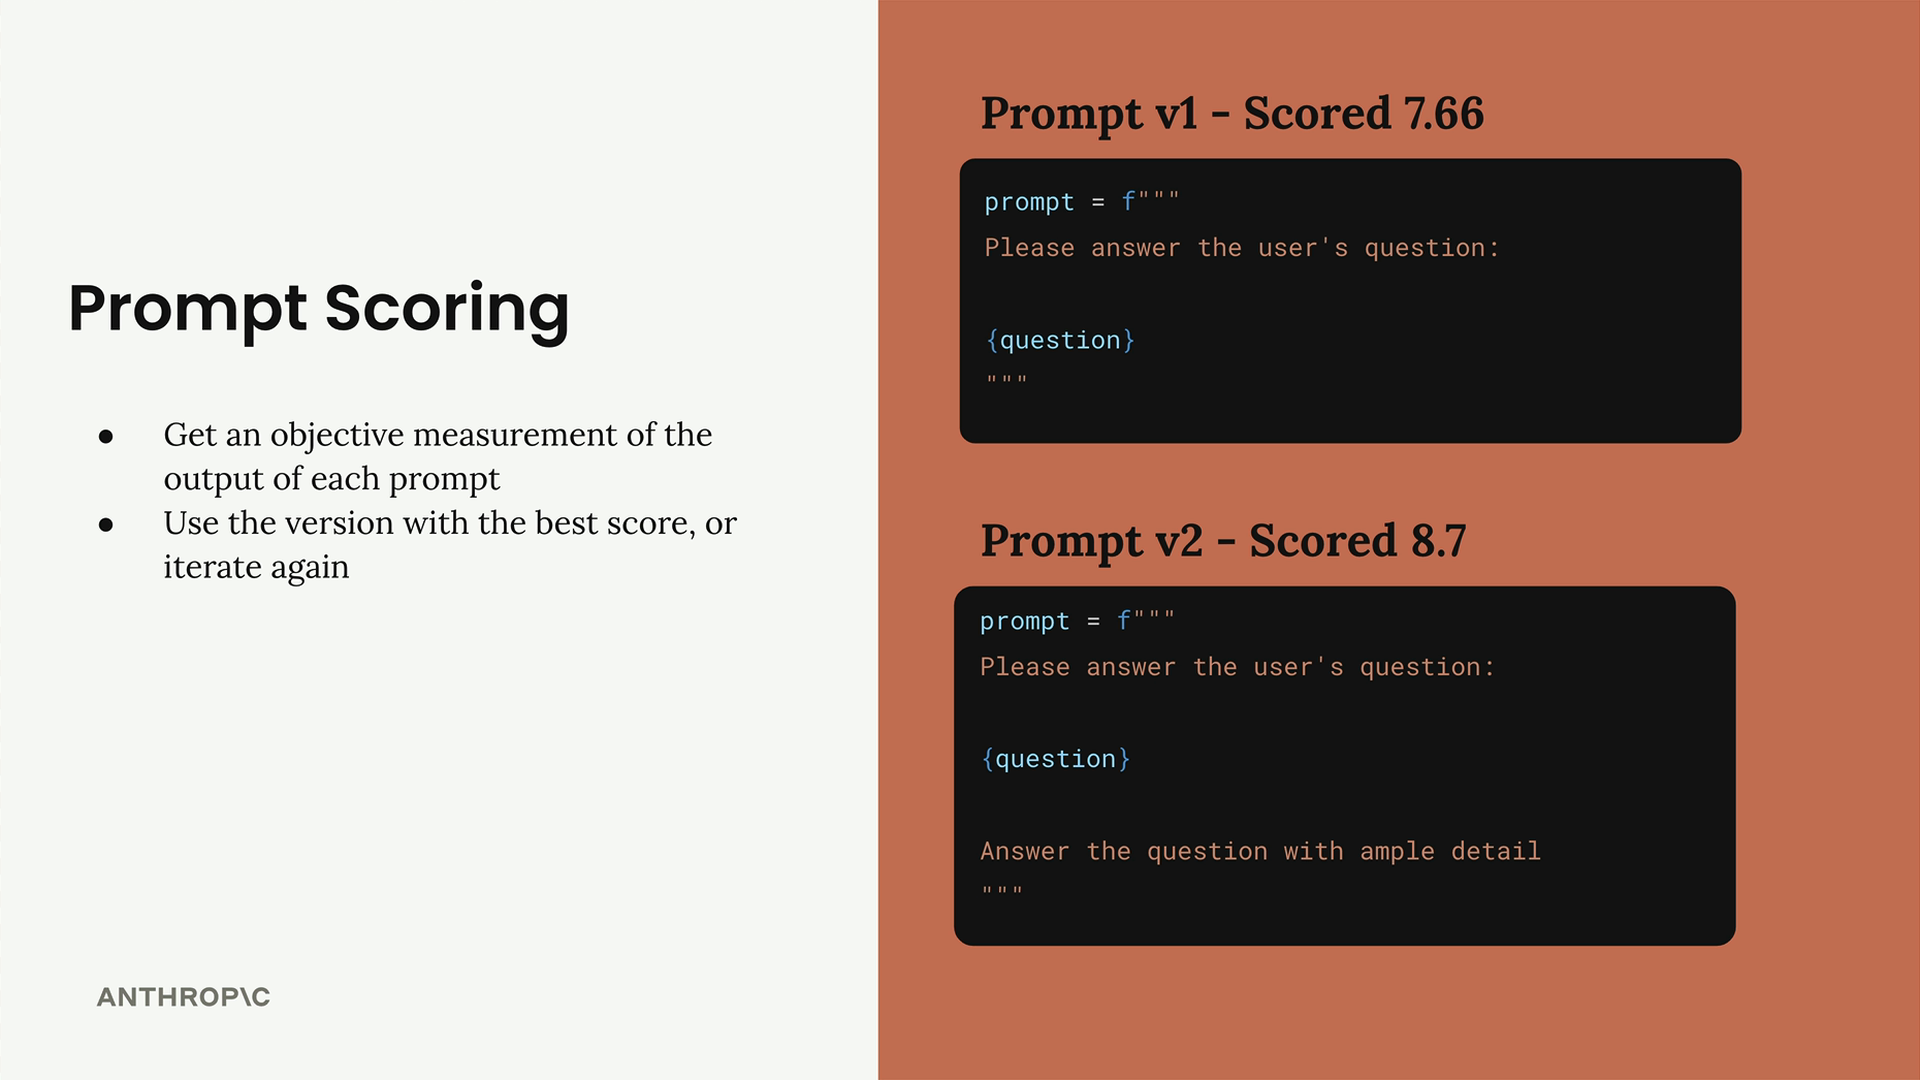
在我们的示例中:
- 提示 v1 得分 7.66
- 提示 v2 得分 8.7
v2 的更高分数表明,添加"请详尽地回答问题"提升了该提示在我们测试用例中的表现。
这种系统化的方法为您提供了一种客观的方式来衡量提示的改进,而不是依赖主观判断。您可以从简单的实现开始,随着需求的增长逐步添加更复杂的评估标准。