提示缓存是一项功能,它通过复用先前请求中的计算工作来加快Claude的响应速度,并降低文本生成的成本。为了理解其工作原理,让我们先看看在一次典型请求中,Claude内部通常会发生什么。
Claude通常如何处理请求
当您向Claude发送一条消息时,在您收到回复之前,幕后会发生许多事情。Claude并不会立即开始生成文本——它会首先对您的输入消息进行大量的处理工作。
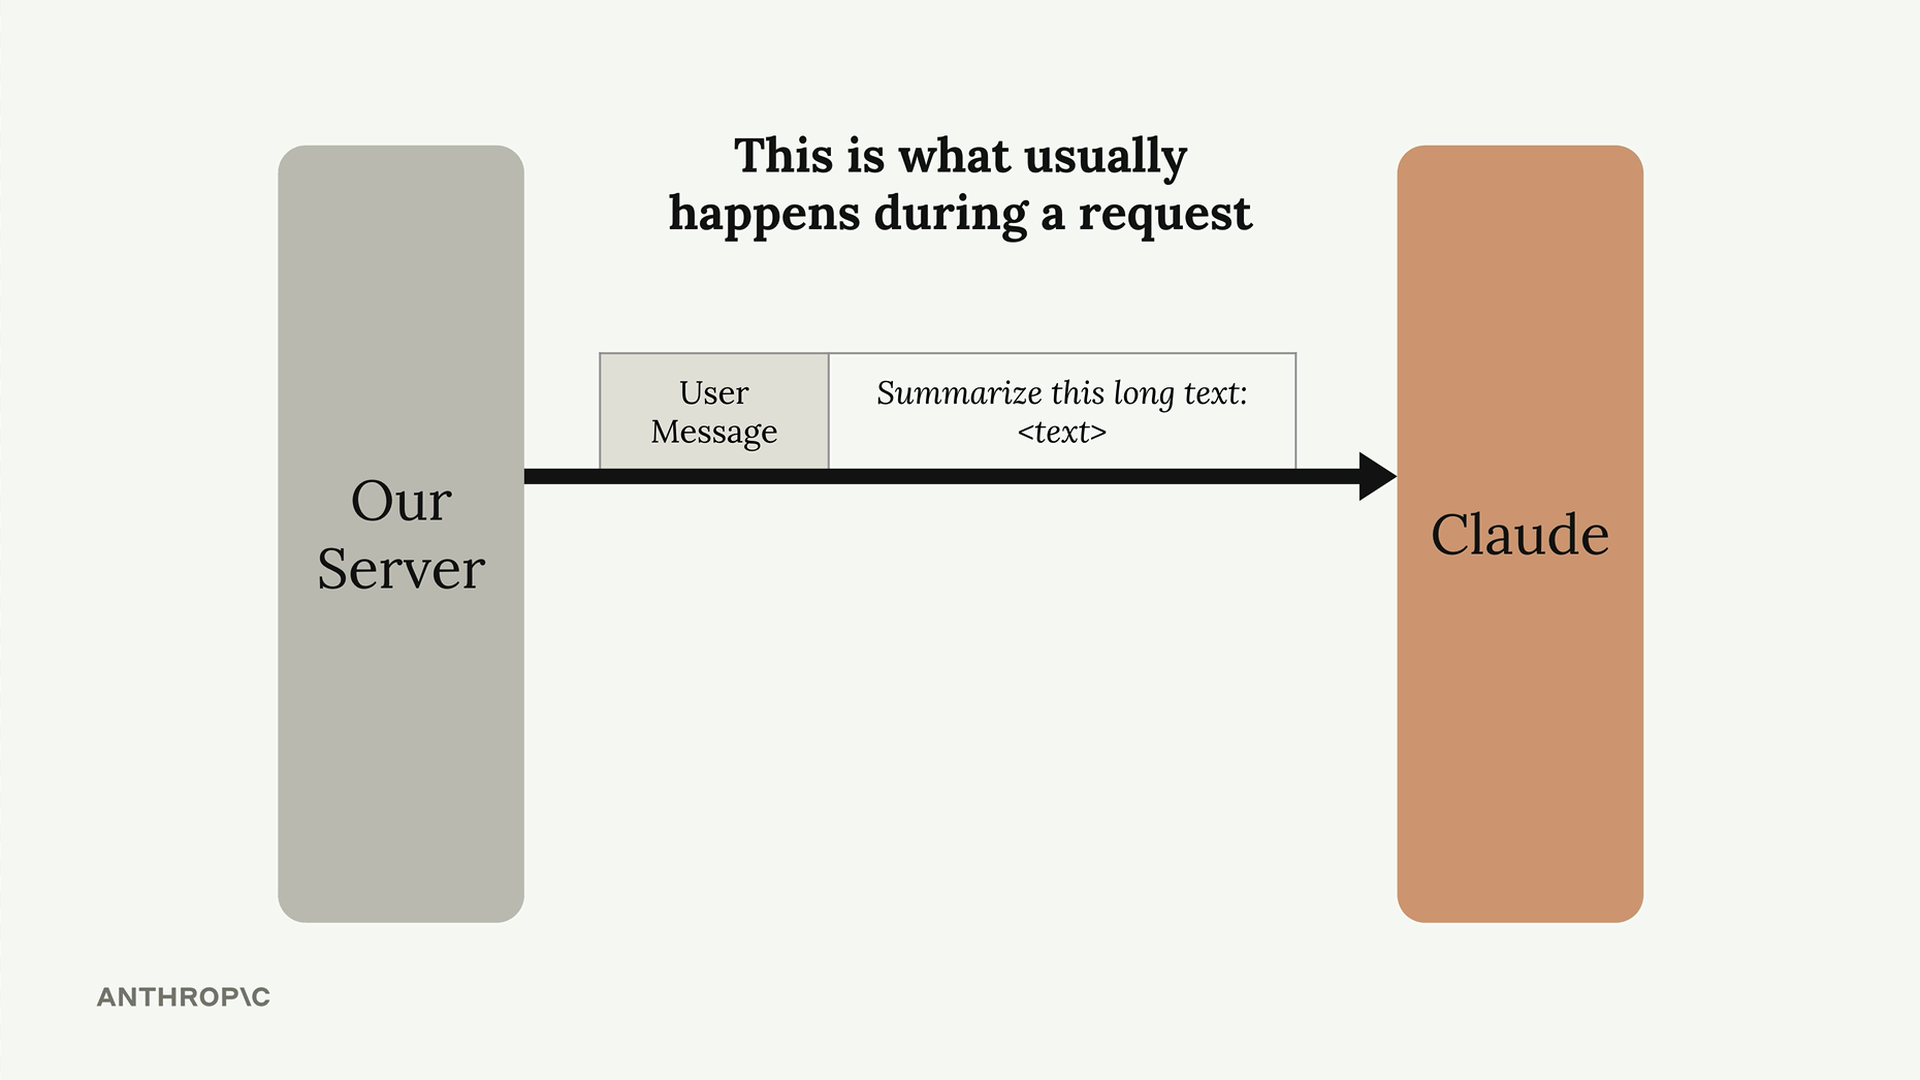
以下是Claude处理您消息时所做的工作:
- 对提示进行分词(tokenize)
- 为每个令牌创建嵌入(embeddings)
- 根据周围文本添加上下文
- 生成输出文本
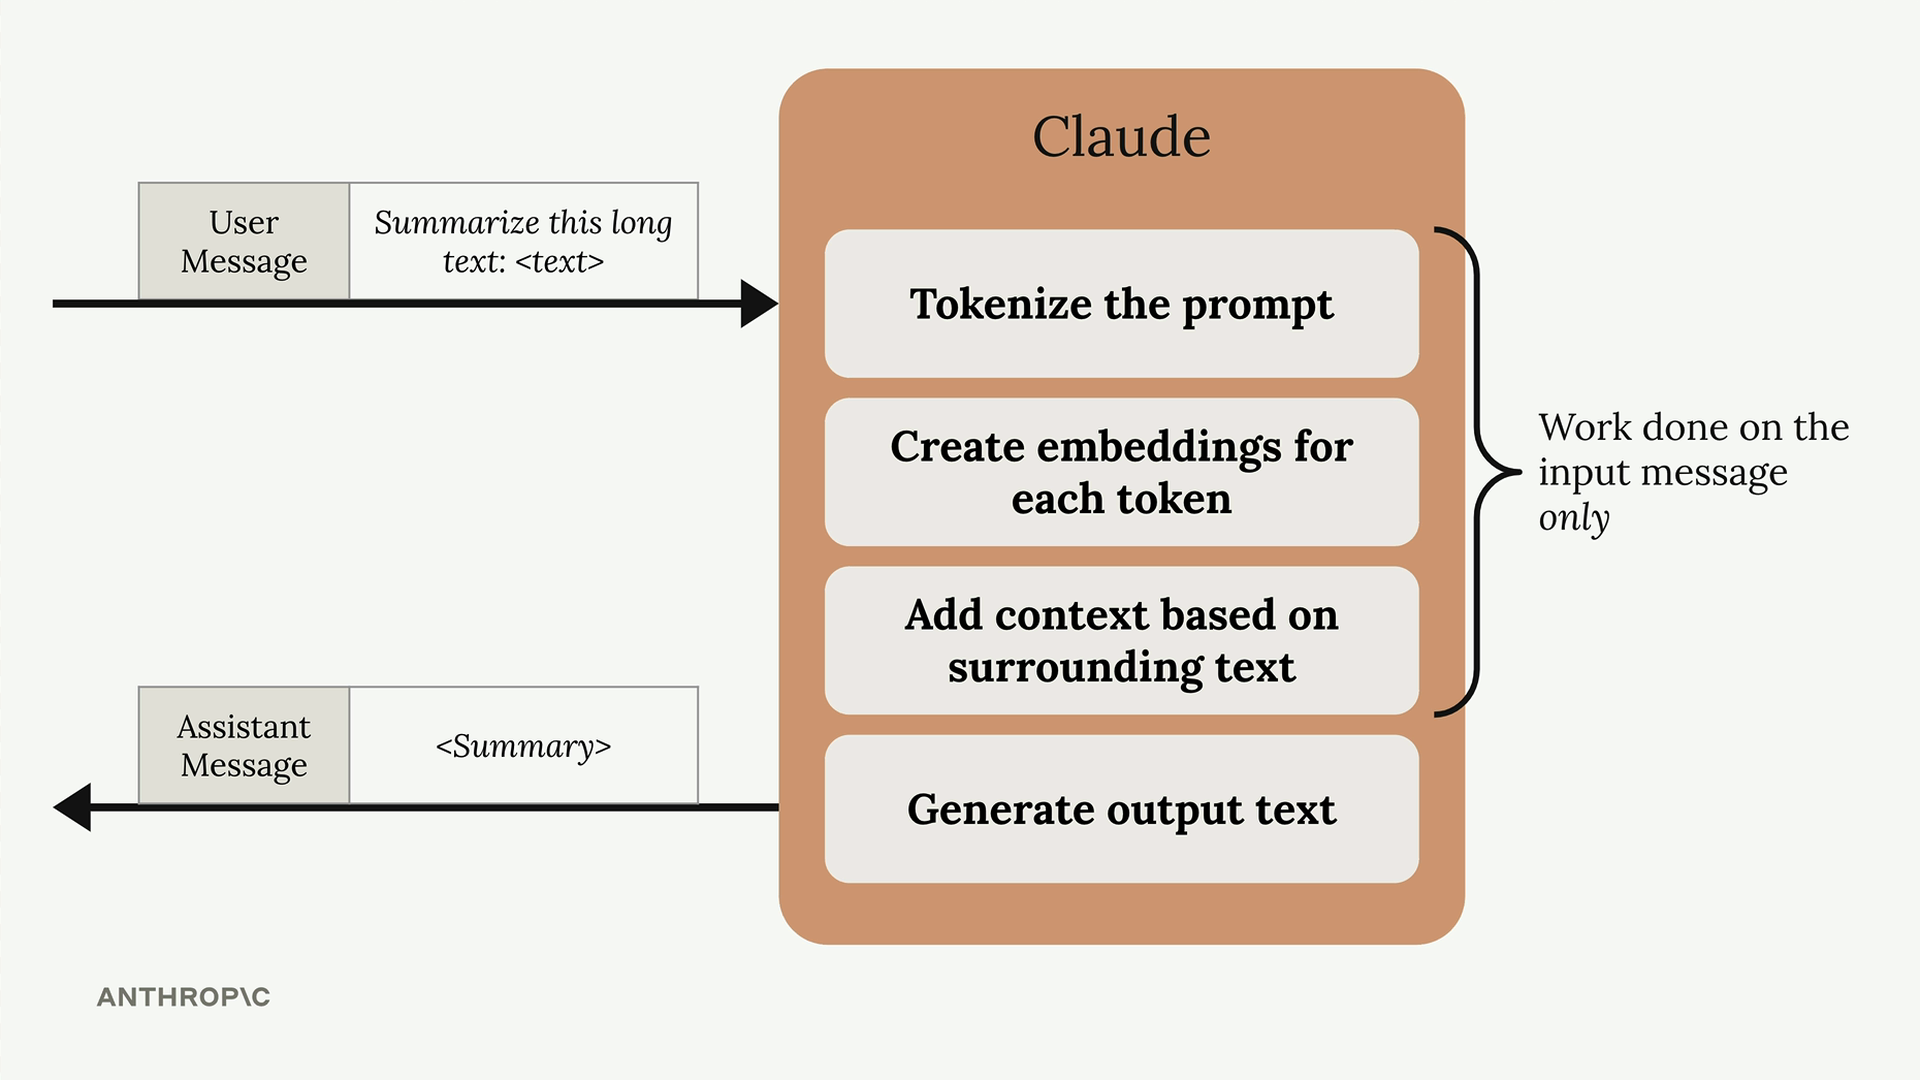
所有这些预处理工作都发生在Claude生成任何实际响应之前。一旦Claude完成对您请求的处理并发回响应,它就会丢弃刚才完成的所有计算工作。
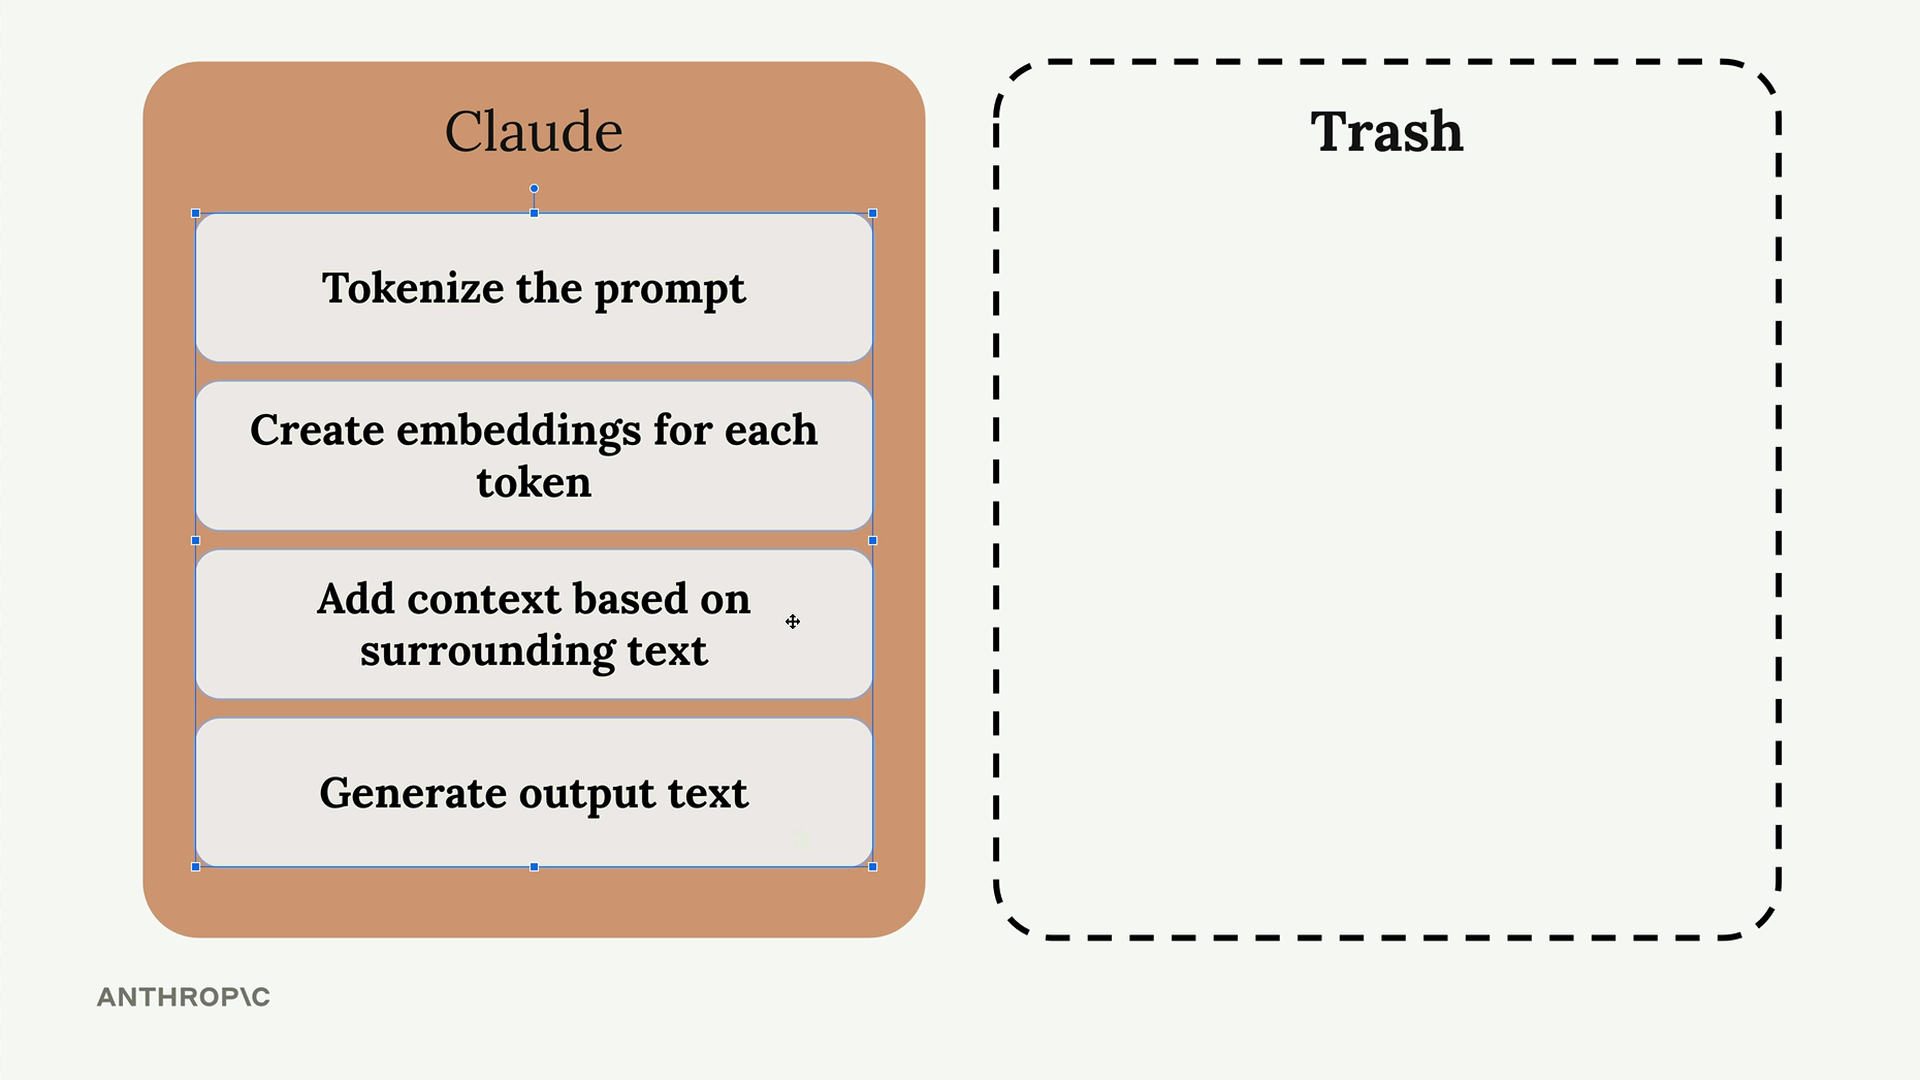
丢弃工作带来的问题
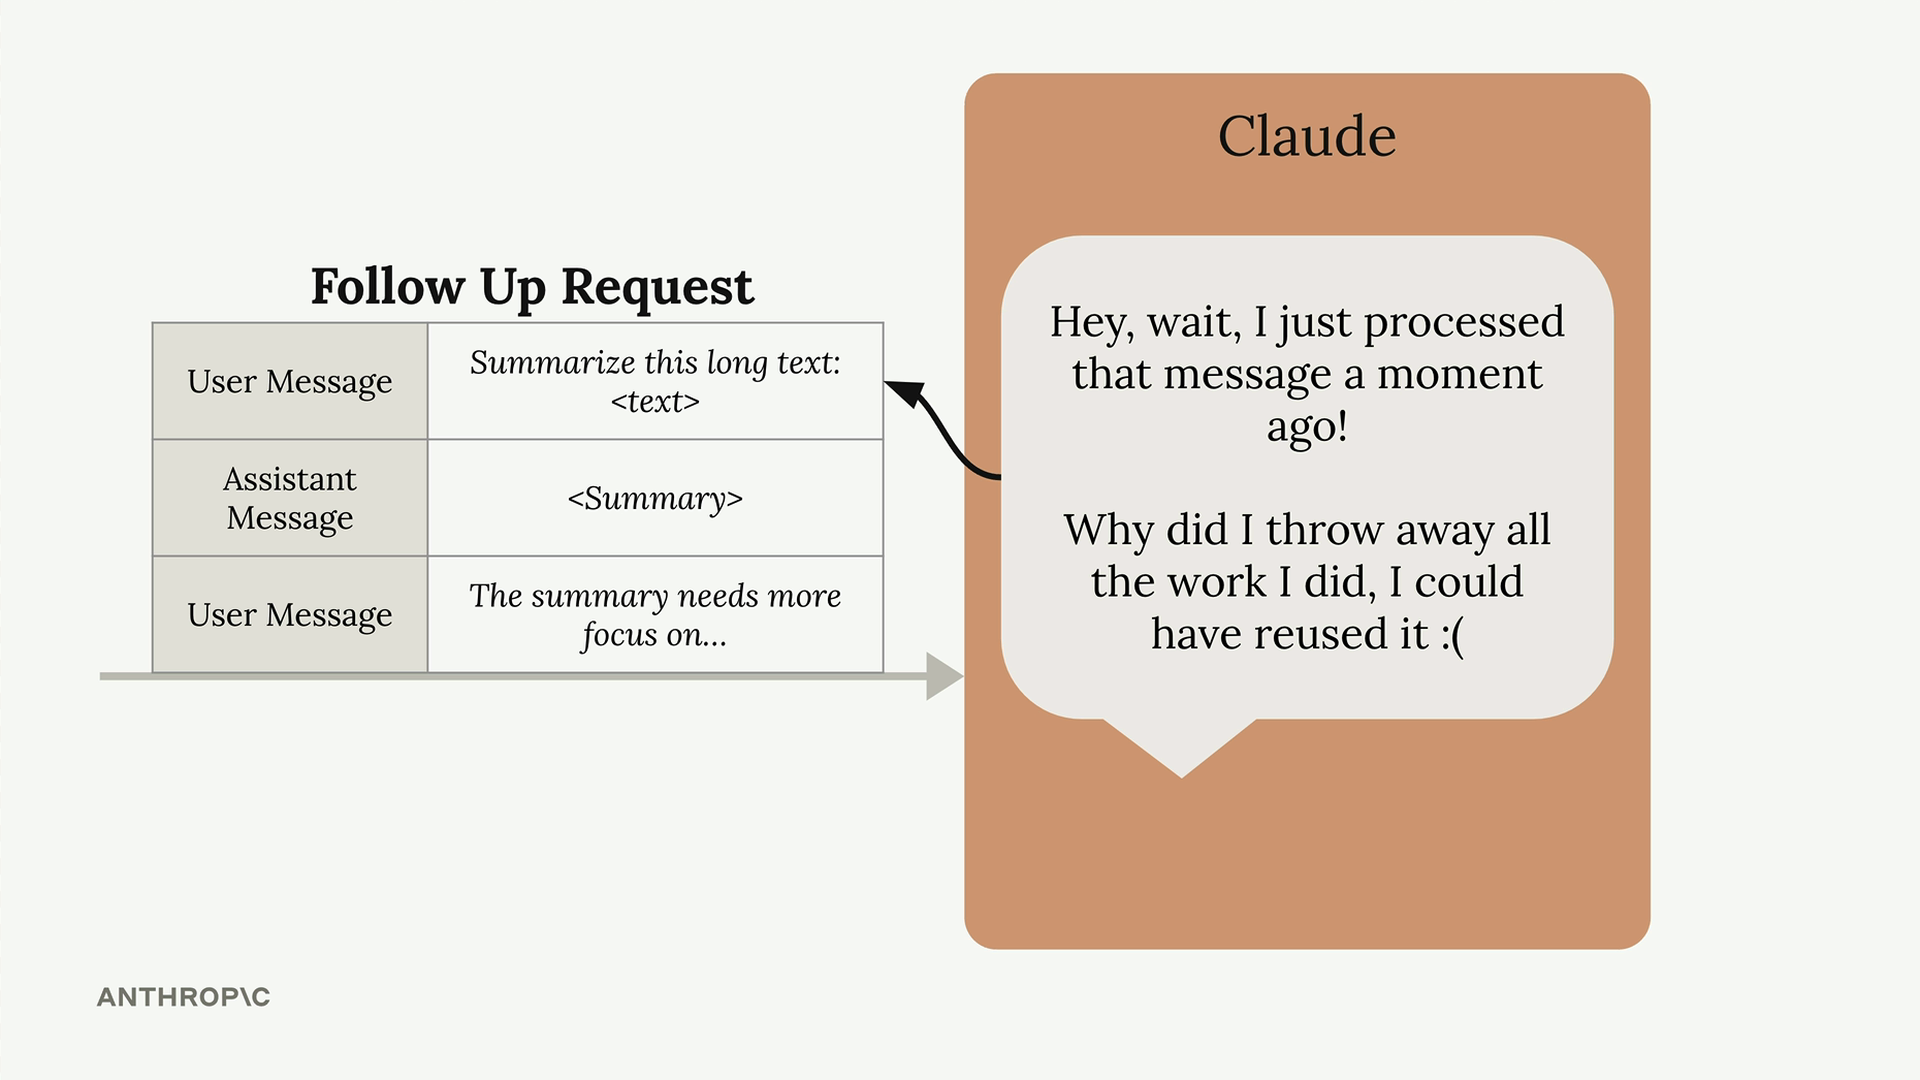
当您与Claude进行对话时,这会造成一种低效情况。假设您发出一个后续请求,其中包含之前的同一条消息,加上Claude之前的回复,再加上一条用于继续对话的新消息。
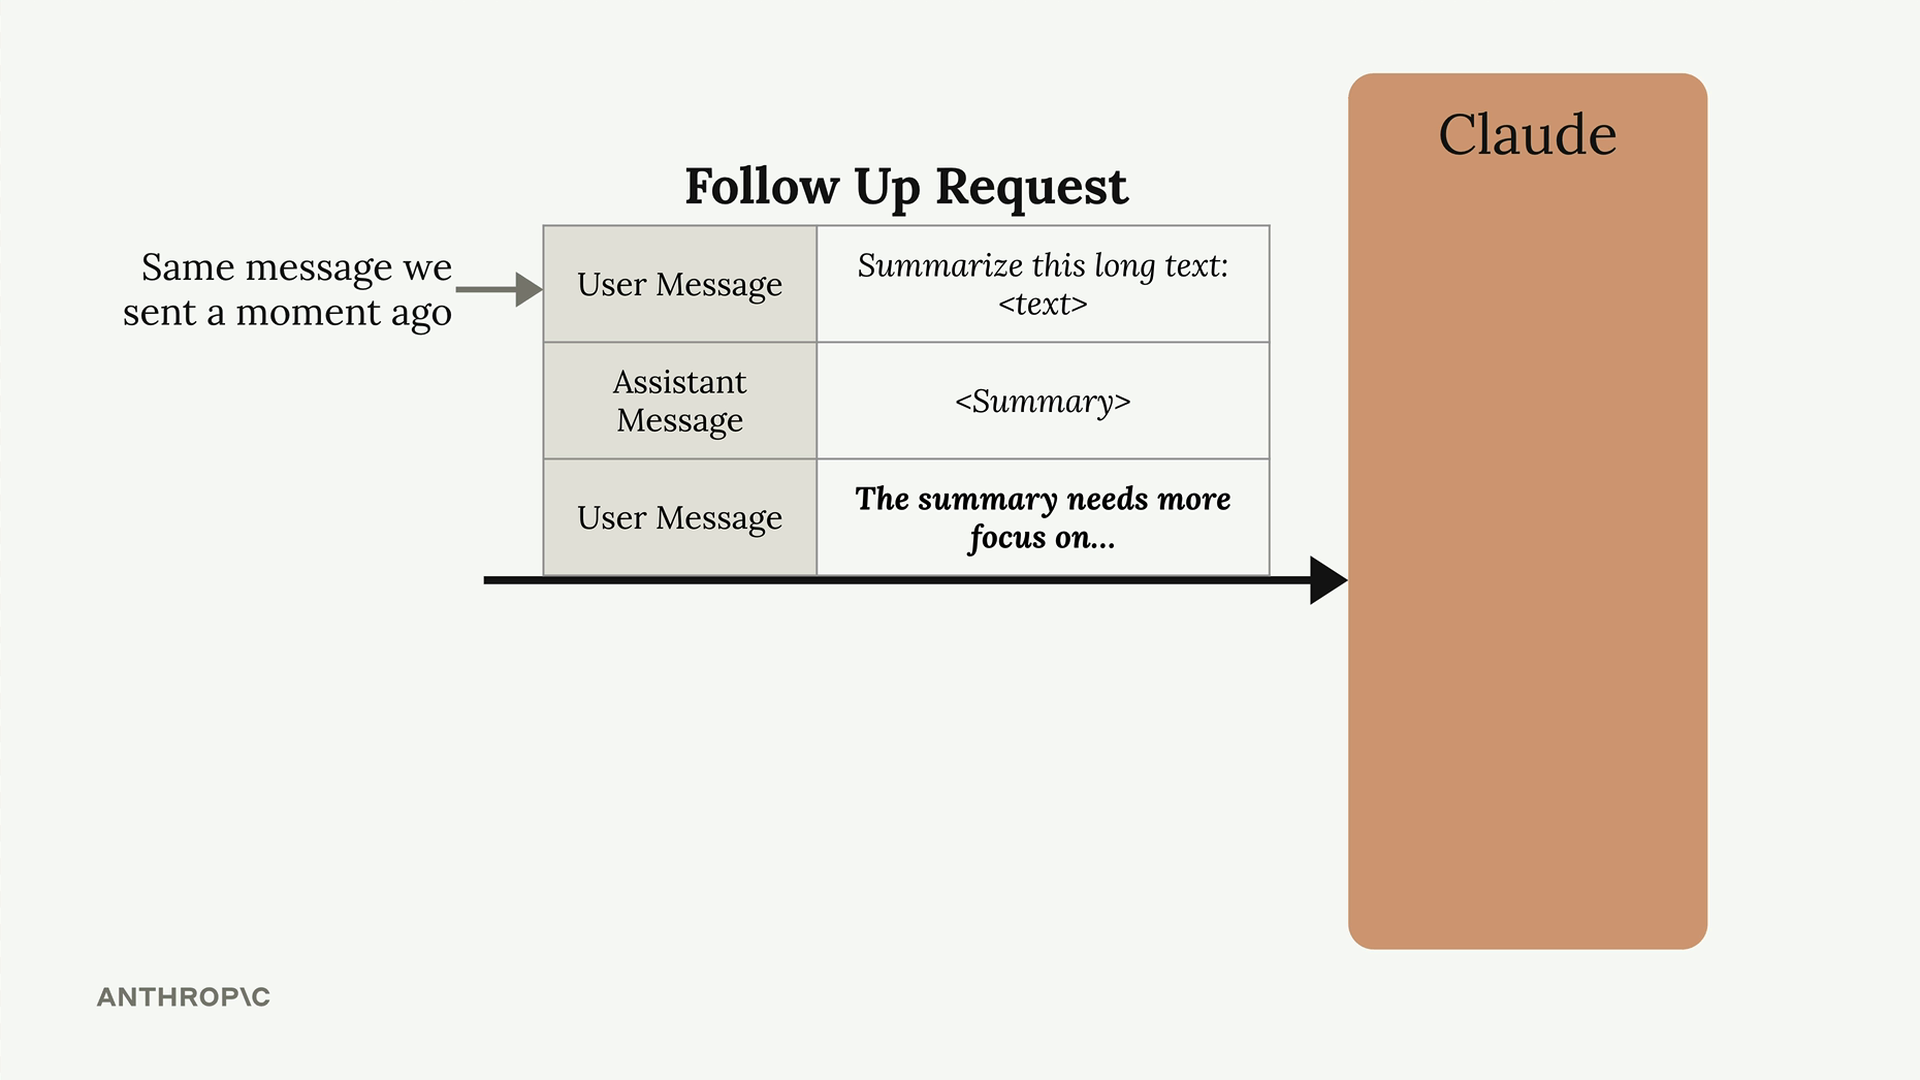
当Claude再次看到原始消息时,它必须重新完成刚才被丢弃的所有相同计算工作。Claude的处理逻辑本质上是这样的:"我刚刚处理过这条完全相同的消息并完成了所有这些工作,然后把它丢弃了。现在我必须重新再做一遍。"
提示缓存如何解决这个问题
提示缓存通过保存计算工作而不是丢弃它,来解决这种低效问题。其工作原理如下:
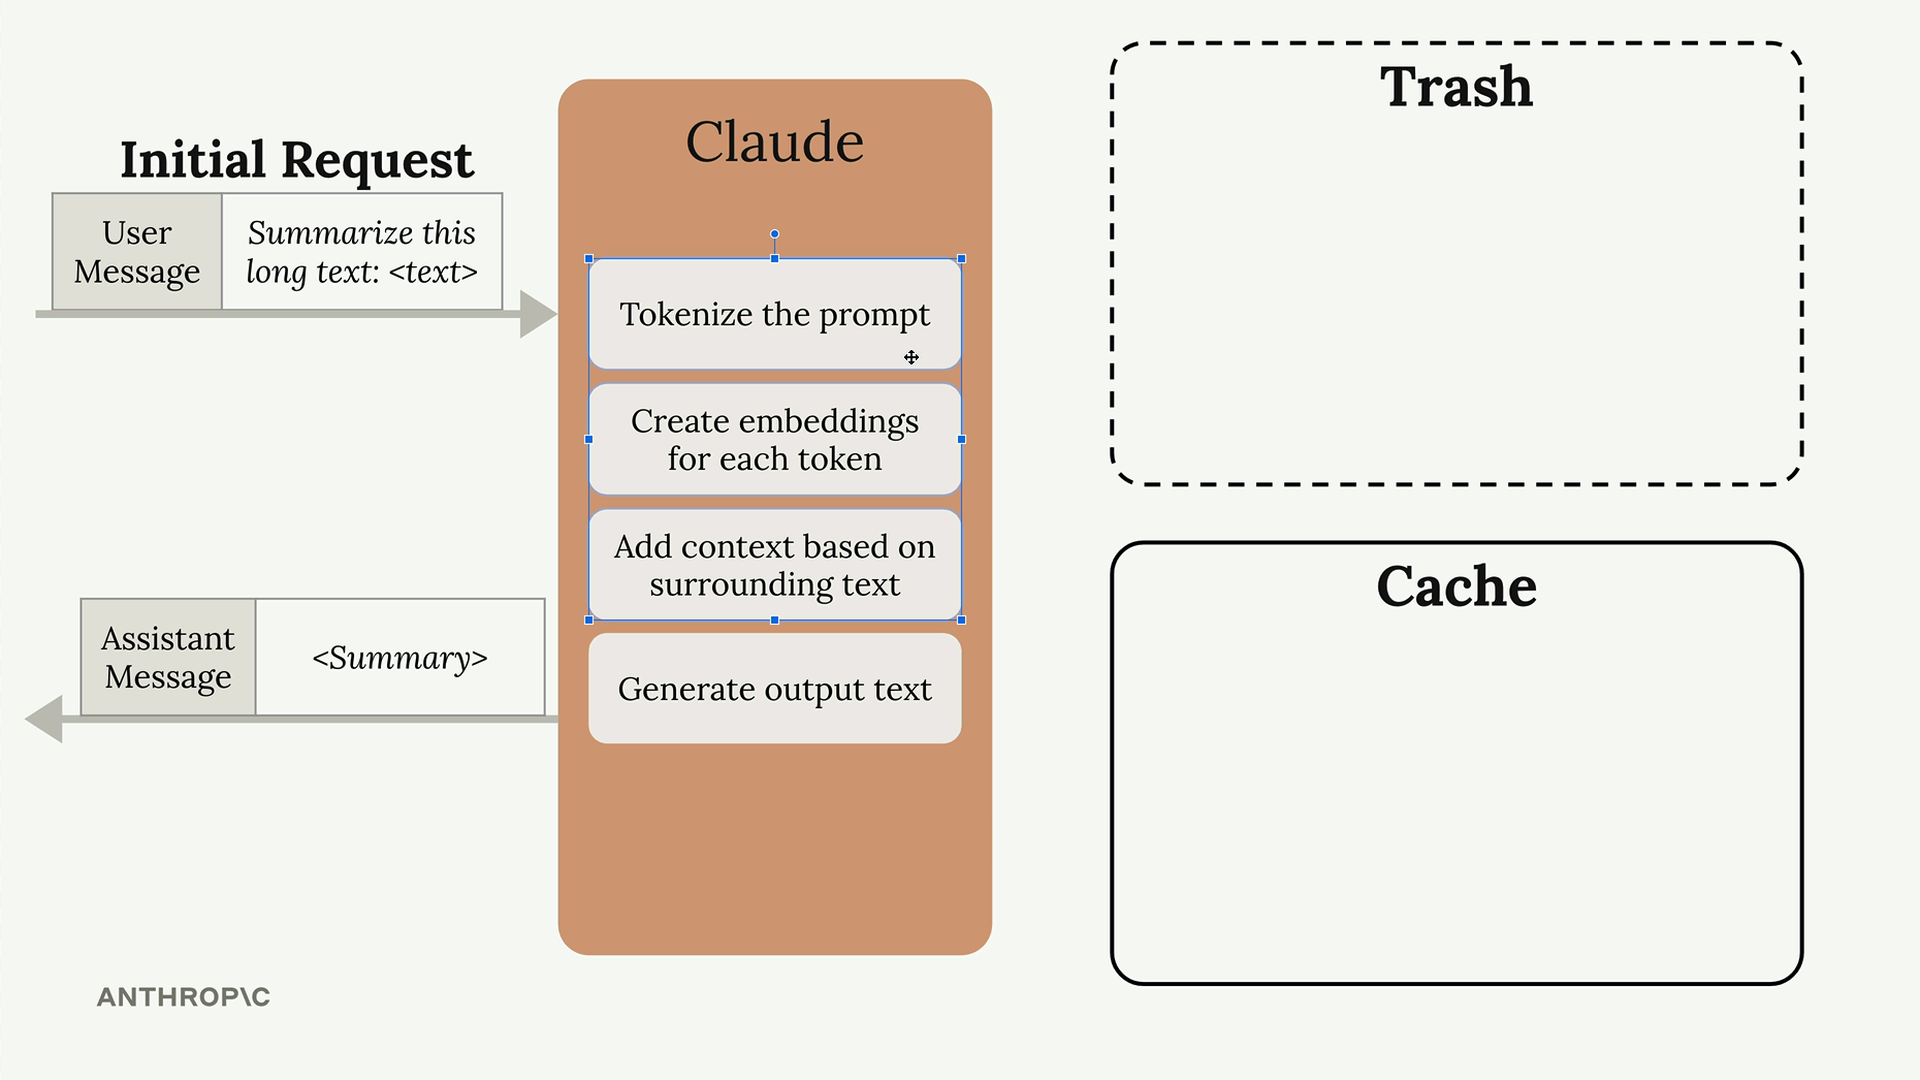
当Claude处理您的初始请求时,它不会丢弃所有的预处理工作,而是将这些工作存储在缓存中。该缓存的作用类似于一个查找表,将特定的输入消息映射到其对应的计算结果。
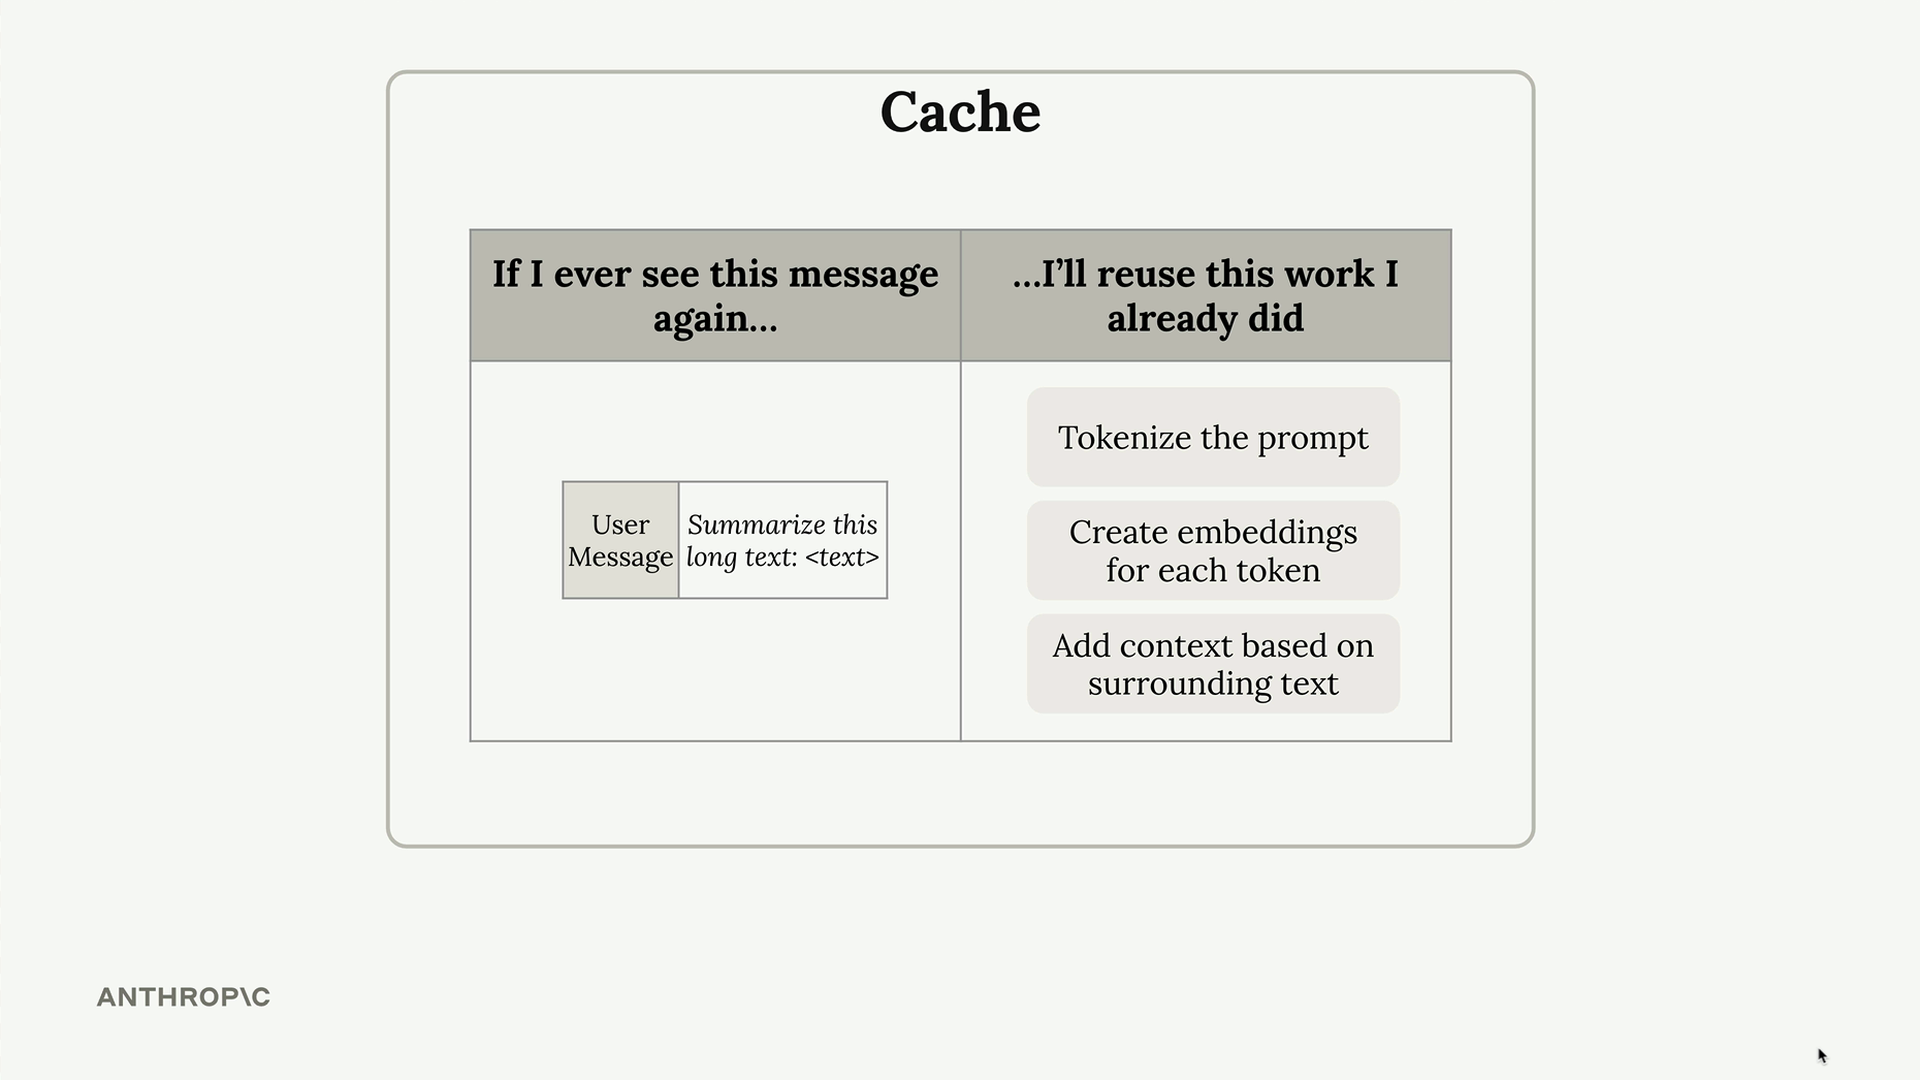
当您发出包含相同内容的后续请求时,Claude可以检查其缓存,并复用之前的工作,而不是从头开始。
主要优势与限制
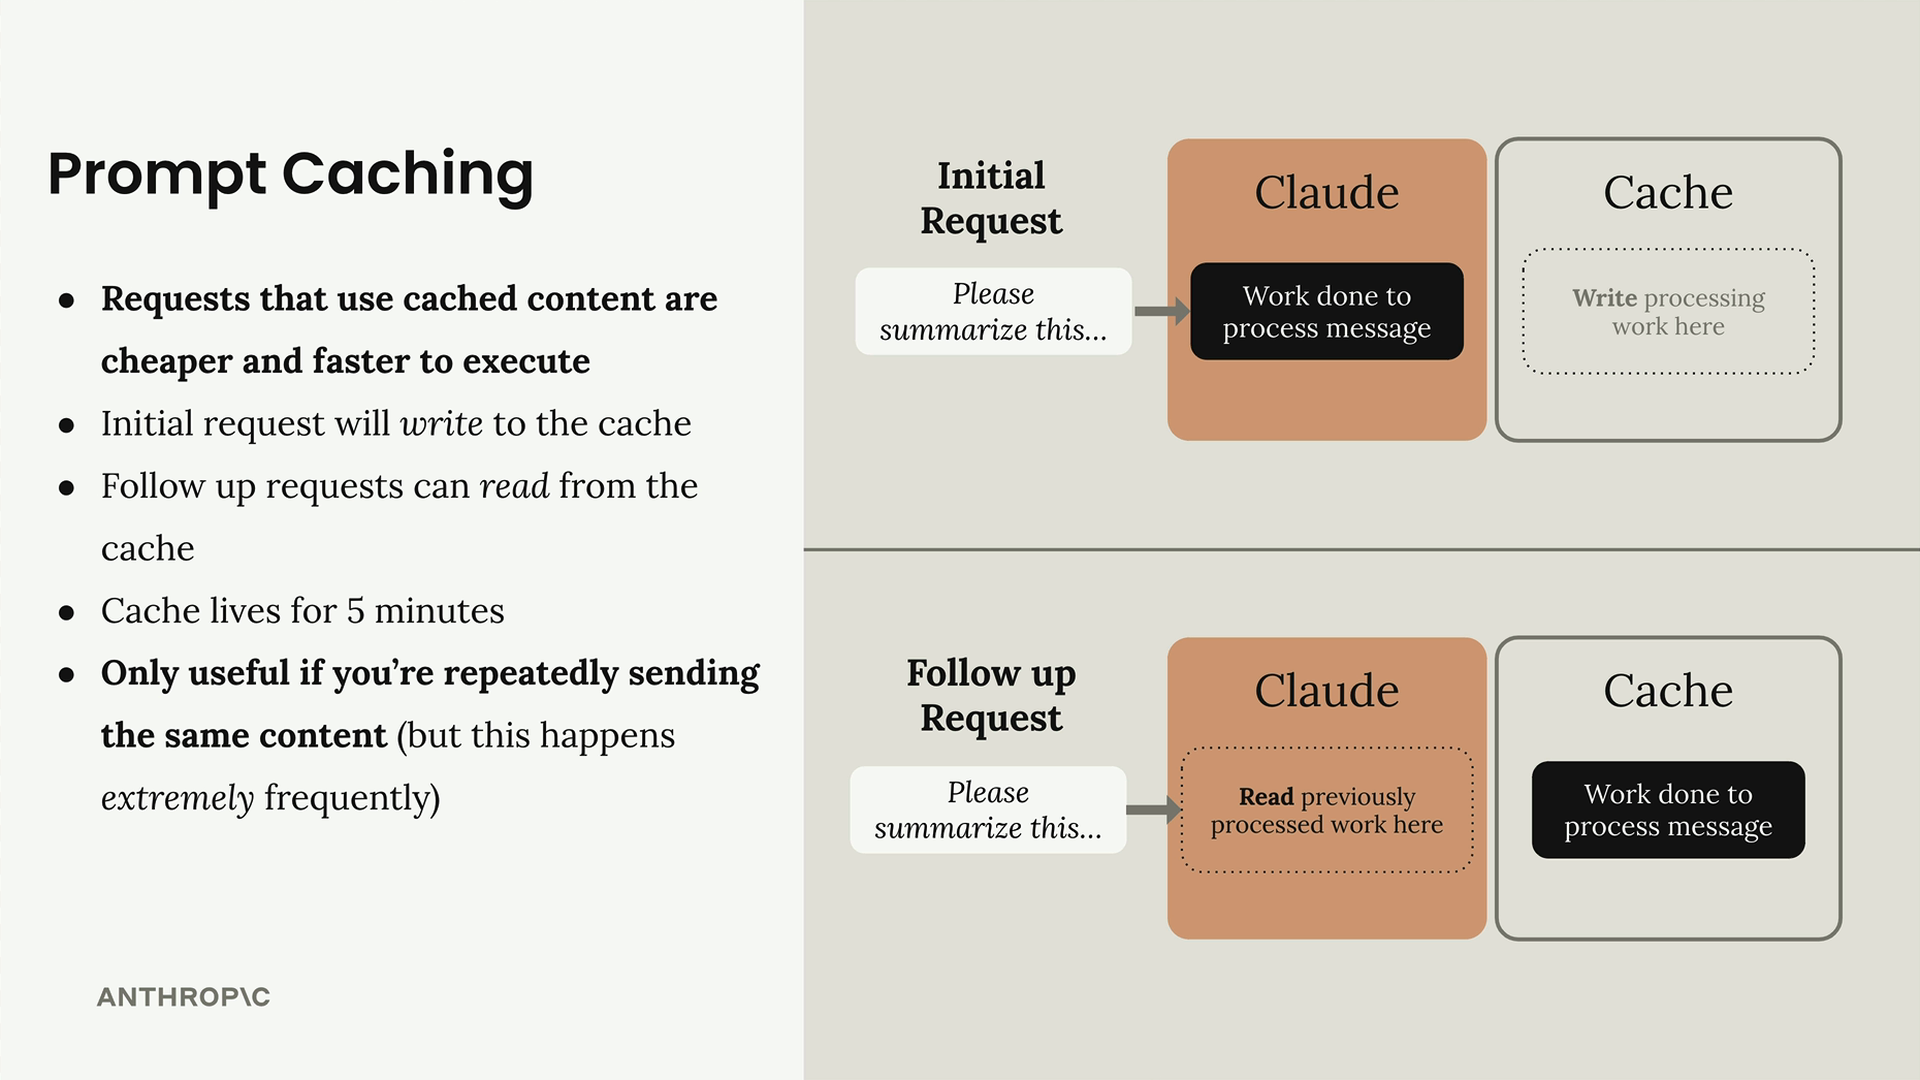
提示缓存具有以下几个优势:
- 使用缓存内容的请求执行起来更便宜、更快
- 初始请求会写入缓存
- 后续请求可以从缓存中读取
- 缓存的有效期为5分钟
- 仅在您反复发送相同内容时才有用(但这种情况其实非常常见)
缓存的生命周期为5分钟,因此它对于在短时间内多次发送具有重叠内容的请求的对话或工作流最为有利。这种模式在实际应用中其实非常普遍——想想聊天机器人、文档分析工具,或任何维护对话上下文的系统。
提示缓存之所以特别有价值,是因为许多AI应用确实会反复发送相同的内容。无论是系统提示、对话历史,还是正在分析的大型文档,相同的文本往往会在一个会话中的多个请求中反复出现。