Le découpage de texte (chunking) est l'une des étapes les plus critiques dans la construction d'un pipeline RAG (Retrieval Augmented Generation). La manière dont vous divisez vos documents a un impact direct sur la qualité de l'ensemble de votre système. Une stratégie de découpage médiocre peut conduire à l'insertion d'un contexte non pertinent dans vos requêtes, amenant votre IA à donner des réponses complètement erronées.
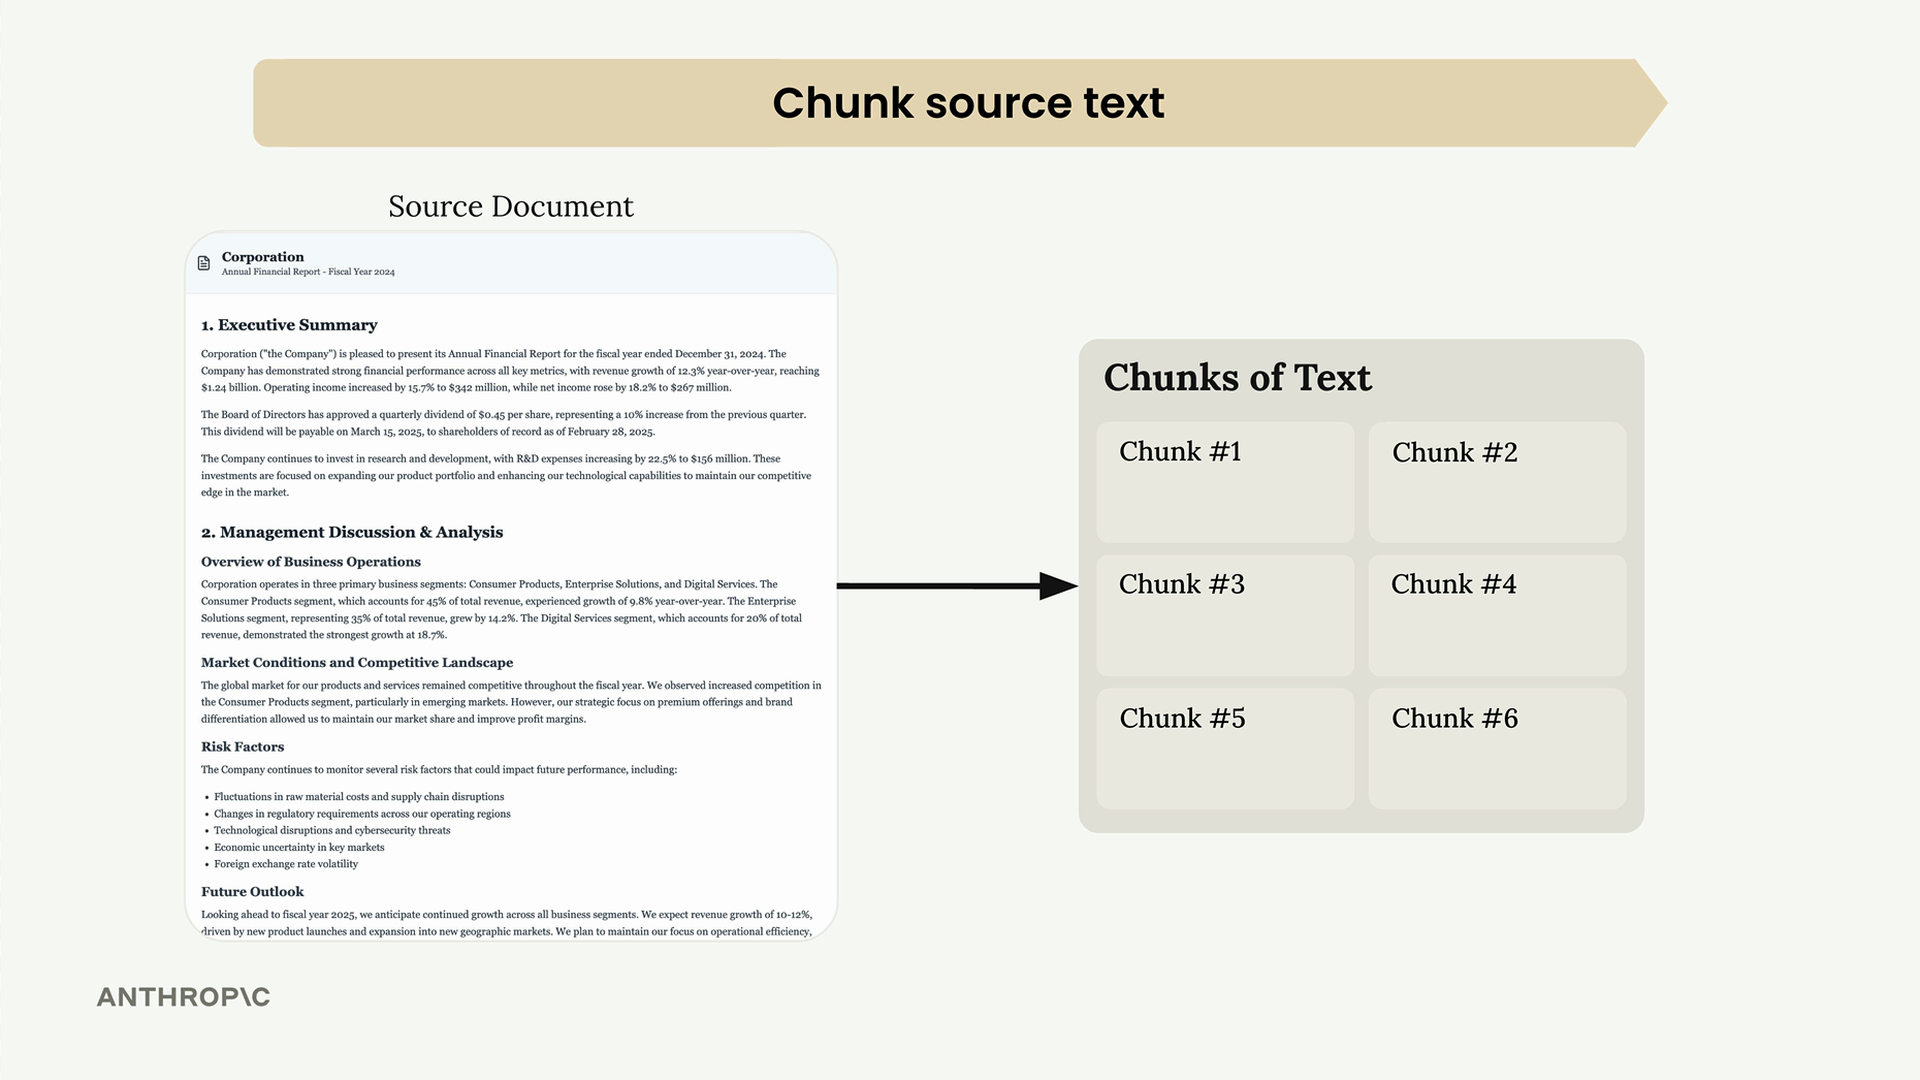
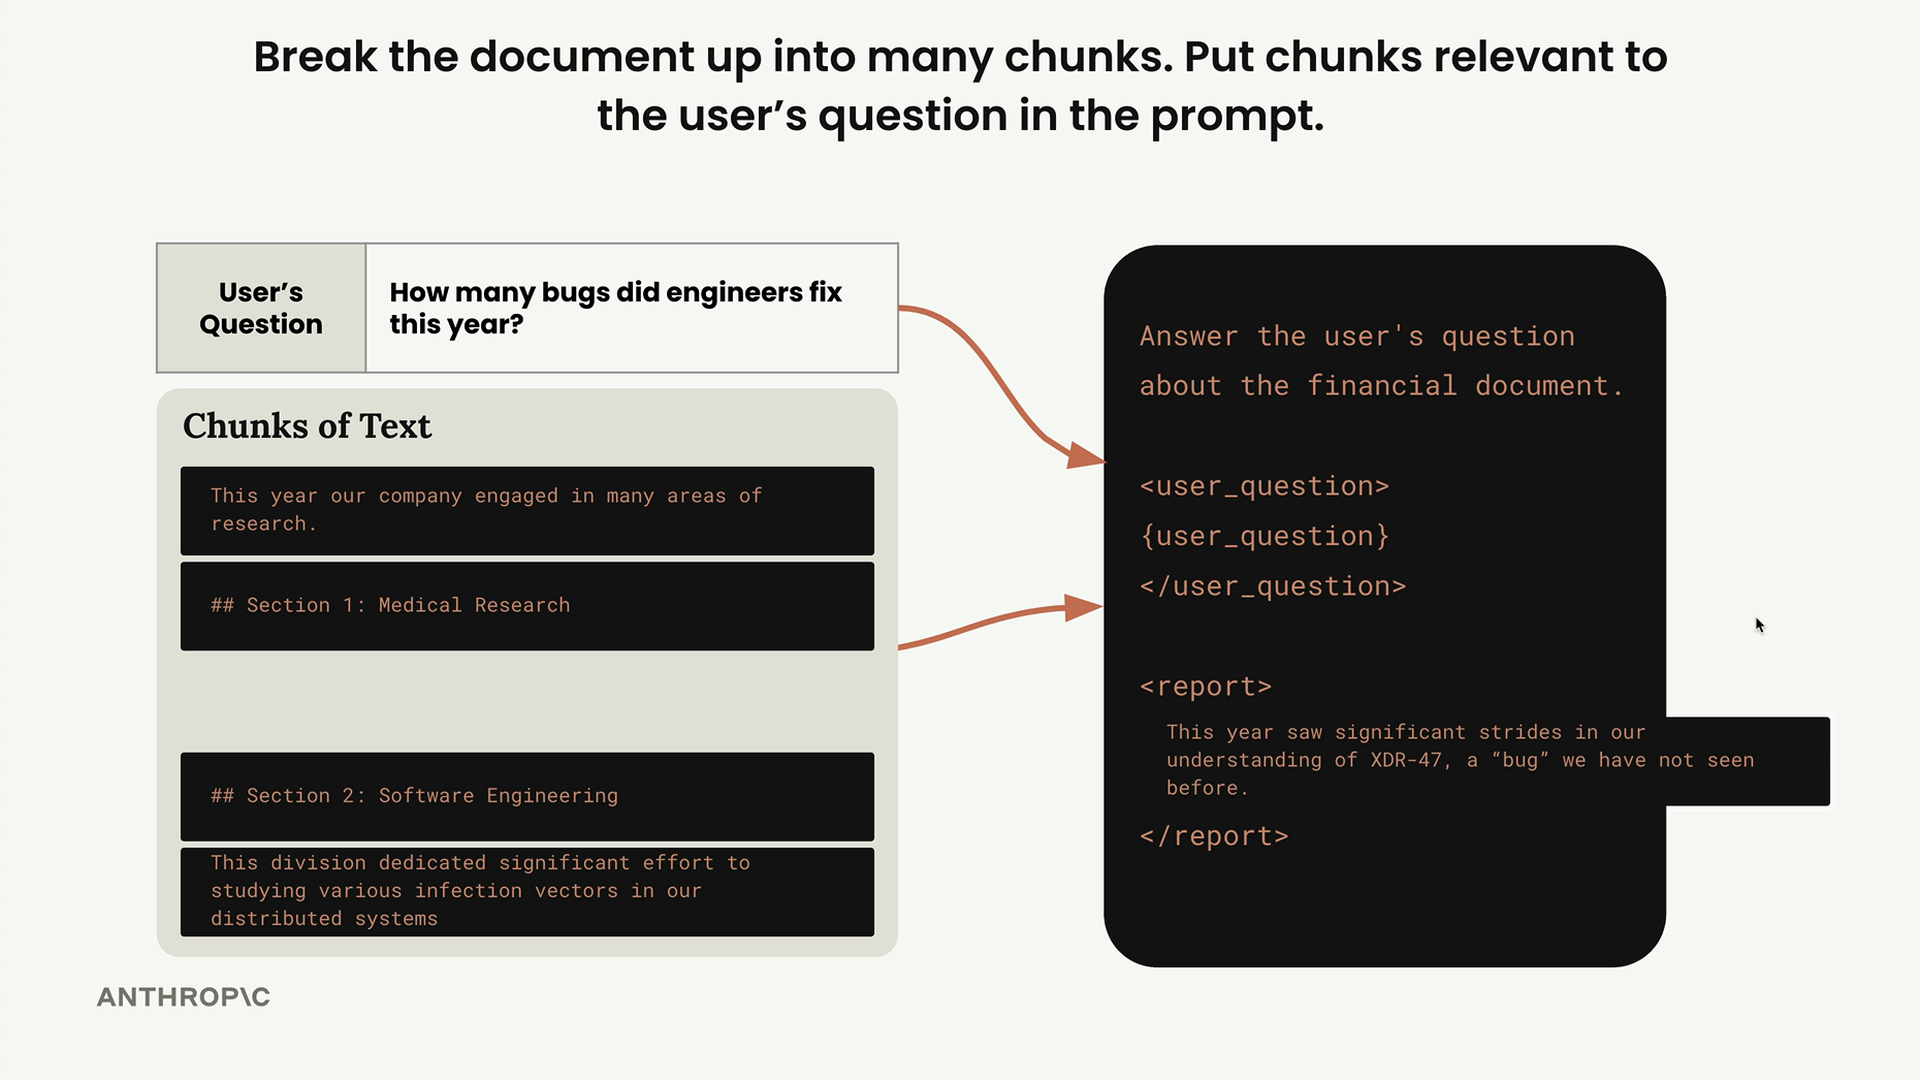
Prenons cet exemple : vous disposez d'un document comportant des sections sur la recherche médicale et l'ingénierie logicielle. Si vous découpez mal le texte, un utilisateur demandant « Combien de bugs les ingénieurs ont-ils corrigés cette année ? » pourrait obtenir des informations sur la recherche médicale au lieu de l'ingénierie logicielle, simplement parce que la section médicale contenait par hasard le mot « bug » dans un contexte différent.
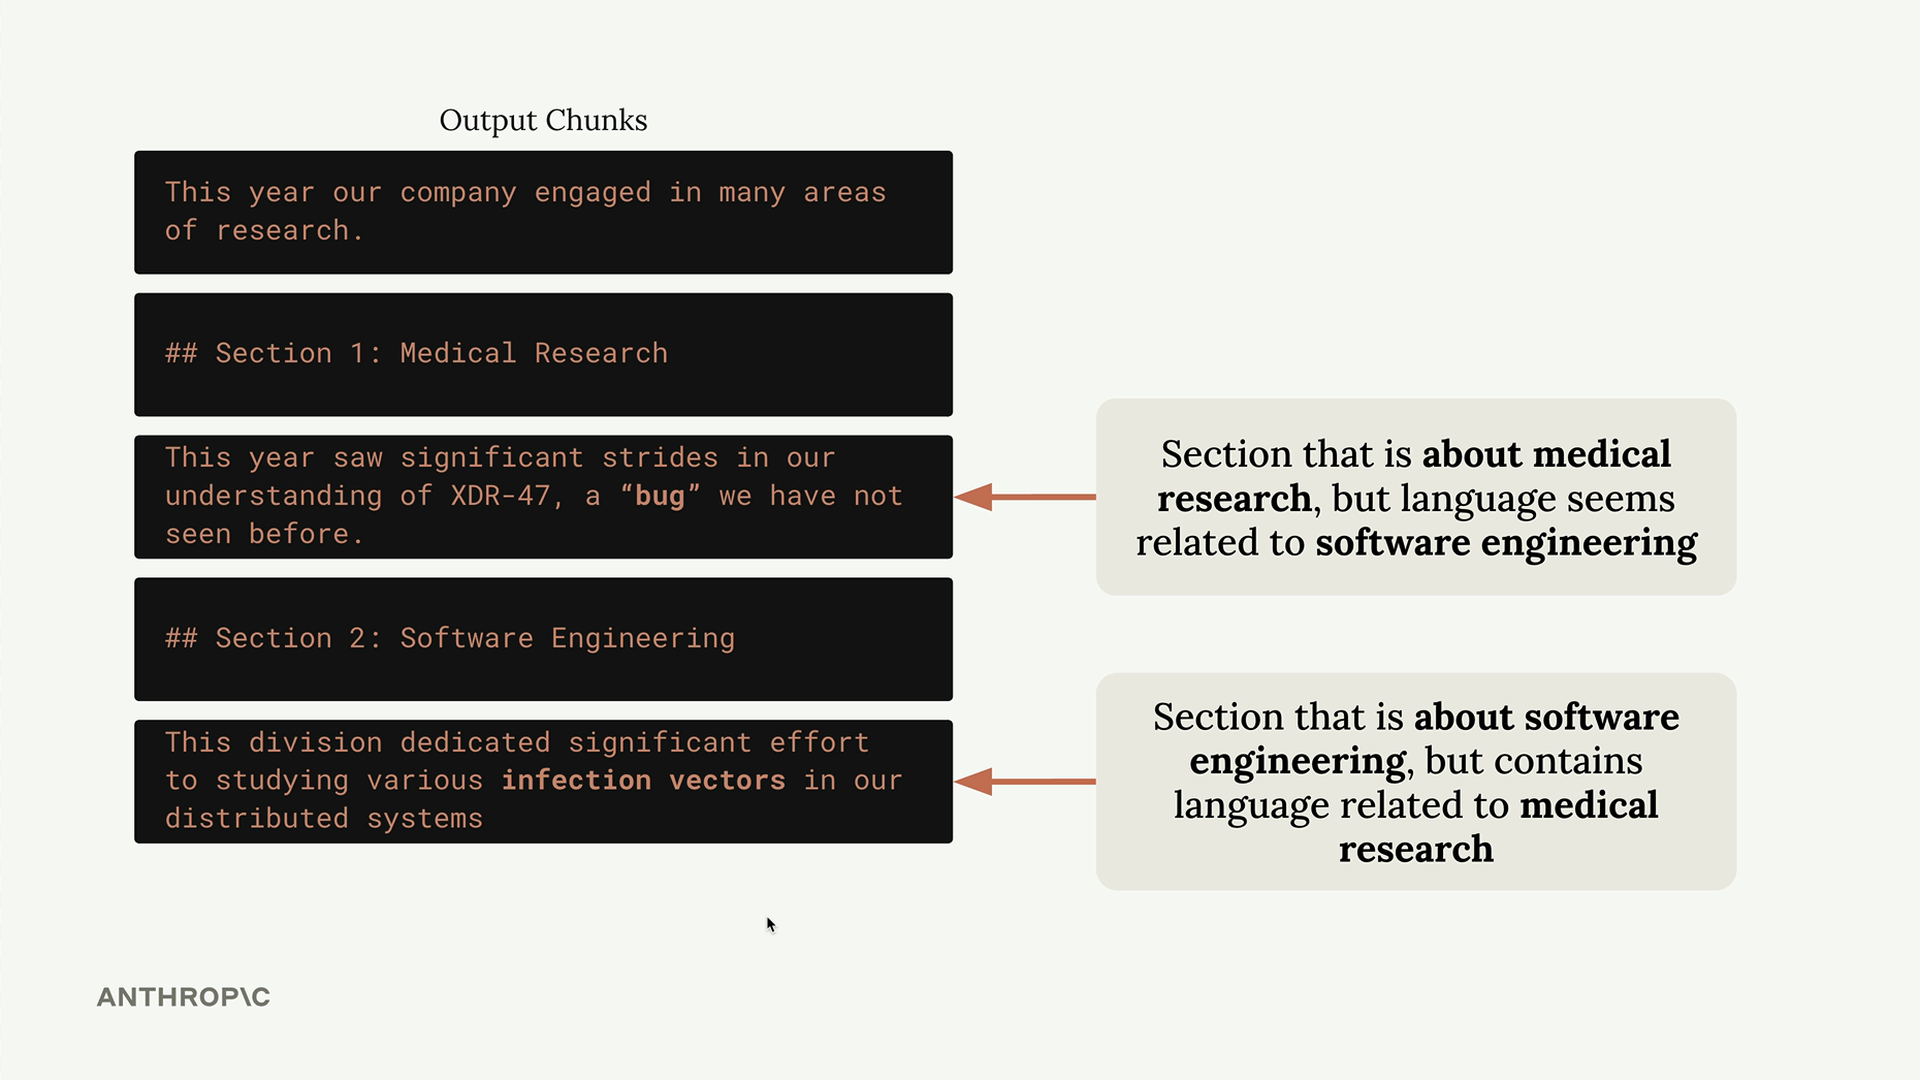
Cela démontre l'importance de la stratégie de découpage. L'objectif est de créer des chunks qui conservent une cohérence sémantique et fournissent un contexte pertinent lorsqu'ils sont récupérés.
Trois principales stratégies de découpage
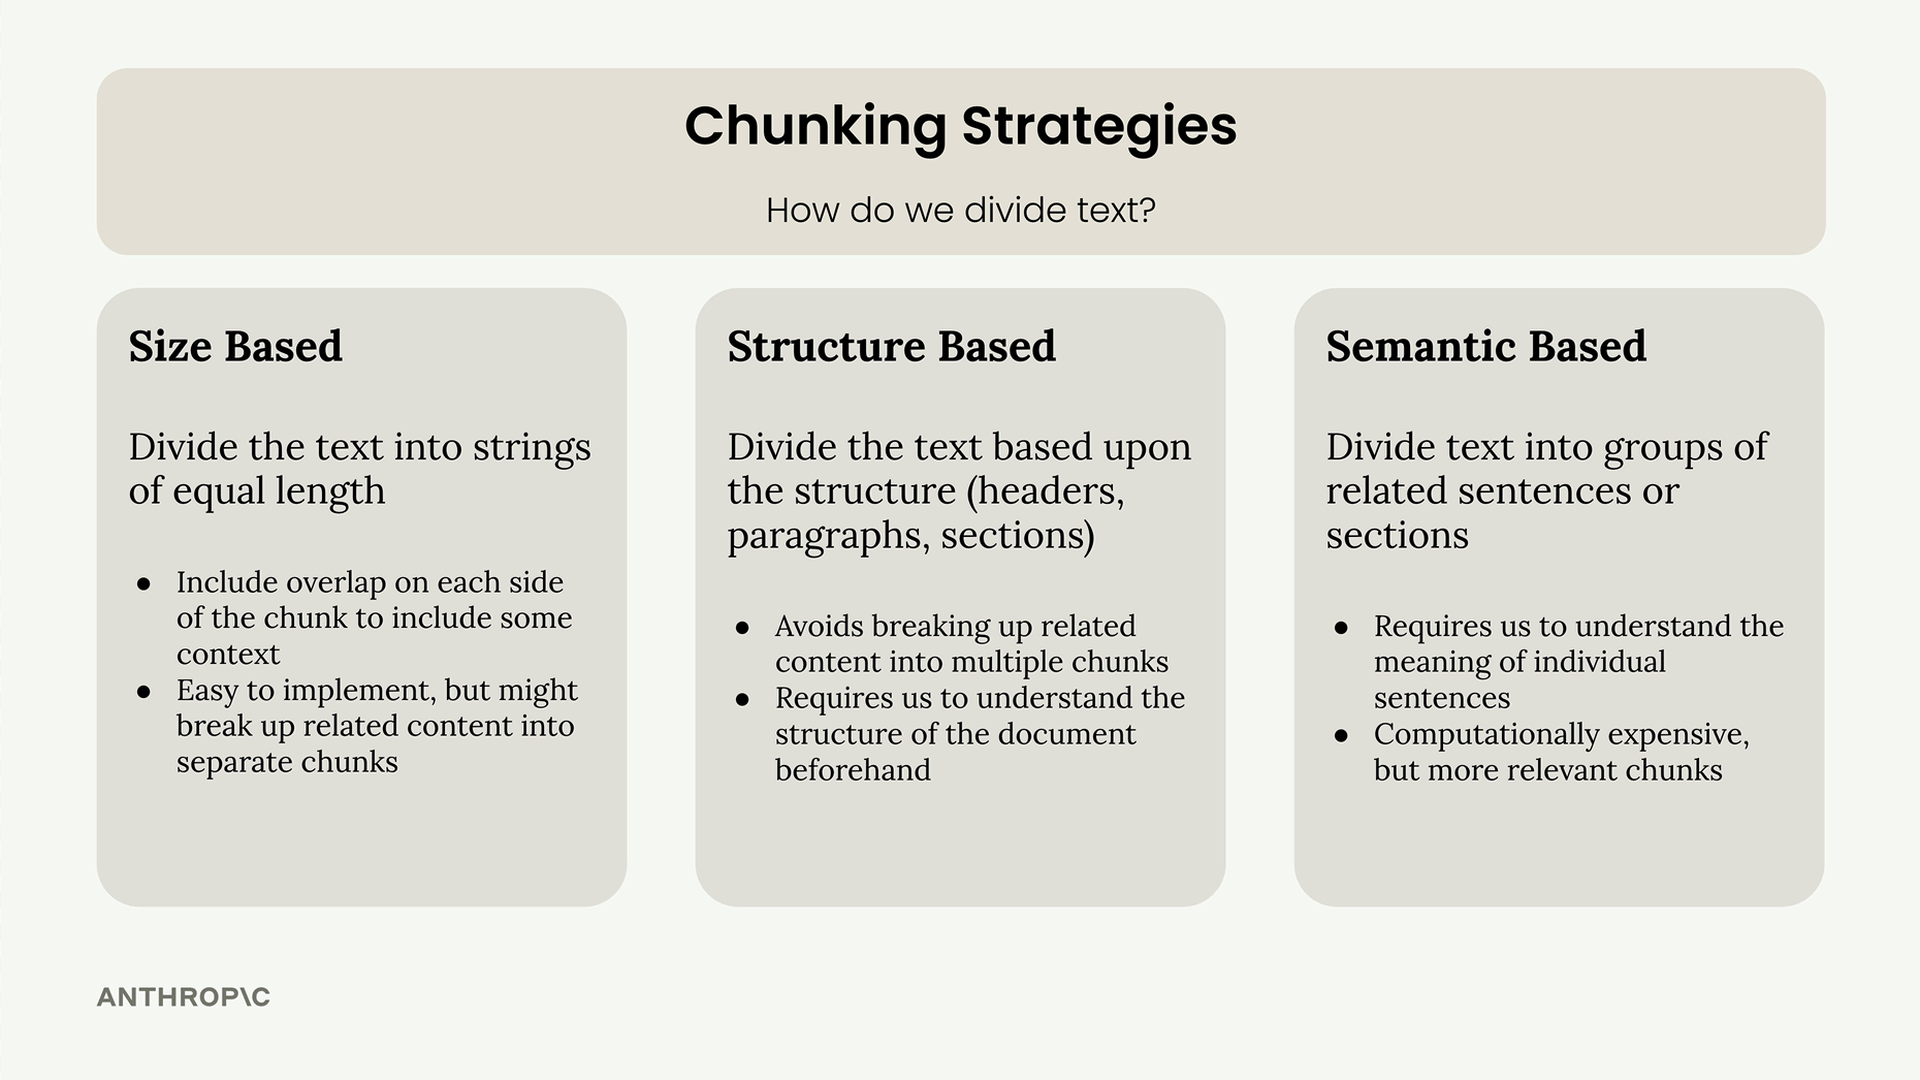
Il existe trois approches principales pour découper du texte, chacune avec des avantages distincts et des compromis :
- Basée sur la taille : Diviser le texte en chaînes de longueur égale
- Basée sur la structure : Diviser en fonction de la structure du document (titres, paragraphes, sections)
- Basée sur la sémantique : Regrouper des phrases ou des sections liées en utilisant des techniques de TAL (traitement automatique du langage)
Découpage basé sur la taille
Le découpage basé sur la taille est l'approche la plus simple. Vous divisez simplement votre document en chunks de nombre de caractères ou de mots approximativement égal. C'est facile à mettre en œuvre et cela fonctionne de manière fiable sur différents types de documents.
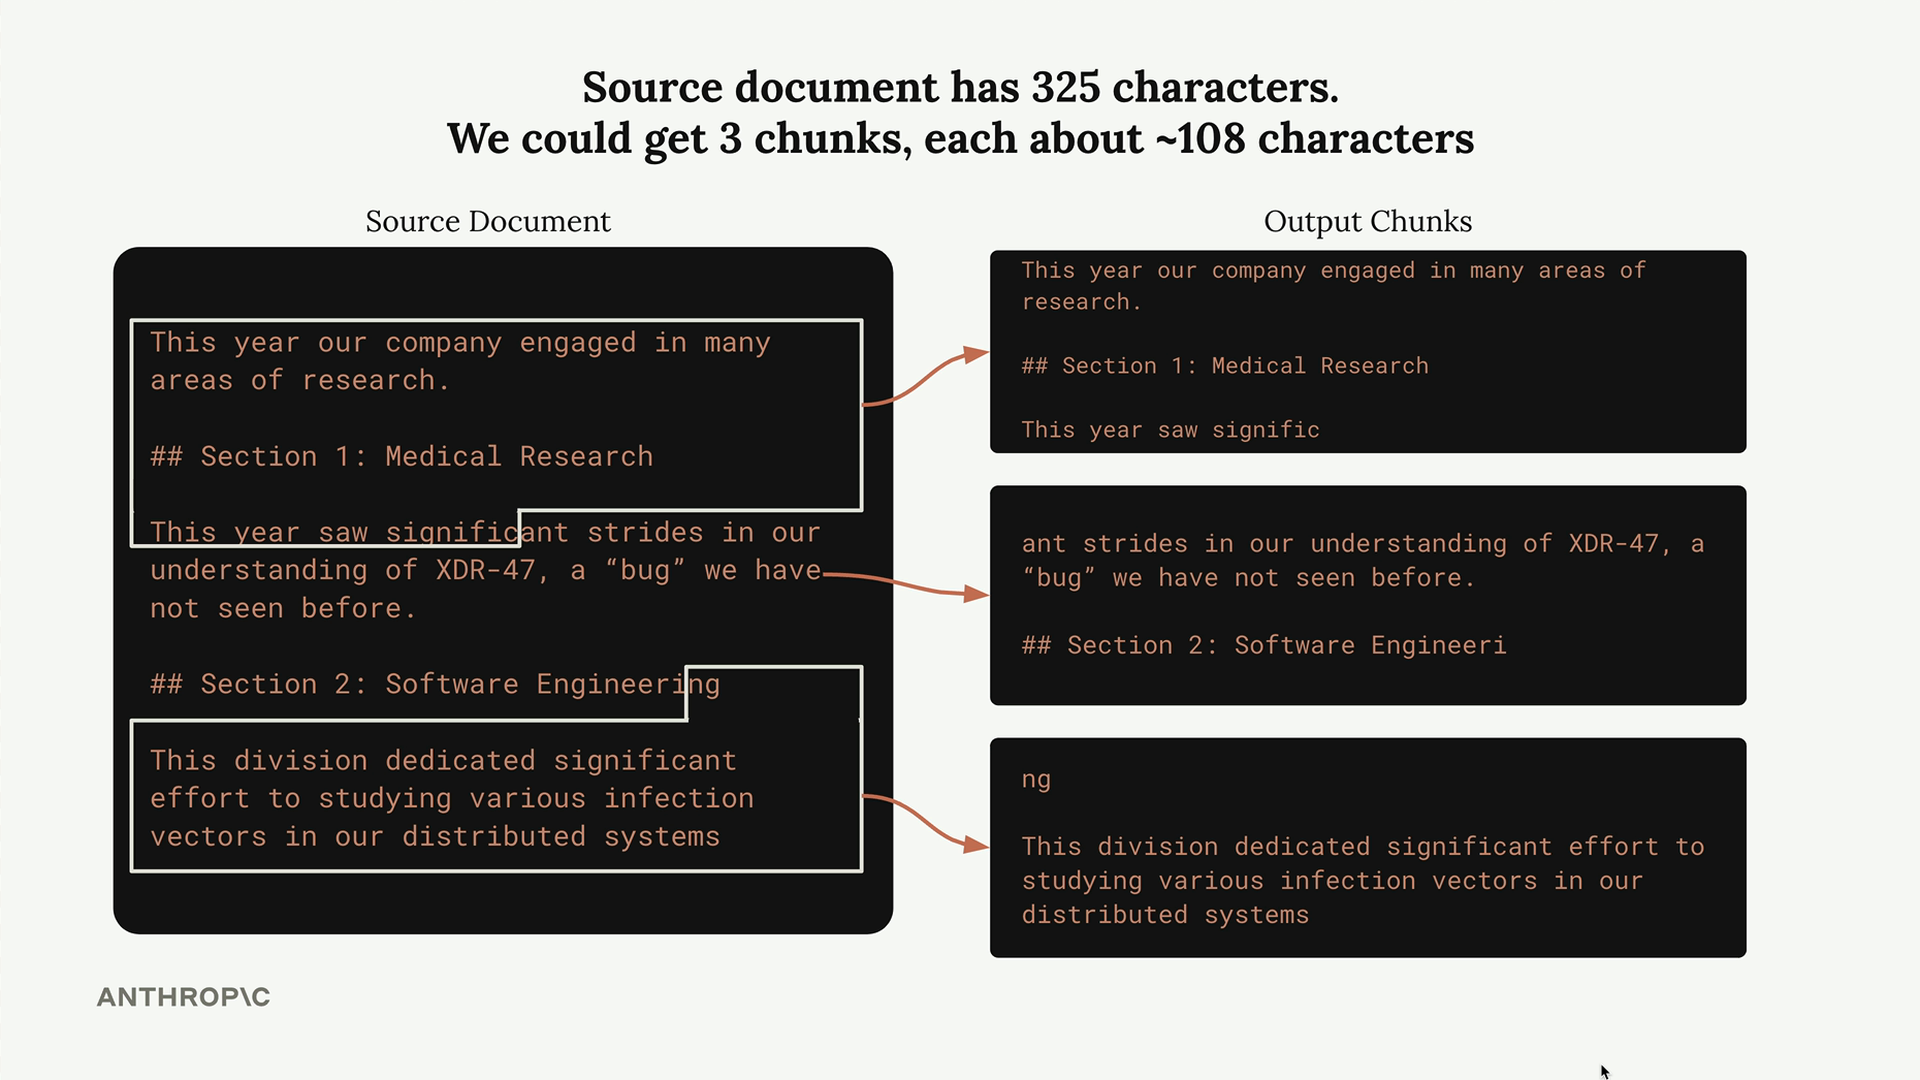
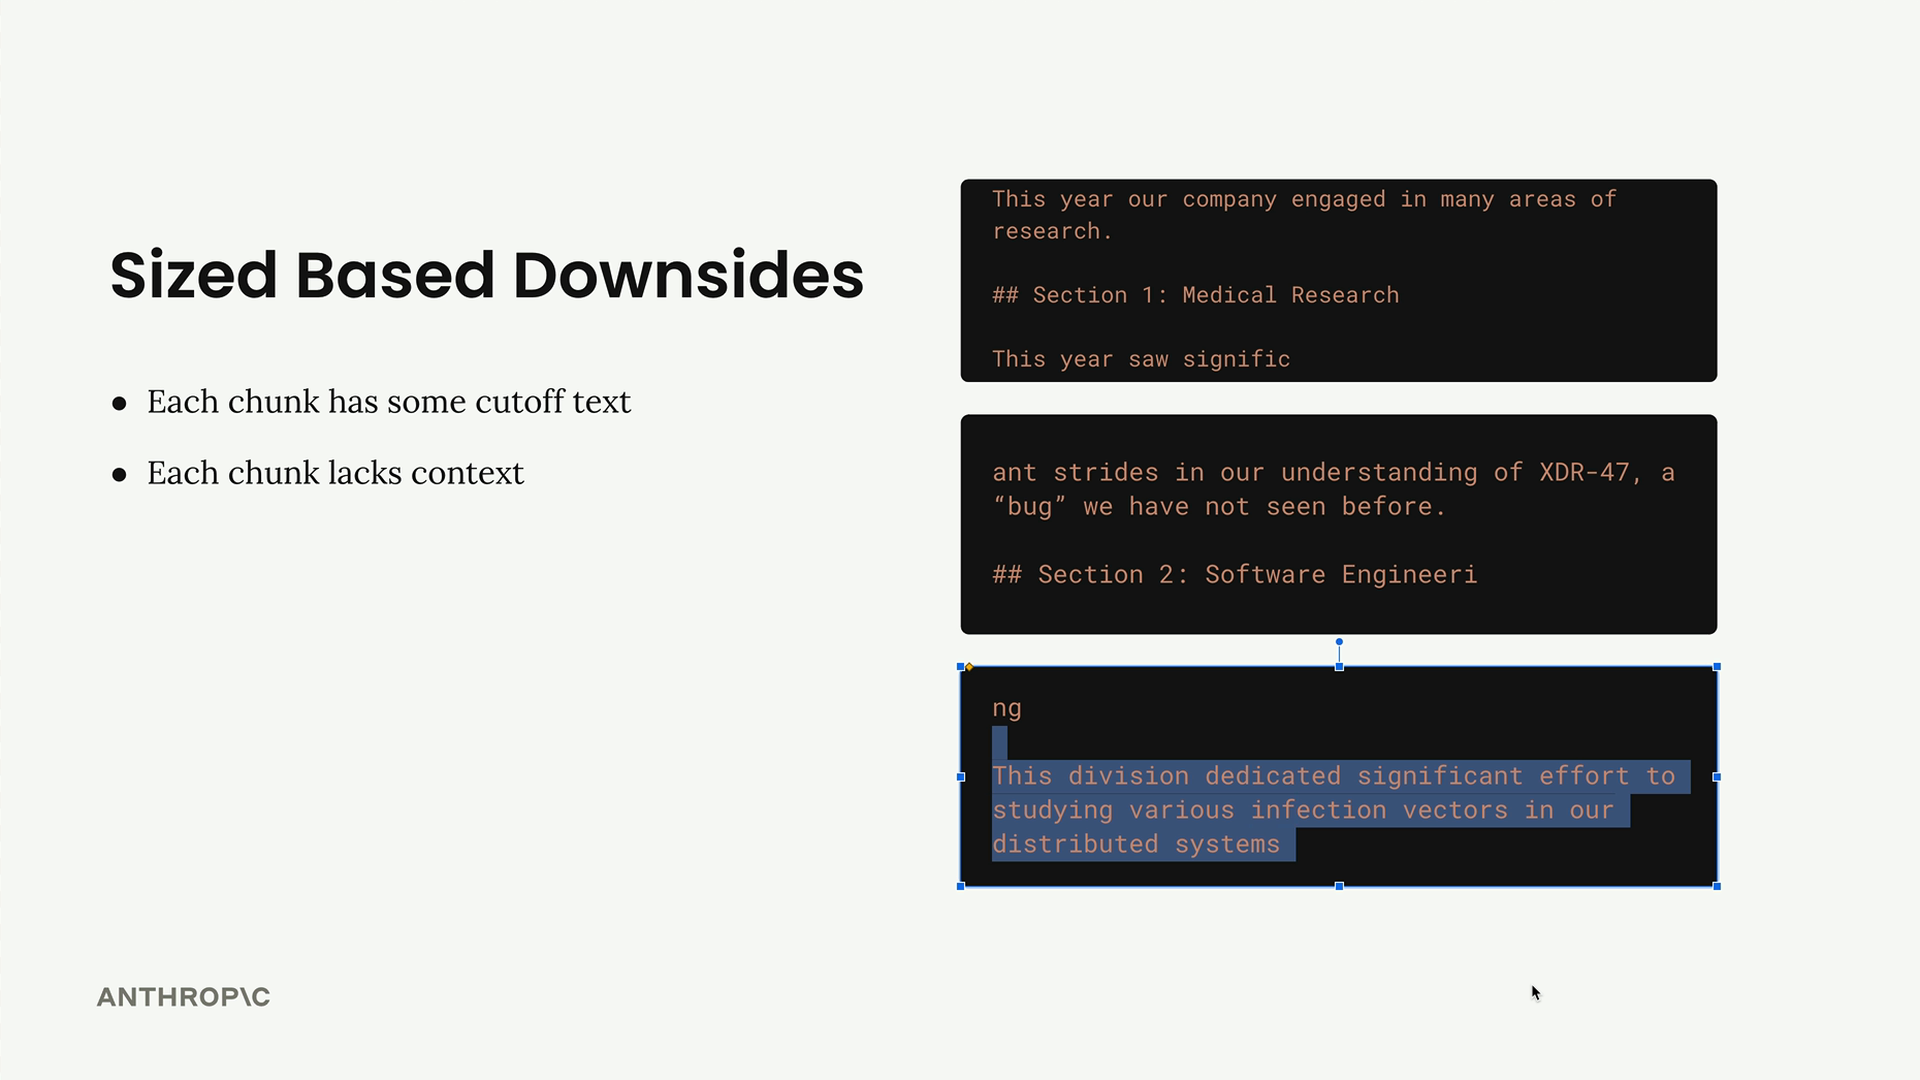
Cependant, cette approche présente des inconvénients évidents. Les mots sont coupés en milieu de phrase, et les chunks perdent un contexte important. Par exemple, un chunk pourrait ne pas inclure le titre de section qui expliquerait le sujet réel du contenu.
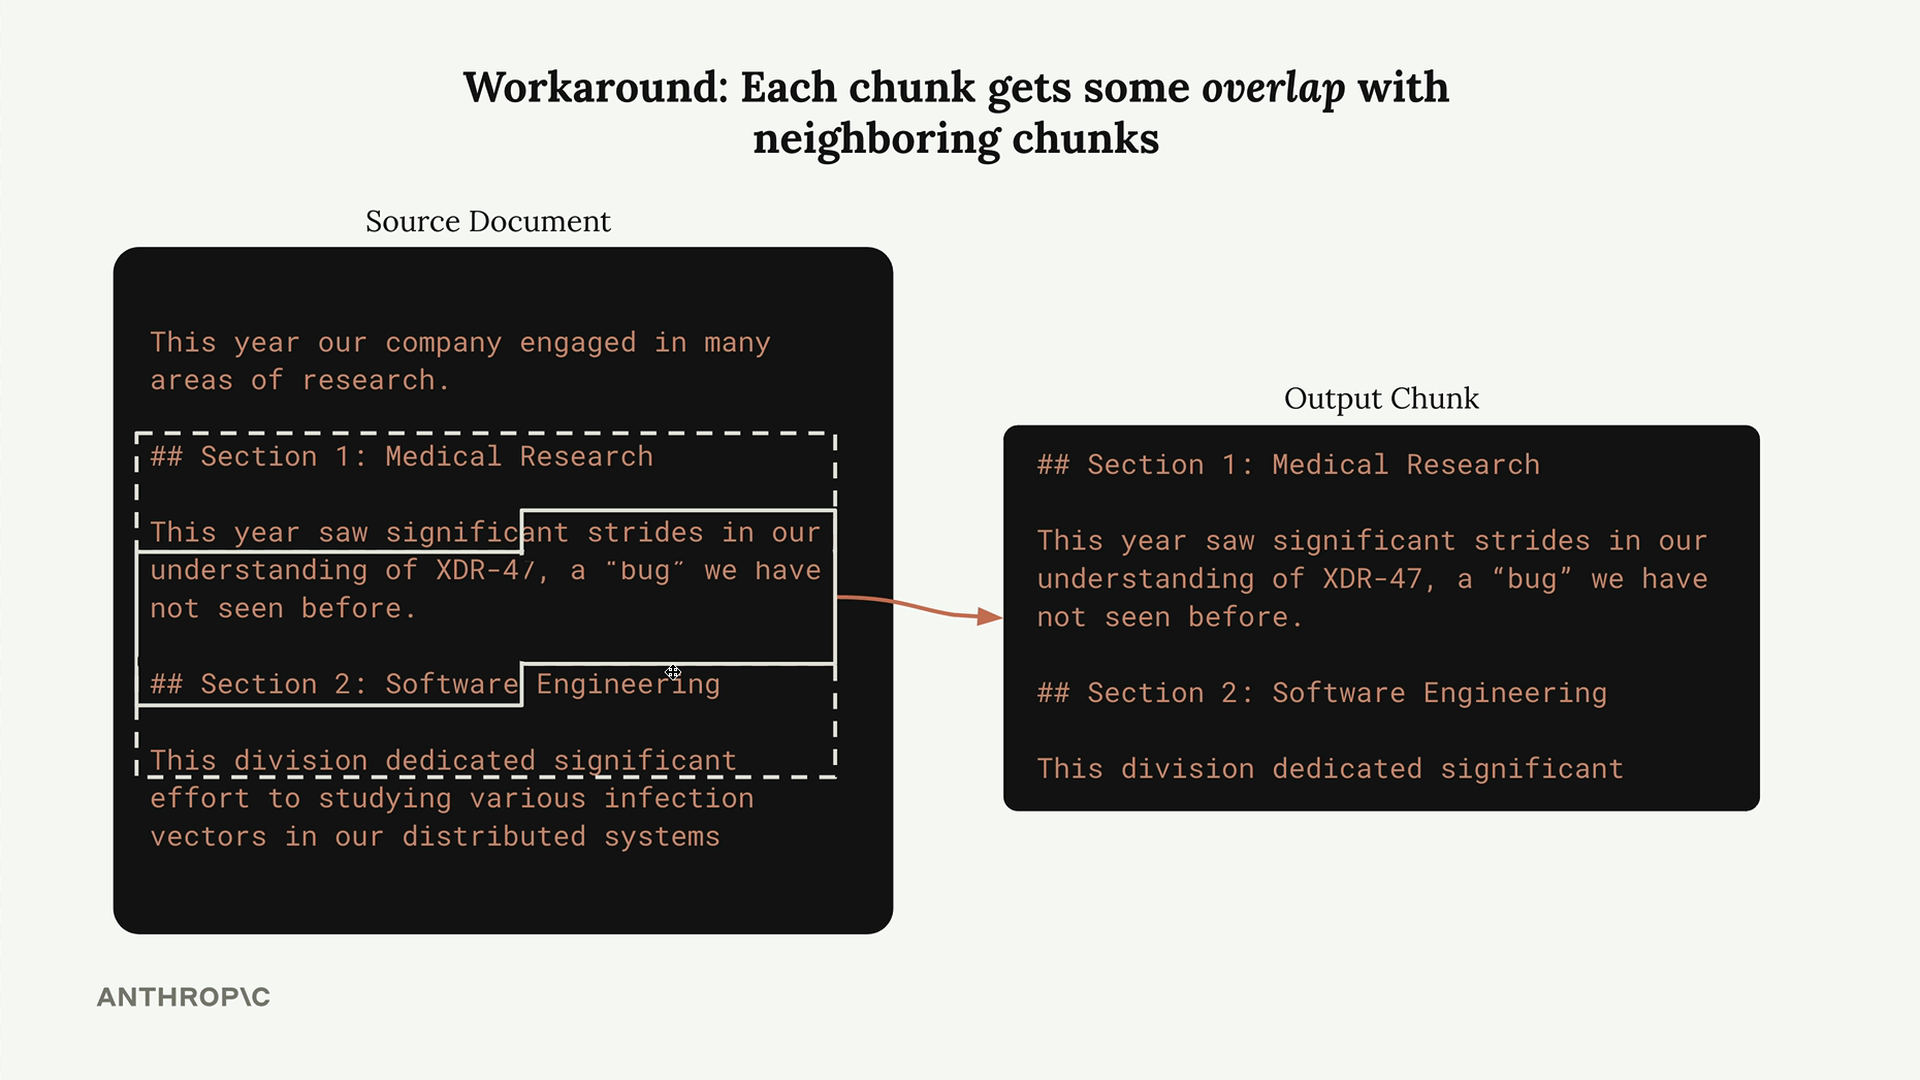
La solution consiste à ajouter un chevauchement entre les chunks. Chaque chunk inclut certains caractères des chunks voisins, ce qui garantit une meilleure préservation du contexte et évite les coupures abruptes.
Voici une implémentation de base du découpage basé sur les caractères avec chevauchement :
def chunk_by_char(text, chunk_size=150, chunk_overlap=20):
    chunks = []
    start_idx = 0

    while start_idx < len(text):
        end_idx = min(start_idx + chunk_size, len(text))
        chunk_text = text[start_idx:end_idx]
        chunks.append(chunk_text)

        start_idx = (
            end_idx - chunk_overlap if end_idx < len(text) else len(text)
        )

    return chunks
Découpage basé sur la structure
Le découpage basé sur la structure exploite l'organisation naturelle de vos documents. Si vous travaillez avec des fichiers markdown, vous pouvez découper au niveau des titres. Pour d'autres formats, vous pourriez découper au niveau des paragraphes ou d'autres éléments structurels.
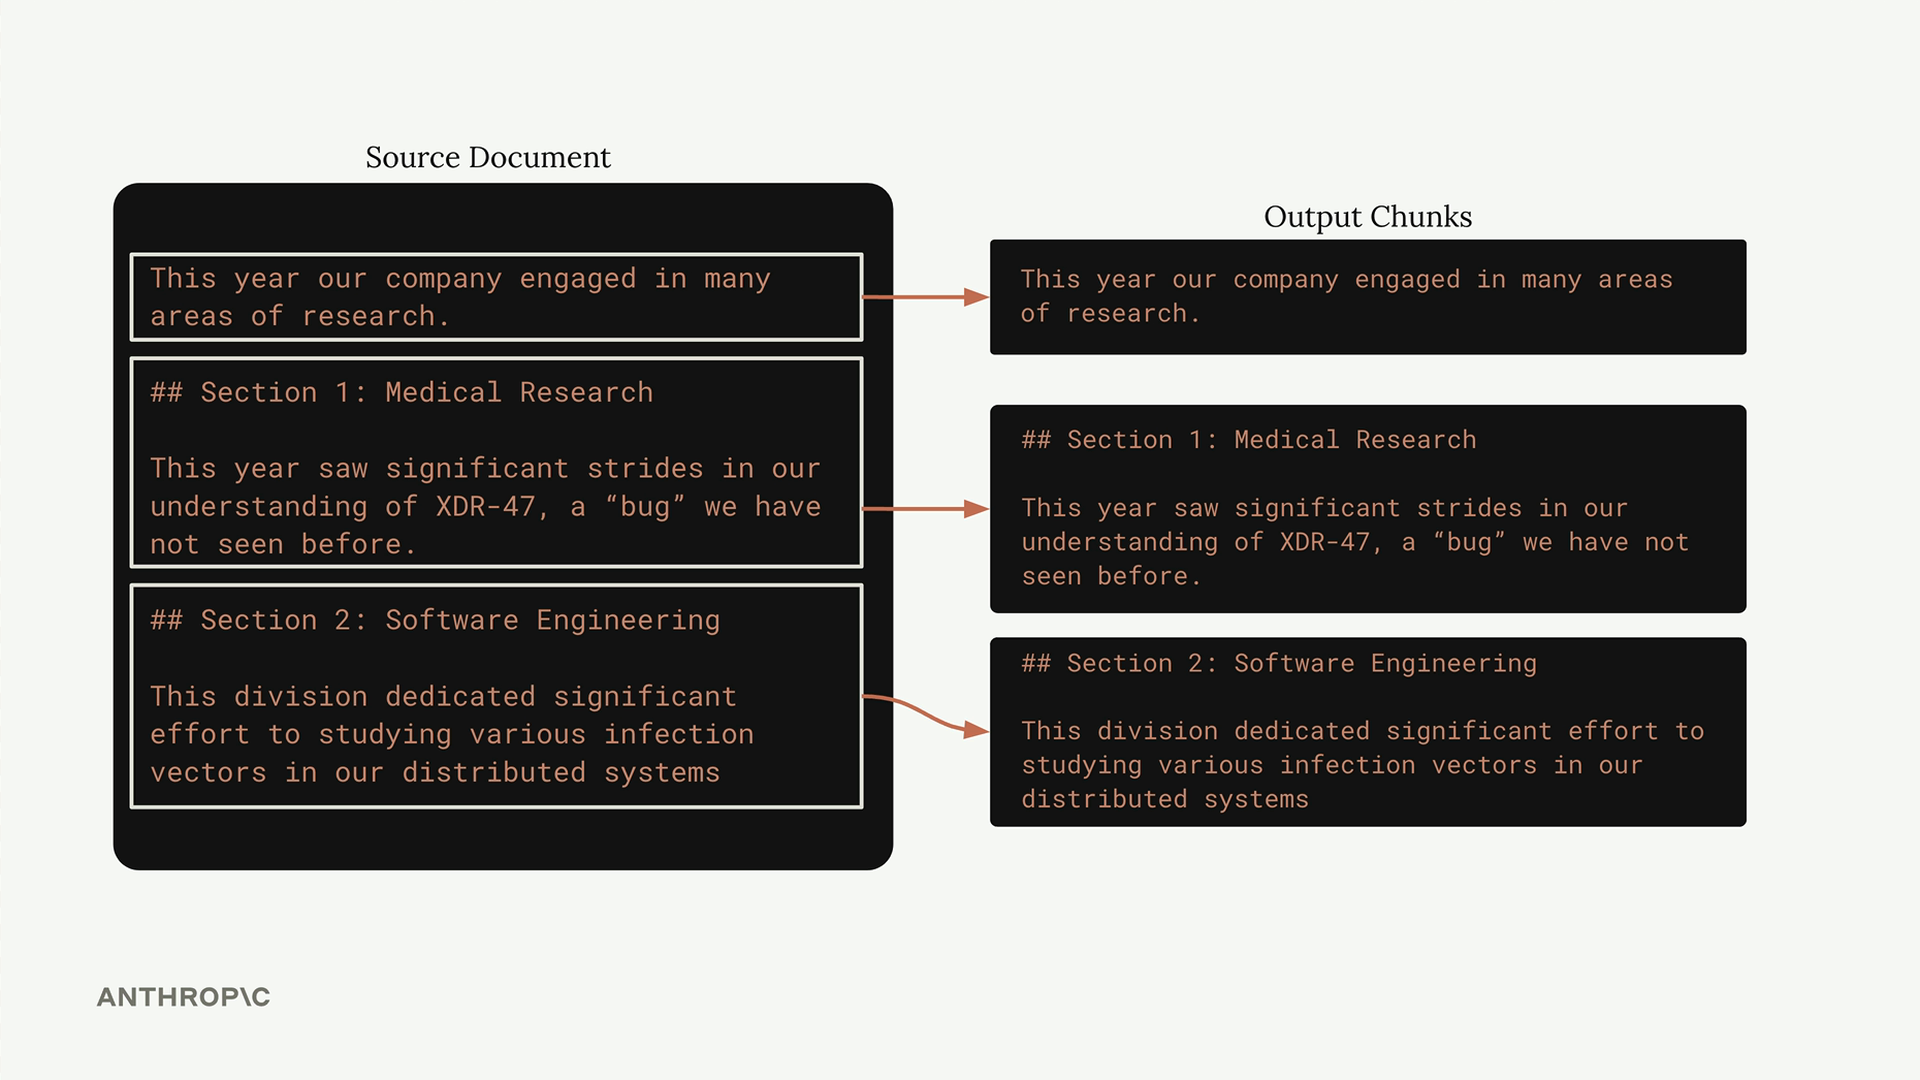
Cette approche fonctionne très bien lorsque vous avez des garanties sur la structure du document. Pour les documents markdown, vous pouvez découper au niveau des titres de section :
import re

def chunk_by_section(document_text):
    pattern = r'\n## '
    return re.split(pattern, document_text)
La principale limite est que de nombreux documents n'ont pas de structure cohérente. Les fichiers texte brut, les PDF ou les documents téléchargés par les utilisateurs pourraient ne pas présenter de marqueurs structurels clairs sur lesquels découper.
Découpage basé sur la sémantique
Le découpage basé sur la sémantique est l'approche la plus sophistiquée. Elle analyse le sens et les relations entre les phrases pour regrouper le contenu lié. Cela implique généralement :
- De diviser le texte en phrases
- D'utiliser des techniques de TAL pour mesurer la similarité sémantique
- De regrouper les phrases liées en chunks cohérents
Bien que cela puisse produire des chunks de la plus haute qualité, c'est coûteux sur le plan computationnel et plus complexe à mettre en œuvre. Pour la plupart des applications, les approches plus simples fonctionnent suffisamment bien.
Mise en œuvre pratique
Voici une fonction de découpage basée sur les phrases qui offre un bon compromis :
def chunk_by_sentence(text, max_sentences_per_chunk=5, overlap_sentences=1):
    sentences = re.split(r'(?<=[.!?])\s+', text)
    chunks = []
    start_idx = 0

    while start_idx < len(sentences):
        end_idx = min(start_idx + max_sentences_per_chunk, len(sentences))
        current_chunk = sentences[start_idx:end_idx]
        chunks.append(' '.join(current_chunk))

        start_idx += max_sentences_per_chunk - overlap_sentences

        if start_idx < 0:
            start_idx = 0

    return chunks
Choisir la bonne stratégie
Votre choix de stratégie de découpage dépend entièrement de votre cas d'usage spécifique :
- Structure de document cohérente : Utilisez le découpage basé sur la structure pour les résultats les plus nets
- Types de documents mixtes : Le découpage basé sur les phrases fonctionne souvent bien
- Code ou contenu technique : Le découpage basé sur les caractères est le plus fiable
- Formats de documents inconnus : Le découpage basé sur les caractères est votre option la plus sûre
Rappelez-vous que le découpage est souvent un processus itératif. Commencez par une approche simple, testez-la avec vos documents et cas d'usage spécifiques, puis affinez-la en fonction des résultats. La « meilleure » stratégie de découpage est celle qui fonctionne de manière fiable pour vos données et exigences particulières.