Lorsque vous créez des applications avec Claude, comprendre le cycle de vie complet d'une requête vous aide à concevoir de meilleurs systèmes et à déboguer les problèmes plus efficacement. Examinons ce qui se passe lorsqu'un utilisateur envoie un message à votre application de chat alimentée par l'IA.
Le flux complet de la requête
Le parcours de l'entrée utilisateur à la réponse de l'IA comprend cinq étapes distinctes : Requête vers le serveur, Requête vers Vertex, Traitement par le modèle, Réponse vers le serveur et Réponse vers le client. Chaque étape joue un rôle crucial dans la délivrance de cette réponse « magique » que les utilisateurs attendent.
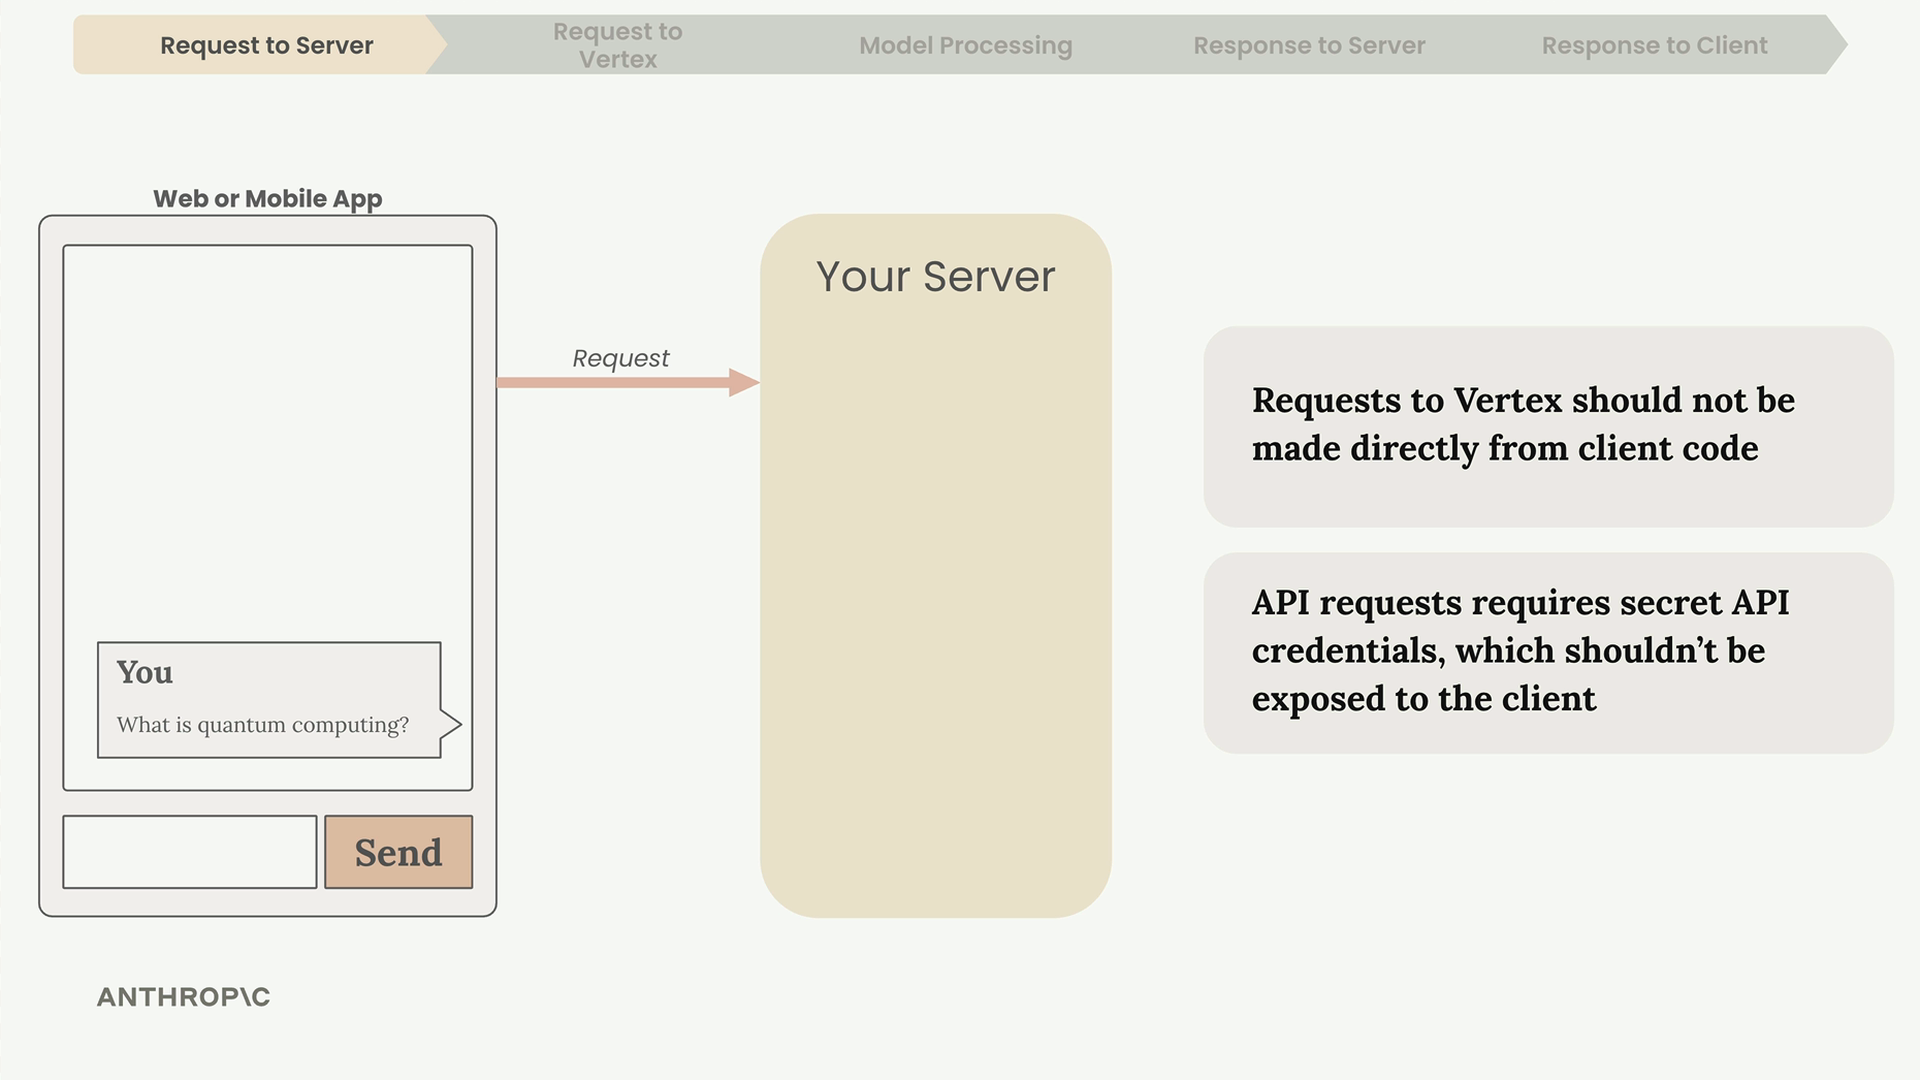
Pourquoi vous avez besoin d'un serveur
Ne faites jamais de requêtes API directement depuis du code côté client. Voici pourquoi :
- Les requêtes API nécessitent des identifiants secrets qui doivent rester sécurisés
- Exposer des identifiants dans le code client les rend visibles à n'importe qui
- Votre serveur agit comme un intermédiaire sécurisé entre votre application et Vertex
Acheminez toujours les requêtes via votre propre serveur que vous contrôlez et sécurisez.
Effectuer la requête API
Votre serveur communique avec Vertex en utilisant soit les SDK d'Anthropic, soit les SDK officiels de Vertex de Google. Anthropic fournit des SDK officiels pour Python, TypeScript, Go et Ruby.
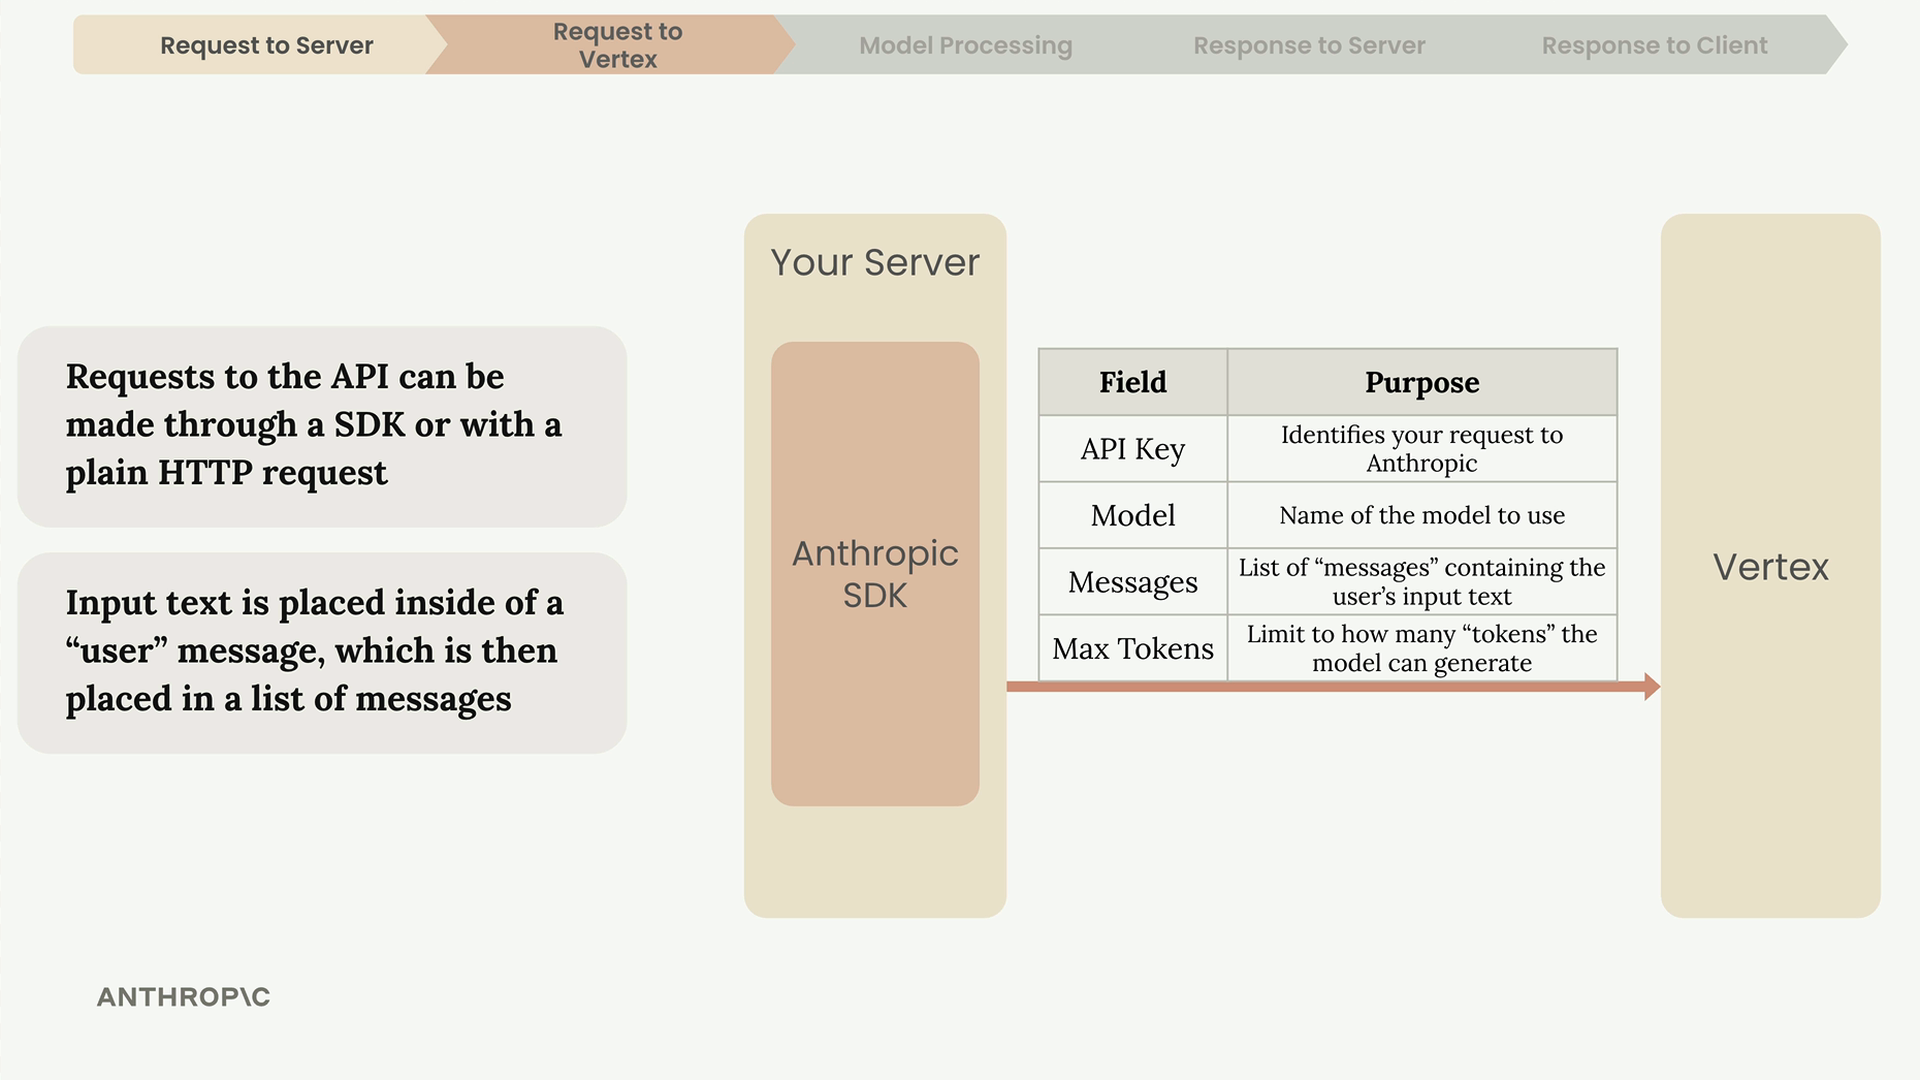
Chaque requête doit inclure ces champs clés :
- Identifiants Google Cloud - Autorisent votre requête sur Google Cloud
- Modèle - Nom du modèle spécifique à utiliser
- Messages - Liste contenant le texte saisi par l'utilisateur
- Jetons maximum - Limite le nombre de jetons que le modèle peut générer
Le texte saisi par l'utilisateur est placé à l'intérieur d'un message « user », qui est ensuite inséré dans une liste de messages envoyée à l'API.
À l'intérieur de Claude : le processus de génération de texte
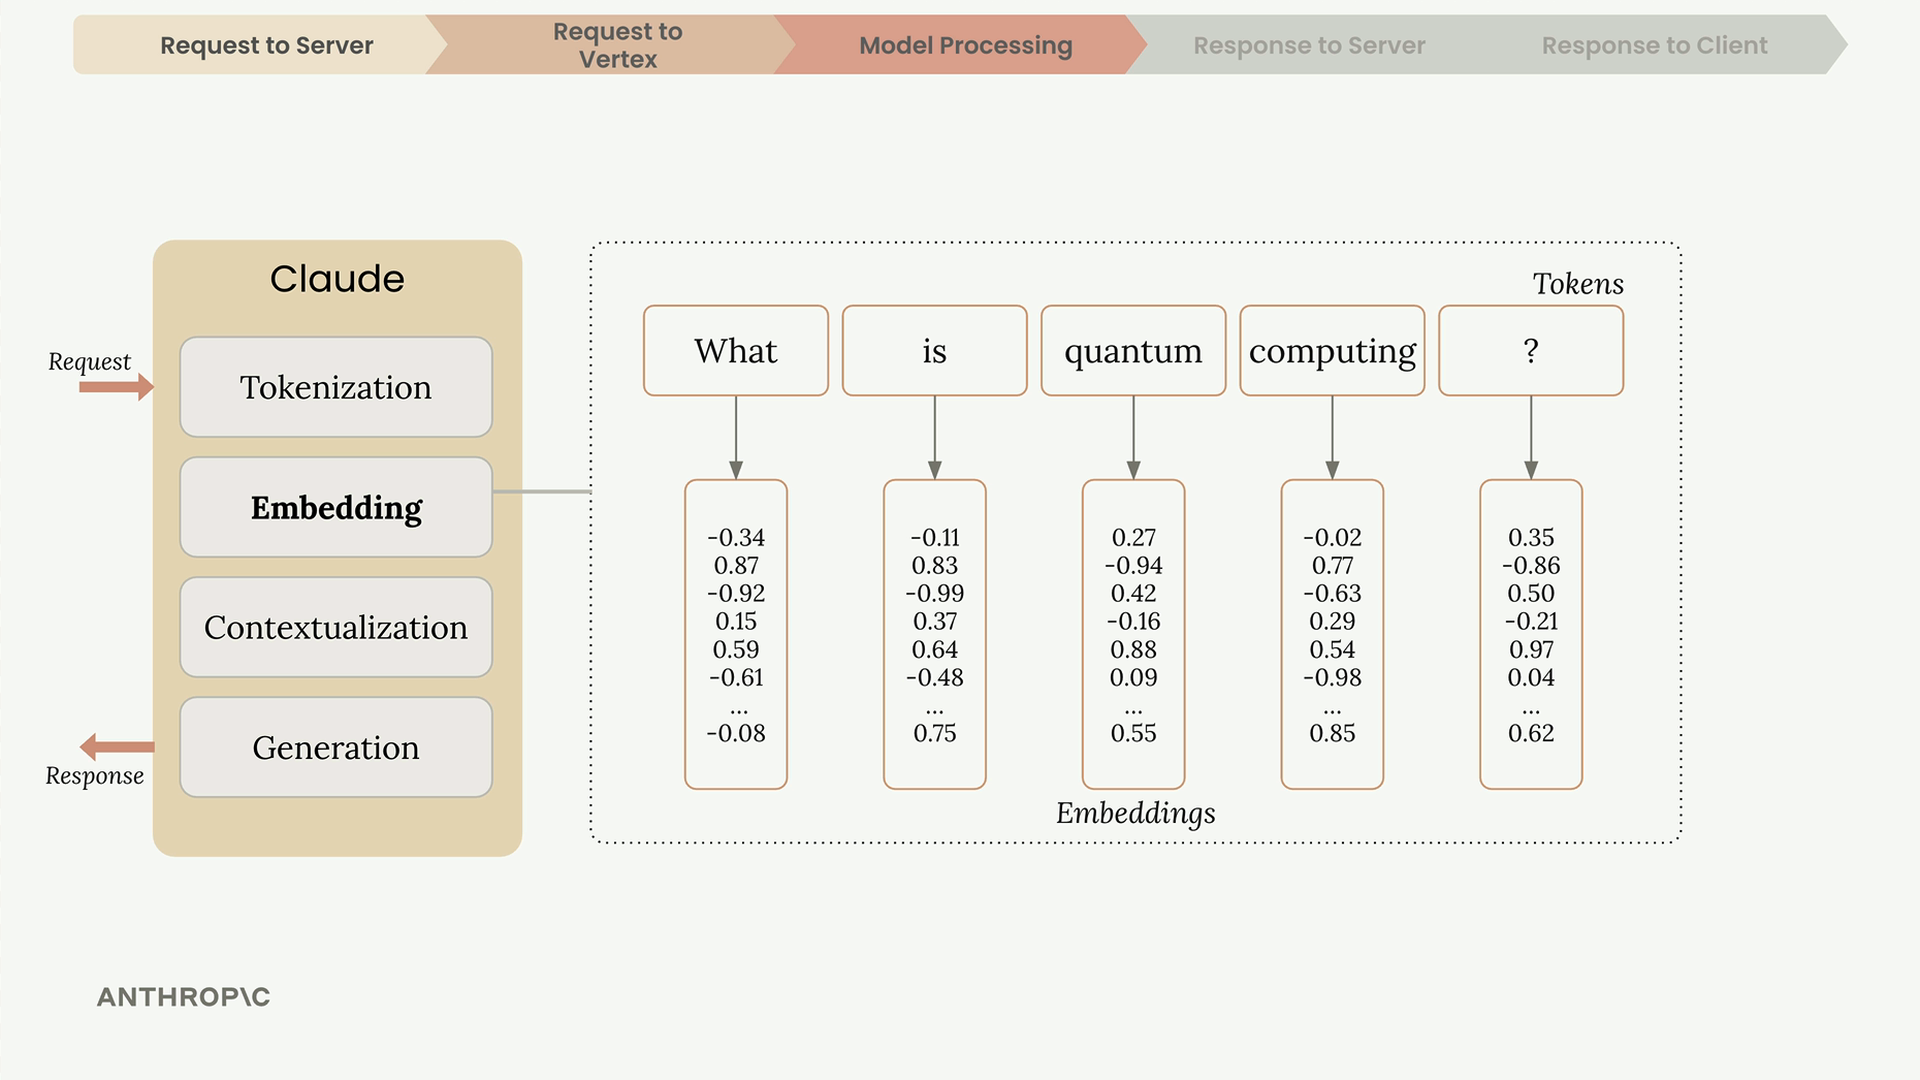
Une fois que Vertex reçoit votre requête, Claude la traite en quatre étapes : Tokenisation, Embedding, Contextualisation et Génération.
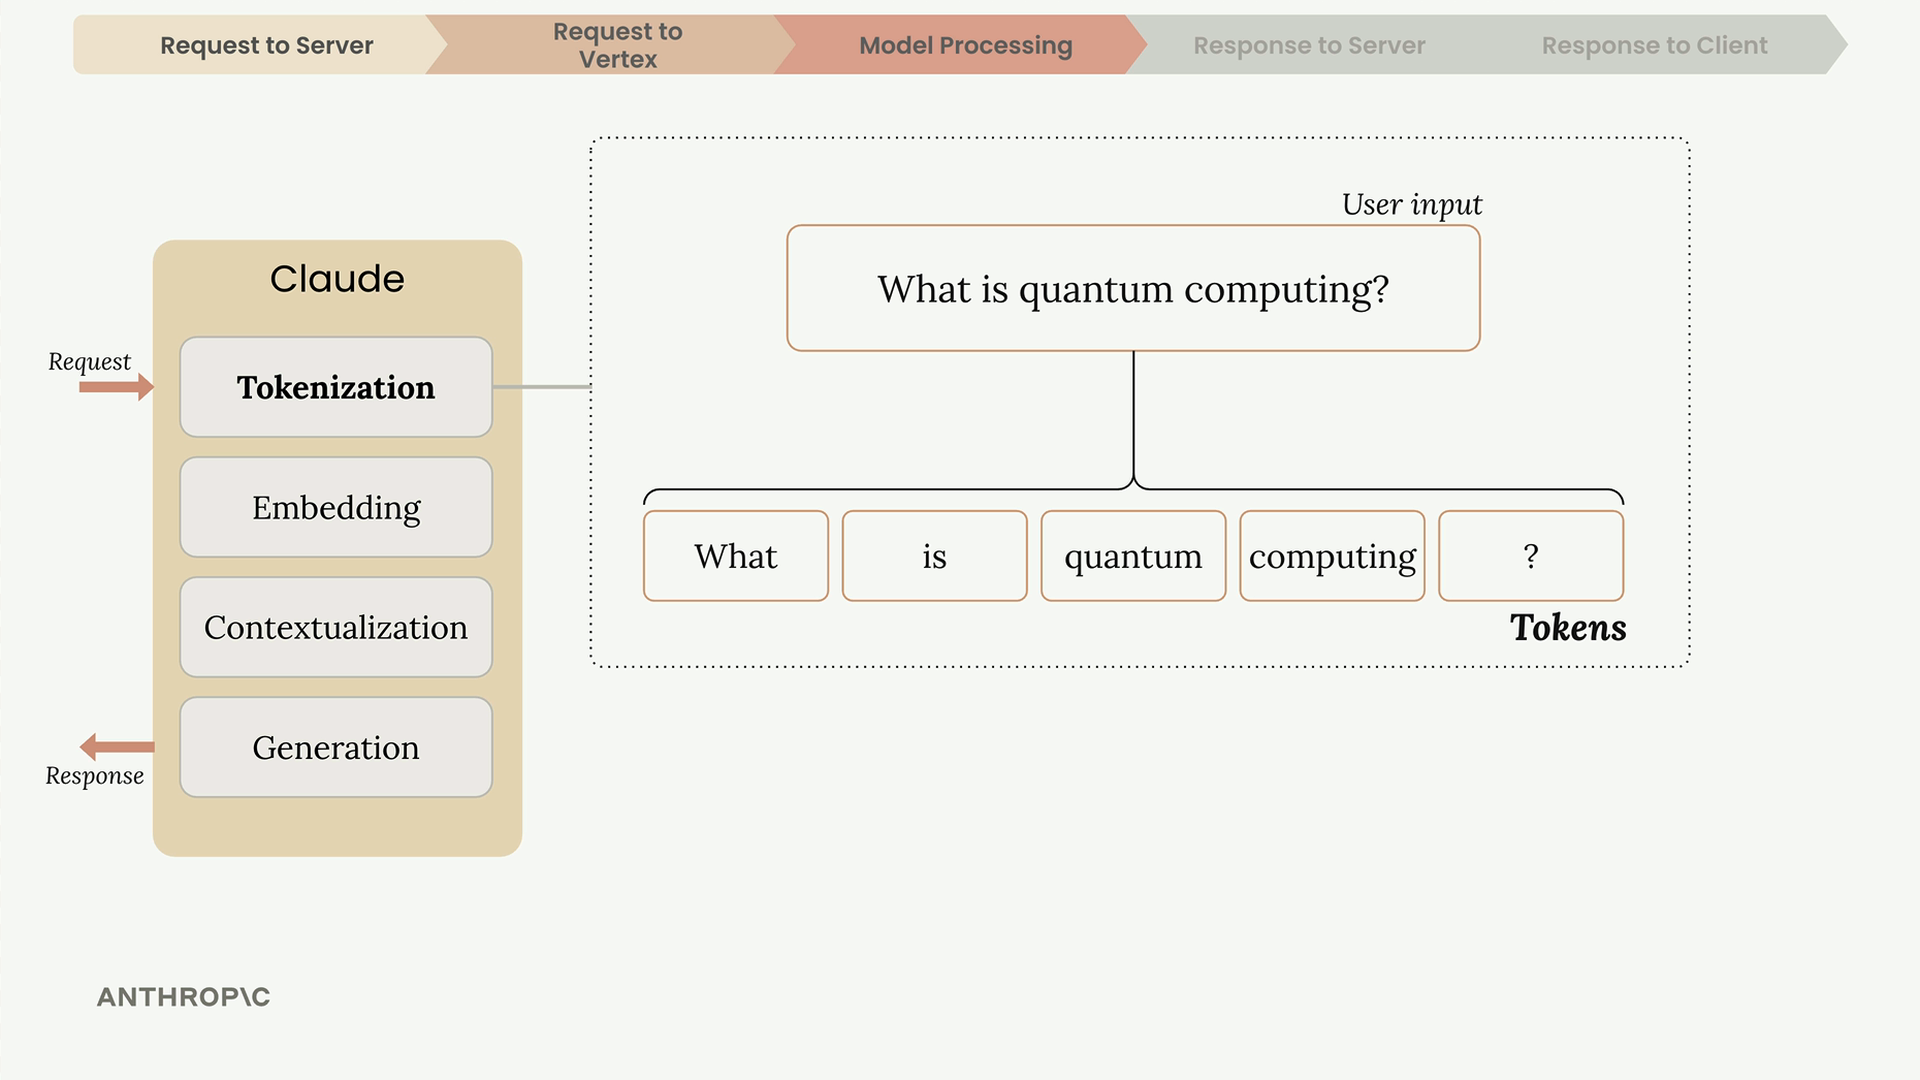
Tokenisation
Claude commence par décomposer le texte d'entrée en petits fragments appelés jetons. Il peut s'agir de mots entiers, de parties de mots, d'espaces ou de symboles. Pour simplifier, considérez chaque mot comme un jeton.
Embedding
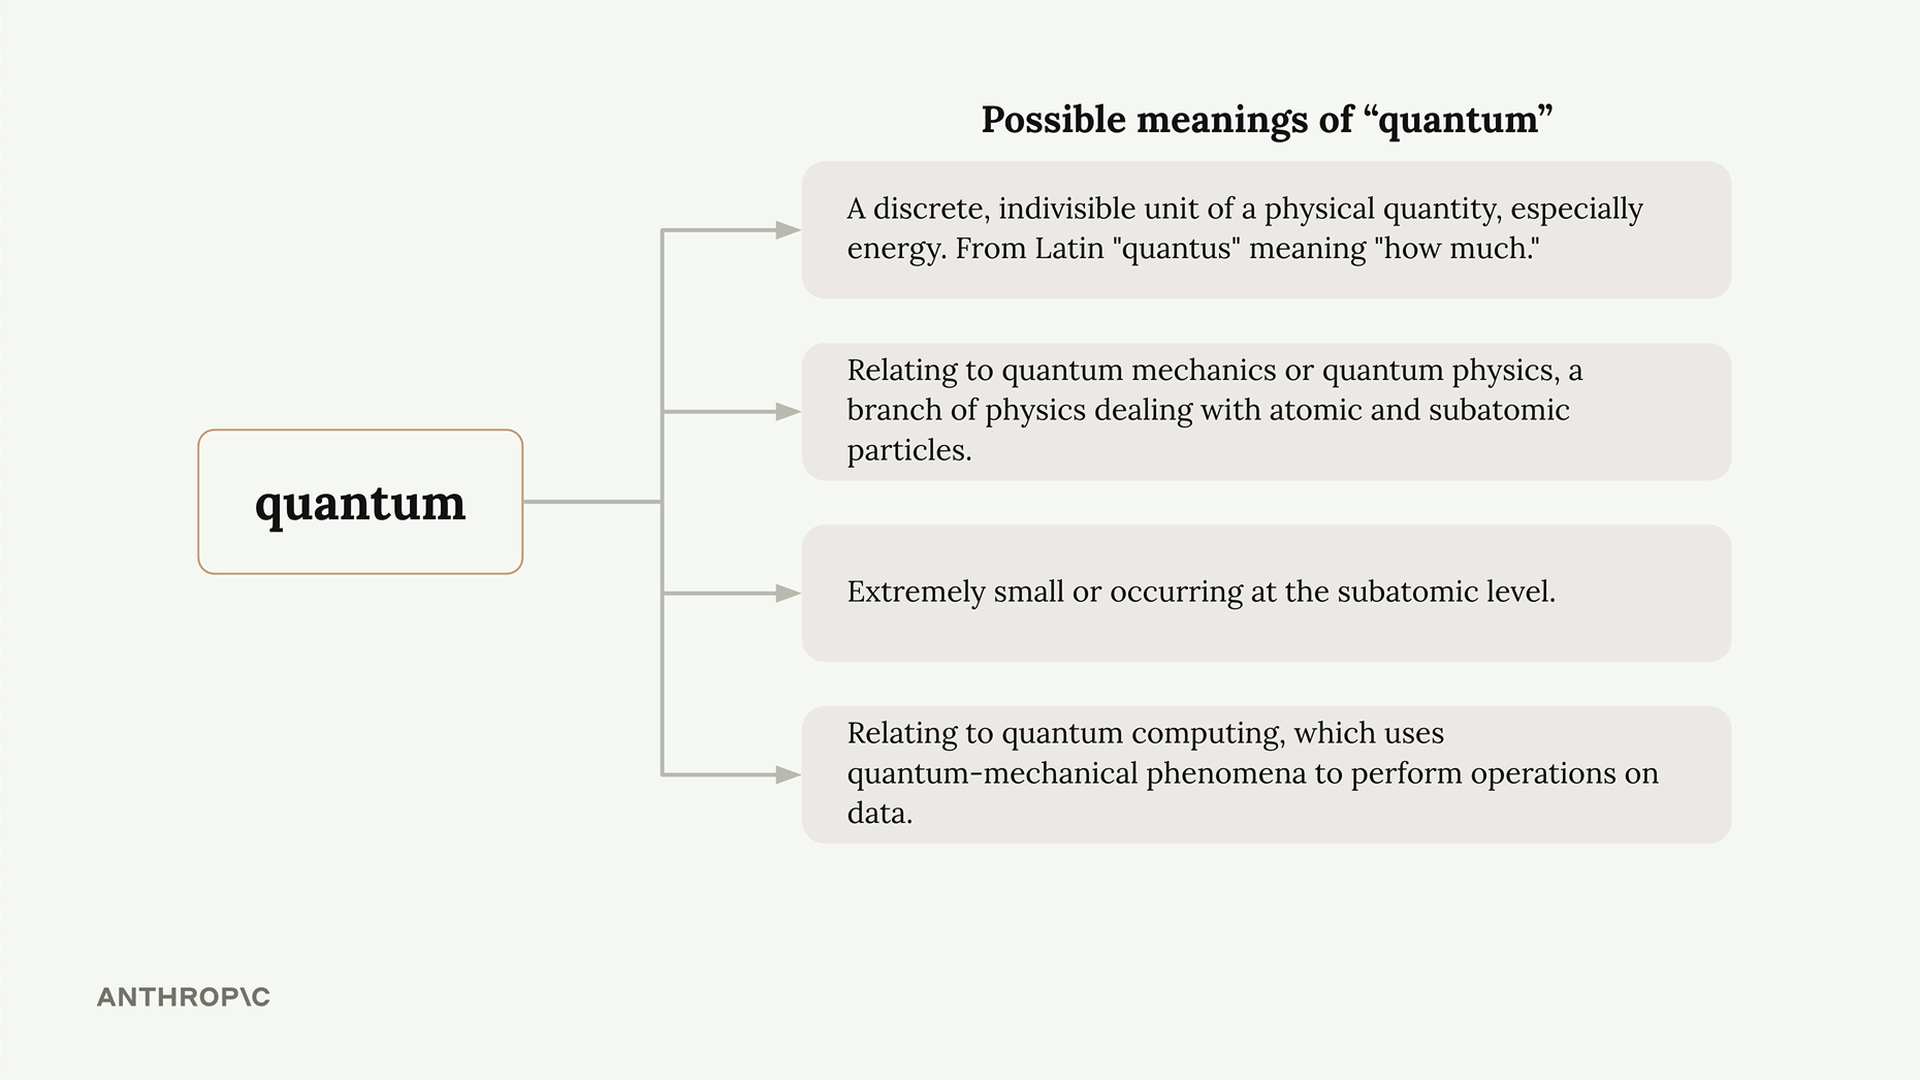
Chaque jeton est converti en un embedding - une longue liste de nombres qui représente tous les sens possibles de ce mot. Pensez aux embeddings comme à des définitions basées sur des nombres.
Contextualisation
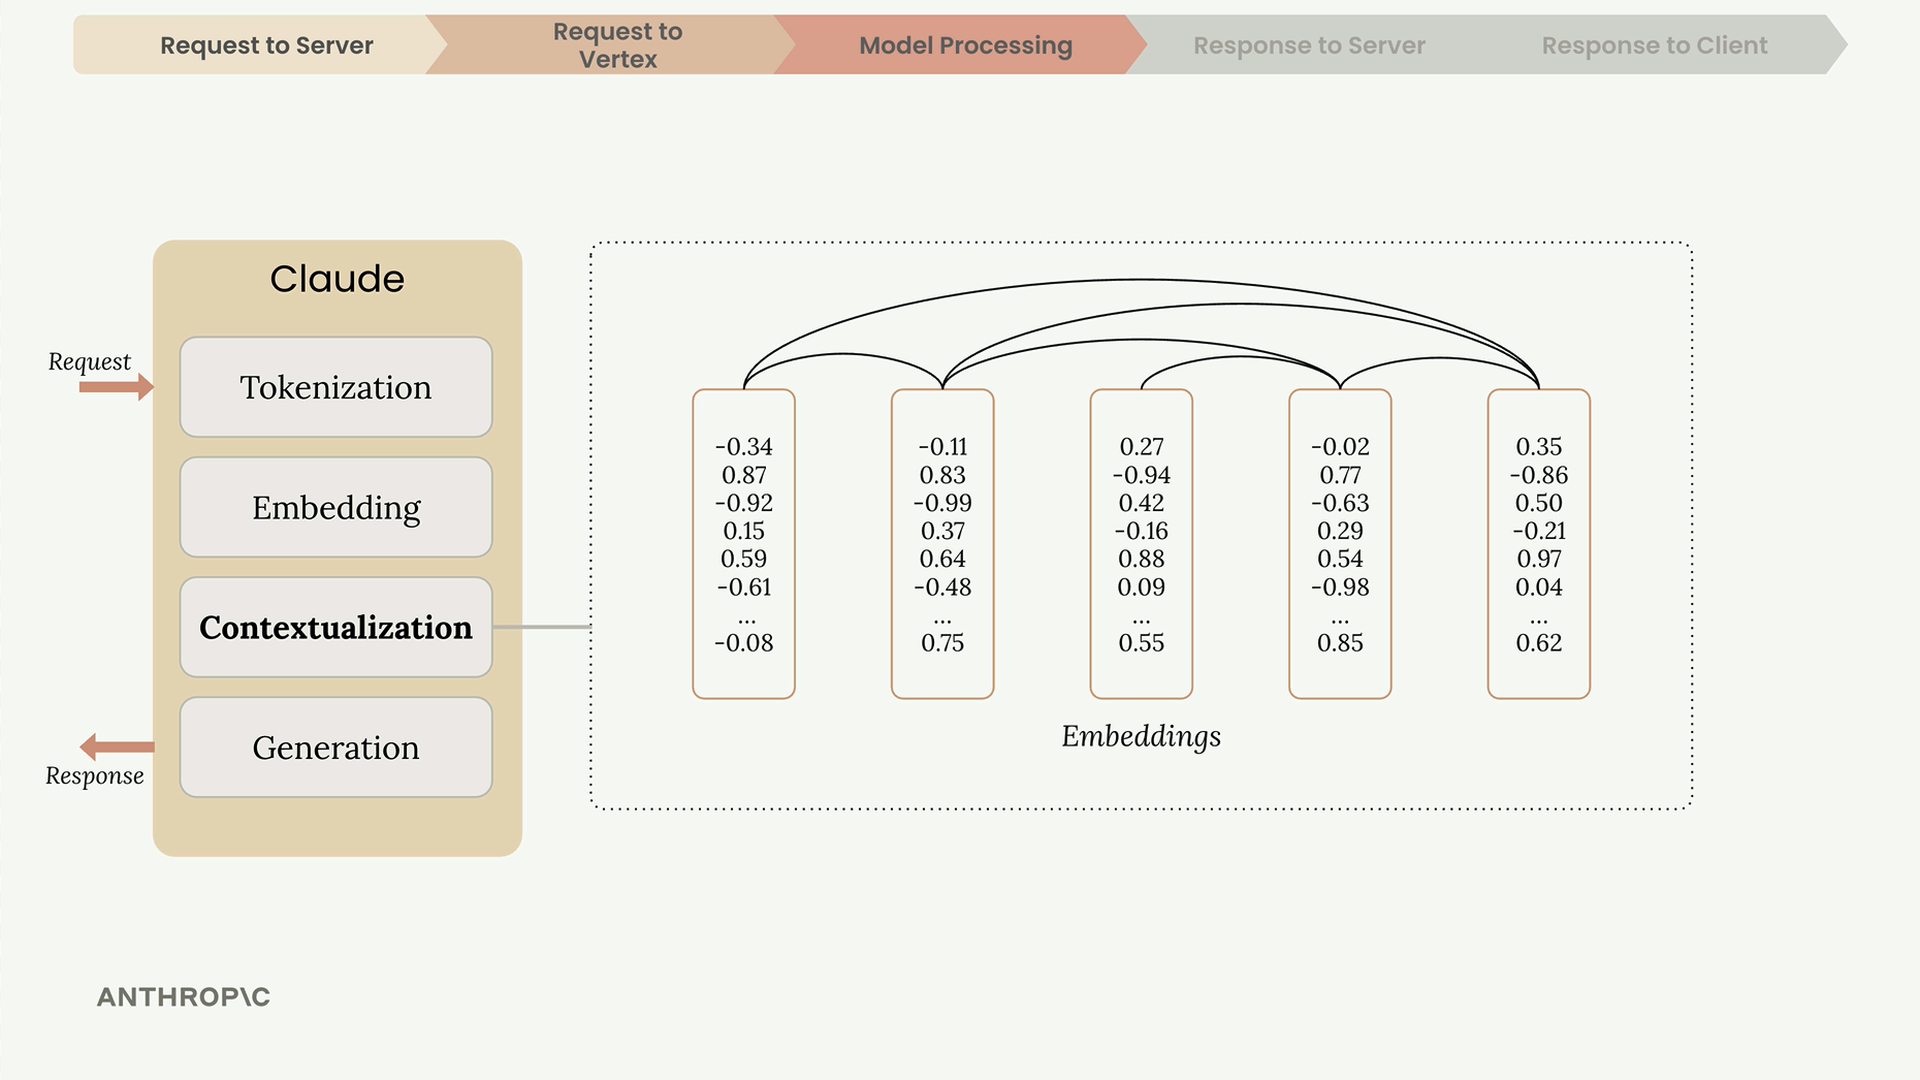
Puisque les mots peuvent avoir plusieurs sens, Claude utilise le contexte pour déterminer la bonne interprétation. Le mot « quantum » pourrait faire référence à la physique, à l'informatique, ou simplement signifier « très petit » - le contexte fourni par les mots environnants clarifie le sens voulu.
Pendant la contextualisation, chaque embedding est ajusté en fonction de ses voisins, en mettant en valeur le sens qui a le plus de sens compte tenu du contexte.
Génération
Les embeddings contextualisés passent à travers une couche de sortie qui produit des probabilités pour chaque mot suivant possible. Claude ne choisit pas toujours le mot ayant la plus forte probabilité - il utilise un mélange de probabilité et d'aléatoire pour créer des réponses plus naturelles et variées.
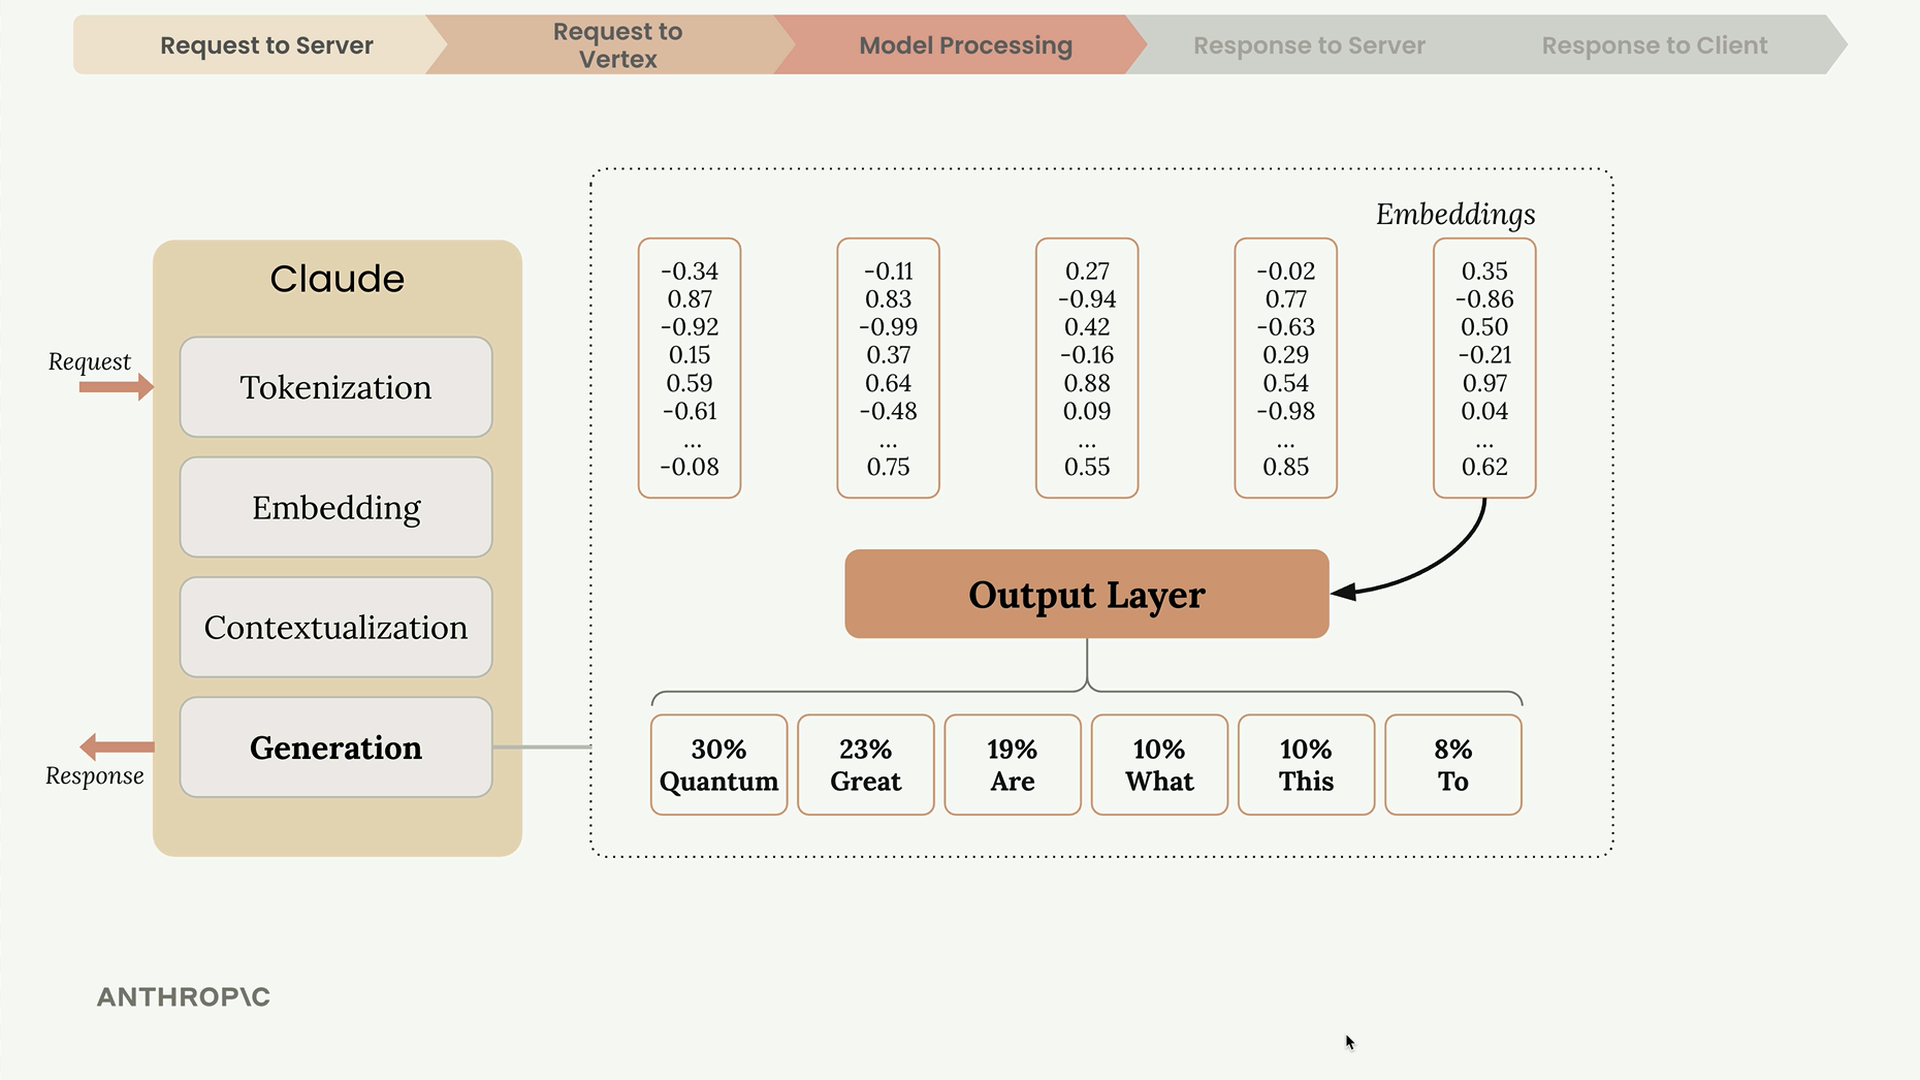
Après avoir sélectionné un mot, Claude l'ajoute à la séquence et répète l'ensemble du processus pour le mot suivant.
Quand la génération s'arrête
Après avoir généré chaque jeton, Claude vérifie plusieurs conditions pour décider s'il doit continuer :
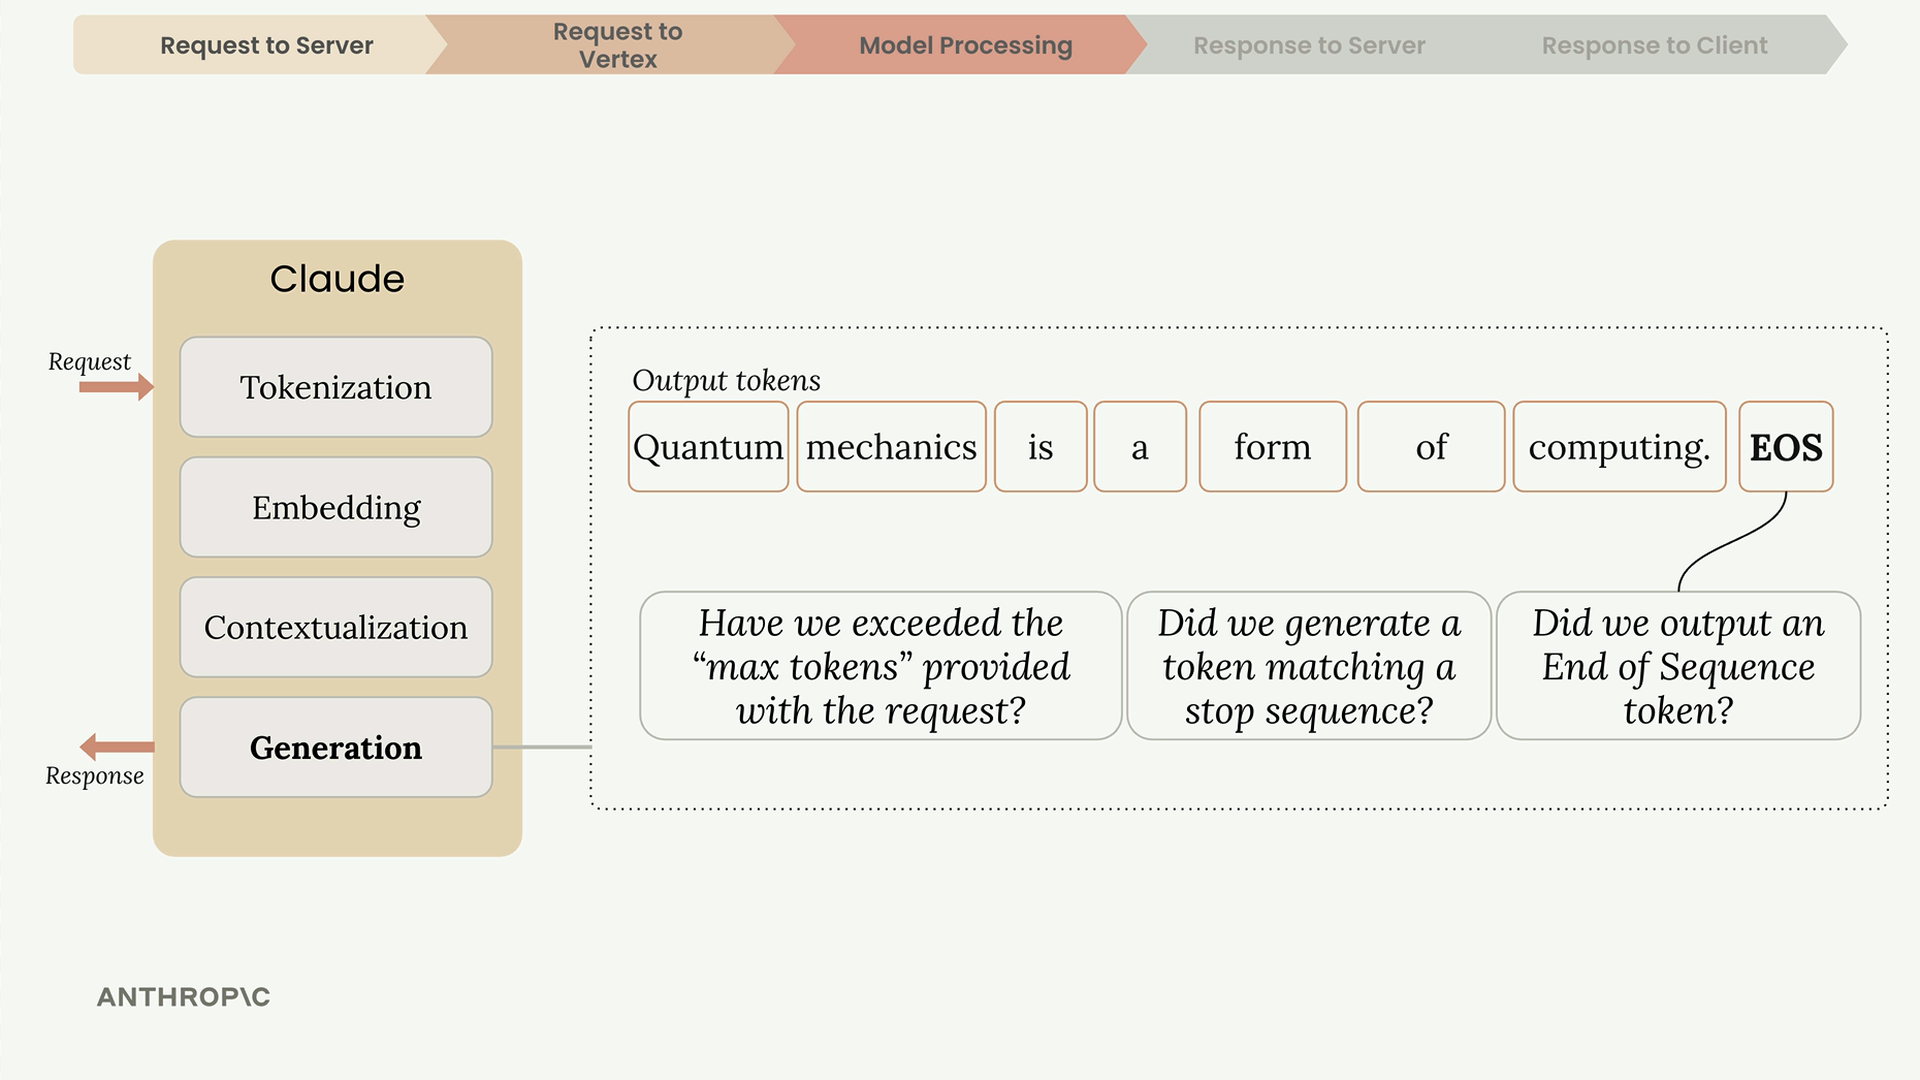
- Nombre maximum de jetons atteint - A-t-il atteint la limite que vous avez spécifiée ?
- Fin naturelle - A-t-il généré un jeton de fin de séquence ?
- Séquence d'arrêt - A-t-il rencontré une phrase d'arrêt prédéfinie ?
Le jeton de fin de séquence est un signal spécial (un texte non visible) que Claude utilise pour indiquer qu'il est parvenu à une conclusion naturelle.
La réponse
Une fois la génération terminée, Vertex renvoie une réponse à votre serveur contenant :
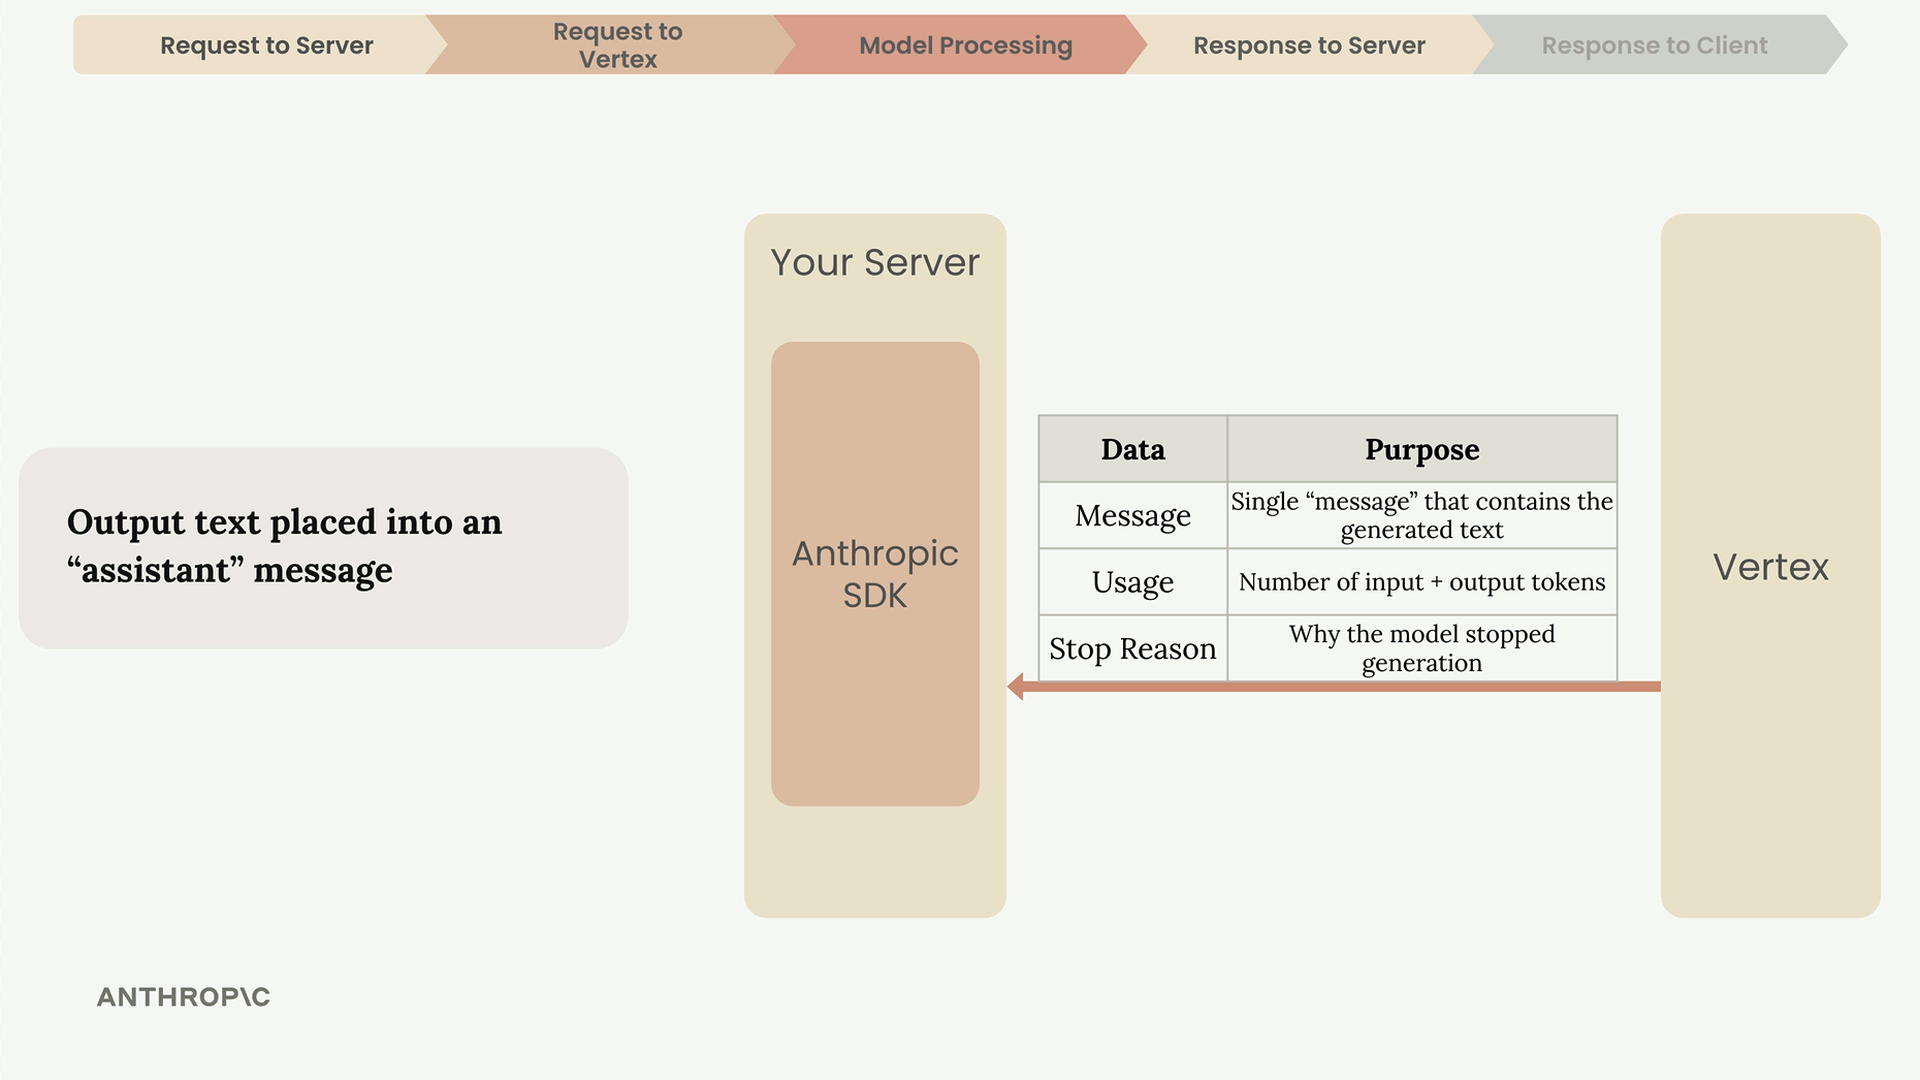
- Message - Le texte généré
- Usage - Le nombre de jetons d'entrée et de sortie
- Raison d'arrêt - Pourquoi le modèle a arrêté de générer
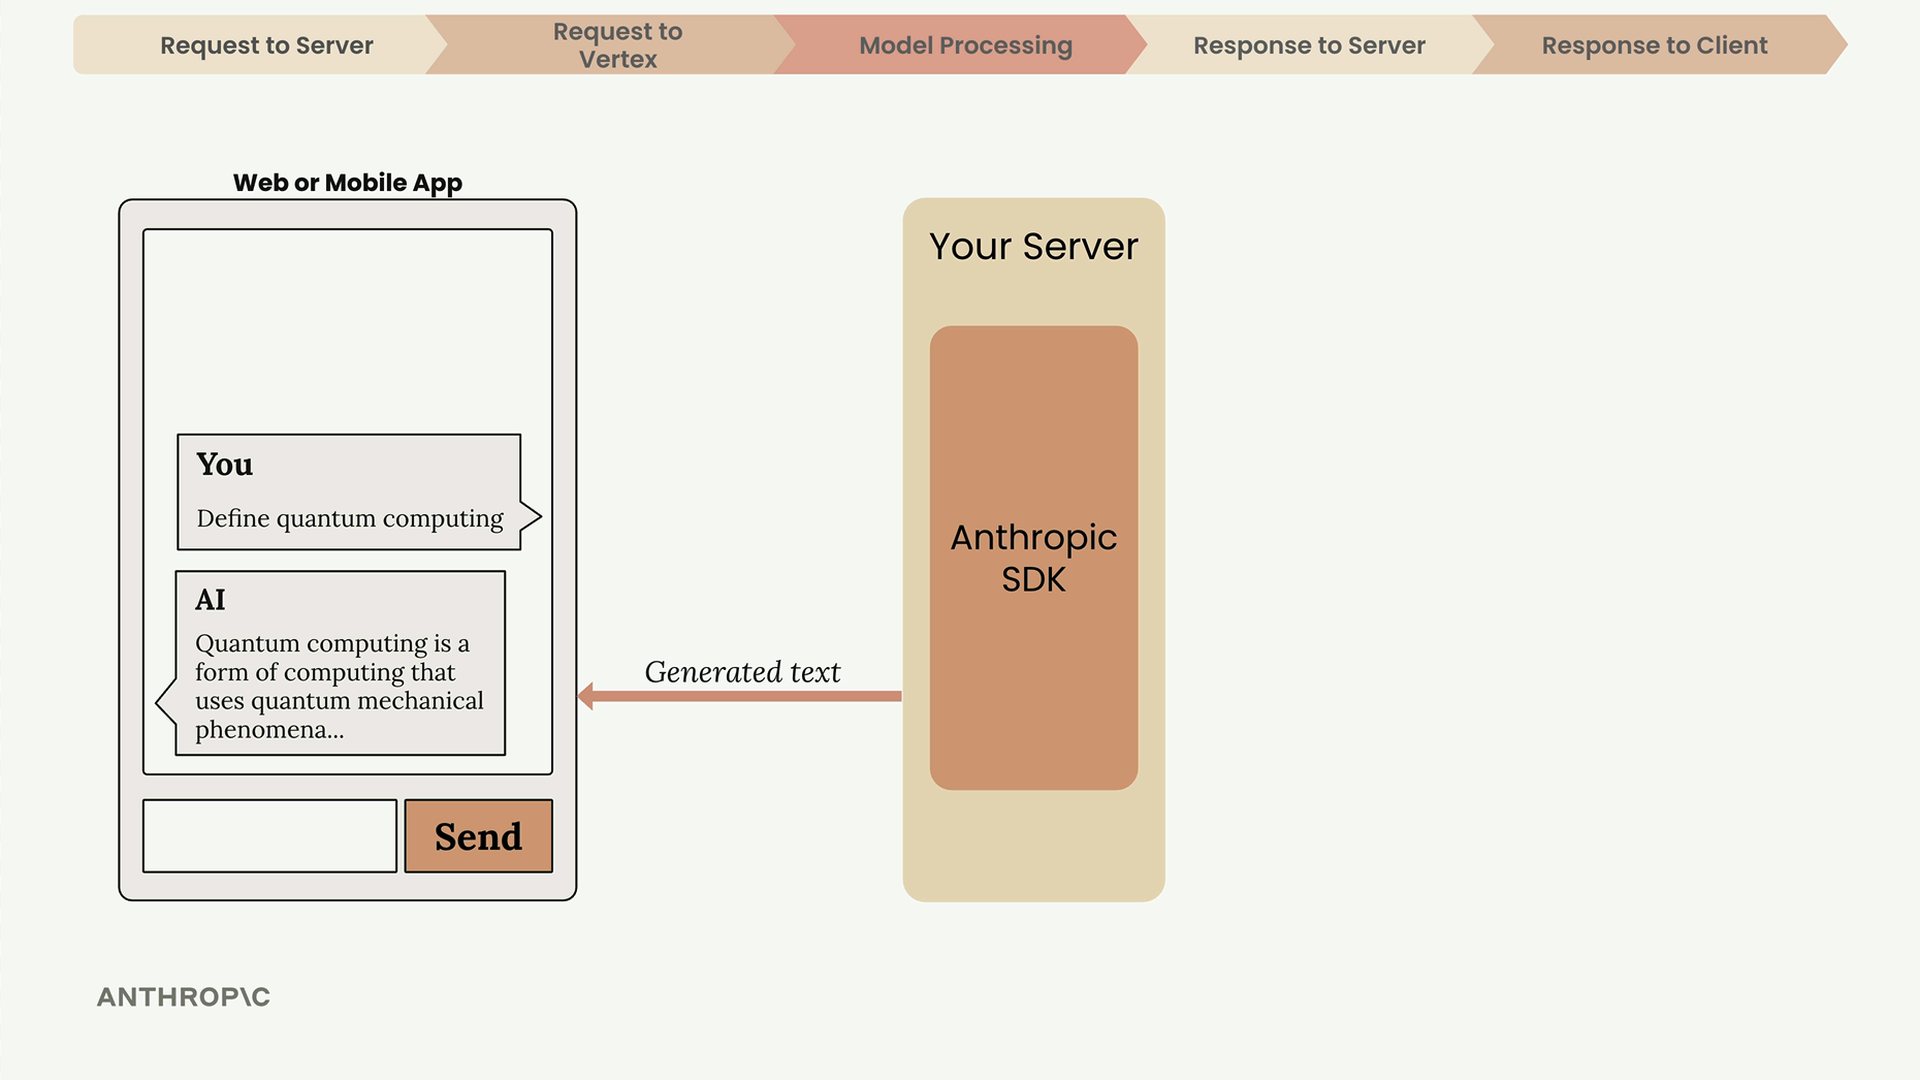
Votre serveur transmet ensuite le texte généré à votre application cliente, où il apparaît dans l'interface de chat.
La vue d'ensemble
Tout ce processus - de l'entrée utilisateur en passant par la tokenisation, l'embedding, la contextualisation, la génération, et jusqu'au retour vers l'utilisateur - se déroule en quelques secondes. Comprendre ce flux vous aide à créer des applications plus robustes et à résoudre les problèmes lorsqu'ils surviennent.
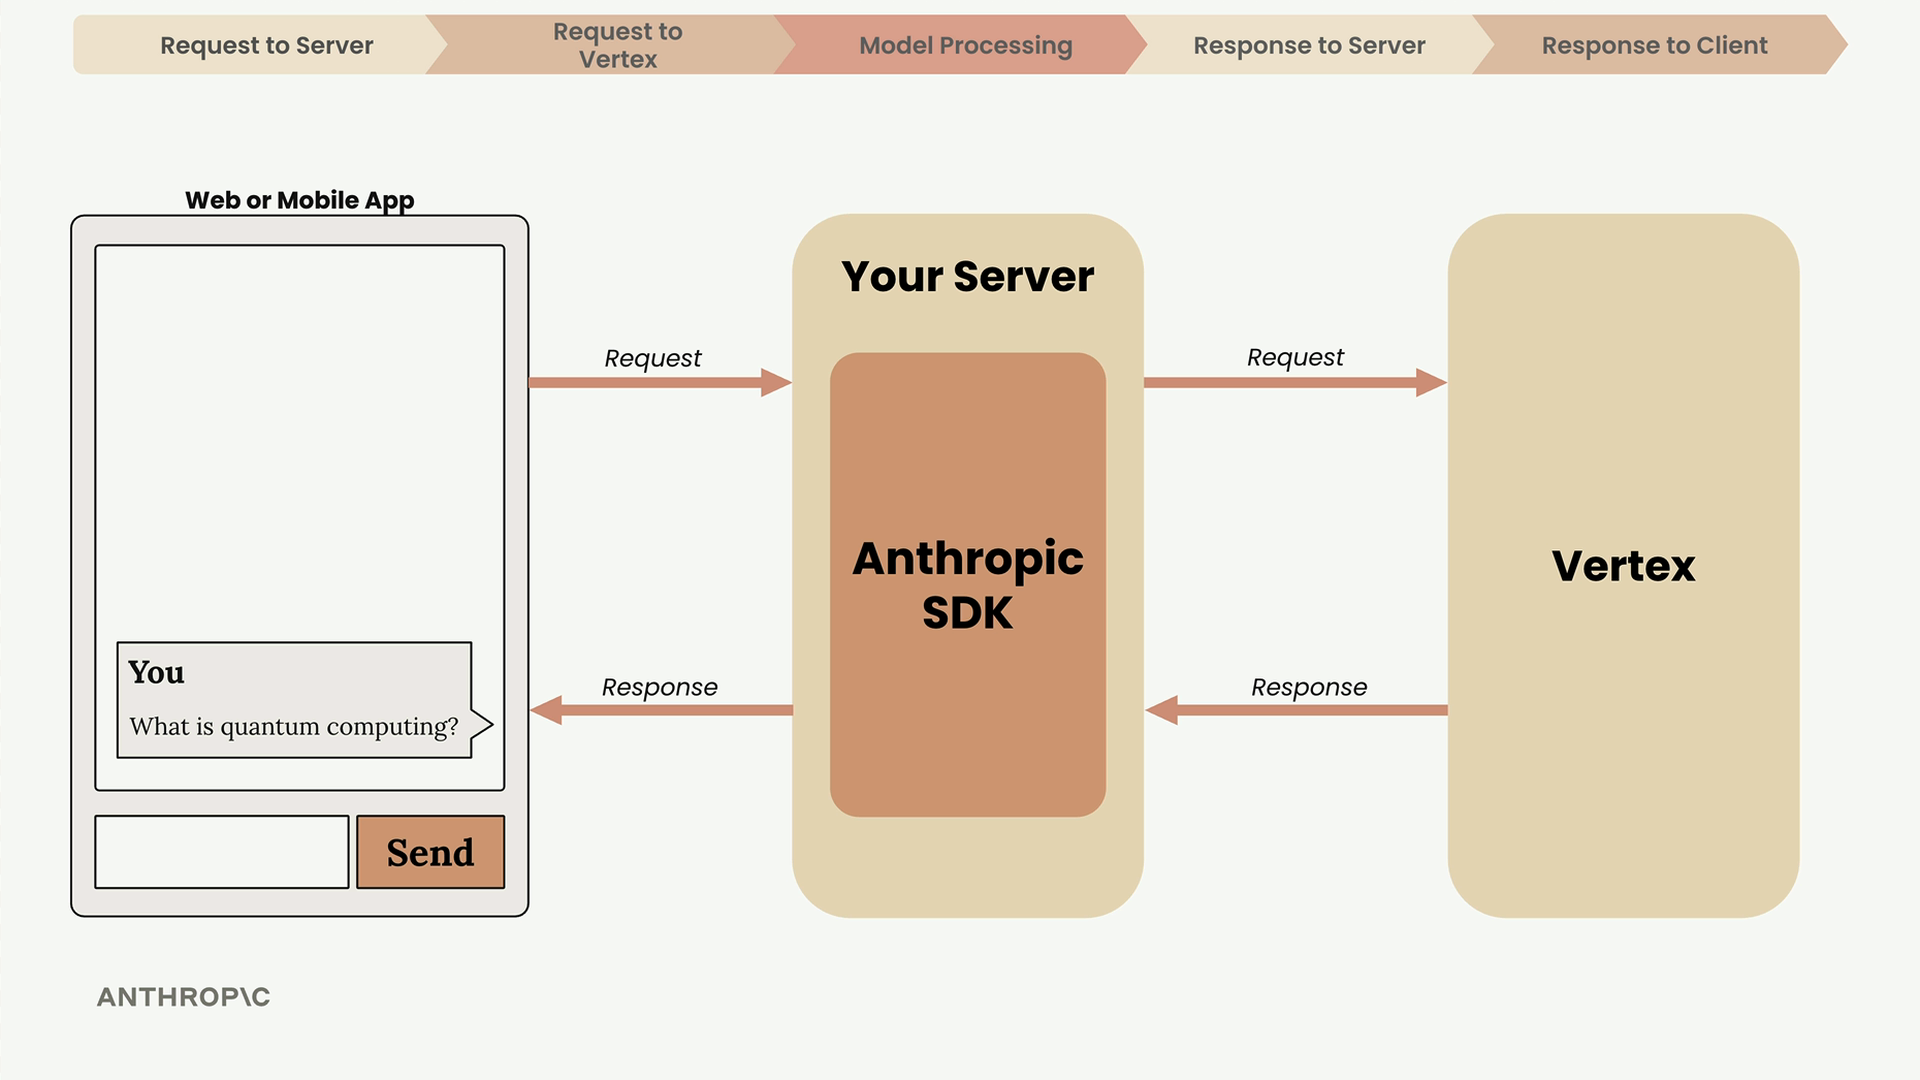
Le point essentiel à retenir : utilisez toujours un serveur comme intermédiaire, comprenez que la génération de texte est un processus itératif, et portez attention aux métadonnées de la réponse pour surveiller l'usage et comprendre le comportement du modèle.