Lorsque vous construisez un pipeline RAG, vous découvrirez rapidement que la recherche sémantique seule ne renvoie pas toujours les meilleurs résultats. Parfois, vous avez besoin de correspondances exactes de termes que la recherche sémantique pourrait manquer. La solution consiste à combiner la recherche sémantique avec la recherche lexicale à l'aide d'une technique appelée BM25.
Le problème de la recherche sémantique seule
Supposons que vous recherchiez un identifiant d'incident spécifique comme « INC-2023-Q4-011 » dans un document. Bien que ce terme exact apparaisse plusieurs fois dans des sections pertinentes, la recherche sémantique pourrait renvoyer des sections sans rapport qui sont sémantiquement similaires mais qui ne contiennent pas réellement le terme spécifique que vous recherchez.
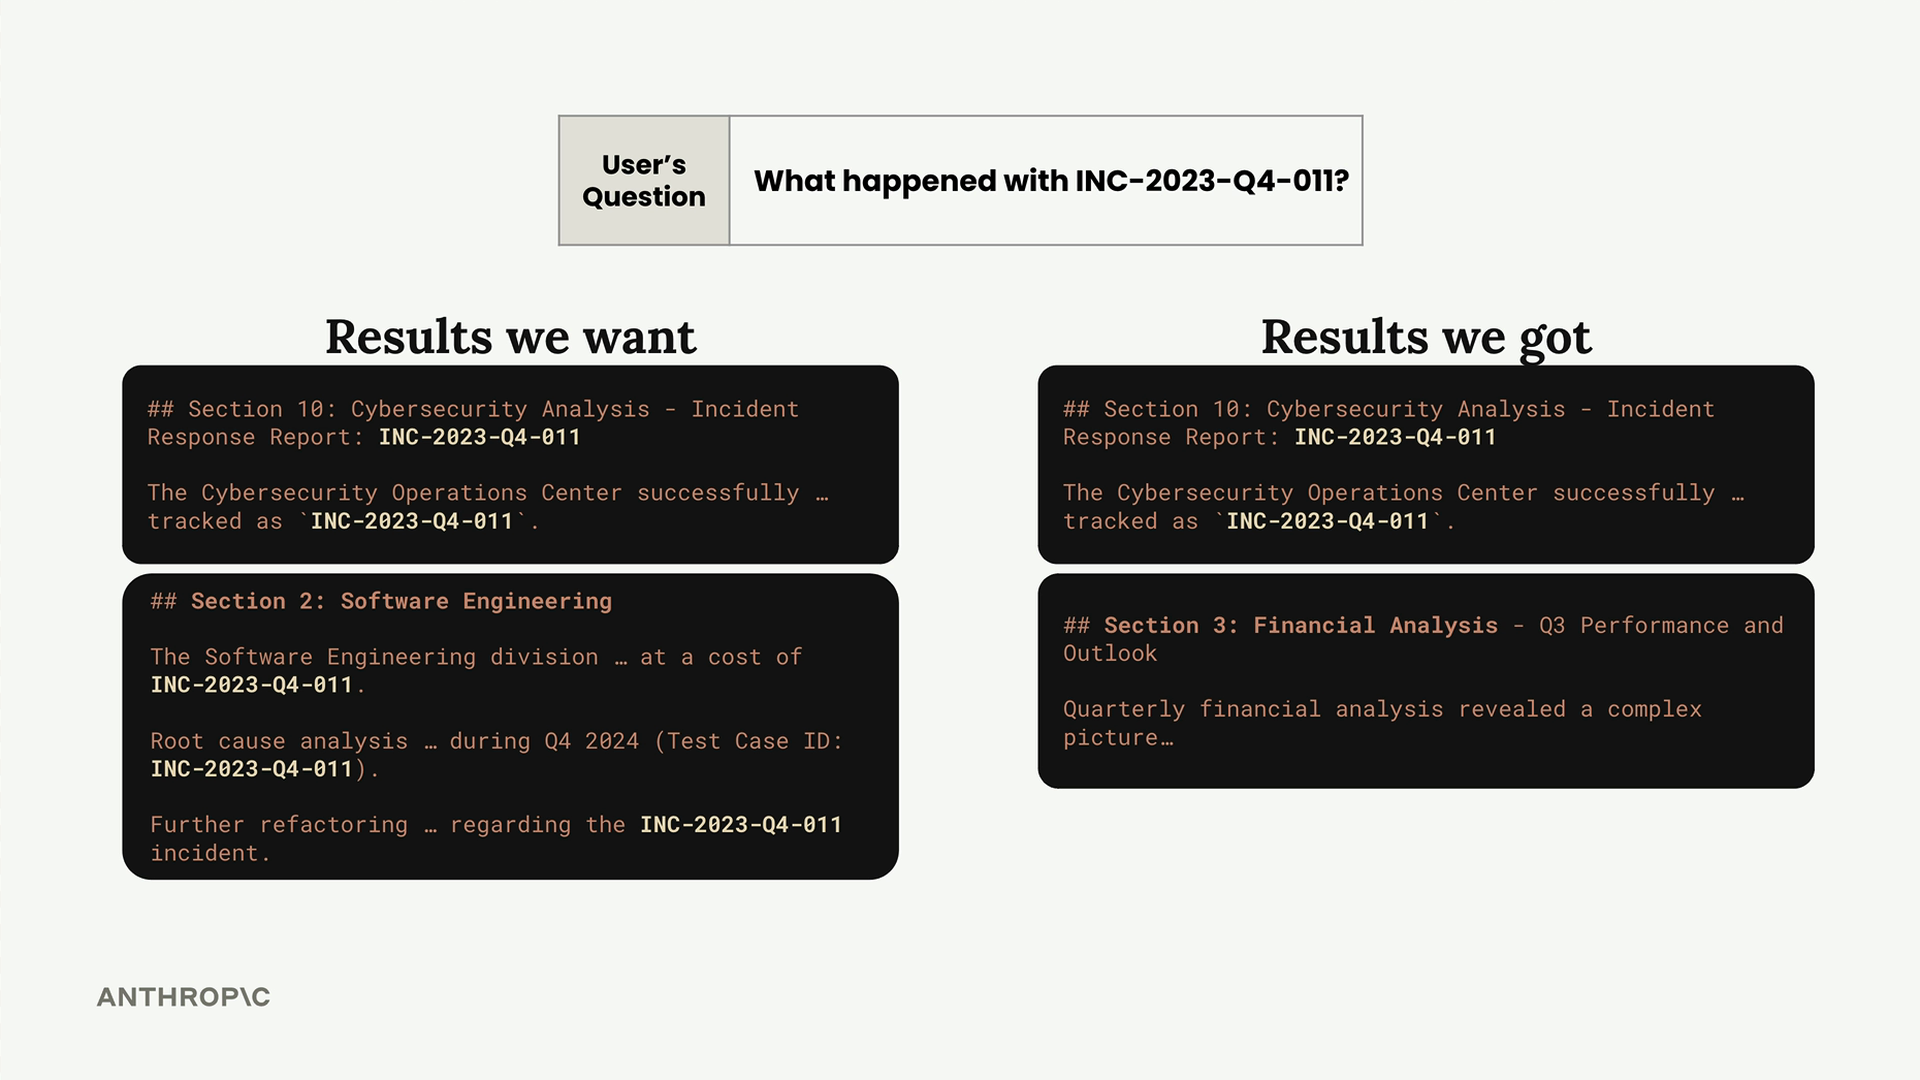
Cela se produit parce que la recherche sémantique se concentre sur le sens plutôt que sur les correspondances exactes. Lorsque vous avez besoin d'une correspondance précise des termes, vous avez besoin d'une approche différente.
Stratégie de recherche hybride
La solution consiste à exécuter deux recherches en parallèle et à fusionner les résultats :
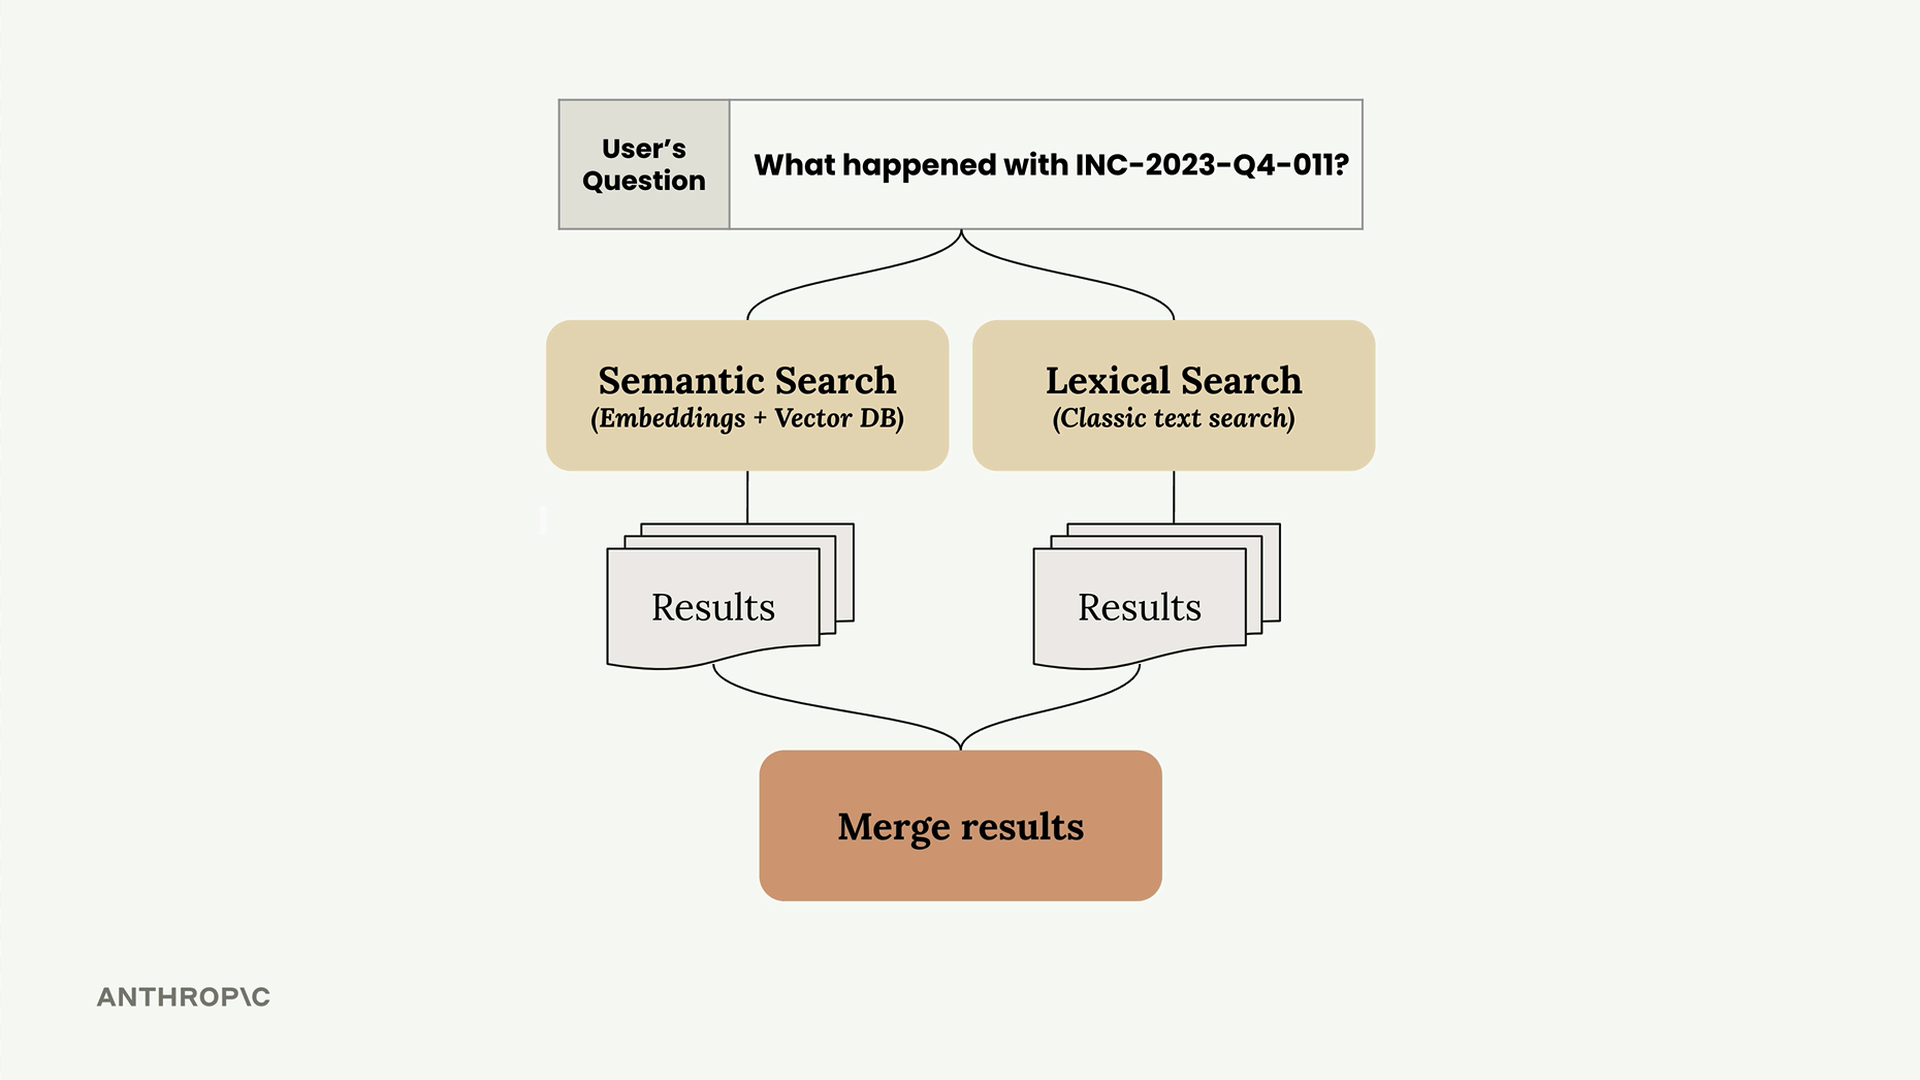
- Recherche sémantique - Utilise des embeddings et des bases de données vectorielles pour une correspondance basée sur le sens
- Recherche lexicale - Utilise une recherche de texte classique pour une correspondance exacte des termes
- Fusion des résultats - Combine les deux ensembles de résultats pour une meilleure couverture
Comment fonctionne BM25
BM25 (Best Match 25) est un algorithme populaire pour la recherche lexicale dans les pipelines RAG. Voici comment il traite une requête de recherche :
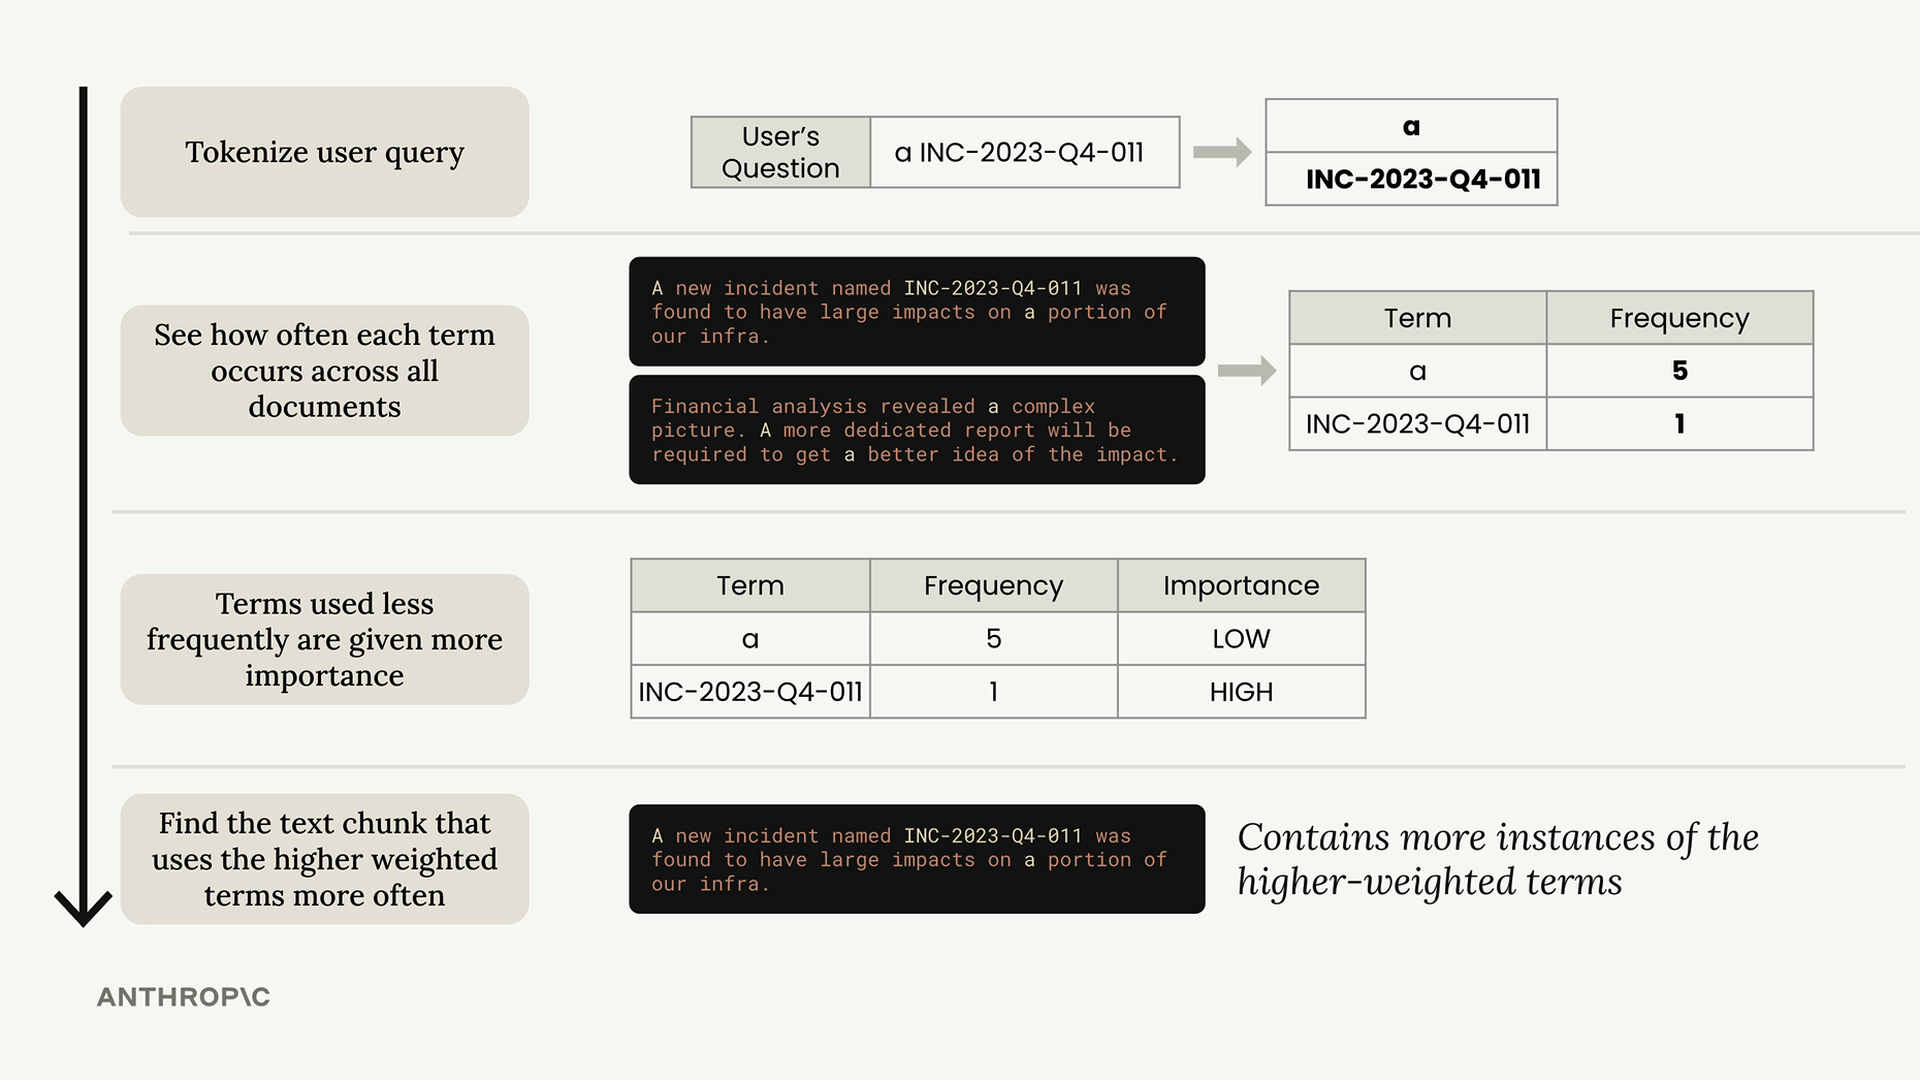
L'algorithme suit ces étapes clés :
- Tokeniser la requête - Décomposer la question de l'utilisateur en termes individuels
- Compter la fréquence des termes - Voir à quelle fréquence chaque terme apparaît dans tous les documents
- Pondérer les termes par rareté - Les termes moins fréquemment utilisés obtiennent des scores d'importance plus élevés
- Trouver les meilleures correspondances - Renvoyer les segments qui contiennent davantage d'occurrences des termes les plus fortement pondérés
L'idée clé est que les termes rares comme « INC-2023-Q4-011 » sont bien plus importants pour la recherche que les mots courants comme « a » ou « le ».
Mise en œuvre de la recherche BM25
Voici comment configurer un système de recherche BM25 :
# Créer un magasin BM25
store = BM25Index()

# Ajouter des documents au magasin
for chunk in chunks:
    store.add_document({"content": chunk})

# Rechercher dans le magasin
results = store.search("What happened with INC-2023-Q4-011?", 3)
L'implémentation BM25 fournit la même API que votre système de recherche sémantique - les deux disposent des méthodes add_document() et search(), ce qui les rend faciles à utiliser ensemble.
De meilleurs résultats de recherche
Lorsque vous exécutez la même requête via BM25 qui a échoué avec la recherche sémantique seule, vous obtenez de bien meilleurs résultats. Au lieu de renvoyer des sections non pertinentes, BM25 donne la priorité aux sections qui contiennent effectivement vos termes de recherche spécifiques.
L'algorithme identifie correctement que « INC-2023-Q4-011 » est un terme rare et important, et classe les documents qui le contiennent bien plus haut que les documents ne contenant que des mots courants de la requête.
Prochaines étapes
Maintenant que vous disposez de systèmes de recherche sémantique et lexicale fonctionnant indépendamment, l'étape suivante consiste à fusionner leurs résultats. Cette approche hybride vous offre le meilleur des deux mondes - la compréhension contextuelle de la recherche sémantique combinée à la précision de la correspondance exacte des termes de la recherche lexicale.
Les deux systèmes de recherche utilisent des API similaires, ce qui permet d'interroger facilement les deux en parallèle et de combiner leurs résultats en un seul ensemble de résultats plus complet.