La réflexion étendue est la fonctionnalité de raisonnement avancé de Claude qui donne au modèle le temps de réfléchir à des problèmes complexes avant de générer une réponse. Lorsqu'elle est activée, Claude produit un processus de réflexion visible que les utilisateurs peuvent examiner pour comprendre comment le modèle a abordé leur requête.
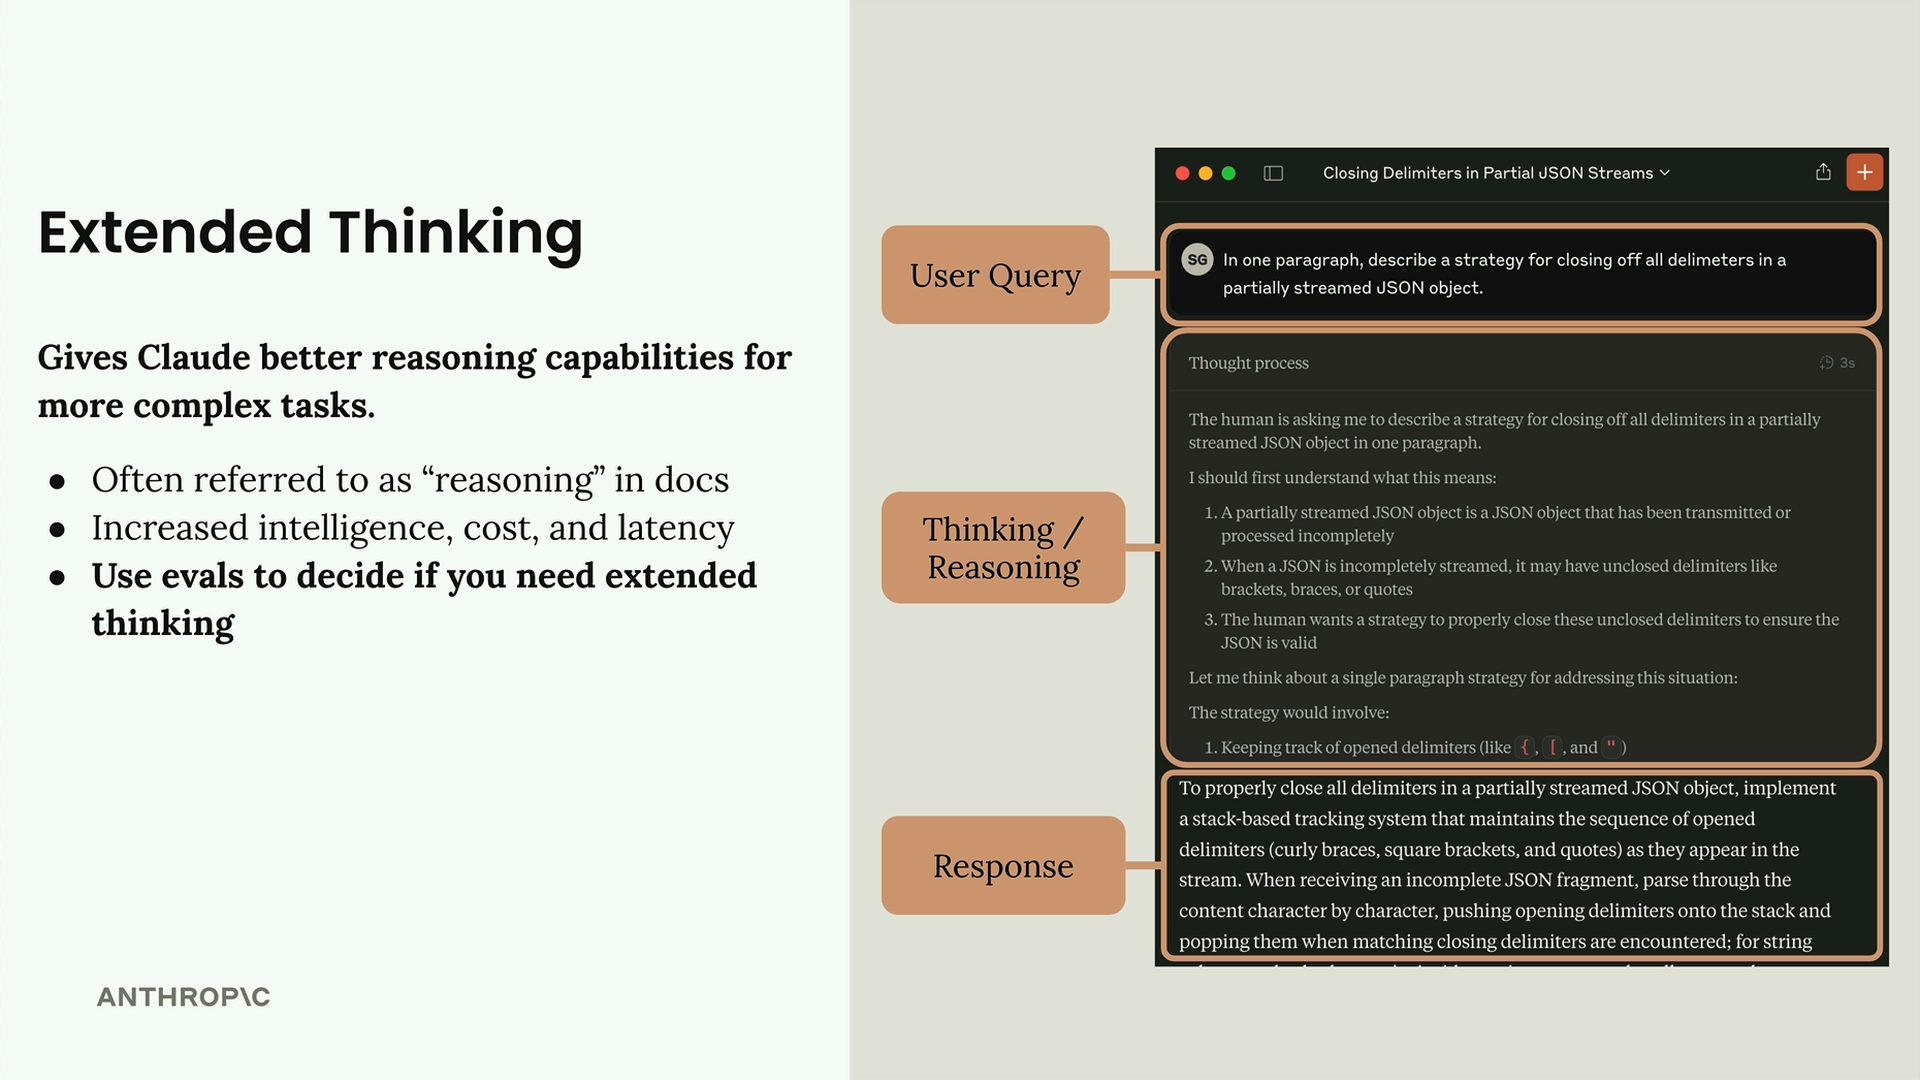
Cette fonctionnalité améliore considérablement la capacité de Claude à gérer des tâches complexes avec une plus grande précision, mais elle s'accompagne de compromis importants. Vous serez facturé pour tous les jetons générés pendant la phase de réflexion, et le temps de traitement supplémentaire augmente la latence de la réponse. L'essentiel est de savoir quand l'amélioration de l'intelligence justifie le coût et le temps d'attente supplémentaires.
Quand utiliser la réflexion étendue
La décision d'activer la réflexion étendue doit être guidée par vos évaluations de requêtes. Voici l'approche recommandée :
- Rédigez et testez d'abord votre requête sans réflexion étendue
- Exécutez des évaluations pour mesurer la précision
- Si les résultats ne répondent pas à vos exigences après des efforts d'optimisation de la requête
- Envisagez alors d'activer la réflexion étendue comme solution
Comment la réflexion étendue modifie les réponses
Sans réflexion étendue, le déroulement des réponses de Claude est simple : vous envoyez un message utilisateur contenant un bloc de texte et vous recevez en retour un message d'assistant contenant un bloc de texte.
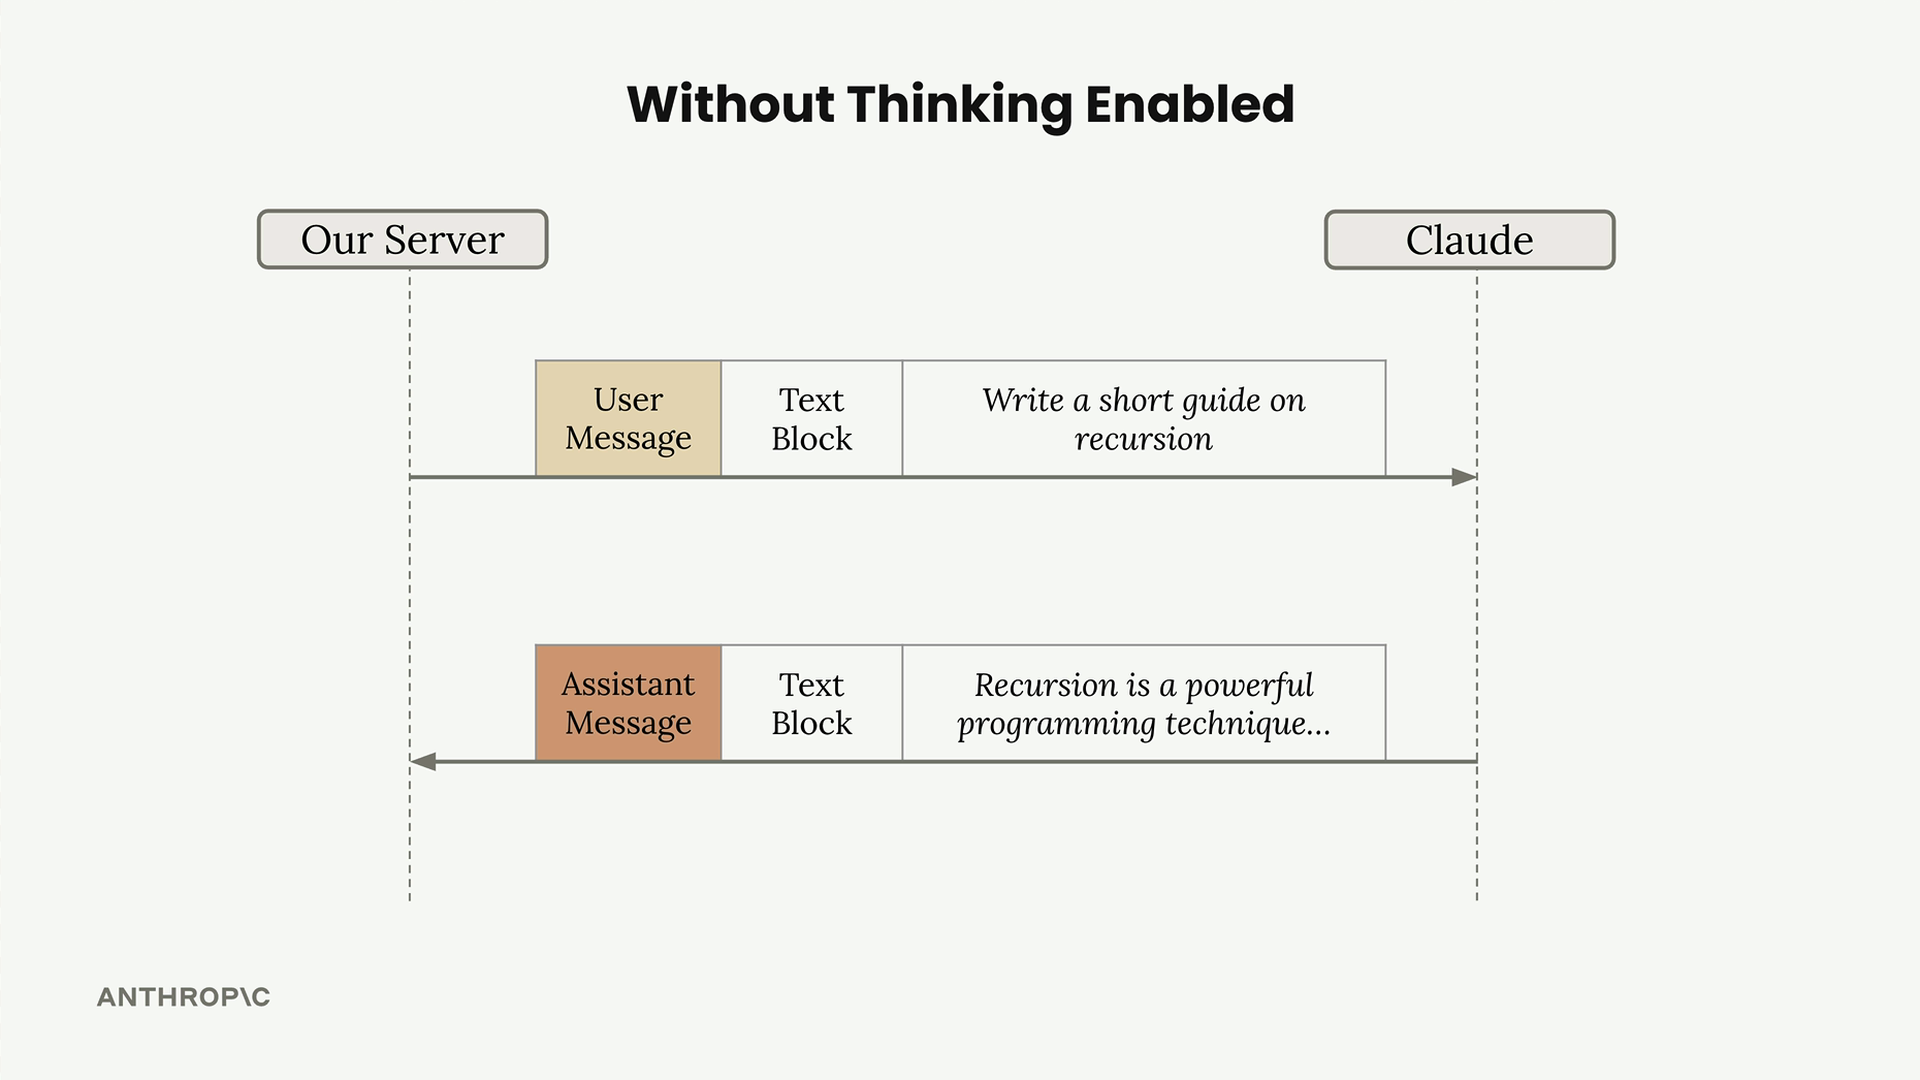
Lorsque la réflexion étendue est activée, la structure de la réponse change de manière significative. Vous recevrez un message d'assistant contenant deux blocs distincts :
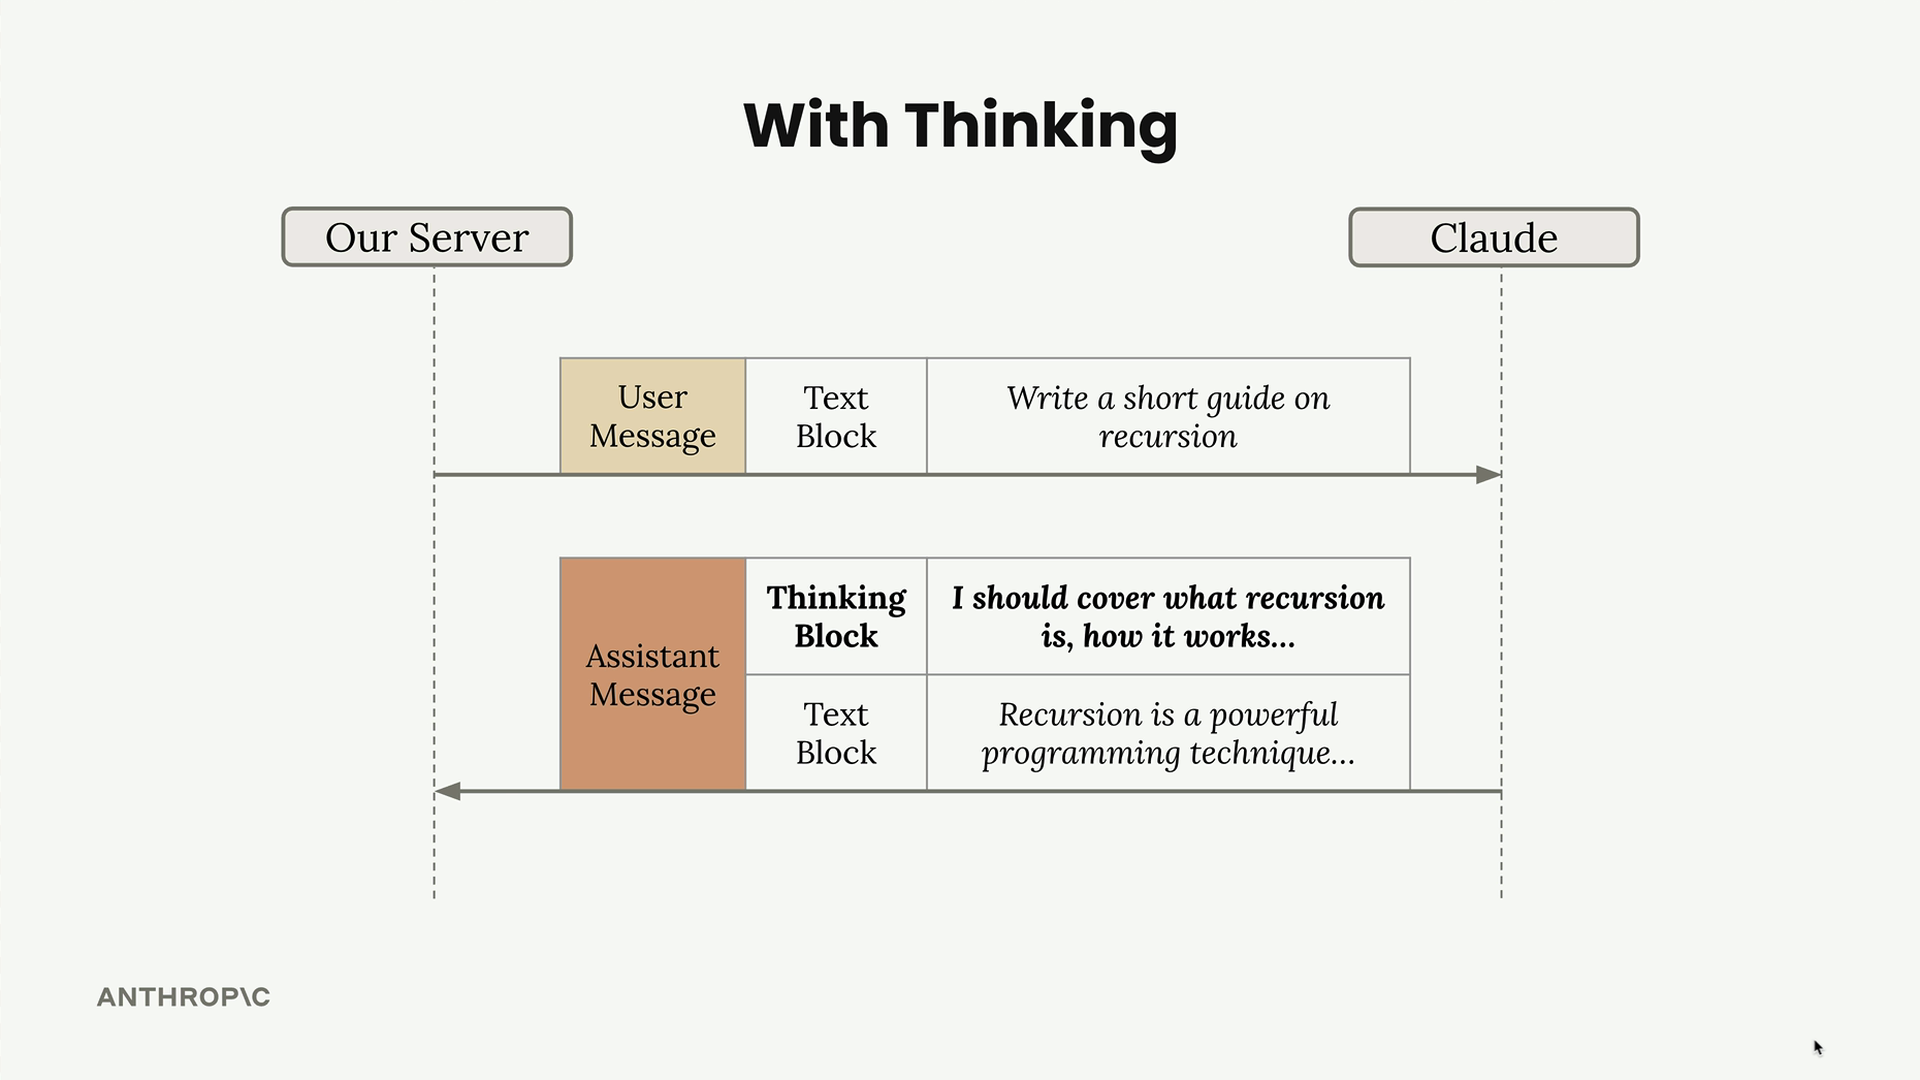
- Un bloc
thinkingcontenant le processus de raisonnement de Claude - Un bloc
textcontenant la réponse finale
Le système de signature
Chaque bloc de réflexion inclut une signature cryptographique qui remplit un objectif de sécurité important. Cette signature garantit que le texte de réflexion n'a pas été modifié lorsque vous incluez le message dans de futurs tours de conversation.
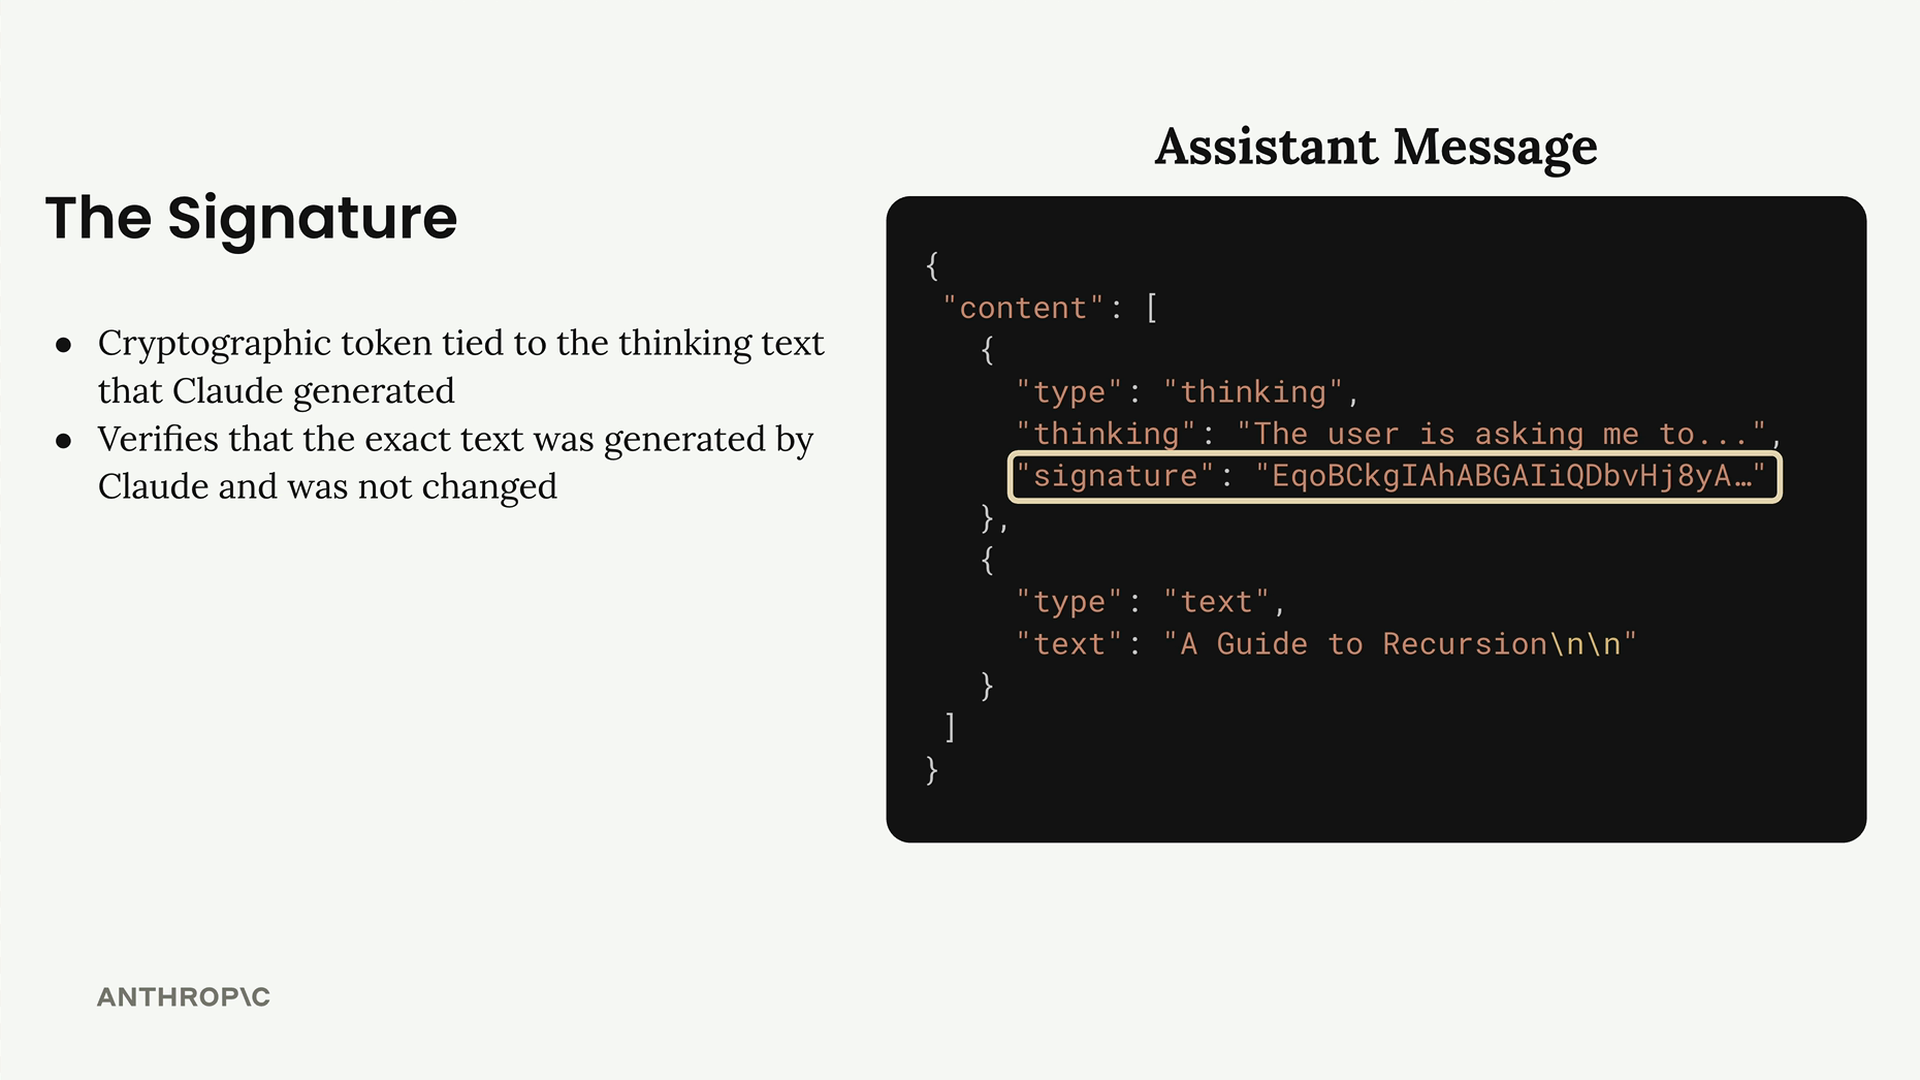
Claude s'appuie fortement sur le contenu de la réflexion pour générer ses réponses. Il est donc essentiel d'empêcher toute altération afin de maintenir un comportement sûr et cohérent. Si vous modifiez le texte de réflexion, la validation de la signature échouera.
Réflexion masquée
Il arrive que le processus de réflexion de Claude soit signalé par les systèmes de sécurité internes. Dans ce cas, vous recevrez un bloc de réflexion masquée au lieu du texte de réflexion brut.
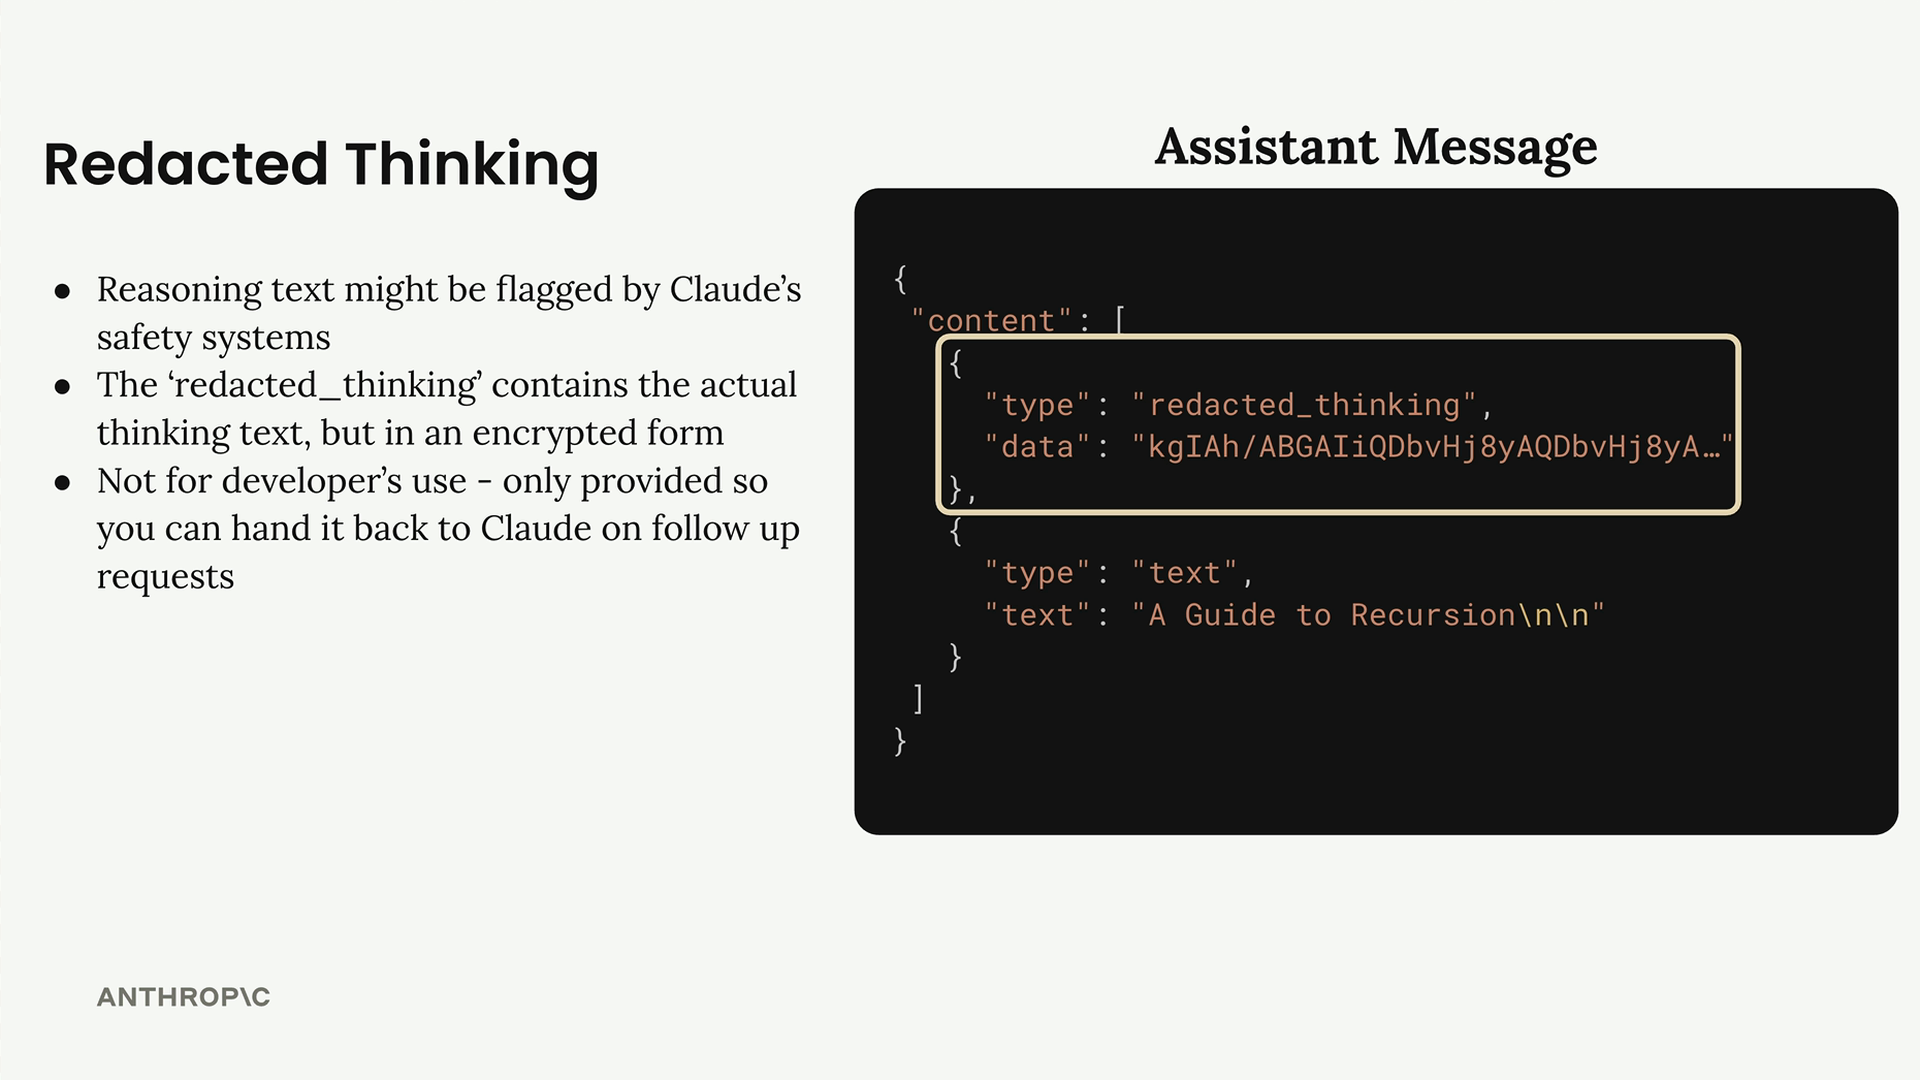
Le contenu masqué contient le texte de réflexion réel sous forme chiffrée. Bien que vous ne puissiez pas le lire, vous pouvez tout de même l'inclure dans de futurs tours de conversation afin que Claude ne perde pas le contexte de son raisonnement précédent.
Mise en œuvre
Pour activer la réflexion étendue dans votre code, vous devrez modifier votre fonction de chat avec deux nouveaux paramètres :
def chat(
    messages,
    system=None,
    temperature=1.0,
    stop_sequences=[],
    tools=None,
    thinking=False,
    thinking_budget=1024
):
Le budget de réflexion représente le nombre maximal de jetons que Claude peut utiliser pour le raisonnement. La valeur minimale autorisée est de 1024 jetons. Il est important de noter que votre paramètre max_tokens doit dépasser votre budget de réflexion : si vous définissez un budget de réflexion de 1024, max_tokens doit être d'au moins 1025.
En pratique, vous voudrez une marge bien plus importante. Par exemple, avec un budget de réflexion de 1024 et un max_tokens de 4000, Claude peut utiliser jusqu'à 1024 jetons pour la réflexion et jusqu'à 2976 jetons pour la réponse proprement dite.
Ajoutez la configuration de réflexion à vos paramètres d'API lorsque la fonctionnalité est activée :
if thinking:
    params["thinking"] = {
        "type": "enabled",
        "budget_tokens": thinking_budget
    }
Tester les réponses masquées
Pendant le développement, vous voudrez peut-être tester la manière dont votre application gère les blocs de réflexion masquée. Vous pouvez forcer Claude à renvoyer une réponse masquée en incluant cette chaîne de déclenchement spéciale dans votre message :
TRIGGER_REDACTED_THINKING_46C9A13E193C177646C7398A98432ECCCE4C1253D5E2D82641AC0E52CC2876CBCela garantit que votre gestion des erreurs fonctionne correctement lorsque vous rencontrez du contenu masqué en production.