La création d'un serveur MCP devient beaucoup plus simple lorsque vous utilisez le SDK Python officiel. Au lieu d'écrire des schémas JSON complexes à la main, vous pouvez définir des outils avec des décorateurs et laisser le SDK faire le gros du travail.
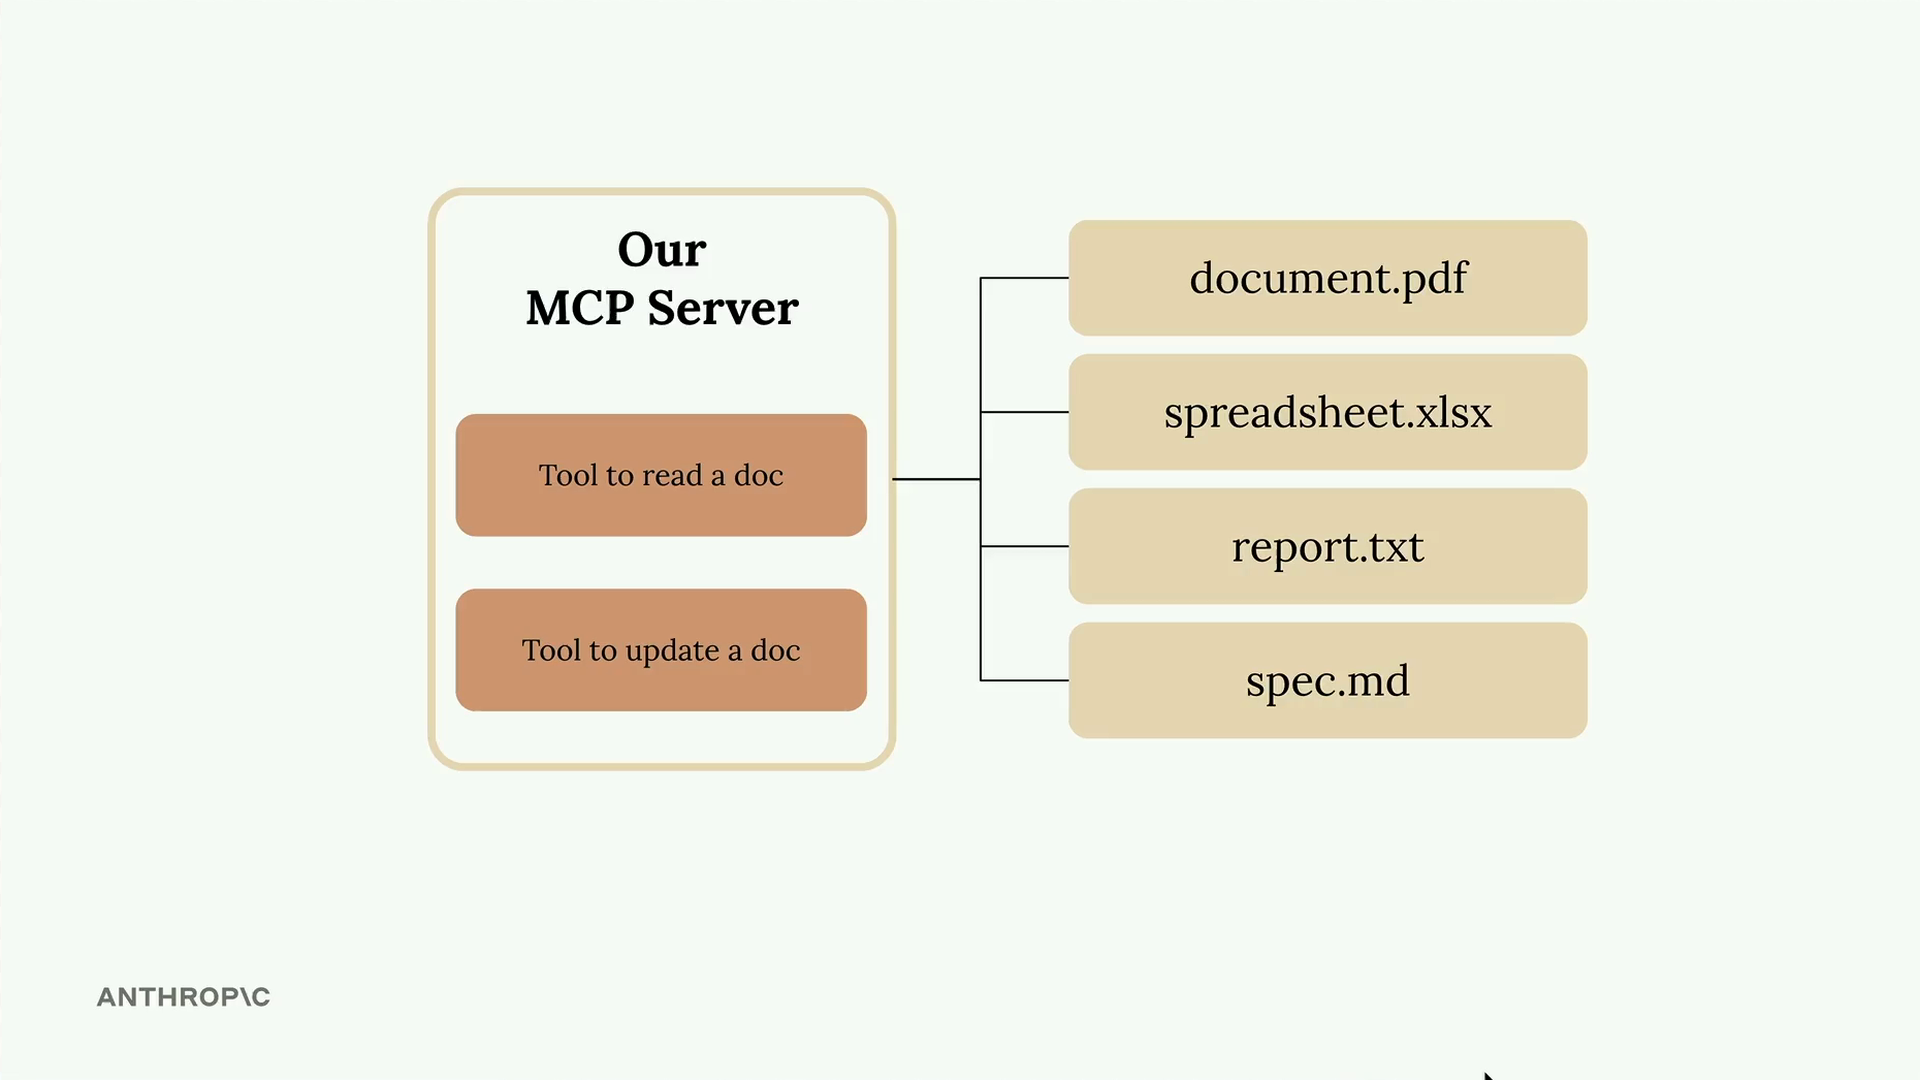
Dans cet exemple, nous créons un serveur de gestion de documents avec deux outils principaux : l'un pour lire des documents et l'autre pour les mettre à jour. Tous les documents existent en mémoire sous forme d'un simple dictionnaire où les clés sont des identifiants de documents et les valeurs sont le contenu.
Configuration du serveur MCP
Le projet utilise la version 1 du SDK Python MCP, et sa configuration installe cette version pour vous. Si vous configurez votre propre projet, installez "mcp[cli]<2". La version 2 a renommé FastMCP en MCPServer, de sorte que l'import ci-dessous échoue avec elle.
Le SDK Python MCP simplifie grandement la création de serveurs. Vous pouvez initialiser un serveur en une seule ligne :
from mcp.server.fastmcp import FastMCP
from pydantic import Field

mcp = FastMCP("DocumentMCP", log_level="ERROR")
Cela crée un serveur MCP pleinement fonctionnel capable de gérer les définitions d'outils, les connexions des clients et le routage des messages.
Définition d'outils avec des décorateurs
L'approche par décorateurs du SDK élimine le besoin d'écrire manuellement des schémas JSON. Voici comment définir un outil simple :
@mcp.tool(
    name="add_ints",
    description="Add two integers together",
)
def tool_fn(
    a=Field(description="First number to add"),
    b=Field(description="Second number to add"),
) -> int:
    return a + b
En coulisses, MCP génère le schéma d'outil complet dont Claude a besoin pour comprendre quand et comment utiliser votre outil.
Construction de l'outil de lecture de documents
Le premier outil lit le contenu d'un document par son identifiant. Il prend un identifiant de document et renvoie le contenu correspondant depuis notre dictionnaire en mémoire :
@mcp.tool(
    name="read_doc_contents",
    description="Read the contents of a document and return it as a string."
)
def read_document(
    doc_id: str = Field(description="Id of the document to read")
):
    if doc_id not in docs:
        raise ValueError(f"Doc with id {doc_id} not found")

    return docs[doc_id]
La fonction inclut une gestion des erreurs de base pour intercepter les demandes de documents inexistants. Lorsque Claude appelle cet outil avec un identifiant de document valide, il reçoit le contenu intégral du document sous forme de chaîne de caractères.
Création de l'outil d'édition de documents
Le second outil effectue de simples opérations de recherche et de remplacement sur les documents. Il nécessite trois paramètres : l'identifiant du document, le texte à rechercher et le texte de remplacement :
@mcp.tool(
    name="edit_document",
    description="Edit a document by replacing a string in the documents content with a new string."
)
def edit_document(
    doc_id: str = Field(description="Id of the document that will be edited"),
    old_str: str = Field(description="The text to replace. Must match exactly, including white space."),
    new_str: str = Field(description="The new text to insert in place of the old text.")
):
    if doc_id not in docs:
        raise ValueError(f"Doc with id {doc_id} not found")

    docs[doc_id] = docs[doc_id].replace(old_str, new_str)
Cette implémentation utilise la méthode intégrée replace des chaînes de caractères en Python, qui nécessite des correspondances exactes, espaces compris. L'outil modifie le document directement dans notre dictionnaire.
Principaux avantages de l'approche par SDK
- Aucune écriture manuelle de schéma JSON requise
- Les indications de type fournissent une validation automatique des paramètres
- Les descriptions de champs aident Claude à comprendre l'utilisation de l'outil
- La gestion des erreurs s'intègre naturellement avec les exceptions Python
- L'enregistrement des outils se fait automatiquement grâce aux décorateurs
Le SDK Python MCP transforme la création d'outils, qui passe d'un exercice complexe d'écriture de schémas à de simples définitions de fonctions Python. Vos outils deviennent plus faciles à maintenir et à tester, tandis que Claude obtient toutes les métadonnées dont il a besoin pour les utiliser efficacement.