Les ressources dans MCP permettent à votre serveur d'exposer des données pouvant être directement incluses dans les requêtes, plutôt que de nécessiter des appels d'outils pour accéder aux informations. Cela crée un moyen plus efficace de fournir du contexte aux modèles d'IA comme Claude.
Comprendre le flux de ressources
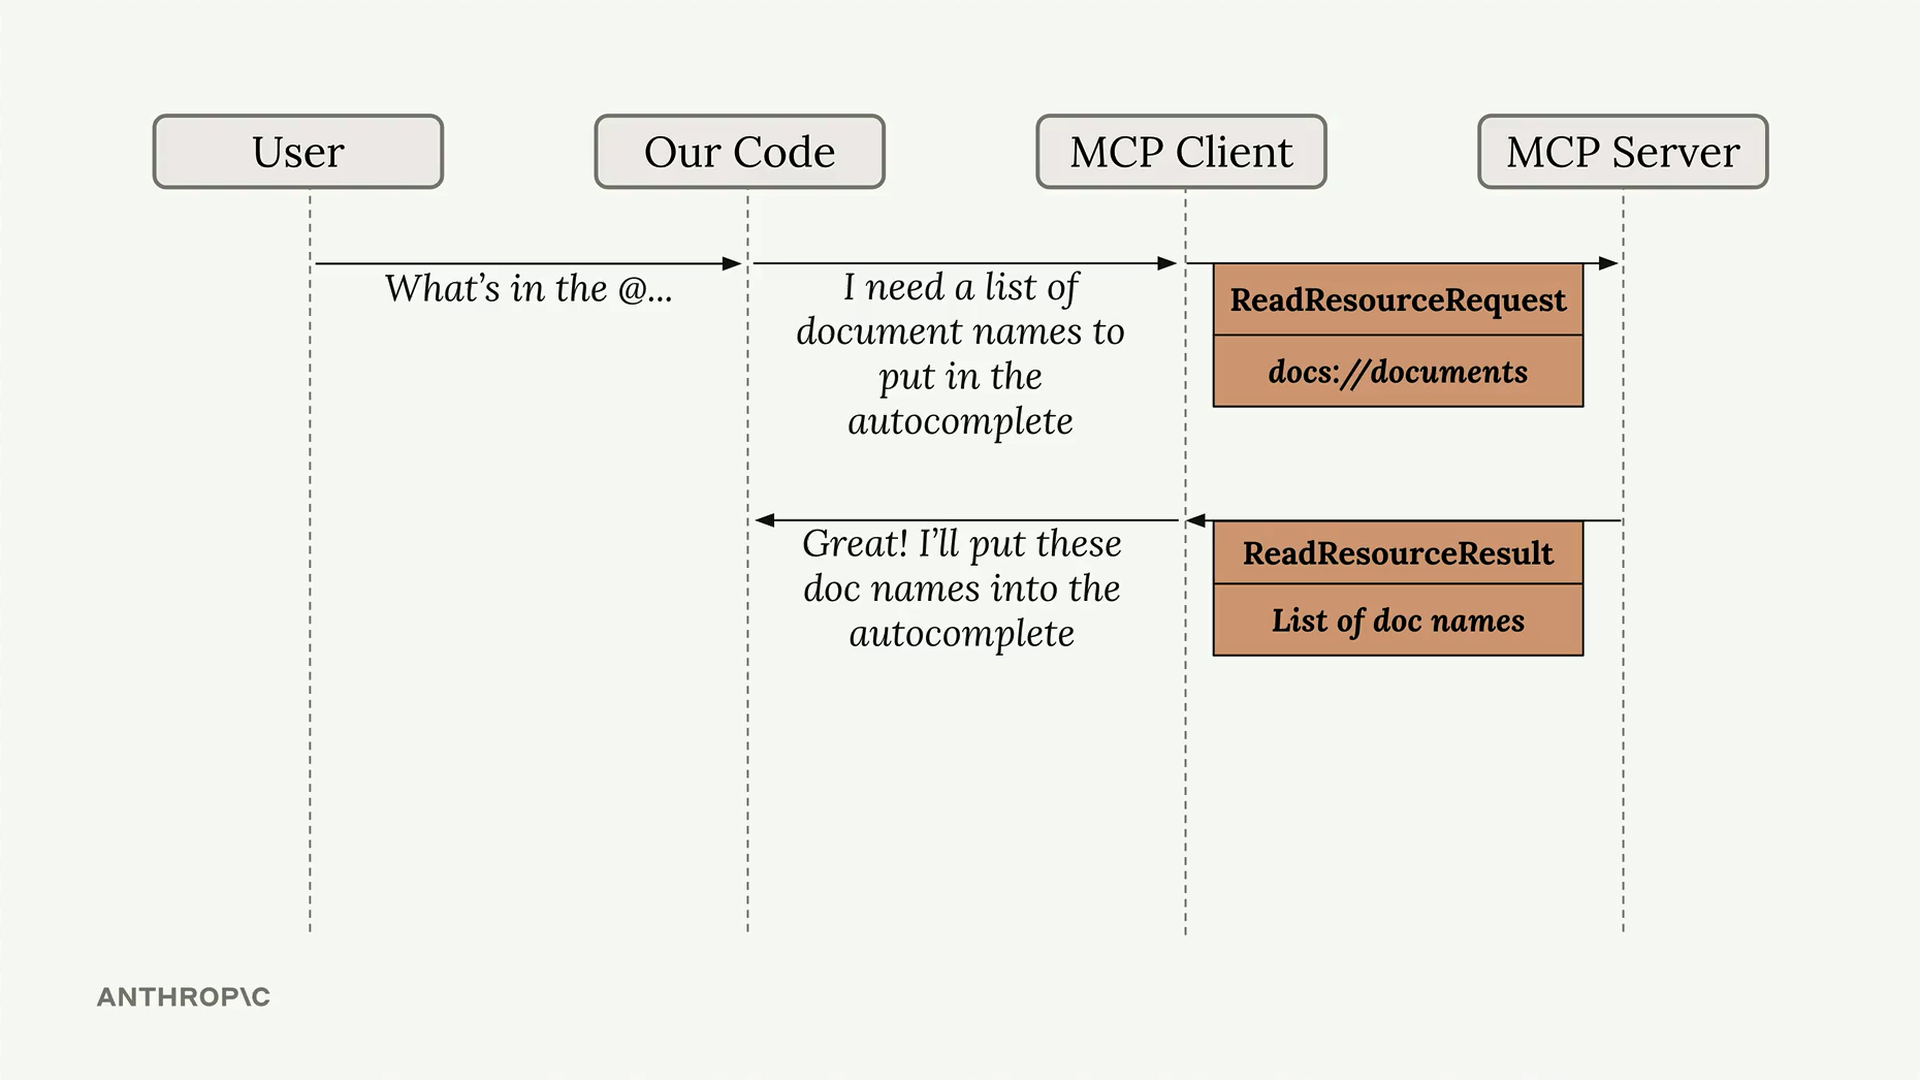
Lorsqu'un utilisateur souhaite accéder au contenu d'une ressource, le flux fonctionne ainsi :
- L'utilisateur demande des informations sur une ressource (par exemple « @report.pdf »)
- Votre code a besoin d'une liste de noms de documents pour l'autocomplétion
- Le client MCP envoie une ReadResourceRequest au serveur MCP
- Le serveur répond avec un ReadResourceResult contenant les données de la ressource
- Votre code peut ensuite placer ces données directement dans les requêtes
Implémenter la lecture de ressources
Pour lire des ressources depuis votre client MCP, vous devrez implémenter une fonction read_resource. D'abord, ajoutez les imports nécessaires :
import json
from pydantic import AnyUrl
La fonction principale effectue une requête vers votre session MCP et traite la réponse :
async def read_resource(self, uri: str) -> Any:
    result = await self.session().read_resource(AnyUrl(uri))
    resource = result.contents[0]
Gérer différents types de ressources
Les ressources peuvent renvoyer différents types de contenu, vous devez donc vérifier le type MIME et analyser le contenu en conséquence :
if isinstance(resource, types.TextResourceContents):
    if resource.mimeType == "application/json":
        return json.loads(resource.text)

    return resource.text
Cette approche gère deux scénarios principaux :
- Les ressources JSON qui nécessitent une analyse
- Les ressources en texte brut qui peuvent être renvoyées telles quelles
Tester l'accès aux ressources
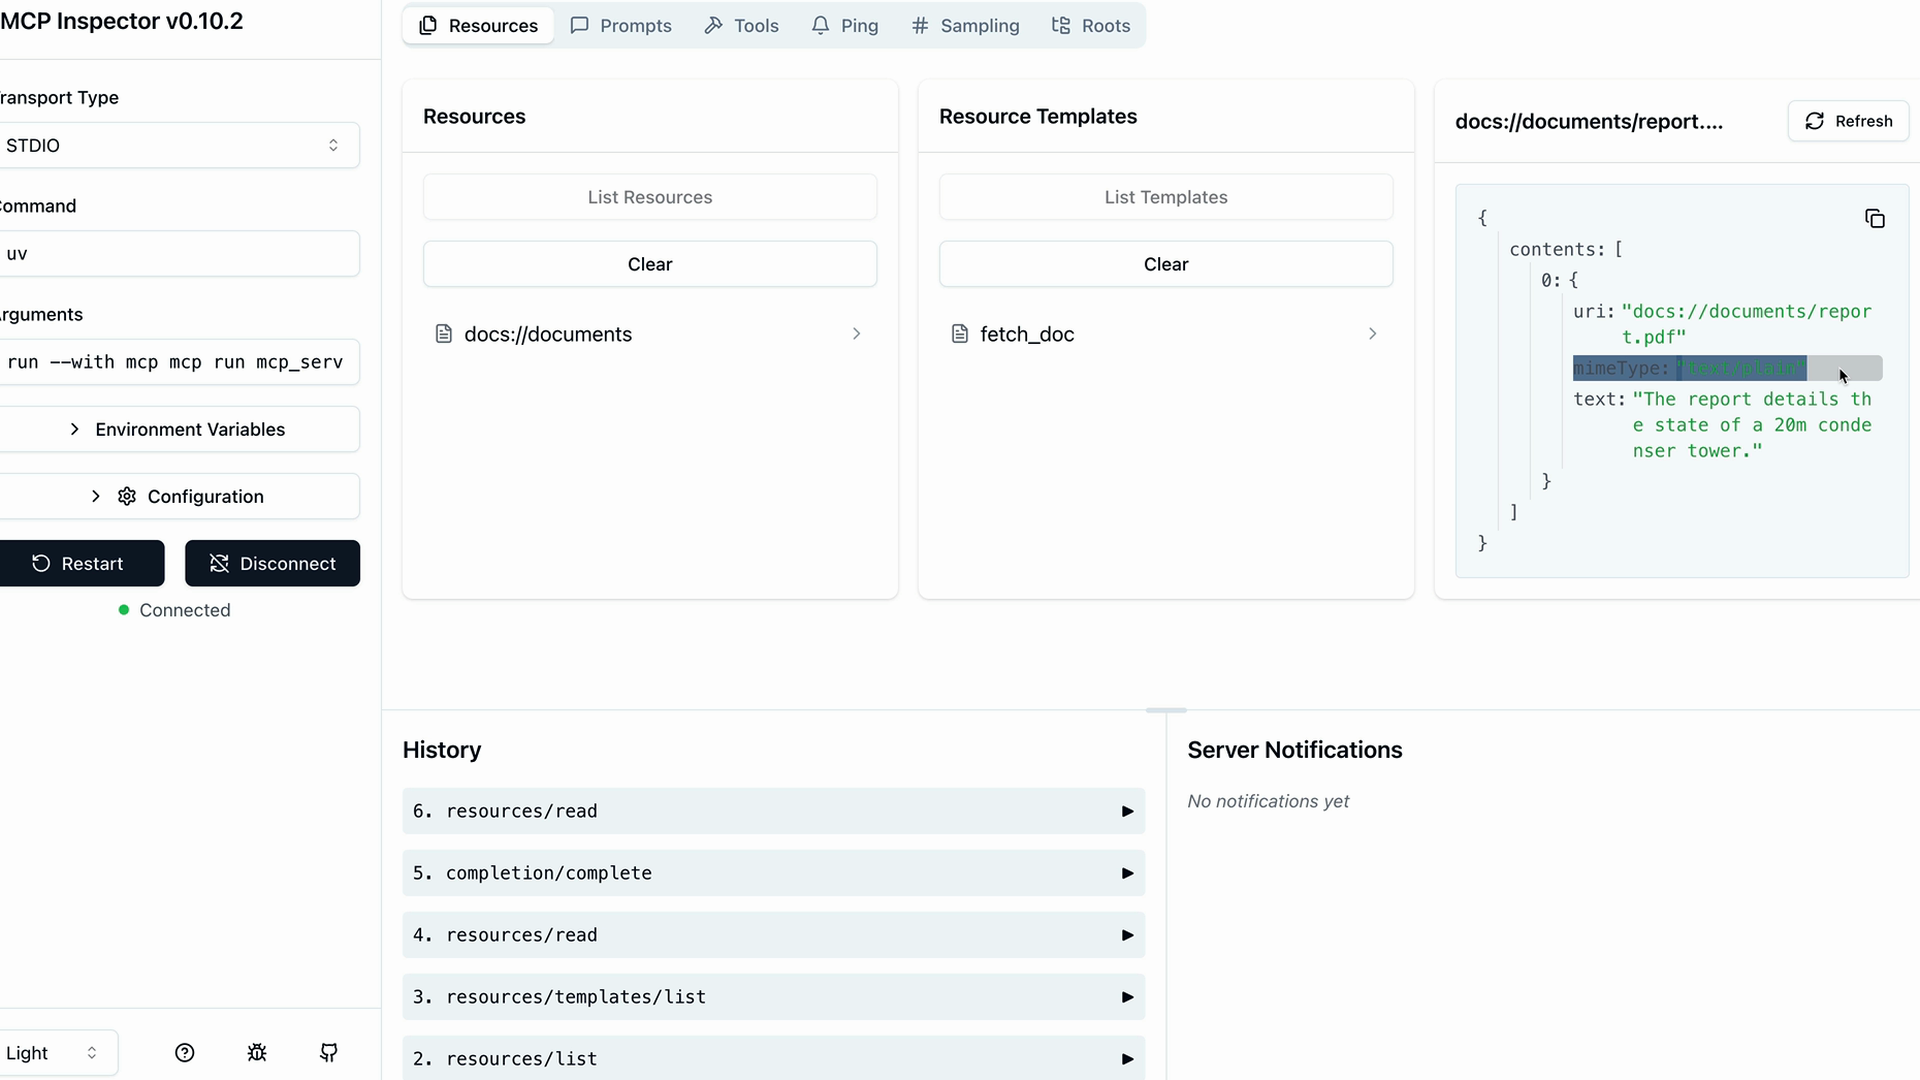
Vous pouvez vérifier que votre implémentation des ressources fonctionne en la testant dans votre application. Lorsque vous tapez « @ » suivi d'un nom de ressource, vous devriez voir une liste d'autocomplétion des ressources disponibles. En sélectionner une inclura son contenu directement dans votre requête.
L'avantage principal de cette approche est l'efficacité : Claude reçoit immédiatement le contenu du document sans avoir besoin d'effectuer d'appels d'outils supplémentaires pour accéder à l'information.
Ressource contre utilisation d'outils
Les ressources sont particulièrement utiles lorsque :
- Vous disposez d'un contenu statique ou semi-statique fréquemment référencé
- Vous souhaitez réduire le nombre d'appels API
- Le contenu doit être immédiatement disponible dans le contexte de la requête
Cela diffère des outils, qui sont plus adaptés aux opérations dynamiques ou lorsque vous avez besoin que l'IA décide d'accéder ou non à certaines informations en fonction du contexte de la conversation.