Lors de la création de flux de travail d'évaluation de requêtes, les systèmes de notation fournissent des signaux objectifs sur la qualité des résultats. Un évaluateur prend le résultat du modèle et renvoie une forme de retour mesurable - généralement un nombre entre 1 et 10, où 10 représente une qualité élevée et 1 une qualité médiocre.
Types d'évaluateurs
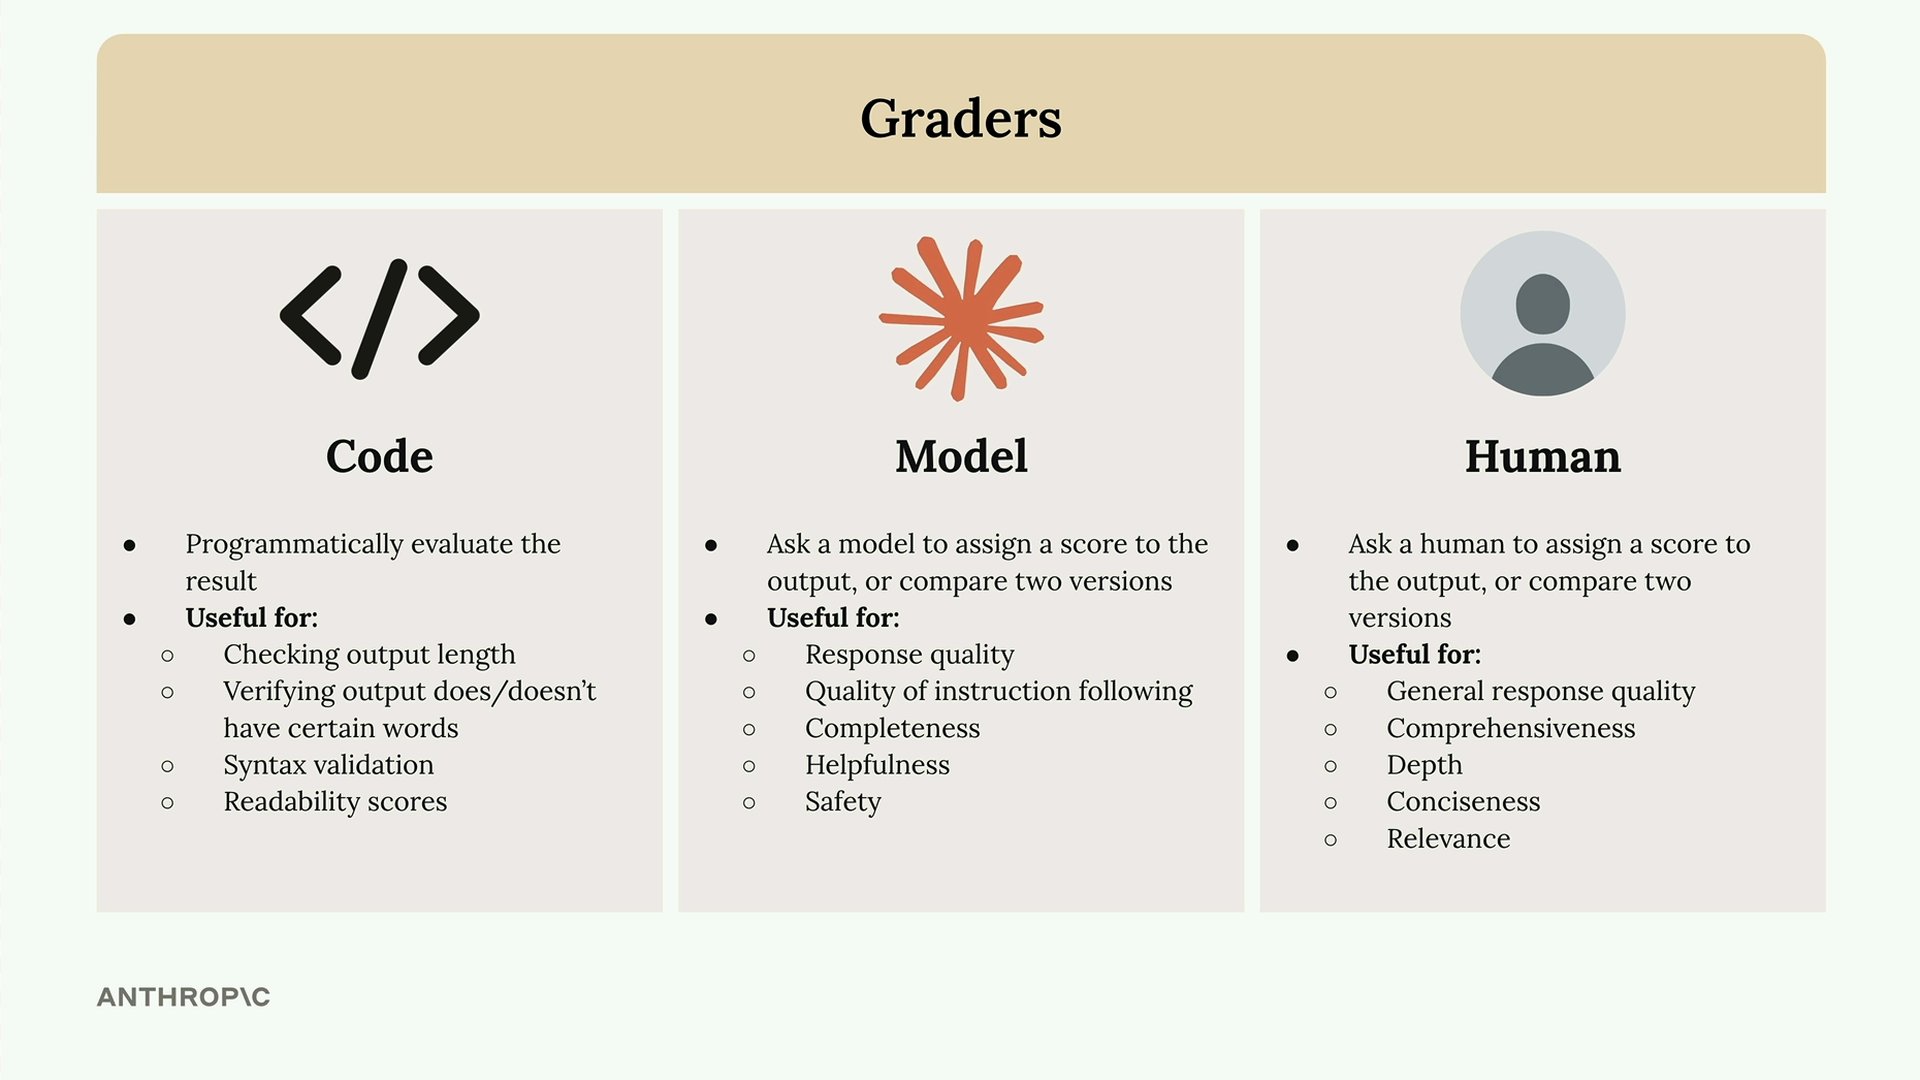
Il existe trois approches principales pour évaluer les résultats d'un modèle :
- Évaluateurs par code - Évaluent les résultats de manière programmatique à l'aide de code personnalisé
- Évaluateurs par modèle - Utilisent un autre modèle d'IA pour évaluer la qualité
- Évaluateurs humains - Font examiner et noter manuellement les résultats par des personnes
Évaluateurs par code
Les évaluateurs par code vous permettent d'implémenter toute vérification programmatique imaginable. Les usages courants incluent :
- La vérification de la longueur du résultat
- La vérification de la présence ou de l'absence de certains mots dans le résultat
- La validation de la syntaxe pour le JSON, Python ou les expressions régulières
- Les scores de lisibilité pour garantir des niveaux de lecture appropriés
Évaluateurs par modèle
Les évaluateurs par modèle offrent une flexibilité considérable en utilisant un appel API supplémentaire pour évaluer les résultats. Ils sont utiles pour évaluer :
- La qualité de la réponse
- La qualité du respect des instructions
- L'exhaustivité
- L'utilité
- La sécurité
Évaluateurs humains
Les évaluateurs humains offrent la plus grande flexibilité, mais présentent des inconvénients importants. Bien que les humains puissent évaluer les réponses selon n'importe quel critère imaginable, le processus est long et fastidieux.
Définir les critères d'évaluation
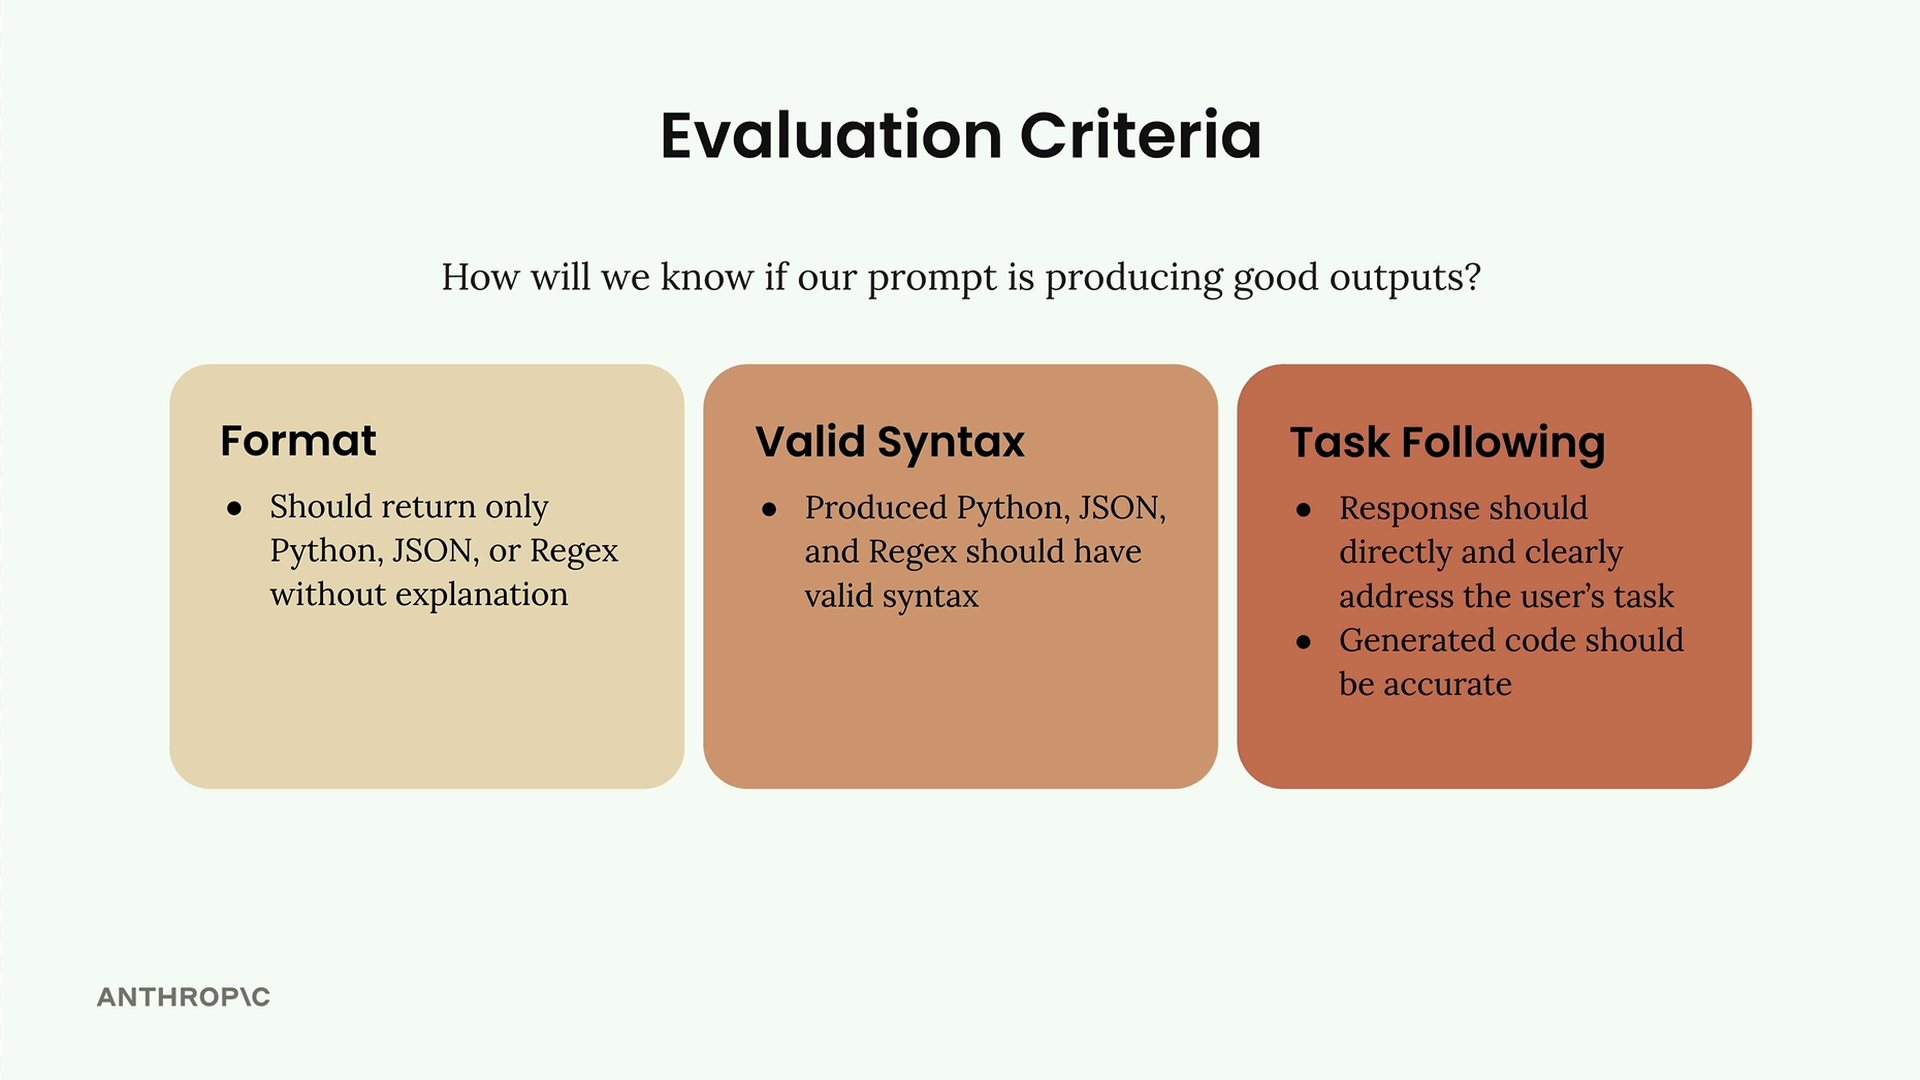
Avant de mettre en œuvre un évaluateur, vous devez disposer de critères d'évaluation clairs. Pour une requête de génération de code, vous pourriez vous concentrer sur :
- Format - Ne devrait renvoyer que du Python, du JSON ou une expression régulière, sans explication
- Syntaxe valide - Le code produit doit avoir une syntaxe valide
- Respect de la tâche - La réponse doit répondre directement à la tâche de l'utilisateur avec un code précis
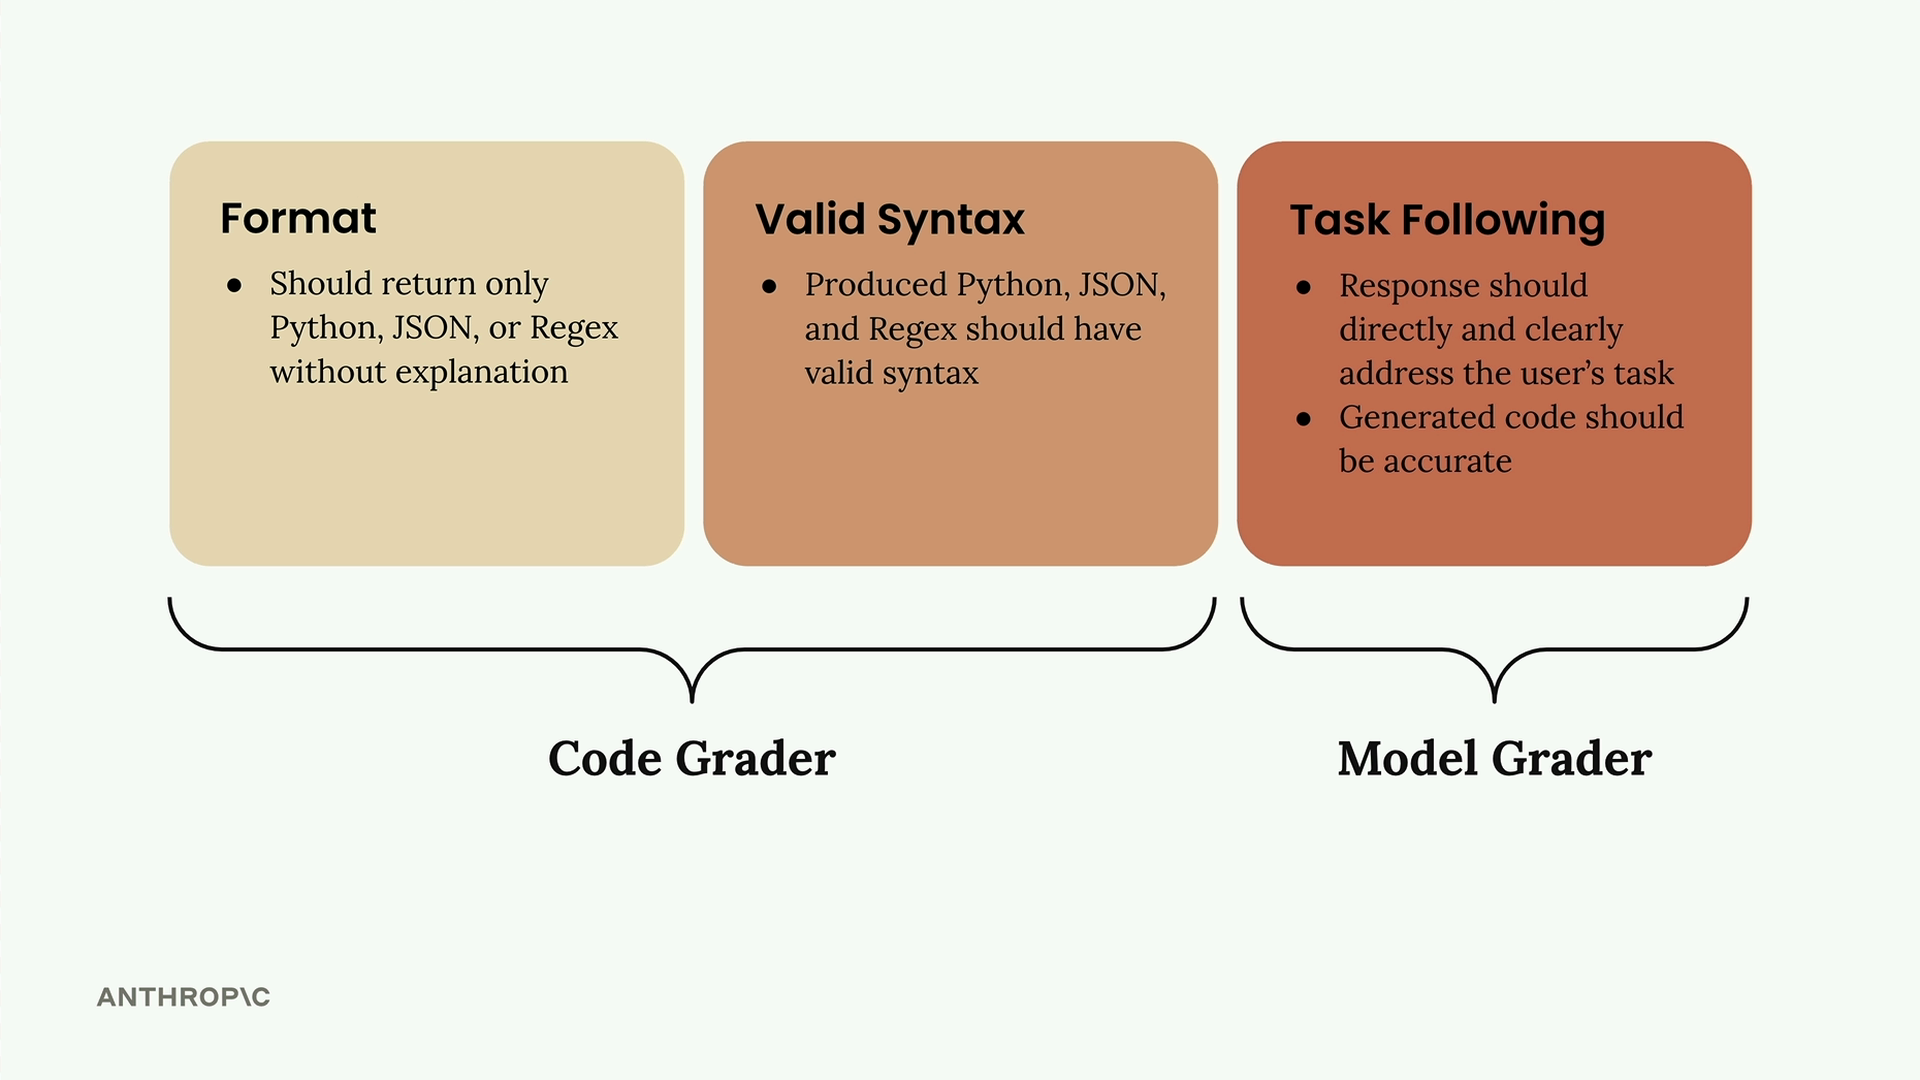
Les deux premiers critères fonctionnent bien avec les évaluateurs par code, tandis que le respect de la tâche convient mieux aux évaluateurs par modèle en raison de leur flexibilité.
Mettre en œuvre un évaluateur par modèle
Les évaluateurs par modèle sont souvent les plus simples à mettre en œuvre. Voici une structure de base :
def grade_by_model(test_case, output):
    eval_prompt = f"""
    You are an expert code reviewer. Evaluate this AI-generated solution.

    Task: {test_case["task"]}
    Solution: {output}

    Provide your evaluation as a structured JSON object with:
    - "strengths": An array of 1-3 key strengths
    - "weaknesses": An array of 1-3 key areas for improvement
    - "reasoning": A concise explanation of your assessment
    - "score": A number between 1-10
    """

    messages = []
    add_user_message(messages, eval_prompt)
    add_assistant_message(messages, "```json")
    eval_text = chat(messages, stop_sequences=["```"])
    return json.loads(eval_text)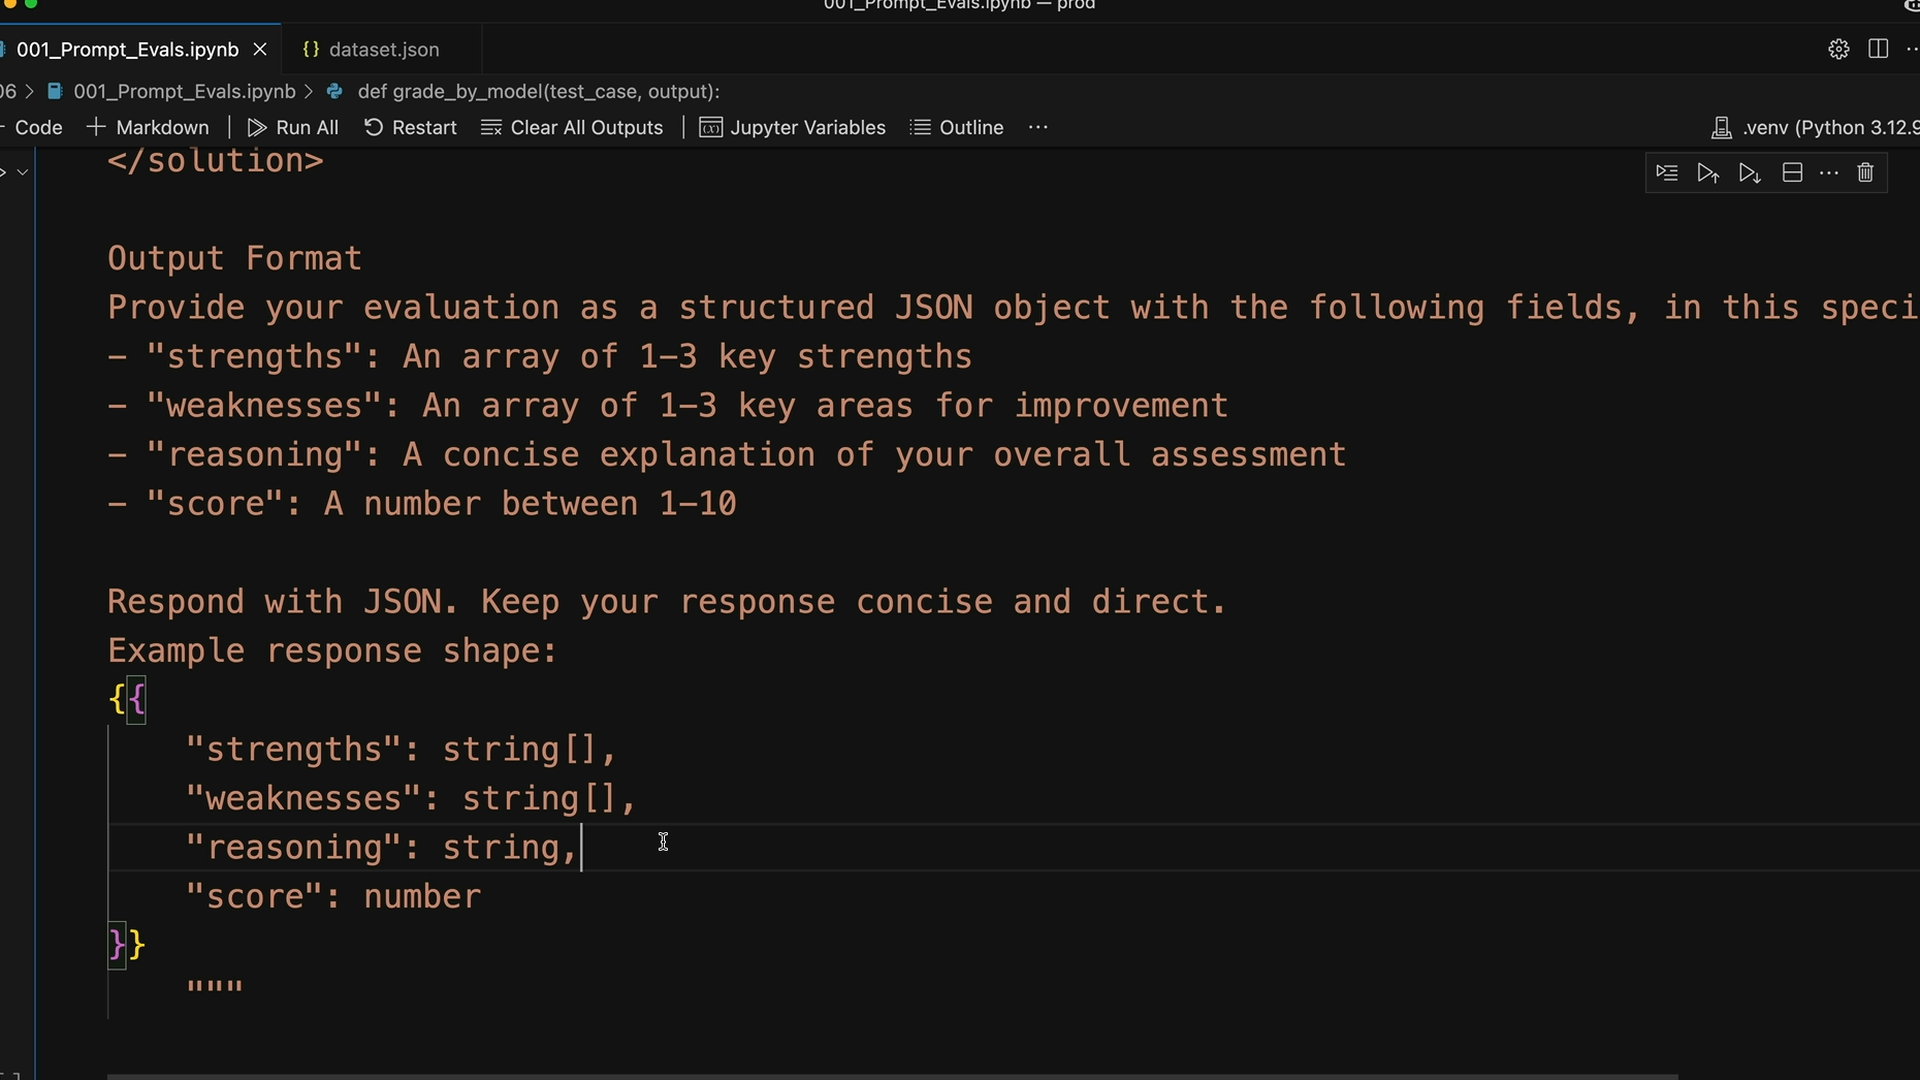
La requête de notation doit être complète et inclure :
- Une définition claire du rôle de l'évaluateur
- La tâche d'origine
- La solution générée par l'IA à évaluer
- Des exigences précises de format de sortie
Demandez plus qu'un simple score. Demandez les points forts, les points faibles et le raisonnement en plus du score numérique. Cela évite que le modèle ne se contente de scores moyens comme 6 et force une évaluation plus réfléchie.
Intégrer les évaluateurs dans votre flux de travail
Une fois que vous disposez d'une fonction d'évaluation, intégrez-la dans votre exécuteur de cas de test :
def run_test_case(test_case):
    output = run_prompt(test_case)

    # Appeler l'évaluateur du modèle
    model_grade = grade_by_model(test_case, output)
    score = model_grade["score"]
    reasoning = model_grade["reasoning"]

    return {
        "output": output,
        "test_case": test_case,
        "score": score,
        "reasoning": reasoning
    }
Après avoir exécuté tous les cas de test, calculez un score moyen pour obtenir une mesure objective de la performance de votre requête :
from statistics import mean

def run_eval(dataset):
    results = []
    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    average_score = mean([result["score"] for result in results])
    print(f"Average score: {average_score}")

    return results
Cela vous donne un nombre concret sur lequel concentrer vos efforts d'amélioration. Bien que les évaluateurs par modèle puissent être quelque peu capricieux et bénéficier d'un meilleur guidage, ils constituent un point de départ pour une évaluation objective que vous pouvez affiner et améliorer progressivement.