La génération augmentée par récupération (Retrieval Augmented Generation, ou RAG) est une technique qui vous aide à travailler avec de grands documents lorsque vous utilisez Claude. Plutôt que de faire tenir un rapport financier de 800 pages dans une seule requête, le RAG vous permet de trouver et d'inclure intelligemment uniquement les sections les plus pertinentes pour chaque question.
Le problème des documents volumineux
Imaginez que vous disposiez d'un document financier volumineux et que vous souhaitiez poser à Claude des questions précises à son sujet, telles que « Quels sont les facteurs de risque de cette entreprise ? ». Vous êtes alors confronté à un défi fondamental : comment faire parvenir à Claude les bonnes informations issues du document afin qu'il puisse répondre efficacement à votre question ?
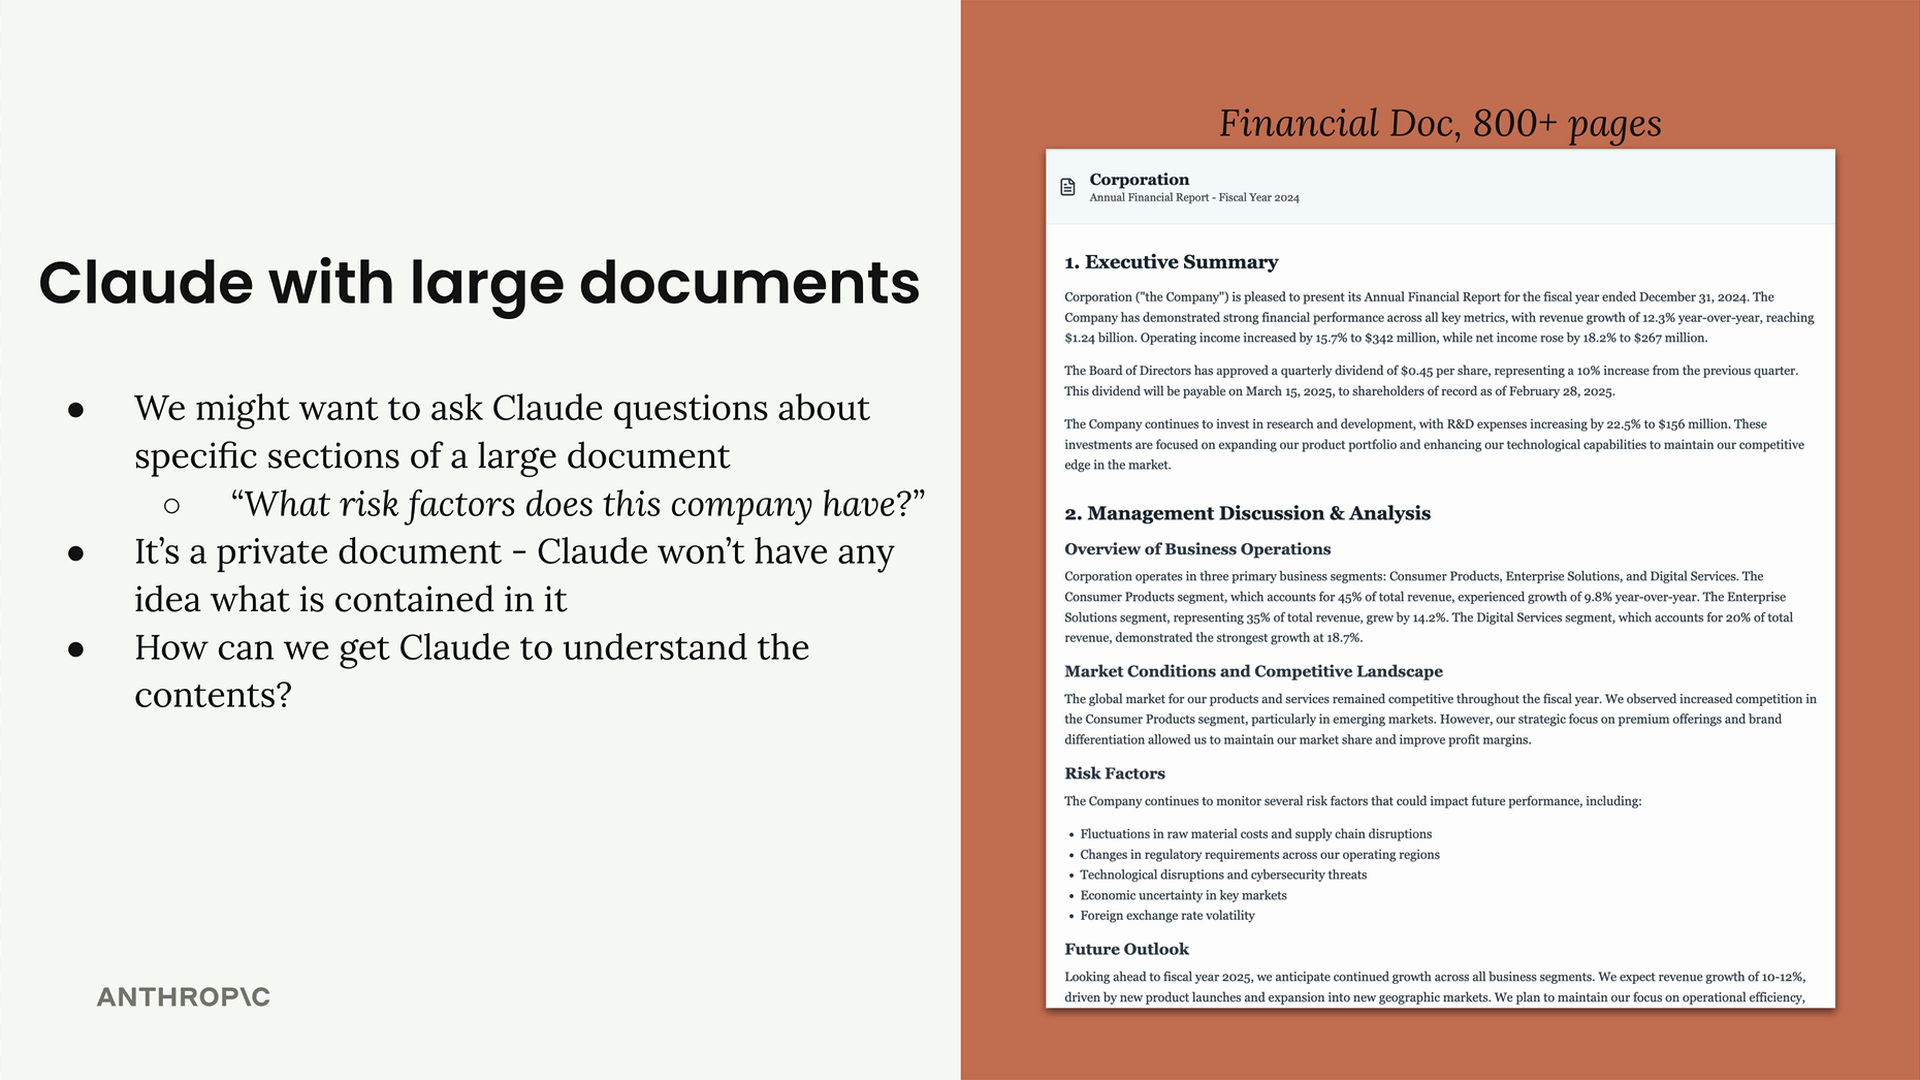
Option 1 : tout inclure dans la requête
La première approche semble simple : extraire tout le texte du document et l'insérer directement dans votre requête, accompagné de la question de l'utilisateur.
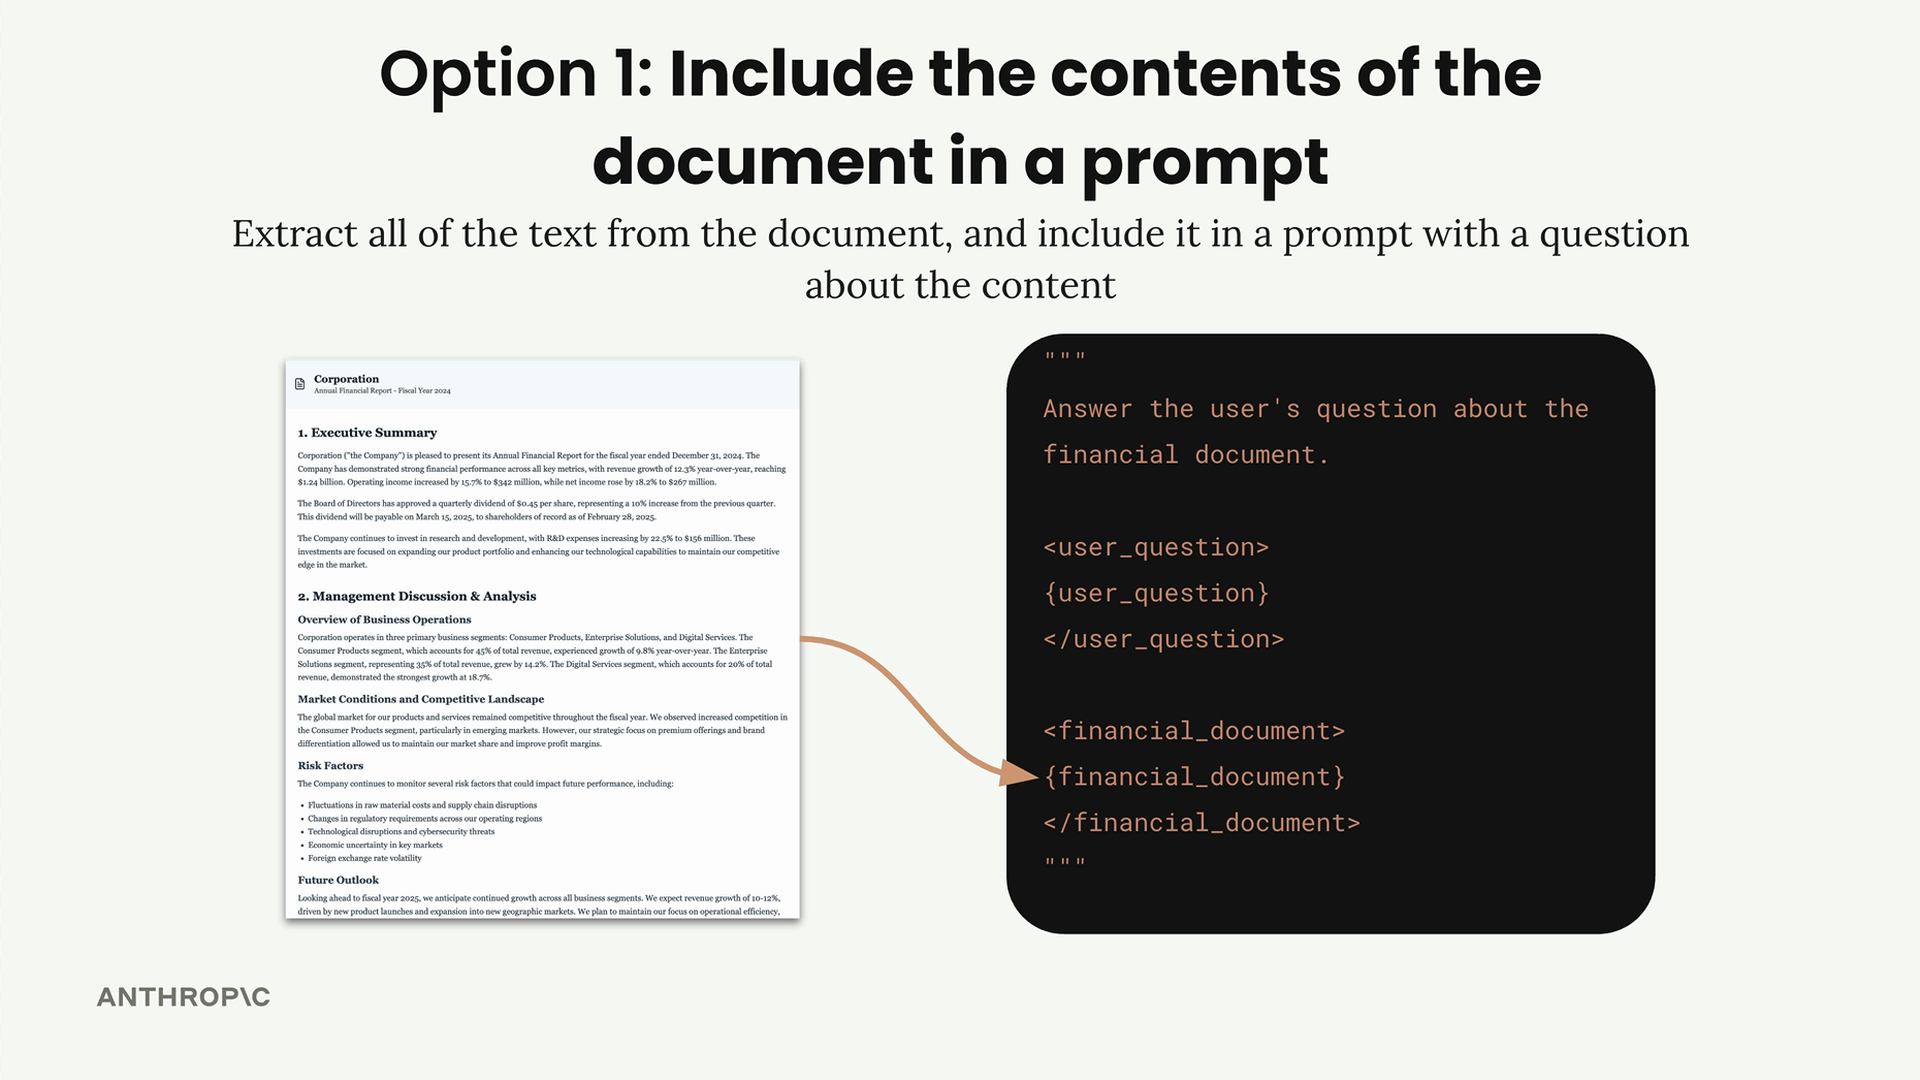
Cette approche pose plusieurs problèmes :
- Il existe une limite stricte quant à la quantité de texte que Claude peut traiter : votre document pourrait être trop long
- Claude devient moins performant avec des requêtes très longues
- Des requêtes plus volumineuses coûtent plus cher et prennent plus de temps à traiter
Option 2 : découper les documents en segments
La deuxième approche est plus sophistiquée. Vous découpez le document en segments plus petits lors d'une étape de prétraitement, puis vous trouvez et incluez uniquement les segments pertinents pour chaque question de l'utilisateur.
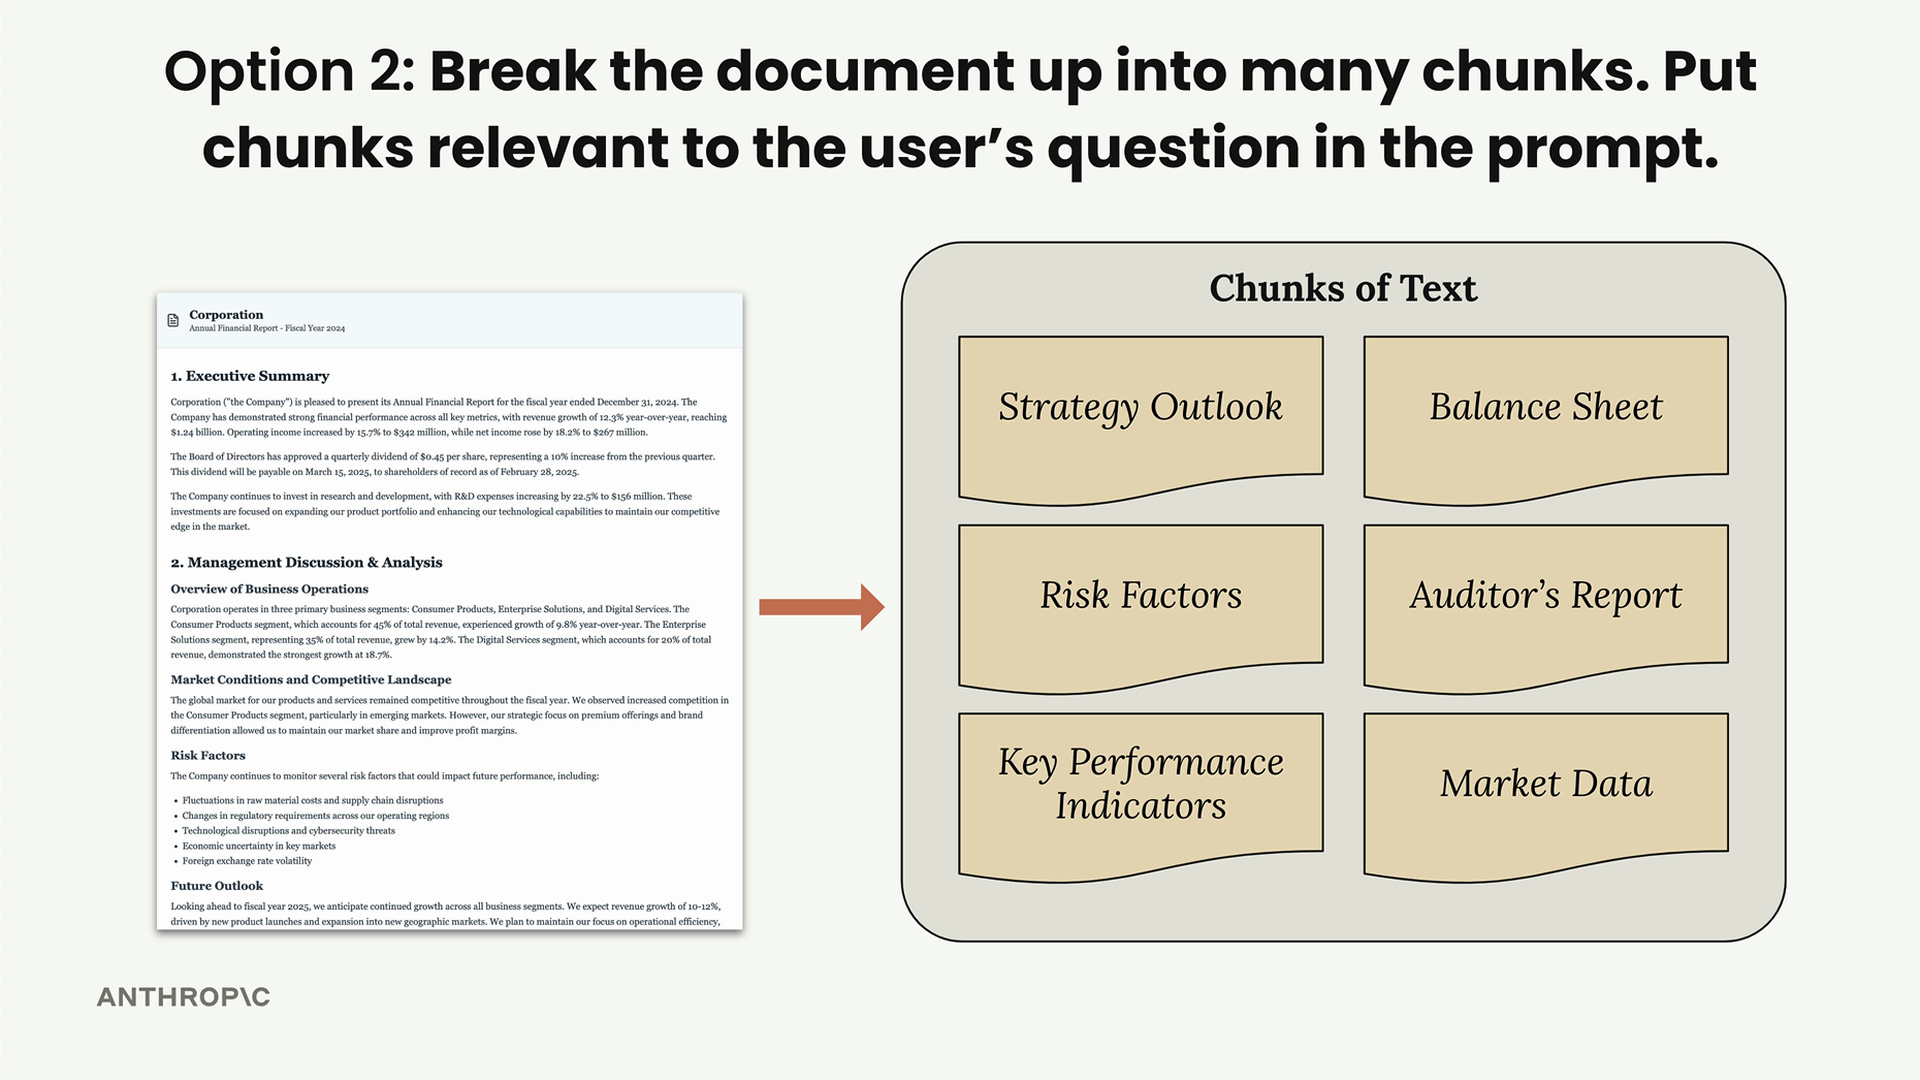
Voici comment cela fonctionne : lorsqu'un utilisateur demande « Quels risques cette entreprise encourt-elle ? », vous parcourez vos segments pour trouver celui concernant les « Facteurs de risque » et n'incluez que cette section dans votre requête à Claude.
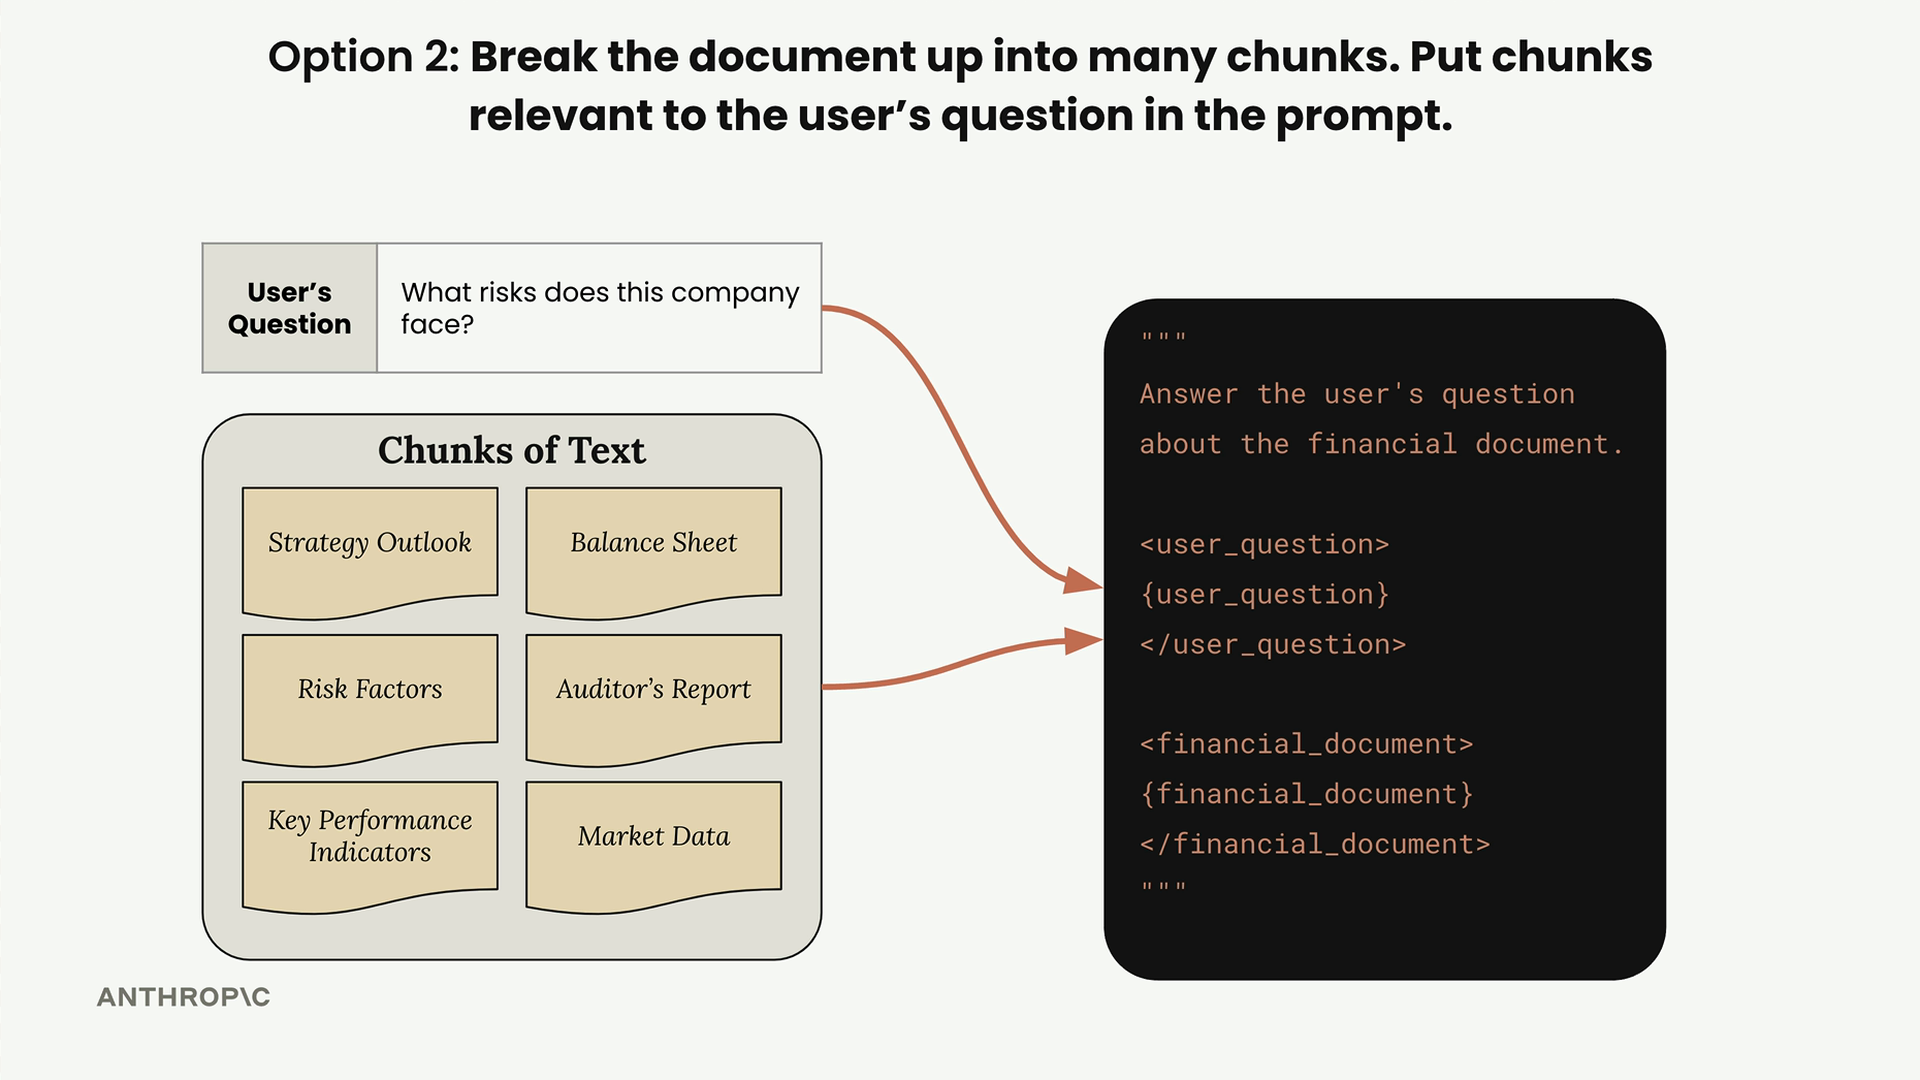
Avantages de l'approche par segmentation
- Claude peut se concentrer uniquement sur le contenu le plus pertinent
- S'adapte à des documents très volumineux
- Fonctionne avec plusieurs documents
- Des requêtes plus petites coûtent moins cher et s'exécutent plus rapidement
Difficultés liées à la segmentation
- Nécessite une étape de prétraitement pour diviser les documents
- Nécessite un mécanisme de recherche pour trouver les segments « pertinents »
- Les segments inclus peuvent ne pas contenir tout le contexte dont Claude a besoin
- De nombreuses façons de segmenter le texte existent : quelle est la meilleure approche ?
Par exemple, si vous n'incluez que la section « Facteurs de risque », vous pourriez passer à côté d'un contexte important présent dans la section « Perspectives stratégiques », qui explique comment l'entreprise prévoit de gérer ces risques.
C'est cela, le RAG
L'option 2 correspond à la génération augmentée par récupération. Malgré sa complexité, le RAG offre des avantages considérables pour travailler avec de grands documents, mais il s'accompagne de défis techniques qui nécessitent une réflexion approfondie.
Les composants clés du RAG sont les suivants :
- Le prétraitement et la segmentation des documents
- Un mécanisme de recherche permettant de trouver les segments pertinents
- La sélection intelligente des segments à inclure dans les requêtes
Lorsque vous envisagez d'utiliser le RAG pour votre application, vous devez évaluer si les avantages compensent la complexité supplémentaire pour votre cas d'usage spécifique. Cette technique se révèle particulièrement efficace lorsque vous travaillez avec de vastes collections de documents nécessitant des réponses précises et contextuelles, mais elle requiert un travail d'ingénierie préalable plus important que la simple inclusion de documents entiers dans les requêtes.