La mémorisation des requêtes est une fonctionnalité qui accélère les réponses de Claude et réduit le coût de la génération de texte en réutilisant le travail de calcul effectué lors de requêtes précédentes. Au lieu de jeter tout le travail de traitement après chaque requête, Claude peut l'enregistrer et le réutiliser lorsque vous envoyez à nouveau un contenu similaire.
Comment Claude traite normalement les requêtes
Pour comprendre la mémorisation des requêtes, examinons d'abord ce qui se passe lors d'une requête typique sans mémorisation activée.
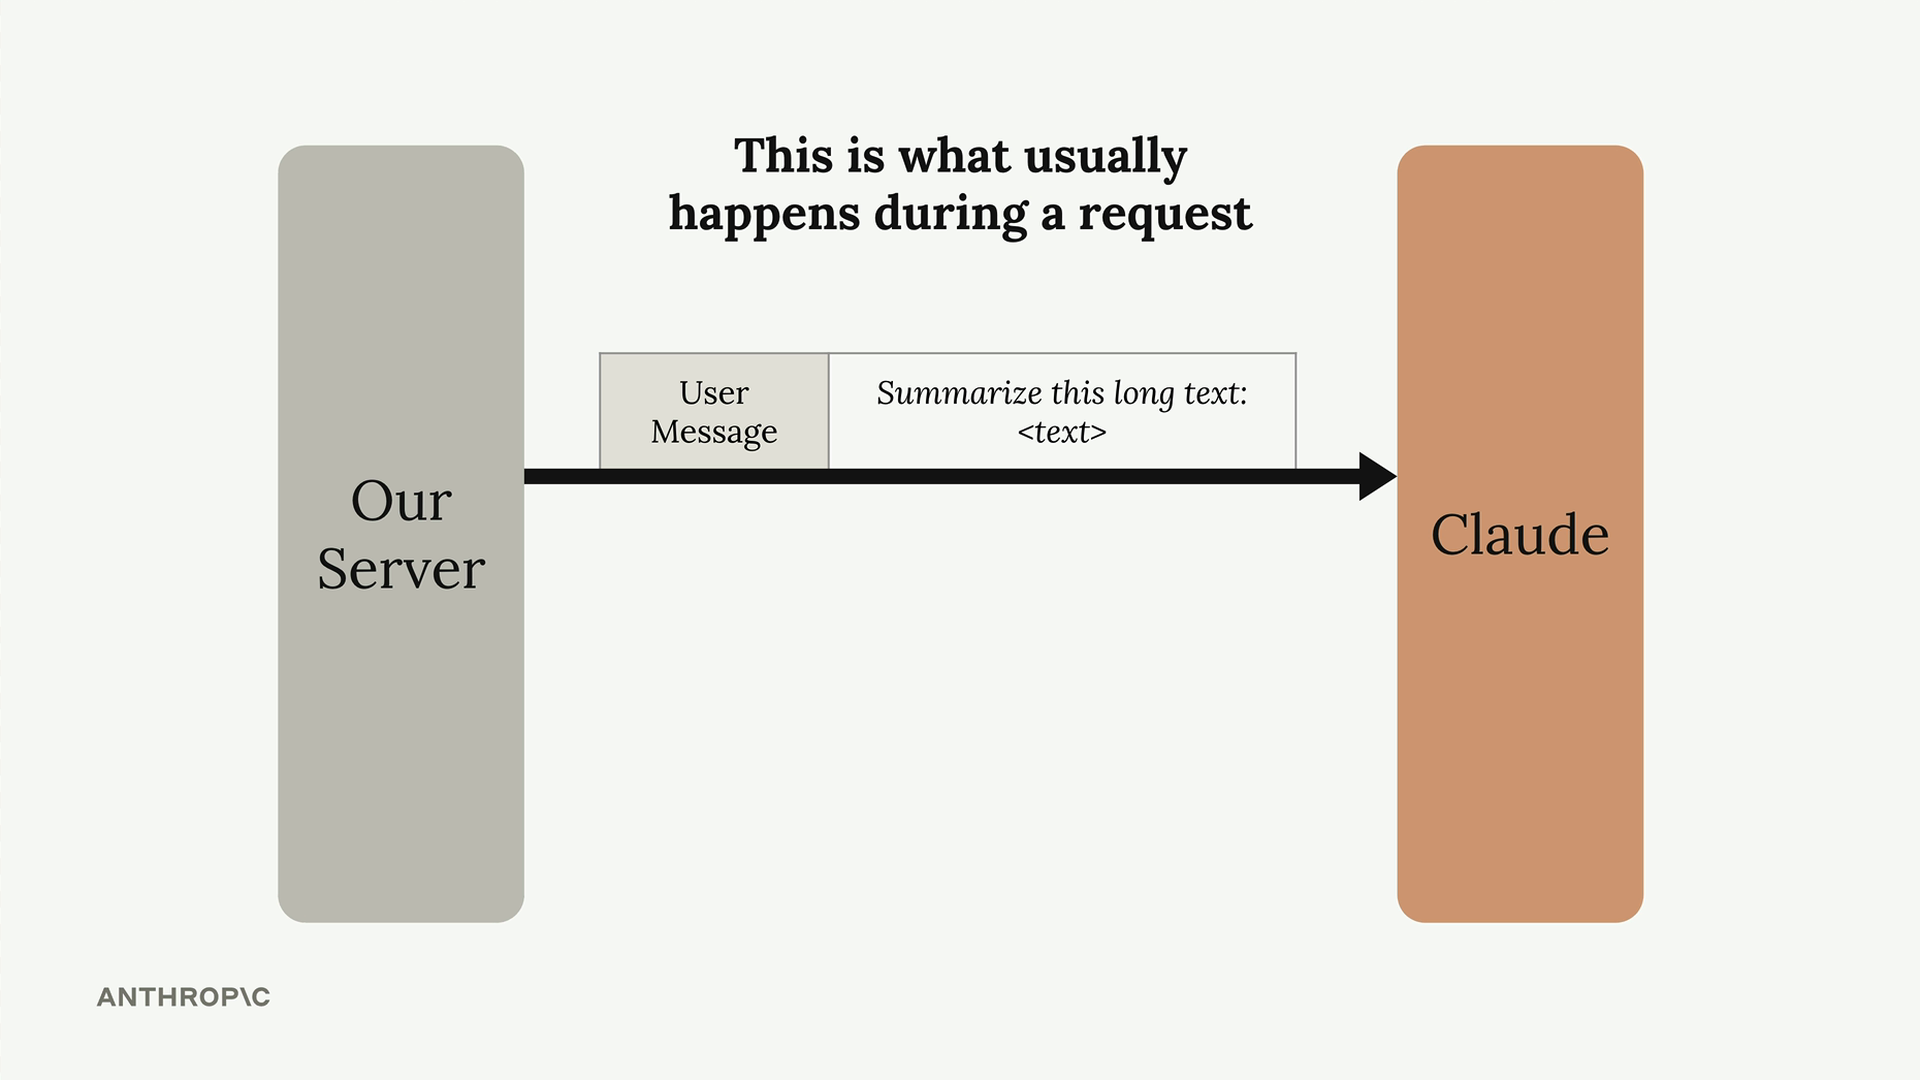
Lorsque vous envoyez un message à Claude, il ne commence pas immédiatement à générer une réponse. Claude effectue plutôt un travail de prétraitement approfondi sur votre entrée :
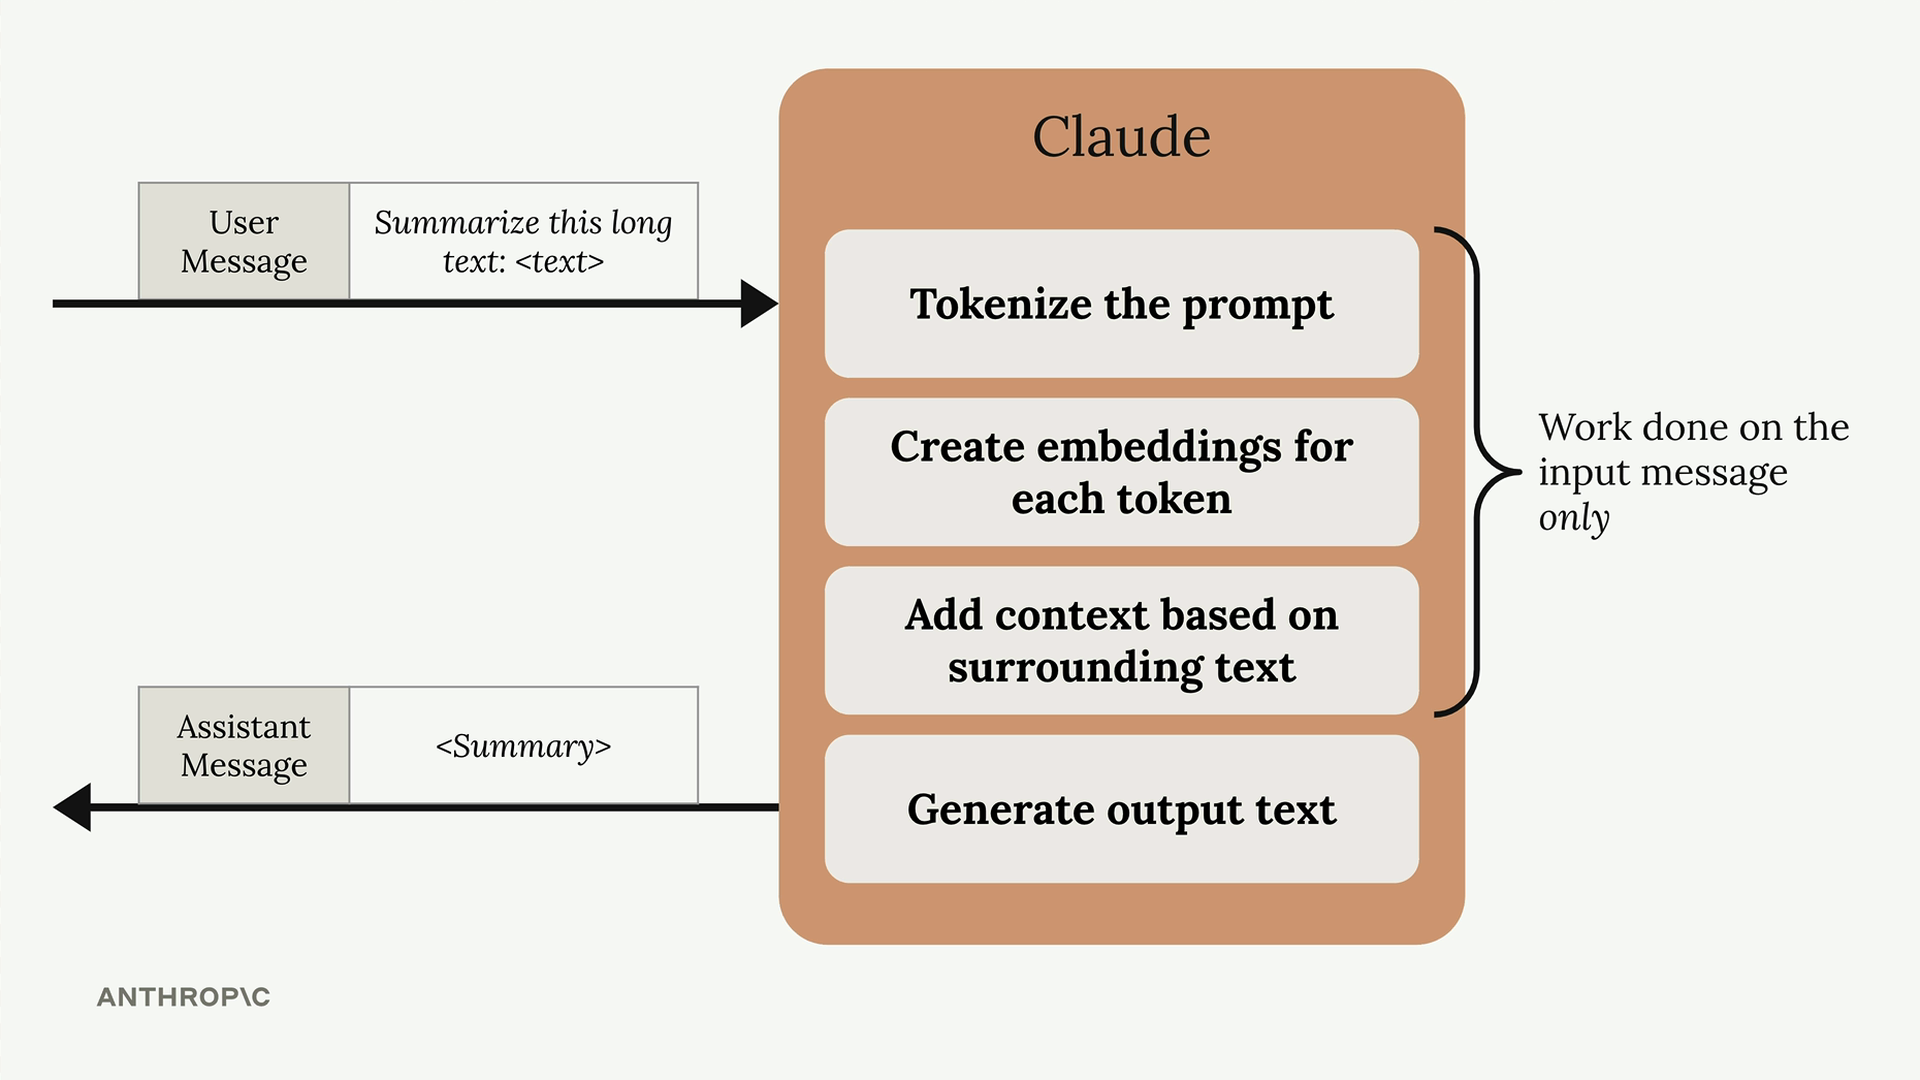
- Tokenise la requête (découpe le texte en unités plus petites)
- Crée des embeddings pour chaque jeton (représentations mathématiques)
- Ajoute du contexte en fonction du texte environnant
- Ce n'est qu'ensuite qu'il génère le texte de sortie réel
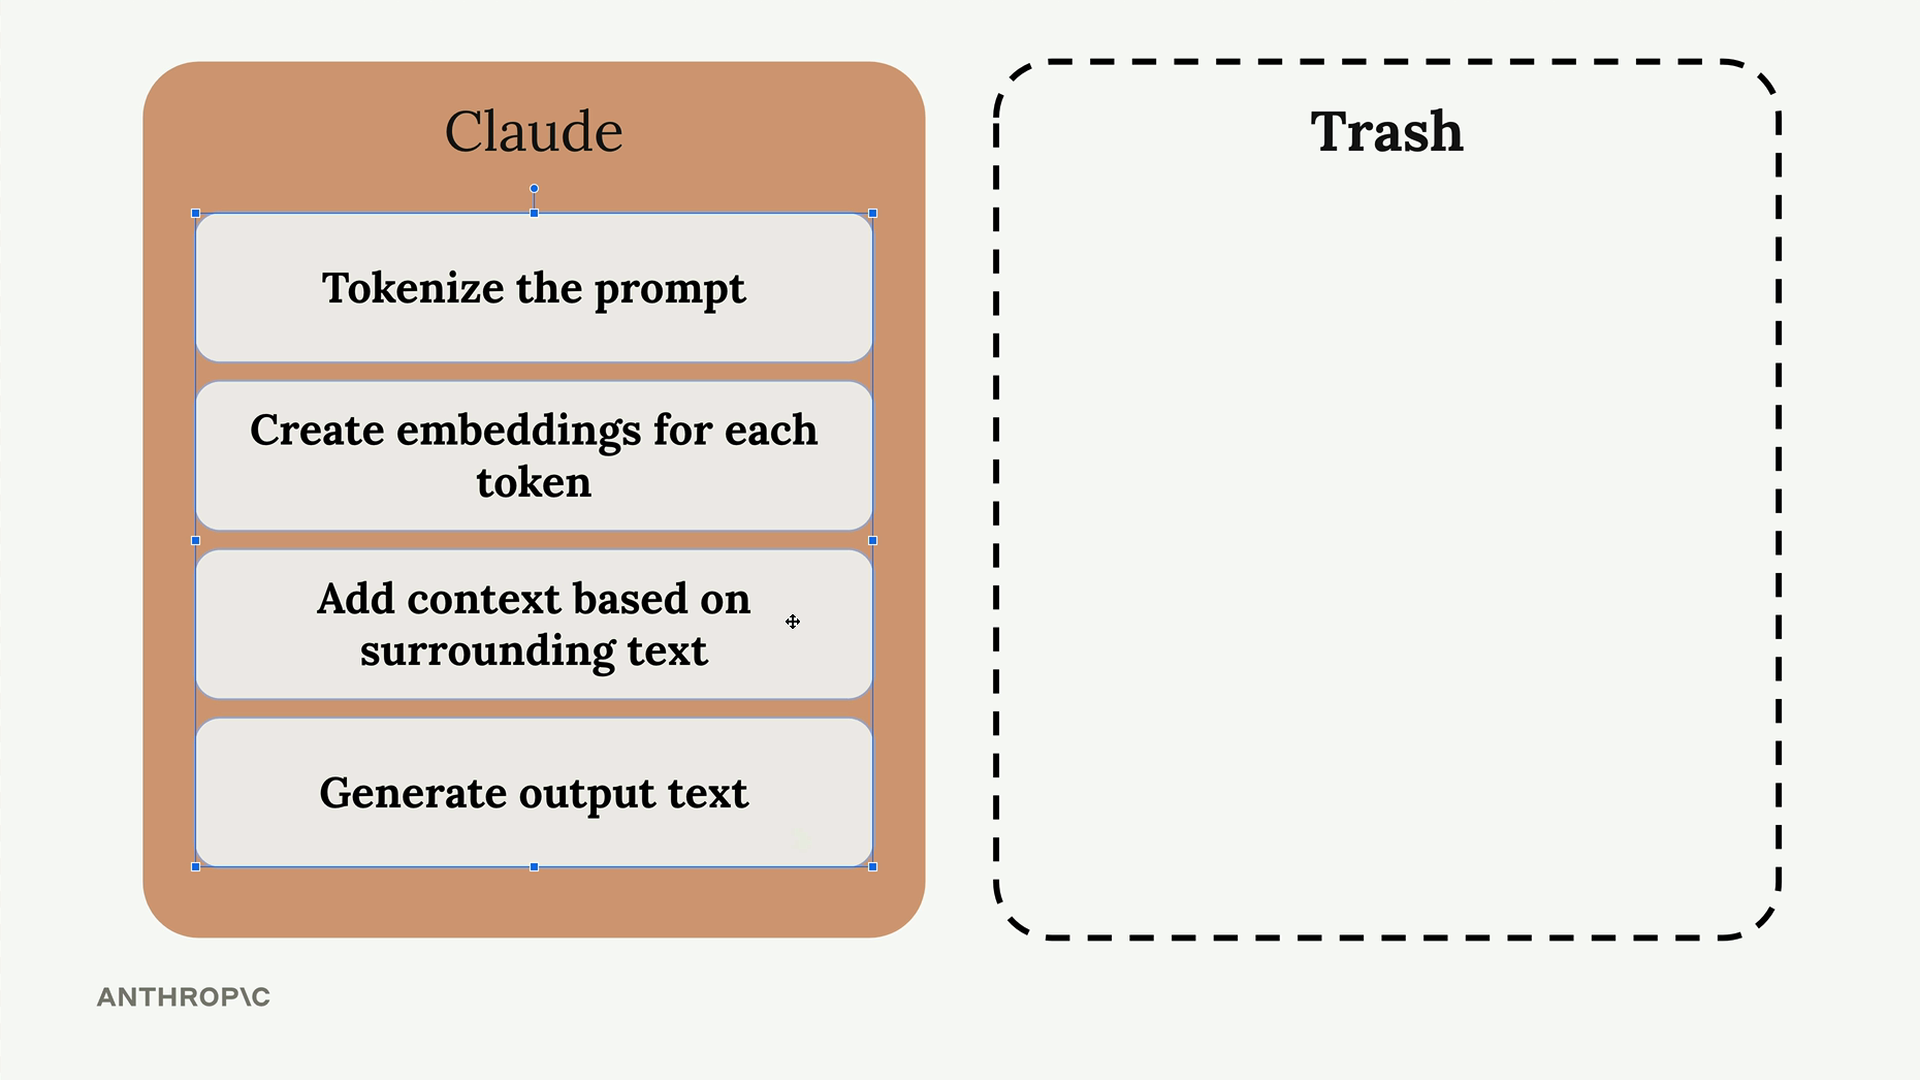
Après vous avoir envoyé la réponse, Claude se débarrasse de tout ce travail de calcul. Tout est jeté, et Claude se déclare prêt pour la prochaine requête.
Le problème du contenu répété
C'est là que les choses deviennent inefficaces. Imaginez que vous ayez une conversation avec Claude, de sorte que votre requête de suivi inclut :
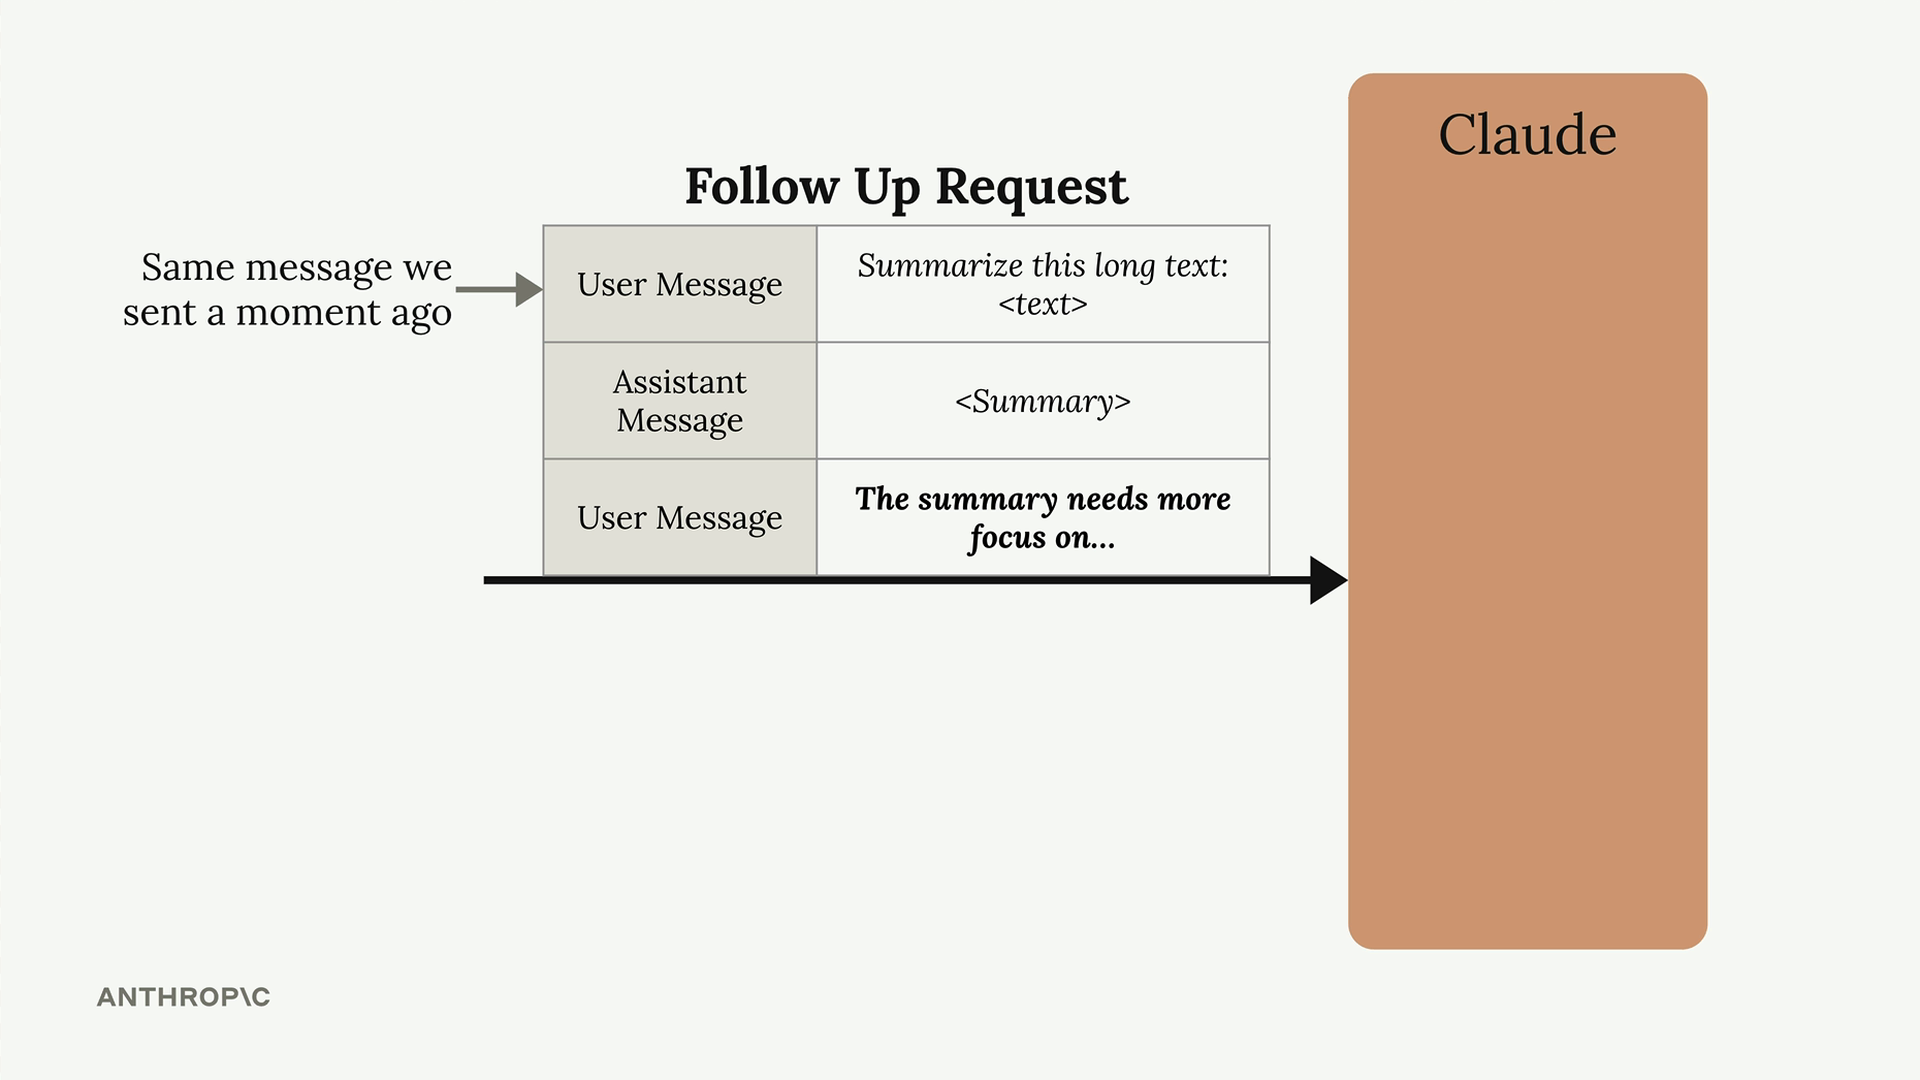
- Le même message utilisateur original qu'avant
- La réponse précédente de Claude
- Votre nouveau message de suivi
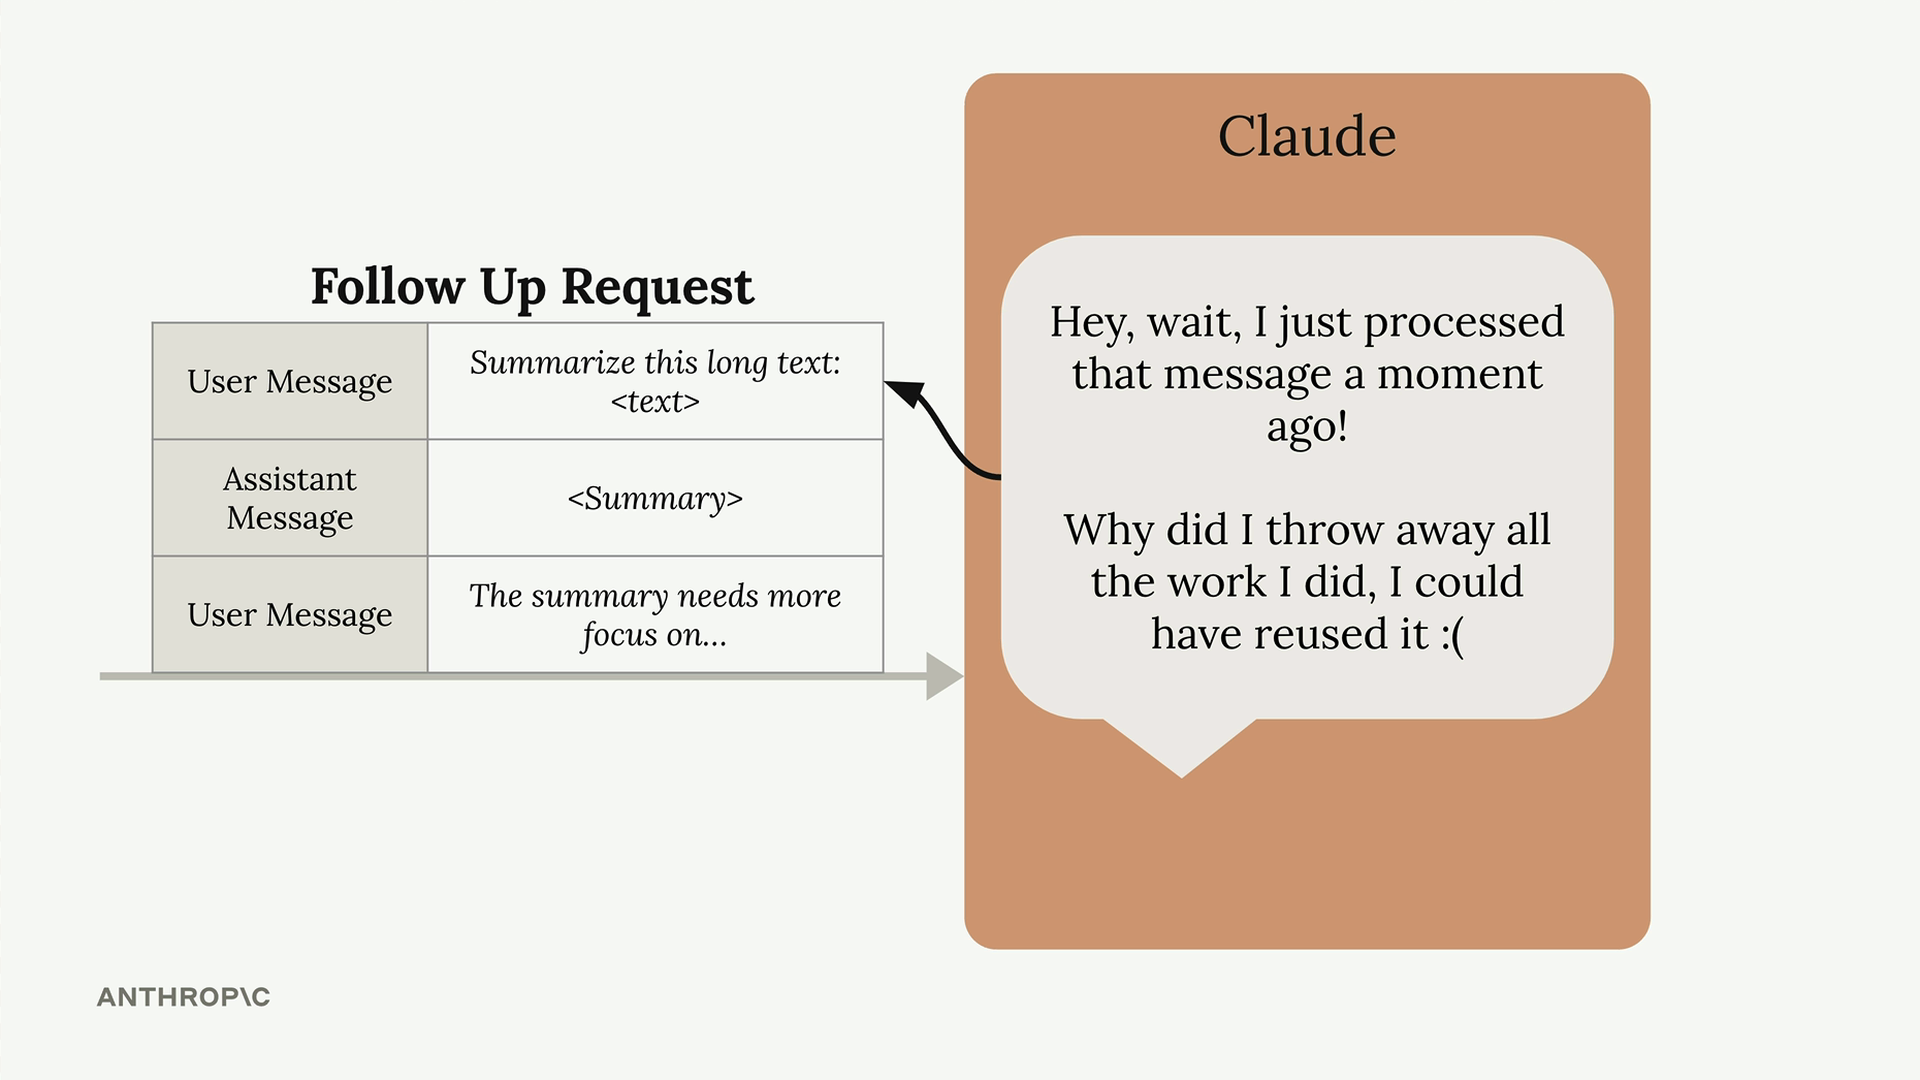
Claude doit retraiter ce message original depuis le début, même s'il vient d'analyser exactement le même contenu quelques instants plus tôt. Comme Claude pourrait le penser : « Je viens de traiter ce message et j'ai jeté tout le travail que j'avais fait. J'aurais pu le réutiliser ! »
Comment la mémorisation des requêtes résout ce problème
La mémorisation des requêtes change ce processus gaspilleur. Au lieu de jeter le travail de prétraitement, Claude l'enregistre dans une mémoire cache.
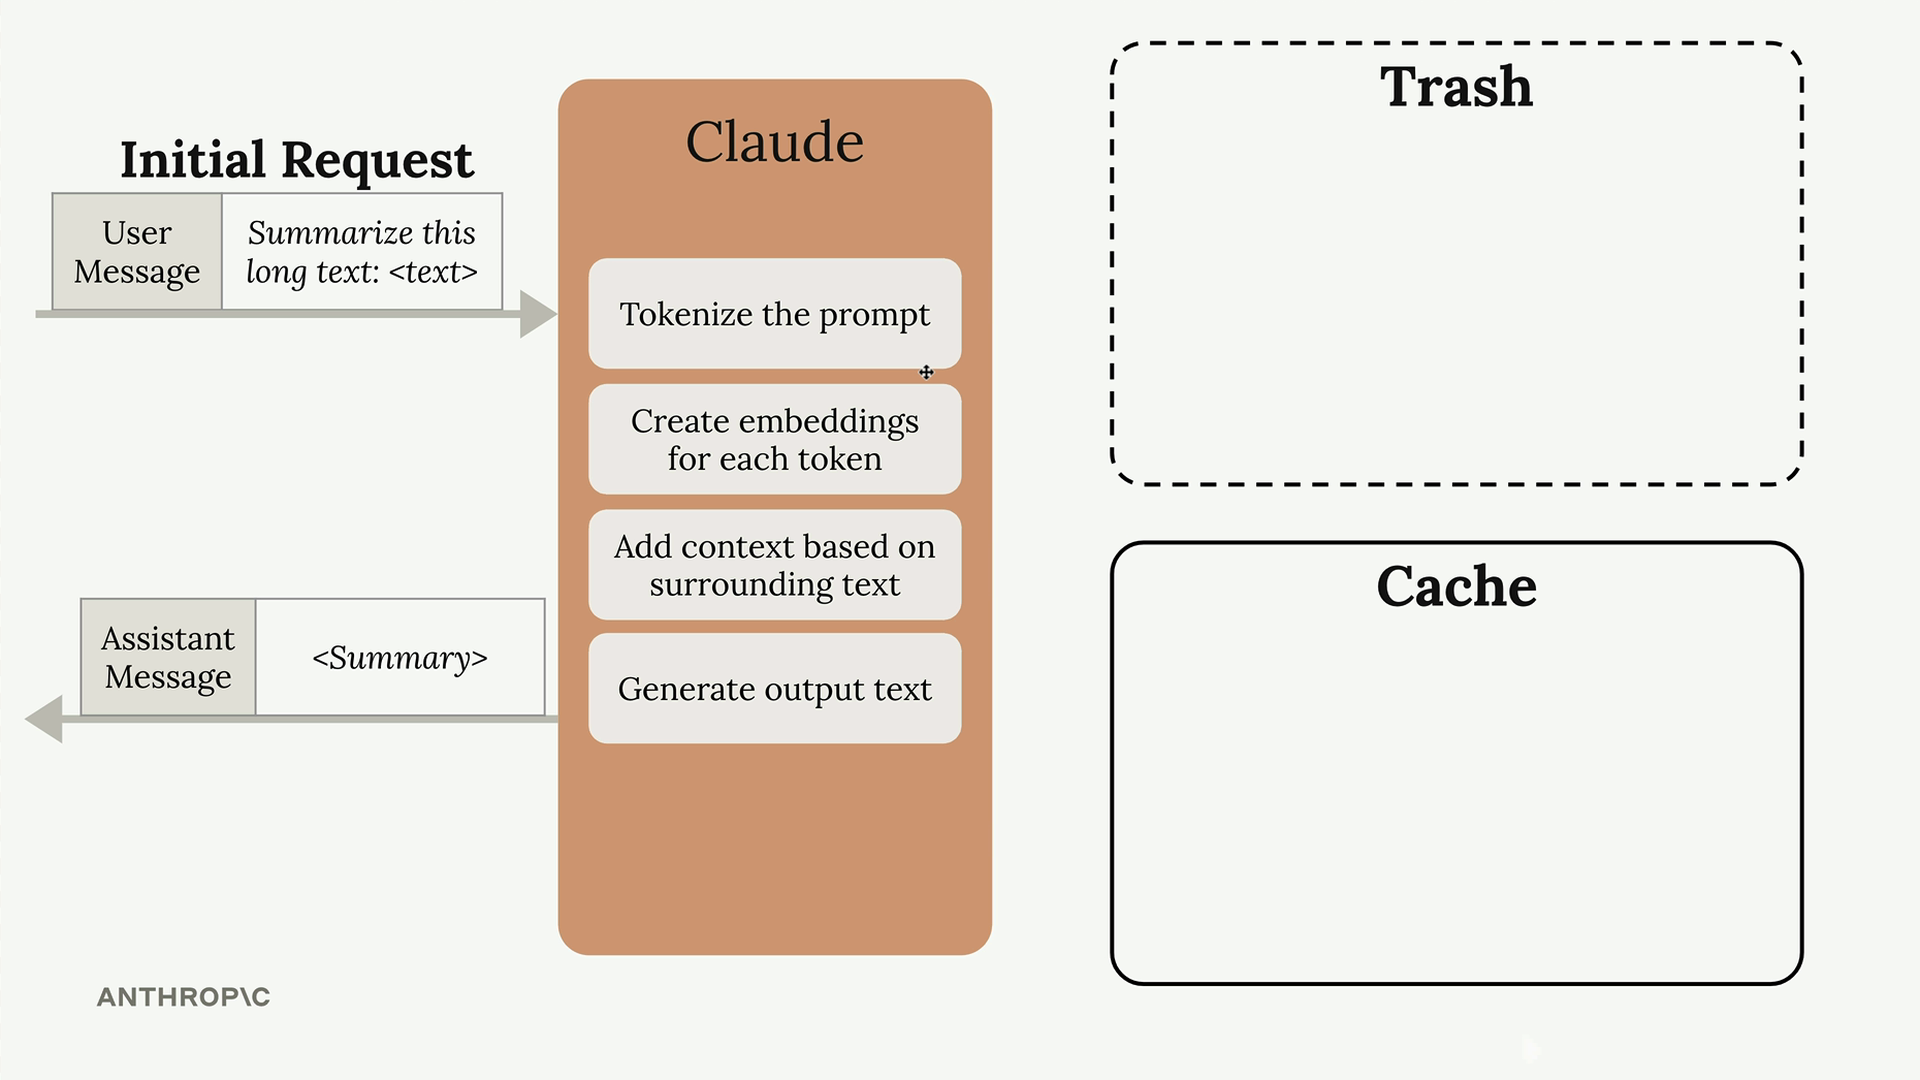
Voici comment cela fonctionne :
- Requête initiale : Claude traite votre message et écrit le travail de calcul dans une mémoire cache
- Requêtes de suivi : Lorsque Claude revoit le même contenu, il lit le travail déjà traité depuis la mémoire cache au lieu de tout recommencer
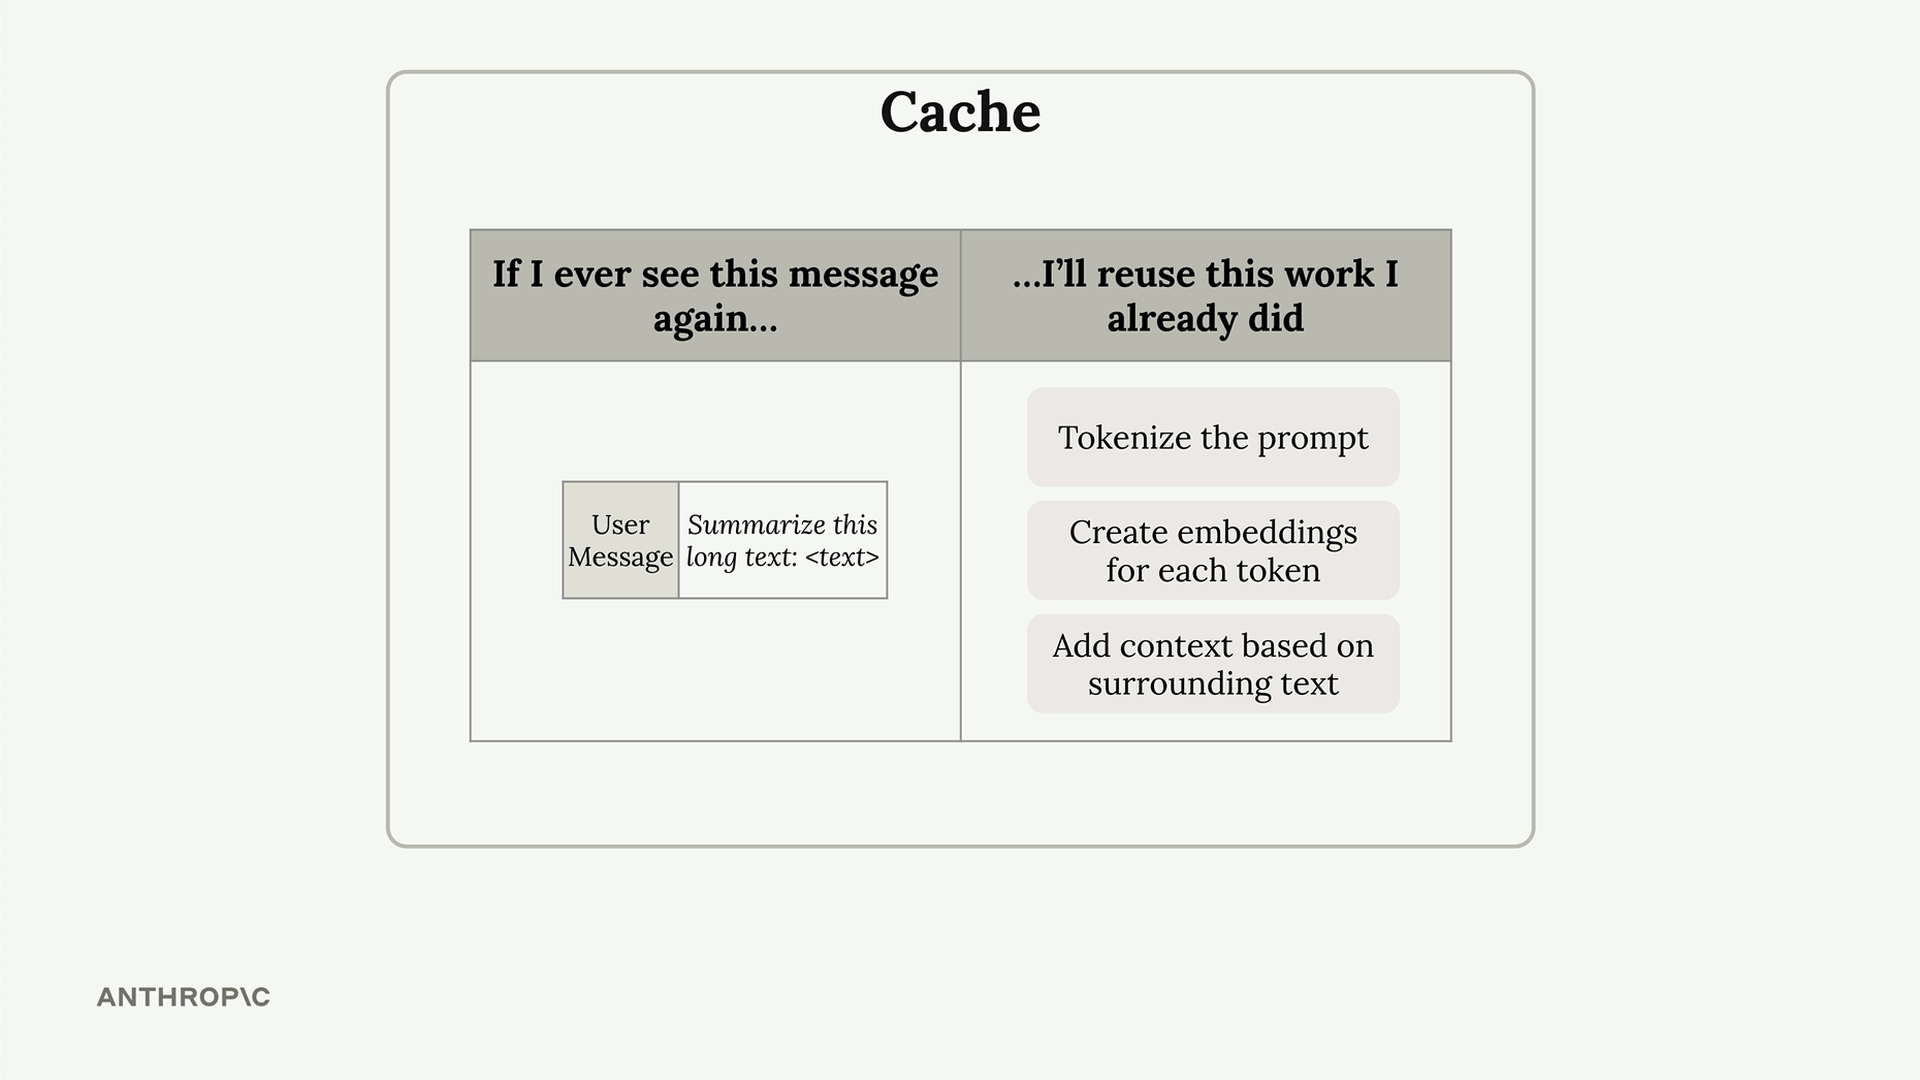
La mémoire cache agit comme une table de correspondance : « Si je revois jamais ce message, je réutiliserai ce travail que j'ai déjà fait. »
Avantages et limites clés
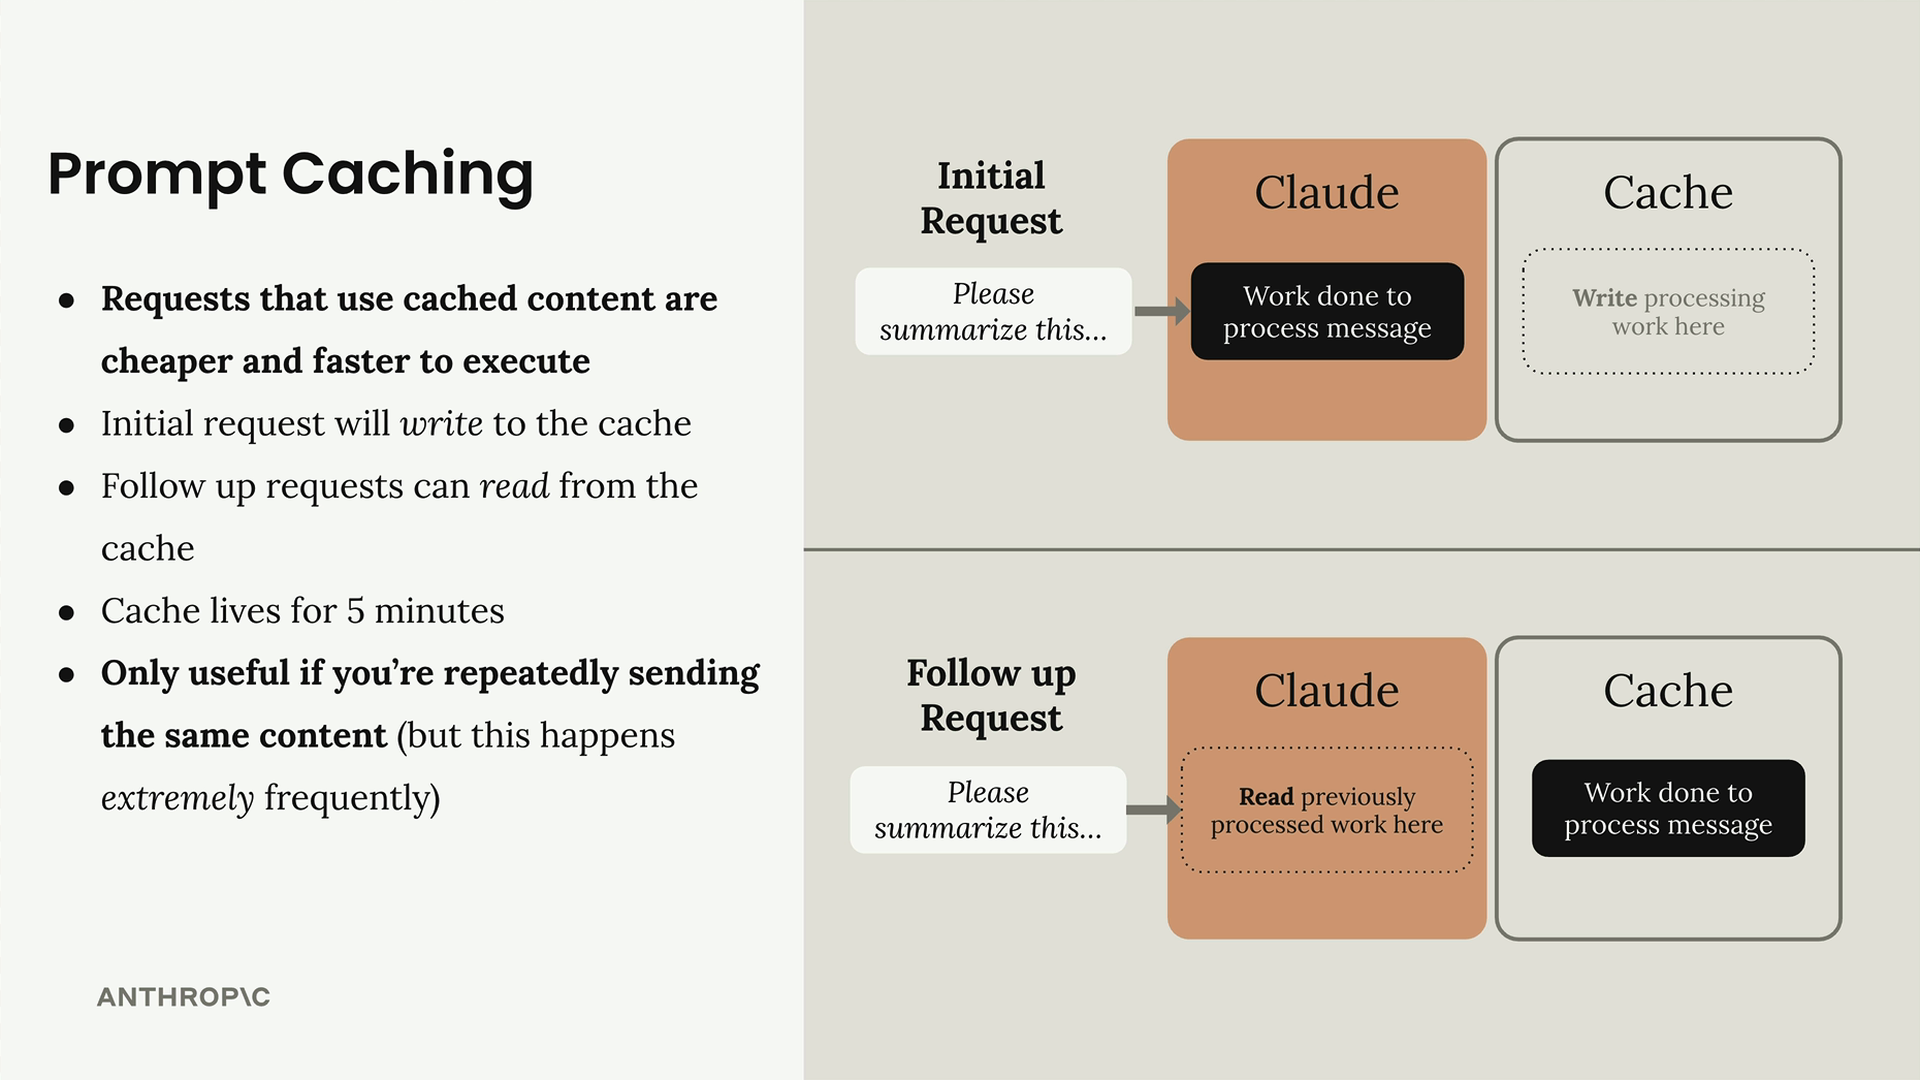
La mémorisation des requêtes offre plusieurs avantages :
- Réponses plus rapides : Les requêtes utilisant du contenu mis en cache s'exécutent plus rapidement
- Coûts réduits : Vous payez moins pour un traitement qui réutilise du travail mis en cache
- Optimisation automatique : La requête initiale écrit dans la mémoire cache, les requêtes de suivi y lisent
Cependant, il existe des limitations importantes à garder à l'esprit :
- Durée de vie courte : La mémoire cache ne vit que 5 minutes
- Correspondances exactes requises : Utile uniquement lorsque vous envoyez de façon répétée le même contenu
- Cas d'usage courant : Cela se produit extrêmement fréquemment dans les applications conversationnelles et les flux de travail d'analyse de documents
La mémorisation des requêtes est particulièrement précieuse pour les applications où les utilisateurs font fréquemment référence aux mêmes documents, poursuivent des conversations, ou itèrent sur des requêtes similaires dans un court laps de temps.