La création d'un flux de travail personnalisé d'évaluation de requêtes commence par l'élaboration d'une requête solide, puis par la génération de données de test pour évaluer ses performances. Voyons ensemble comment mettre en place un système d'évaluation pour une requête qui aide les utilisateurs à écrire du code spécifique à AWS.
Définir l'objectif
Notre requête doit aider les utilisateurs à rédiger trois types spécifiques de résultats pour des cas d'usage AWS :
- du code Python
- des fichiers de configuration JSON
- des expressions régulières
L'exigence clé est que, lorsqu'un utilisateur demande de l'aide pour une tâche, nous renvoyions un résultat net dans l'un de ces formats, sans explications, en-têtes ou pieds de page supplémentaires.
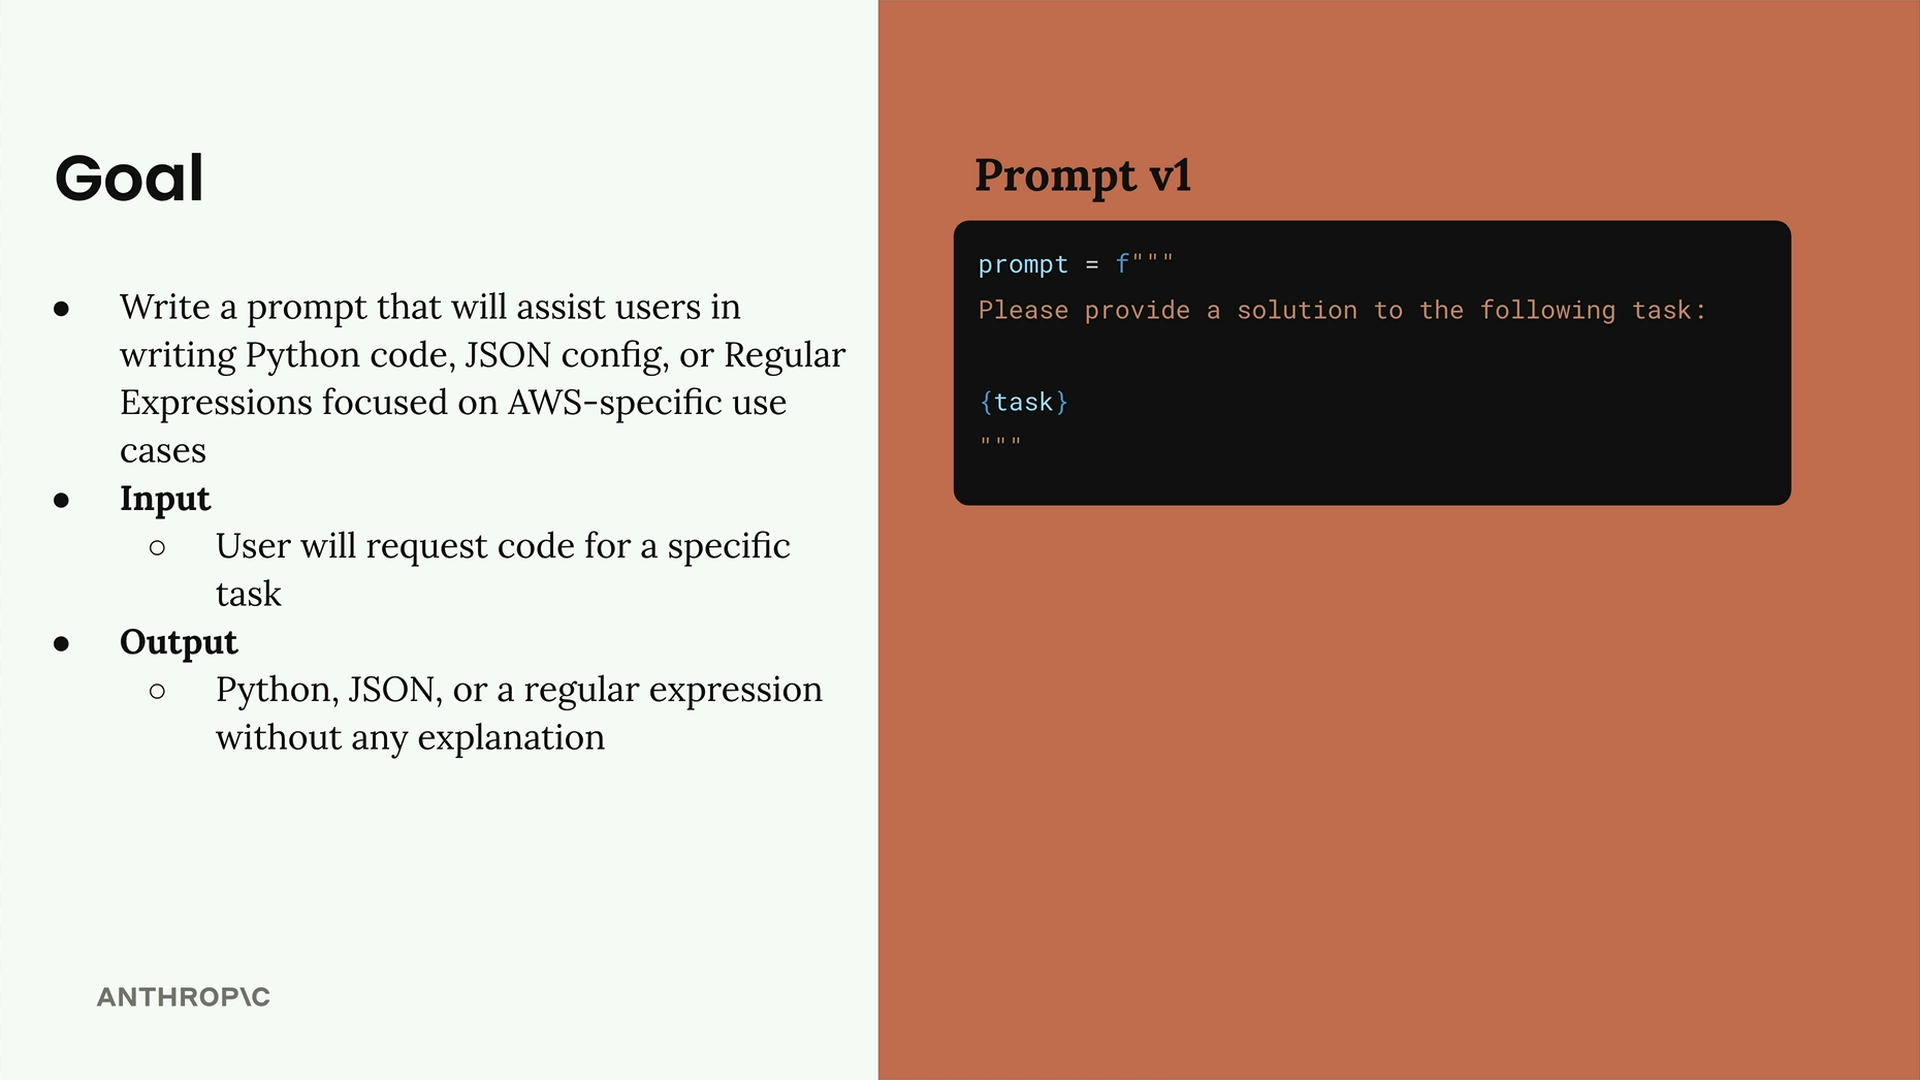
Voici notre modèle de requête initial :
prompt = f"""
Please provide a solution to the following task:
{task}
"""
Créer un jeu de données d'évaluation
Un jeu de données d'évaluation contient les entrées que nous allons fournir à notre requête pour tester ses performances. Dans notre cas, nous avons besoin d'un tableau d'objets JSON où chaque objet possède une propriété « task » décrivant ce que nous souhaitons que Claude accomplisse.
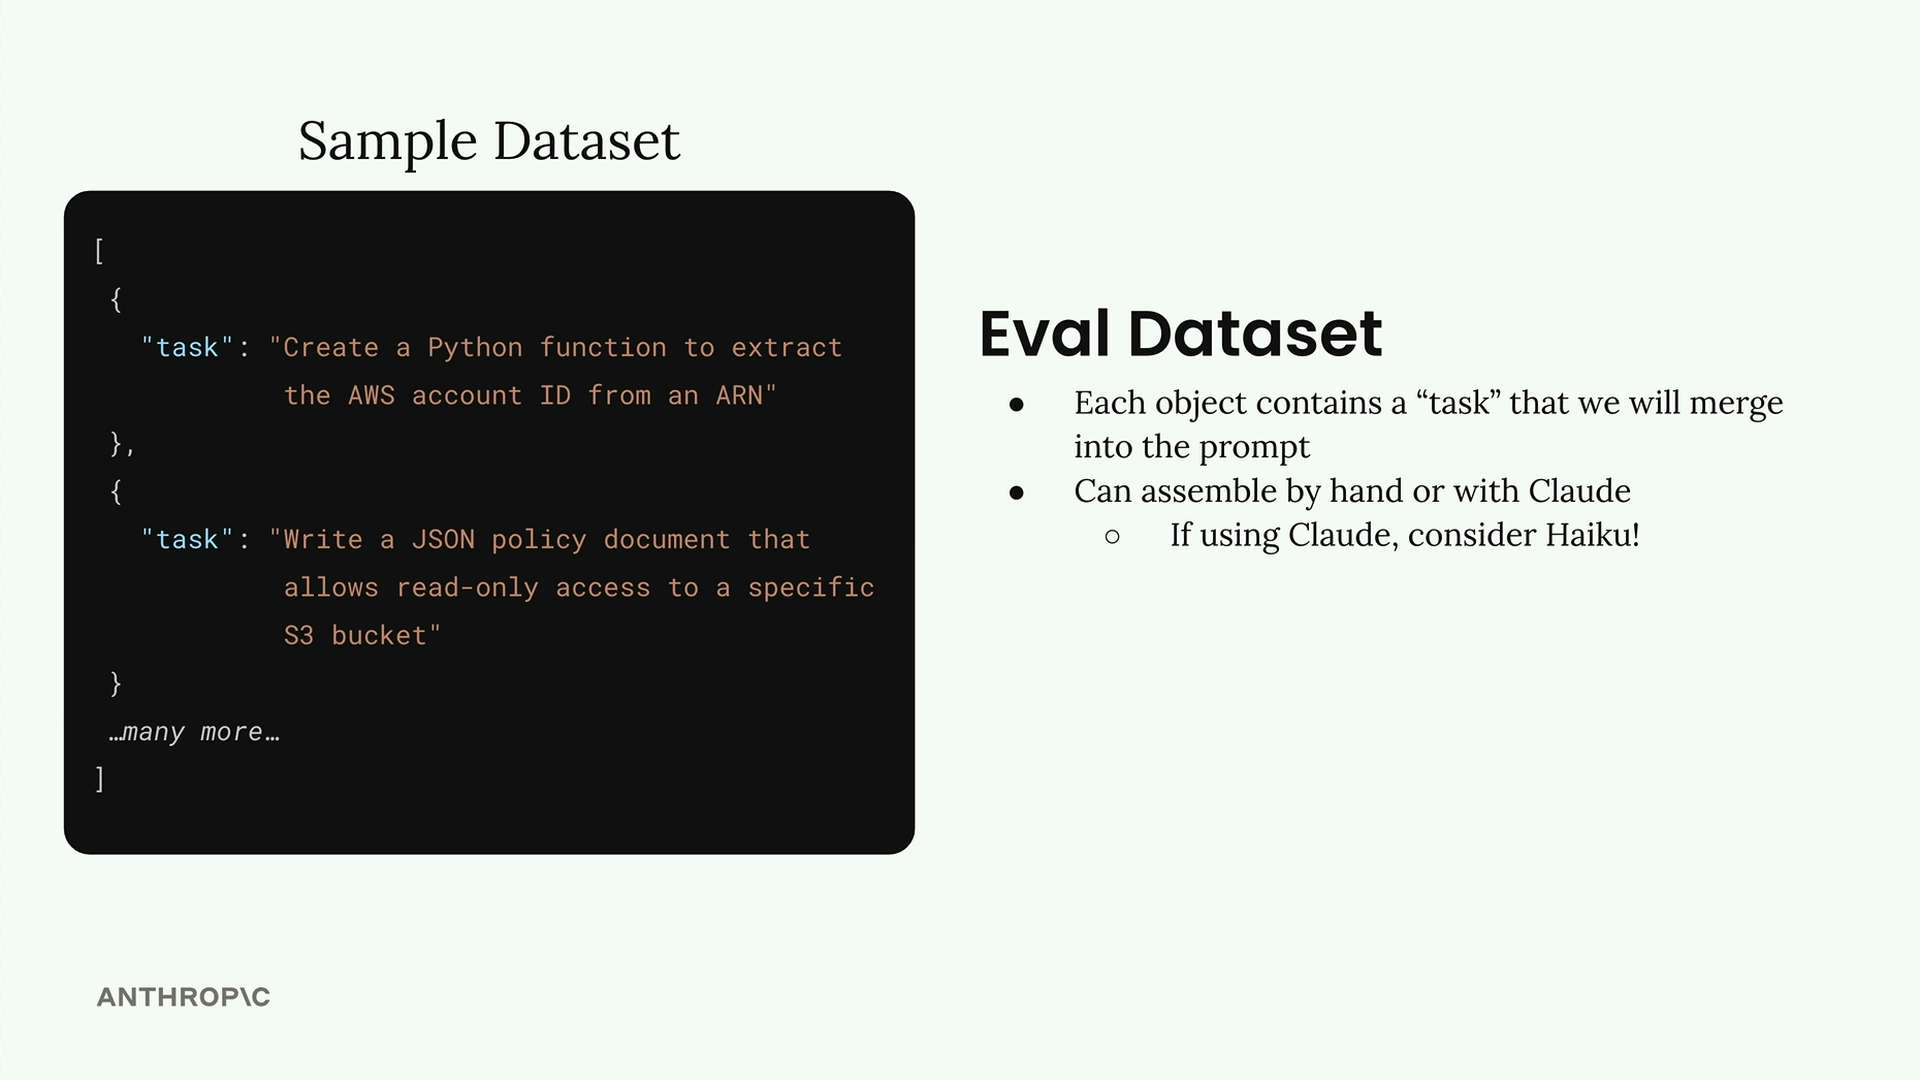
Vous pouvez créer des jeux de données de deux manières :
- les assembler manuellement
- les générer automatiquement à l'aide de Claude
Pour la génération automatique, l'utilisation d'un modèle plus rapide comme Haiku est judicieuse, puisque nous générons des données de test plutôt qu'un résultat de production.
Générer des données de test avec du code
Construisons une fonction qui demande à Claude de générer des cas de test pour nous. La fonction créera une requête complète qui demande des types spécifiques de tâches liées à AWS.
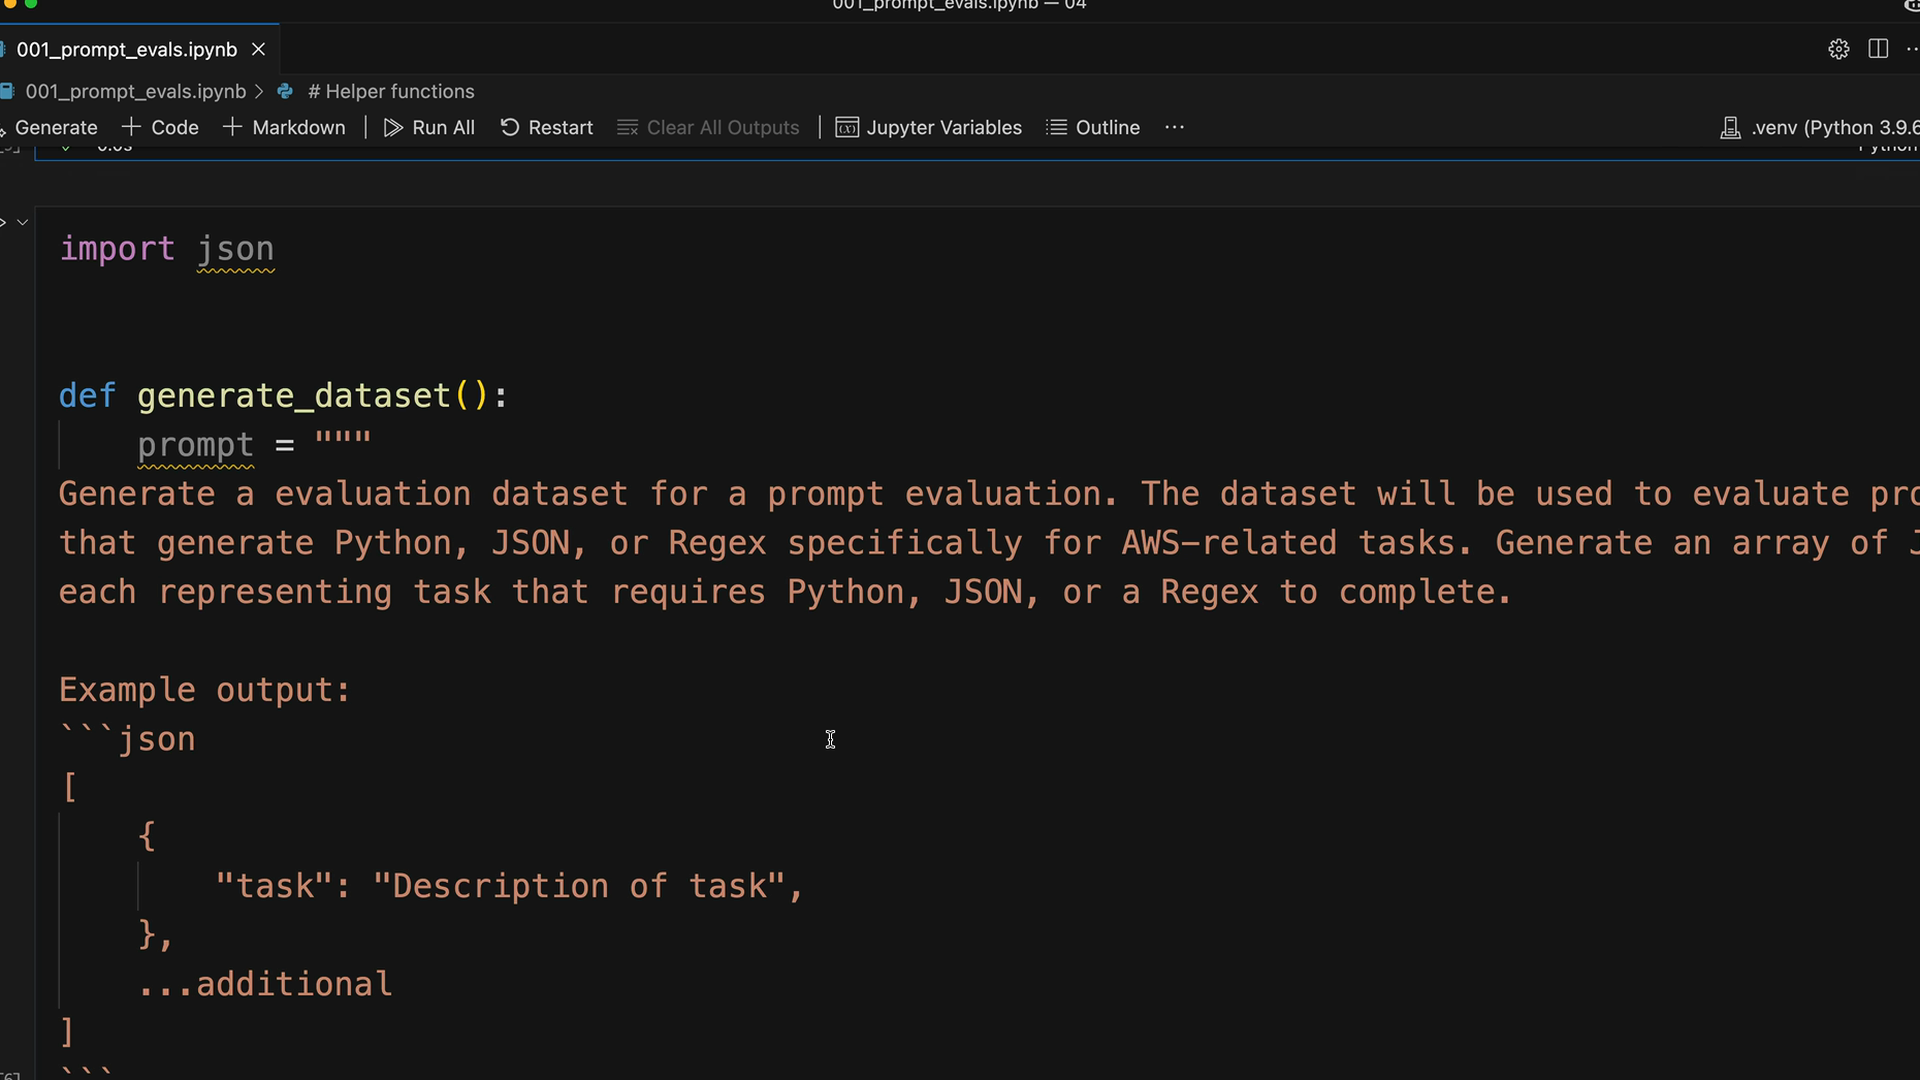
Voici la structure centrale de la fonction :
def generate_dataset():
    prompt = """
    Generate an evaluation dataset for a prompt evaluation. The dataset will be used to evaluate prompts
    that generate Python, JSON, or Regex specifically for AWS-related tasks. Generate an array of objects,
    each representing task that requires Python, JSON, or a Regex to complete.

    Example output:
    ```json
    [
        {
            "task": "Description of task",
        },
        ...additional
    ]
    ```

    * Focus on tasks that can be solved by writing a single Python function, a single JSON object, or a single regex
    * Focus on tasks that do not require writing much code

    Please generate 3 objects.
    """
Mettre en œuvre la logique de génération
Pour obtenir un résultat JSON propre de la part de Claude, nous allons utiliser la technique de pré-remplissage avec des séquences d'arrêt :
    messages = []
    add_user_message(messages, prompt)
    add_assistant_message(messages, "```json")
    text = chat(messages, stop_sequences=["```"])
    return json.loads(text)
Cette approche garantit que Claude commence sa réponse par un JSON correctement formaté et s'arrête à la clôture de la balise markdown.
Tester et enregistrer le jeu de données
Après avoir exécuté la fonction de génération, vous devriez obtenir en retour des cas de test réalistes tels que :
- Créer une fonction Python pour extraire la région AWS à partir d'un ARN
- Rédiger une configuration JSON pour une fonction AWS Lambda
- Développer une expression régulière pour valider un nom de bucket AWS S3
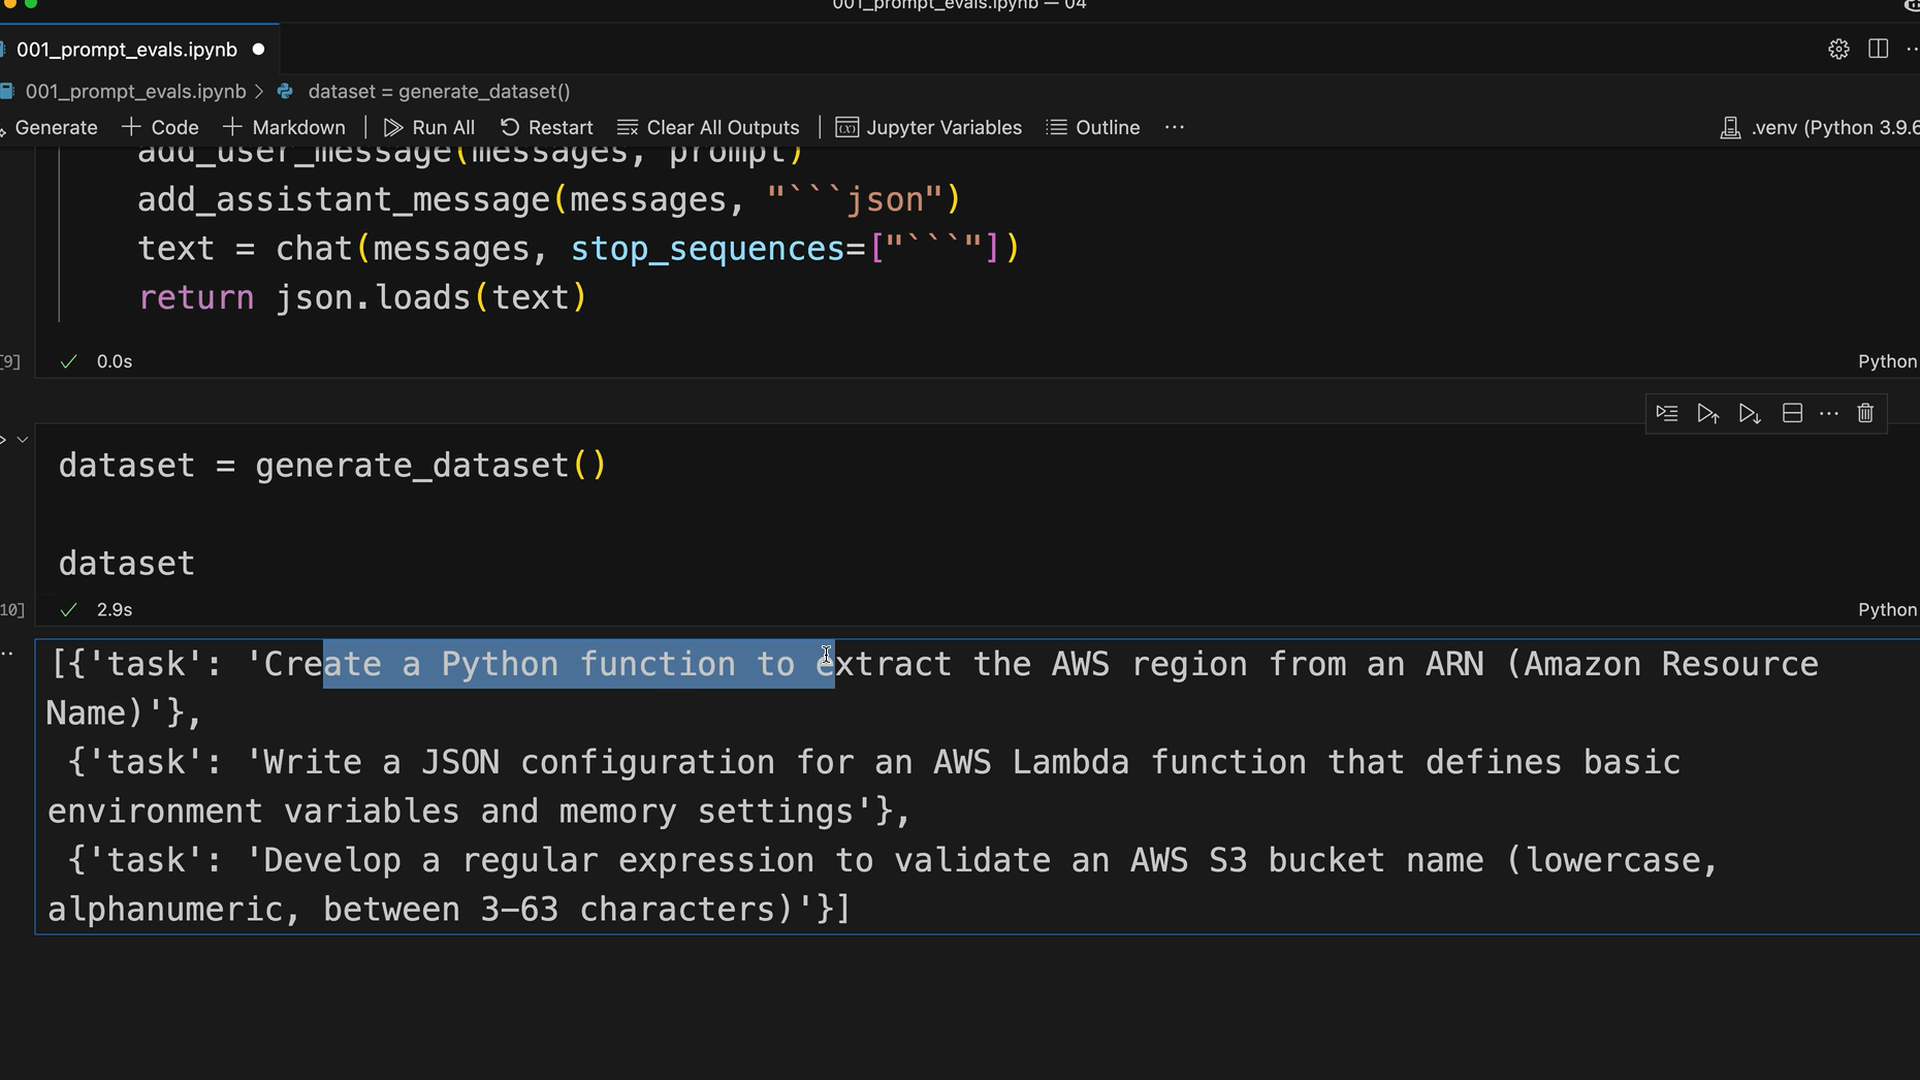
Enregistrez votre jeu de données généré dans un fichier pour une réutilisation facile :
dataset = generate_dataset()

with open('dataset.json', 'w') as f:
    json.dump(dataset, f, indent=2)
Cela crée un fichier dataset.json dans le répertoire de votre notebook contenant tous vos cas de test, prêt à être utilisé pour l'évaluation des requêtes dans les prochaines étapes de votre flux de travail.