La récupération contextuelle est une technique qui améliore la précision des pipelines RAG en résolvant un problème fondamental : lorsque vous découpez un document en fragments, chaque fragment perd sa connexion avec le contexte plus large du document.
Le problème avec le découpage standard
Lorsque vous prenez un document source et le découpez en fragments pour votre base de données vectorielle, chaque élément individuel ne sait plus d'où il vient ni comment il se rapporte au reste du document. Cela peut nuire à la précision de la récupération car les fragments manquent d'informations contextuelles importantes.
Comment fonctionne la récupération contextuelle
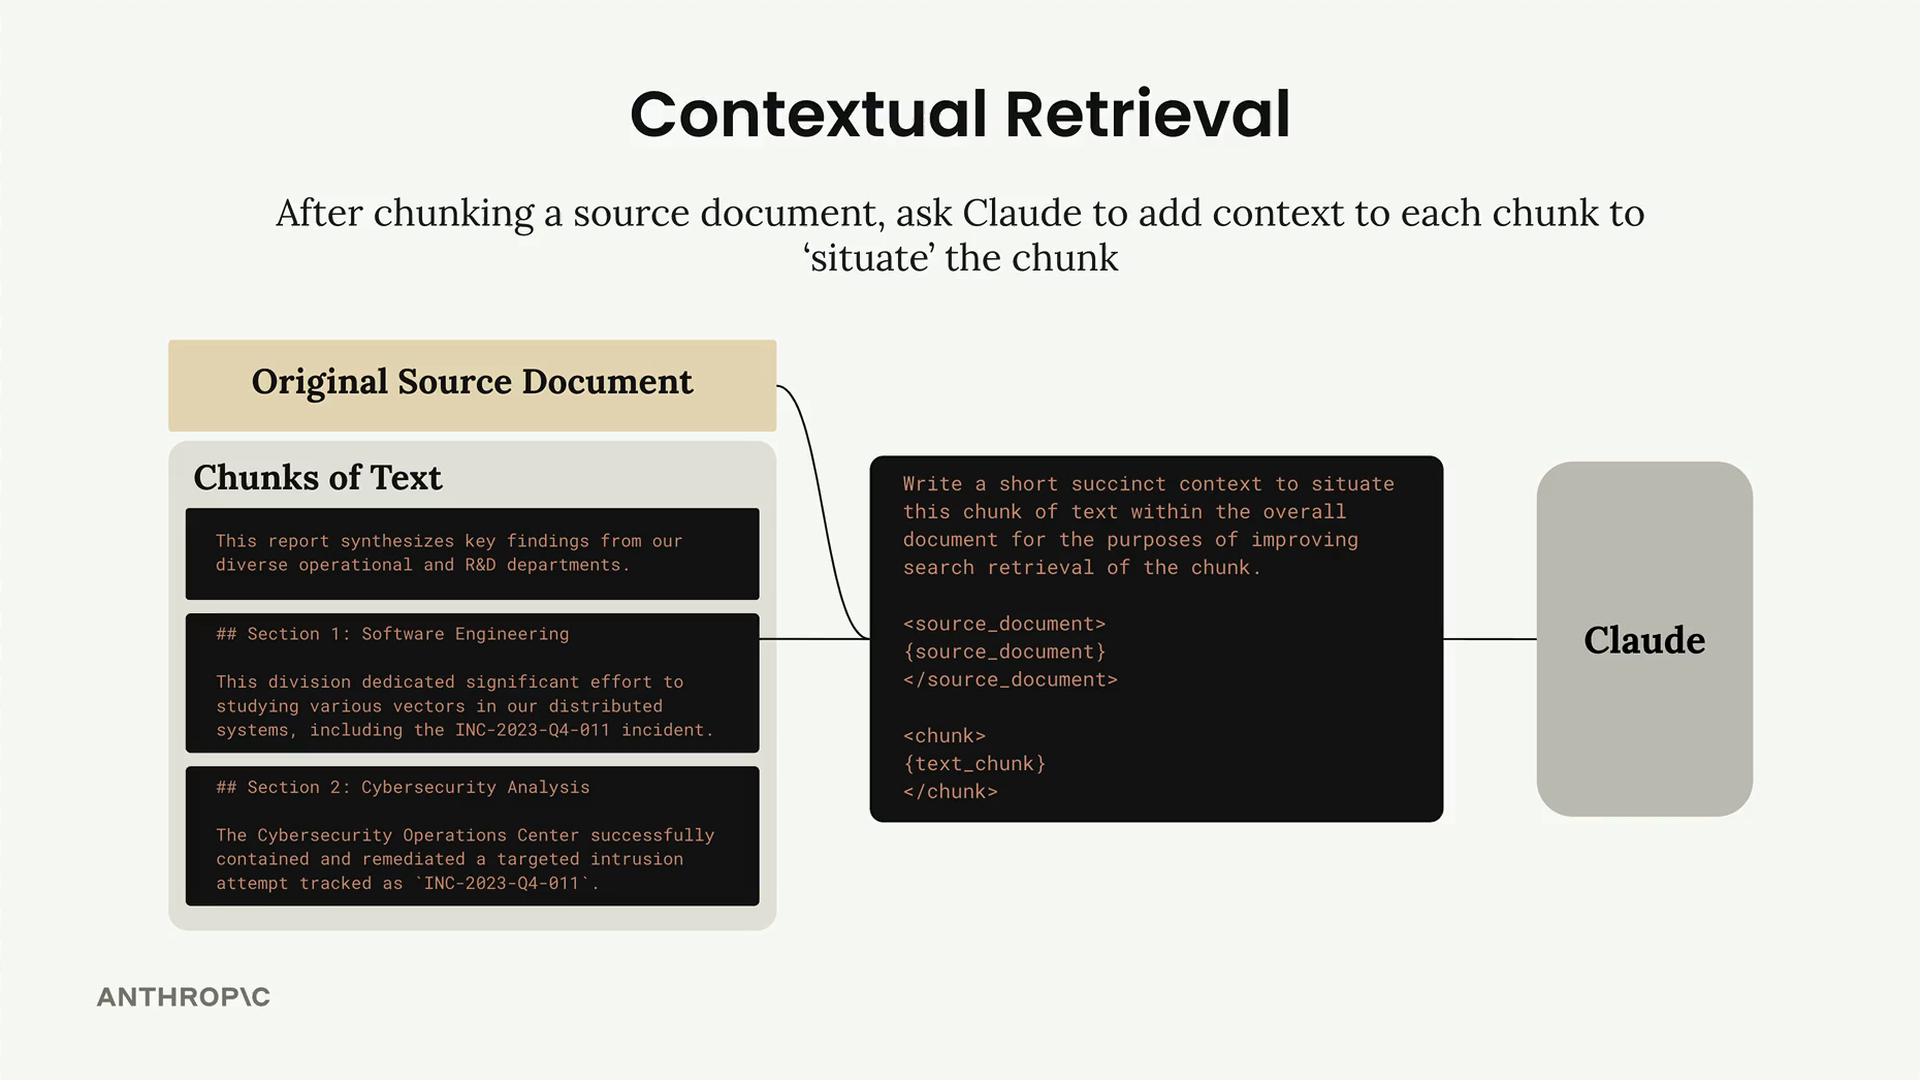
La récupération contextuelle ajoute une étape de prétraitement avant d'insérer les fragments dans votre base de données de récupération. Voici le processus :
- Prenez chaque fragment individuel et le document source original
- Envoyez les deux à Claude avec une requête spécifique lui demandant d'ajouter du contexte
- Claude génère un court extrait qui « situe » le fragment au sein du document plus large
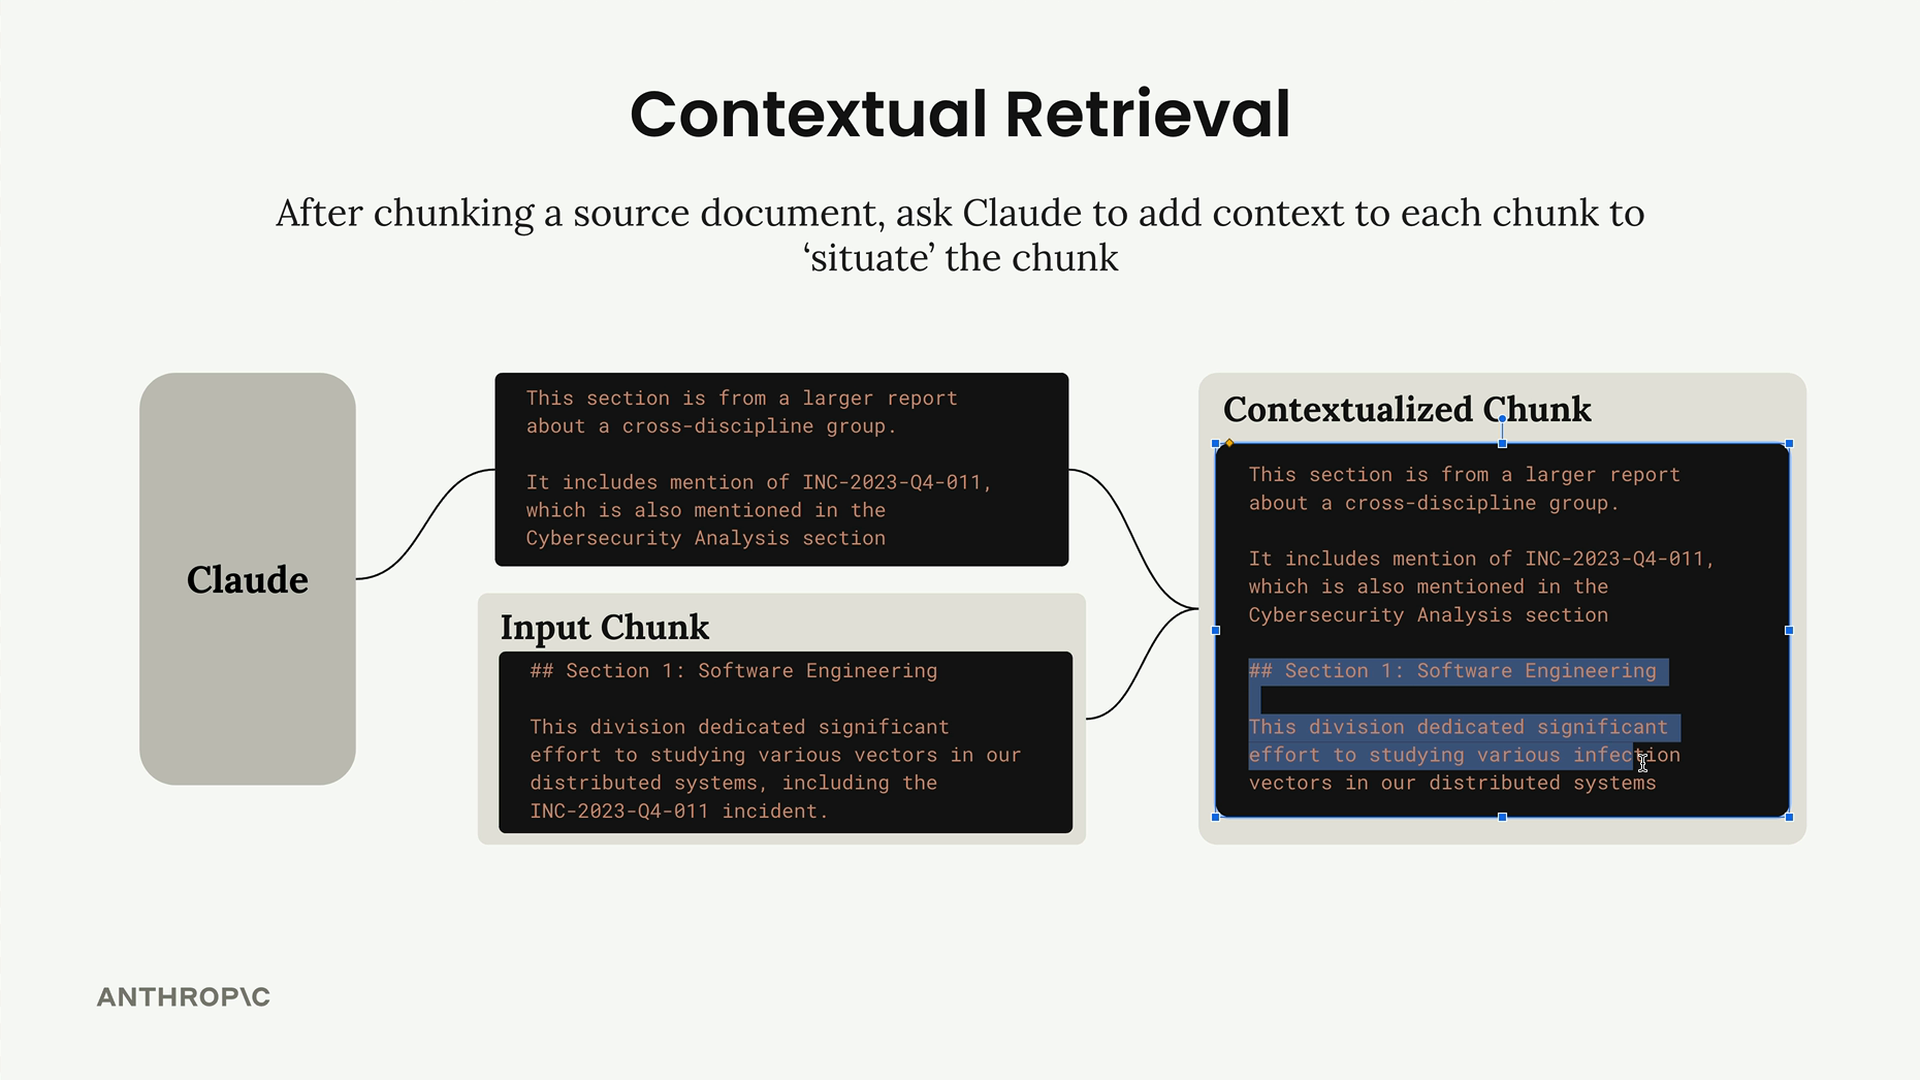
- Combinez ce contexte avec le fragment original pour créer un « fragment contextualisé »
- Utilisez le fragment contextualisé dans vos index vectoriel et BM25
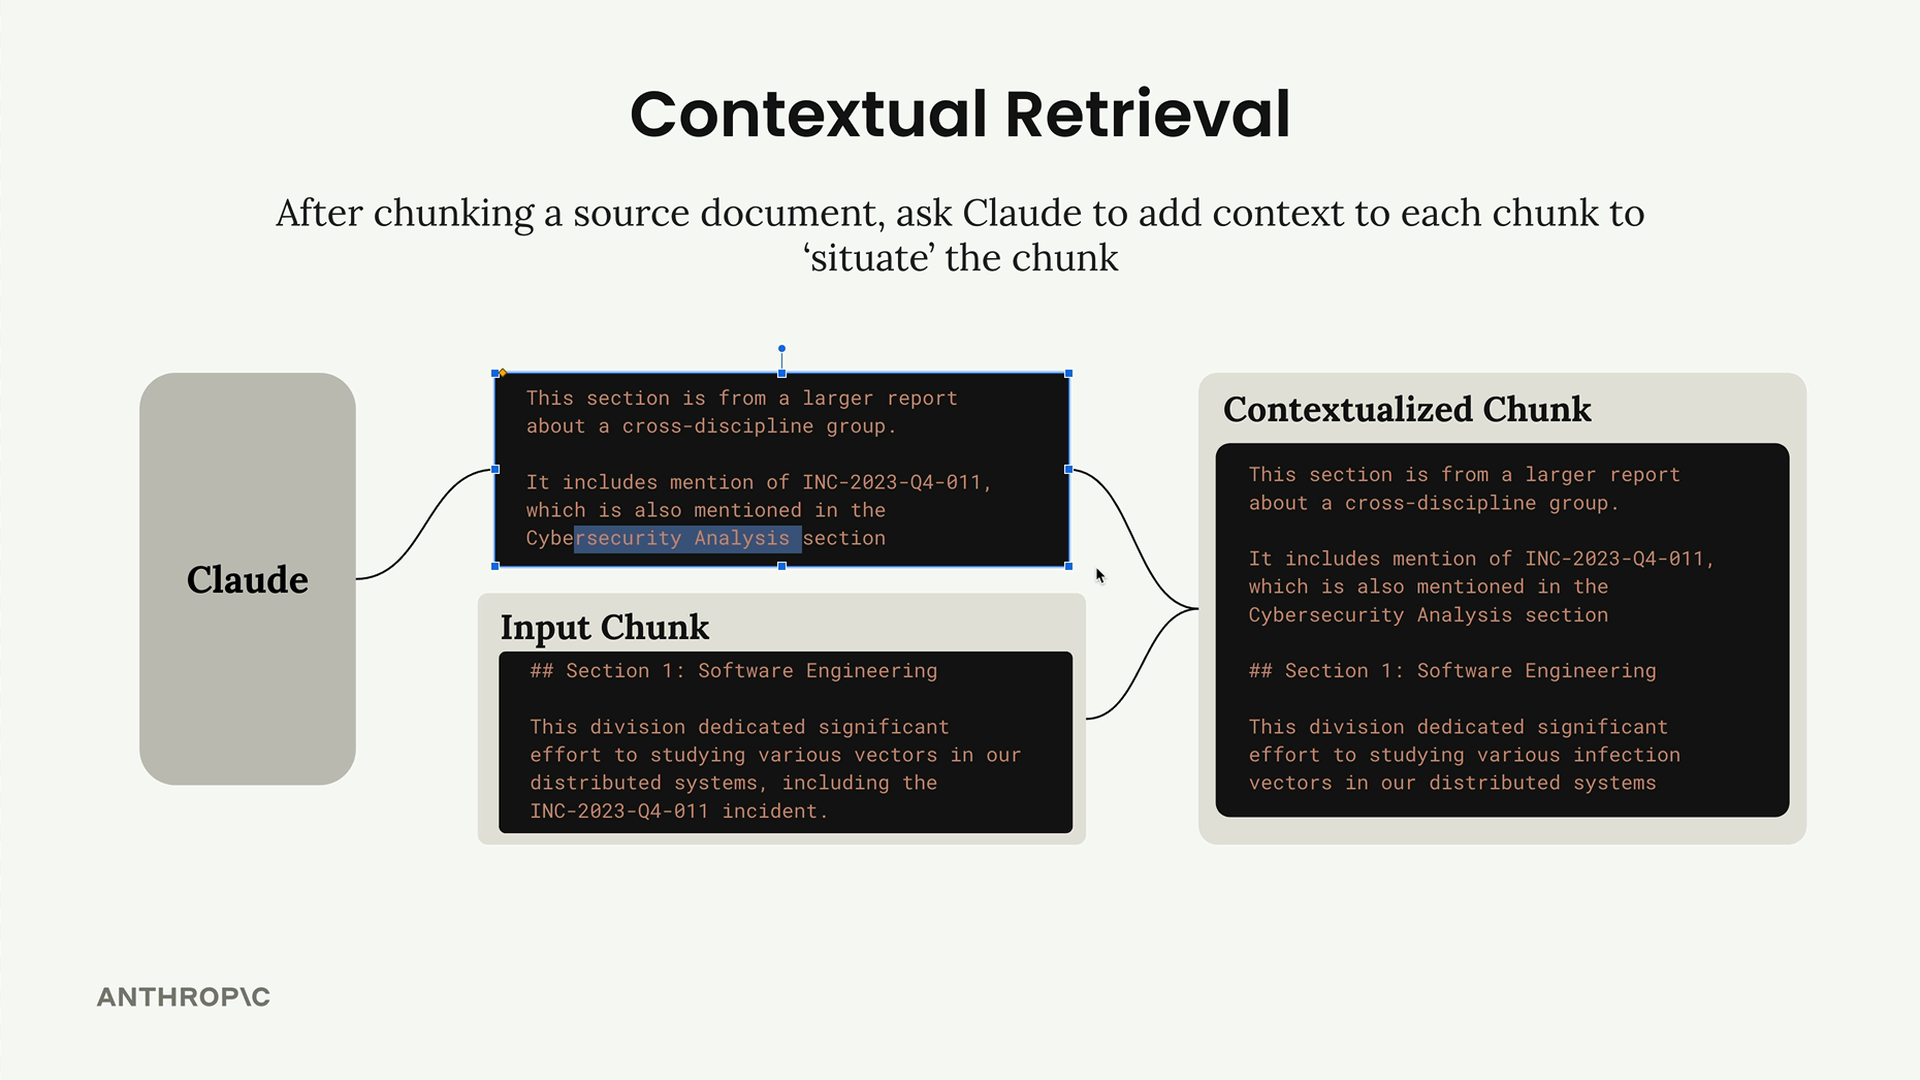
Par exemple, si vous avez une section sur l'ingénierie logicielle qui mentionne un incident de 2023, Claude pourrait générer un contexte comme : « Cette section provient d'un rapport plus large concernant un groupe pluridisciplinaire. Elle mentionne l'INC-2023-04-011, également mentionné dans la section Analyse de cybersécurité. »
Gestion des documents volumineux
Un problème courant survient lorsque votre document source est trop volumineux pour tenir dans la fenêtre de contexte de Claude. Vous pouvez toujours utiliser la récupération contextuelle en fournissant un ensemble réduit de contexte :
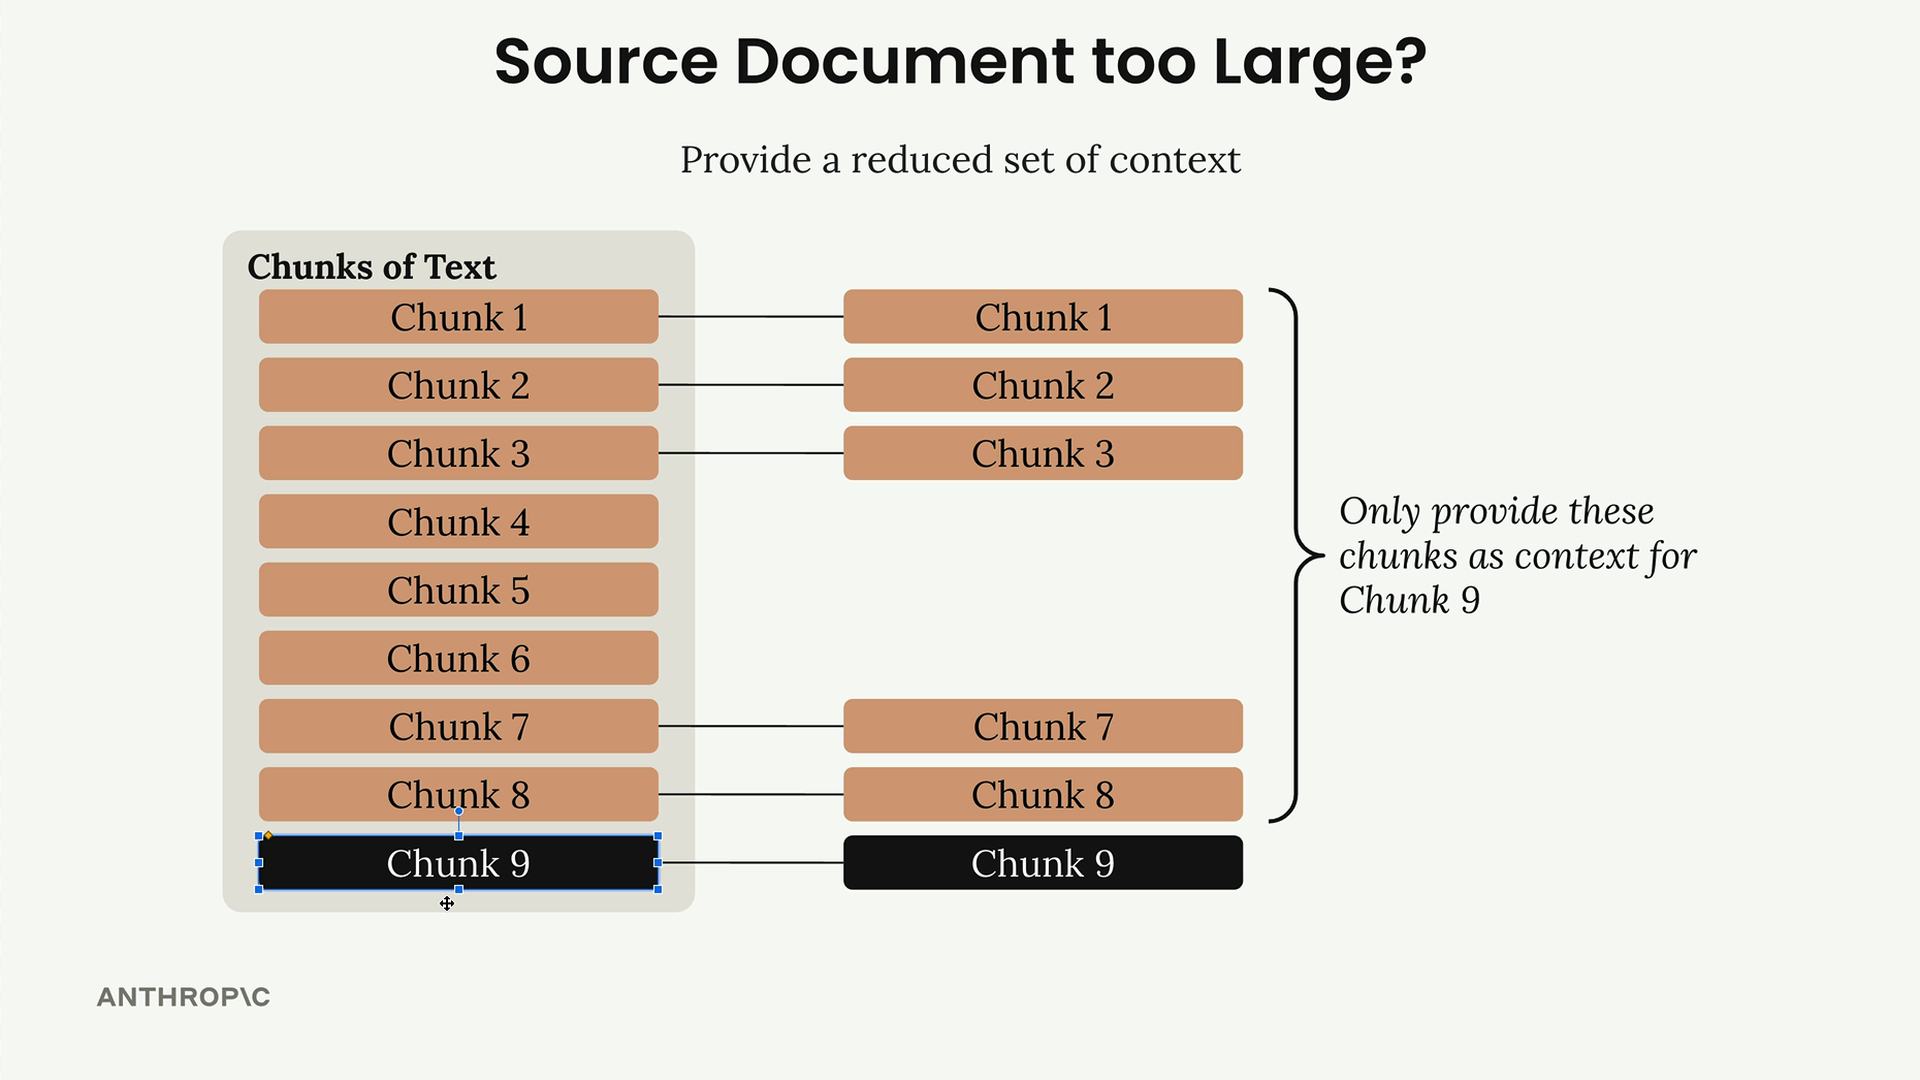
Au lieu d'inclure l'intégralité du document, fournissez :
- Quelques fragments du début du document (contenant souvent des résumés ou des abrégés)
- Les fragments immédiatement précédents au fragment que vous contextualisez
Cette approche donne à Claude suffisamment d'informations pour comprendre la structure du document et le contexte immédiat sans surcharger la requête.
Exemple d'implémentation
Voici une fonction basique pour ajouter du contexte aux fragments :
def add_context(text_chunk, source_text):
    prompt = f"""
Write a short and succinct snippet of text to situate this chunk within the
overall source document for the purposes of improving search retrieval of the chunk.

Here is the original source document:
<document>
{source_text}
</document>

Here is the chunk we want to situate within the whole document:
<chunk>
{text_chunk}
</chunk>

Answer only with the succinct context and nothing else.
"""

    messages = []
    add_user_message(messages, prompt)
    result = chat(messages)

    return text_from_message(result) + "\n" + text_chunk
Pour les documents volumineux, vous pouvez mettre en œuvre une stratégie qui sélectionne les fragments de contexte pertinents :
# Ajouter du contexte à chaque extrait de code, puis l'ajouter au récupérateur
num_start_chunks = 2
num_prev_chunks = 2

for i, chunk in enumerate(chunks):
    context_parts = []

    # Ensemble initial d'extraits de code depuis le début du document
    context_parts.extend(chunks[: min(num_start_chunks, len(chunks))])

    # Extraits de code supplémentaires en amont de l'extrait actuellement contextualisé
    start_idx = max(0, i - num_prev_chunks)
    context_parts.extend(chunks[start_idx:i])

    context = "\n".join(context_parts)

    contextualized_chunk = add_context(chunk, context)
    retriever.add_document({"content": contextualized_chunk})
Quand utiliser la récupération contextuelle
Cette technique est particulièrement utile lorsque :
- Vos documents ont des relations internes complexes entre les sections
- Les fragments font référence à des concepts définis ailleurs dans le document
- La compréhension de la structure du document est importante pour une récupération précise
- Vous travaillez avec des documents techniques, des rapports ou des articles académiques
Bien que la récupération contextuelle ajoute du temps de traitement et des coûts (puisque vous effectuez des appels API supplémentaires), elle peut considérablement améliorer la précision de la récupération pour les documents complexes où le contexte compte.