Lorsque vous développez des applications de chat avec Claude, un défi important en matière d'expérience utilisateur se pose : les réponses peuvent prendre de 10 à 30 secondes à générer, laissant les utilisateurs face à un indicateur de chargement. La solution est le streaming des réponses, qui permet aux utilisateurs de voir le texte apparaître morceau par morceau au fur et à mesure que Claude le génère, créant ainsi une sensation beaucoup plus réactive.
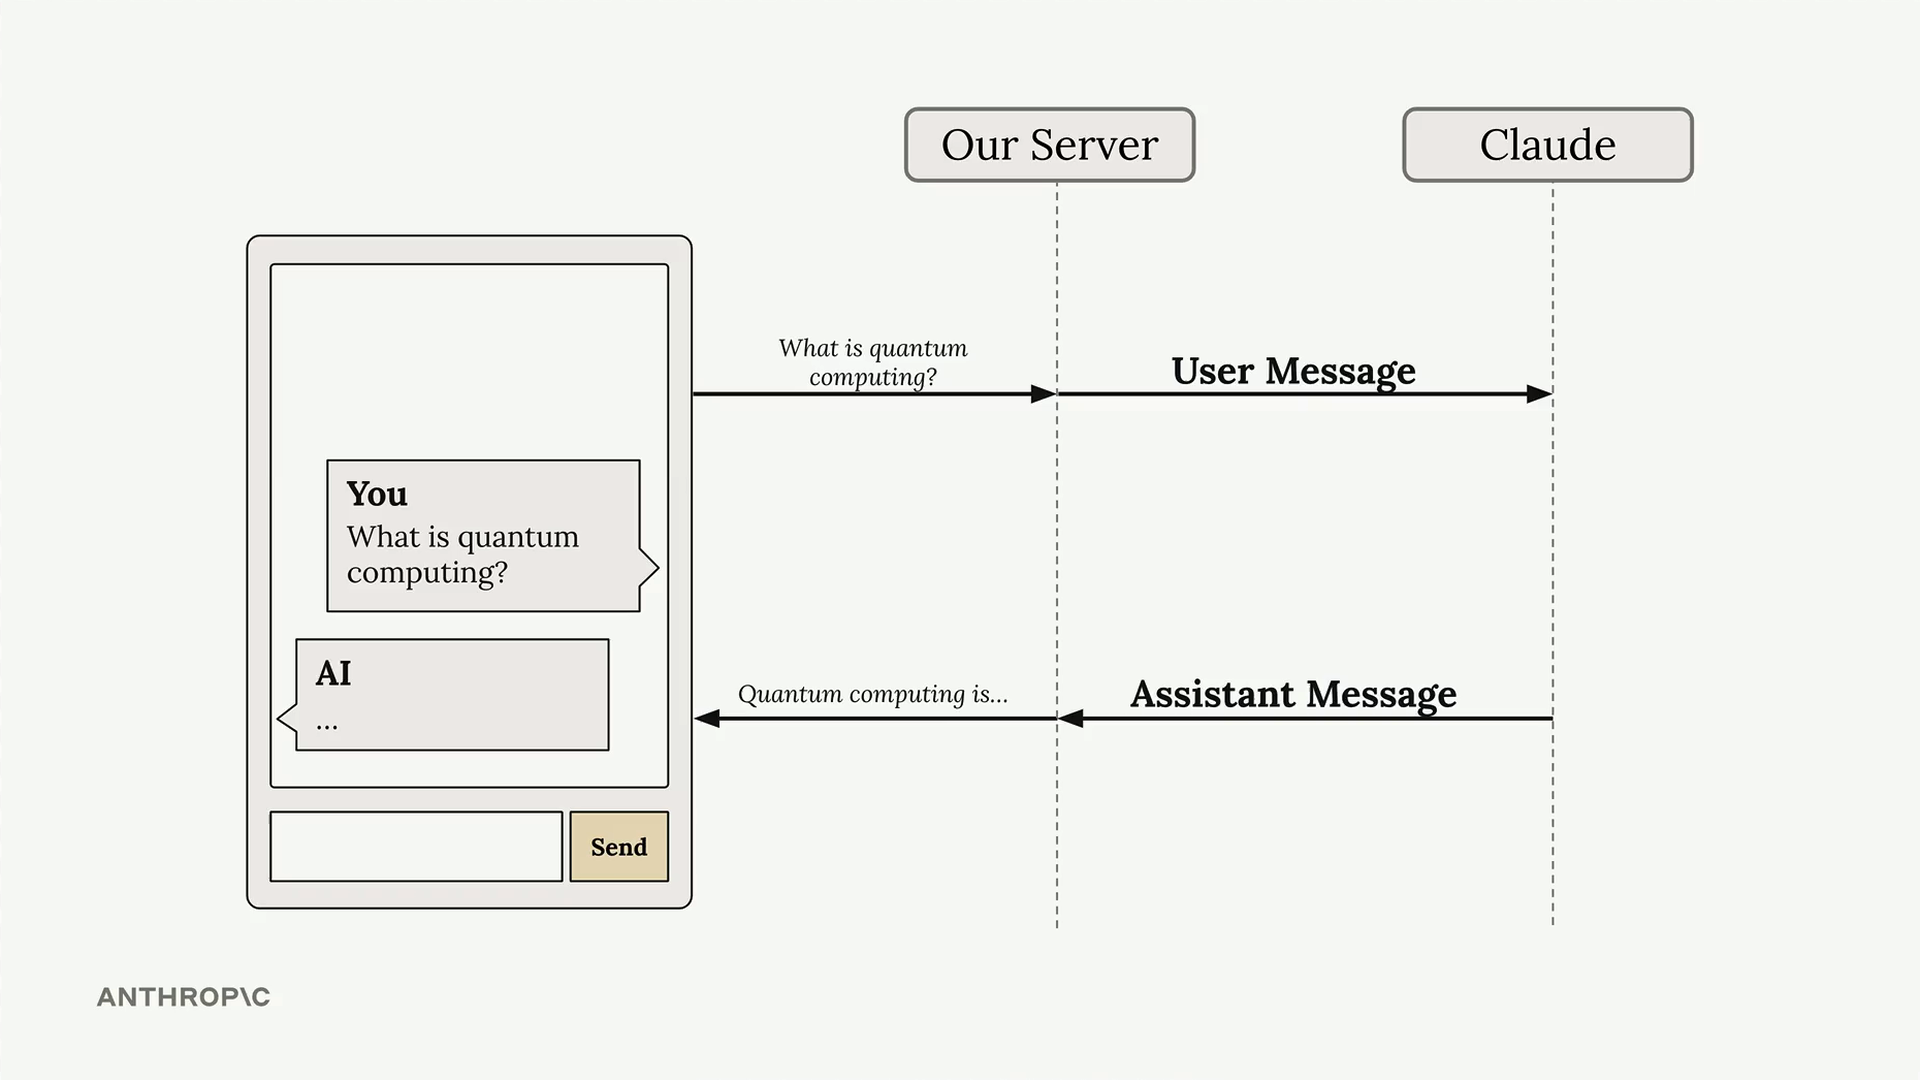
Le problème avec les réponses standard
Dans une configuration de chat classique, votre serveur envoie un message utilisateur à Claude et attend la réponse complète avant de renvoyer quoi que ce soit au client. Cela crée un délai gênant pendant lequel les utilisateurs n'ont aucun retour indiquant que quelque chose se passe.
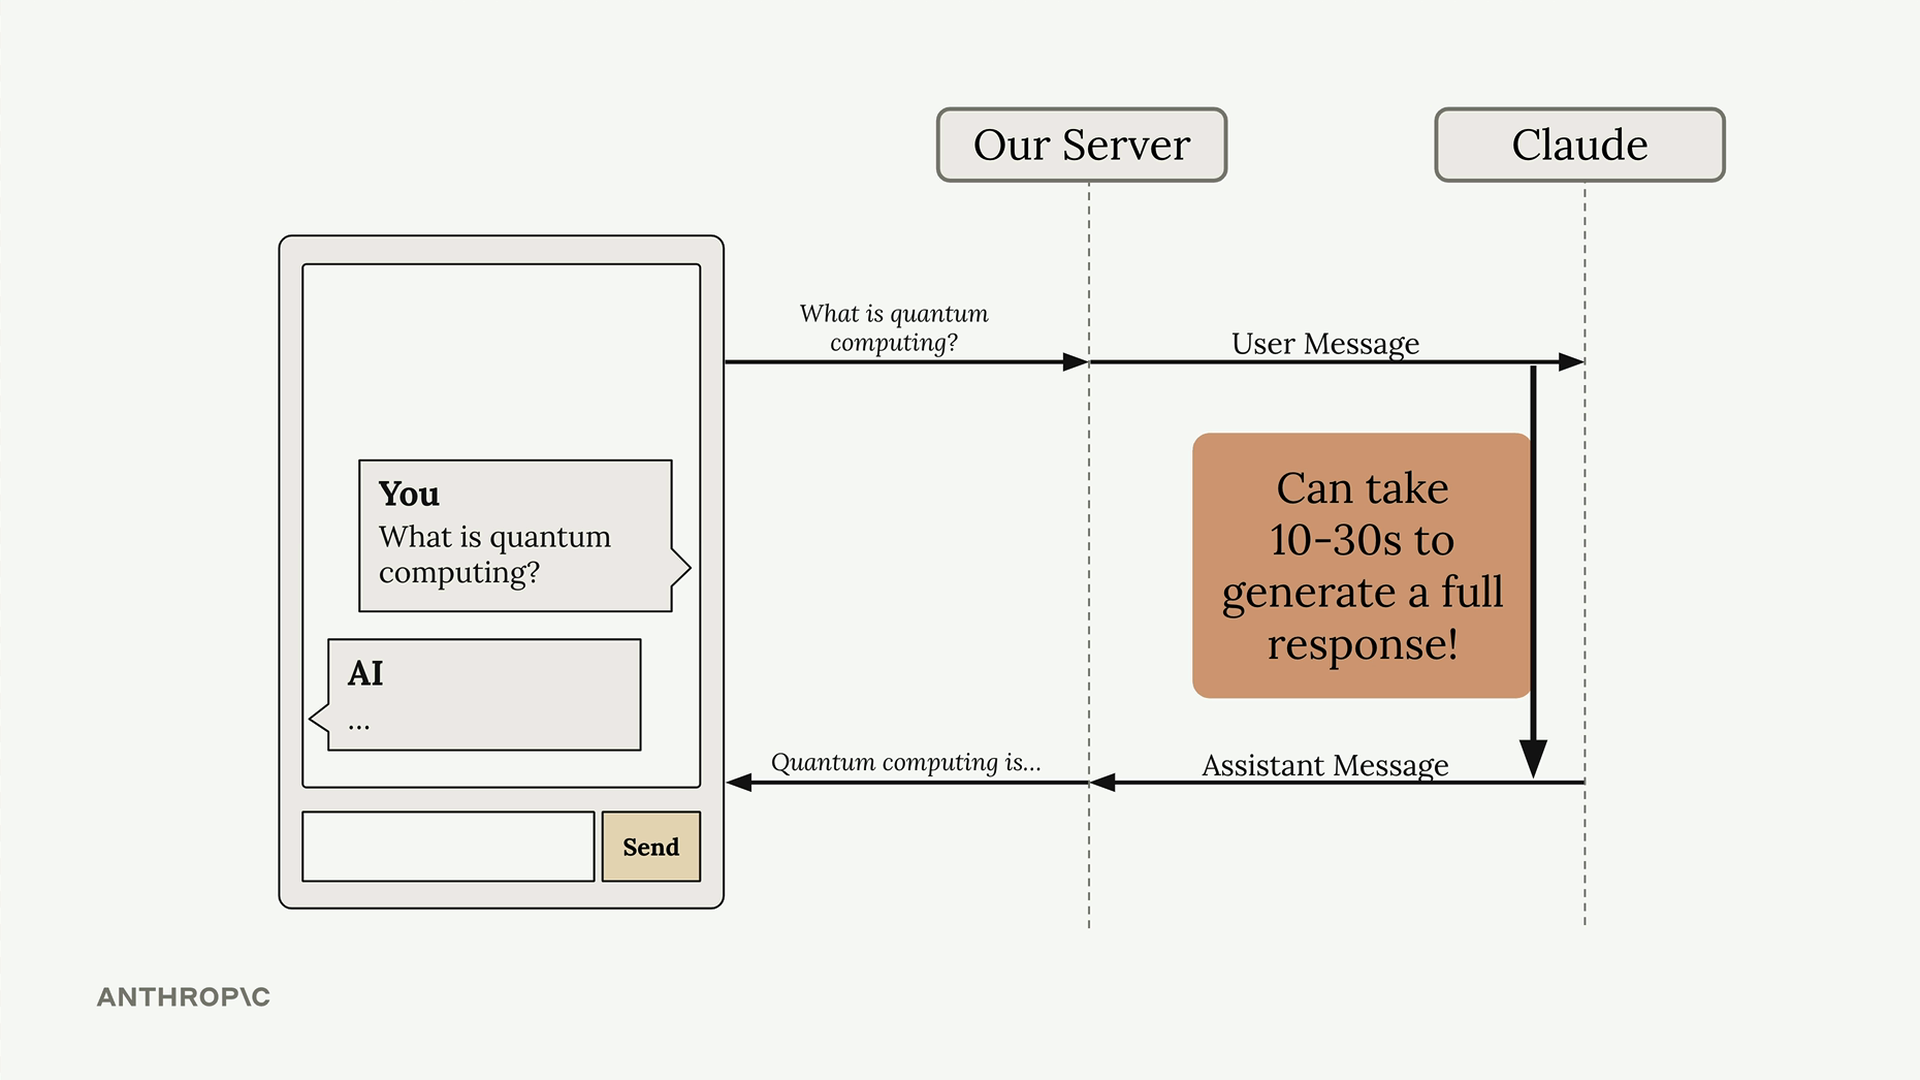
Comment fonctionne le streaming
Lorsque le streaming est activé, Claude renvoie immédiatement une réponse initiale indiquant qu'il a bien reçu votre requête et qu'il commence à générer du texte. Vous recevez ensuite une série d'événements, chacun contenant une petite partie de la réponse globale.
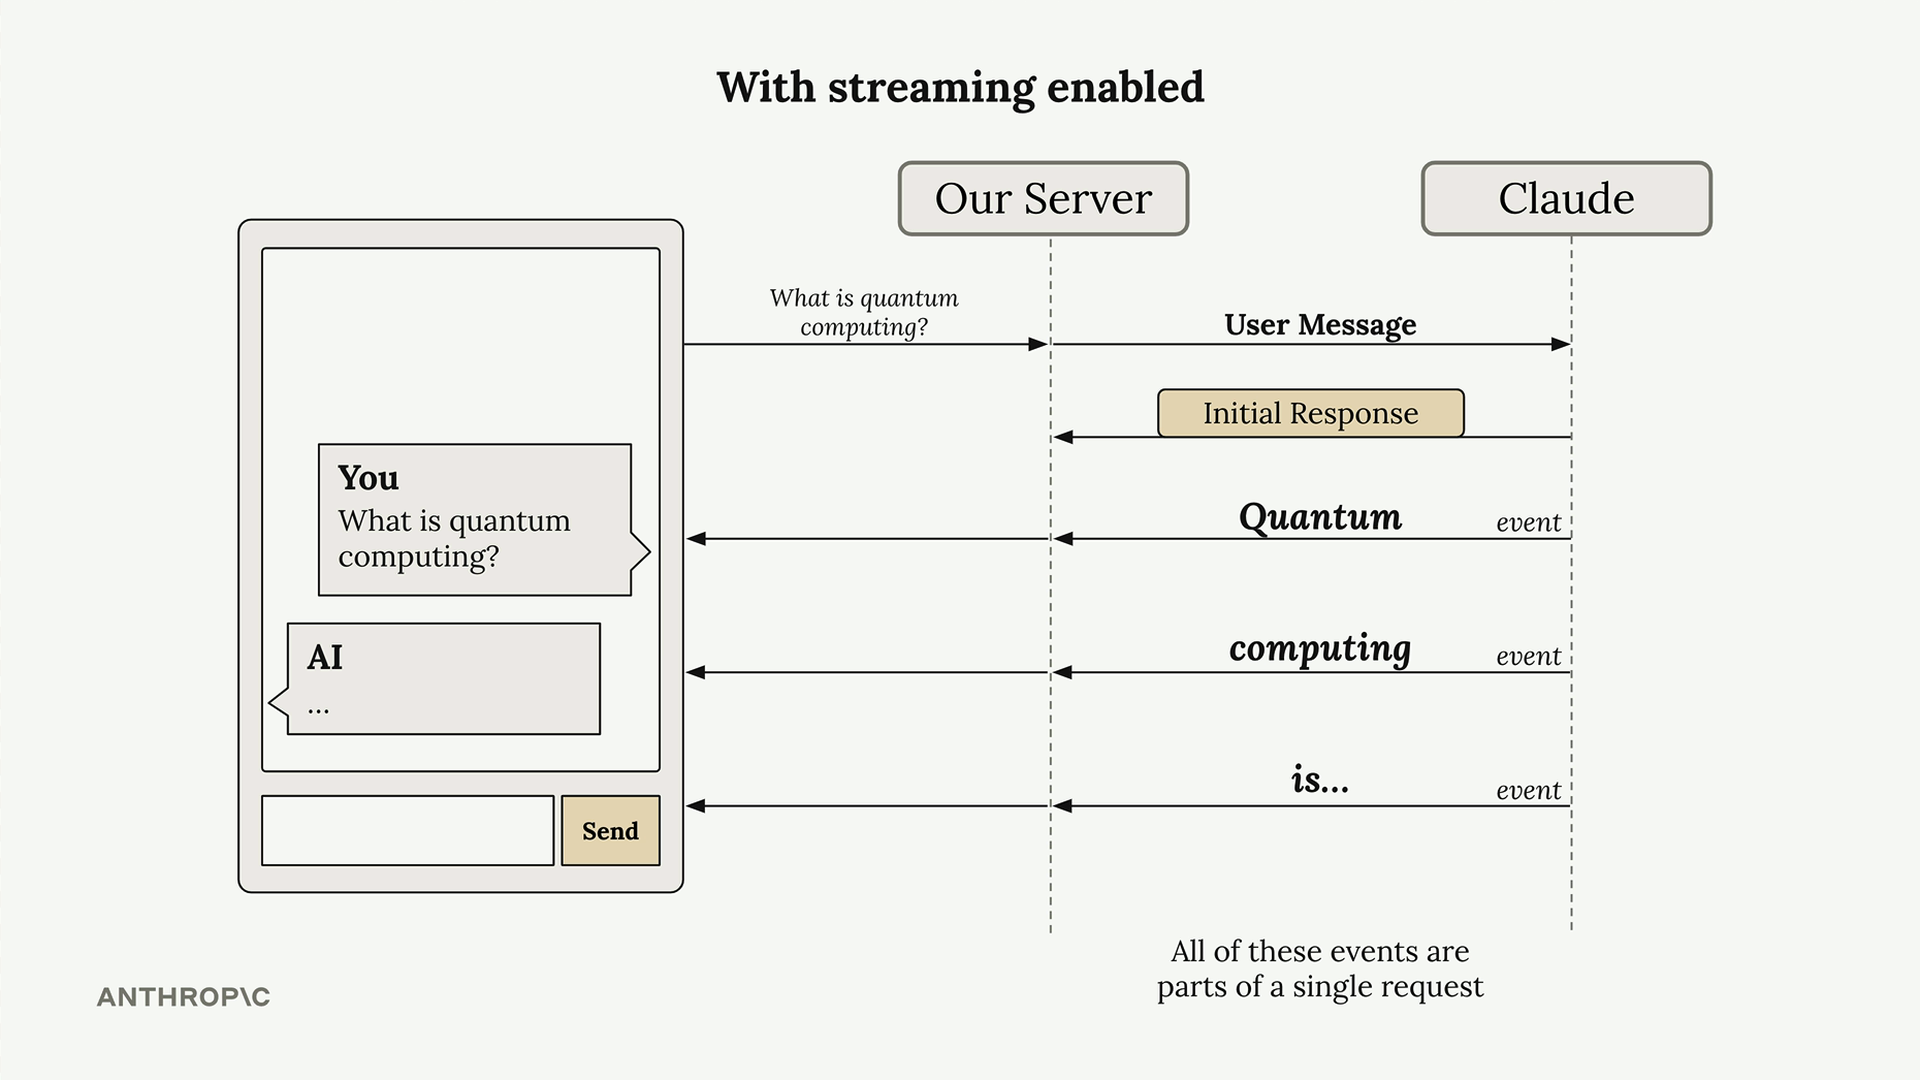
Votre serveur peut transmettre ces morceaux de texte à votre application cliente au fur et à mesure de leur arrivée, permettant aux utilisateurs de voir la réponse se construire mot par mot. Tous ces événements font partie d'une seule et même requête adressée à Claude.
Comprendre les événements de streaming
Lorsque vous activez le streaming, Claude renvoie plusieurs types d'événements :
- MessageStart - Un nouveau message est en cours d'envoi
- ContentBlockStart - Début d'un nouveau bloc contenant du texte, de l'utilisation d'outils ou un autre type de contenu
- ContentBlockDelta - Morceaux du texte réellement généré
- ContentBlockStop - Le bloc de contenu en cours a été complété
- MessageDelta - Le message en cours est complet
- MessageStop - Fin des informations relatives au message en cours
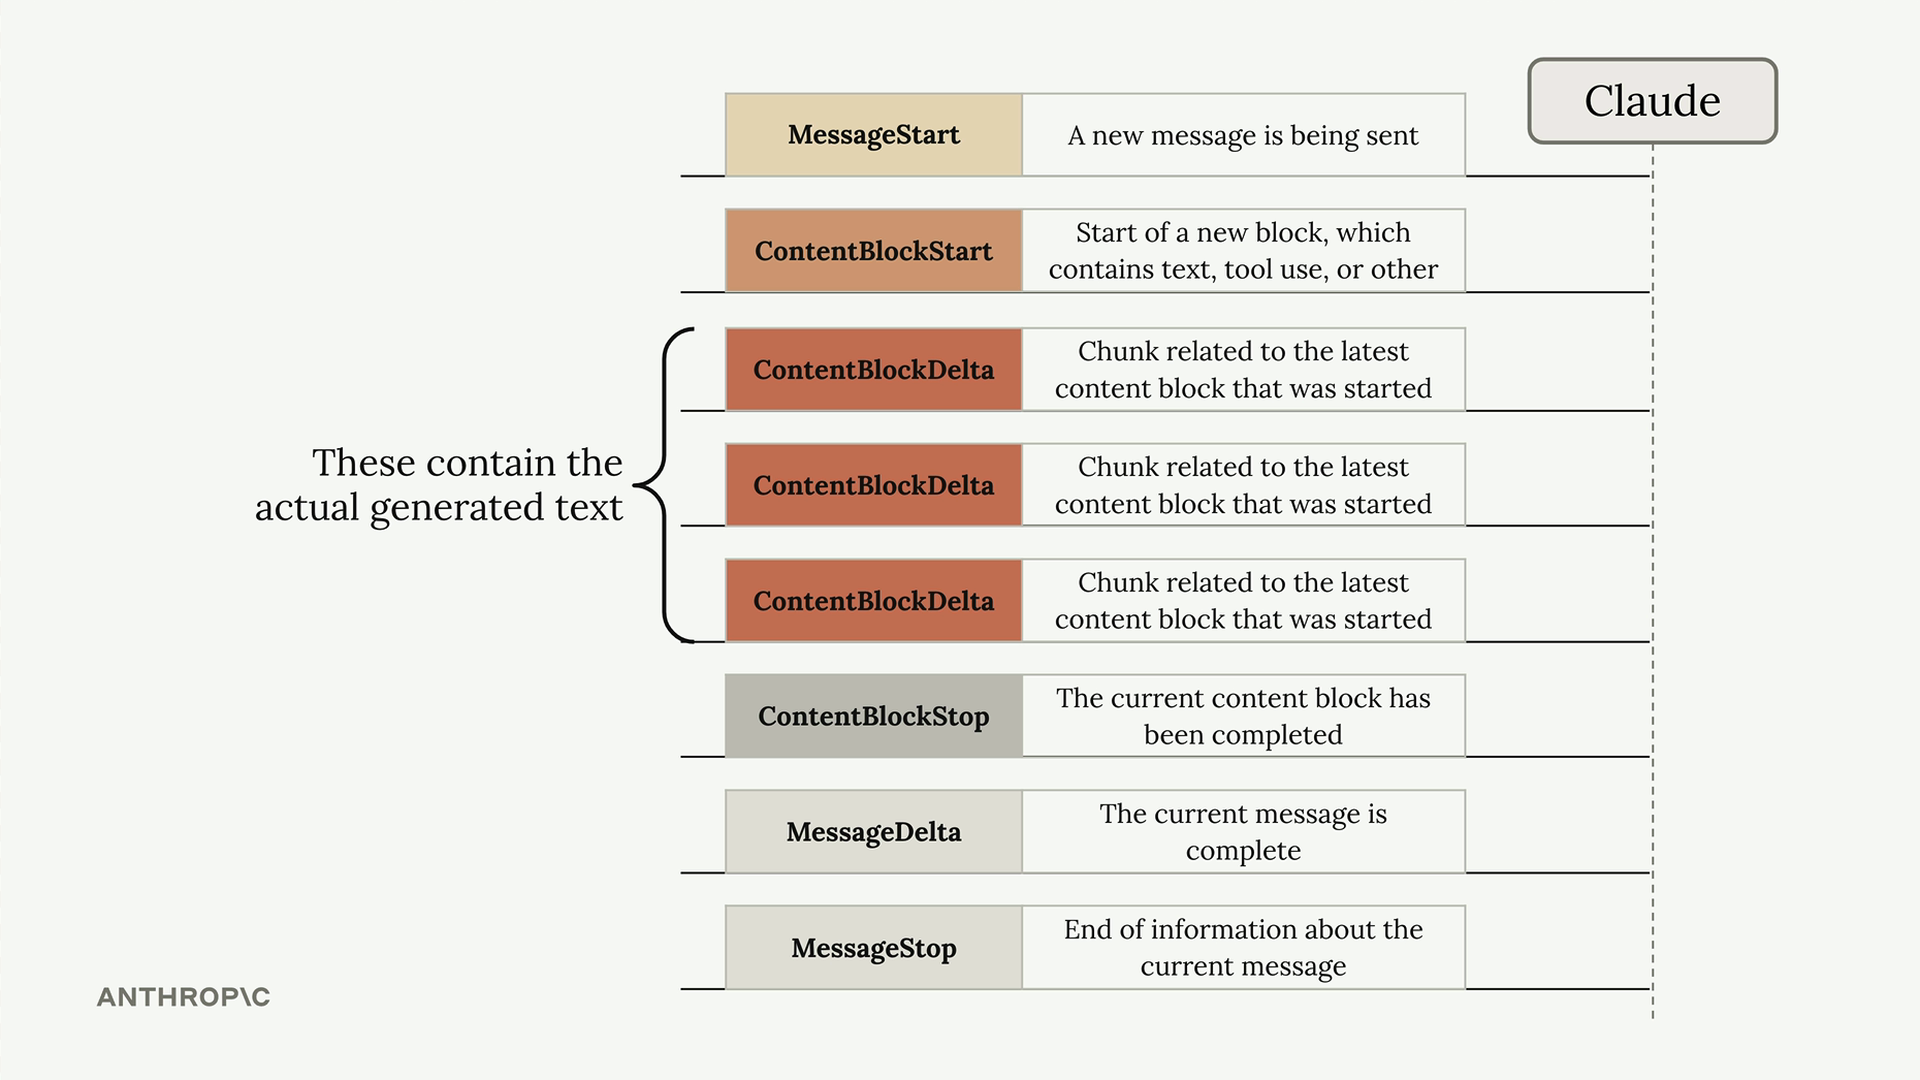
Les événements ContentBlockDelta contiennent le texte réellement généré que vous voudrez afficher aux utilisateurs.
Mise en œuvre de base du streaming
Pour activer le streaming, ajoutez stream=True à votre appel messages.create :
messages = []
add_user_message(messages, "Write a 1 sentence description of a fake database")

stream = client.messages.create(
    model=model,
    max_tokens=1000,
    messages=messages,
    stream=True
)

for event in stream:
    print(event)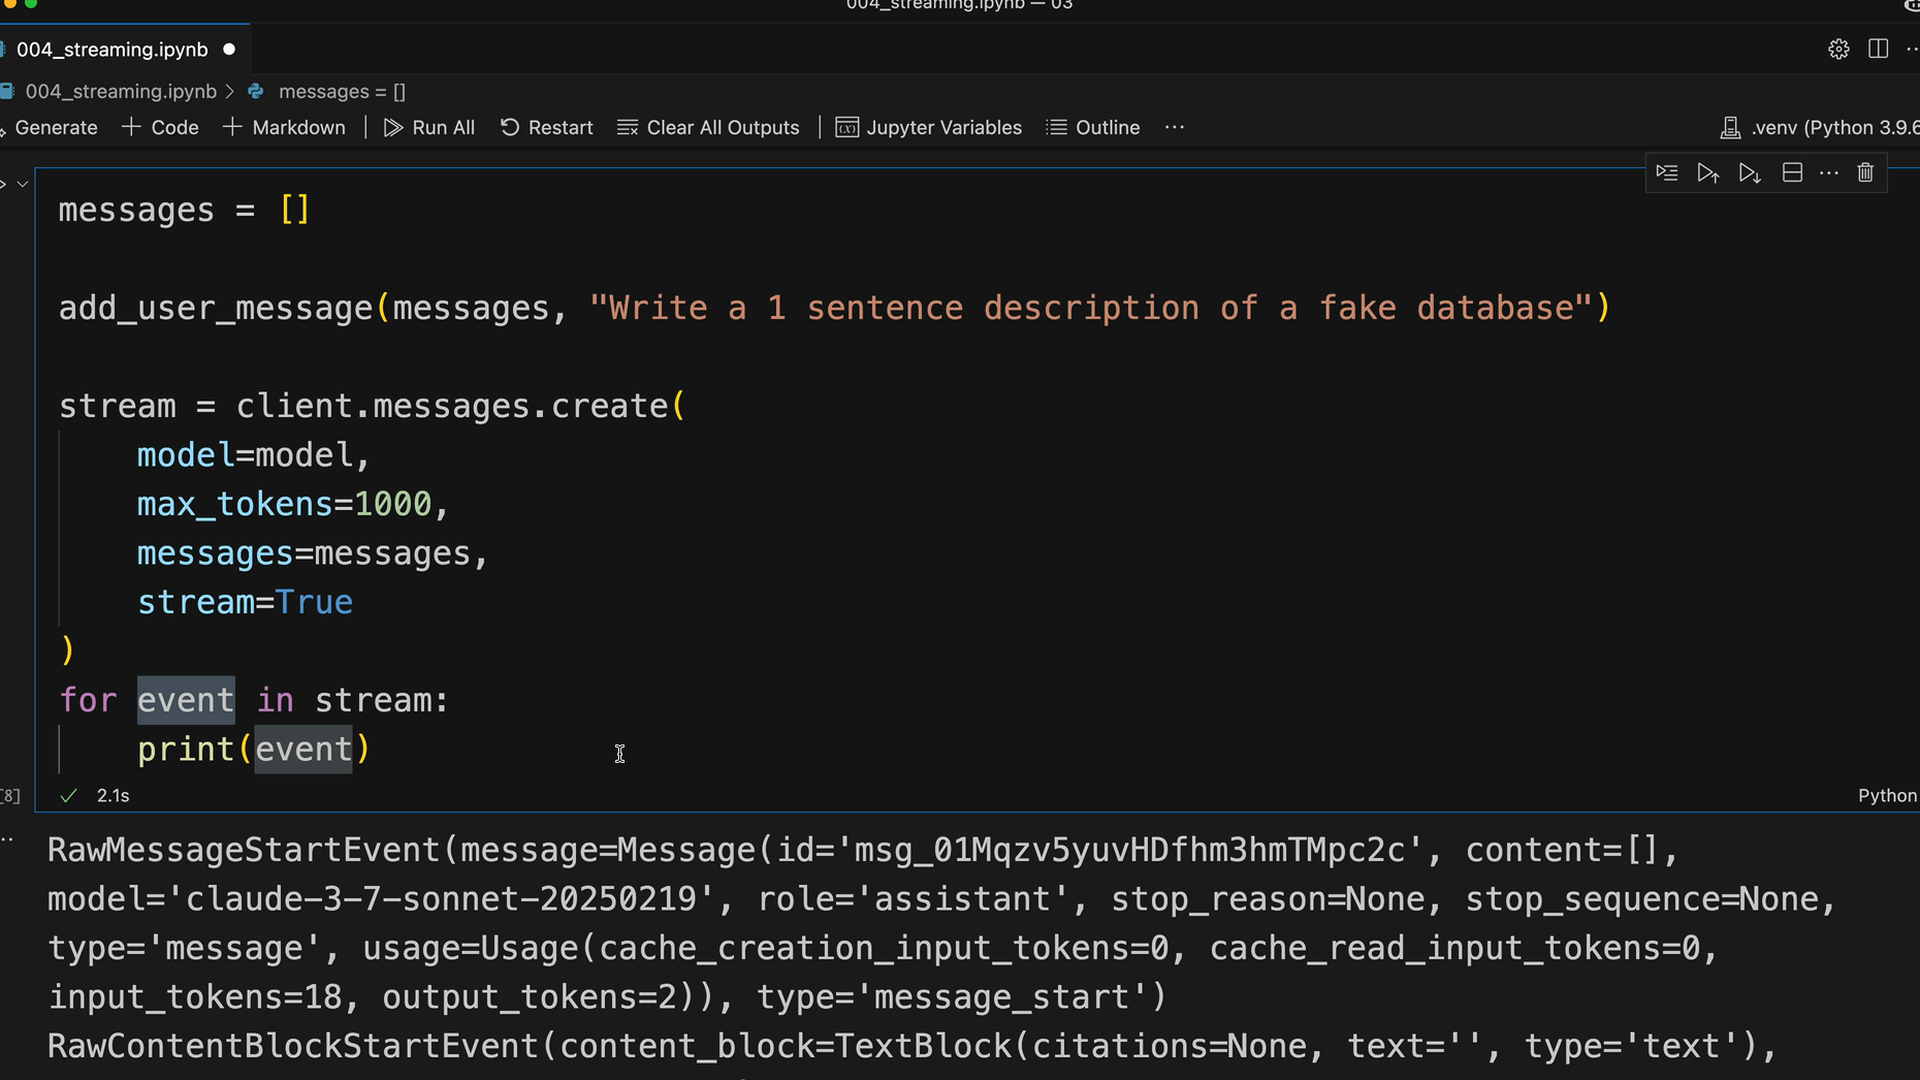
Streaming de texte simplifié
Plutôt que d'analyser manuellement les événements, vous pouvez utiliser l'interface de streaming simplifiée du SDK qui extrait uniquement le contenu textuel :
with client.messages.stream(
    model=model,
    max_tokens=1000,
    messages=messages
) as stream:
    for text in stream.text_stream:
        print(text, end="")
Cette approche filtre automatiquement tout sauf le contenu textuel réel, ce qui correspond généralement à ce dont vous avez besoin pour afficher les réponses aux utilisateurs.
Obtenir le message final
Bien que le streaming soit excellent pour l'expérience utilisateur, vous avez souvent besoin du message complet pour le stockage ou un traitement ultérieur. Une fois le streaming terminé, vous pouvez obtenir le message final assemblé :
with client.messages.stream(
    model=model,
    max_tokens=1000,
    messages=messages
) as stream:
    for text in stream.text_stream:
        pass  # Send to client in real application

    final_message = stream.get_final_message()
Cela vous donne à la fois la capacité de streaming pour l'expérience utilisateur et l'objet message complet pour le stockage en base de données ou l'historique des conversations.
Considérations pratiques
Chaque morceau de texte dans le flux peut contenir plusieurs mots, voire des phrases complètes - vous n'êtes pas garanti de recevoir exactement un mot par événement. La taille des morceaux dépend de la rapidité avec laquelle Claude génère chaque portion de texte.
Dans les applications en production, vous transmettrez généralement ces morceaux de texte immédiatement à votre application cliente via des WebSockets ou des Server-Sent Events, permettant aux utilisateurs de voir les réponses apparaître en temps réel tout en conservant l'historique complet de la conversation sur votre serveur.