Nachdem wir die Grundlagen von RAG, Text-Chunking und Embeddings behandelt haben, gehen wir nun Schritt für Schritt die komplette RAG-Pipeline durch. Dieses Beispiel zeigt dir genau, wie all diese Teile zusammenarbeiten, um relevante Informationen abzurufen und Antworten zu generieren.
Schritt 1: Deinen Quelltext in Chunks aufteilen
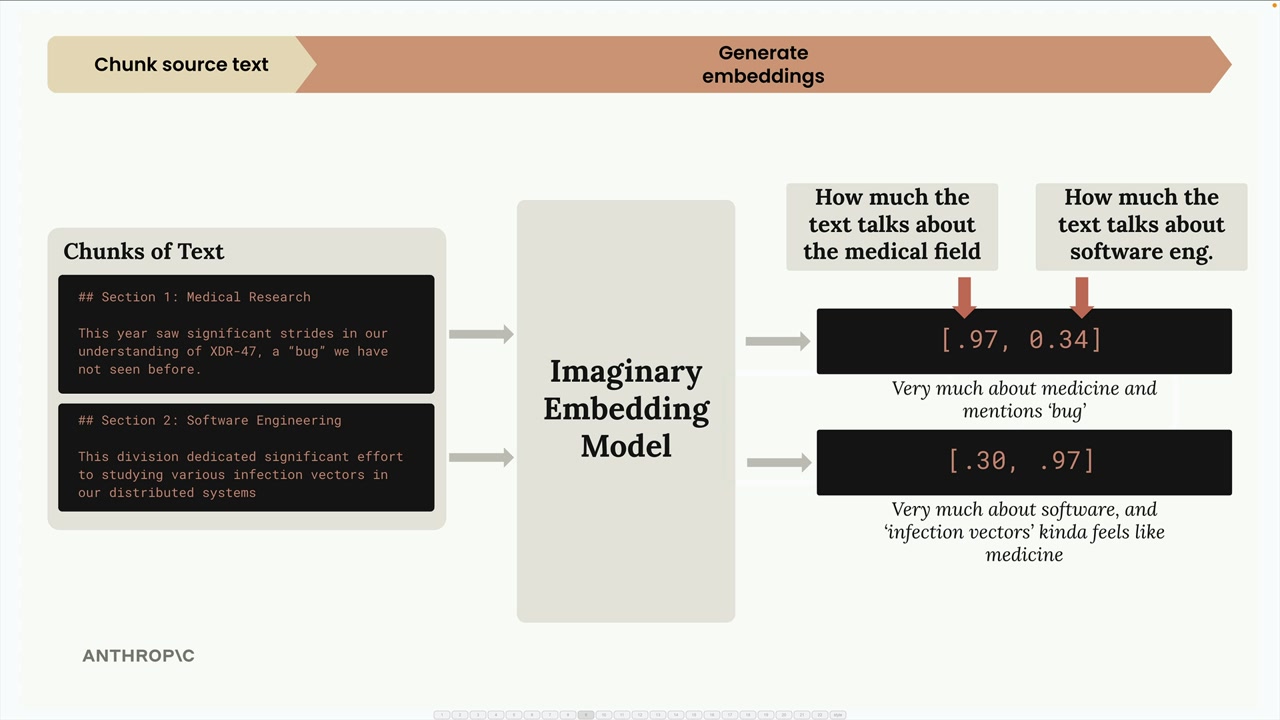
Zunächst nehmen wir unser Quelldokument und teilen es in handhabbare Chunks auf. Für dieses Beispiel verwenden wir zwei einfache Textabschnitte:
- Abschnitt 1: Medizinische Forschung - „Dieses Jahr gab es bedeutende Fortschritte in unserem Verständnis von XDR-47, einem 'Bug', den wir zuvor noch nicht gesehen haben."
- Abschnitt 2: Software-Engineering - „Diese Abteilung widmete sich intensiv der Untersuchung verschiedener Infektionsvektoren in unseren verteilten Systemen"
Schritt 2: Embeddings generieren
Als Nächstes wandeln wir jeden Text-Chunk mithilfe eines Embedding-Modells in numerische Embeddings um. Um dies leichter verständlich zu machen, stellen wir uns vor, wir hätten ein perfektes Embedding-Modell, das immer genau zwei Zahlen zurückgibt, und wir wissen, wofür jede Zahl steht.
In unserem imaginären Modell:
- Die erste Zahl gibt an, wie stark der Text über den medizinischen Bereich spricht
- Die zweite Zahl gibt an, wie stark der Text über Software-Engineering spricht
Für den Abschnitt zur medizinischen Forschung erhalten wir vielleicht [0.97, 0.34] - stark medizinfokussiert, aber mit einigen Software-Elementen wegen des Wortes „Bug". Für den Abschnitt zum Software-Engineering erhalten wir [0.30, 0.97] - stark softwarefokussiert, aber mit medizinischen Untertönen durch „Infektionsvektoren".
Normalisierung
Die Embedding-API führt typischerweise einen Normalisierungsschritt durch, der jeden Vektor so skaliert, dass er eine Magnitude von 1,0 hat. Du musst dir über die Mathematik dahinter keine Gedanken machen - sie wird automatisch erledigt. Das ergibt normalisierte Vektoren wie [0.944, 0.331] und [0.295, 0.955].
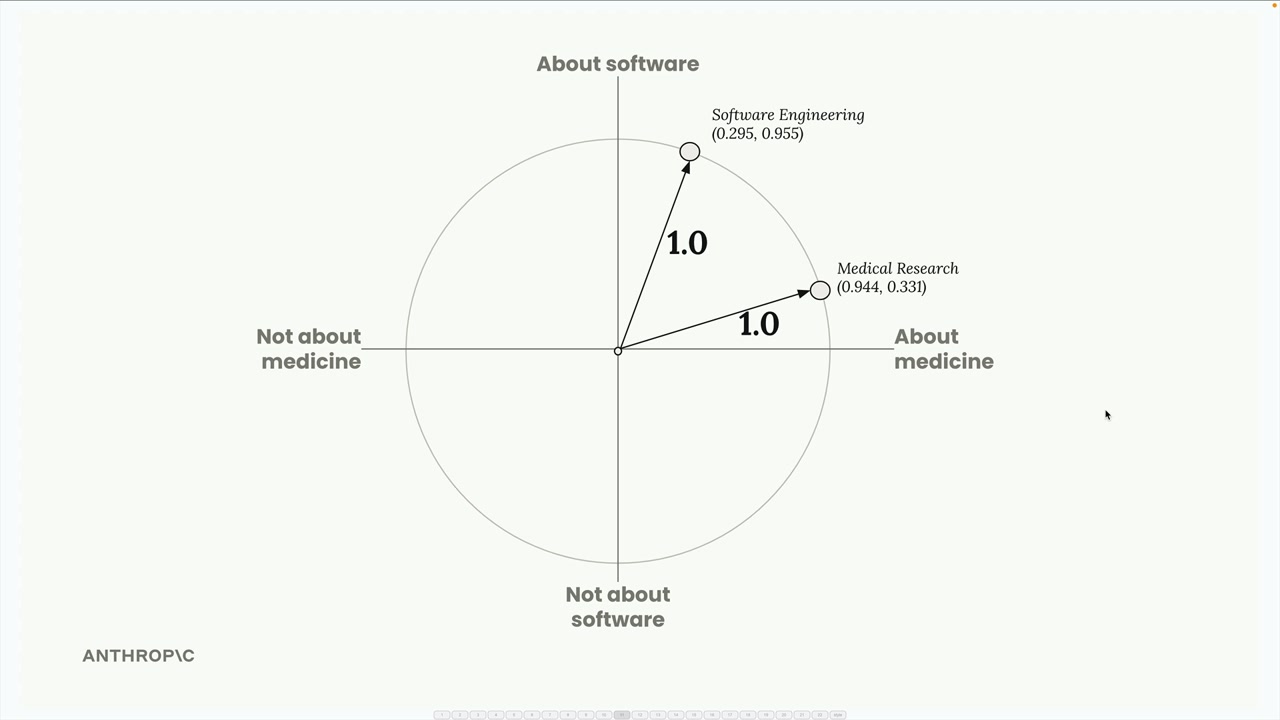
Wir können diese Embeddings auf einem Einheitskreis visualisieren, wobei jeder Punkt einen unserer Text-Chunks repräsentiert.
Schritt 3: In der Vektordatenbank speichern
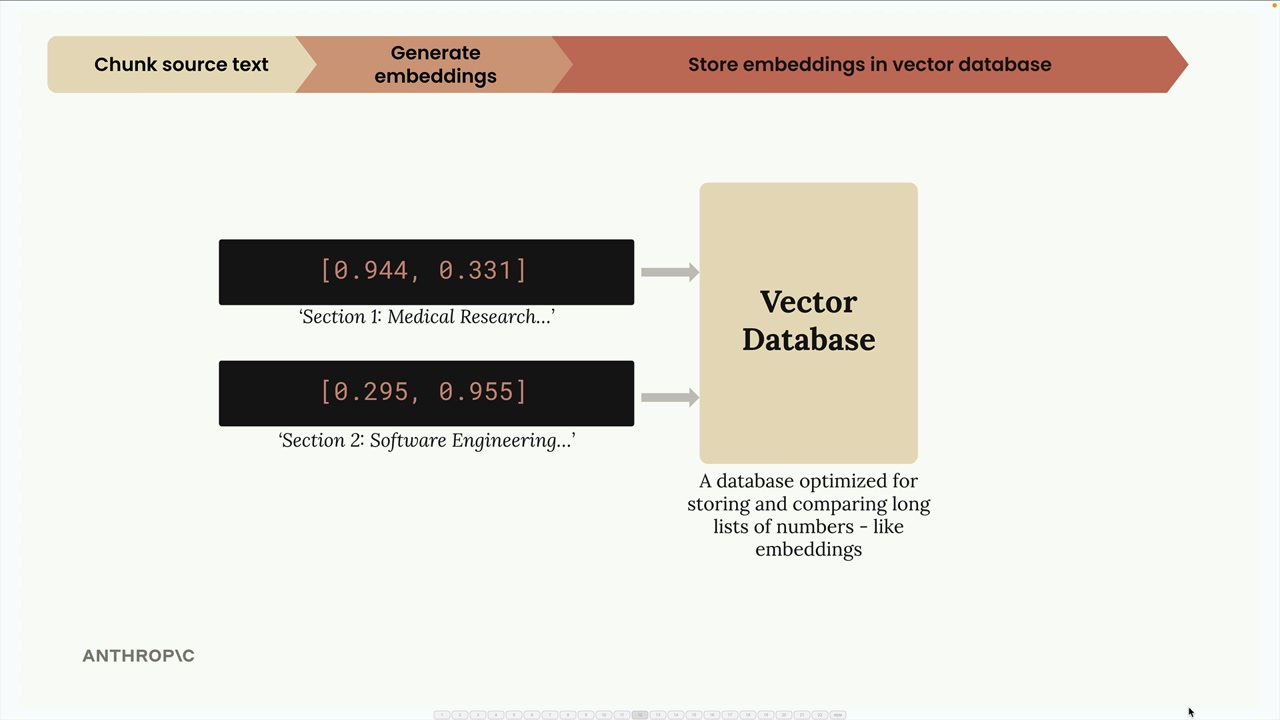
Wir speichern diese Embeddings in einer Vektordatenbank - einer spezialisierten Datenbank, die darauf optimiert ist, lange Listen von Zahlen wie unsere Embeddings zu speichern, zu vergleichen und zu durchsuchen.
An diesem Punkt pausieren wir. Die gesamte bisherige Arbeit war Vorverarbeitung, die im Voraus geschieht. Jetzt warten wir darauf, dass ein Nutzer eine Anfrage stellt.
Schritt 4: Nutzeranfrage verarbeiten
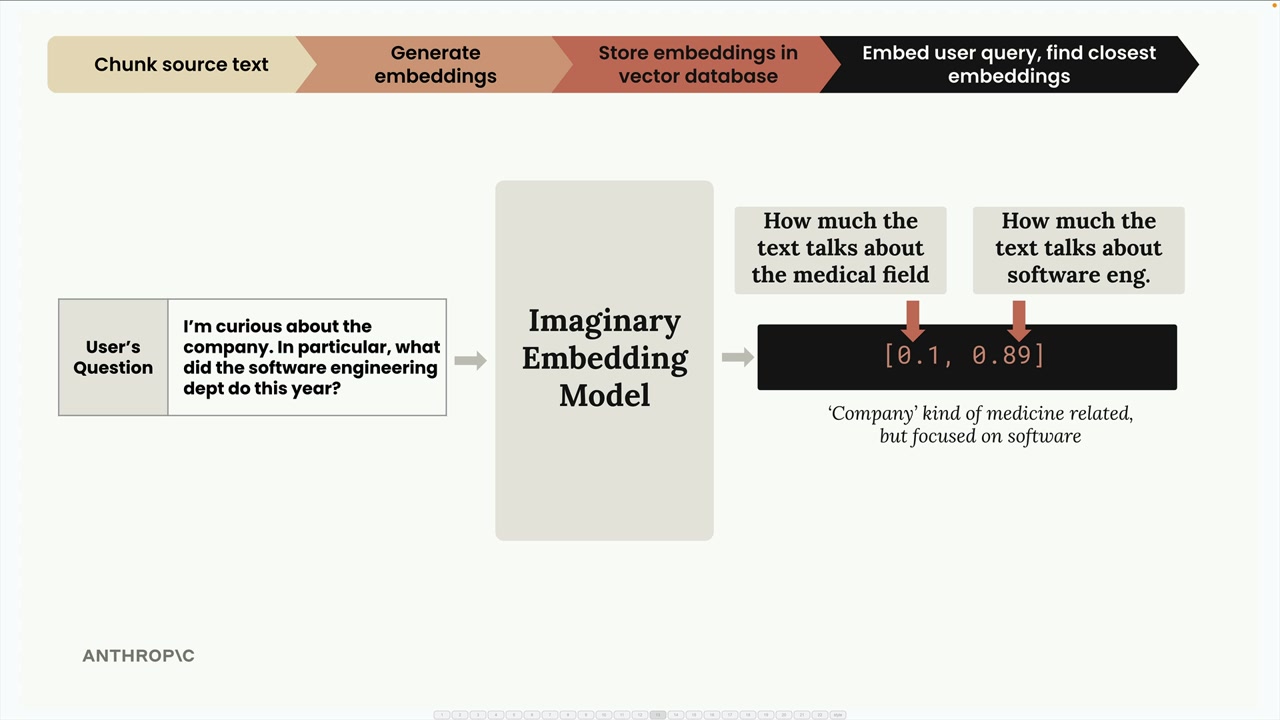
Wenn ein Nutzer eine Frage stellt wie „Ich interessiere mich für das Unternehmen. Was genau hat die Software-Engineering-Abteilung dieses Jahr gemacht?", lassen wir seine Anfrage durch dasselbe Embedding-Modell laufen.
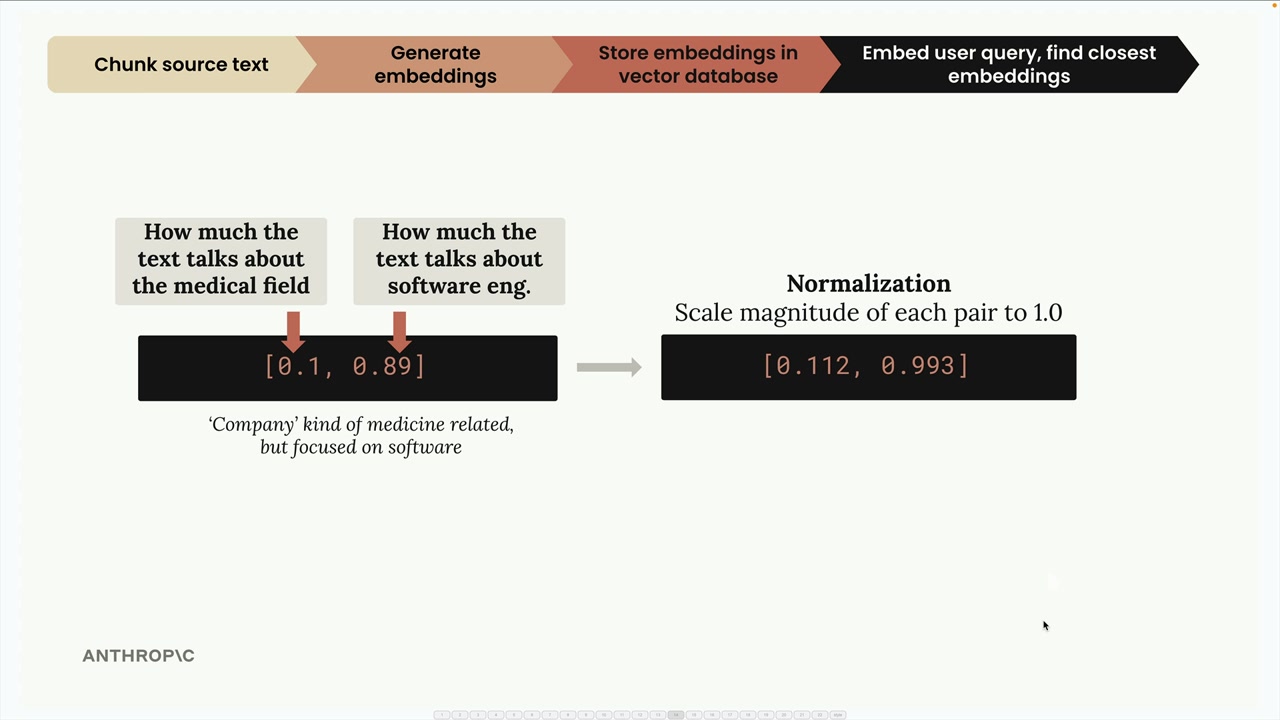
Diese Anfrage wird etwa als [0.1, 0.89] eingebettet - niedriger medizinischer Wert, hoher Software-Engineering-Wert. Nach der Normalisierung erhalten wir [0.112, 0.993].
Schritt 5: Ähnliche Embeddings finden
Wir senden das Embedding der Nutzeranfrage an unsere Vektordatenbank und bitten sie, die ähnlichsten gespeicherten Embeddings zu finden.
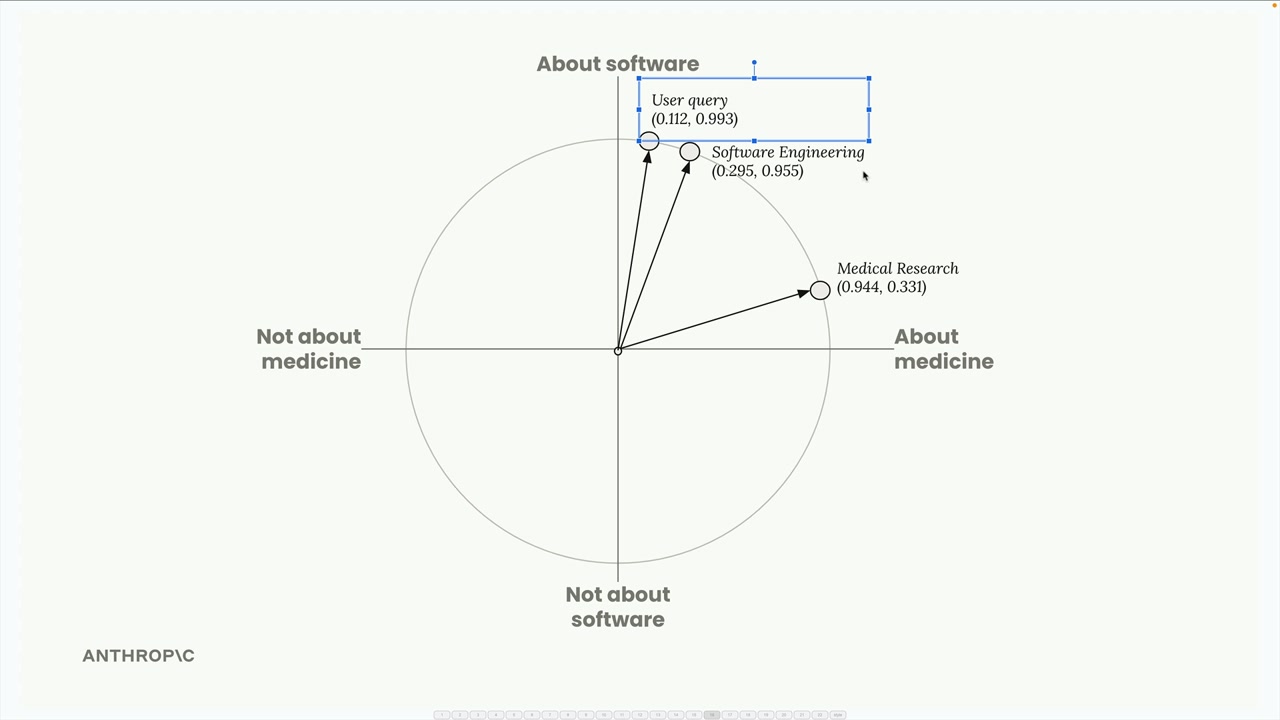
Die Datenbank gibt den Abschnitt zum Software-Engineering zurück, weil er am besten zu dem passt, wonach der Nutzer gefragt hat.
Wie Ähnlichkeit funktioniert: Kosinus-Ähnlichkeit
Die Vektordatenbank verwendet die Kosinus-Ähnlichkeit, um zu bestimmen, welche Embeddings am ähnlichsten sind. Dabei wird der Kosinus des Winkels zwischen zwei Vektoren gemessen.
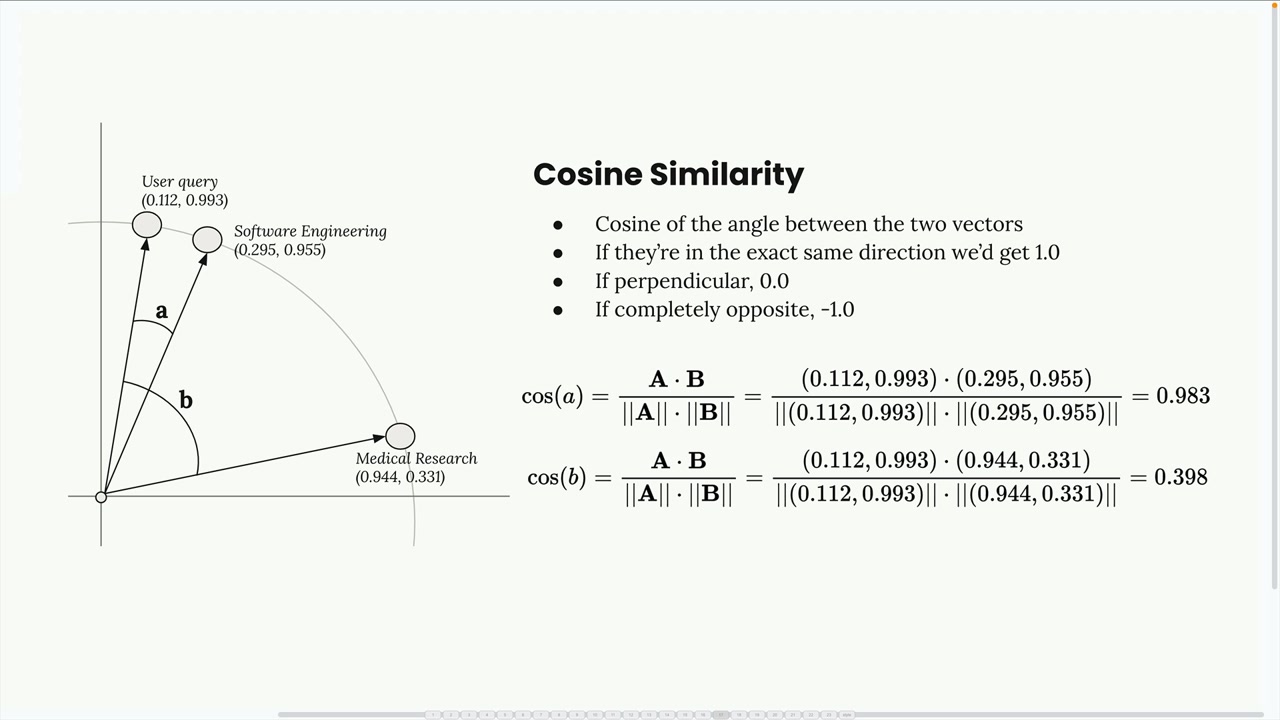
Wichtige Punkte zur Kosinus-Ähnlichkeit:
- Die Ergebnisse liegen im Bereich von -1 bis 1
- Werte nahe 1 bedeuten hohe Ähnlichkeit
- Werte nahe -1 bedeuten sehr unterschiedlich
- 0 bedeutet senkrecht (keine Beziehung)
In unserem Beispiel beträgt die Kosinus-Ähnlichkeit zwischen der Nutzeranfrage und dem Software-Engineering-Chunk 0,983 - eine sehr hohe Ähnlichkeit. Die Ähnlichkeit mit dem medizinischen Forschungs-Chunk liegt nur bei 0,398 - deutlich niedriger.
Kosinus-Distanz
Du wirst in der Dokumentation von Vektordatenbanken oft auf „Kosinus-Distanz" stoßen. Diese wird einfach als (1 - Kosinus-Ähnlichkeit) berechnet. Bei der Kosinus-Distanz gilt:
- Werte nahe 0 bedeuten hohe Ähnlichkeit
- Größere Werte bedeuten weniger Ähnlichkeit
Diese Anpassung macht die Zahlen in vielen Kontexten leichter interpretierbar.
Schritt 6: Den finalen Prompt erstellen
Zum Schluss nehmen wir die Frage des Nutzers und den relevantesten Text-Chunk, den wir gefunden haben, kombinieren sie zu einem Prompt und senden ihn an Claude, um eine Antwort zu erhalten.
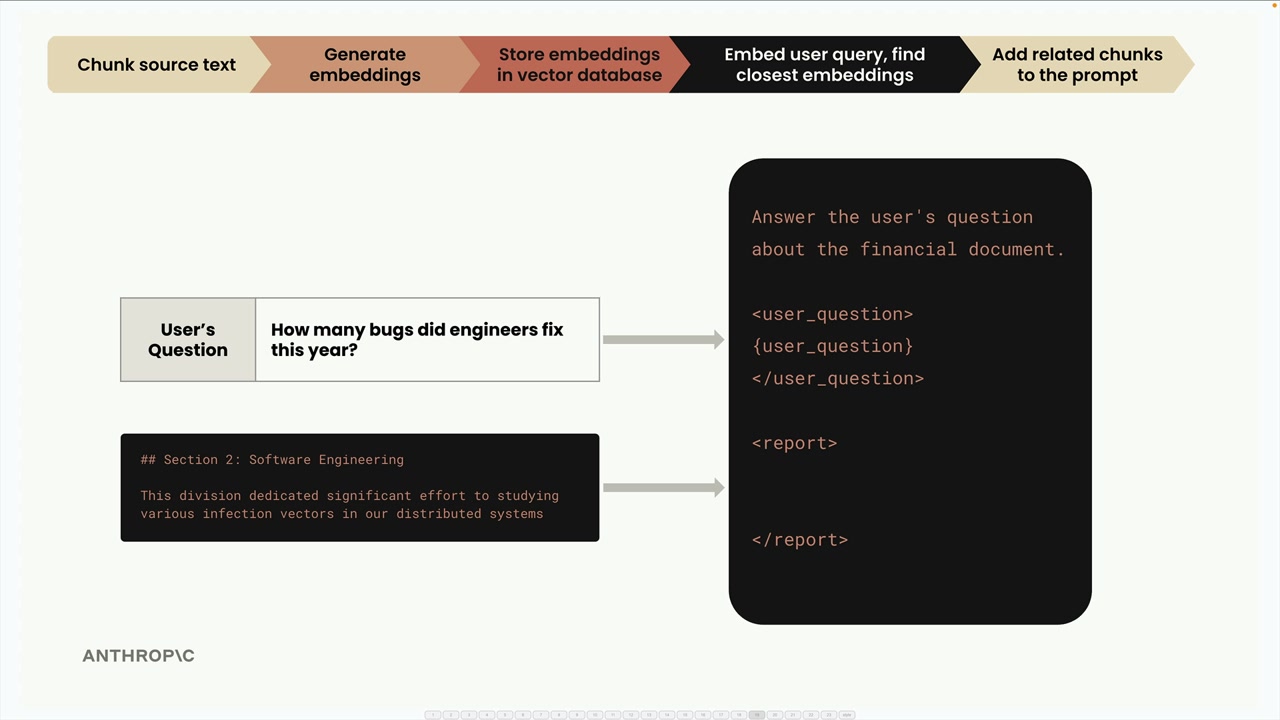
Der Prompt könnte so aussehen:
Answer the user's question about the financial document.

<user_question>
How many bugs did engineers fix this year?
</user_question>

<report>
## Section 2: Software Engineering
This division dedicated significant effort to studying various infection vectors in our distributed systems
</report>Und das ist die komplette RAG-Pipeline! Das System hat erfolgreich die relevantesten Informationen anhand semantischer Ähnlichkeit abgerufen und sie als Kontext für die Generierung einer präzisen Antwort bereitgestellt.