Jetzt, da unser Evaluierungsdatensatz bereit ist, ist es Zeit, die zentrale Evaluierungs-Pipeline aufzubauen. Dabei geht es darum, jeden Testfall mit unserem Prompt zusammenzuführen, ihn an Claude zu übergeben und anschließend die Ergebnisse zu bewerten.
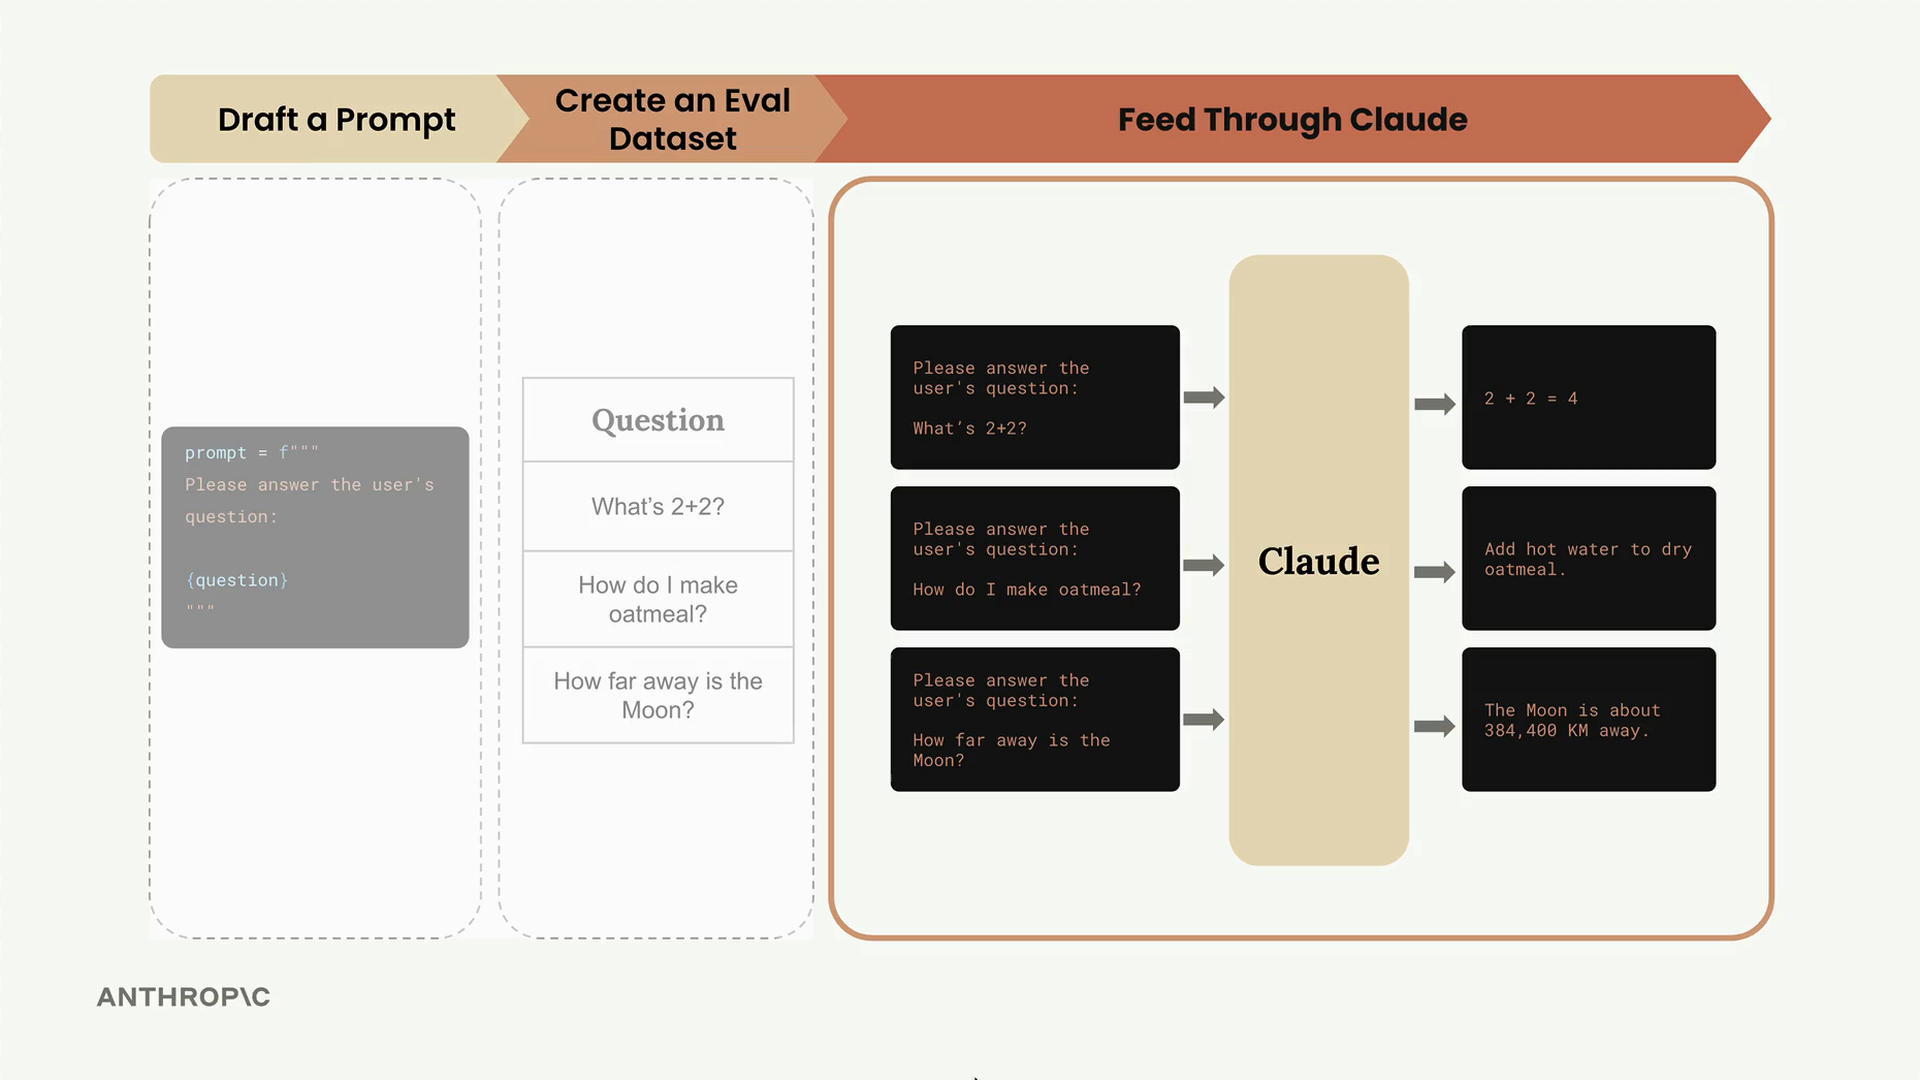
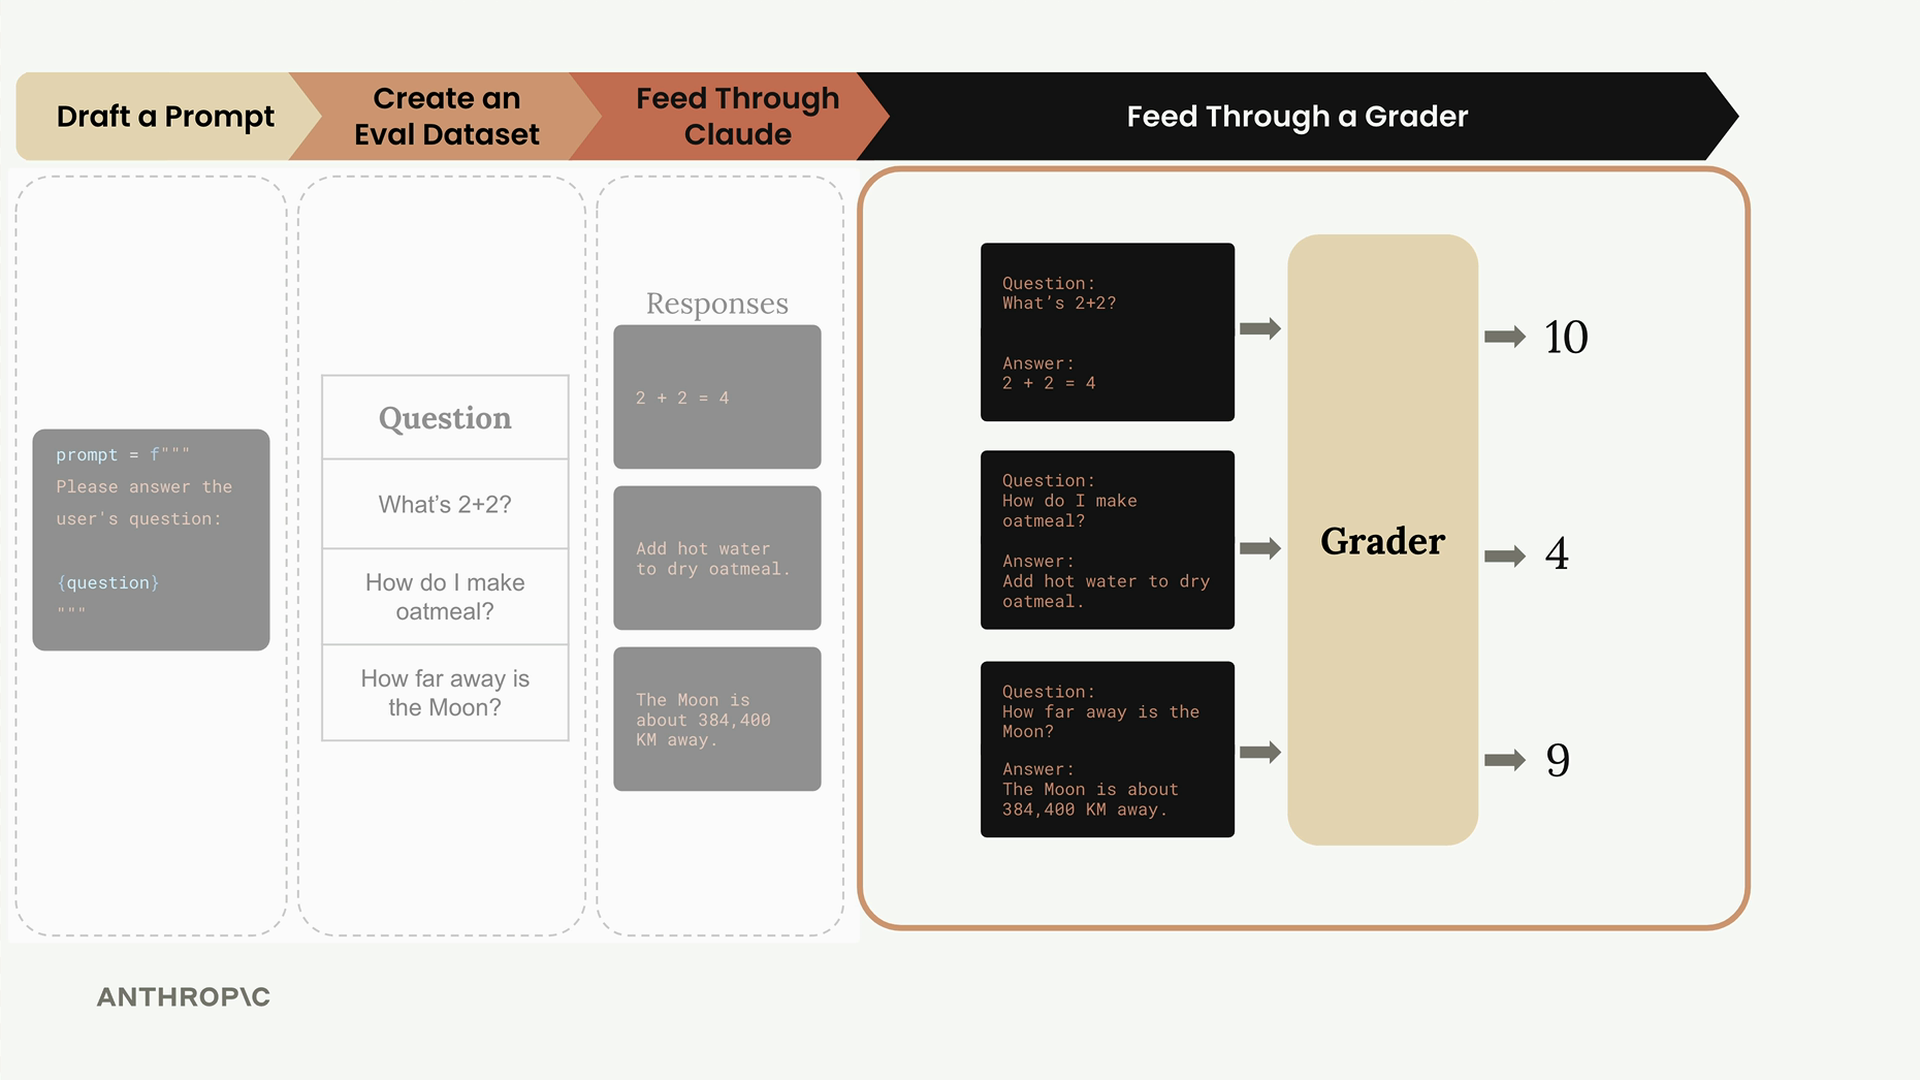
Der Evaluierungsprozess folgt einem klaren Workflow: Wir nehmen unseren Datensatz mit Testfällen, kombinieren jeden davon mit unserer Prompt-Vorlage, senden ihn zur Verarbeitung an Claude und bewerten dann die Ausgabe mithilfe eines Grader-Systems.
Aufbau der zentralen Funktionen
Die Evaluierungs-Pipeline besteht aus drei Hauptfunktionen, jede mit einer spezifischen Aufgabe. Beginnen wir mit der einfachsten – der Funktion, die einzelne Prompts verarbeitet.
Die Funktion run_prompt
Diese Funktion nimmt einen Testfall und führt ihn mit unserer Prompt-Vorlage zusammen:
def run_prompt(test_case):
    """Merges the prompt and test case input, then returns the result"""
    prompt = f"""
Please solve the following task:

{test_case["task"]}
"""

    messages = []
    add_user_message(messages, prompt)
    output = chat(messages)
    return output
Im Moment halten wir den Prompt extrem einfach. Wir fügen keine Formatierungsanweisungen hinzu, sodass Claude wahrscheinlich ausführlichere Ausgaben zurückgibt, als wir benötigen. Wir werden dies später verfeinern, während wir unser Prompt-Design iterieren.
Die Funktion run_test_case
Diese Funktion orchestriert die Ausführung eines einzelnen Testfalls und die Bewertung des Ergebnisses:
def run_test_case(test_case):
    """Calls run_prompt, then grades the result"""
    output = run_prompt(test_case)

    # TODO - Bewertung
    score = 10

    return {
        "output": output,
        "test_case": test_case,
        "score": score
    }
Im Moment verwenden wir eine fest codierte Bewertung von 10. Die Bewertungslogik ist der Punkt, an dem wir in den kommenden Abschnitten erheblich Zeit verbringen werden, aber dieser Platzhalter ermöglicht es uns, die gesamte Pipeline zu testen.
Die Funktion run_eval
Diese Funktion koordiniert den gesamten Evaluierungsprozess:
def run_eval(dataset):
    """Loads the dataset and calls run_test_case with each case"""
    results = []

    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    return results
Diese Funktion verarbeitet jeden Testfall in unserem Datensatz und sammelt alle Ergebnisse in einer einzigen Liste.
Ausführen der Evaluierung
Um unsere Evaluierungs-Pipeline auszuführen, laden wir unseren Datensatz und lassen ihn durch unsere Funktionen laufen:
with open("dataset.json", "r") as f:
    dataset = json.load(f)

results = run_eval(dataset)
Beim ersten Ausführen solltest du damit rechnen, dass es etwas Zeit in Anspruch nimmt – selbst mit Claude Haiku kann die Verarbeitung eines vollständigen Datensatzes rund 30 Sekunden dauern. Wir werden Optimierungstechniken später behandeln.
Untersuchung der Ergebnisse
Die Evaluierung gibt ein strukturiertes JSON-Array zurück, bei dem jedes Objekt ein Testfallergebnis darstellt:
print(json.dumps(results, indent=2))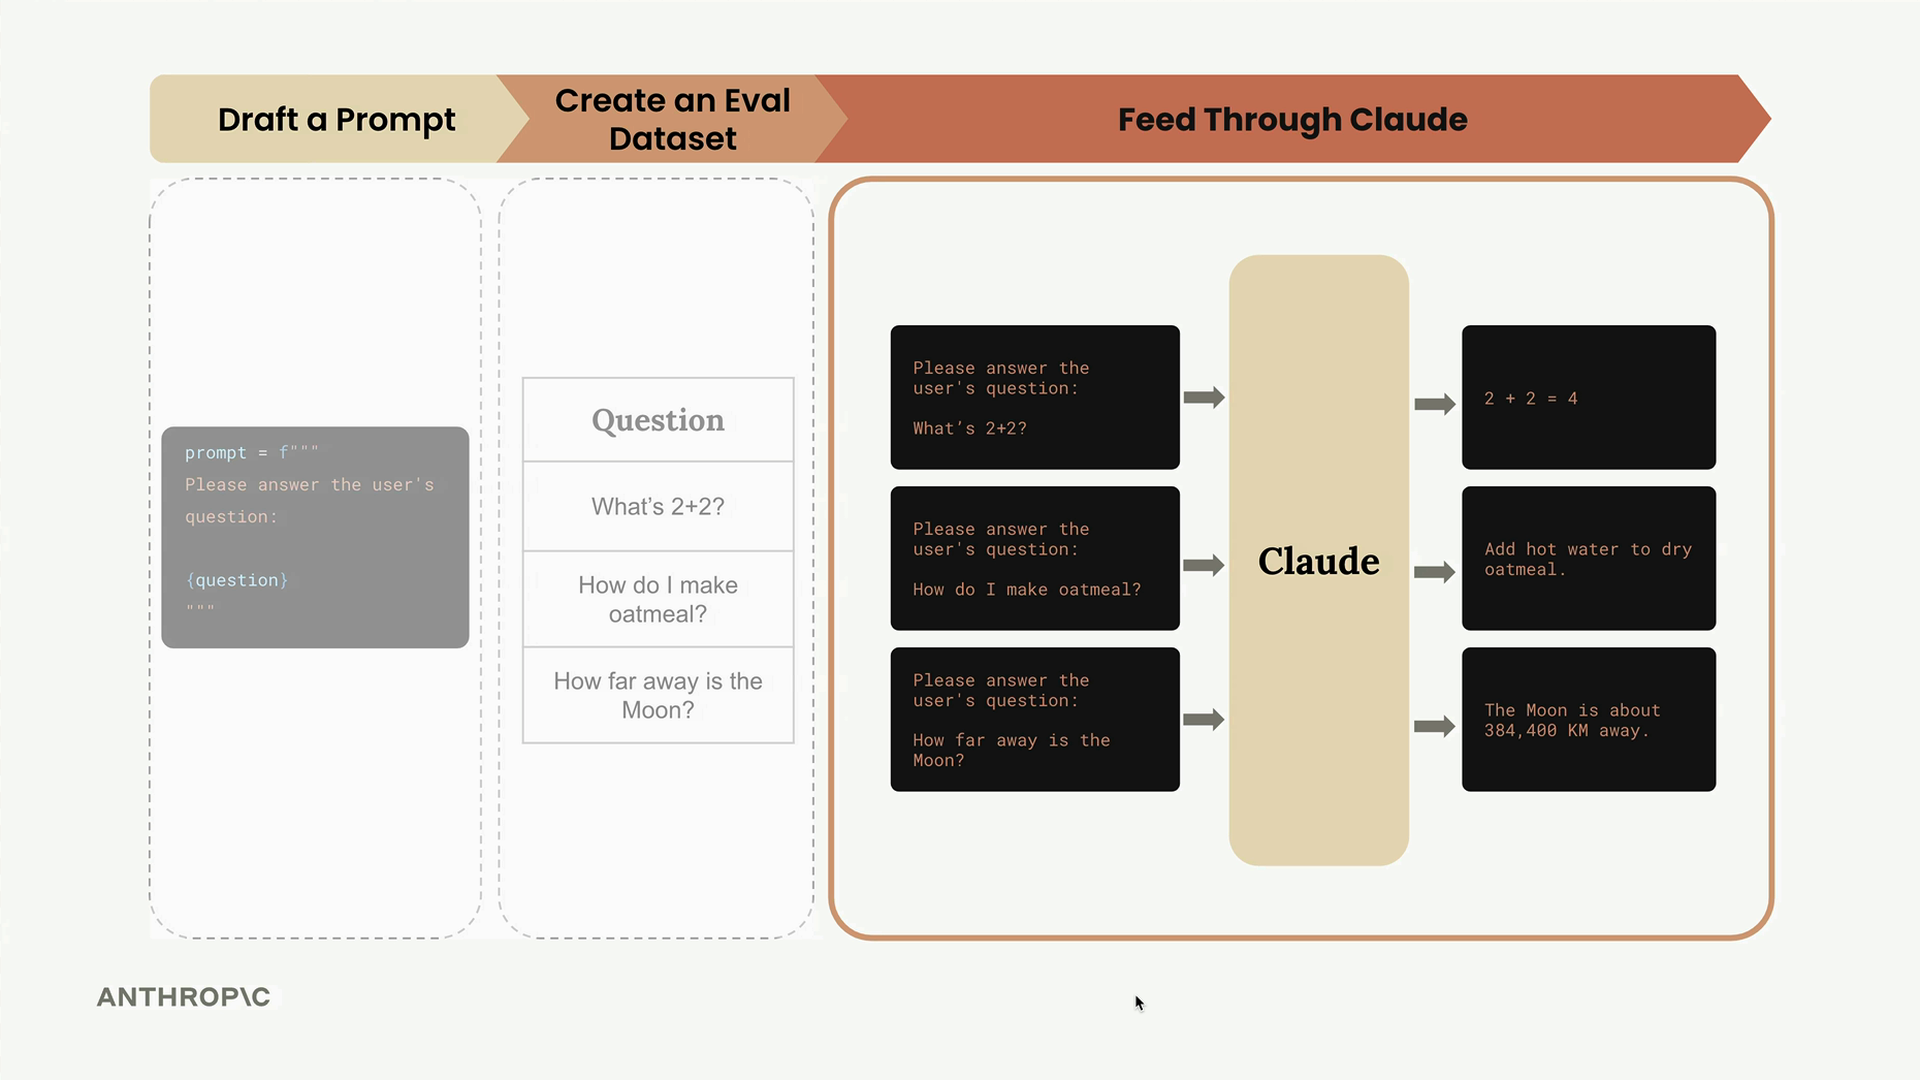
Jedes Ergebnis enthält drei wichtige Informationen:
- output: Die vollständige Antwort von Claude
- test_case: Der ursprüngliche Testfall, der verarbeitet wurde
- score: Die Bewertungszahl (derzeit fest codiert)
Wie du in der Ausgabe sehen kannst, erzeugt Claude ziemlich ausführliche Antworten, da wir noch keine spezifischen Formatierungsanweisungen bereitgestellt haben. Genau dieses Problem werden wir angehen, während wir unsere Prompts verfeinern.
Was wir erreicht haben
An diesem Punkt haben wir erfolgreich die zentrale Evaluierungs-Pipeline aufgebaut. Wir können unseren Datensatz nehmen, ihn durch Claude verarbeiten lassen und strukturierte Ergebnisse sammeln. Das wichtigste fehlende Stück ist das Bewertungssystem – diese fest codierte Bewertung von 10 muss durch eine tatsächliche Evaluierungslogik ersetzt werden.
Diese Pipeline stellt die Grundlage der meisten KI-Evaluierungssysteme dar. Auch wenn es einfach erscheinen mag, hast du gerade den Großteil dessen aufgebaut, was eine Eval-Pipeline tatsächlich leistet. Die Komplexität liegt in den Details – bessere Prompts, ausgefeiltere Bewertung und Leistungsoptimierungen.
Als Nächstes tauchen wir in das entscheidende Thema der Grader ein, die unsere fest codierten Bewertungen in aussagekräftige Evaluierungen von Claudes Leistung verwandeln werden.