Der Aufbau eines benutzerdefinierten Prompt-Evaluierungs-Workflows beginnt mit der Erstellung eines soliden Prompts und der anschließenden Generierung von Testdaten, um zu sehen, wie gut er funktioniert. Lass uns gemeinsam durch die Einrichtung eines Evaluierungssystems für einen Prompt gehen, der Nutzern hilft, AWS-spezifischen Code zu schreiben.
Das Ziel festlegen
Unser Prompt muss Nutzer beim Schreiben von drei spezifischen Arten von Ausgaben für AWS-Anwendungsfälle unterstützen:
- Python-Code
- JSON-Konfigurationsdateien
- Reguläre Ausdrücke
Die zentrale Anforderung besteht darin, dass wir, wenn ein Nutzer Hilfe bei einer Aufgabe anfordert, eine saubere Ausgabe in einem dieser Formate zurückgeben, ohne zusätzliche Erklärungen, Header oder Footer.
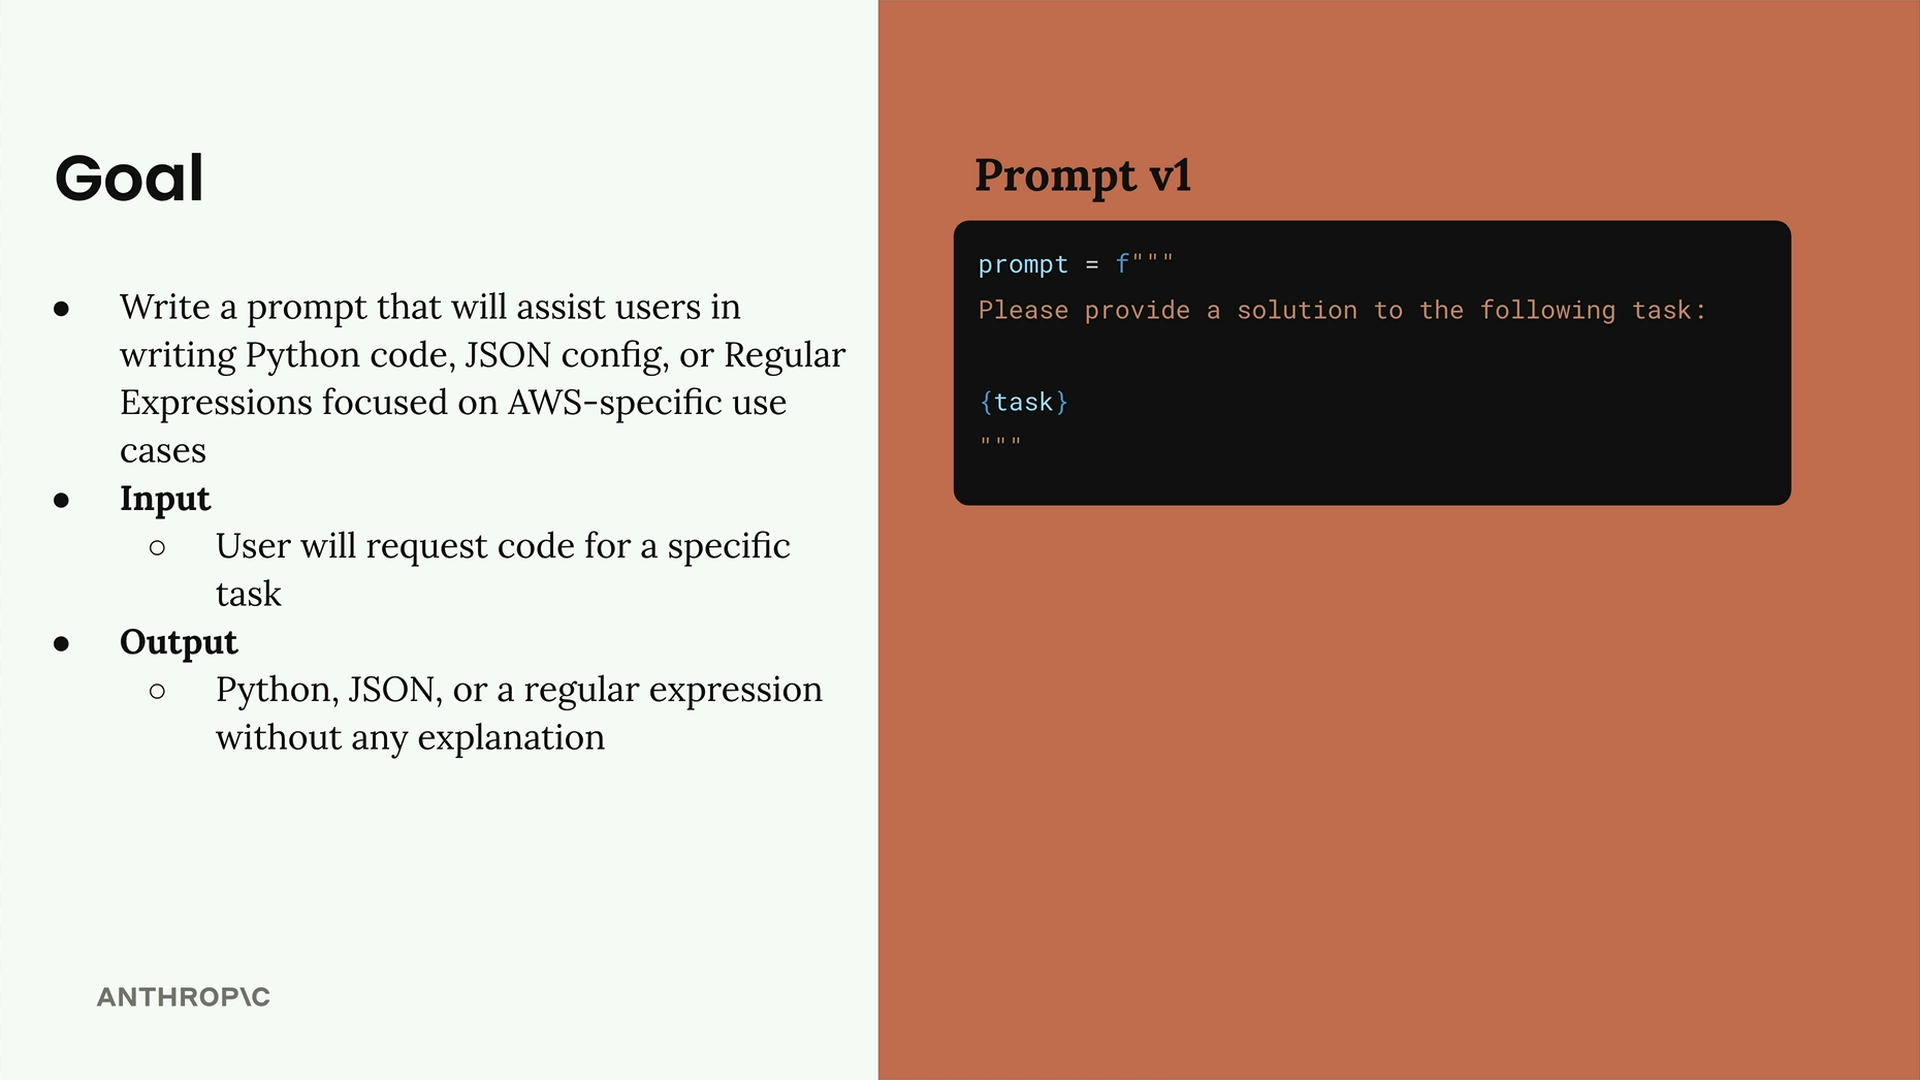
Hier ist unser Ausgangs-Prompt (Version 1):
prompt = f"""
Please provide a solution to the following task:
{task}
"""
Einen Evaluierungsdatensatz erstellen
Ein Evaluierungsdatensatz enthält Eingaben, die wir in unseren Prompt einspeisen werden. Für jede Kombination aus Prompt und Eingabe führen wir den Prompt aus und analysieren die Ergebnisse.
Unser Datensatz wird ein Array von JSON-Objekten sein, wobei jedes Objekt eine „task"-Eigenschaft enthält, die beschreibt, was Claude erreichen soll. Wir können diesen Datensatz entweder manuell erstellen oder automatisch mit Claude generieren.
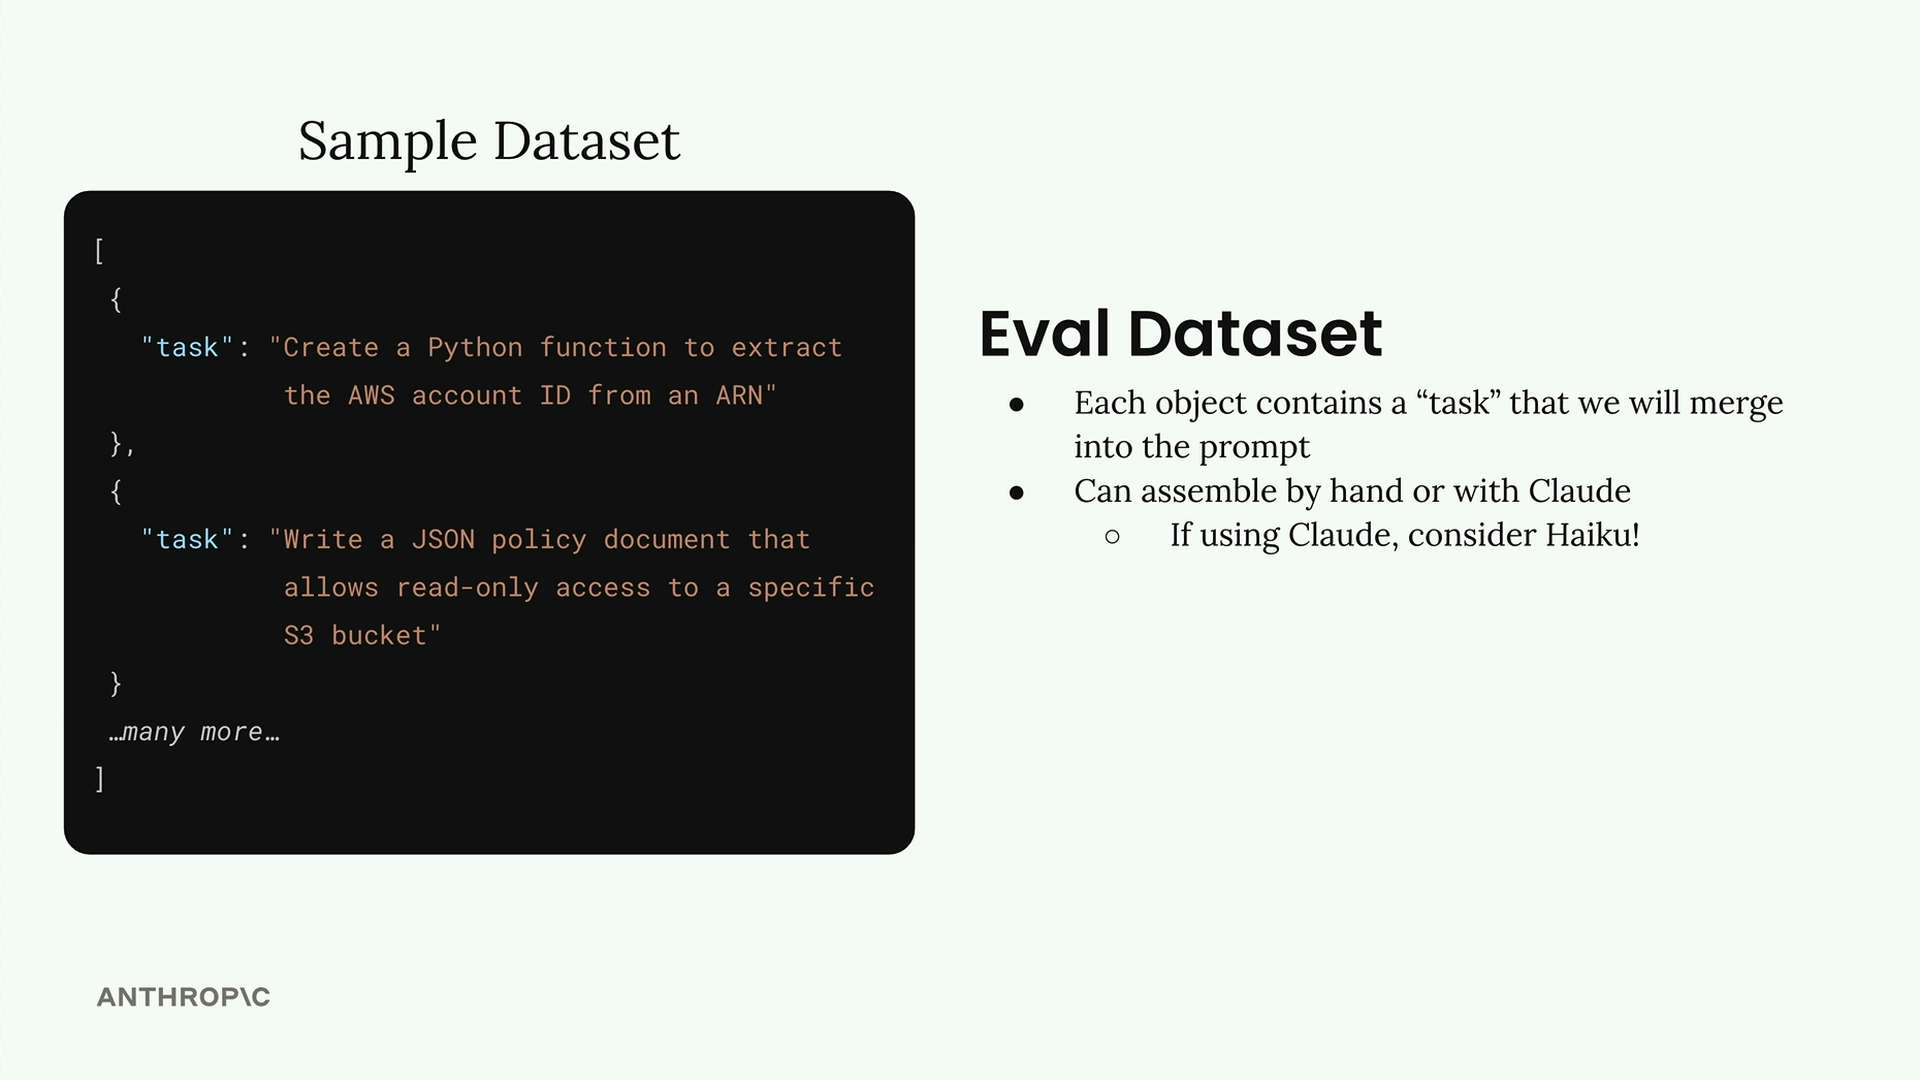
Da wir Testdaten generieren, ist dies eine perfekte Gelegenheit, ein schnelleres Modell wie Haiku anstelle des vollständigen Claude-Modells zu verwenden.
Testdaten mit Code generieren
Lass uns eine Funktion erstellen, die automatisch unseren Testdatensatz generiert. Zunächst benötigen wir unsere Hilfsfunktionen für die Arbeit mit Claude:
def add_user_message(messages, text):
    user_message = {"role": "user", "content": text}
    messages.append(user_message)

def add_assistant_message(messages, text):
    assistant_message = {"role": "assistant", "content": text}
    messages.append(assistant_message)

def chat(messages, system=None, temperature=1.0, stop_sequences=[]):
    params = {
        "model": model,
        "max_tokens": 1000,
        "messages": messages,
        "temperature": temperature
    }
    if system:
        params["system"] = system
    if stop_sequences:
        params["stop_sequences"] = stop_sequences

    response = client.messages.create(**params)
    return response.content[0].text
Jetzt erstellen wir unsere Funktion zur Datensatzgenerierung:
def generate_dataset():
    prompt = """
Generate an evaluation dataset for a prompt evaluation. The dataset will be used to evaluate prompts that generate Python, JSON, or Regex specifically for AWS-related tasks. Generate an array of JSON objects, each representing task that requires Python, JSON, or a Regex to complete.

Example output:
```json
[
  {
    "task": "Description of task",
  },
  ...additional
]
```

* Focus on tasks that can be solved by writing a single Python function, a single JSON object, or a single regex
* Focus on tasks that do not require writing much code

Please generate 3 objects.
"""
Um die JSON-Antwort korrekt zu parsen, verwenden wir Prefilling und Stop-Sequenzen:
    messages = []
    add_user_message(messages, prompt)
    add_assistant_message(messages, "```json")
    text = chat(messages, stop_sequences=["```"])
    return json.loads(text)
Die Datensatzgenerierung testen
Lass uns unsere Funktion ausführen und sehen, welche Art von Testfällen wir erhalten:
dataset = generate_dataset()
print(dataset)
Dies sollte drei verschiedene Testfälle zurückgeben, die unsere Zielausgaben abdecken - Python-Funktionen, JSON-Konfigurationen und reguläre Ausdrücke für AWS-spezifische Aufgaben.
Den Datensatz speichern
Sobald wir unseren Datensatz haben, speichern wir ihn in einer Datei, damit wir ihn später während der Evaluierung einfach laden können:
with open('dataset.json', 'w') as f:
    json.dump(dataset, f, indent=2)
Dies erstellt eine dataset.json-Datei im selben Verzeichnis wie dein Notebook, die deine Liste von Aufgaben enthält, die bereit für die Prompt-Evaluierung ist.
Mit dieser Grundlage hast du jetzt eine systematische Methode, um Testdaten zu generieren, mit denen du bewerten kannst, wie gut deine Prompts bei verschiedenen Arten von AWS-bezogenen Coding-Aufgaben funktionieren.