Beim Aufbau von RAG-Pipelines wirst du schnell feststellen, dass semantische Suche allein nicht immer die besten Ergebnisse liefert. Manchmal benötigst du exakte Begriffsübereinstimmungen, die die semantische Suche übersehen könnte. Die Lösung besteht darin, semantische Suche mit lexikalischer Suche unter Verwendung einer Technik namens BM25 zu kombinieren.
Das Problem mit semantischer Suche allein
Angenommen, du suchst in einem Dokument nach einer bestimmten Vorfall-ID wie „INC-2023-Q4-011“. Während semantische Suche hervorragend darin ist, Kontext und Bedeutung zu verstehen, kann sie Abschnitte zurückgeben, die semantisch verwandt sind, aber den exakten Begriff, nach dem du suchst, gar nicht enthalten.
Im obigen Beispiel gab die semantische Suche den Cybersicherheitsabschnitt zurück (der tatsächlich die Vorfall-ID enthält), aber auch einen Finanzanalyseabschnitt, der den Vorfall überhaupt nicht erwähnt. Das passiert, weil sich semantische Suche auf konzeptionelle Ähnlichkeit konzentriert und nicht auf exakte Begriffsübereinstimmung.
Hybride Suchstrategie
Die Lösung besteht darin, sowohl semantische als auch lexikalische Suche parallel auszuführen und dann die Ergebnisse zusammenzuführen. Das gibt dir das Beste aus beiden Welten:
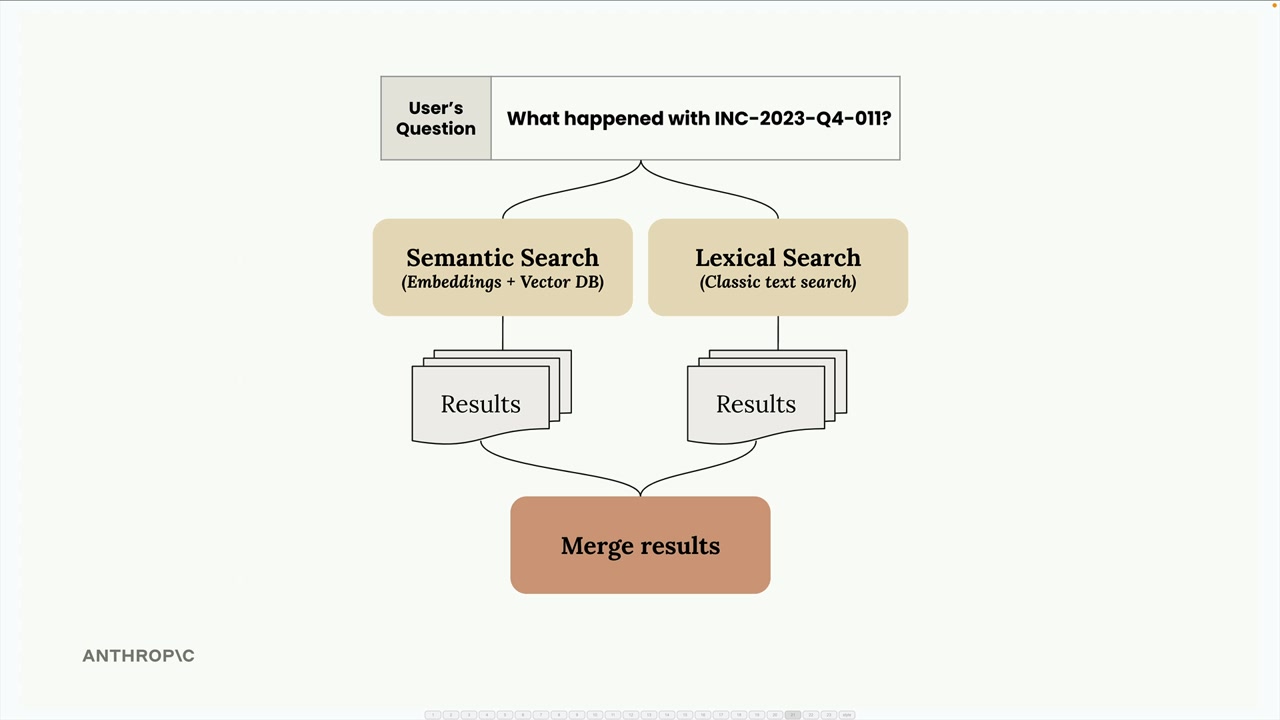
- Semantische Suche findet konzeptionell verwandte Inhalte mithilfe von Embeddings
- Lexikalische Suche findet exakte Begriffsübereinstimmungen mithilfe klassischer Textsuche
- Zusammengeführte Ergebnisse kombinieren beide Ansätze für bessere Genauigkeit
Wie BM25 funktioniert
BM25 (Best Match 25) ist ein beliebter Algorithmus für lexikalische Suche in RAG-Systemen. So verarbeitet er eine Suchanfrage:
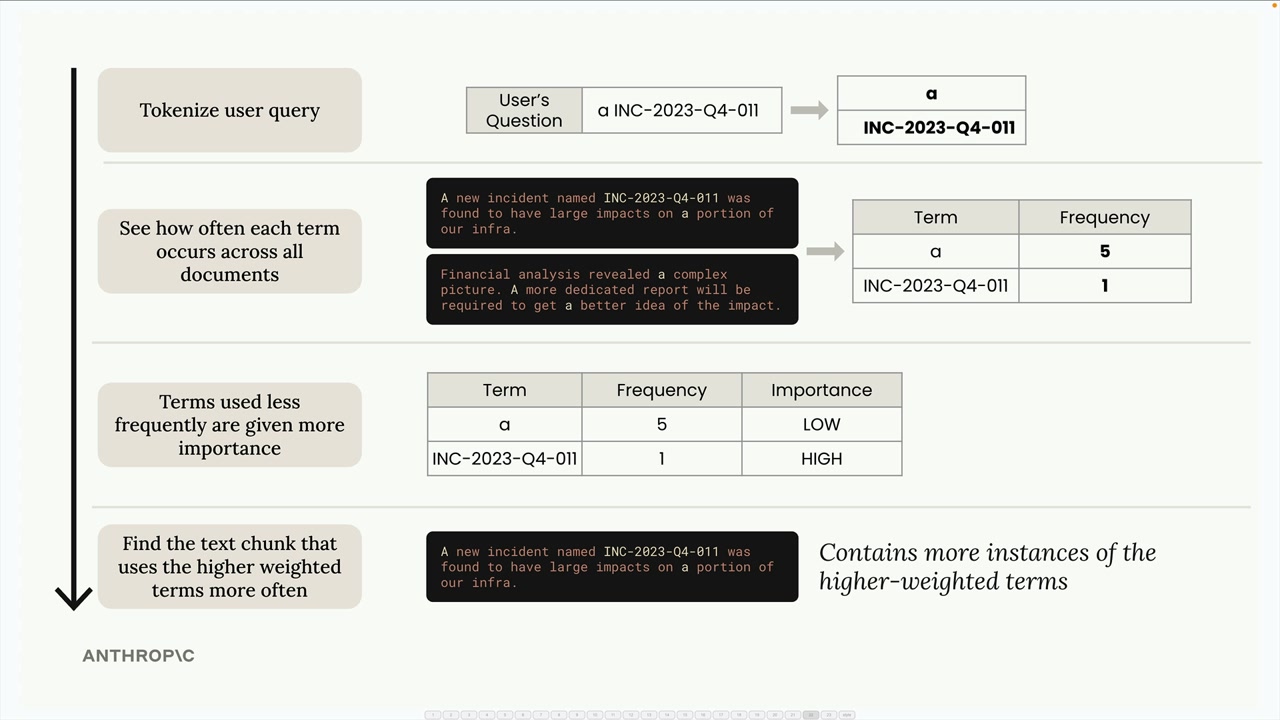
Schritt 1: Die Anfrage tokenisieren Zerlege die Frage des Nutzers in einzelne Begriffe. Zum Beispiel wird „a INC-2023-Q4-011“ zu ["a", "INC-2023-Q4-011"].
Schritt 2: Begriffshäufigkeit zählen Schau dir an, wie oft jeder Begriff in all deinen Dokumenten vorkommt. Häufige Wörter wie „a“ könnten 5 Mal vorkommen, während spezifische Begriffe wie „INC-2023-Q4-011“ nur einmal vorkommen könnten.
Schritt 3: Begriffe nach Wichtigkeit gewichten Begriffe, die seltener vorkommen, erhalten höhere Wichtigkeitswerte. Das Wort „a“ erhält eine geringe Wichtigkeit, weil es häufig ist, während „INC-2023-Q4-011“ eine hohe Wichtigkeit erhält, weil es selten ist.
Schritt 4: Beste Übereinstimmungen finden Gib Dokumente zurück, die mehr Instanzen der höher gewichteten Begriffe enthalten.
BM25-Suche implementieren
So richtest du ein grundlegendes BM25-Suchsystem ein:
# 1. Teile deinen Text in Abschnitte
chunks = chunk_by_section(text)

# 2. Erstelle einen BM25-Store und füge Dokumente hinzu
store = BM25Index()
for chunk in chunks:
    store.add_document({"content": chunk})

# 3. Durchsuche den Store
results = store.search("What happened with INC-2023-Q4-011?", 3)

# Ergebnisse ausgeben
for doc, distance in results:
    print(distance, "\n", doc["content"][:200], "\n----\n")
Wenn du diese Suche ausführst, erhältst du deutlich bessere Ergebnisse als mit semantischer Suche allein. Der BM25-Algorithmus priorisiert Abschnitte, die tatsächlich deine spezifischen Suchbegriffe enthalten, besonders seltene Begriffe wie Vorfall-IDs.
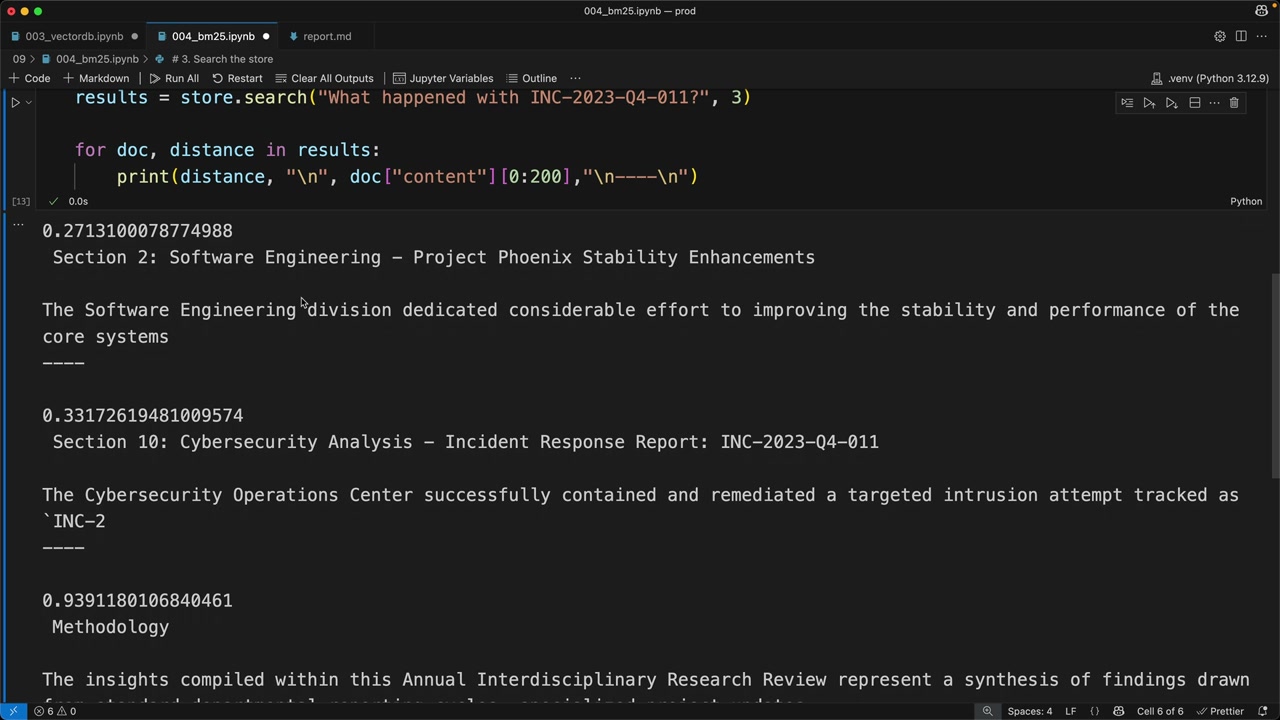
Beachte, wie die Ergebnisse jetzt korrekt den Abschnitt Software Engineering und den Abschnitt Cybersecurity priorisieren – beide enthalten tatsächlich die Vorfall-ID, nach der du suchst.
Warum das besser funktioniert
BM25 ist hervorragend darin, exakte Übereinstimmungen zu finden, weil es:
- seltenen, spezifischen Begriffen eine höhere Gewichtung gibt
- häufige Wörter ignoriert, die keinen Suchwert hinzufügen
- sich auf Begriffshäufigkeit statt auf semantische Bedeutung konzentriert
- besonders gut für technische Begriffe, IDs und spezifische Phrasen funktioniert
Die wesentliche Erkenntnis ist, dass beide Suchmethoden sich ergänzende Stärken haben. Semantische Suche versteht Kontext und Bedeutung, während lexikalische Suche sicherstellt, dass du keine exakten Begriffsübereinstimmungen verpasst. Durch die Kombination beider erschaffst du ein robusteres Suchsystem, das sowohl konzeptionelle Anfragen als auch spezifische Suchvorgänge effektiv bewältigt.
Im nächsten Schritt lernst du, wie man Ergebnisse aus beiden Suchsystemen zusammenführt, um eine einheitliche hybride Sucherfahrung zu schaffen.