Wenn du Tool-Nutzung mit Streaming in Claude kombinierst, erhältst du Echtzeit-Updates, während die KI Tool-Argumente generiert. Das sorgt für eine reaktionsschnellere Nutzererfahrung, aber es gibt einige wichtige Details darüber zu verstehen, wie das im Hintergrund funktioniert.
Grundlegendes Tool-Streaming
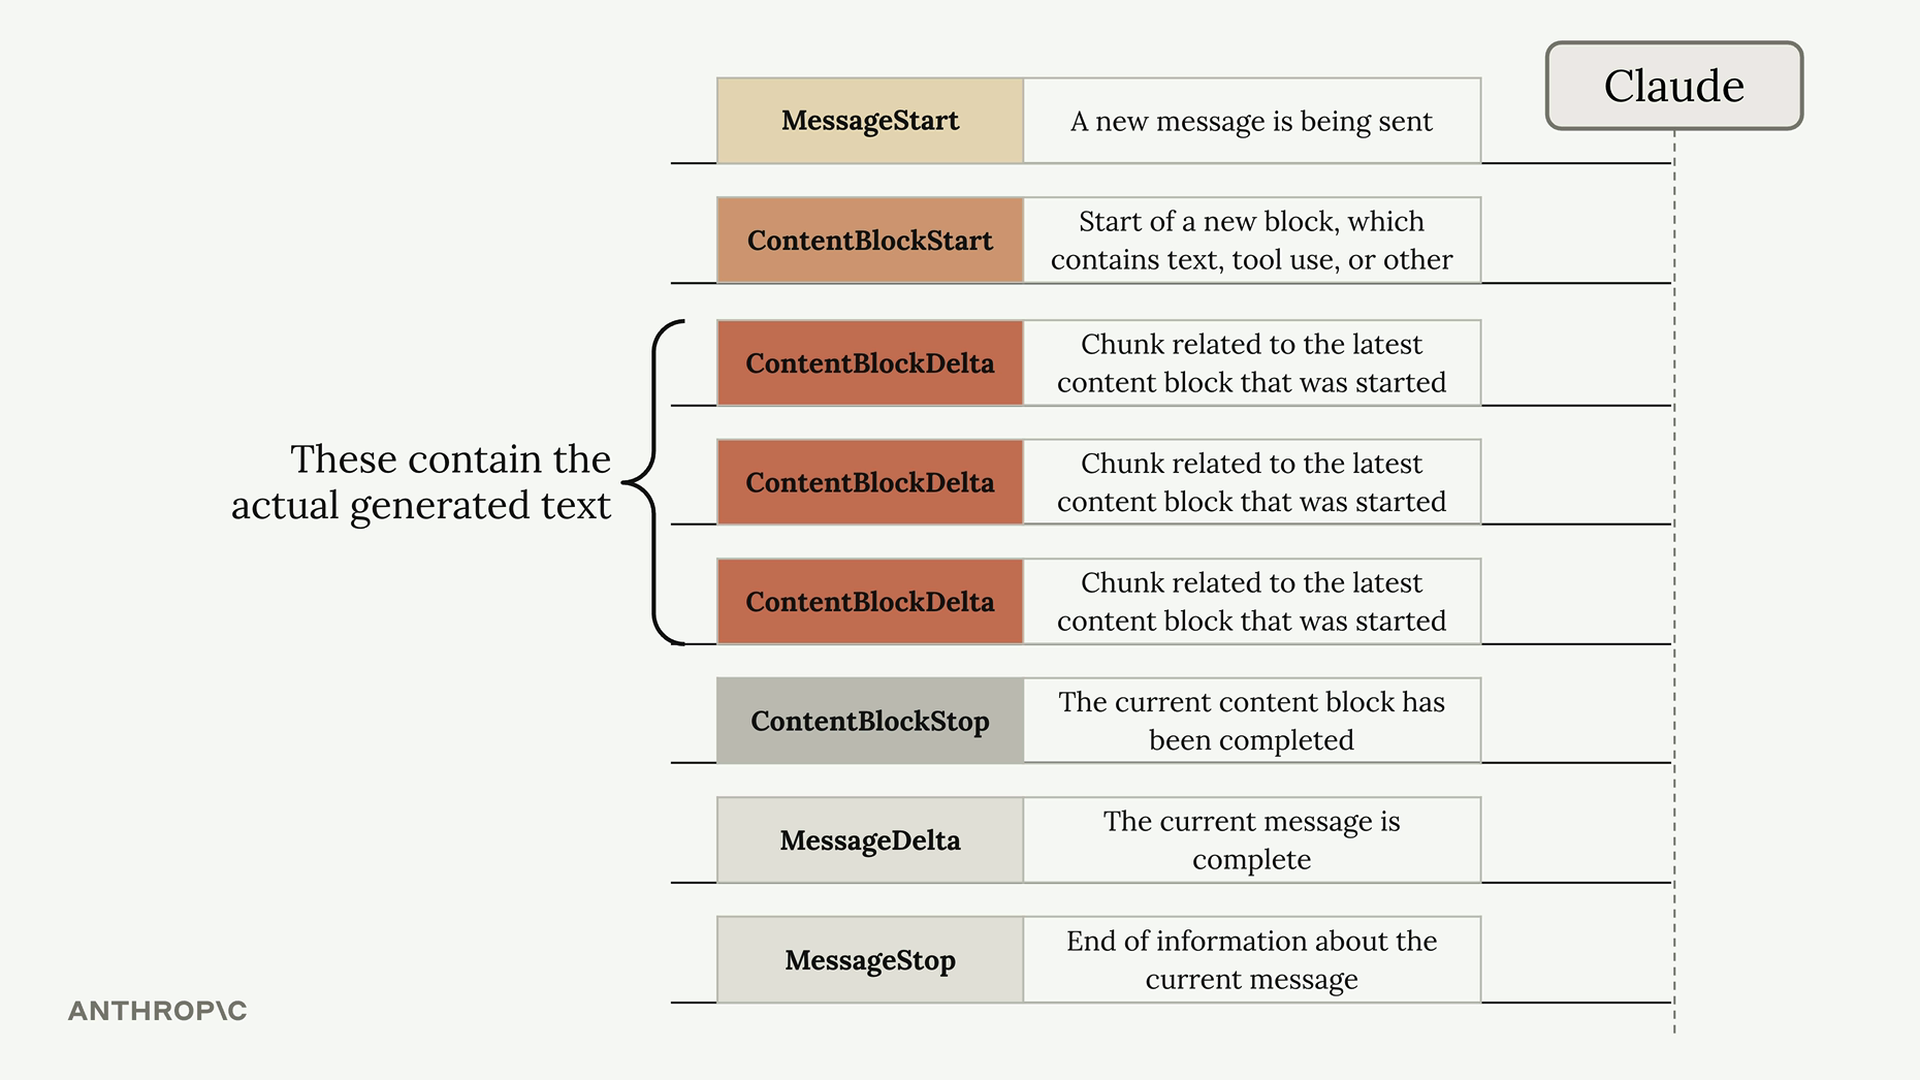
Bei aktiviertem Streaming sendet Claude unterschiedliche Arten von Ereignissen zurück, während es deine Anfrage verarbeitet. Du kennst bereits Ereignisse wie ContentBlockDelta für die normale Textgenerierung. Für die Tool-Nutzung musst du zusätzlich einen neuen Ereignistyp namens InputJsonEvent verarbeiten.
Jedes InputJsonEvent enthält zwei wesentliche Eigenschaften:
- partial_json - Ein Teilstück des JSON, das einen Teil der Tool-Argumente repräsentiert
- snapshot - Das kumulative JSON, das aus allen bisher empfangenen Teilstücken aufgebaut wurde
So verarbeitest du diese Ereignisse in deiner Streaming-Pipeline:
for chunk in stream:
    if chunk.type == "input_json":
        # Verarbeite den partiellen JSON-Chunk
        print(chunk.partial_json)
        # Oder verwende den bisherigen vollständigen Snapshot
        current_args = chunk.snapshot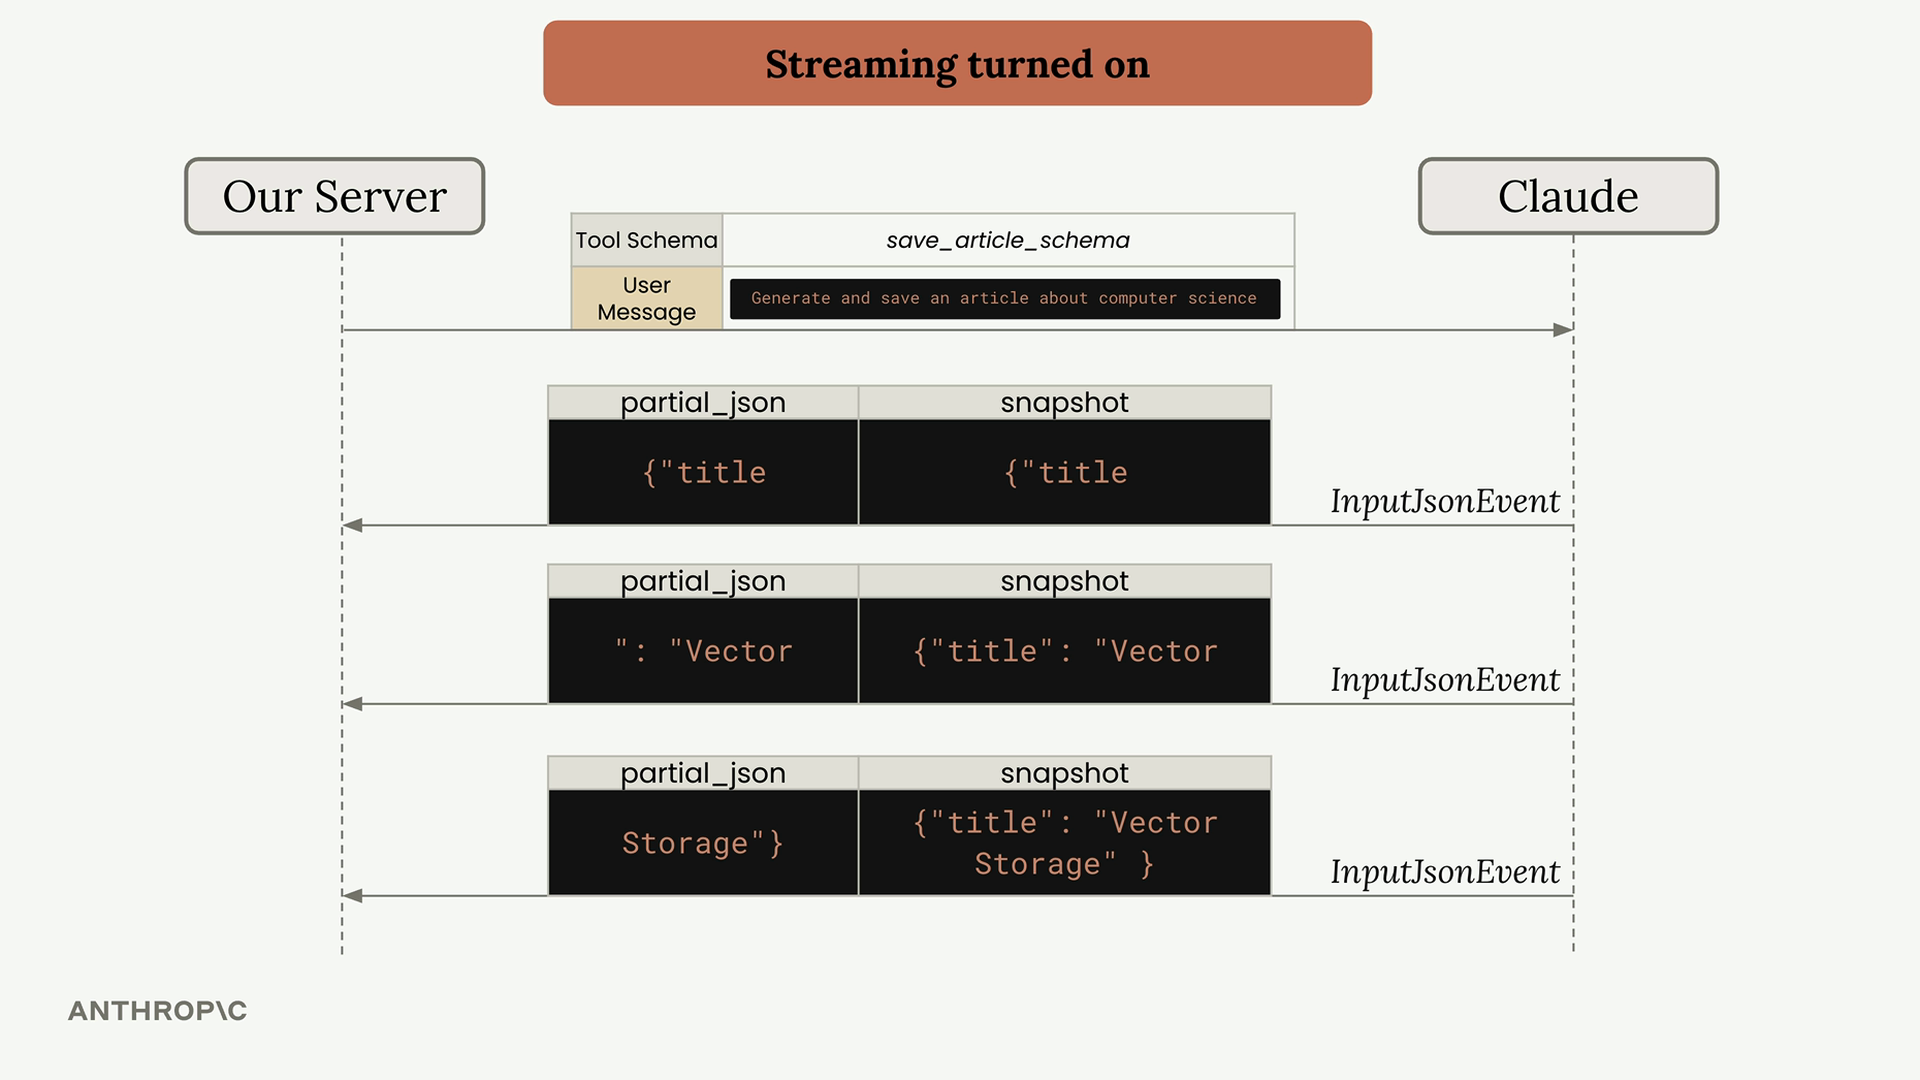
Wie die JSON-Validierung funktioniert
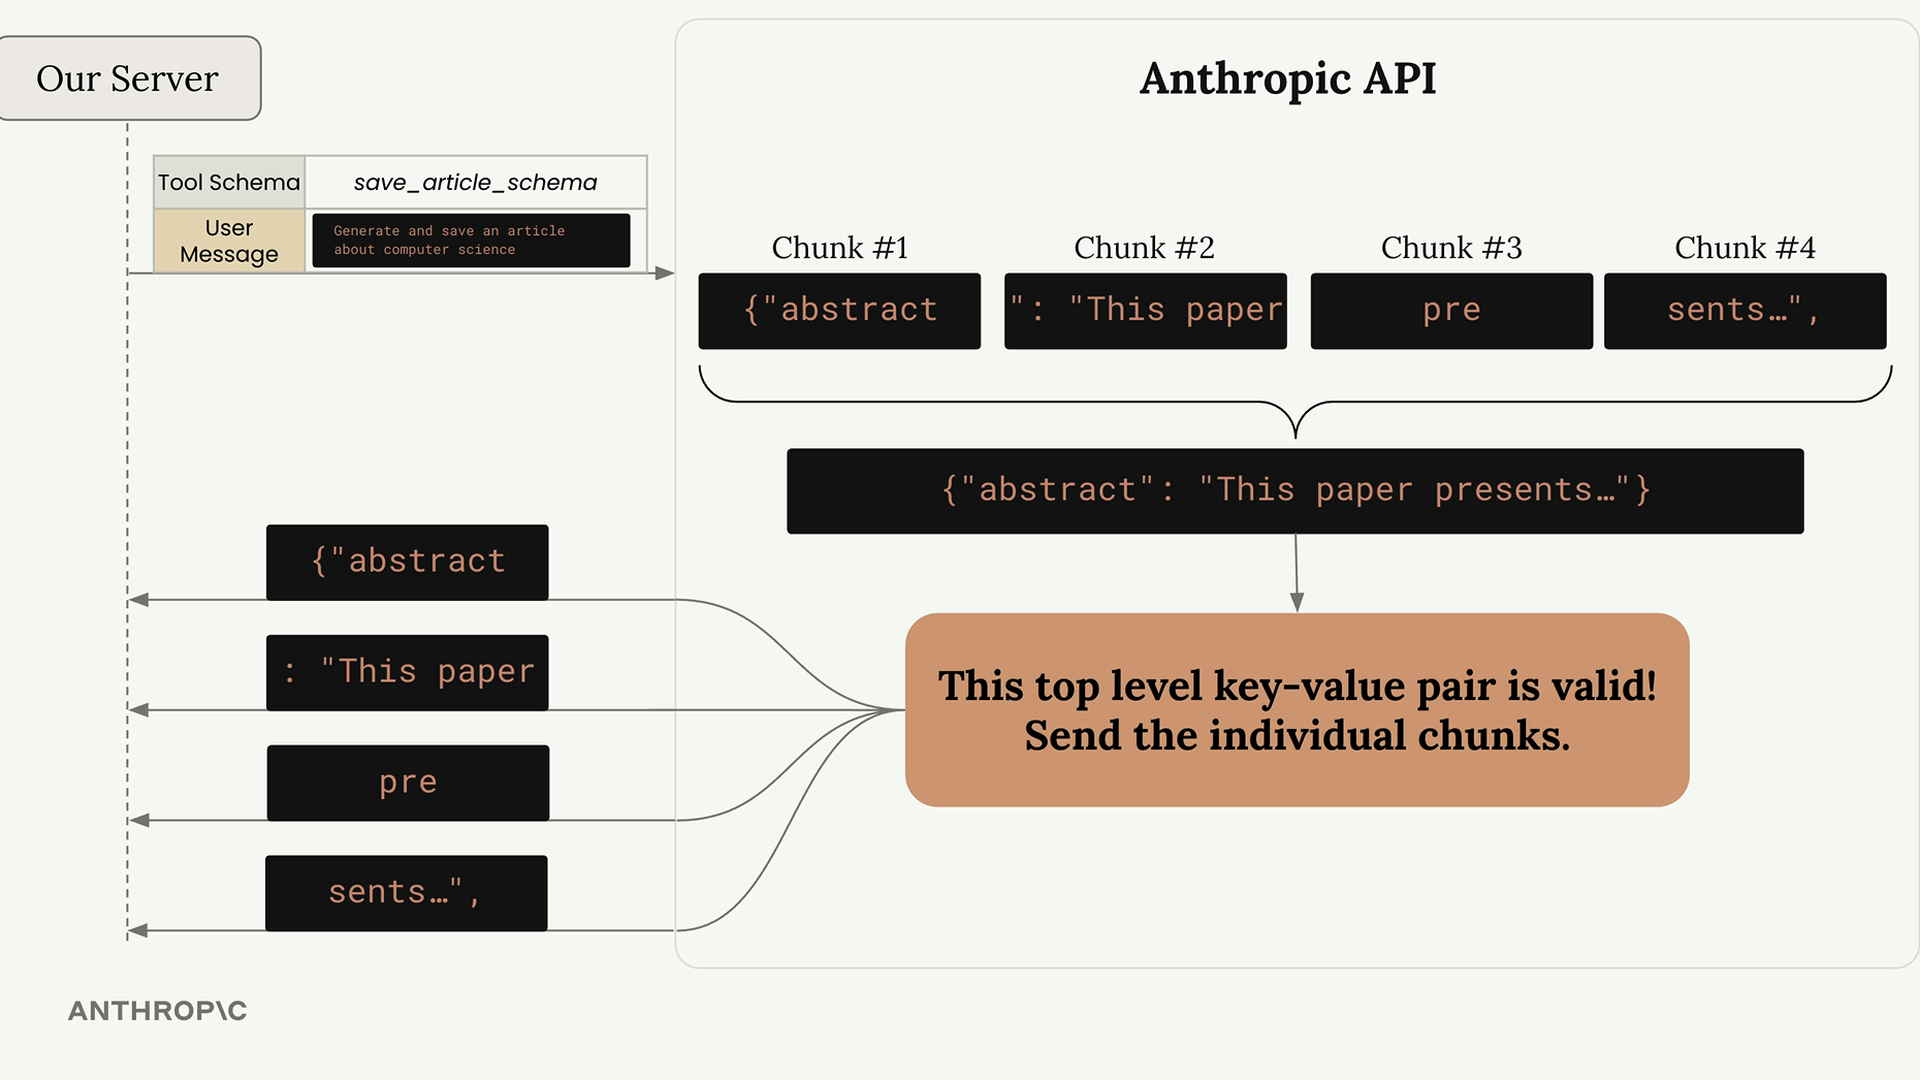
Hier wird es interessant. Die Anthropic API sendet dir nicht sofort jedes Teilstück, sobald Claude es generiert. Stattdessen puffert sie die Teilstücke und validiert sie zunächst.
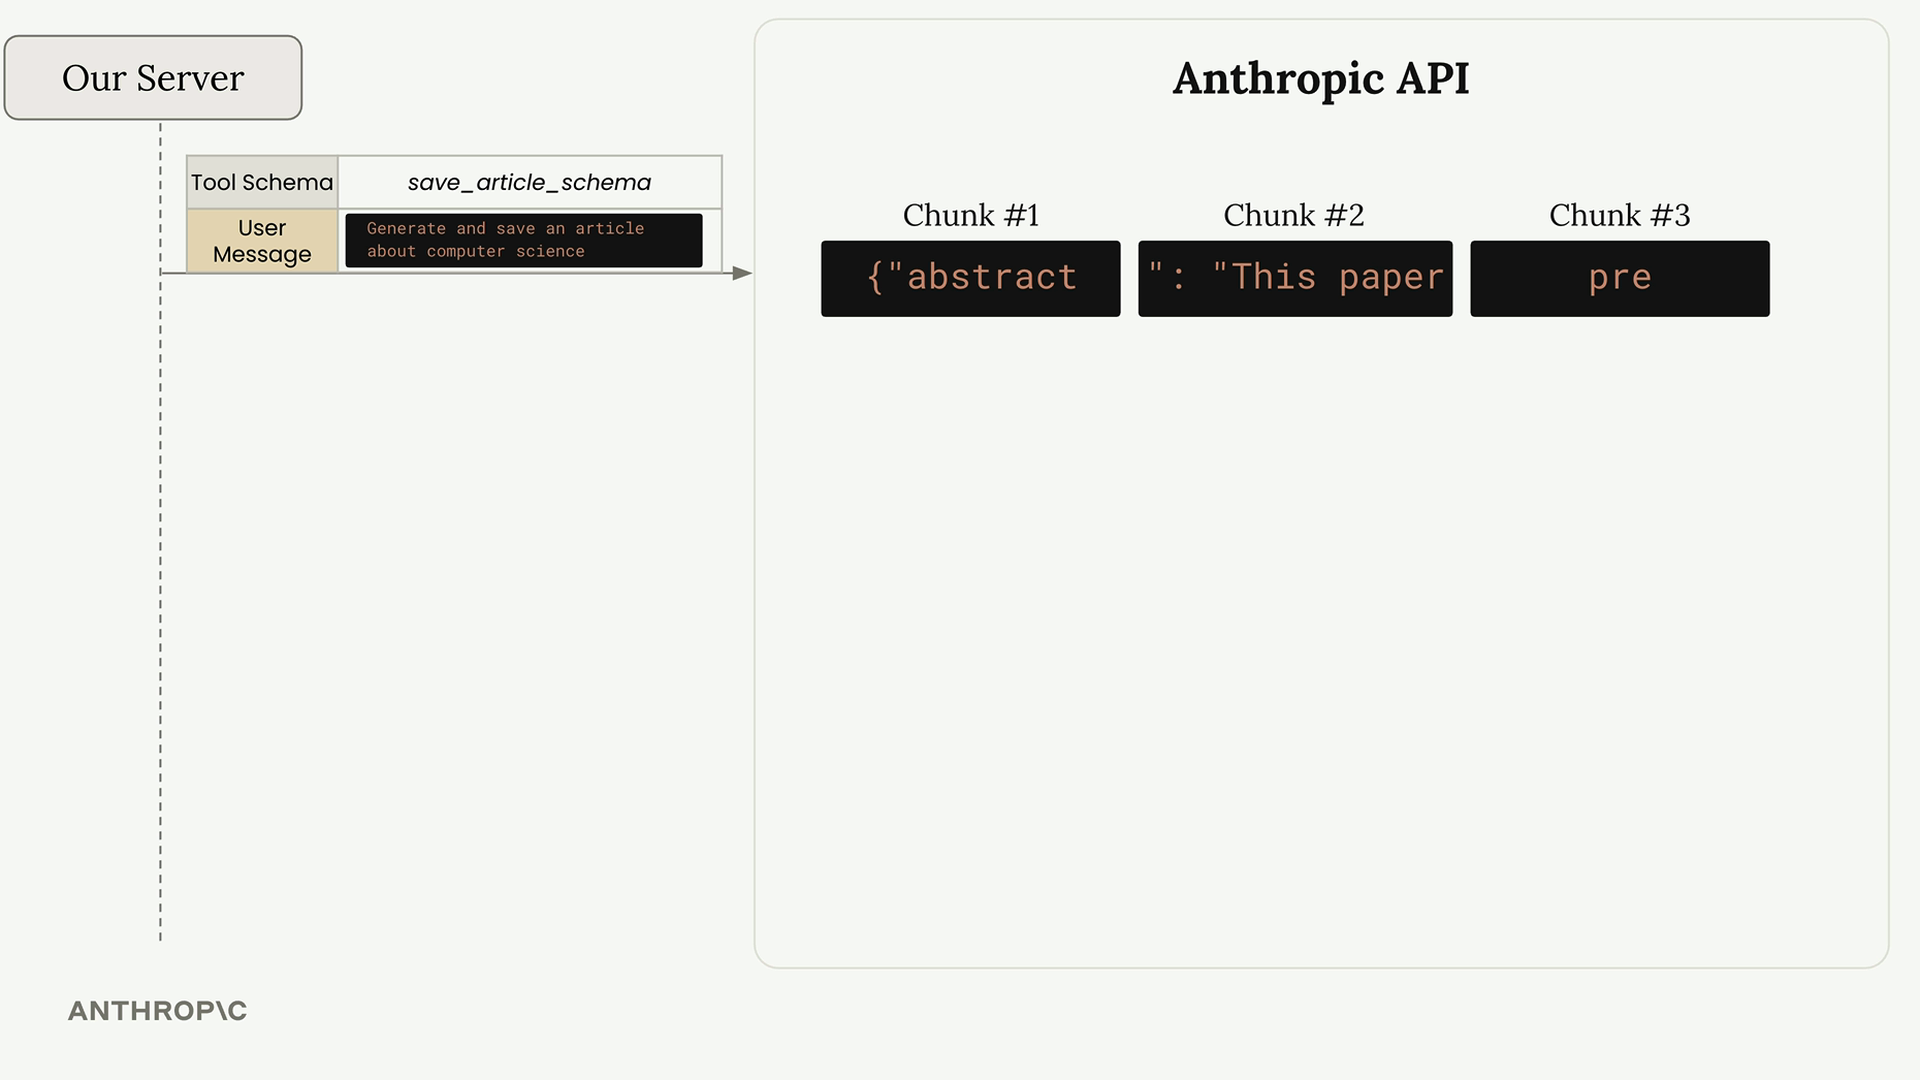
Die API wartet auf vollständige Schlüssel-Wert-Paare auf oberster Ebene, bevor sie irgendetwas sendet. Wenn dein Tool beispielsweise diese Struktur erwartet:
{
  "abstract": "This paper presents a novel...",
  "meta": {
    "word_count": 847,
    "review": "This paper introduces QuanNet..."
  }
}
Die API wird:
- Warten, bis der gesamte
abstract-Wert vollständig ist - Dieses Schlüssel-Wert-Paar gegen dein Schema validieren
- Alle gepufferten Teilstücke für
abstractauf einmal senden - Den Vorgang für das
meta-Objekt wiederholen
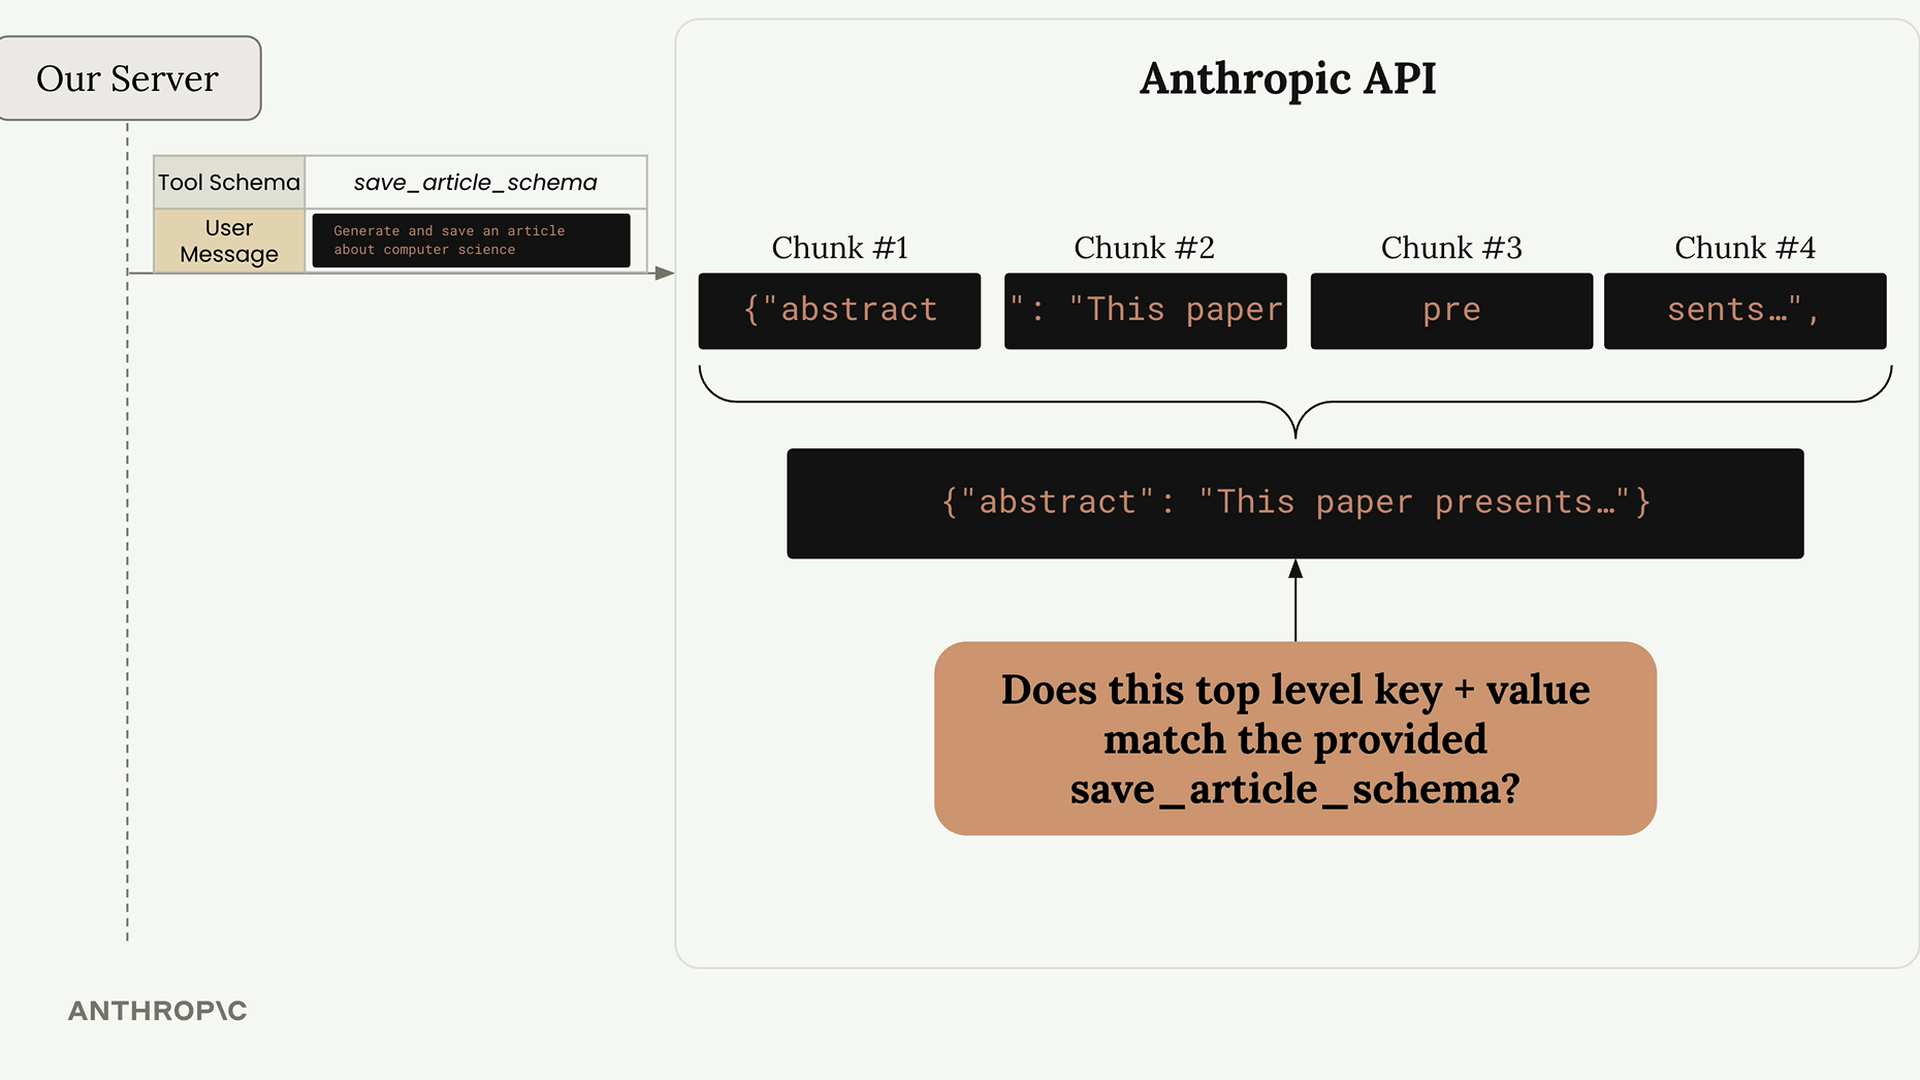
Dieser Validierungsprozess erklärt, warum du Verzögerungen gefolgt von Text-Schüben siehst, selbst bei aktiviertem Streaming. Die Teilstücke werden zurückgehalten, bis ein vollständiges, gültiges Schlüssel-Wert-Paar auf oberster Ebene bereit ist.
Feingranulares Tool-Calling
Wenn du schnelleres, feingranulareres Streaming benötigst - etwa um Nutzern sofortige Updates zu zeigen oder schnell mit der Verarbeitung von Teilergebnissen zu beginnen - kannst du feingranulares Tool-Calling aktivieren.
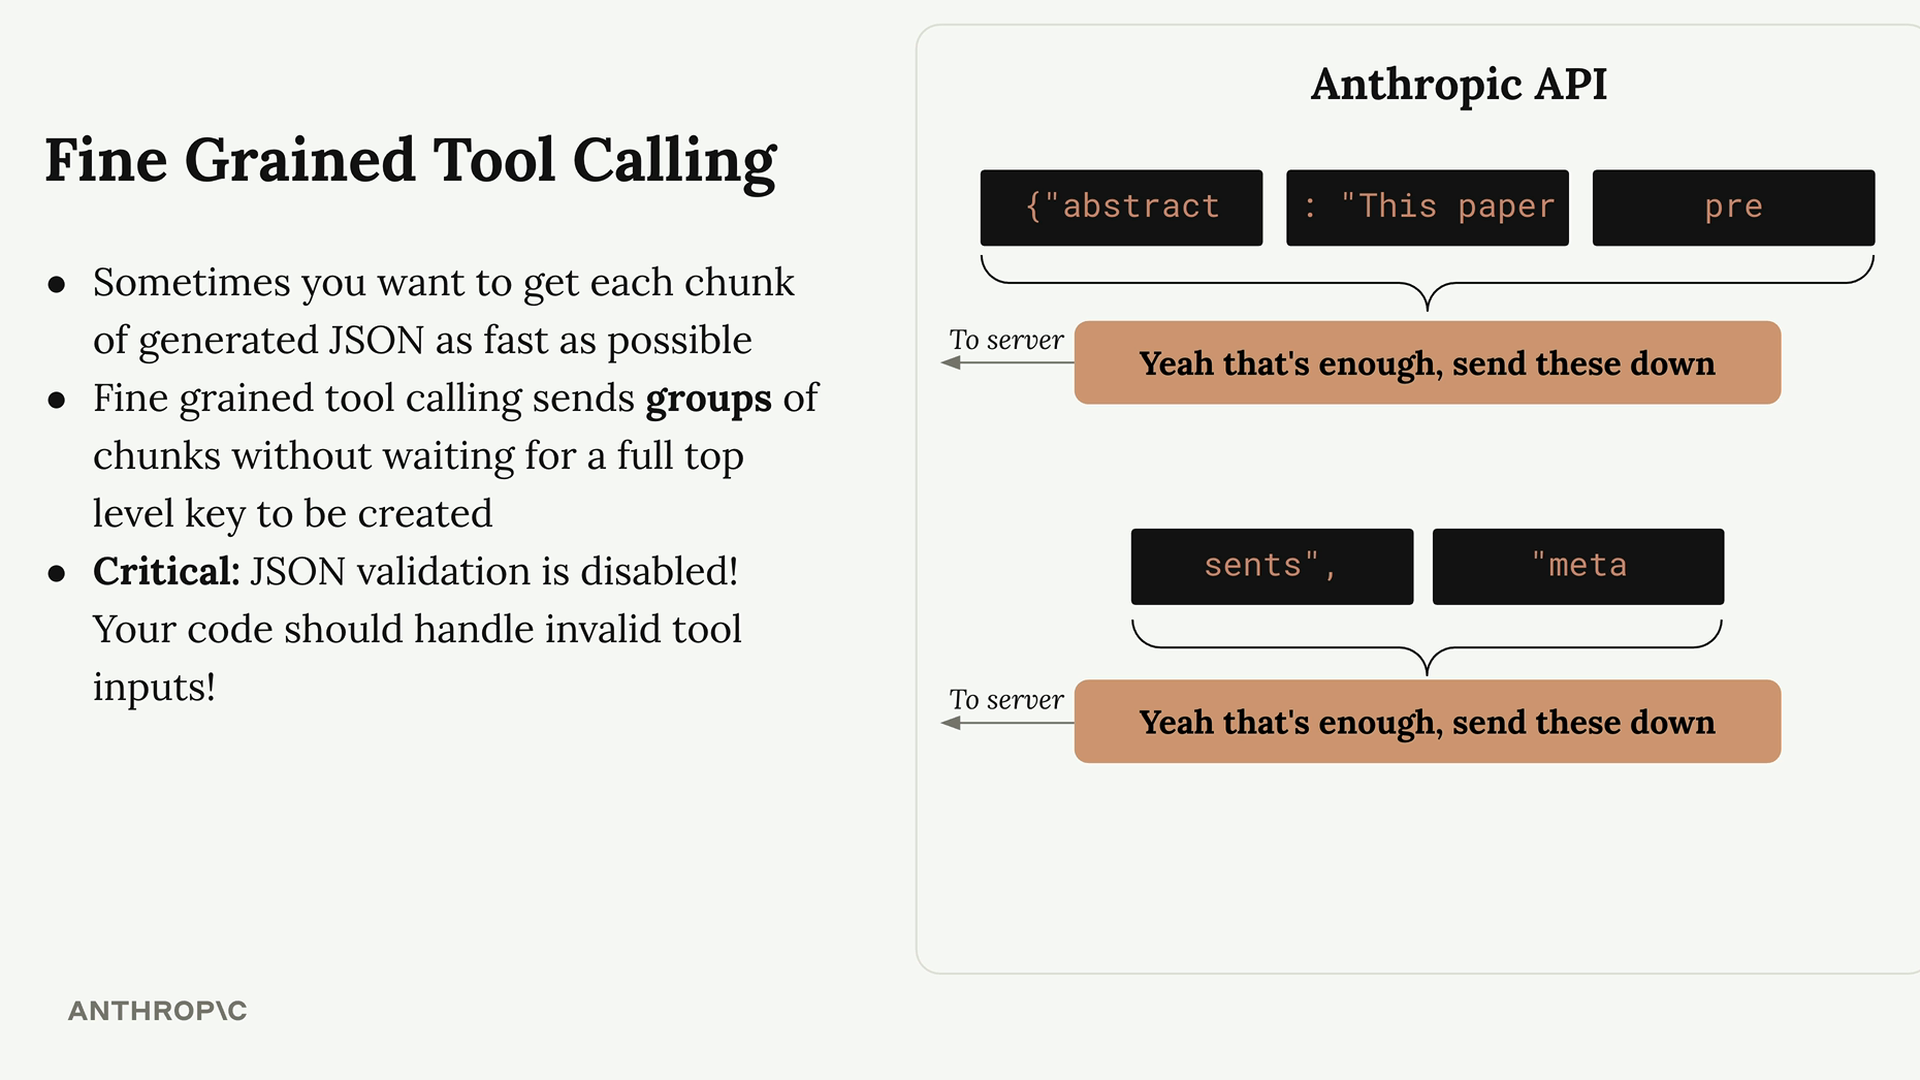
Feingranulares Tool-Calling macht im Wesentlichen eine Sache: Es deaktiviert die JSON-Validierung auf der API-Seite. Das bedeutet:
- Du erhältst Teilstücke, sobald Claude sie generiert
- Keine Pufferungsverzögerungen zwischen Schlüsseln auf oberster Ebene
- Traditionelleres Streaming-Verhalten
- Wichtig: Die JSON-Validierung ist deaktiviert - dein Code muss ungültiges JSON verarbeiten können
Aktiviere es, indem du eager_input_streaming auf True am Tool setzt:
run_conversation(
    messages,
    tools=[{**save_article_schema, "eager_input_streaming": True}]
)
Mit feingranularem Tool-Calling erhältst du möglicherweise einen word_count-Wert viel früher im Stream, ohne darauf zu warten, dass das gesamte meta-Objekt vollständig ist.
Umgang mit ungültigem JSON
Bei der Verwendung von feingranularem Tool-Calling kann Claude ungültiges JSON wie "word_count": undefined anstelle einer korrekten Zahl generieren. Deine Anwendung muss diese Fälle souverän behandeln:
try:
    parsed_args = json.loads(chunk.snapshot)
except json.JSONDecodeError:
    # Ungültiges JSON angemessen behandeln
    print("Received invalid JSON, continuing...")
Ohne feingranulares Tool-Calling würde die Validierung der API diesen Fehler abfangen und problematische Werte möglicherweise in Strings einschließen, was nicht deinem erwarteten Schema entsprechen könnte.
Wann feingranulares Tool-Calling verwenden
Ziehe die Aktivierung von feingranularem Tool-Calling in Betracht, wenn:
- Du Nutzern Echtzeit-Fortschritt bei der Generierung von Tool-Argumenten zeigen musst
- Du so schnell wie möglich mit der Verarbeitung von partiellen Tool-Ergebnissen beginnen möchtest
- Die Pufferungsverzögerungen sich negativ auf deine Nutzererfahrung auswirken
- Du damit vertraut bist, eine robuste JSON-Fehlerbehandlung zu implementieren
Für die meisten Anwendungen ist das Standardverhalten mit Validierung völlig ausreichend. Aber wenn du diese zusätzliche Reaktionsschnelligkeit benötigst, gibt dir feingranulares Tool-Calling die Kontrolle, Teilstücke so schnell zu erhalten, wie Claude sie generieren kann.