Beim Erstellen von Chat-Anwendungen mit Claude gibt es eine erhebliche Herausforderung für die Benutzererfahrung: Antworten können 10–30 Sekunden zur Generierung benötigen, wodurch Nutzer auf einen Ladekreisel starren müssen. Die Lösung ist Response-Streaming, das es Nutzern ermöglicht, Text Stück für Stück erscheinen zu sehen, während Claude ihn generiert, was ein deutlich reaktionsschnelleres Gefühl erzeugt.
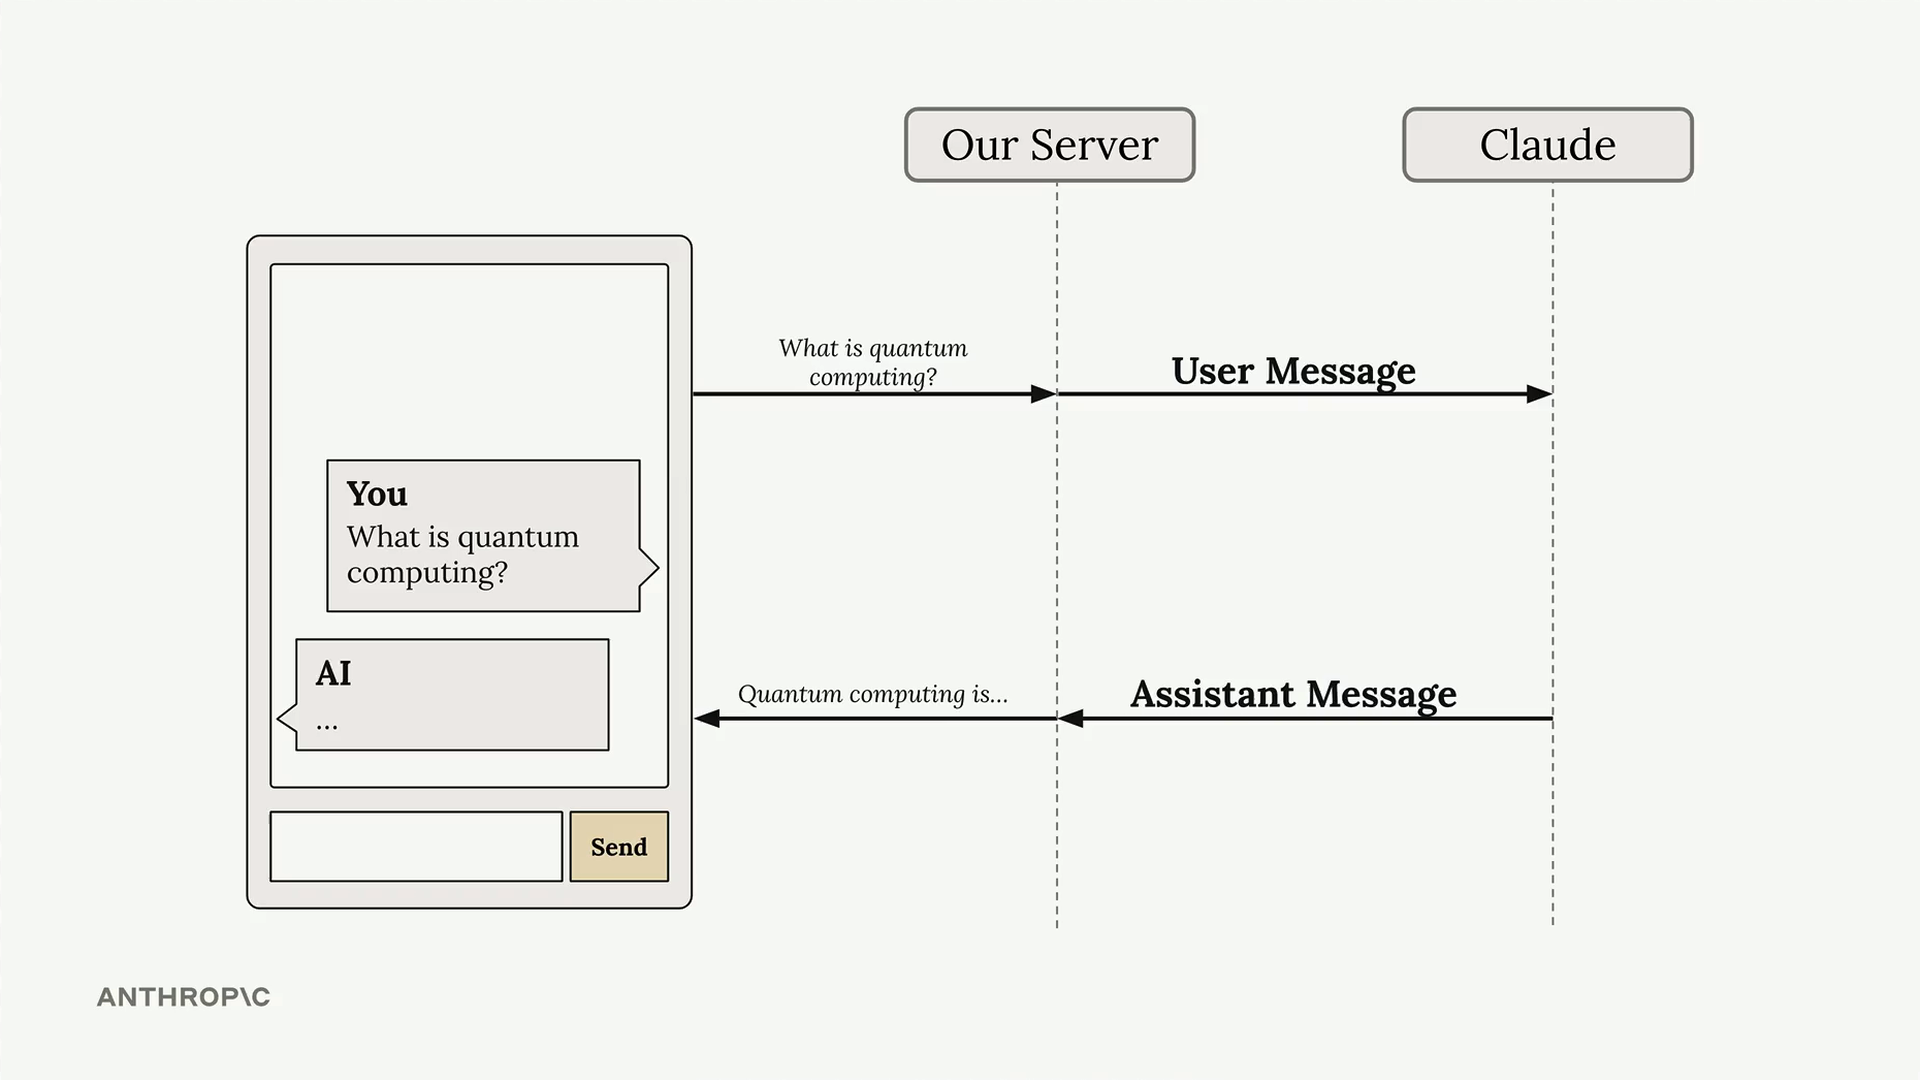
Das Problem mit Standardantworten
In einem typischen Chat-Setup sendet dein Server eine Nutzernachricht an Claude und wartet auf die vollständige Antwort, bevor er etwas an den Client zurücksendet. Dies führt zu einer unangenehmen Verzögerung, bei der Nutzer keine Rückmeldung erhalten, dass überhaupt etwas passiert.
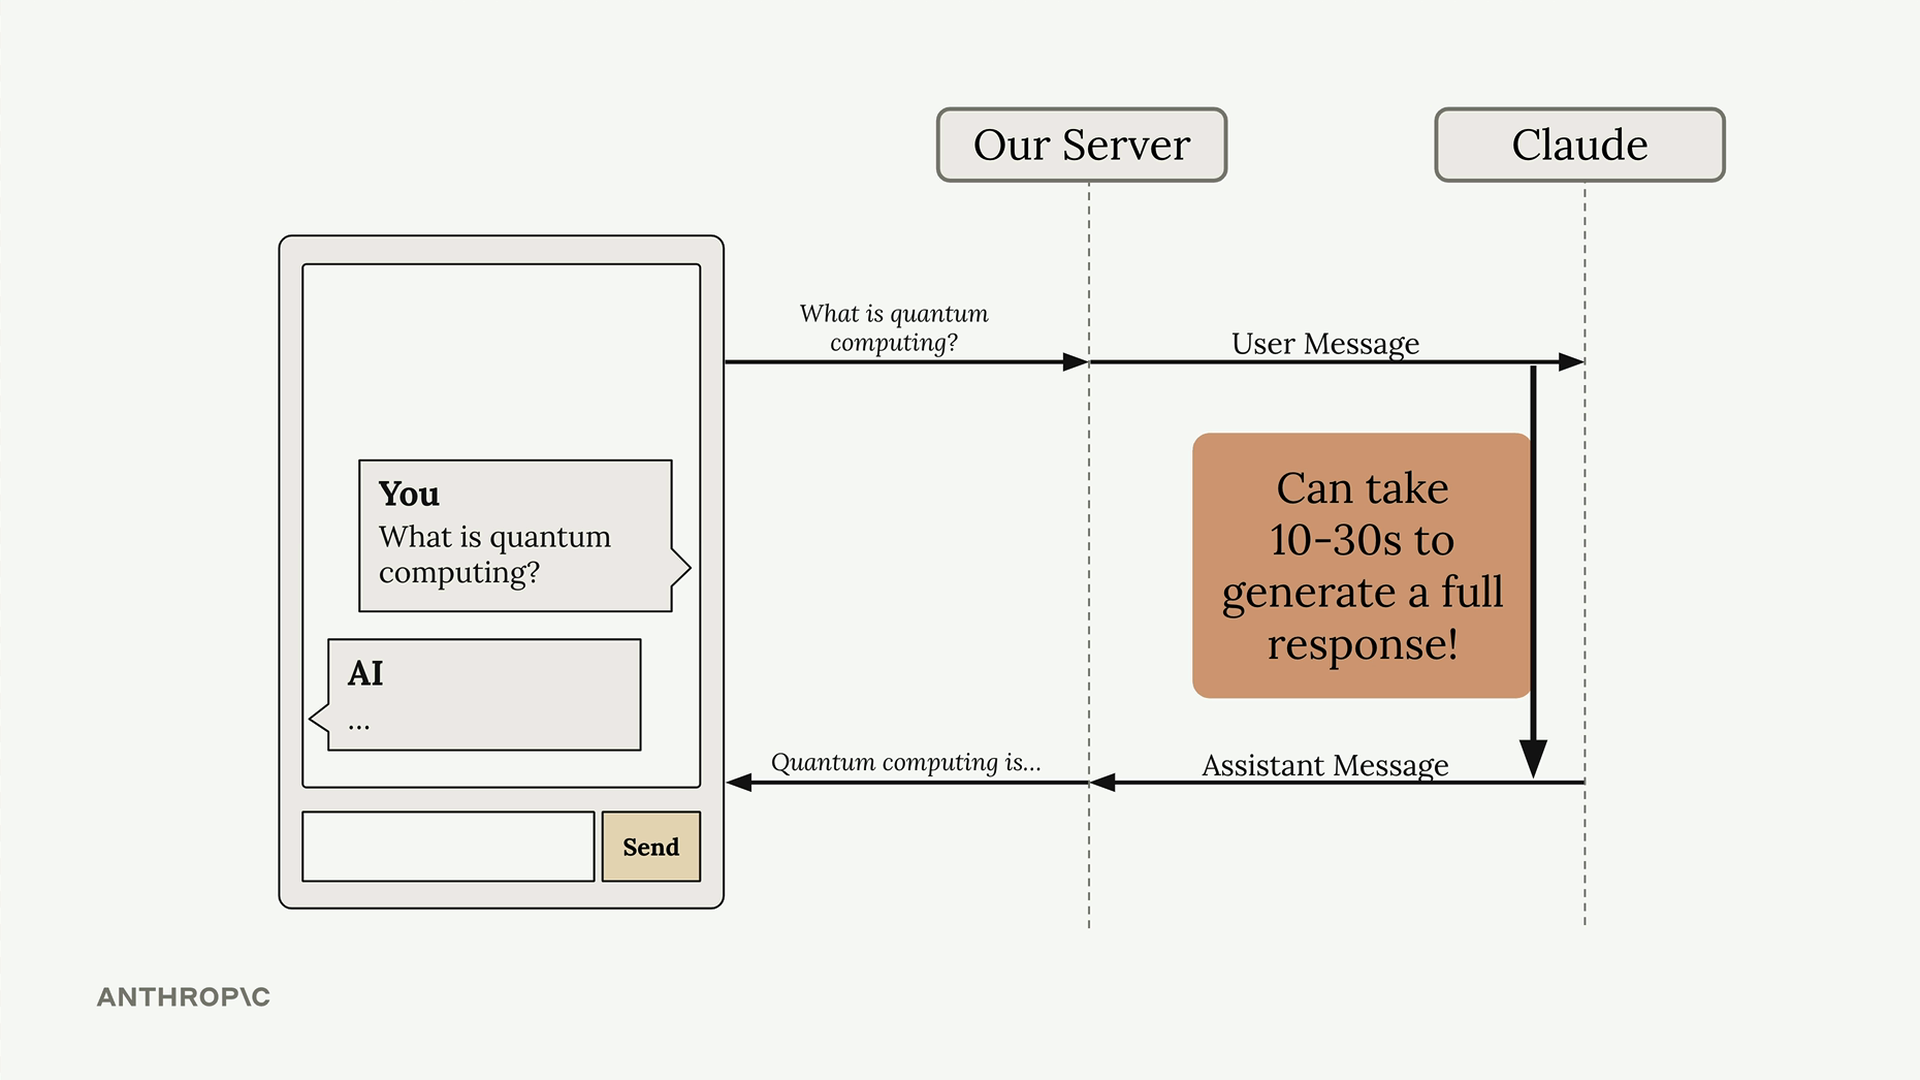
Wie Streaming funktioniert
Bei aktiviertem Streaming sendet Claude sofort eine erste Antwort zurück, die anzeigt, dass deine Anfrage empfangen wurde und mit der Textgenerierung begonnen wird. Danach erhältst du eine Reihe von Ereignissen, von denen jedes einen kleinen Teil der Gesamtantwort enthält.
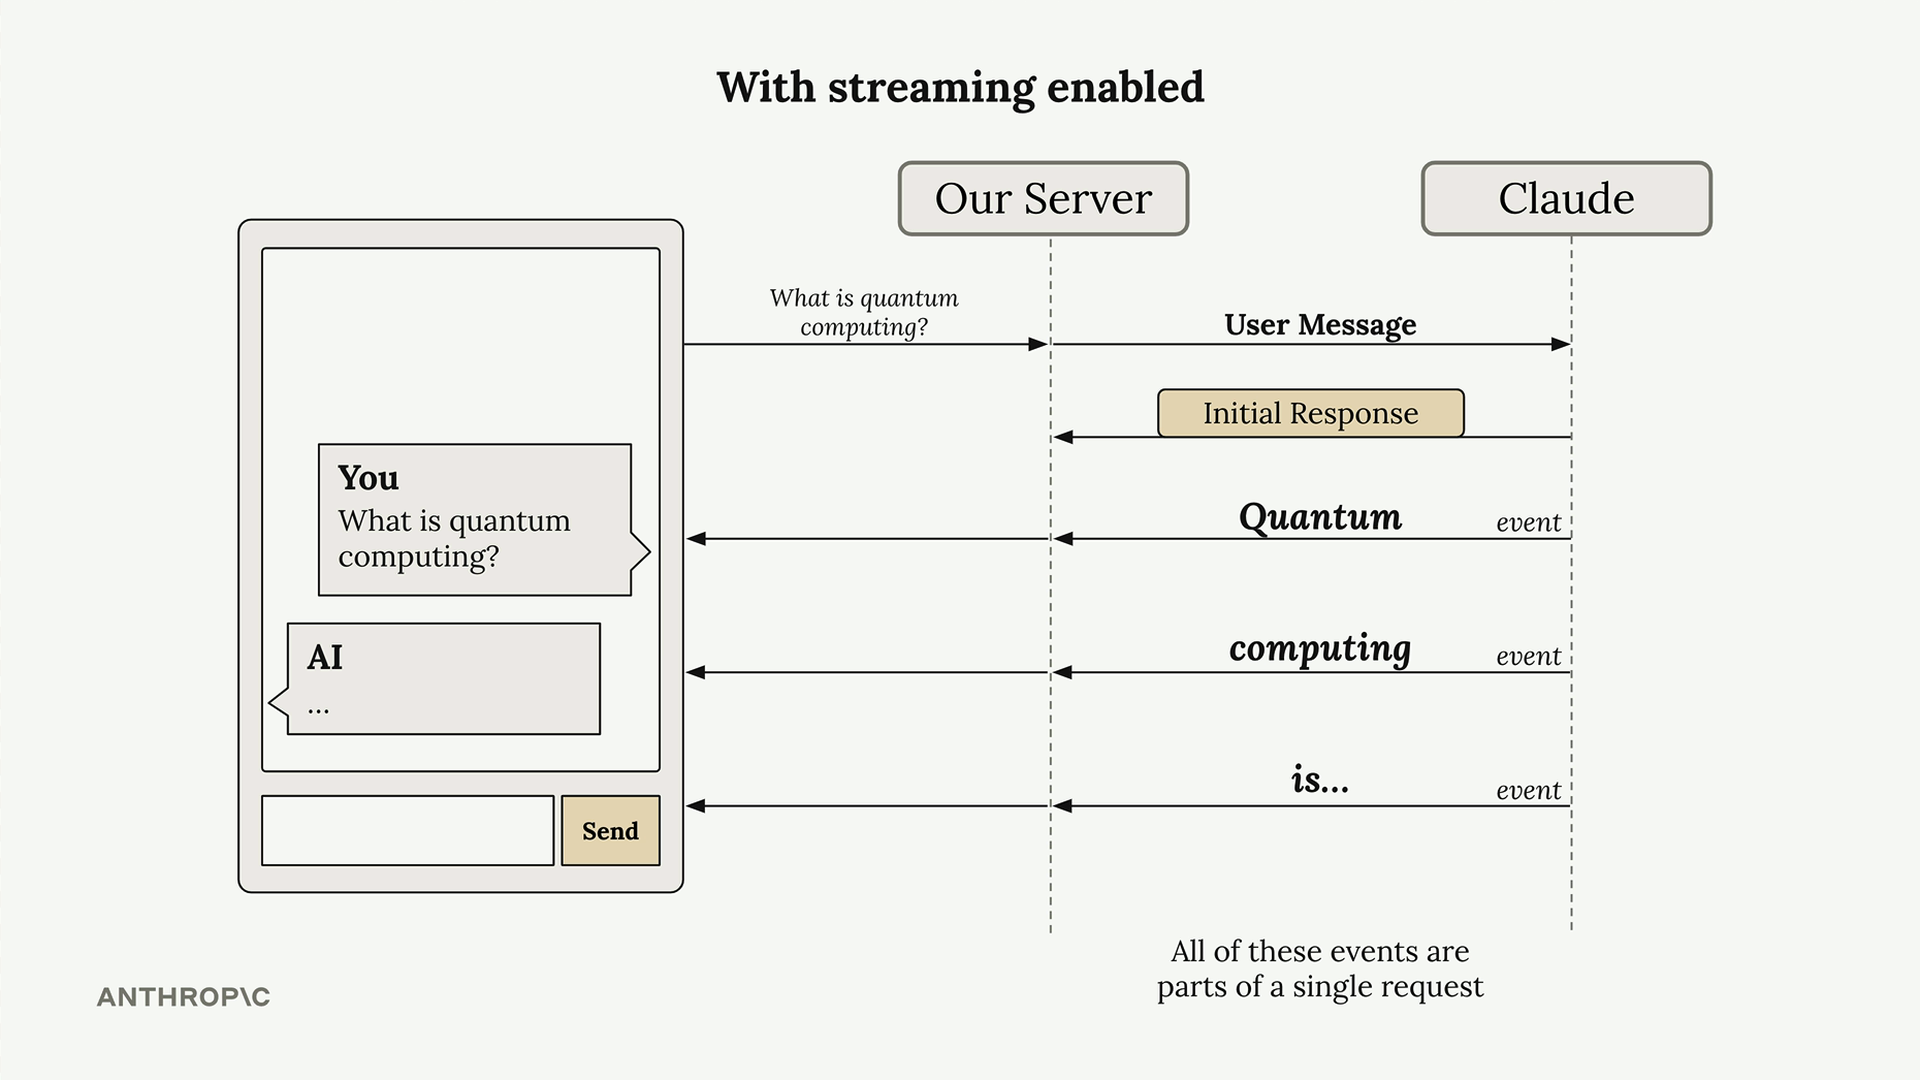
Dein Server kann diese Textteile an deine Client-Anwendung weiterleiten, sobald sie eintreffen, sodass Nutzer sehen können, wie sich die Antwort Wort für Wort aufbaut. All diese Ereignisse sind Teil einer einzigen Anfrage an Claude.
Stream-Ereignisse verstehen
Wenn du Streaming aktivierst, sendet Claude mehrere Arten von Ereignissen zurück:
- MessageStart – Eine neue Nachricht wird gesendet
- ContentBlockStart – Beginn eines neuen Blocks mit Text, Tool-Nutzung oder anderem Inhalt
- ContentBlockDelta – Teile des tatsächlich generierten Textes
- ContentBlockStop – Der aktuelle Inhaltsblock wurde abgeschlossen
- MessageDelta – Die aktuelle Nachricht ist vollständig
- MessageStop – Ende der Informationen zur aktuellen Nachricht
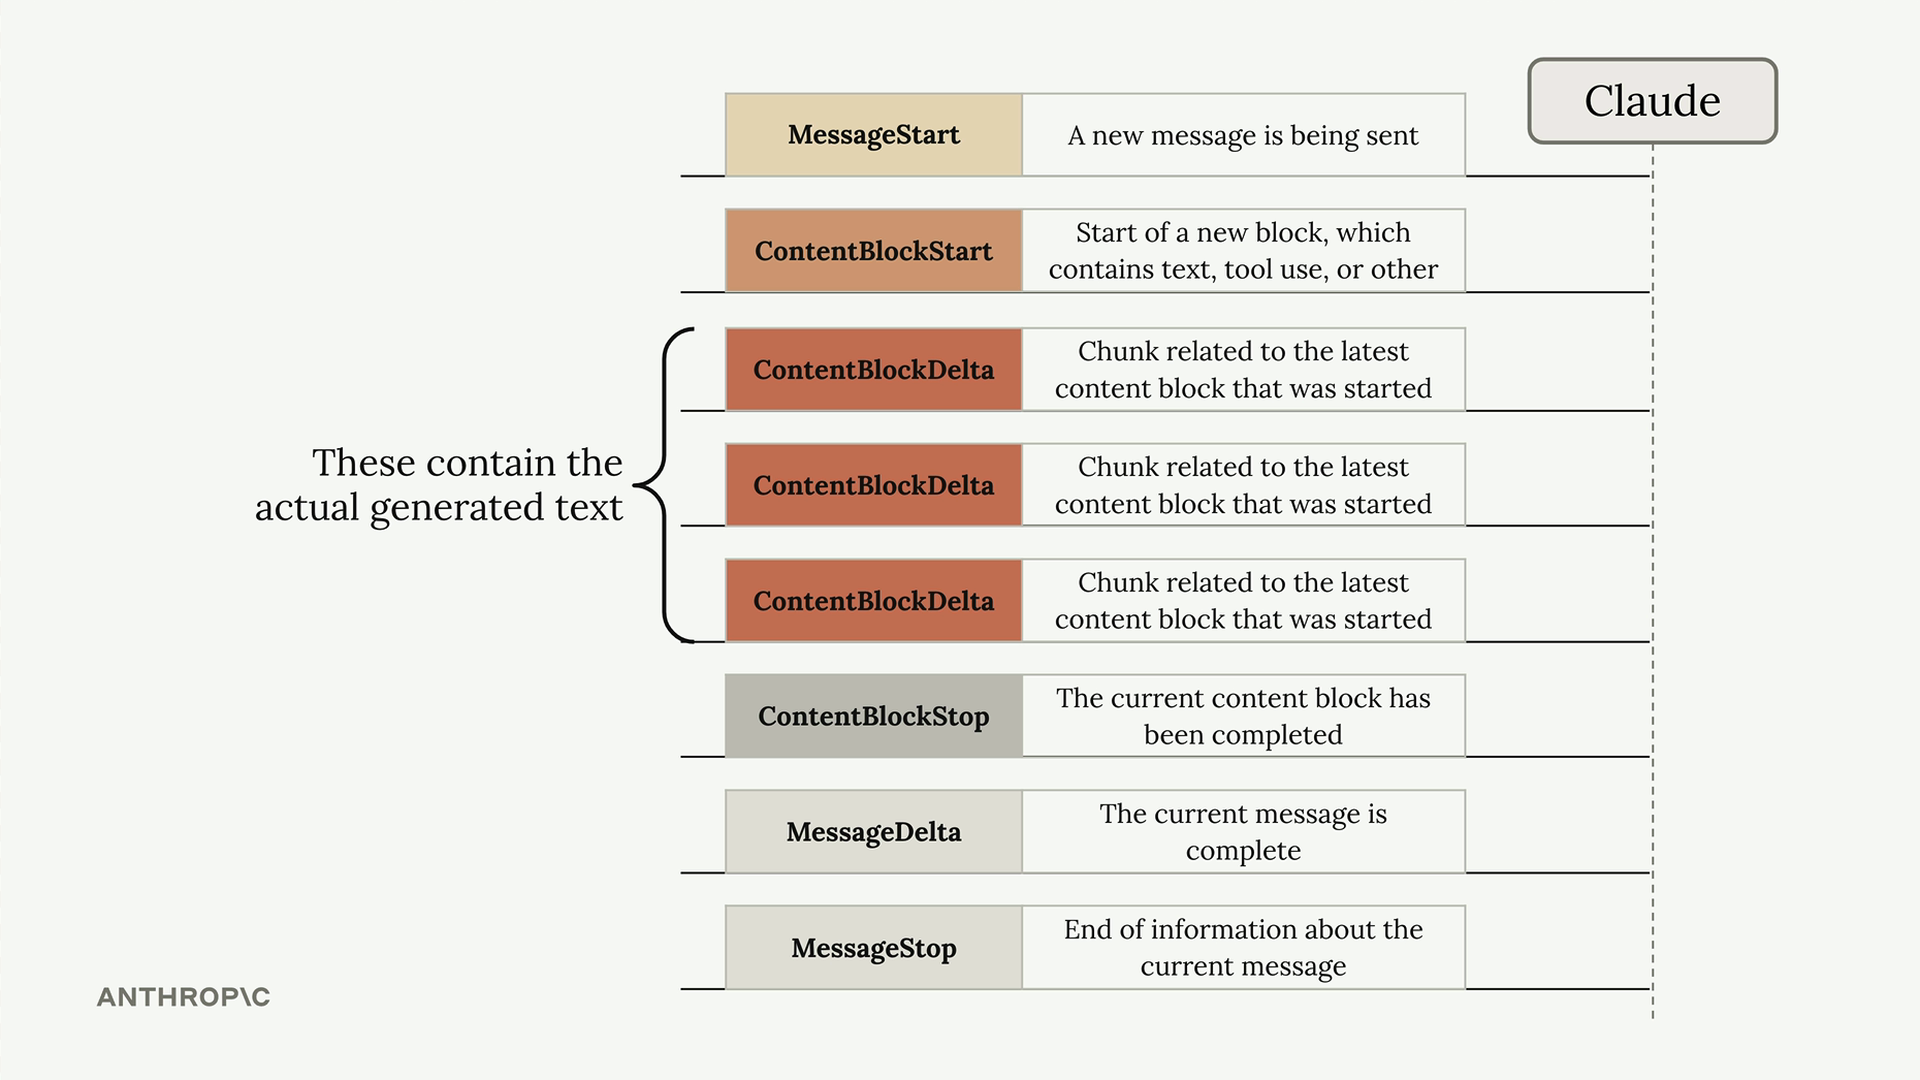
Die ContentBlockDelta-Ereignisse enthalten den tatsächlich generierten Text, den du den Nutzern anzeigen möchtest.
Grundlegende Streaming-Implementierung
Um Streaming zu aktivieren, füge stream=True zu deinem messages.create-Aufruf hinzu:
messages = []
add_user_message(messages, "Write a 1 sentence description of a fake database")

stream = client.messages.create(
    model=model,
    max_tokens=1000,
    messages=messages,
    stream=True
)

for event in stream:
    print(event)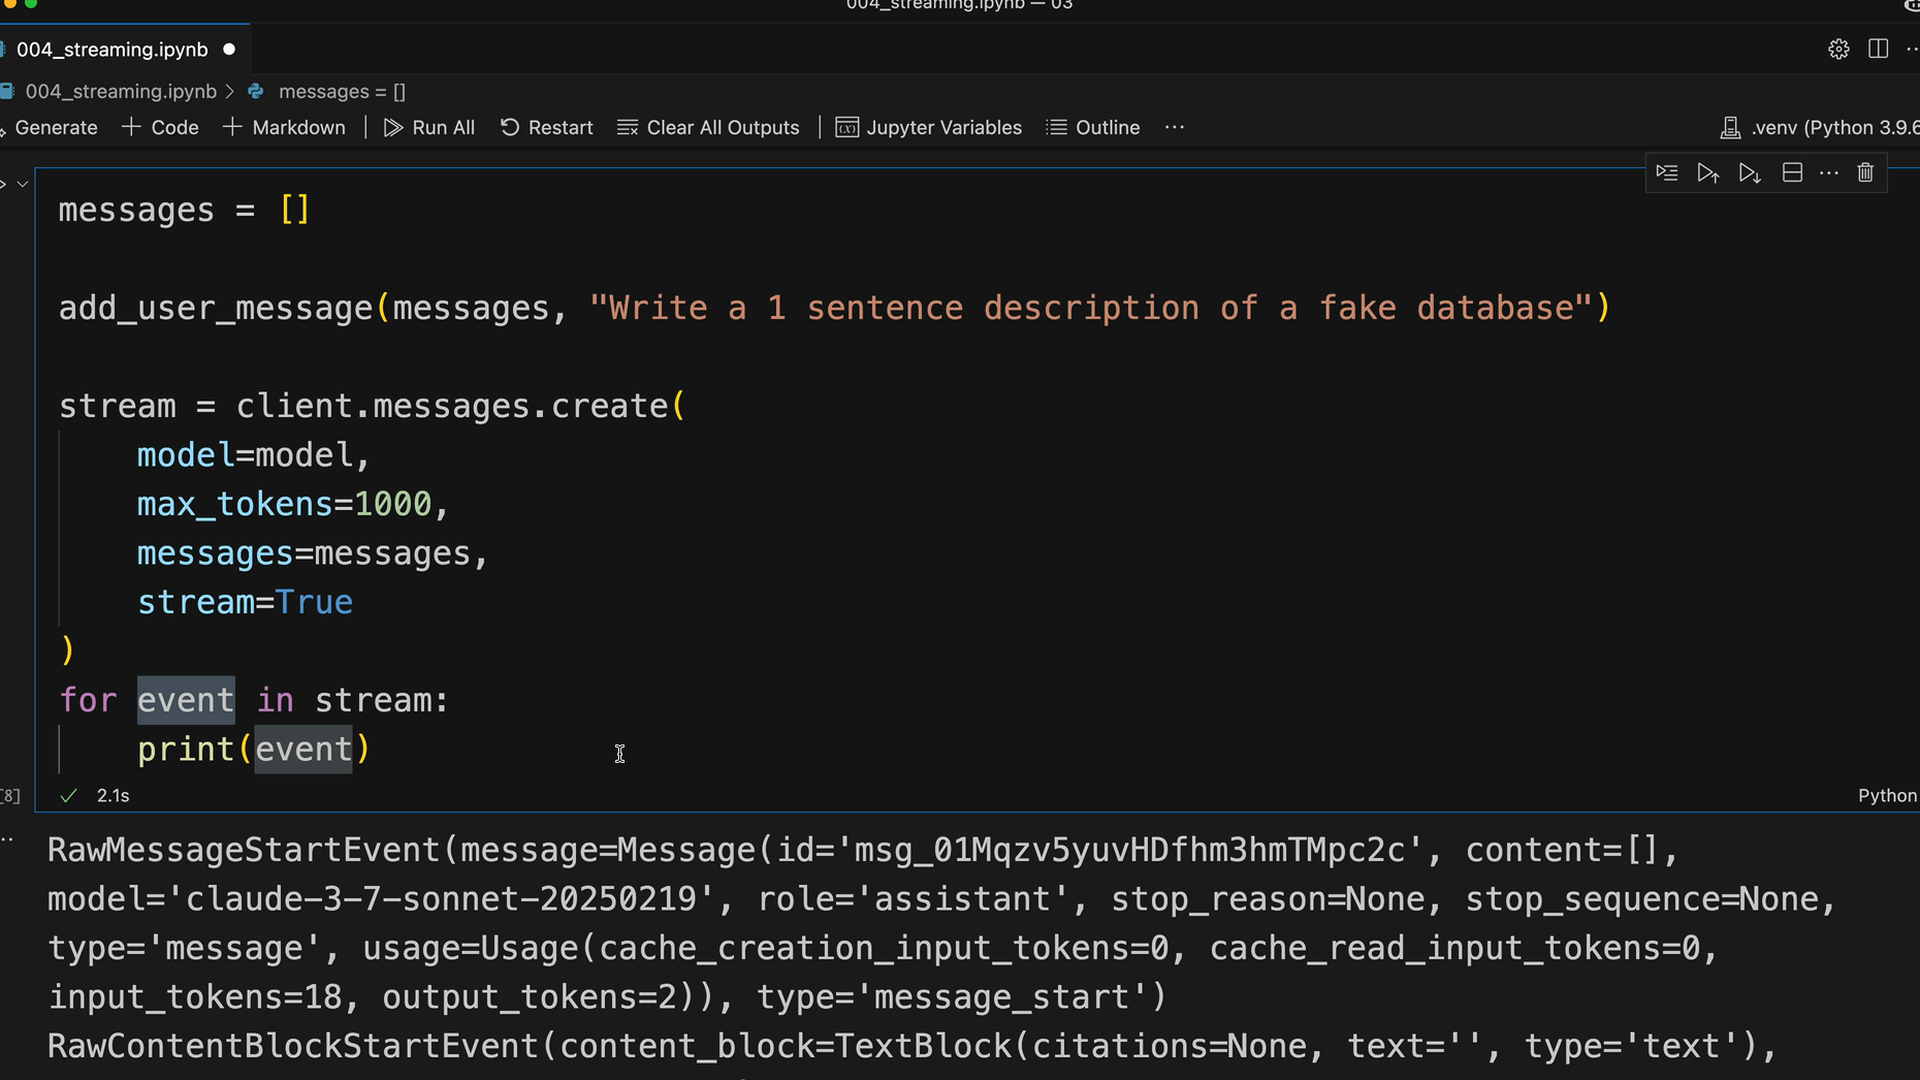
Vereinfachtes Text-Streaming
Anstatt Ereignisse manuell zu parsen, kannst du die vereinfachte Streaming-Schnittstelle des SDKs verwenden, die nur den Textinhalt extrahiert:
with client.messages.stream(
    model=model,
    max_tokens=1000,
    messages=messages
) as stream:
    for text in stream.text_stream:
        print(text, end="")
Dieser Ansatz filtert automatisch alles außer dem tatsächlichen Textinhalt heraus, was normalerweise das ist, was du zum Anzeigen von Antworten für Nutzer benötigst.
Die vollständige Nachricht erhalten
Während das Streamen einzelner Teile großartig für die Benutzererfahrung ist, benötigst du oft die vollständige Nachricht zur Speicherung oder Weiterverarbeitung. Nachdem das Streaming abgeschlossen ist, kannst du die zusammengesetzte finale Nachricht abrufen:
with client.messages.stream(
    model=model,
    max_tokens=1000,
    messages=messages
) as stream:
    for text in stream.text_stream:
        # Sende jeden Chunk an deinen Client
        pass

    # Hole die vollständige Nachricht zur Speicherung in der Datenbank
    final_message = stream.get_final_message()
Das gibt dir das Beste aus beiden Welten: Echtzeit-Streaming für Nutzer und ein vollständiges Nachrichtenobjekt für deine Anwendungslogik.