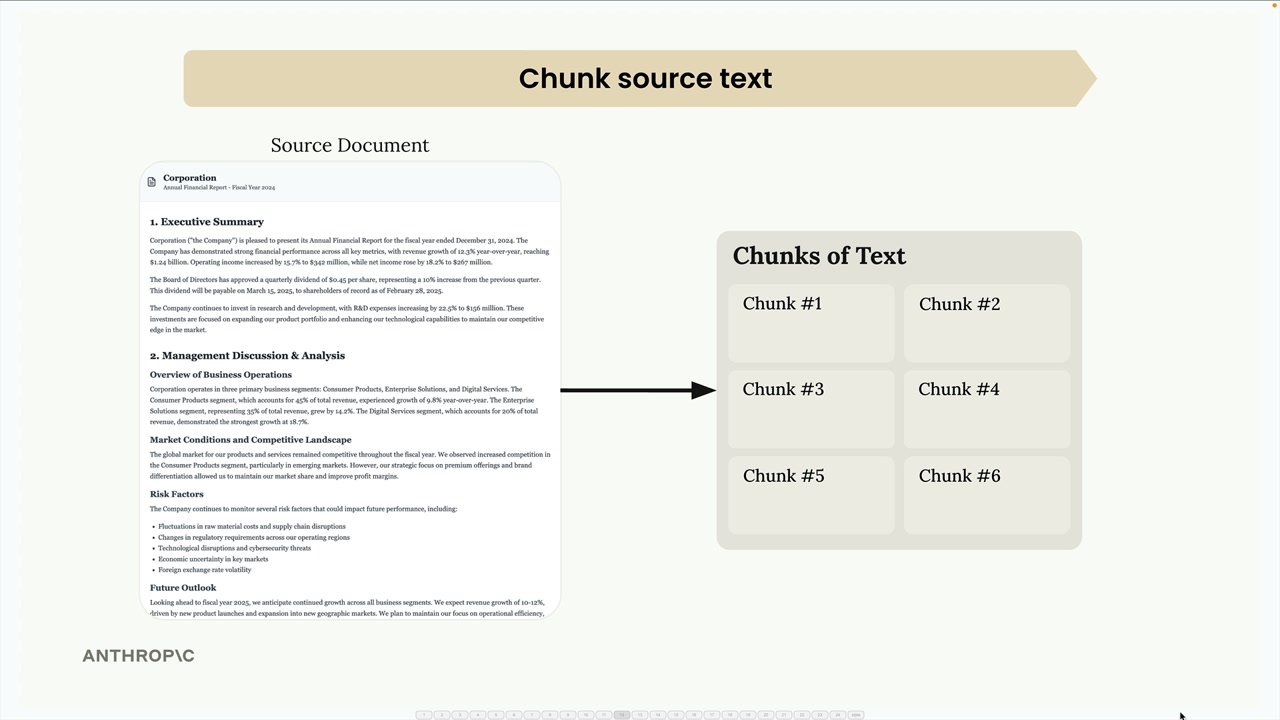
Text-Chunking ist einer der kritischsten Schritte beim Aufbau einer RAG-Pipeline (Retrieval Augmented Generation). Wie du deine Dokumente aufteilst, wirkt sich direkt auf die Qualität deines gesamten Systems aus. Eine schlechte Chunking-Strategie kann dazu führen, dass irrelevanter Kontext in deine Prompts eingefügt wird, wodurch deine KI völlig falsche Antworten gibt.
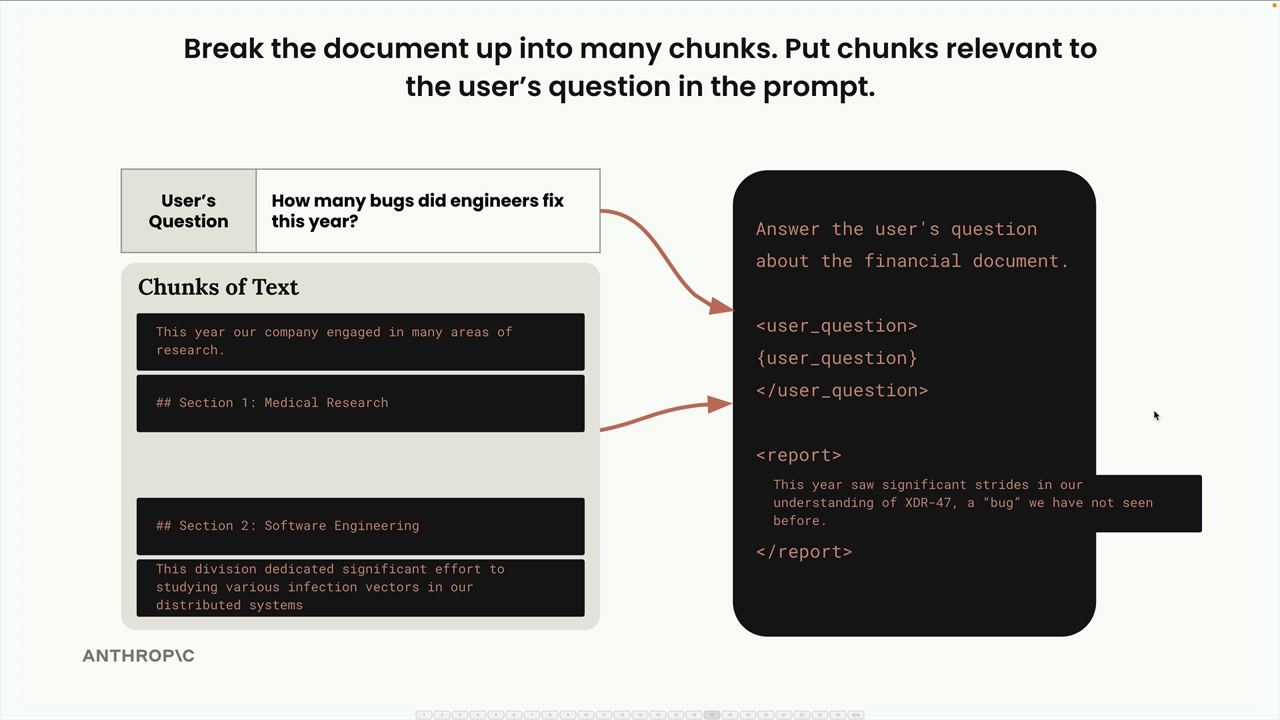
Betrachte dieses Beispiel: Du hast ein Dokument mit Abschnitten zu medizinischer Forschung und Softwareentwicklung. Wenn du schlecht chunkst, könnte ein Nutzer, der fragt „Wie viele Bugs haben die Ingenieure dieses Jahr behoben?“, stattdessen Informationen zur medizinischen Forschung erhalten, einfach weil der medizinische Abschnitt das Wort „Bug“ in einem anderen Kontext enthielt.
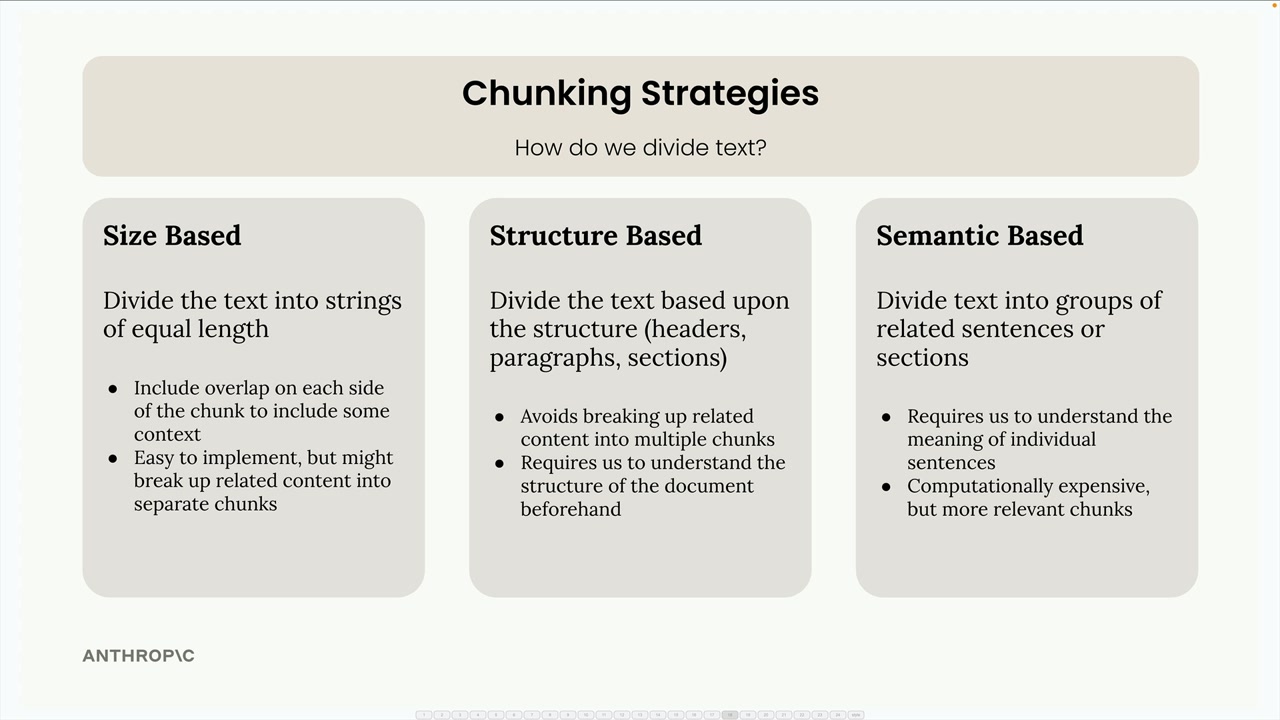
Deshalb ist die Wahl der richtigen Chunking-Strategie so wichtig. Schauen wir uns drei Hauptansätze an.
Größenbasiertes Chunking
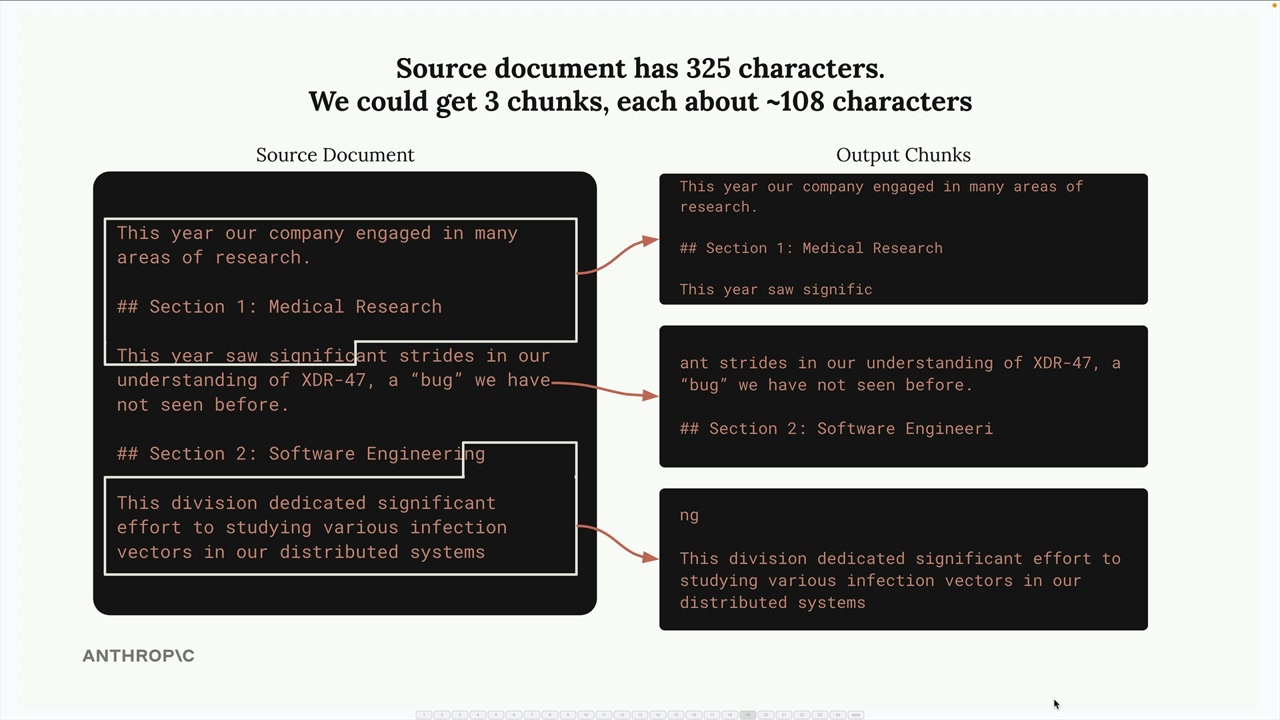
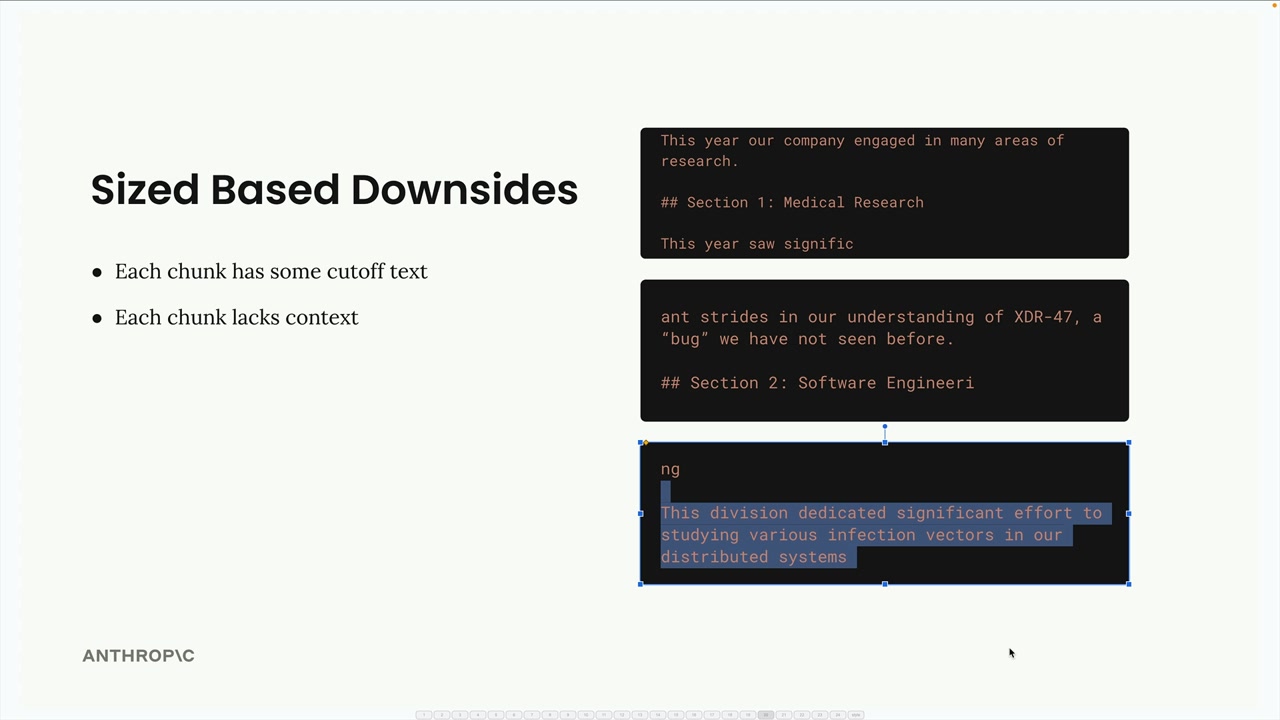
Größenbasiertes Chunking ist der einfachste Ansatz - du teilst deinen Text in Zeichenketten gleicher Länge auf. Wenn du ein Dokument mit 325 Zeichen hast, könntest du es in drei Chunks mit jeweils etwa 108 Zeichen aufteilen.
Diese Methode ist einfach umzusetzen und funktioniert mit jeder Art von Dokument, hat aber klare Nachteile:
- Wörter werden mitten im Satz abgeschnitten
- Chunks verlieren wichtigen Kontext aus dem umgebenden Text
- Abschnittsüberschriften könnten von ihrem Inhalt getrennt werden
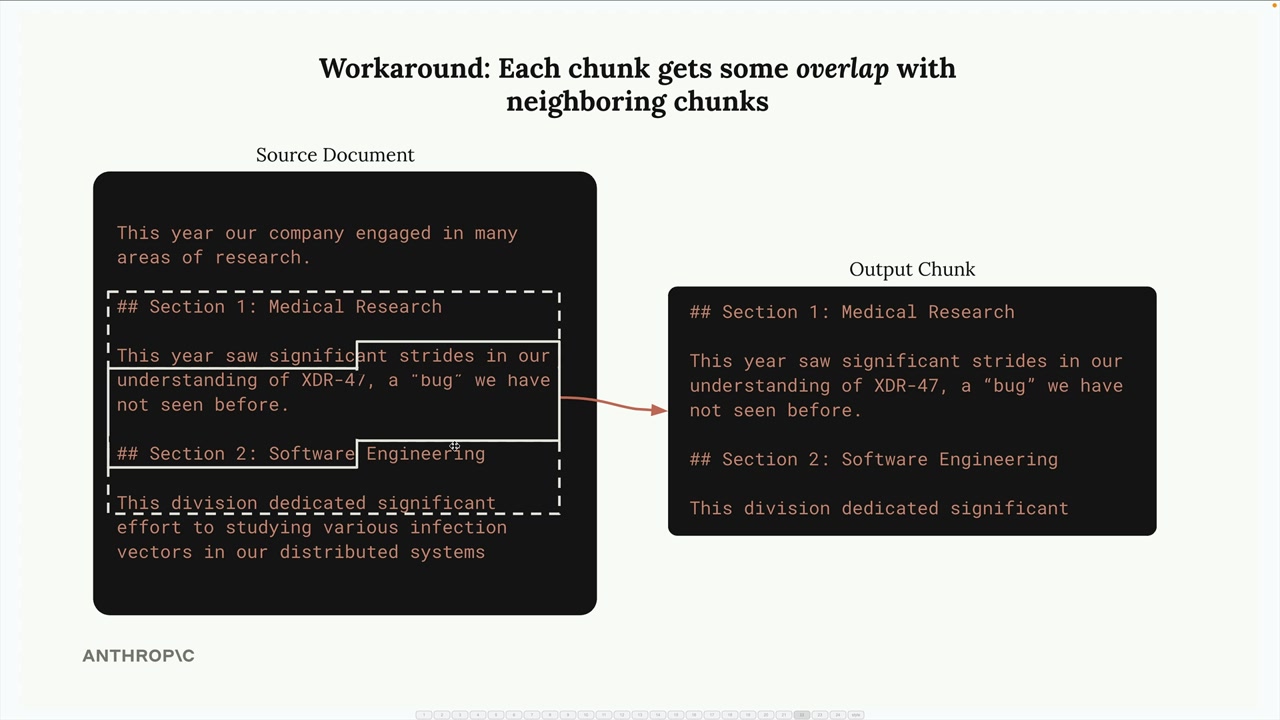
Um diese Probleme zu beheben, kannst du eine Überlappung zwischen den Chunks hinzufügen. Das bedeutet, dass jeder Chunk einige Zeichen aus den benachbarten Chunks enthält, was für besseren Kontext sorgt und vollständige Wörter und Sätze sicherstellt.
Hier ist eine grundlegende Implementierung:
def chunk_by_char(text, chunk_size=150, chunk_overlap=20):
    chunks = []
    start_idx = 0

    while start_idx < len(text):
        end_idx = min(start_idx + chunk_size, len(text))
        chunk_text = text[start_idx:end_idx]
        chunks.append(chunk_text)

        start_idx = (
            end_idx - chunk_overlap if end_idx < len(text) else len(text)
        )

    return chunks
Strukturbasiertes Chunking
Strukturbasiertes Chunking teilt Text basierend auf der natürlichen Struktur des Dokuments auf - Überschriften, Absätze und Abschnitte. Das funktioniert hervorragend, wenn du gut formatierte Dokumente wie Markdown-Dateien hast.
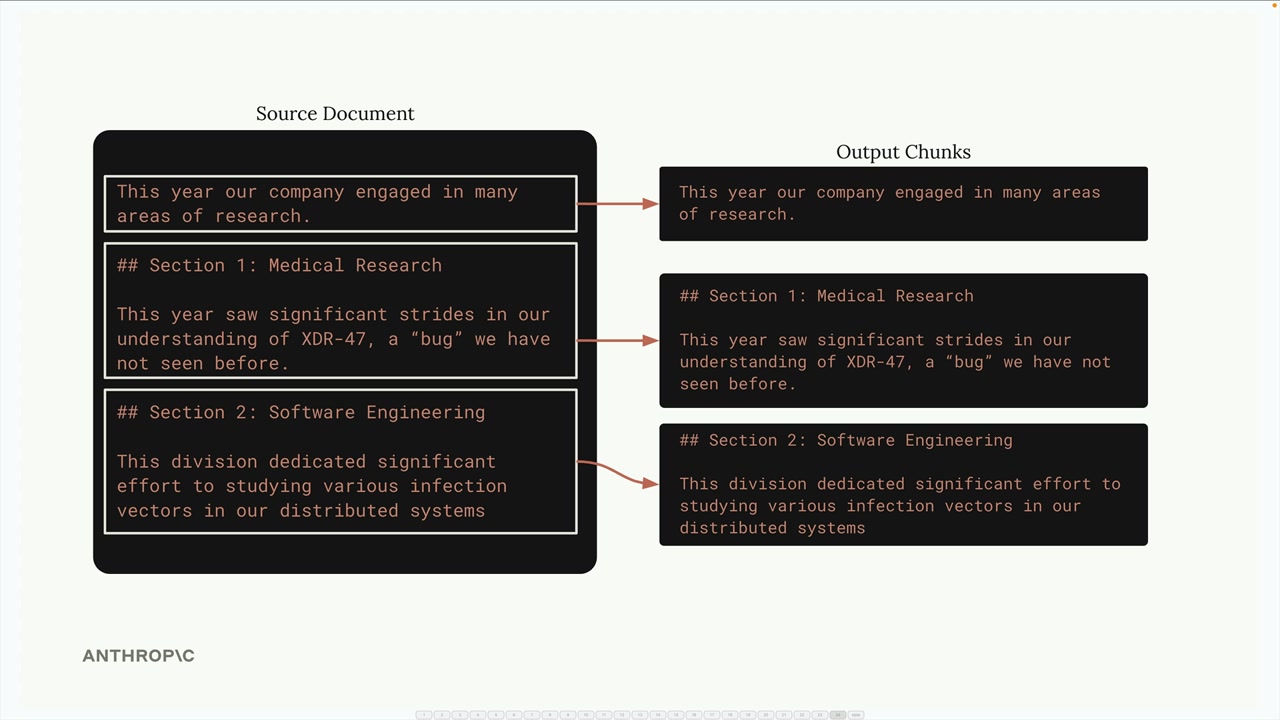
Bei einem Markdown-Dokument kannst du bei den Überschriftenmarkern aufteilen:
import re

def chunk_by_section(document_text):
    pattern = r"\n## "
    return re.split(pattern, document_text)
Dieser Ansatz liefert dir die saubersten, aussagekräftigsten Chunks, weil jeder davon einen vollständigen Abschnitt darstellt. Er funktioniert jedoch nur, wenn du Garantien zur Struktur deines Dokuments hast. Viele Dokumente in der Praxis sind reiner Text oder PDFs ohne klare strukturelle Marker.
Semantisches Chunking
Semantisches Chunking ist der anspruchsvollste Ansatz. Du teilst Text in Sätze auf und verwendest dann Natural Language Processing, um zu bestimmen, wie zusammenhängend aufeinanderfolgende Sätze sind. Du baust Chunks aus Gruppen zusammengehöriger Sätze.
Diese Methode ist rechenintensiv, liefert aber die relevantesten Chunks. Sie erfordert das Verständnis der Bedeutung einzelner Sätze und ist komplexer umzusetzen als die anderen Strategien.
Satzbasiertes Chunking
Ein praktischer Mittelweg ist das Chunking nach Sätzen. Du teilst den Text mithilfe regulärer Ausdrücke in einzelne Sätze auf und gruppierst sie dann mit optionaler Überlappung zu Chunks:
def chunk_by_sentence(text, max_sentences_per_chunk=5, overlap_sentences=1):
    sentences = re.split(r"(?<=[.!?])\s+", text)

    chunks = []
    start_idx = 0

    while start_idx < len(sentences):
        end_idx = min(start_idx + max_sentences_per_chunk, len(sentences))
        current_chunk = sentences[start_idx:end_idx]
        chunks.append(" ".join(current_chunk))

        start_idx += max_sentences_per_chunk - overlap_sentences

        if start_idx < 0:
            start_idx = 0

    return chunks
Die richtige Strategie wählen
Deine Wahl hängt vollständig von deinem Anwendungsfall und den Garantien zu deinem Dokument ab:
- Strukturbasiert: Beste Ergebnisse, wenn du die Formatierung des Dokuments kontrollierst (wie bei internen Unternehmensberichten)
- Satzbasiert: Guter Mittelweg für die meisten Textdokumente
- Größenbasiert: Zuverlässigster Rückfallansatz, der mit jeder Art von Inhalt funktioniert, einschließlich Code
Größenbasiertes Chunking mit Überlappung ist in der Produktion oft die bevorzugte Wahl, weil es einfach, zuverlässig ist und mit jeder Art von Dokument funktioniert. Auch wenn es keine perfekten Ergebnisse liefert, erzeugt es durchweg angemessene Chunks, die deine Pipeline nicht zum Absturz bringen.
Denk daran: Es gibt keine einzige „beste“ Chunking-Strategie. Der richtige Ansatz hängt von deinen spezifischen Dokumenten, Anwendungsfällen und den Kompromissen ab, die du zwischen Implementierungskomplexität und Chunk-Qualität einzugehen bereit bist.