Wenn du mit Claude arbeitest, ist das Schreiben eines guten Prompts nur der Anfang. Um zuverlässige KI-Anwendungen zu entwickeln, musst du zwei zentrale Konzepte verstehen: Prompt-Engineering und Prompt-Bewertung. Prompt-Engineering liefert dir Techniken, um bessere Prompts zu schreiben, während dir die Prompt-Bewertung dabei hilft, zu messen, wie gut diese Prompts tatsächlich funktionieren.
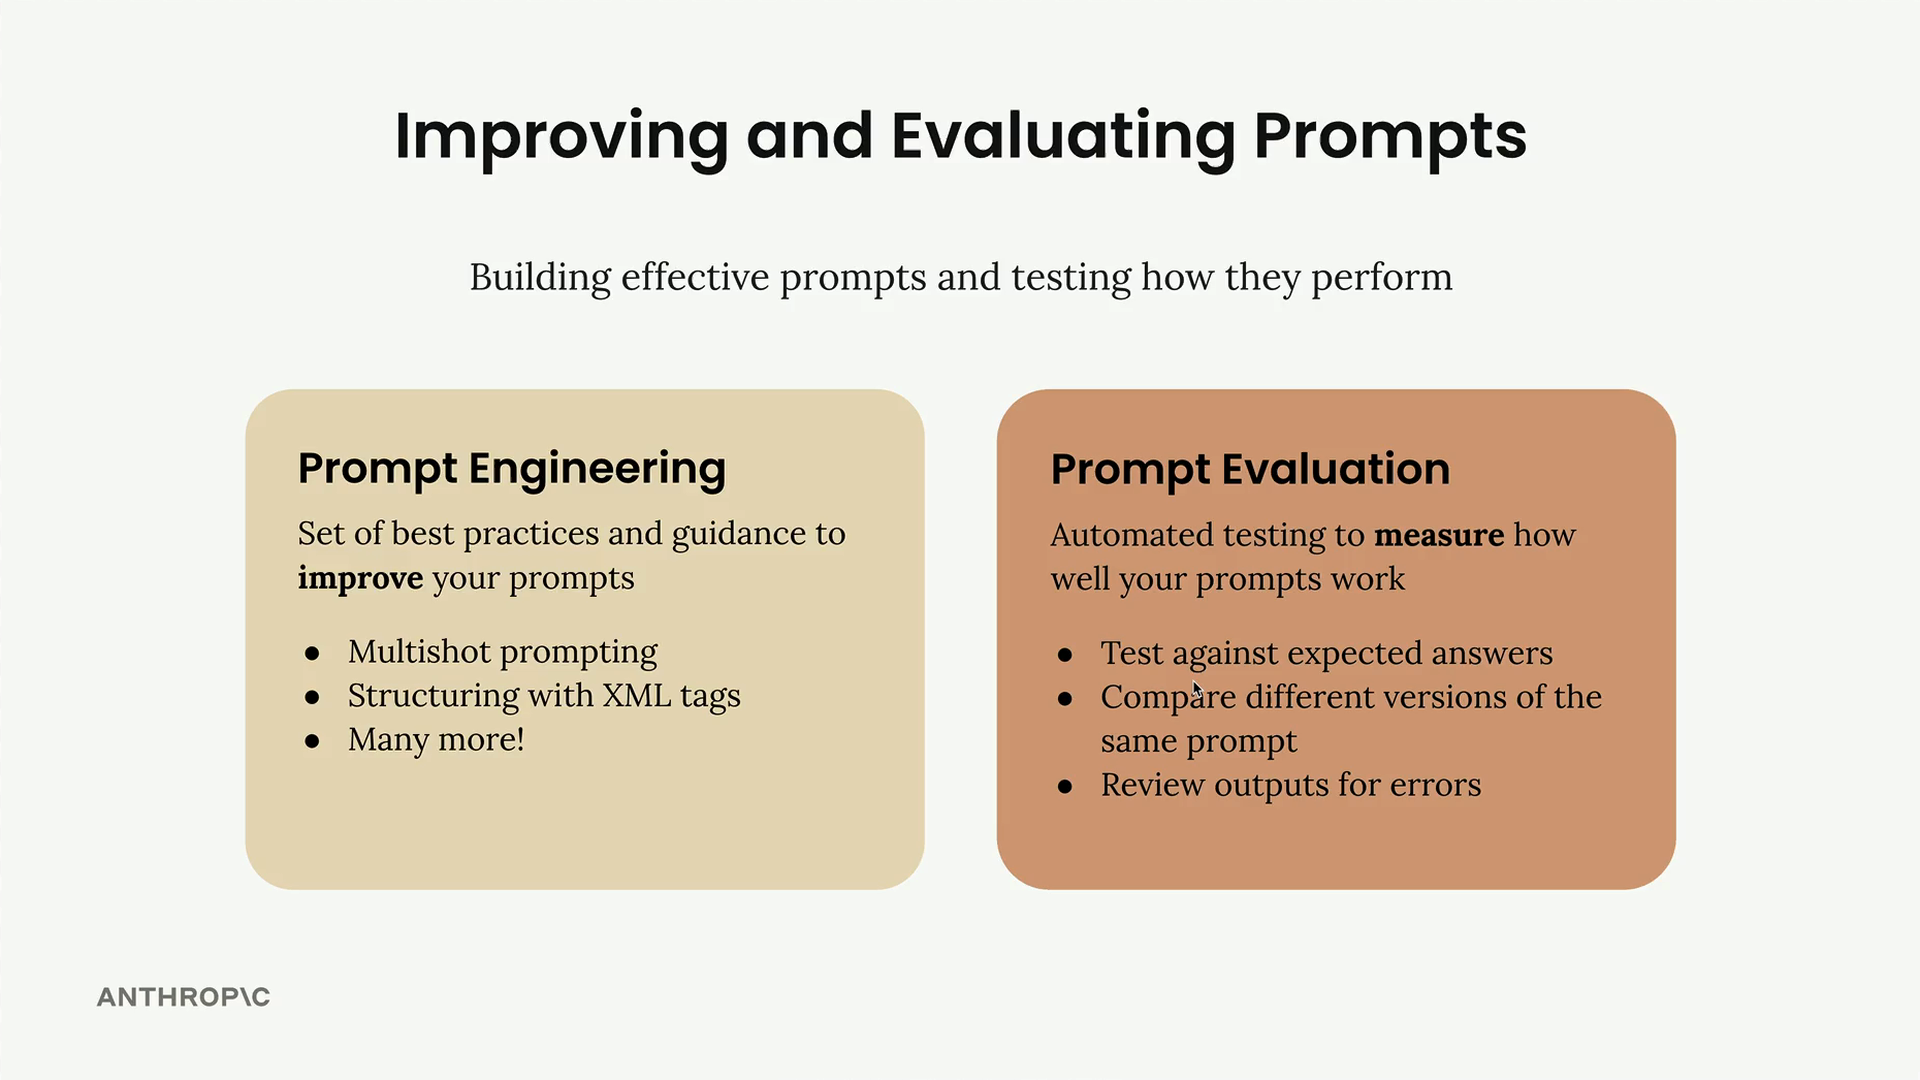
Prompt-Engineering vs. Prompt-Bewertung
Prompt-Engineering ist dein Werkzeugkasten zum Erstellen effektiver Prompts. Er umfasst Techniken wie:
- Multishot-Prompting
- Strukturierung mit XML-Tags
- Viele weitere Best Practices
Diese Techniken helfen Claude zu verstehen, wonach du genau fragst und wie du möchtest, dass es antwortet.
Die Prompt-Bewertung verfolgt einen anderen Ansatz. Statt sich darauf zu konzentrieren, wie man Prompts schreibt, geht es darum, ihre Effektivität durch automatisierte Tests zu messen. Du kannst:
- Gegen erwartete Antworten testen
- Verschiedene Versionen desselben Prompts vergleichen
- Ausgaben auf Fehler überprüfen
Drei Wege nach dem Schreiben eines Prompts
Sobald du einen Prompt entworfen hast, stehen dir in der Regel drei Optionen für das weitere Vorgehen zur Verfügung:
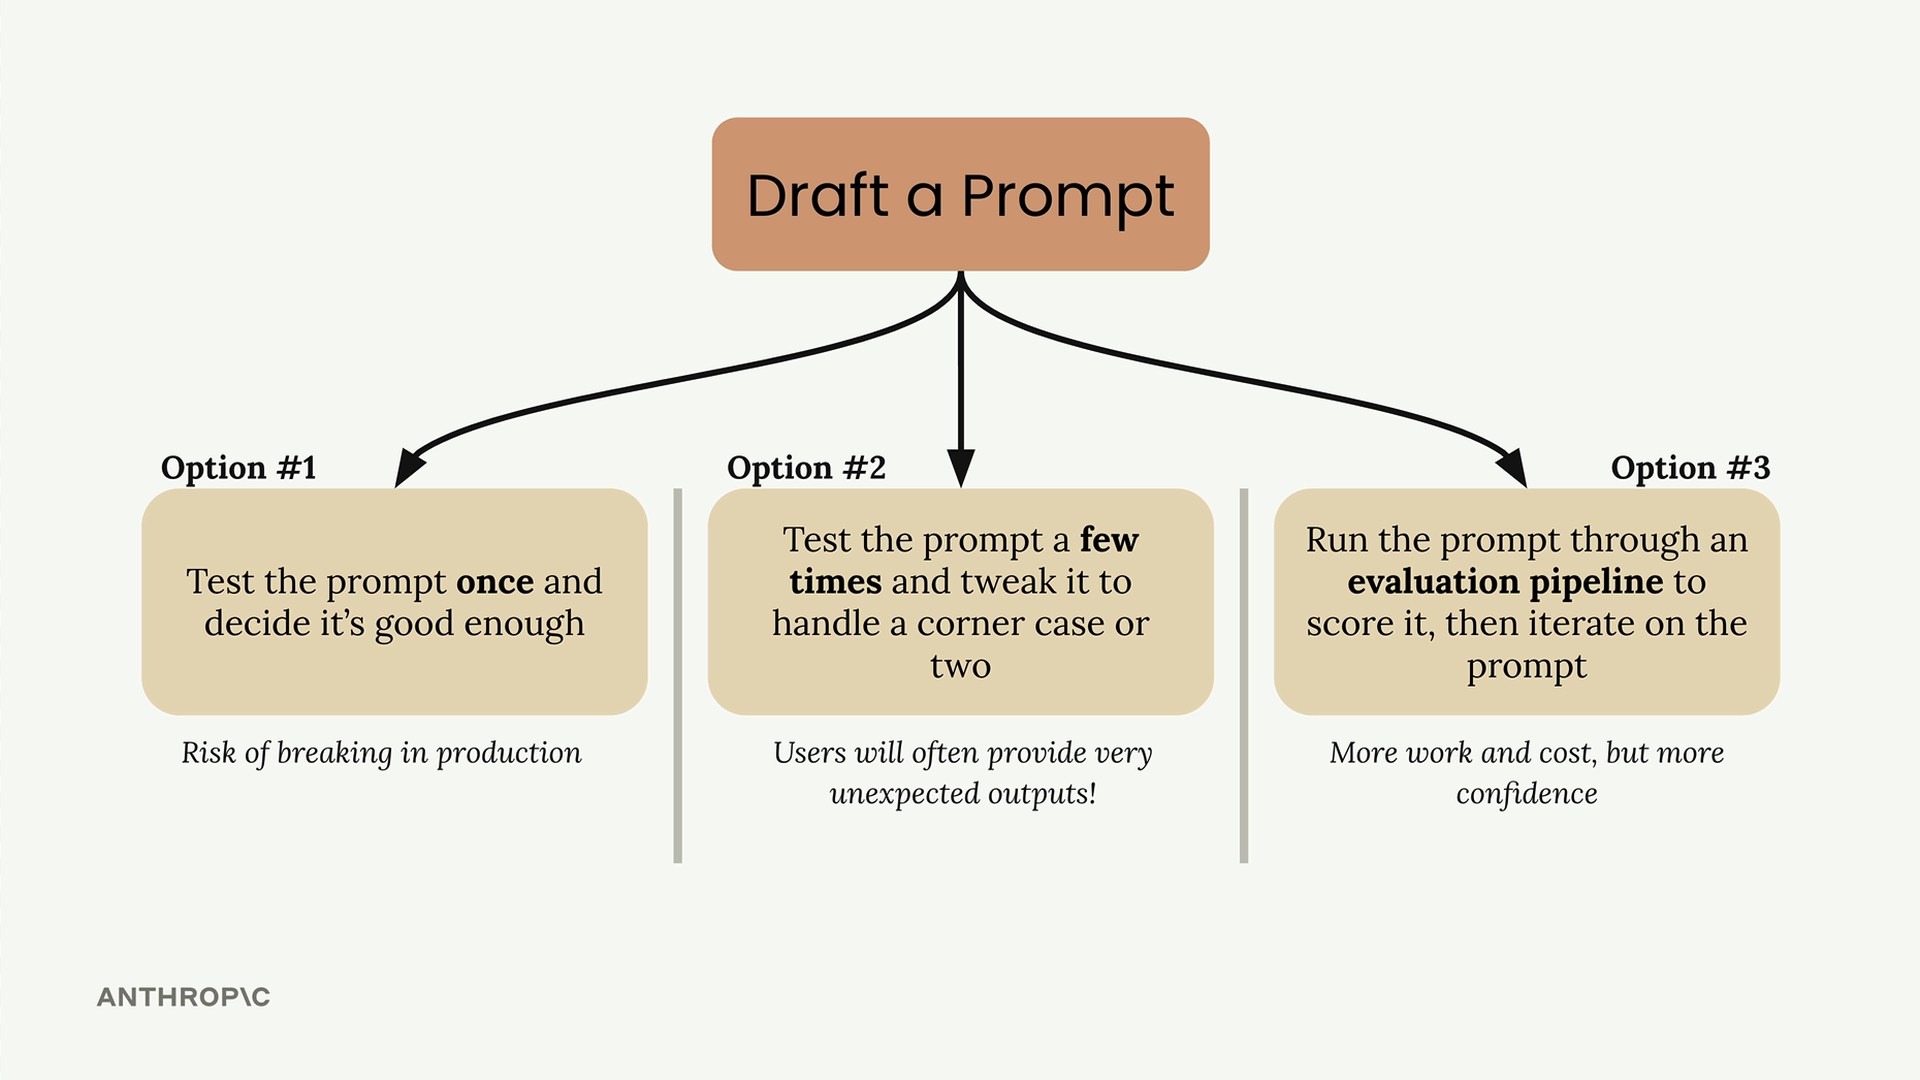
Option 1: Teste den Prompt einmal und entscheide, dass er gut genug ist. Dies birgt ein erhebliches Risiko, in der Produktion zu versagen, wenn Nutzer unerwartete Eingaben machen.
Option 2: Teste den Prompt ein paar Mal und passe ihn an, um einen oder zwei Grenzfälle zu behandeln. Das ist zwar besser als Option 1, aber Nutzer werden oft sehr unerwartete Ausgaben liefern, die du nicht berücksichtigt hast.
Option 3: Lasse den Prompt eine Bewertungspipeline durchlaufen, um ihn zu bewerten, und iteriere dann basierend auf objektiven Metriken am Prompt. Dieser Ansatz erfordert mehr Aufwand und Kosten, gibt dir aber deutlich mehr Vertrauen in die Zuverlässigkeit deines Prompts.
Warum die meisten Entwickler in Test-Fallen tappen
Die Optionen 1 und 2 sind gängige Fallen, in die alle Entwickler tappen, mich selbst eingeschlossen. Es ist naheliegend, einen Prompt für eine ernsthafte Anwendung zu schreiben und ihn nicht gründlich genug zu testen. Wir neigen dazu, zu unterschätzen, wie viele Grenzfälle echte Nutzer erleben werden.
Die Realität ist, dass Nutzer, sobald du einen Prompt in die Produktion bringst, auf Weisen mit ihm interagieren werden, die du nie vorhergesehen hast. Was während deiner begrenzten Tests wie ein solider Prompt wirkte, kann schnell versagen, wenn es mit der vollen Vielfalt realer Eingaben konfrontiert wird.
Der Evaluation-First-Ansatz
Option 3 stellt einen systematischeren Ansatz für die Prompt-Entwicklung dar. Indem du deinen Prompt durch eine Bewertungspipeline laufen lässt, erhältst du objektive Metriken über seine Leistung in einer breiteren Palette von Testfällen. Dieser datengetriebene Ansatz ermöglicht es dir:
- Schwachstellen zu erkennen, bevor sie zu Produktionsproblemen werden
- Verschiedene Prompt-Versionen objektiv zu vergleichen
- Mit Vertrauen auf Basis messbarer Verbesserungen zu iterieren
- Zuverlässigere KI-Anwendungen zu entwickeln
Auch wenn dieser Ansatz mehr Vorabinvestitionen an Zeit und Testinfrastruktur erfordert, zahlt er sich in der Zuverlässigkeit und Robustheit deiner endgültigen Anwendung aus. Das Ziel ist es, Probleme während der Entwicklung zu erkennen, statt erst dann, wenn deine Nutzer auf sie stoßen.