Wenn du KI-Modelle bewertest, die Code generieren, brauchst du mehr als nur die Überprüfung, ob die Antwort sinnvoll erscheint. Du musst auch verifizieren, dass der generierte Code tatsächlich eine gültige Syntax hat und dem korrekten Format folgt. Genau hier kommt die codebasierte Bewertung ins Spiel.
Wie die Code-Bewertung funktioniert
Die Code-Bewertung validiert zwei zentrale Aspekte von KI-generierten Antworten:
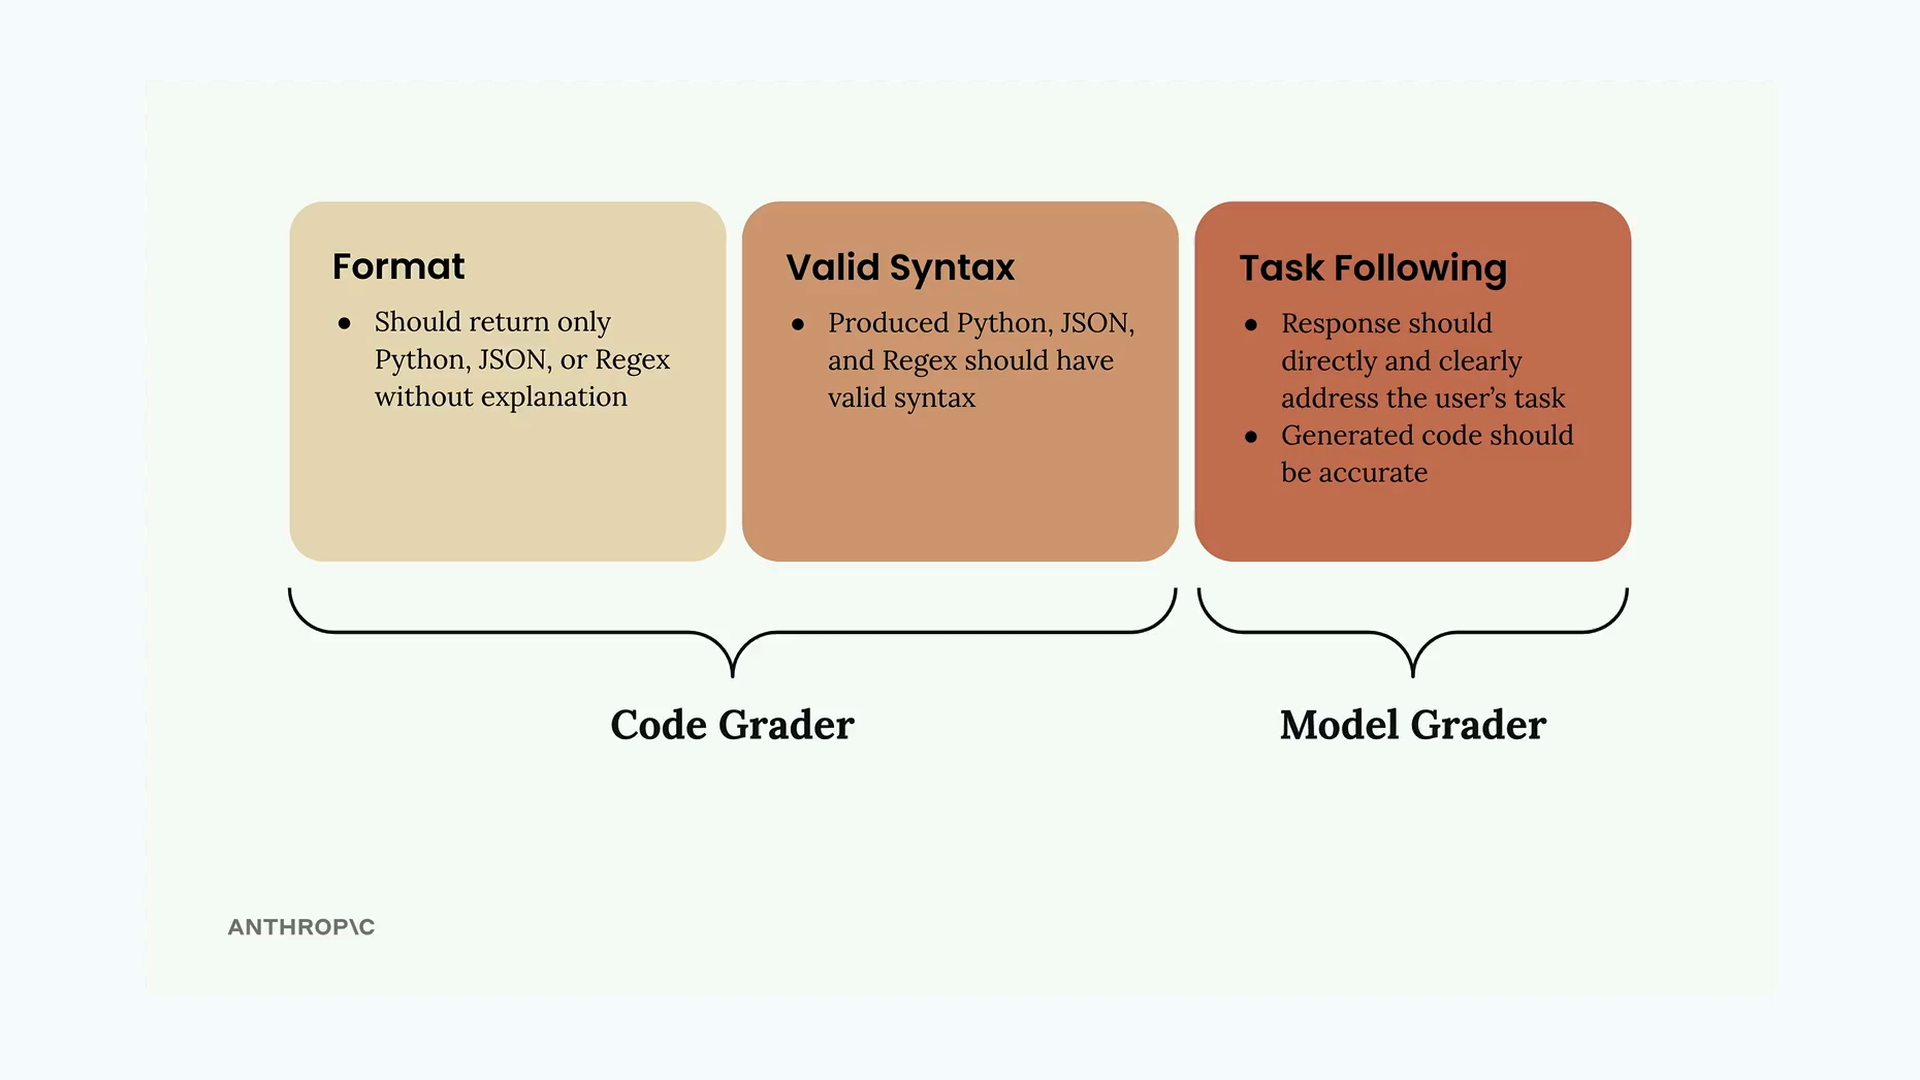
- Format - Die Antwort sollte nur den angeforderten Codetyp (Python, JSON oder Regex) zurückgeben, ohne Erklärungen
- Gültige Syntax - Der generierte Code sollte sich tatsächlich korrekt als die beabsichtigte Sprache parsen lassen
- Task Following - Die Antwort sollte direkt auf das Gefragte eingehen und akkurat sein
Die ersten beiden Kriterien werden vom Code-Grader gehandhabt, während Task Following vom Modell-Grader bewertet wird. Zusammen liefern sie eine umfassende Bewertung.
Funktionen zur Syntaxvalidierung
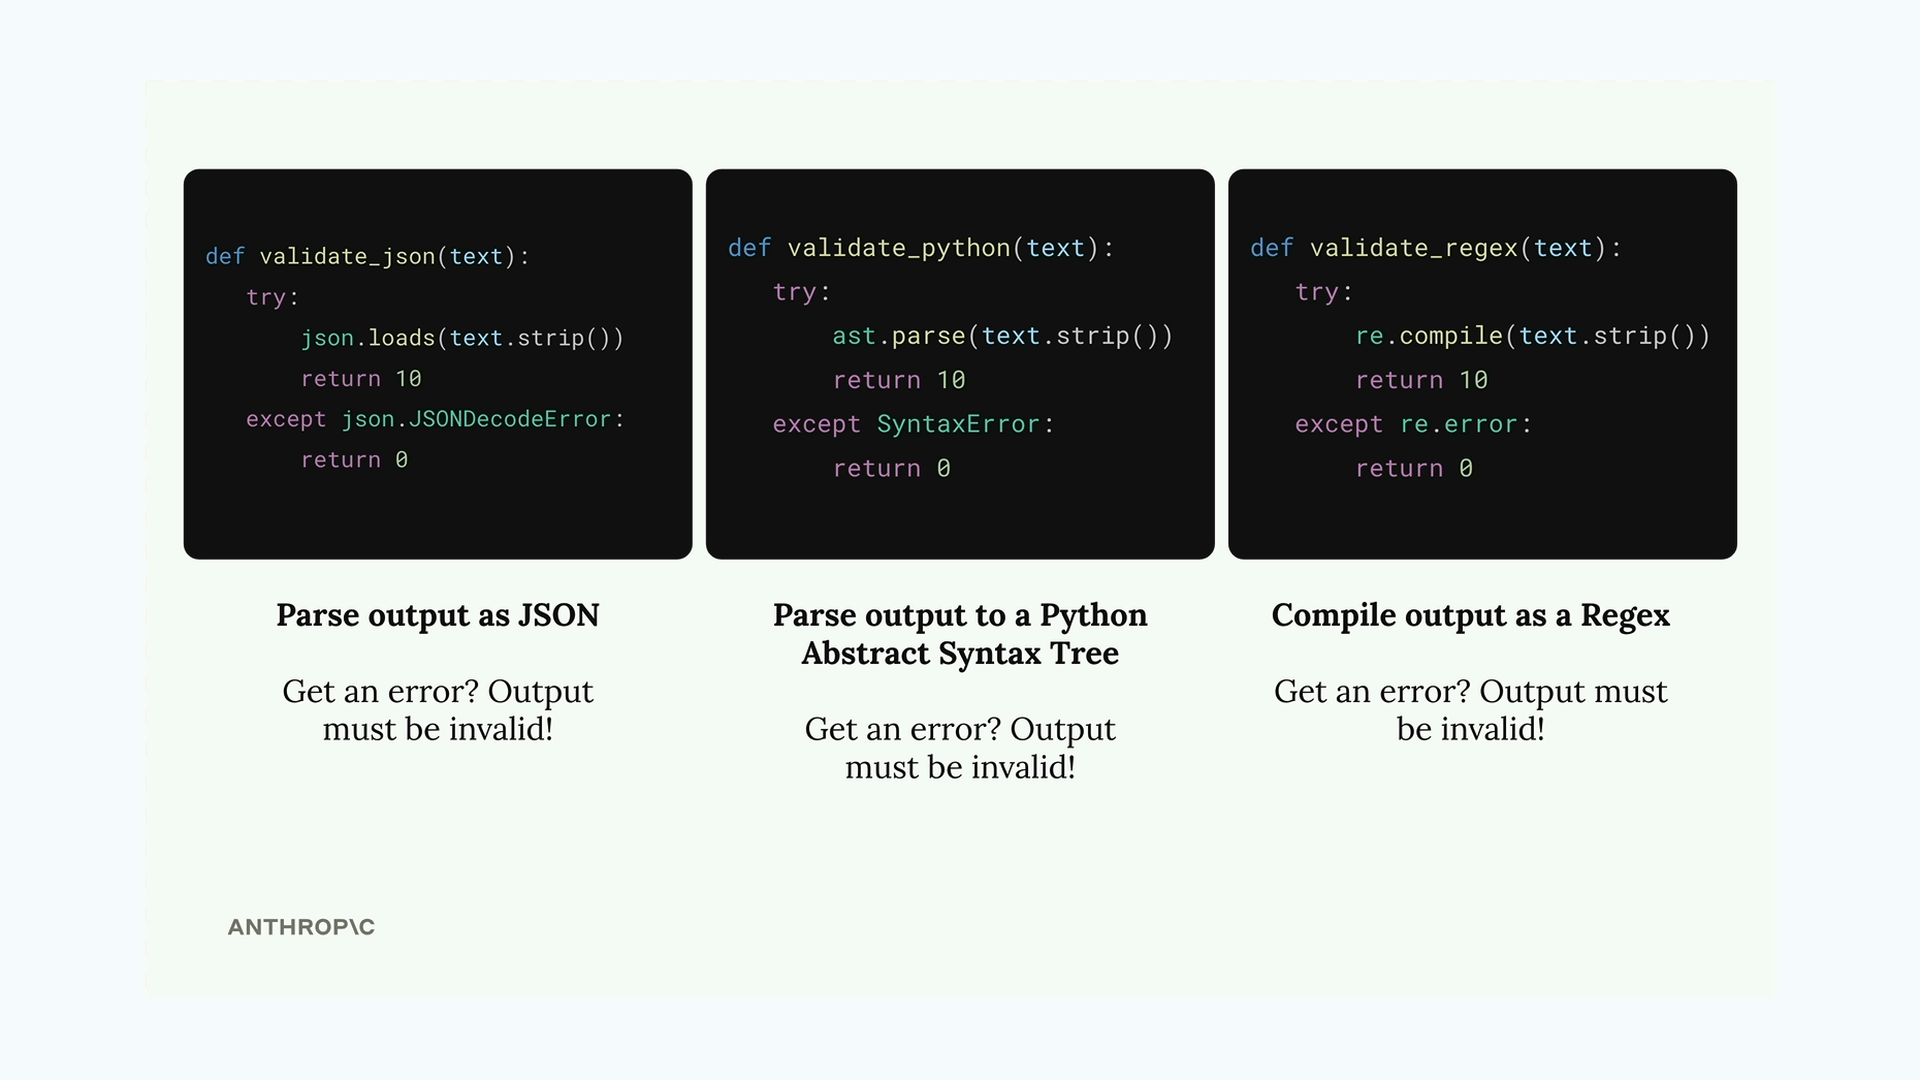
Um zu prüfen, ob der generierte Code eine gültige Syntax hat, kannst du drei Hilfsfunktionen erstellen, die versuchen, die Ausgabe zu parsen:
import ast
import json
import re

def validate_json(text):
    try:
        json.loads(text.strip())
        return 10
    except json.JSONDecodeError:
        return 0

def validate_python(text):
    try:
        ast.parse(text.strip())
        return 10
    except SyntaxError:
        return 0

def validate_regex(text):
    try:
        re.compile(text.strip())
        return 10
    except re.error:
        return 0
Jede Funktion versucht, den Text als jeweiliges Format zu parsen. Gelingt das Parsen, gibt sie eine perfekte Punktzahl von 10 zurück. Schlägt es mit einem Fehler fehl, ist die Syntax ungültig und es wird 0 zurückgegeben.
Anforderungen an das Datensatzformat
Damit der Code-Grader weiß, welcher Validator zu verwenden ist, müssen deine Testfälle das erwartete Ausgabeformat angeben:
{
    "task": "Create a Python function to validate an AWS IAM username",
    "format": "python"
}
Du kannst deinen Prompt zur Datensatzgenerierung aktualisieren, um dieses Format-Feld automatisch einzubeziehen, indem du es der Beispiel-Ausgabestruktur hinzufügst.
Verbesserung der Prompt-Klarheit
Um bessere Ergebnisse von deinem KI-Modell zu erhalten, formuliere deine Prompt-Anweisungen spezifischer hinsichtlich des erwarteten Ausgabeformats:
* Respond only with Python, JSON, or a plain Regex
* Do not add any comments or commentary or explanationDu kannst auch eine vorausgefüllte Assistant-Nachricht mit Code-Blöcken verwenden, um das Modell dazu zu bringen, nur den reinen Code zurückzugeben:
add_assistant_message(messages, "```code")
output = chat(messages, stop_sequences=["```"])
Dies weist Claude an, mit der Generierung von Code-Inhalten zu beginnen, ohne vorab angeben zu müssen, ob es sich um Python, JSON oder Regex handelt.
Kombinieren von Punktzahlen
Wähle zunächst den Validator aus, der zu jedem Testfall passt:
def grade_syntax(output, test_case):
    if test_case["format"] == "json":
        return validate_json(output)
    if test_case["format"] == "python":
        return validate_python(output)
    return validate_regex(output)
Der letzte Schritt besteht darin, die Punktzahl des Modell-Graders mit der Punktzahl des Code-Graders zusammenzuführen. Ein einfacher Ansatz besteht darin, innerhalb von run_test_case den Durchschnitt zu bilden:
model_grade = grade_by_model(test_case, output)
model_score = model_grade["score"]
syntax_score = grade_syntax(output, test_case)

score = (model_score + syntax_score) / 2
Dies gewichtet sowohl die inhaltliche Qualität als auch die technische Korrektheit gleich stark. Du kannst diese Gewichtungen anpassen, je nachdem, was für deinen spezifischen Anwendungsfall wichtiger ist.
Testen deiner Implementierung
Sobald du die Code-Bewertung implementiert hast, führe deine Evaluation aus, um einen Ausgangswert zu erhalten. Die Punktzahl selbst ist nicht von Natur aus gut oder schlecht - entscheidend ist, ob du sie durch die Verfeinerung deiner Prompts verbessern kannst. Das gibt dir eine quantitative Möglichkeit, den Fortschritt beim Prompt-Engineering zu messen, anstatt dich auf eine subjektive Einschätzung zu verlassen.