既然我們已經介紹了 RAG、文本分塊(text chunking)和嵌入(embeddings)的基礎知識,接下來讓我們逐步走過完整的 RAG 流程。這個詳細的範例將向您展示在實際實作中所有部分是如何組合在一起的。
步驟 1:將來源文本分塊
首先,我們取得來源文件並將其拆分成可管理的區塊。在這個範例中,我們將使用兩個簡單的文本區段:
- 區段 1:醫學研究 —「今年在我們對 XDR-47 的了解上有了重大進展,這是一種我們以前從未見過的『bug』。」
- 區段 2:軟體工程 —「這個部門投入大量心力研究我們分散式系統中的各種感染途徑」
步驟 2:生成嵌入
接下來,我們將每個文本區塊轉換為數值嵌入。為了讓這個概念更清楚,我們假設有一個完美的嵌入模型,它總是恰好回傳兩個數字,而且我們知道每個數字代表什麼:
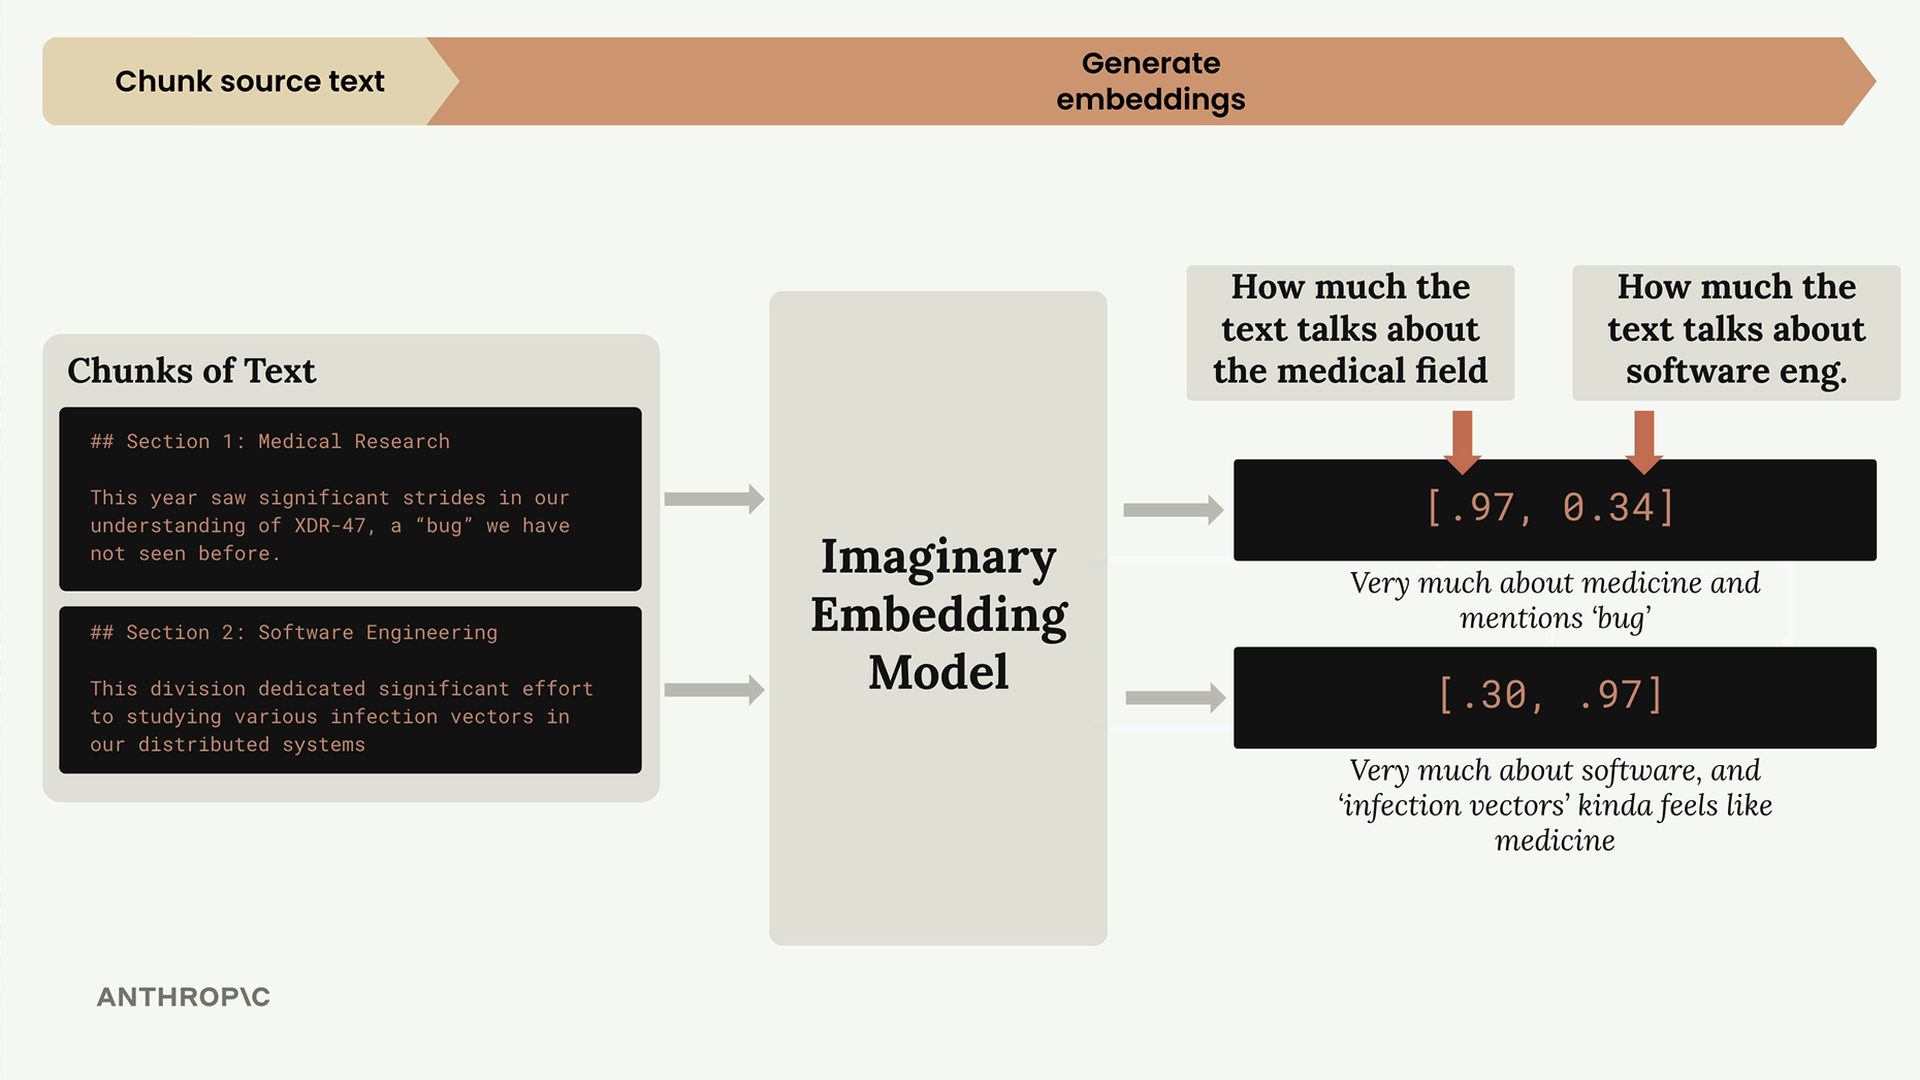
在我們假想的模型中:
- 第一個數字:文本談論醫學領域的程度
- 第二個數字:文本談論軟體工程的程度
因此我們的醫學研究區段得到的嵌入為 [0.97, 0.34]——非常偏醫學,但因為「bug」這個字而有些偏軟體相關。軟體工程區段得到 [0.30, 0.97]——非常偏軟體,但「感染途徑」帶有醫學意涵。
正規化
在儲存這些嵌入之前,它們會經過正規化(normalization)處理,將每個向量縮放成大小(magnitude)為 1.0。這通常由您的嵌入 API 自動處理,但了解它的發生過程仍然很重要。
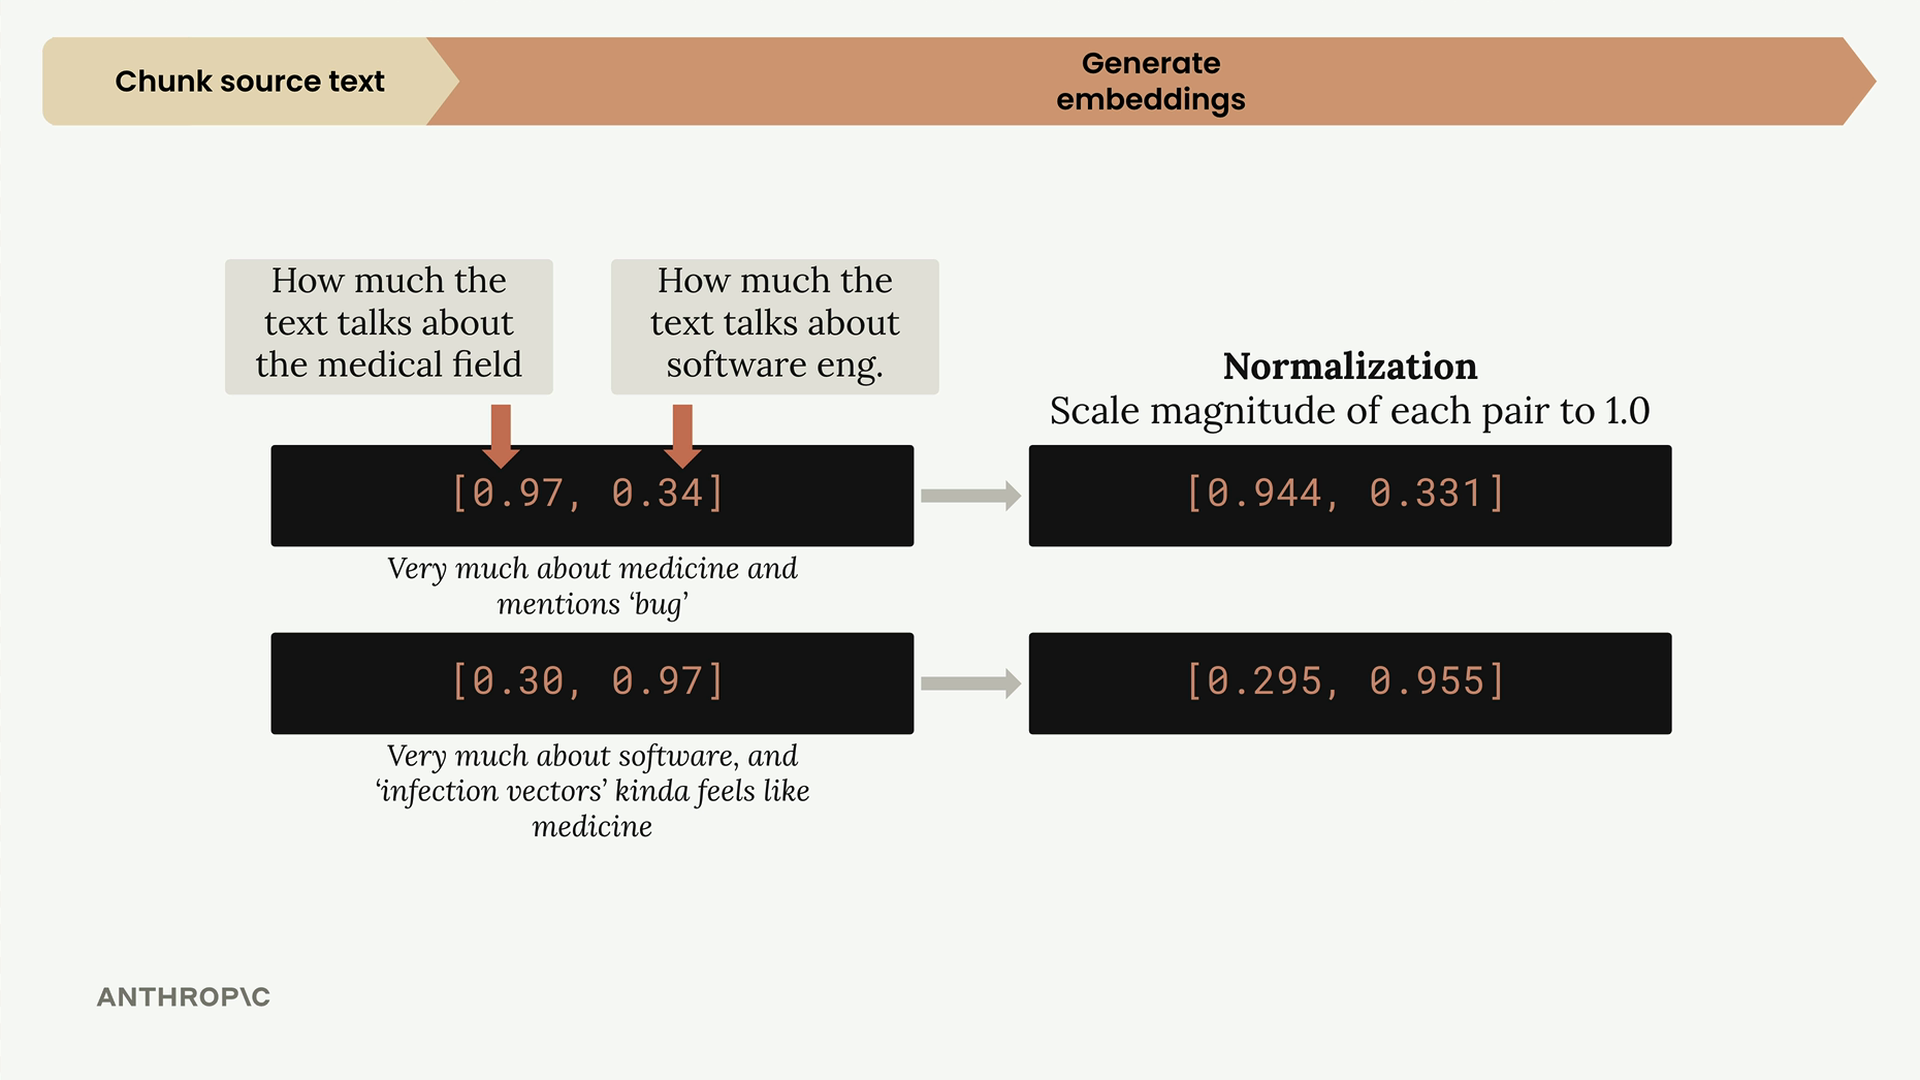
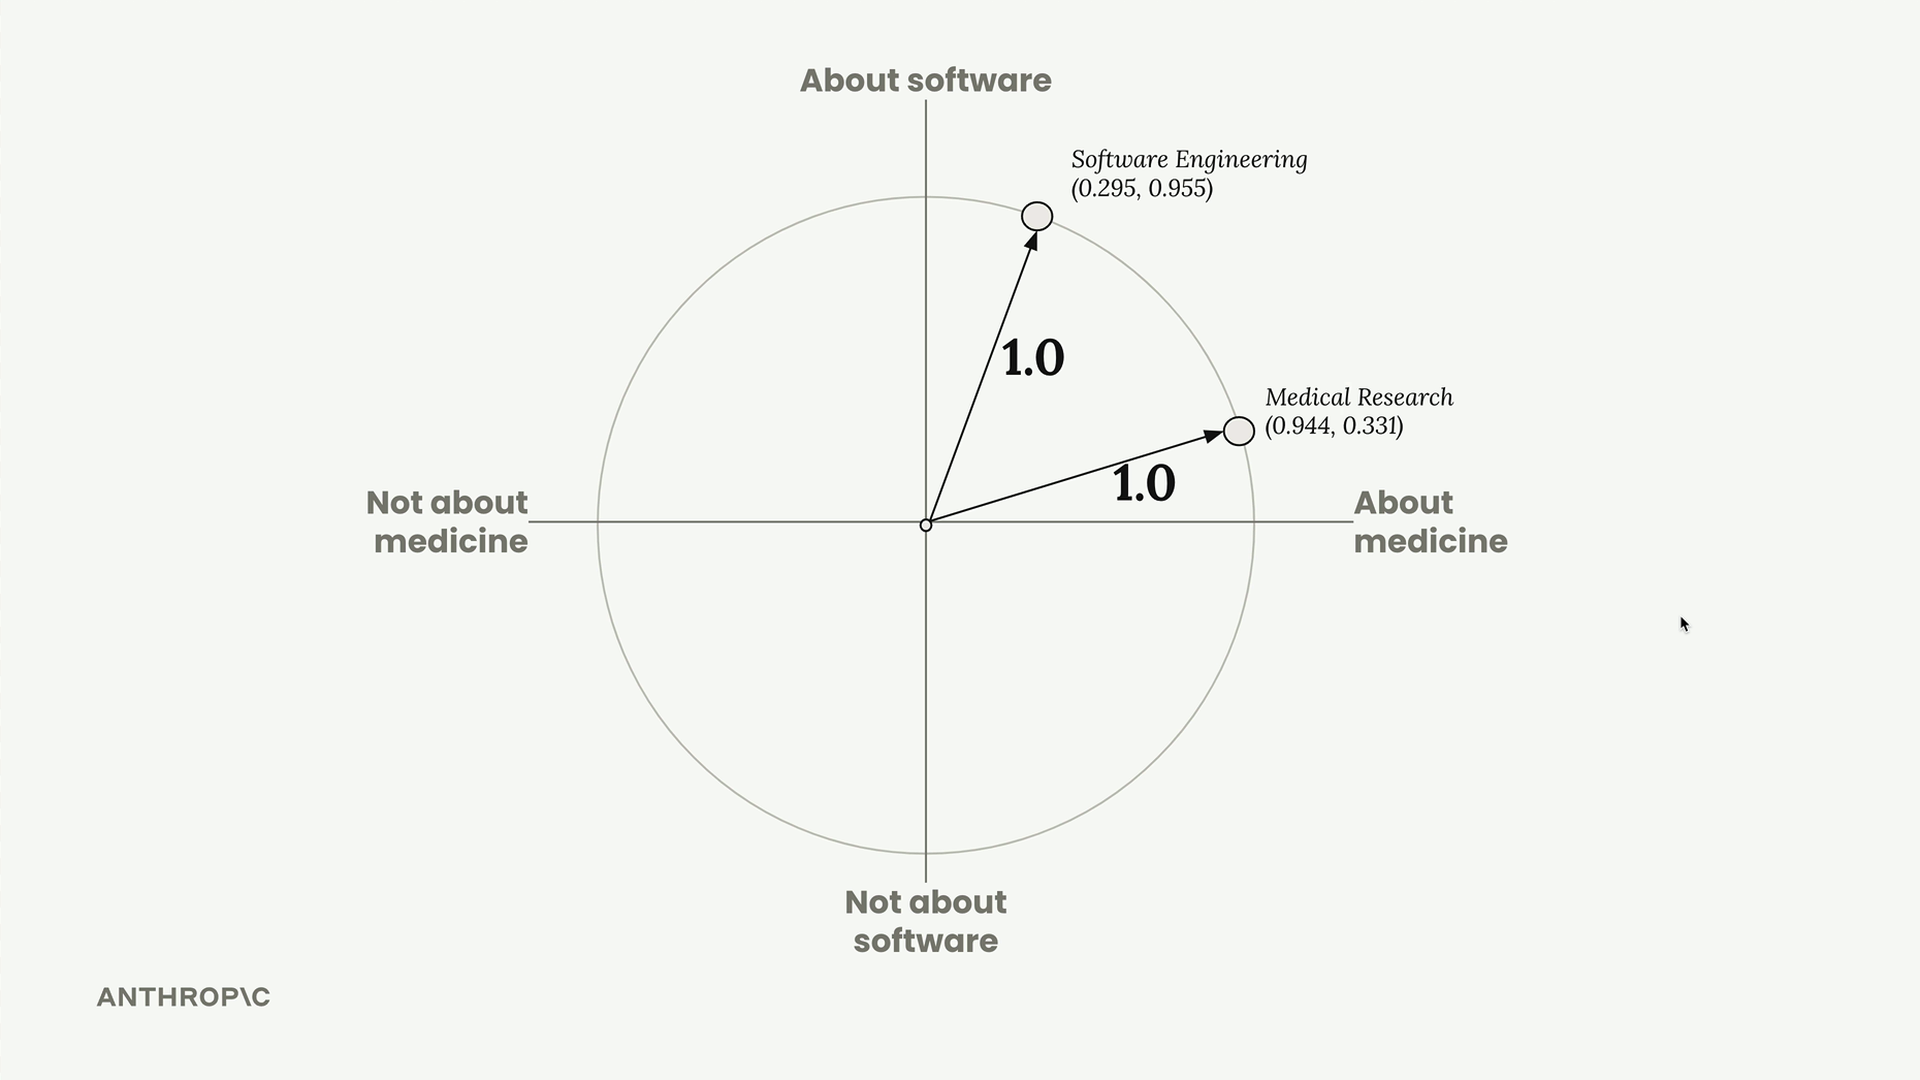
正規化後,我們的嵌入變成 [0.944, 0.331] 和 [0.295, 0.955]。我們可以在單位圓上將這些點視覺化,每個點恰好落在圓的邊緣上。
步驟 3:儲存到向量資料庫
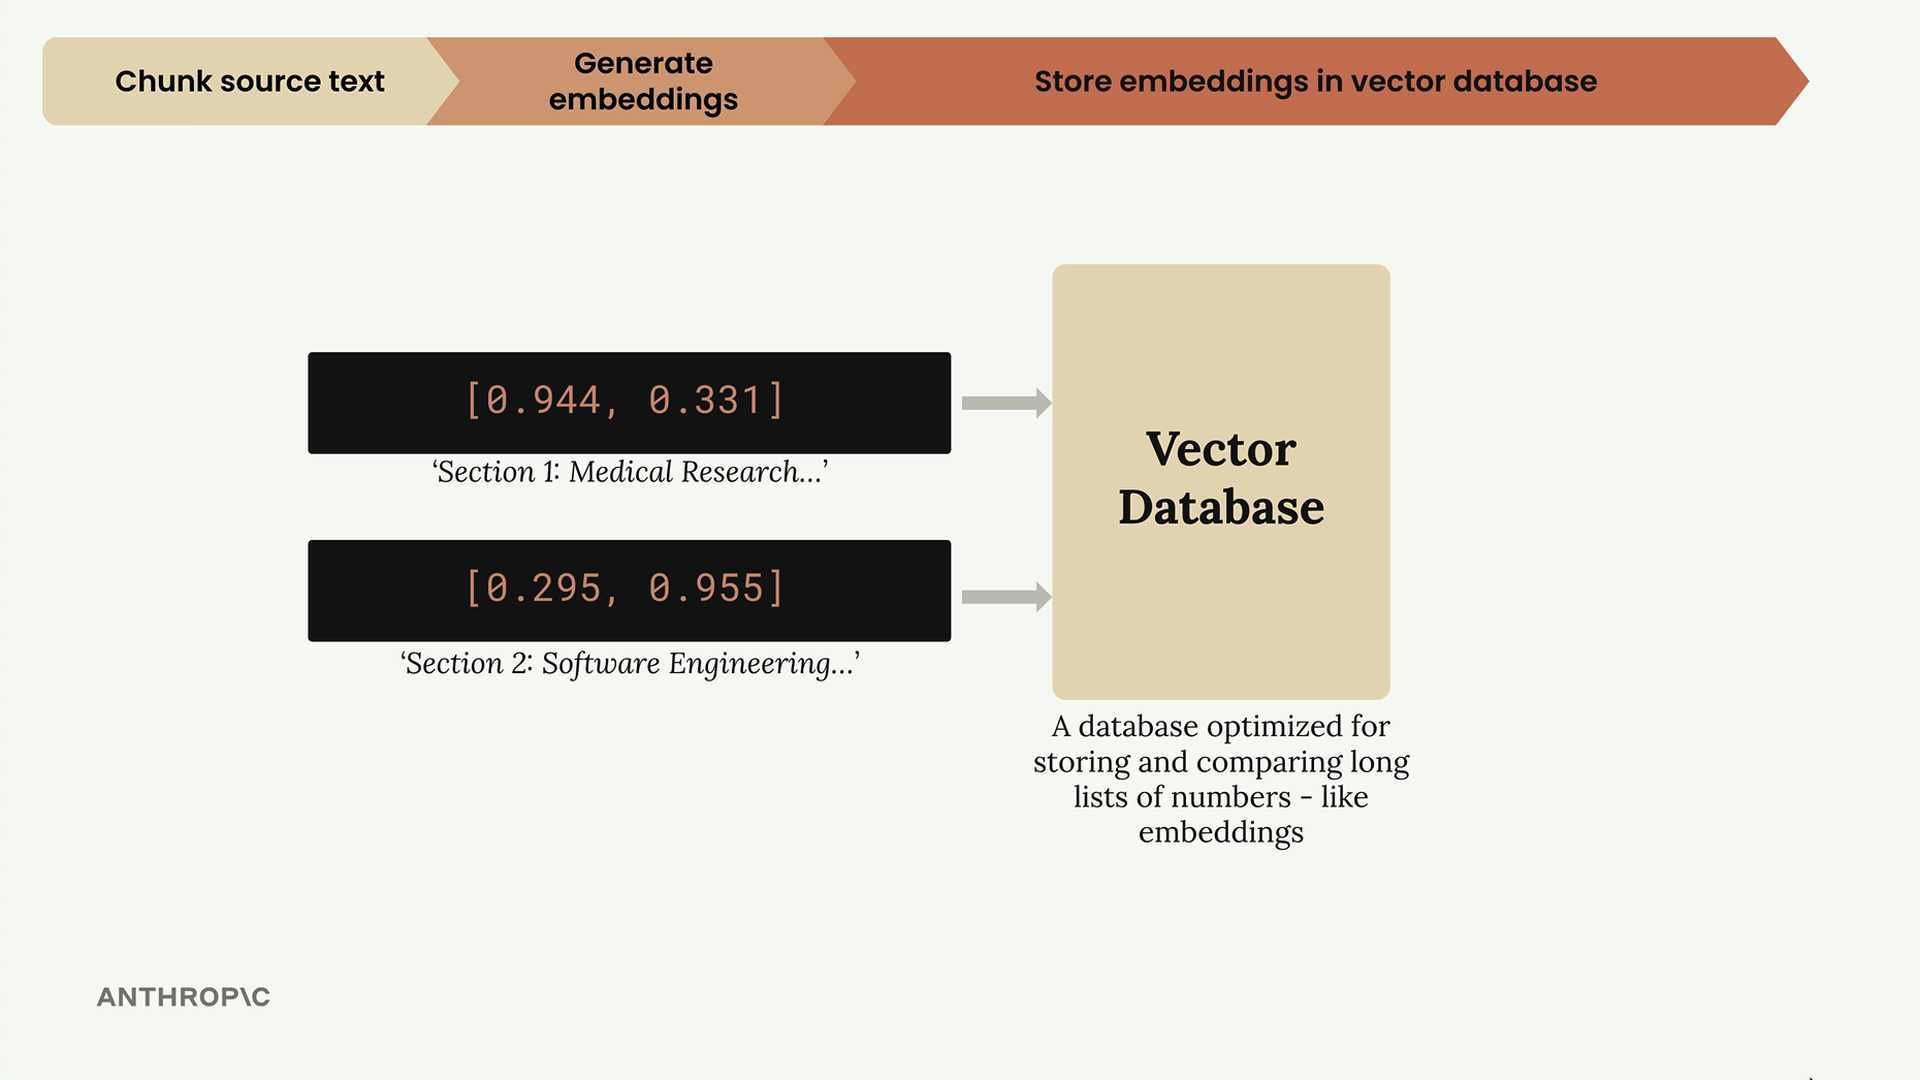
正規化後的嵌入會被儲存到向量資料庫(vector database)中——這是一種專門用於儲存、比較和搜尋像我們嵌入這樣的長串數字列表的資料庫。
到目前為止,我們先暫停一下。到目前為止的所有工作都是提前完成的預處理。現在我們要等待使用者提交查詢。
步驟 4:處理使用者查詢
當使用者提出像「我對這家公司很好奇。特別是,軟體工程部門今年做了什麼?」這樣的問題時,我們會將他們的查詢透過相同的嵌入模型處理。
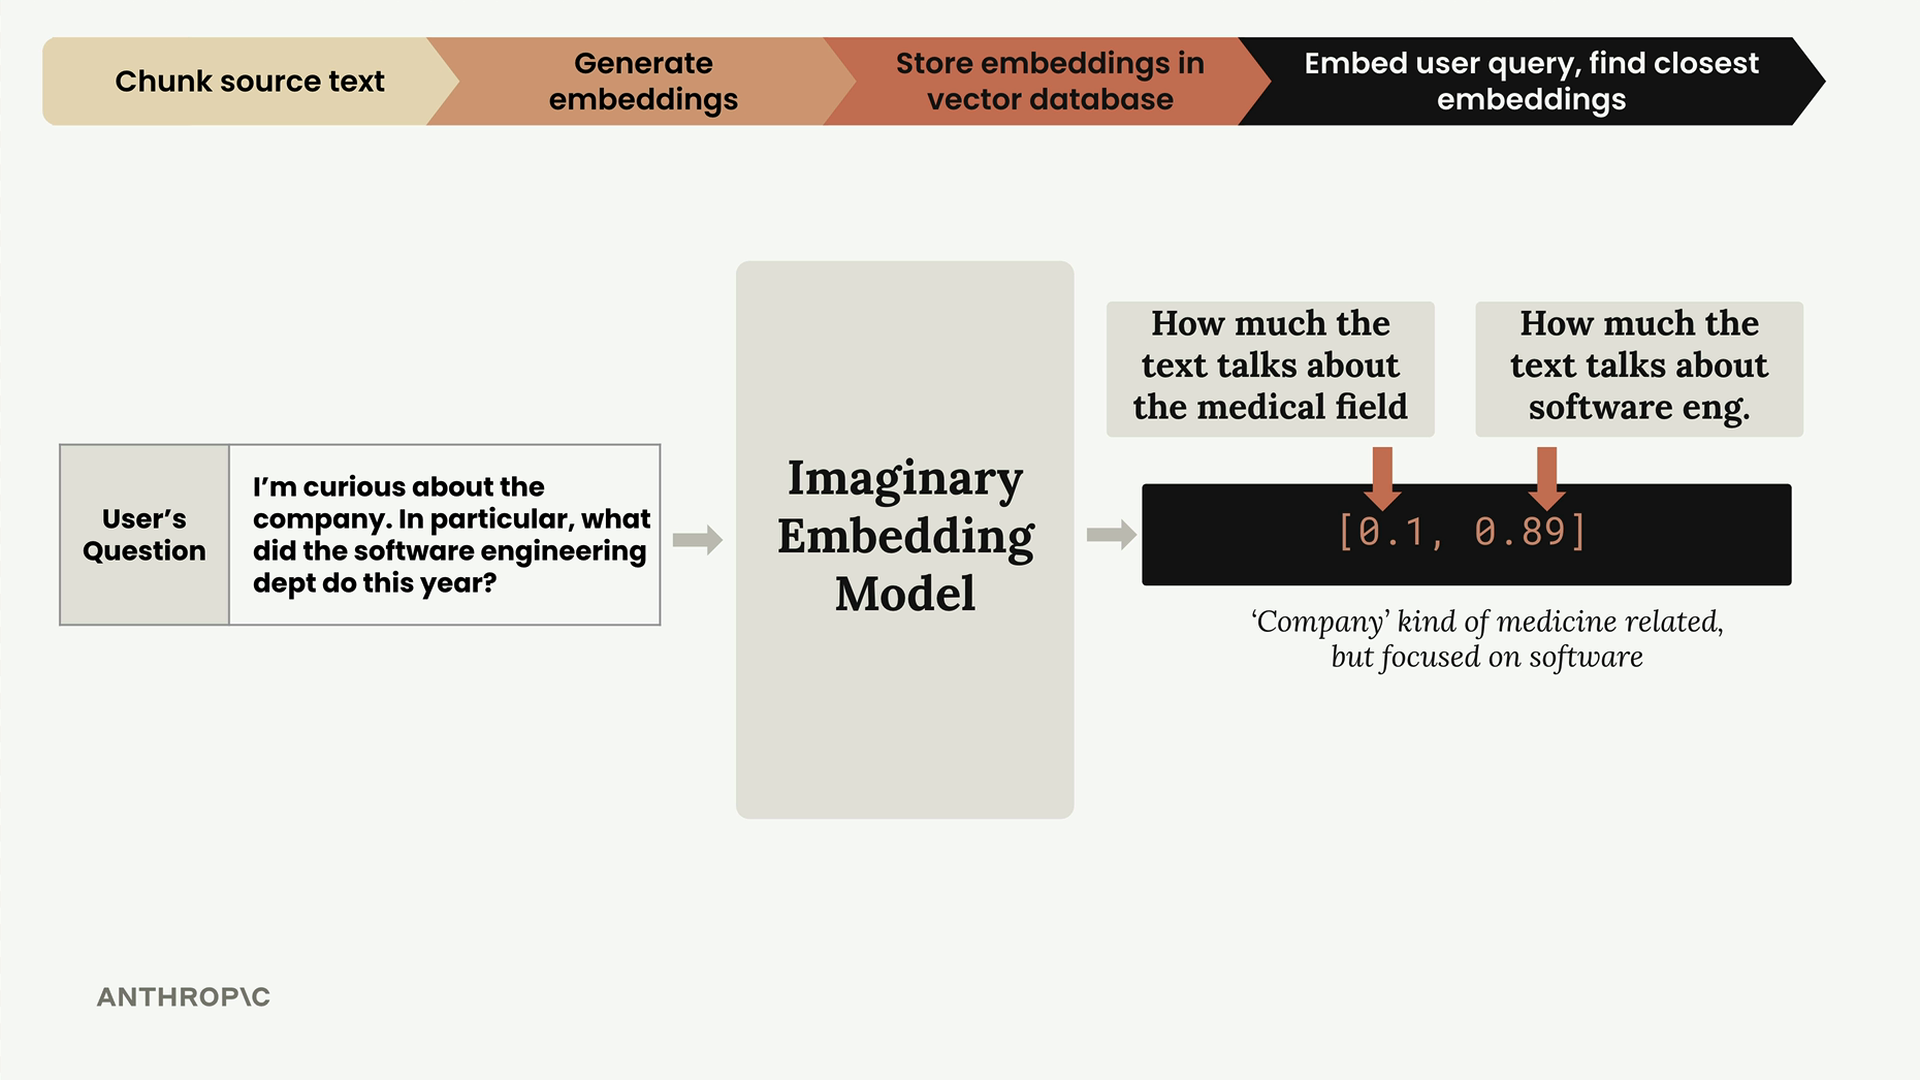
這個查詢被嵌入為 [0.1, 0.89]——醫學分數低,軟體工程分數高。正規化後,它變成 [0.112, 0.993]。
步驟 5:尋找相似的嵌入
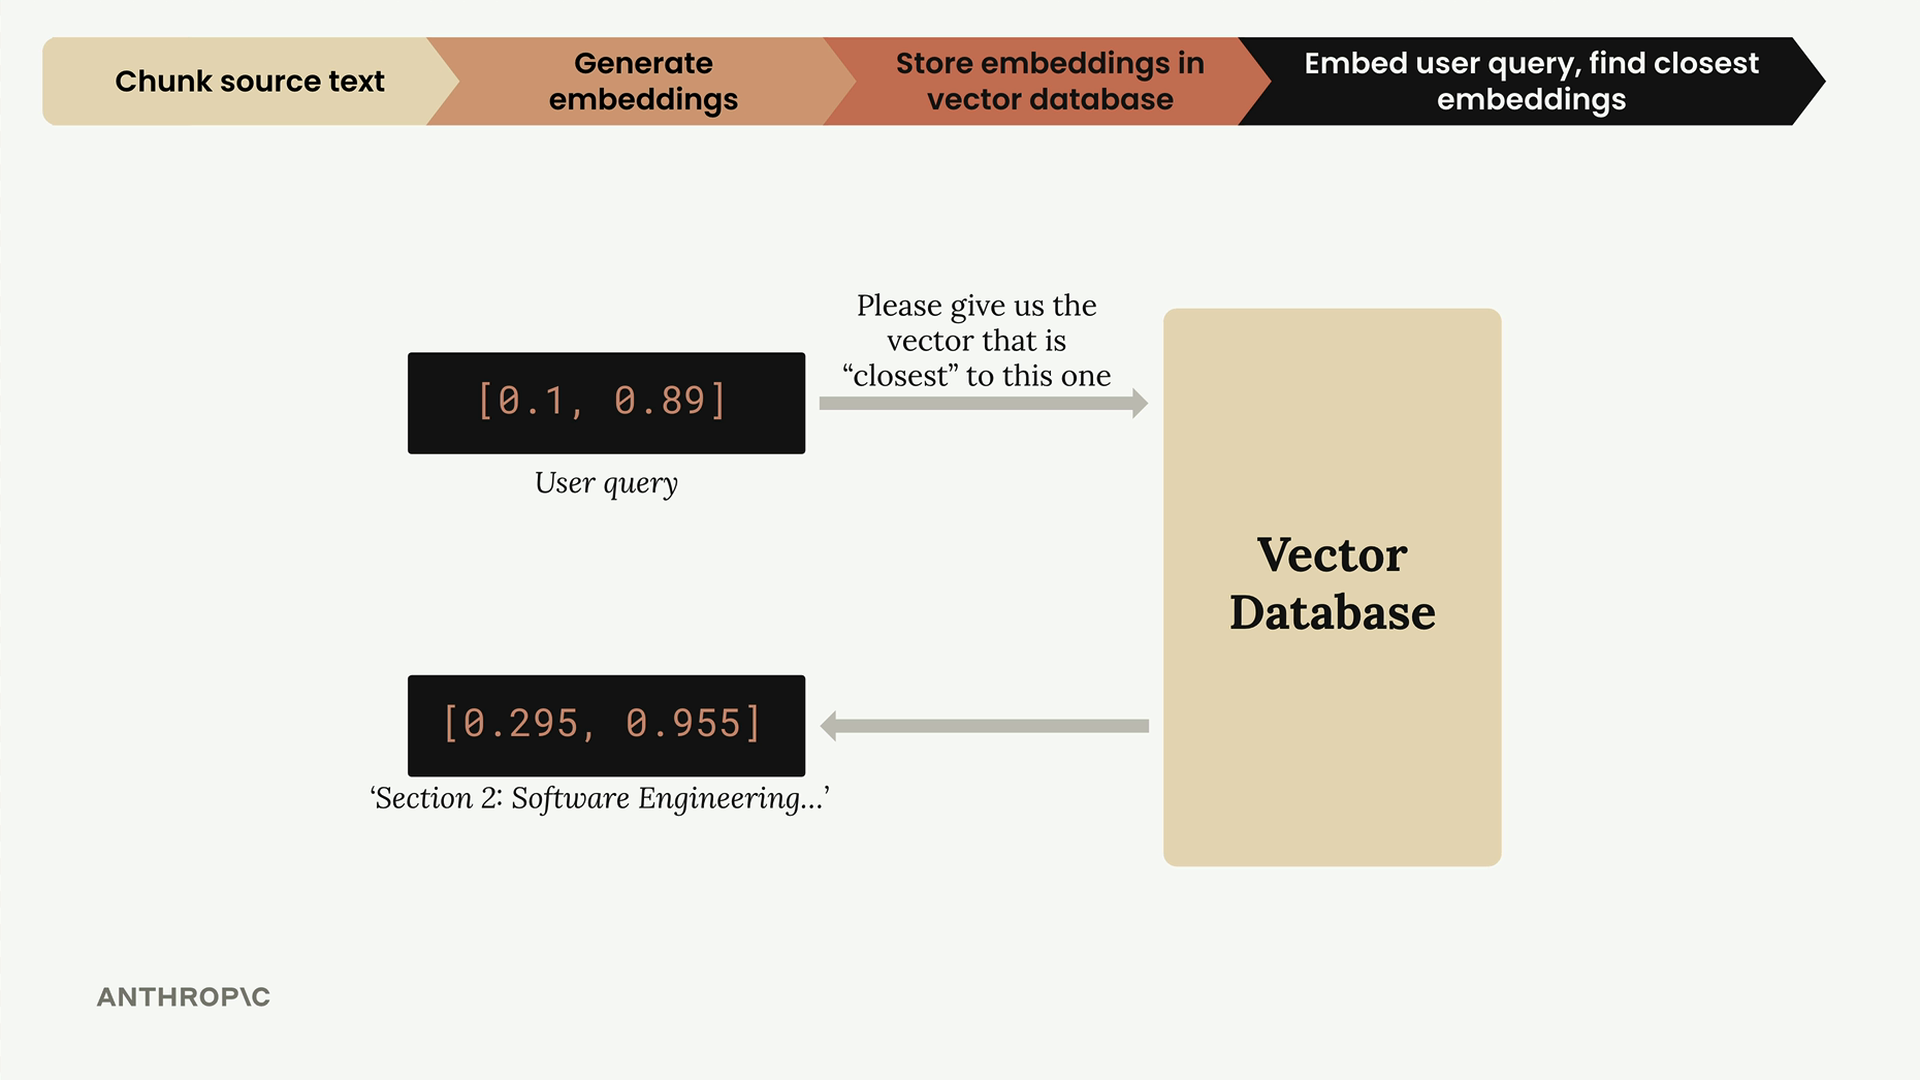
現在我們向向量資料庫詢問:「找出與這個使用者查詢嵌入最接近的已儲存嵌入。」資料庫會回傳軟體工程區段,因為它最相似。
相似性如何運作:餘弦相似度
向量資料庫使用餘弦相似度(cosine similarity)來判斷哪些嵌入最相似。這衡量的是兩個向量之間夾角的餘弦值。
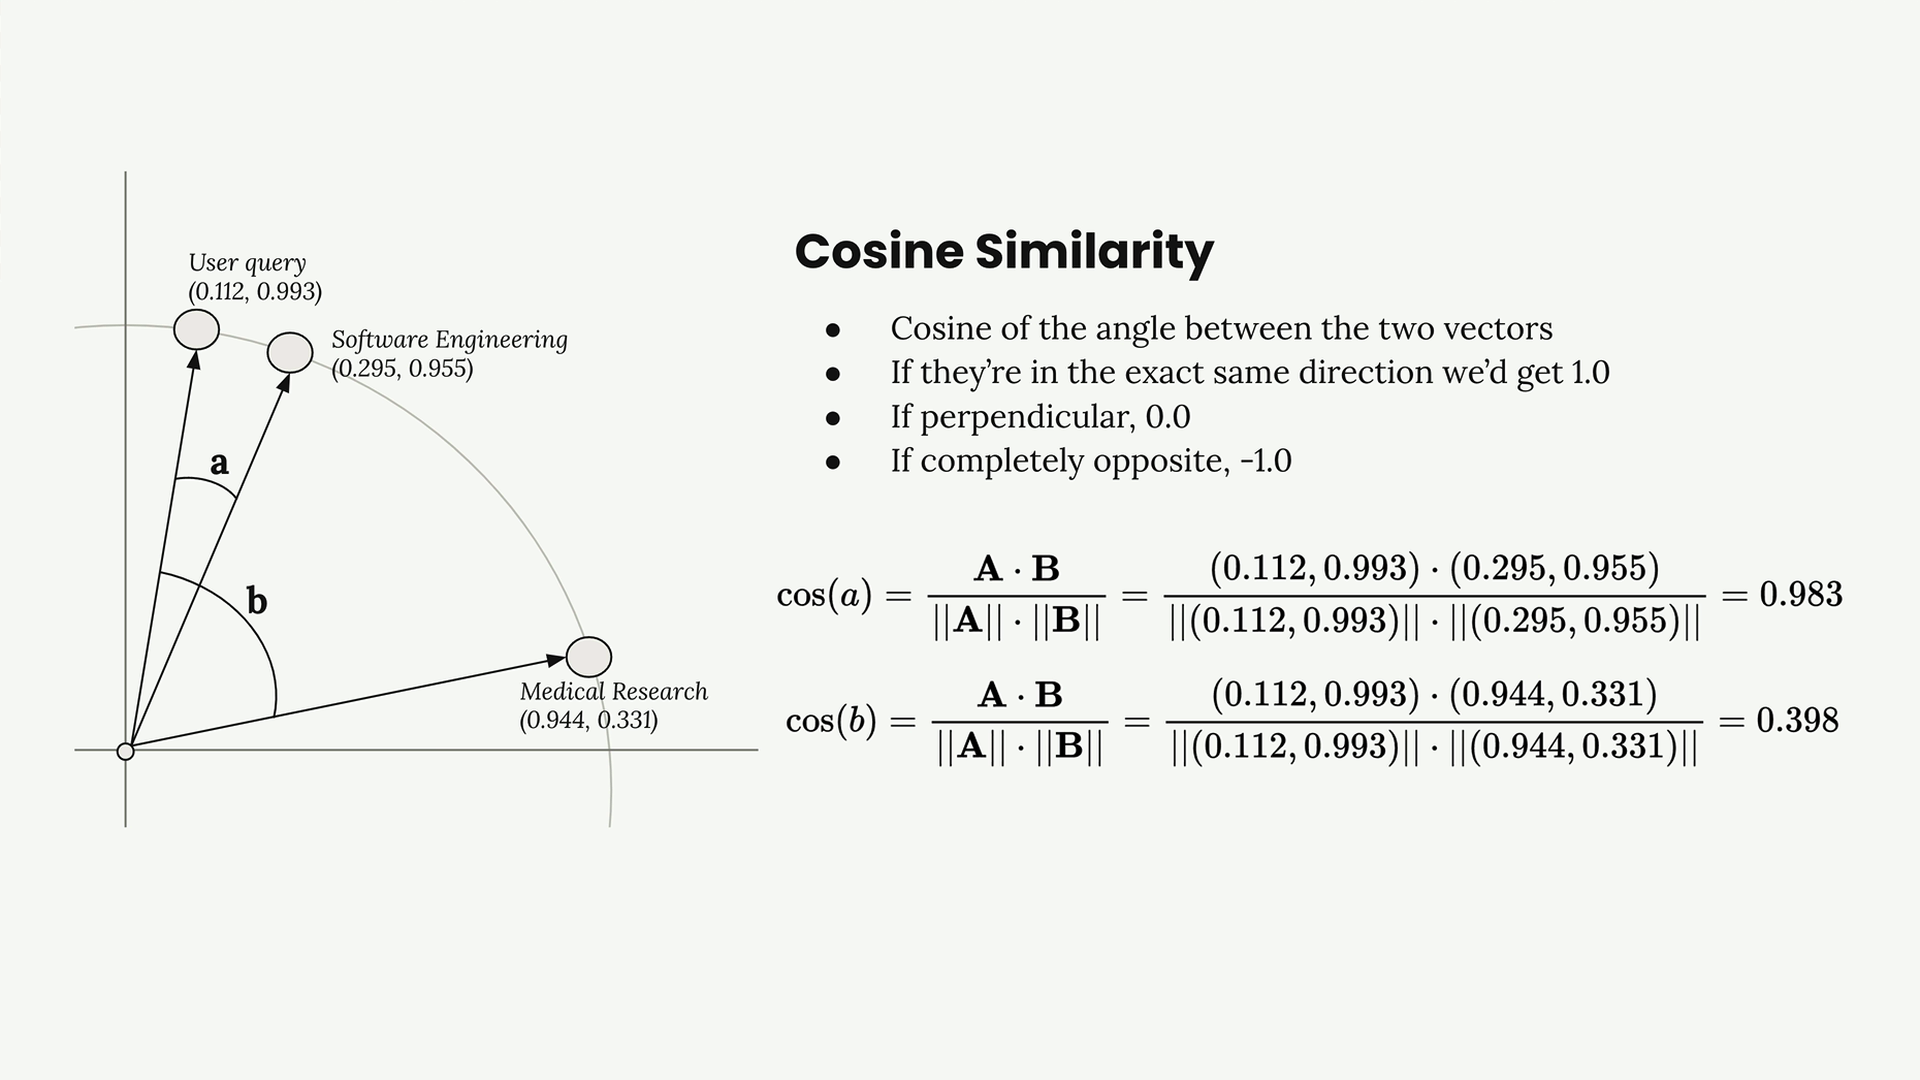
關於餘弦相似度的重點:
- 結果範圍從 -1 到 1
- 接近 1 的值表示非常相似
- 接近 0 的值表示垂直(不相關)
- 接近 -1 的值表示完全相反
計算使用點積公式:cos(a) = (A · B) / (||A|| · ||B||)
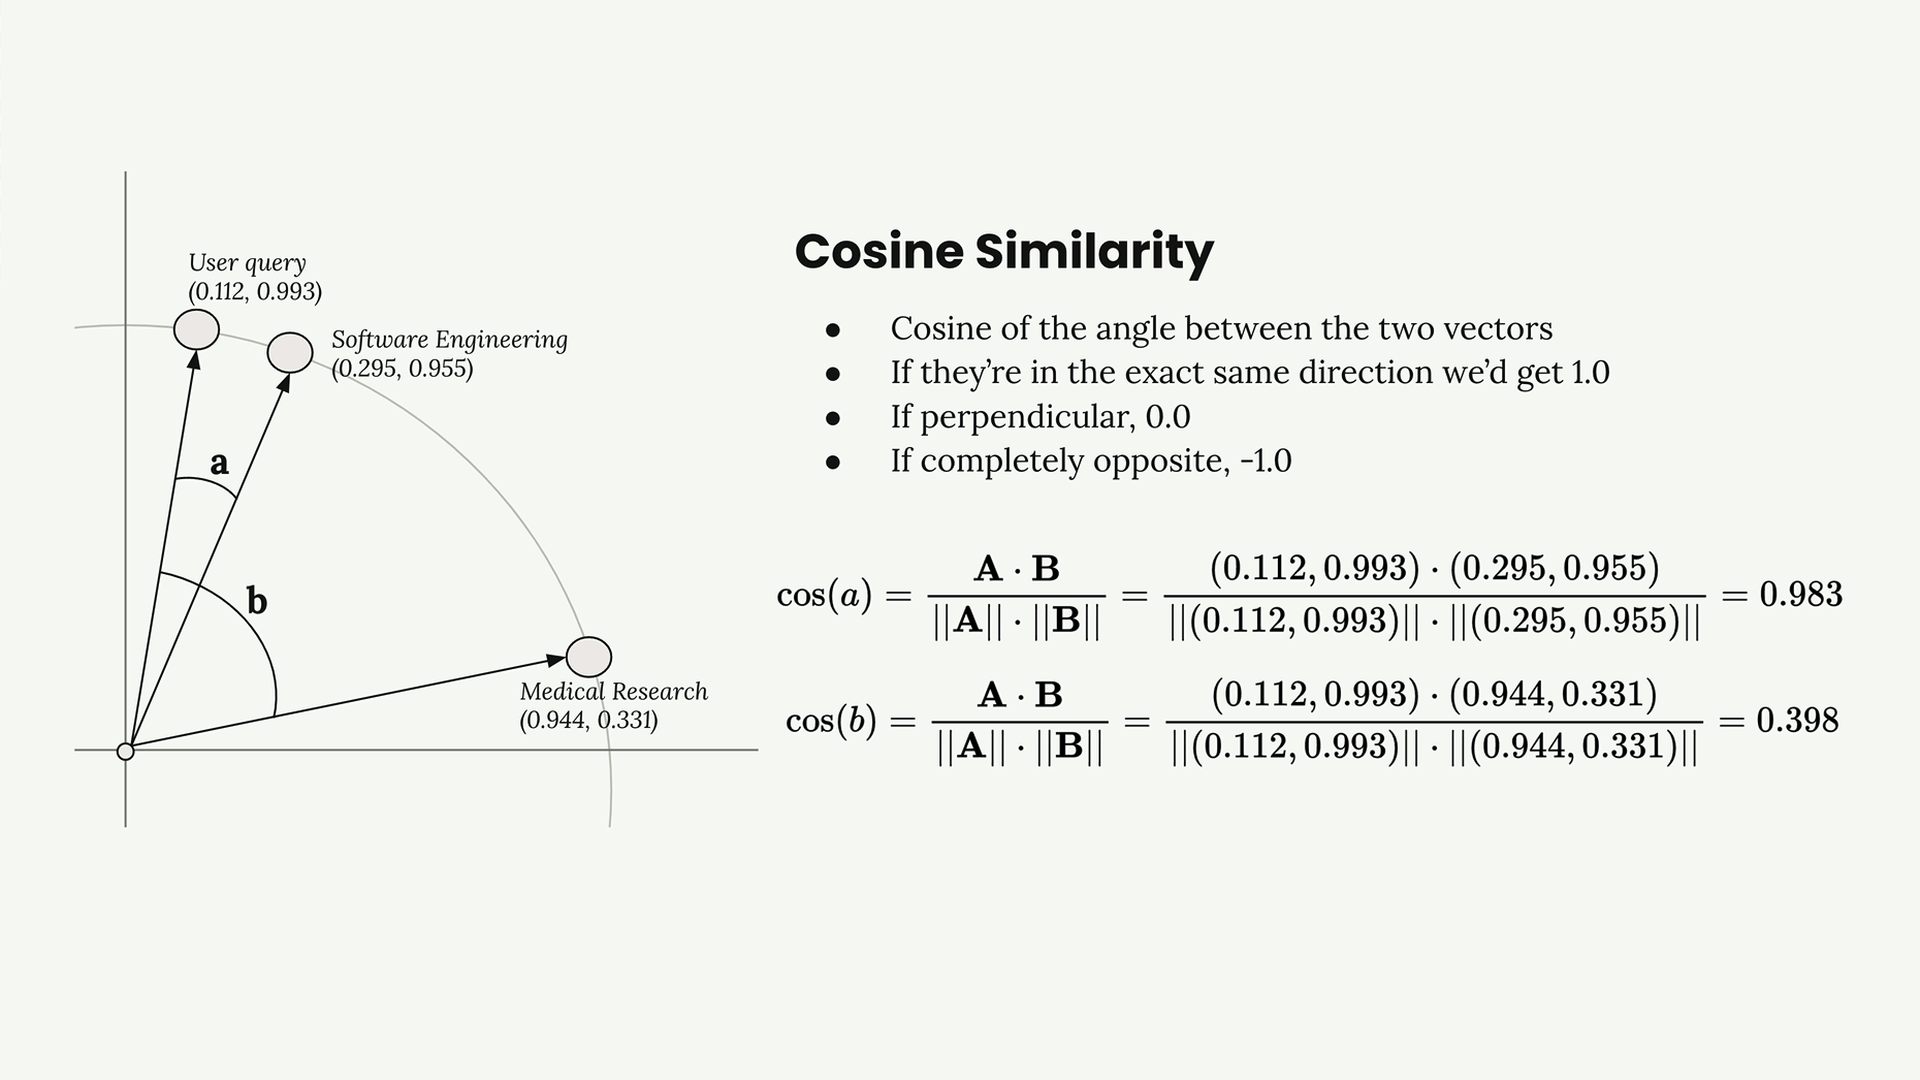
在我們的範例中,使用者查詢與軟體工程區塊的餘弦相似度為 0.983,與醫學研究區塊的餘弦相似度只有 0.398。軟體工程區塊顯然是更好的配對。
餘弦距離
您經常會在向量資料庫的文件中看到「餘弦距離」(cosine distance)。這其實就是 1 - 餘弦相似度,它給我們一個更容易解讀的數字:
- 接近 0 的值表示高相似度
- 較大的值表示較低相似度
步驟 6:建構最終的提示
最後,我們取得使用者的問題和我們找到的最相關文本區塊,將它們組合成給 Claude 的提示:
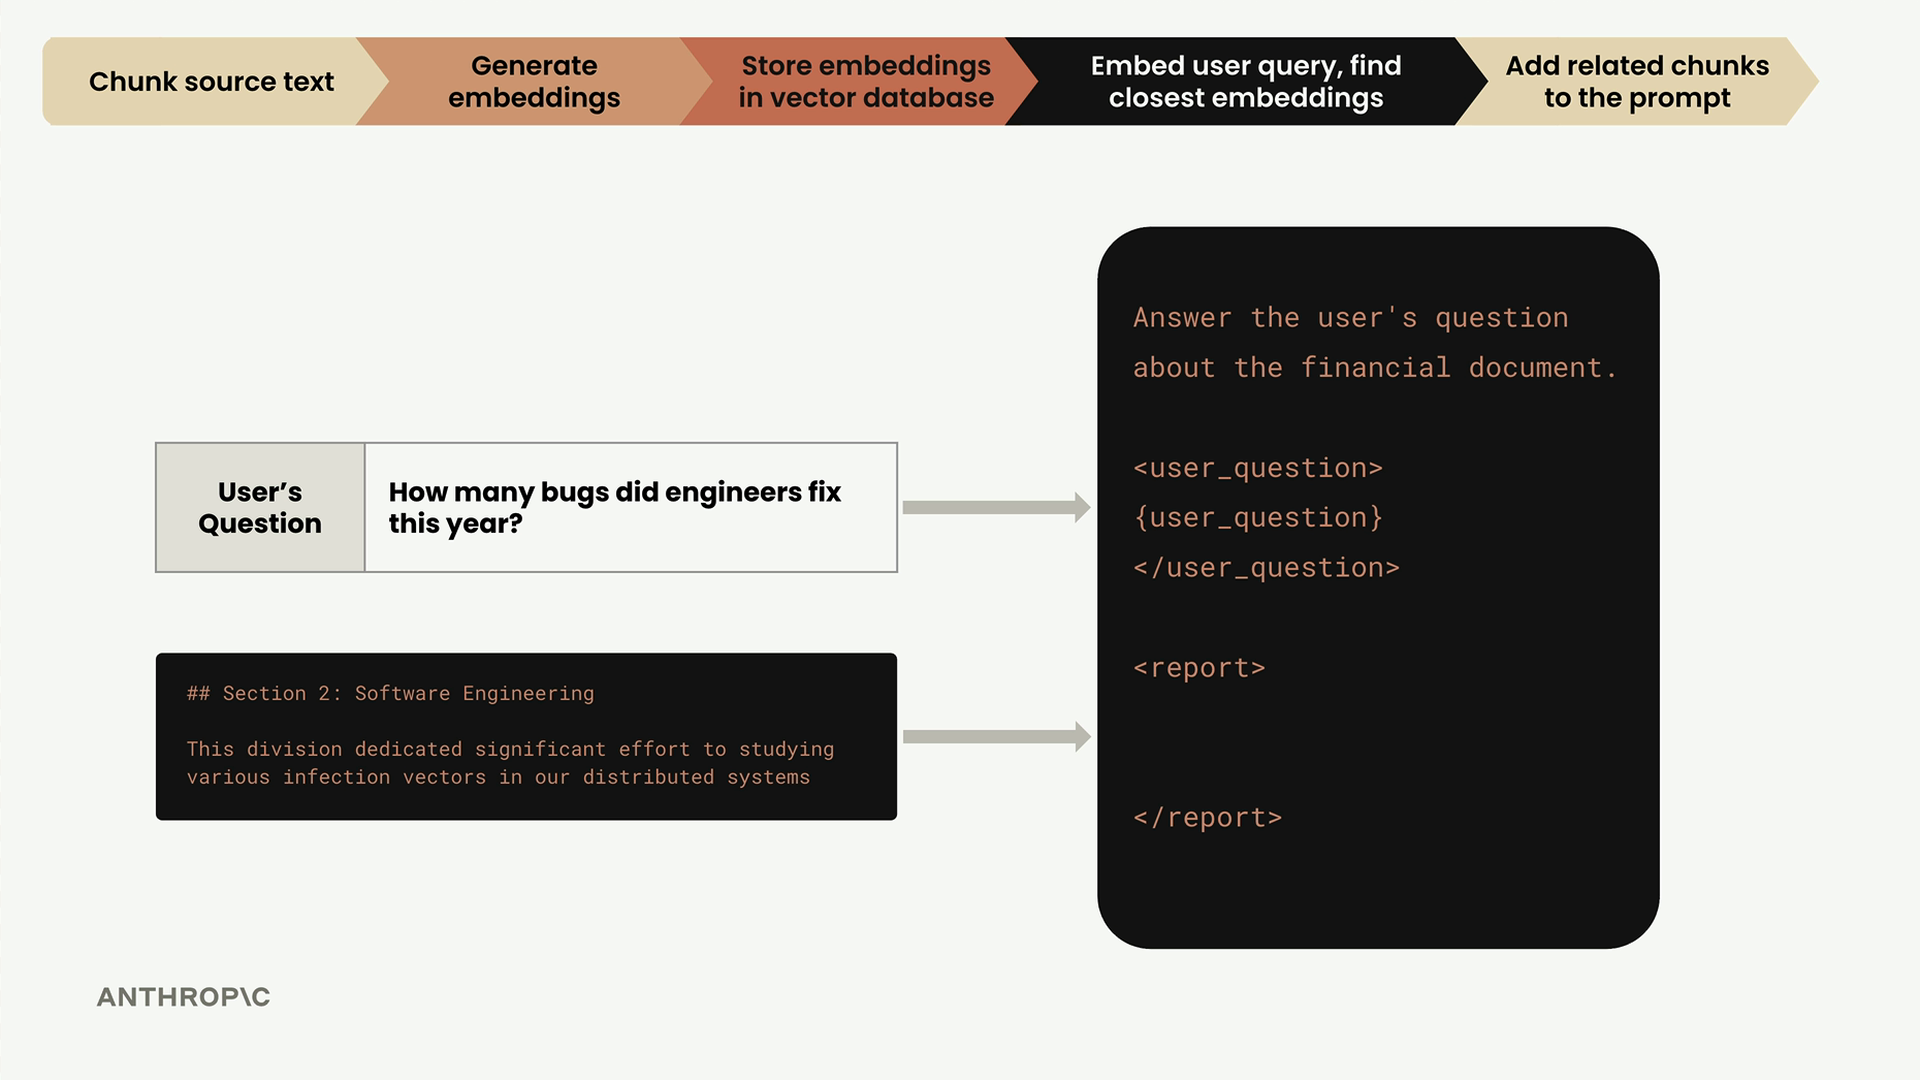
這個提示同時包含使用者的問題以及來自我們文件的相關脈絡,讓 Claude 能夠根據我們知識庫中的特定資訊提供有根據的回答。
完整流程
這就是從頭到尾完整的 RAG 流程:
- 將來源文件分塊
- 為每個區塊生成嵌入
- 將嵌入儲存到向量資料庫
- 當使用者提出問題時,嵌入他們的查詢
- 使用餘弦相似度找出最相似的已儲存嵌入
- 將相關區塊與使用者的問題一起加入提示
- 將增強後的提示送給 Claude 以取得回應
理解這個過程及其背後的數學原理,將有助於您有效地使用向量資料庫,並在您的 RAG 系統未返回預期結果時進行除錯。