情境檢索(Contextual retrieval)是一種技術,透過解決一個根本性問題來提升 RAG 管線的準確性:當您將文件拆分成區塊時,每個區塊都會失去與更廣泛文件情境的連結。
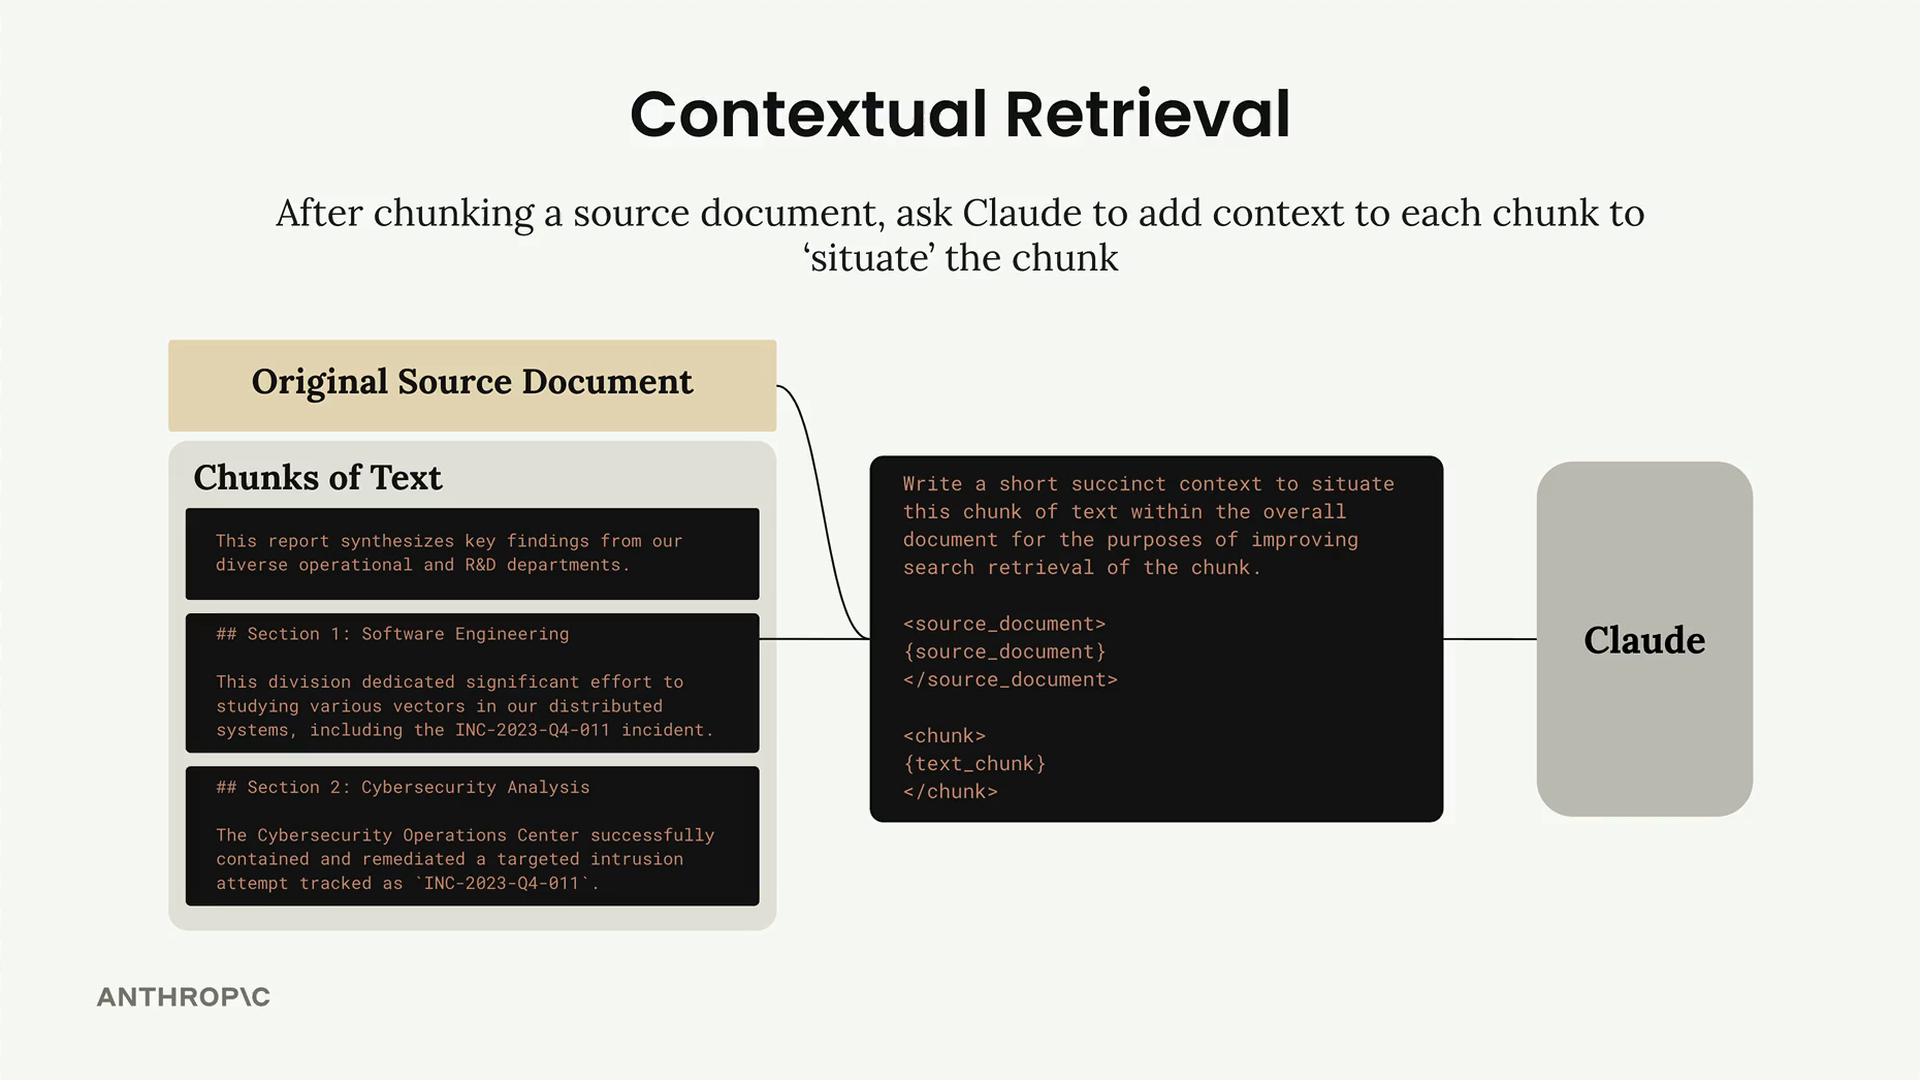
基本概念很簡單。在將您的來源文件分塊之後,您要求 Claude 在將每個區塊儲存到檢索器資料庫之前,先為其新增情境。這個預處理步驟有助於將每個區塊「定位」在更大的文件中。
運作方式
對於每個文字區塊,您會將該區塊與原始來源文件一併傳送給 Claude,並搭配如下的提示:
Write a short and succinct snippet of text to situate this chunk within the
overall source document for the purposes of improving search retrieval of the chunk.

Here is the original source document:
<document>
{source_text}
</document>

Here is the chunk we want to situate within the whole document:
<chunk>
{text_chunk}
</chunk>

Answer only with the succinct context and nothing else.Claude 可能會產生類似這樣的情境:「這個段落來自一份關於跨學科團隊的較大報告。其中提及 INC-2023-04-011,這在網路安全分析(Cybersecurity Analysis)章節中也曾被提及。」
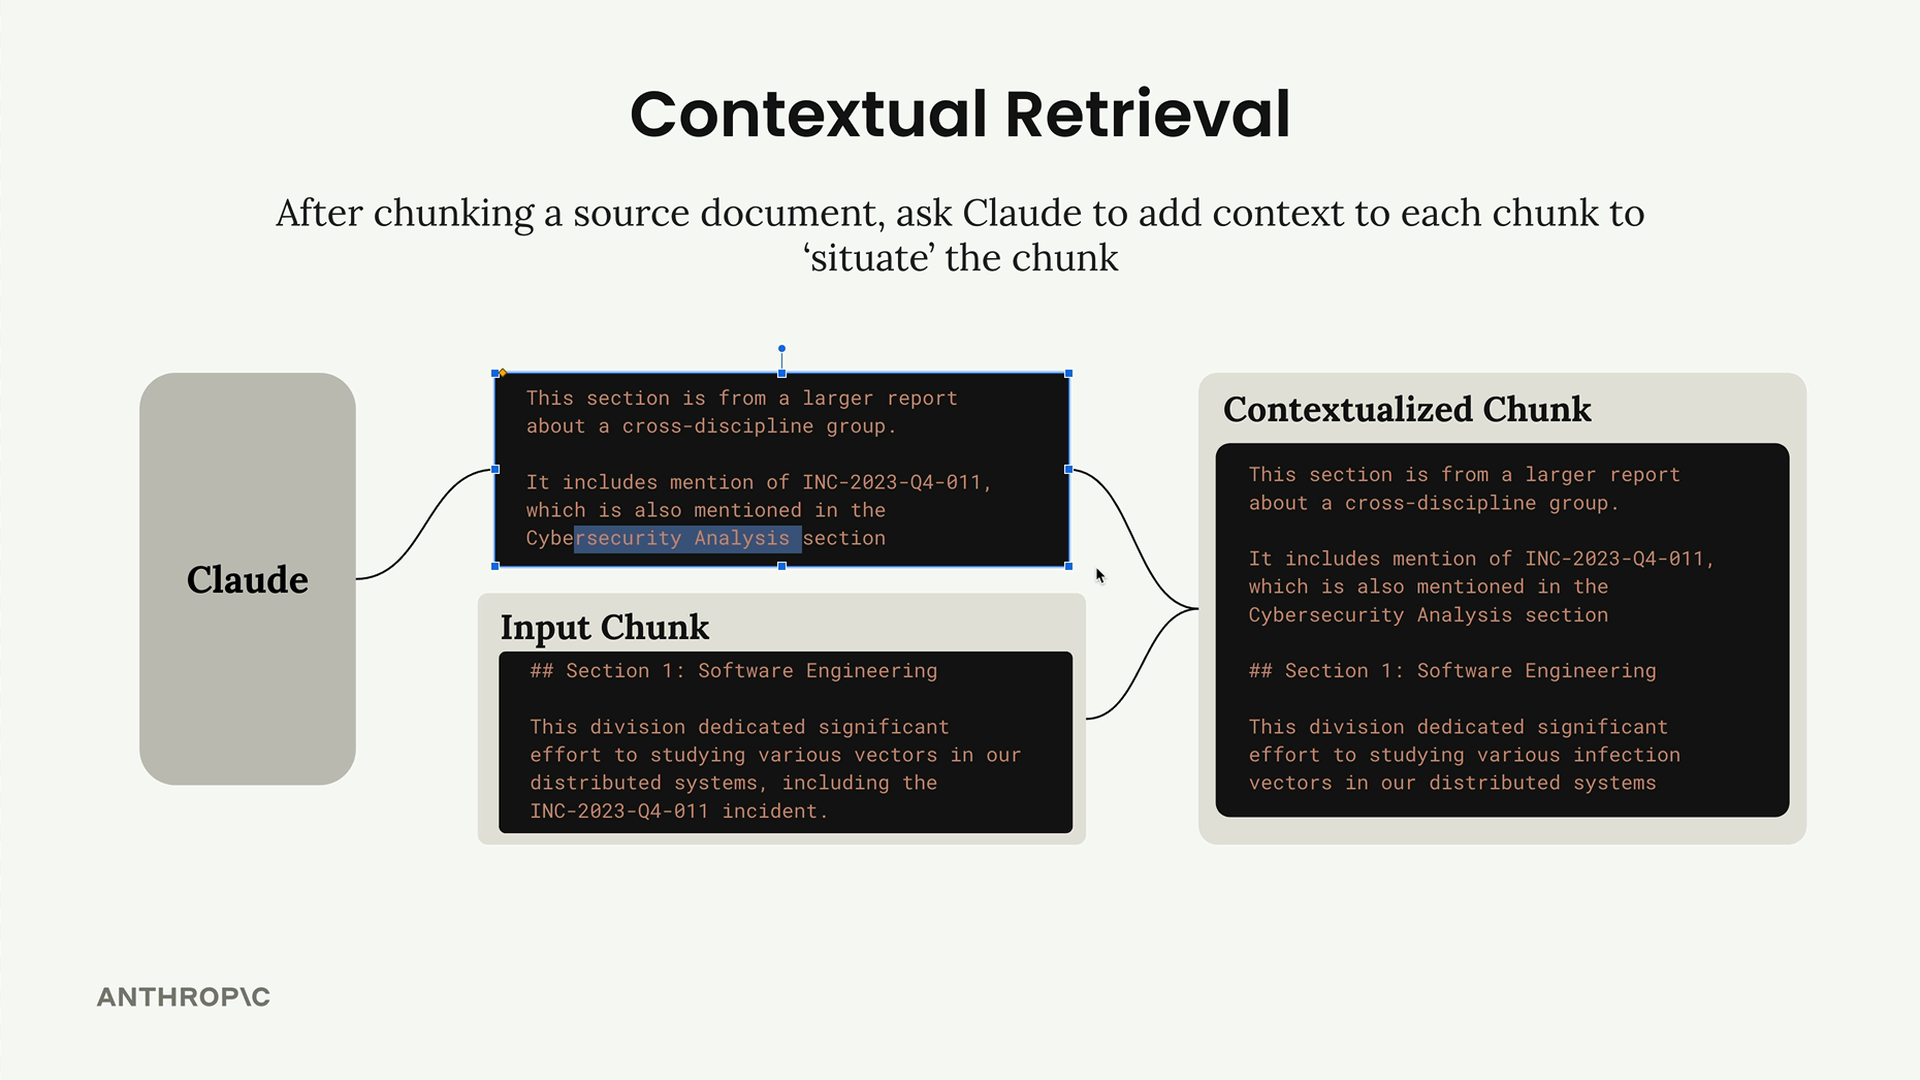
接著,您將這段生成的情境與原始區塊文字結合,建立一個「情境化區塊」(contextualized chunk),並將其儲存到您的向量索引和 BM25 索引中。
處理大型文件
如果您的來源文件太大,無法放入單一提示中,您可以提供一組縮減後的情境,而非整份文件。
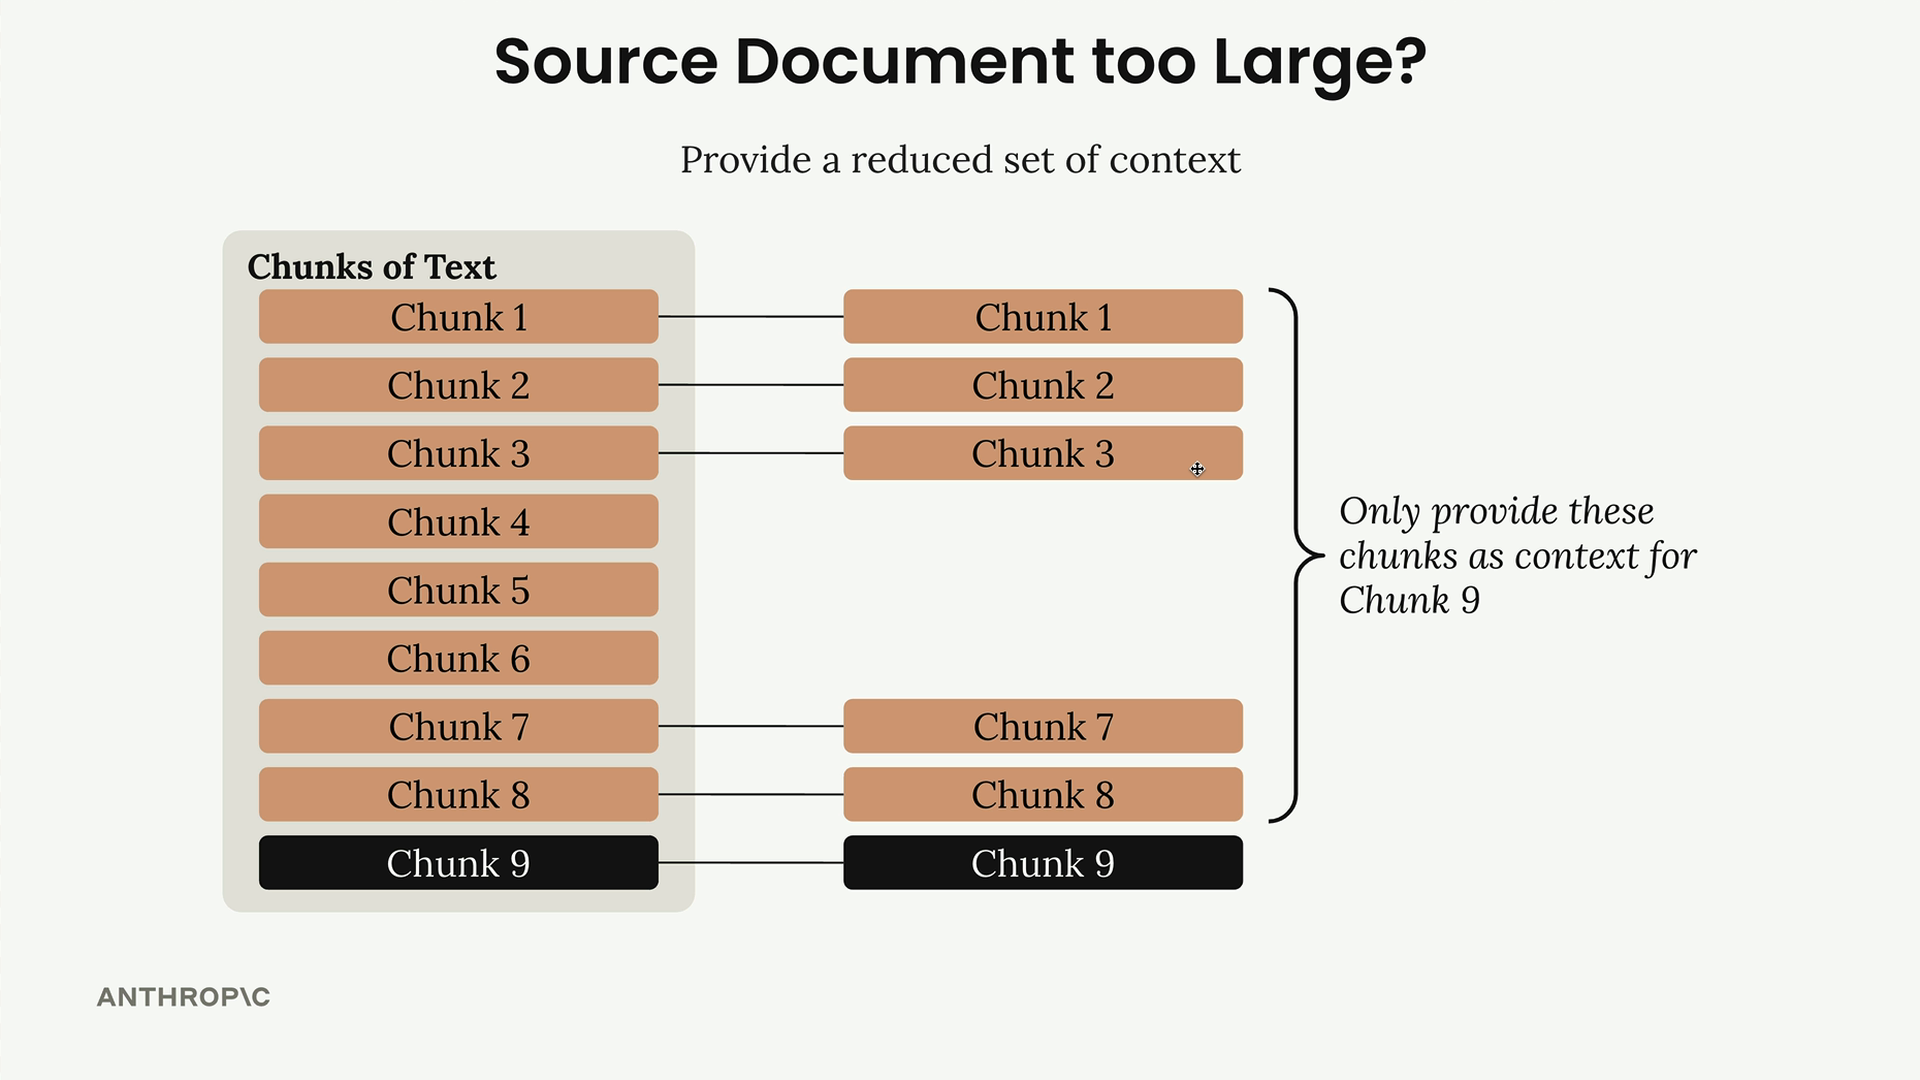
對於您正在進行情境化的任何區塊,請包含:
- 文件開頭的幾個區塊(通常包含摘要或概述)
- 緊接在目標區塊之前的區塊(提供局部情境)
這種方法為 Claude 提供了足夠的資訊來產生有意義的情境,同時又不會讓整份文件壓垮提示。
實作範例
以下是情境檢索函式的基本實作:
def add_context(text_chunk, source_text):
    prompt = f"""
    Write a short and succinct snippet of text to situate this chunk within the
    overall source document for the purposes of improving search retrieval of the chunk.

    Here is the original source document:
    <document>
    {source_text}
    </document>

    Here is the chunk we want to situate within the whole document:
    <chunk>
    {text_chunk}
    </chunk>

    Answer only with the succinct context and nothing else.
    """

    messages = []
    add_user_message(messages, prompt)
    result = chat(messages)

    return result["text"] + "\n" + text_chunk
在處理您的文件區塊時,您會逐一迴圈遍歷每個區塊,並產生情境化的版本:
# 為每個區塊加入上下文,然後加入至 retriever
for i, chunk in enumerate(chunks):
    # 從起始區塊與前面的區塊建立上下文
    context_parts = []
    context_parts.extend(chunks[:min(num_start_chunks, len(chunks))])

    start_idx = max(0, i - num_prev_chunks)
    context_parts.extend(chunks[start_idx:i])

    context = "\n".join(context_parts)

    contextualized_chunk = add_context(chunk, context)
    retriever.add_document({"content": contextualized_chunk})
預期結果
生成的情境提供了有關文件結構與關係的寶貴資訊。舉例來說,Claude 可能會將某個區塊描述為「年度跨學科研究審查報告的第 2 節,詳述軟體工程工作以解決鳳凰計畫(Project Phoenix)中的穩定性問題。此節緊接於方法論章節之後,並先於財務分析章節,構成涵蓋組織內十個研究領域的綜合報告的一部分。」
這些額外的情境有助於檢索系統不僅了解每個區塊包含什麼內容,還能了解它如何融入更大的文件結構,以及與其他章節之間的關聯。雖然對於簡單的文件,您可能不會看到顯著的改善,但隨著文件變得更加複雜,涉及章節之間錯綜複雜的交叉引用與相依關係,情境檢索的價值會愈來愈高。