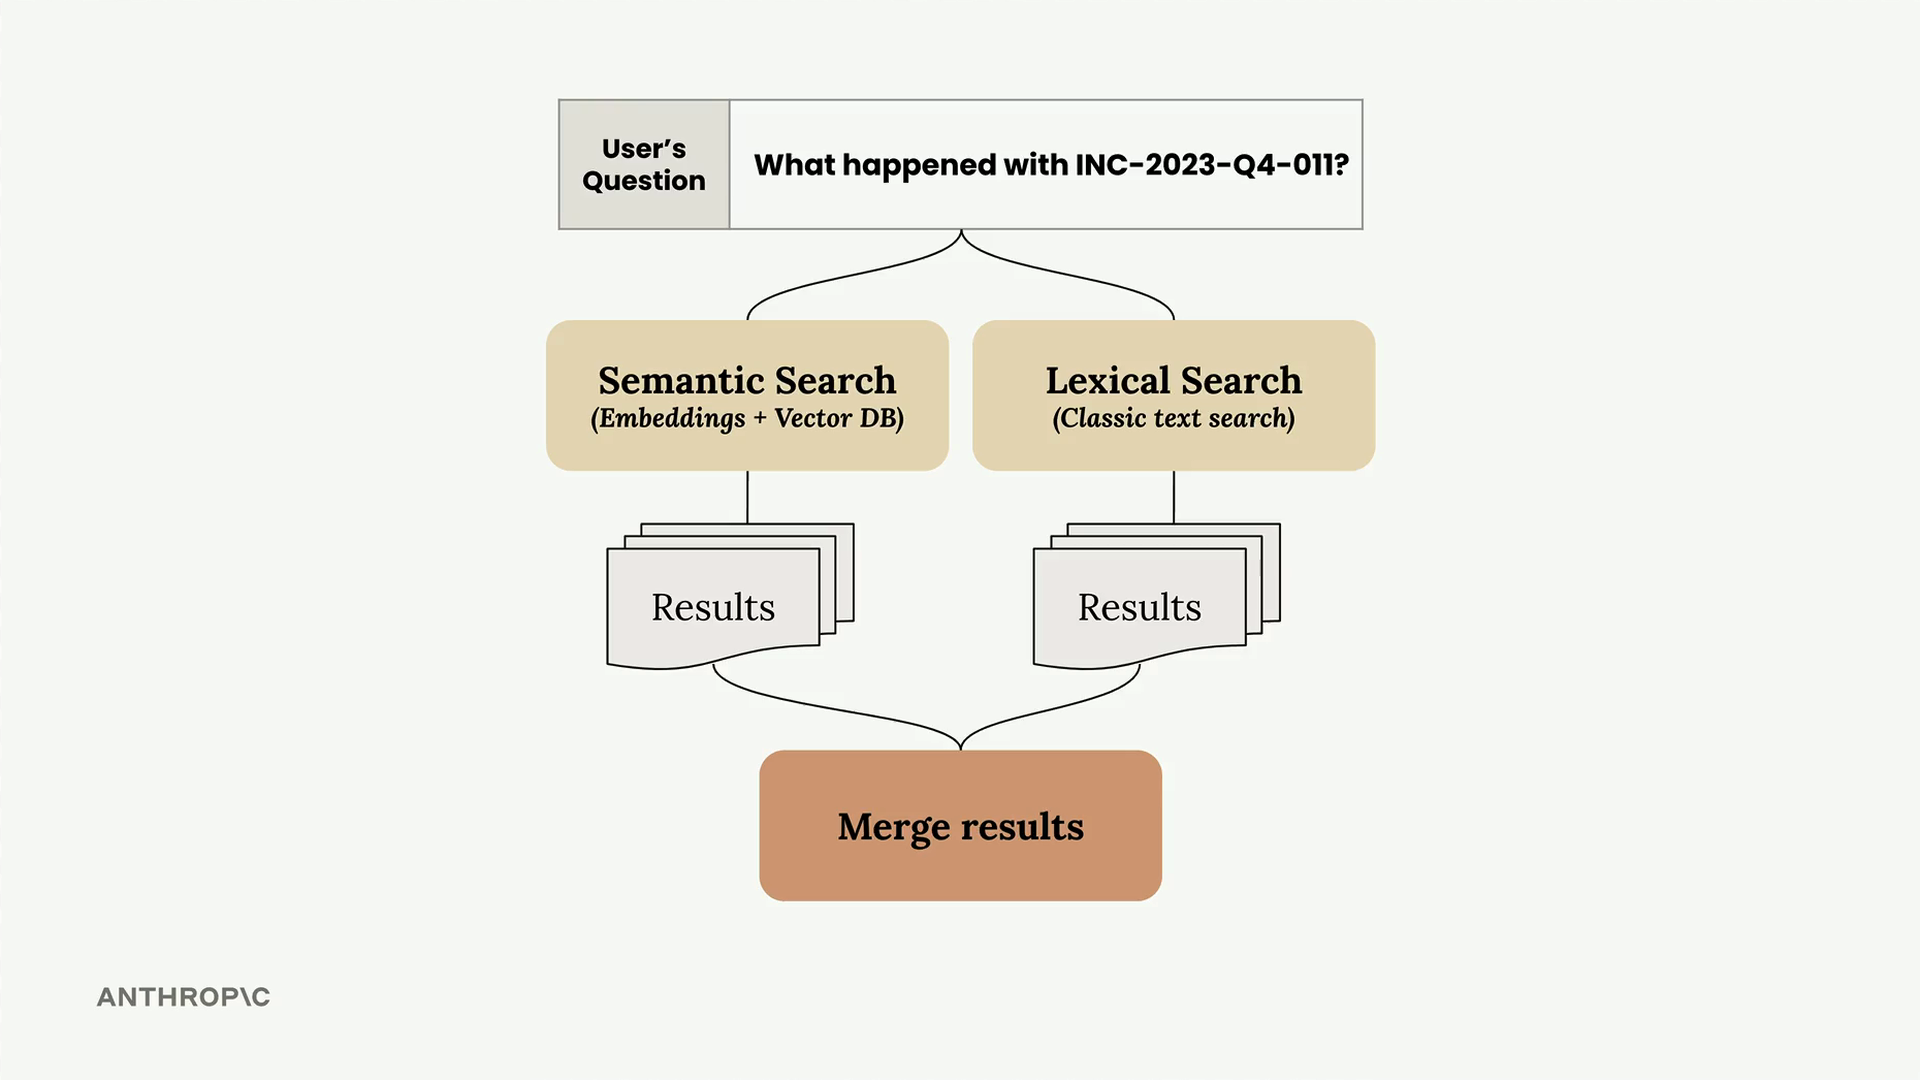
當您同時擁有獨立運作的語意搜尋(向量嵌入)和詞彙搜尋(BM25)時,下一步就是將它們結合成統一的搜尋管線。這種混合方法能充分利用兩種方法的優勢,提供更準確的結果。
建立統一介面
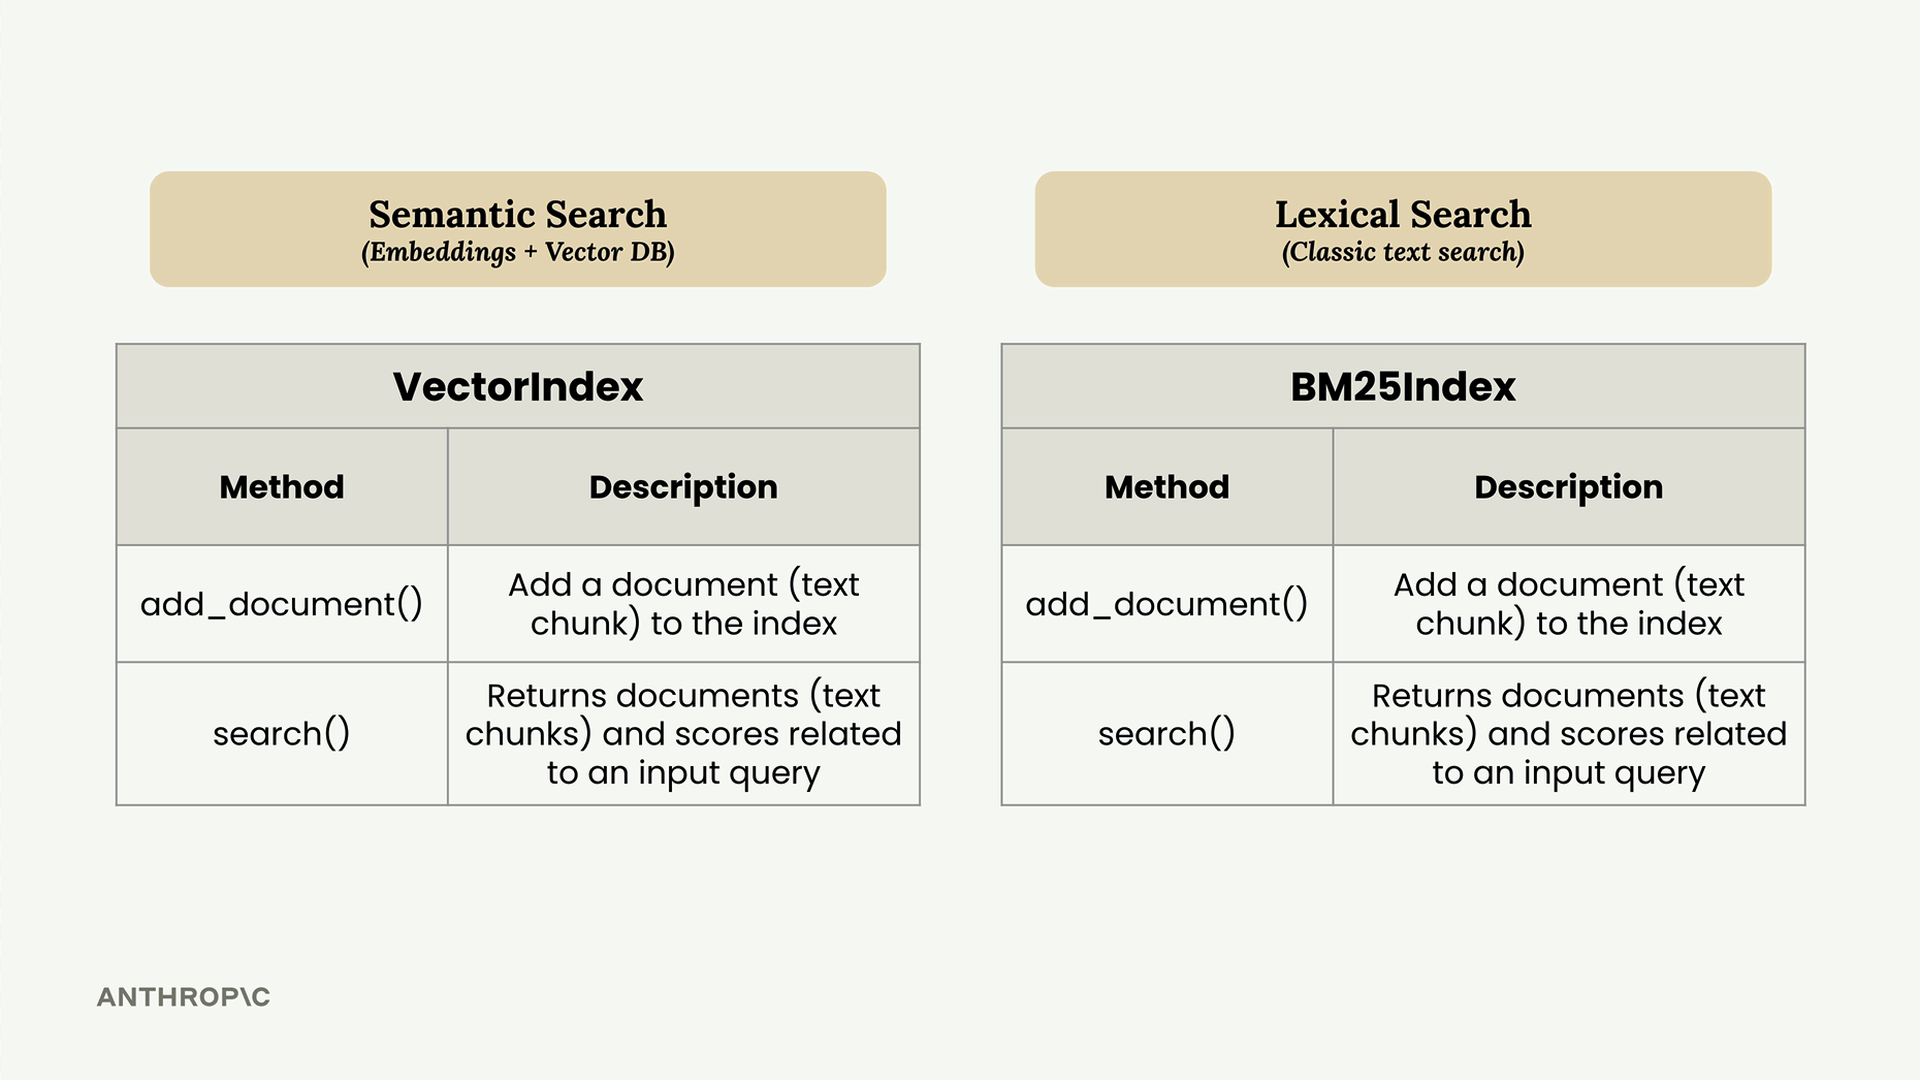
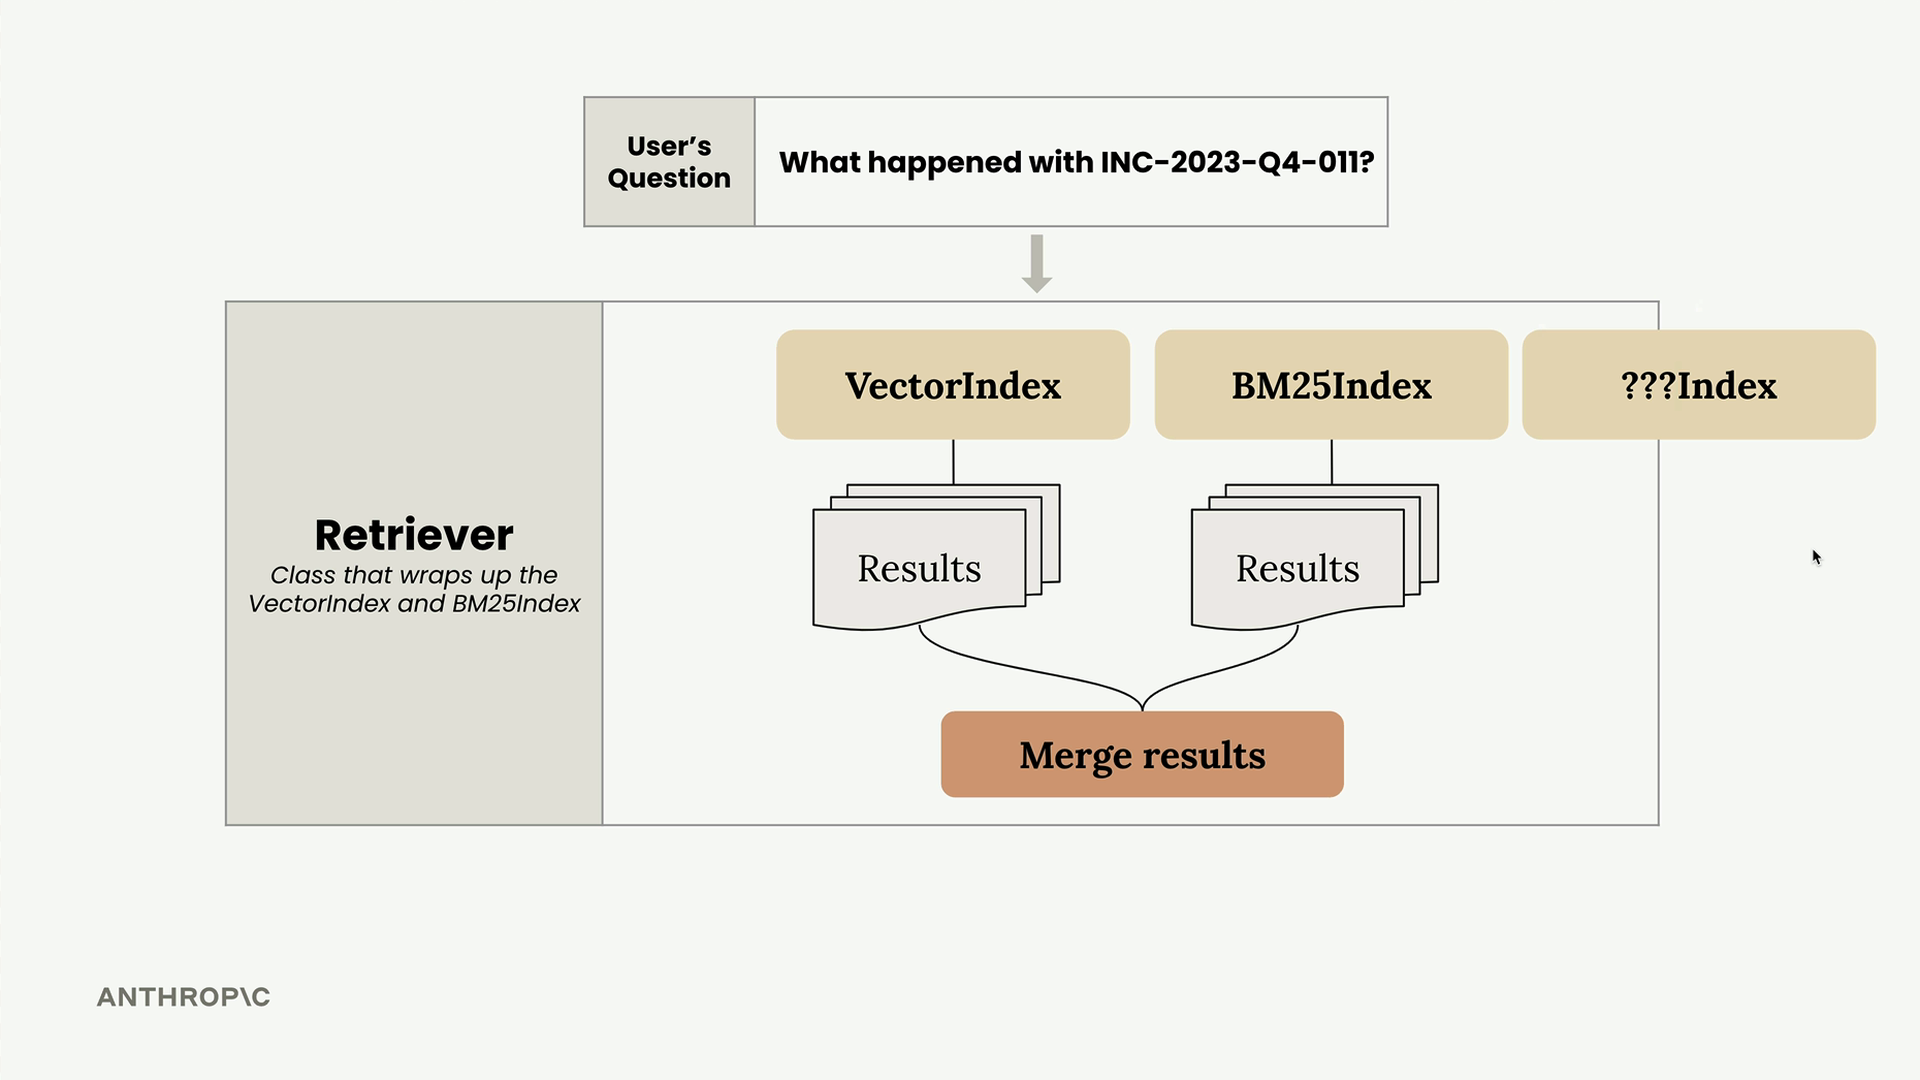
這兩種搜尋實作共享幾乎相同的 API——它們都有 add_document() 和 search() 方法。這種一致性使得將它們包裝在單一協調這兩種方法的 Retriever 類別中變得十分簡單。
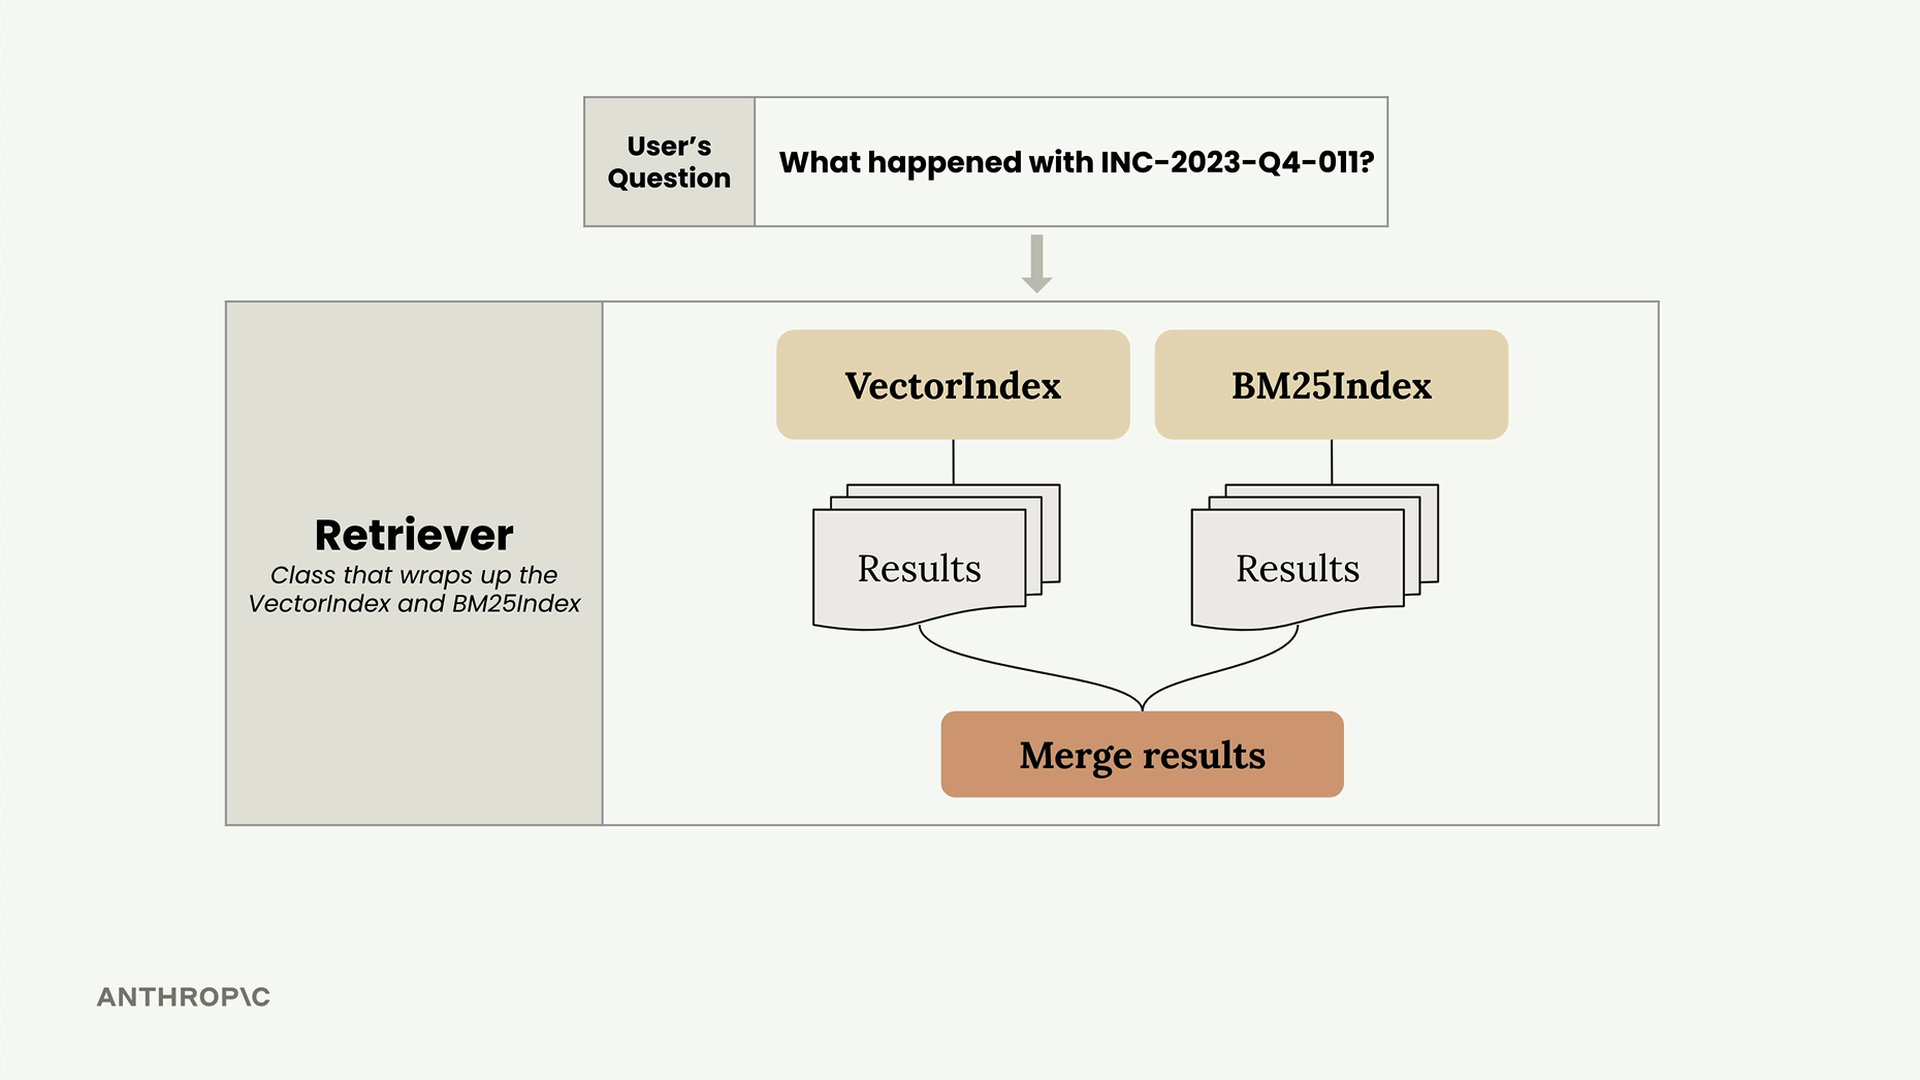
Retriever 作為協調者,執行以下動作:
- 接收使用者的問題
- 將其轉發給 VectorIndex 和 BM25Index
- 從兩個系統收集結果
- 使用排名演算法合併結果
倒數排名融合(Reciprocal Rank Fusion)
挑戰在於合併不同搜尋方法所得的結果。每個系統回傳的結果使用不同的評分機制,因此您無法直接簡單合併分數。因此,我們使用一種稱為「倒數排名融合」(Reciprocal Rank Fusion,簡稱 RRF)的技術。
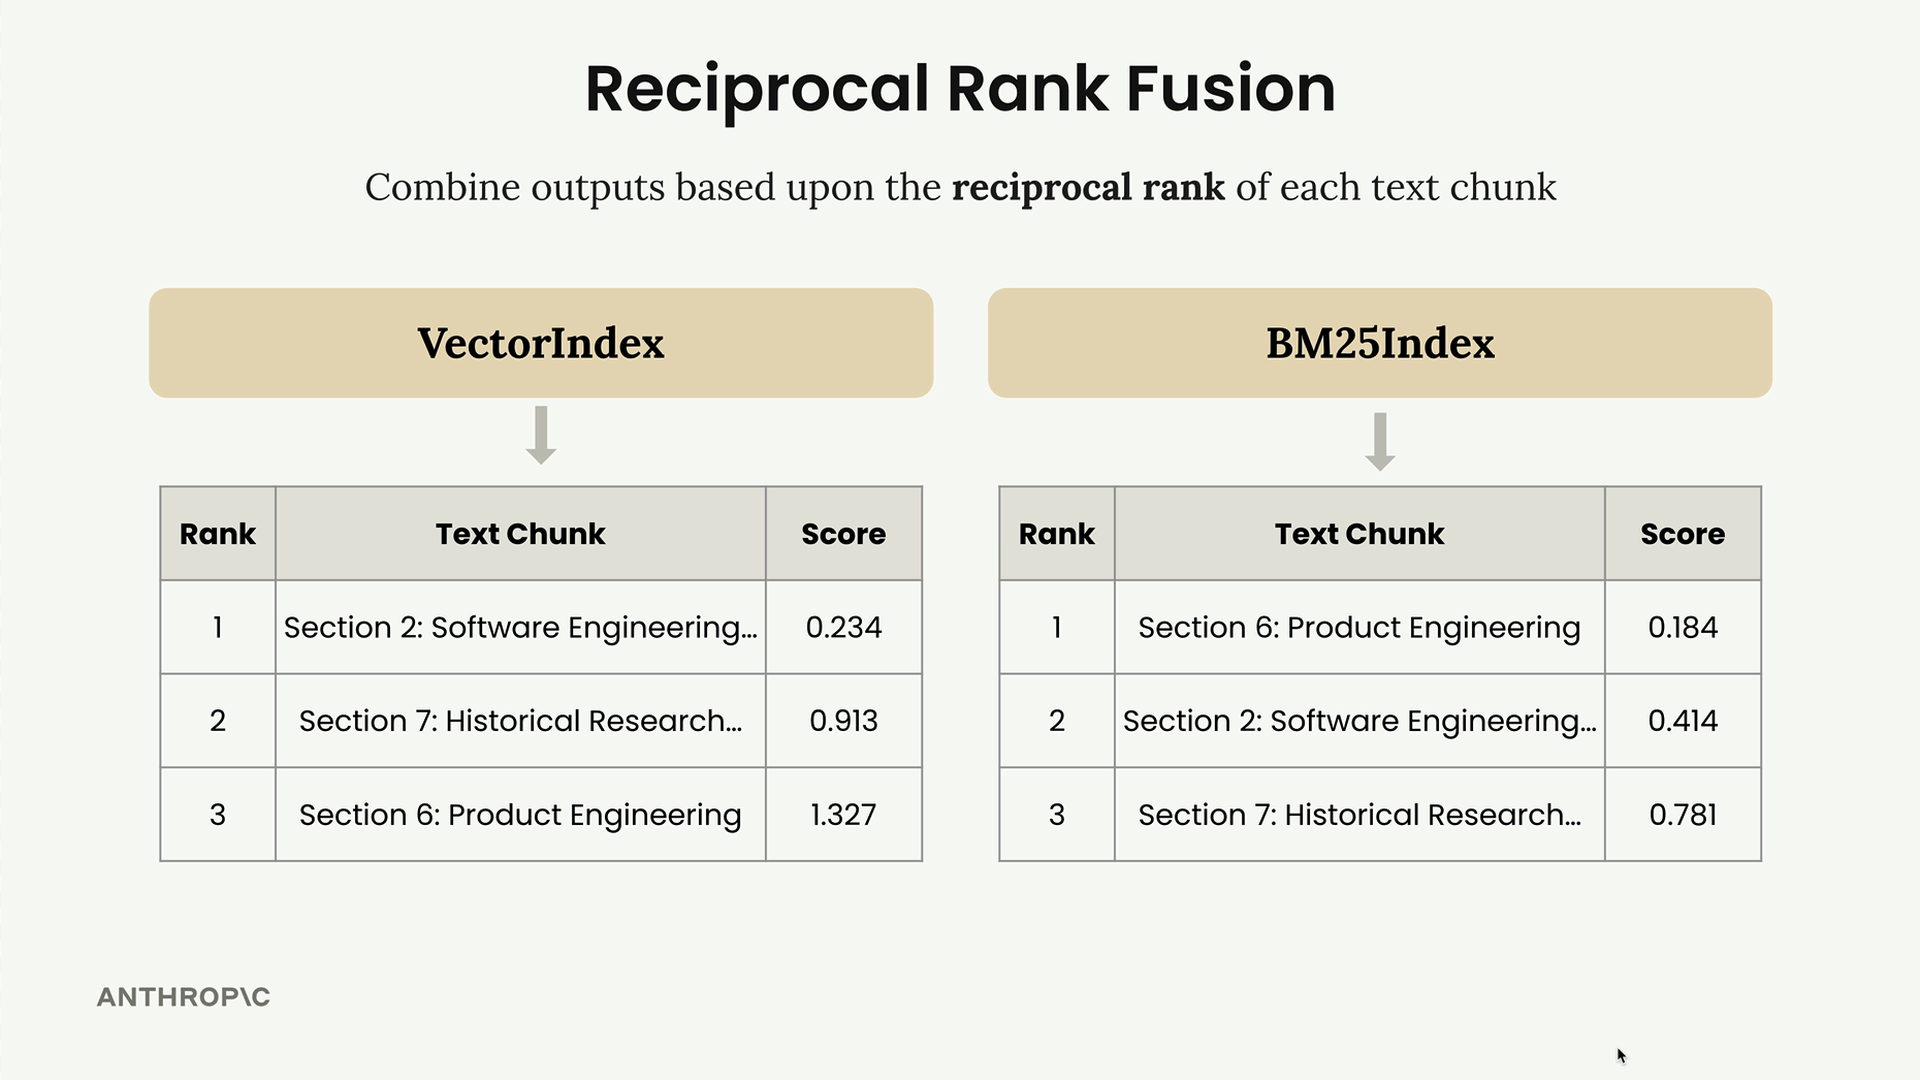
以下是 RRF 如何運作的實際範例。假設您的 VectorIndex 回傳的排名結果為:Section 2、Section 7、Section 6。同時,您的 BM25Index 回傳:Section 6、Section 2、Section 7。
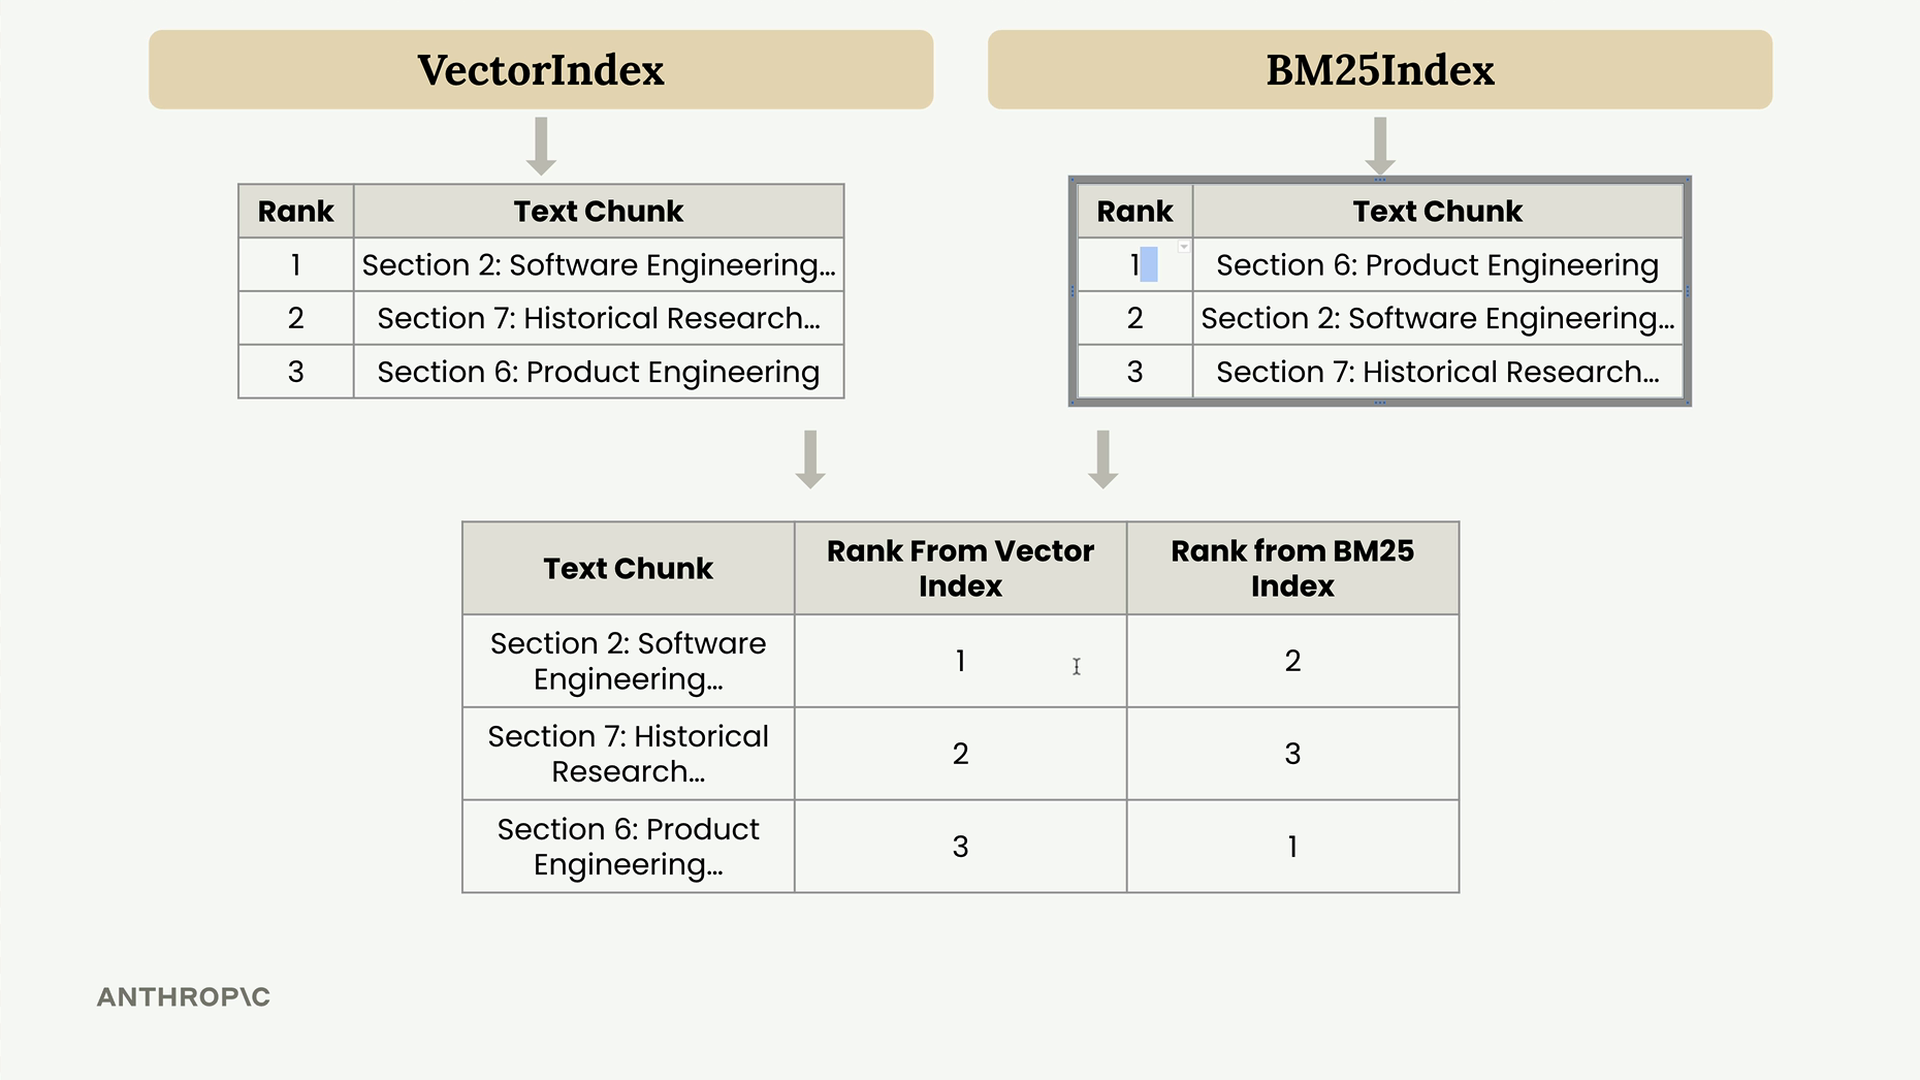
要合併這些結果,您需要建立一個合併表格,顯示每個文字區塊在兩個系統中的排名:
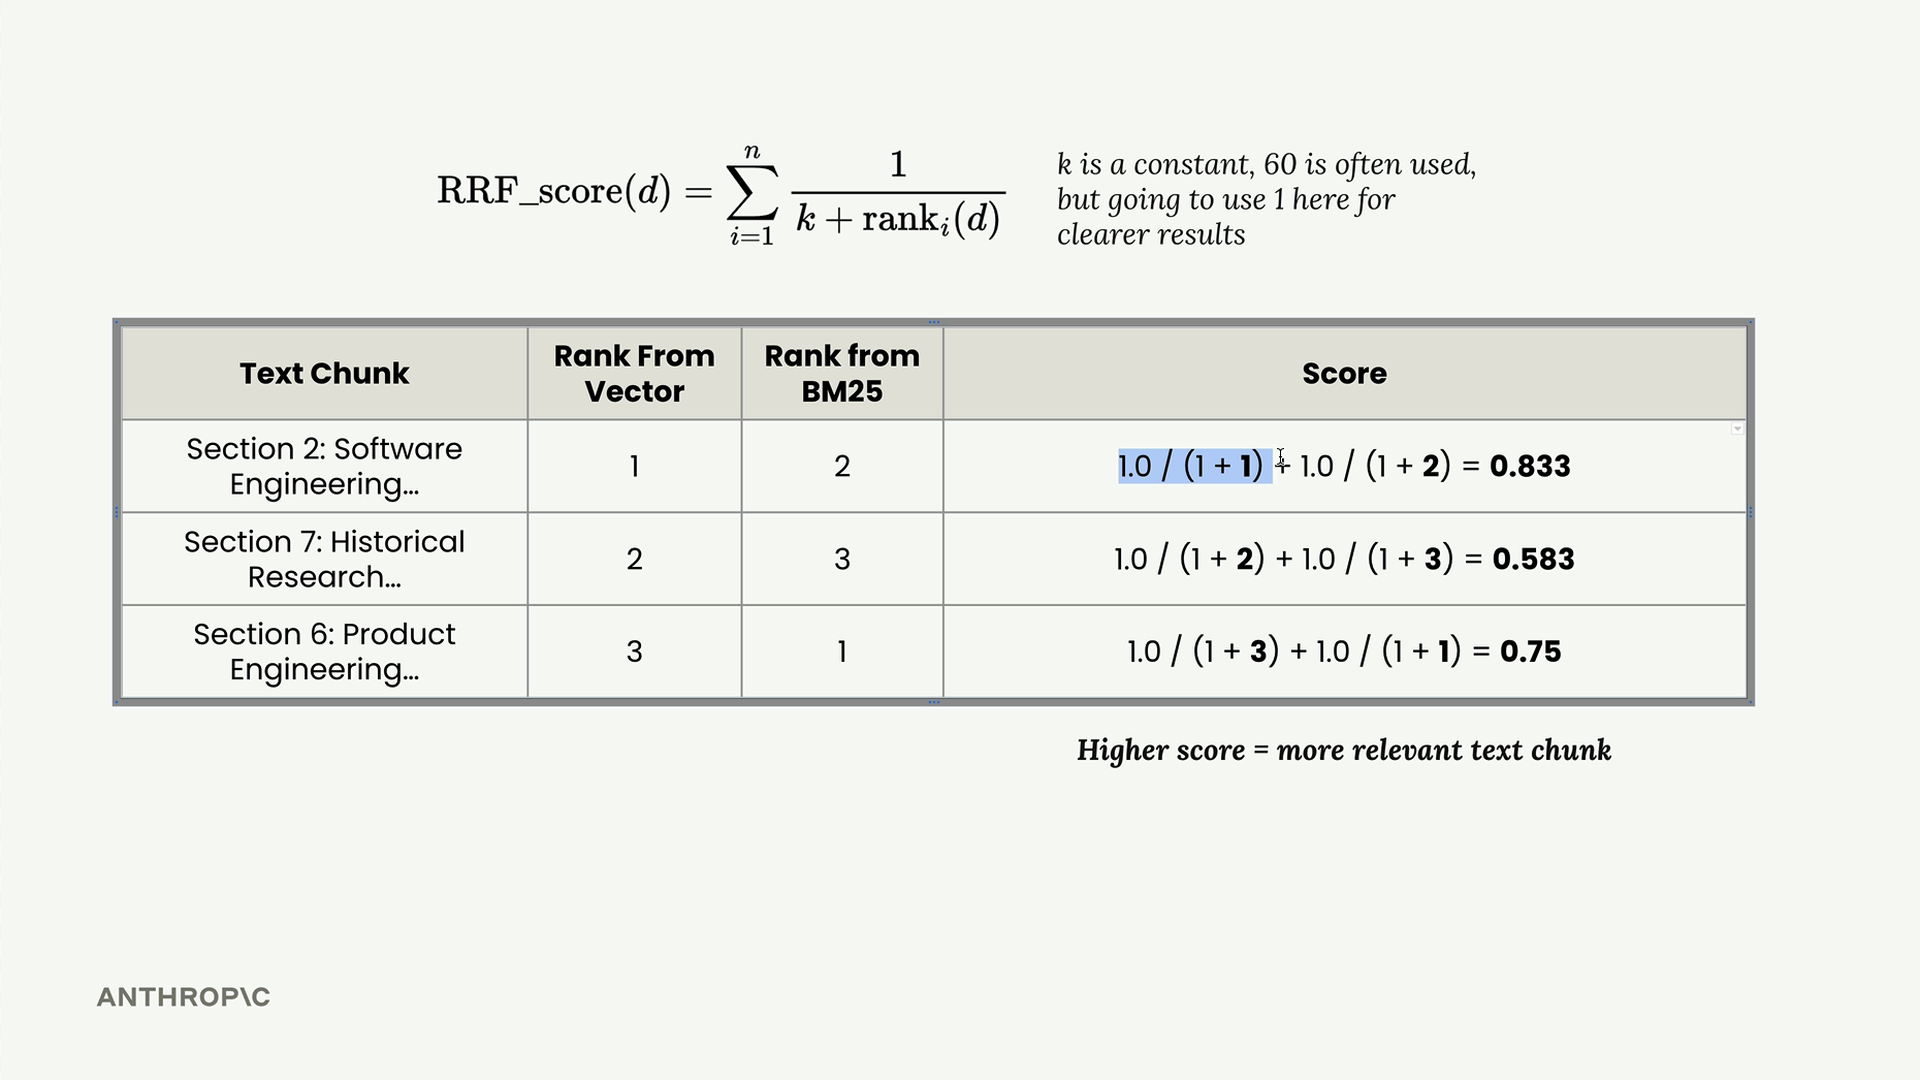
RRF 公式計算每份文件的分數:
RRF_score(d) = Σ(1 / (k + rank_i(d)))其中 k 是一個常數(通常為 60,不過若要得到更清楚的結果,1 也是不錯的選擇),而 rank_i(d) 是文件 d 在第 i 個排名系統中的排名。
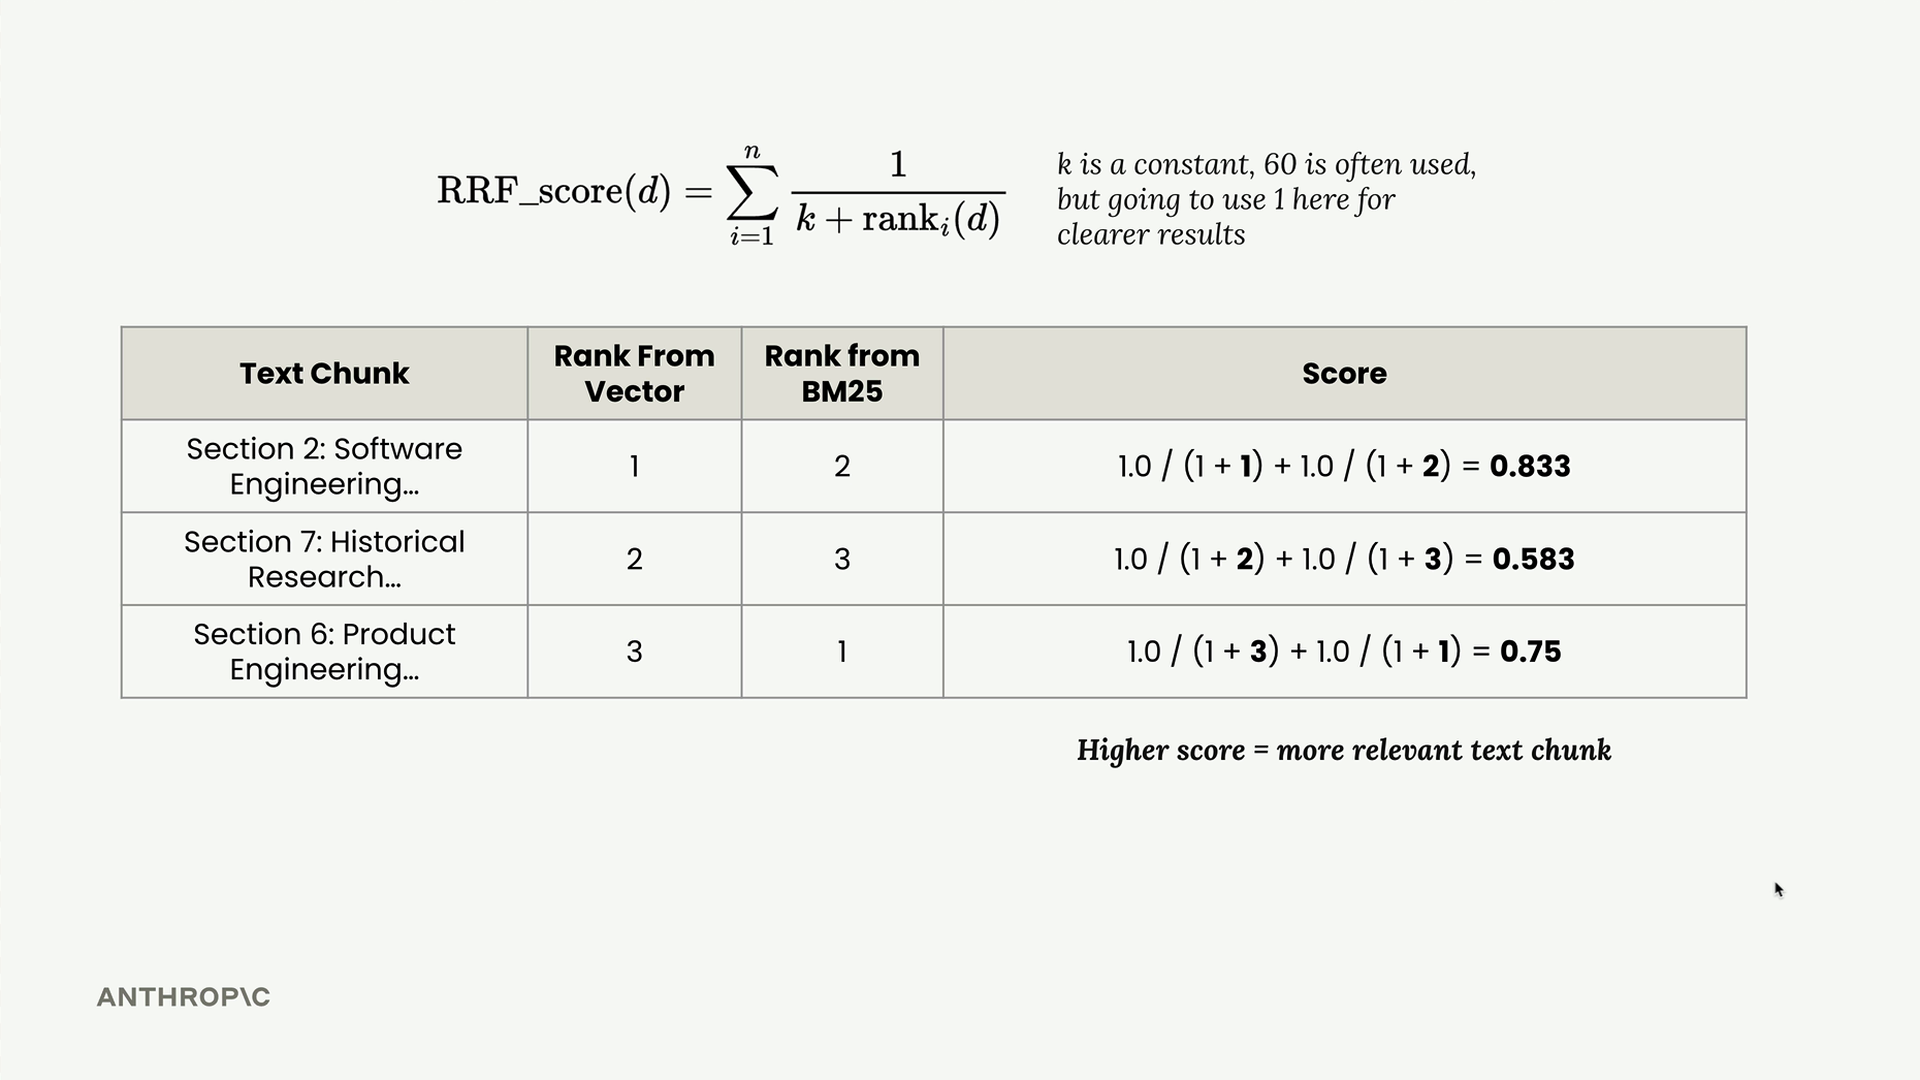
對每個文字區塊,您計算:
- Section 2:1.0/(1+1) + 1.0/(1+2) = 0.833
- Section 7:1.0/(1+2) + 1.0/(1+3) = 0.583
- Section 6:1.0/(1+3) + 1.0/(1+1) = 0.75
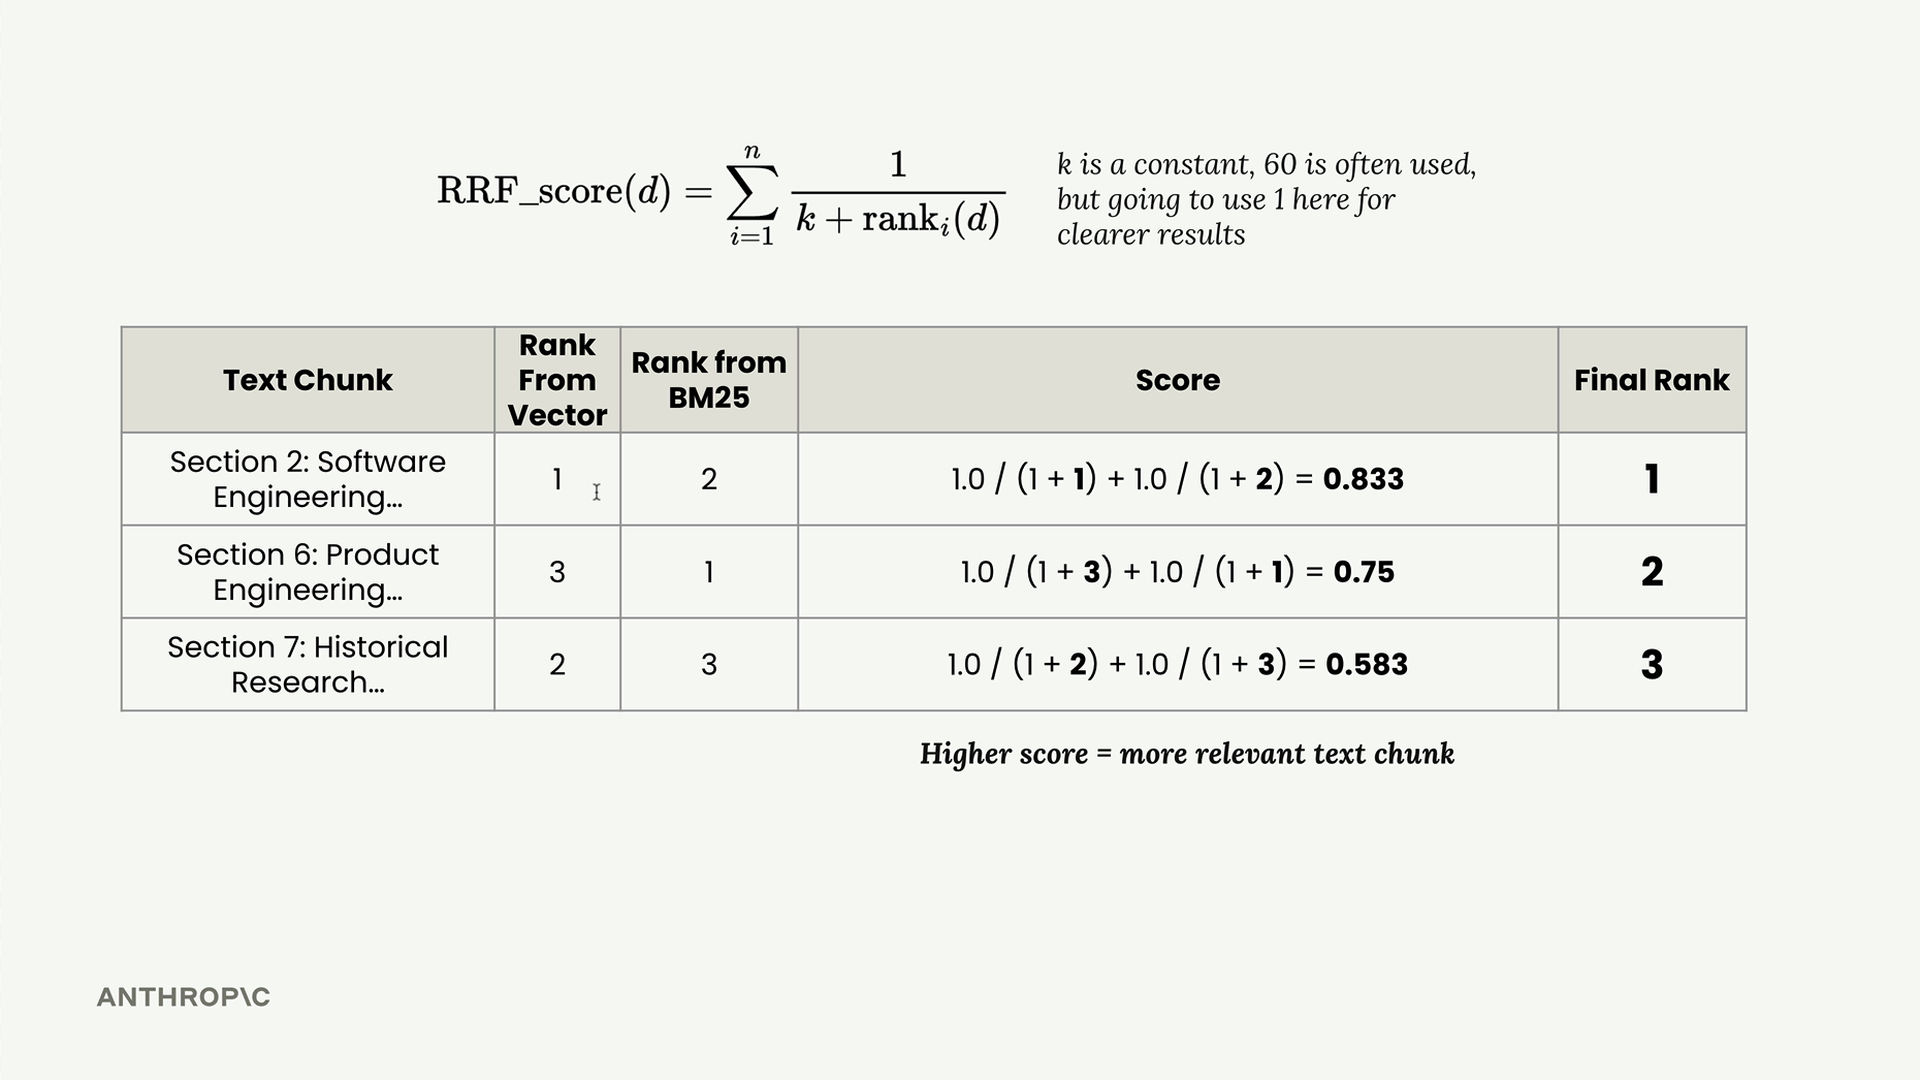
按分數排序後,最終排名變為:Section 2(第一)、Section 6(第二)、Section 7(第三)。
實作
Retriever 類別的實作相當直接:
class Retriever:
    def __init__(self, *indexes):
        self._indexes = list(indexes)

    def add_document(self, document):
        for index in self._indexes:
            index.add_document(document)

    def search(self, query_text, k=1, k_rrf=60):
        # 從所有索引取得結果
        all_results = []
        for idx, results in enumerate(all_results):
            for rank, (doc, _) in enumerate(results):
                # 追蹤文件在各系統中的排名
                # 套用 RRF 公式
                # 回傳合併並排序後的結果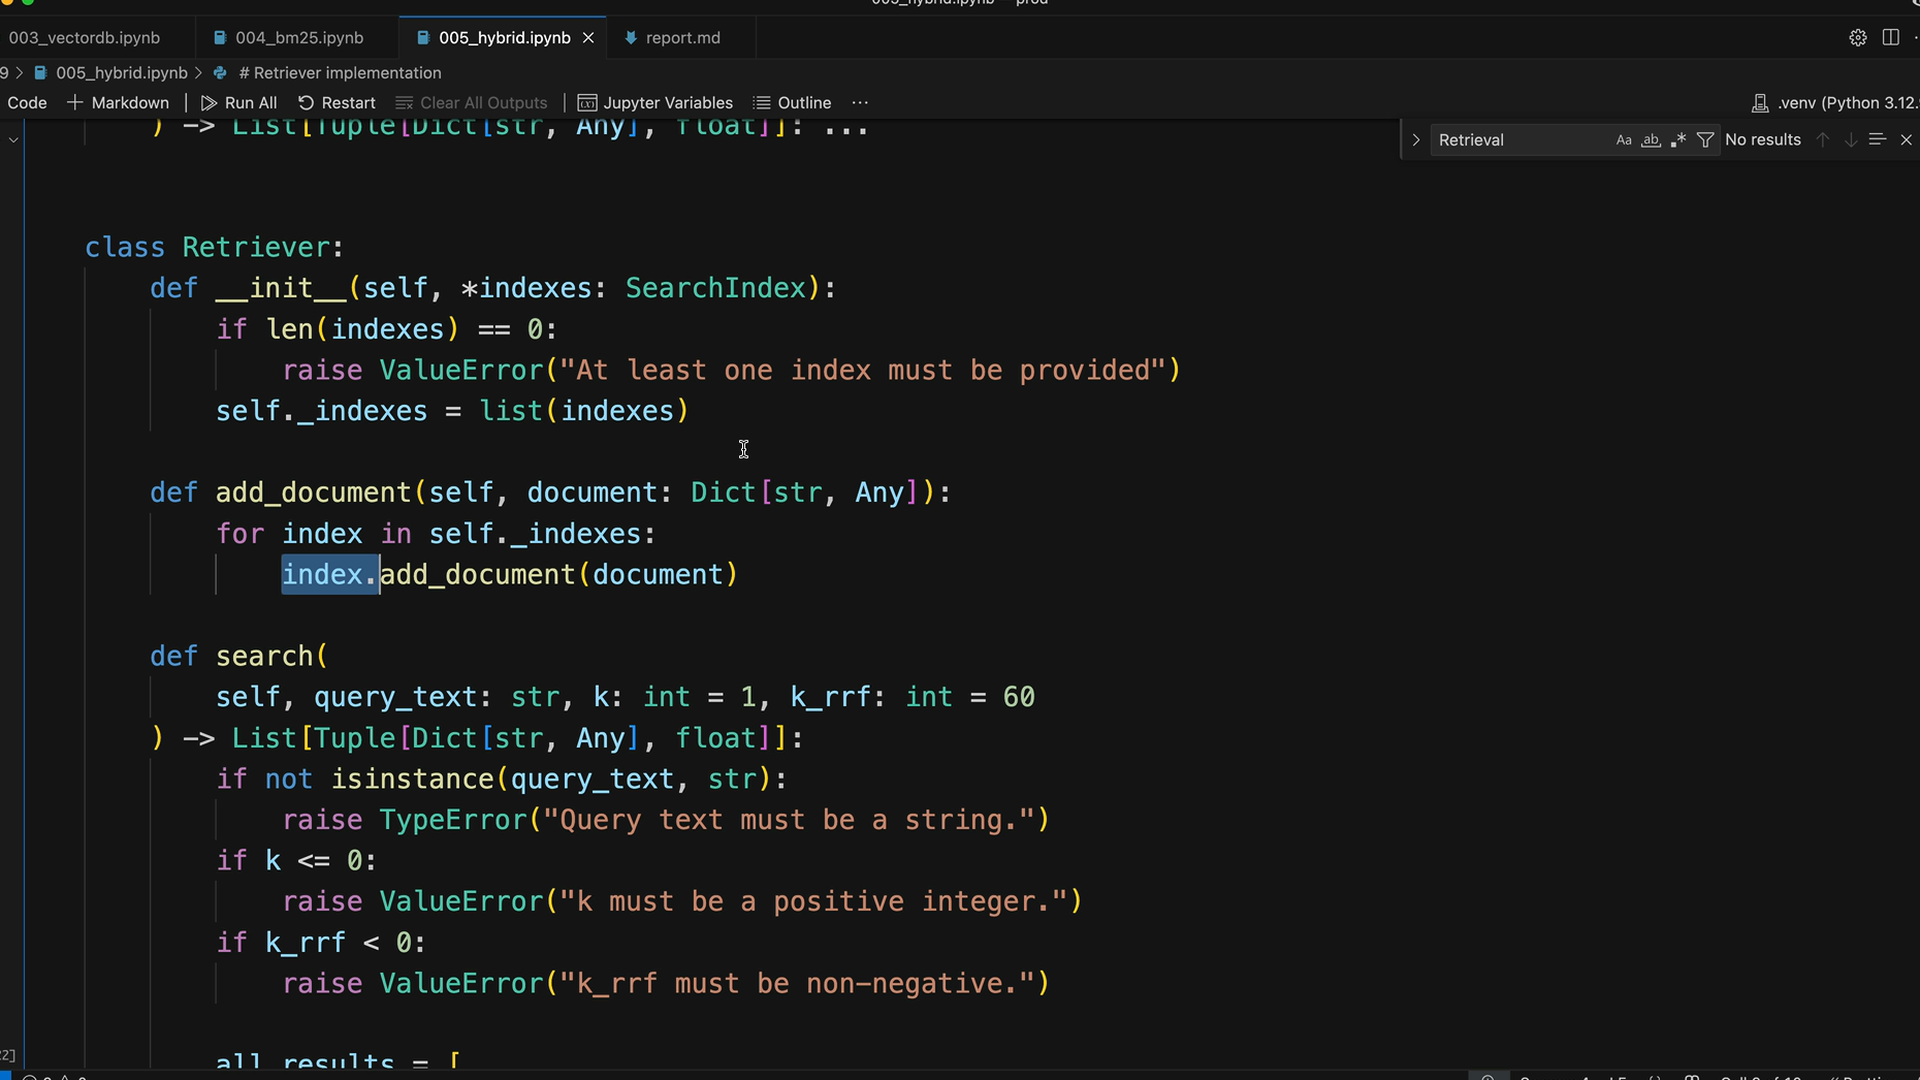
關鍵在於 RRF 演算法透過考量每份文件在所有搜尋系統中的整體表現來建立統一的排名,而不是依賴任何單一的評分方法。
測試混合方法
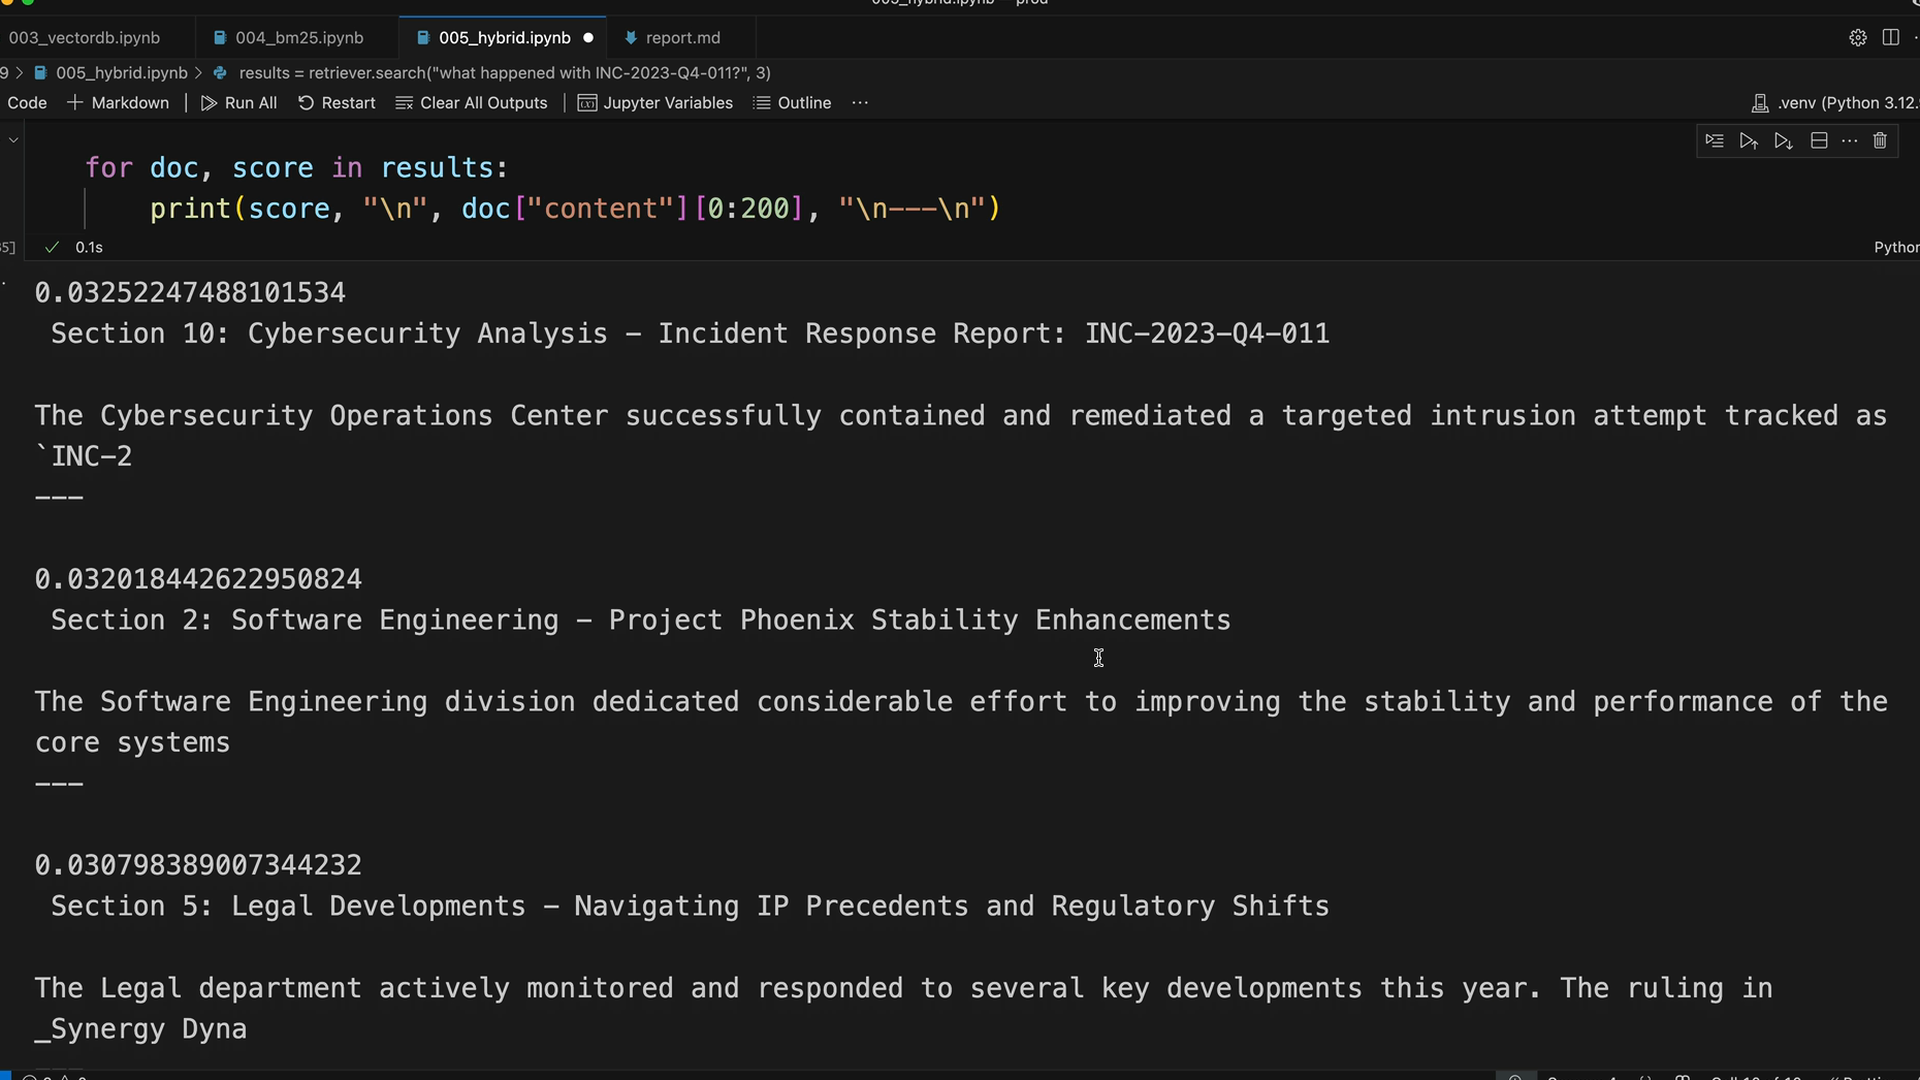
當使用類似「what happened with INC-2023-Q4-011?」這樣的查詢進行測試時,混合方法所提供的結果明顯優於單獨使用任一方法。相較於純向量搜尋可能得到的意外結果,現在您首先會得到最相關的網路安全事件報告,隨後是相關的軟體工程內容。
可延伸性
這種設計的優點在於其模組化特性。由於每個搜尋索引都實作相同的介面(add_document() 和 search()),您可以輕鬆地為系統新增新的搜尋方法。無論是不同的嵌入模型、專門的領域搜尋,還是任何其他檢索技術,只要它遵循既定的 API,就能無縫整合到這個混合管線中。
這種混合搜尋方法結合了向量搜尋的語意理解能力與詞彙搜尋的精確關鍵字匹配能力,並透過數學上嚴謹的 RRF 排名演算法將兩者統一起來,代表檢索準確度上的重大進步。