載入中
檢索增強生成(Retrieval Augmented Generation,簡稱 RAG)是一種技術,能幫助您處理大型文件,方法是將其拆分成較小的片段,並且僅向 Claude 提供與每個問題最相關的片段。RAG 不會讓模型一次消化整份長達 800 頁的財務報告,而是讓您只擷取與回答特定查詢相關的章節。
大型文件的問題
當您擁有一份龐大的文件,並想就此向 Claude 提出特定問題時,您會面臨一個根本性的挑戰:如何在不觸及限制或影響效能的情況下,將正確的資訊提供給 Claude?
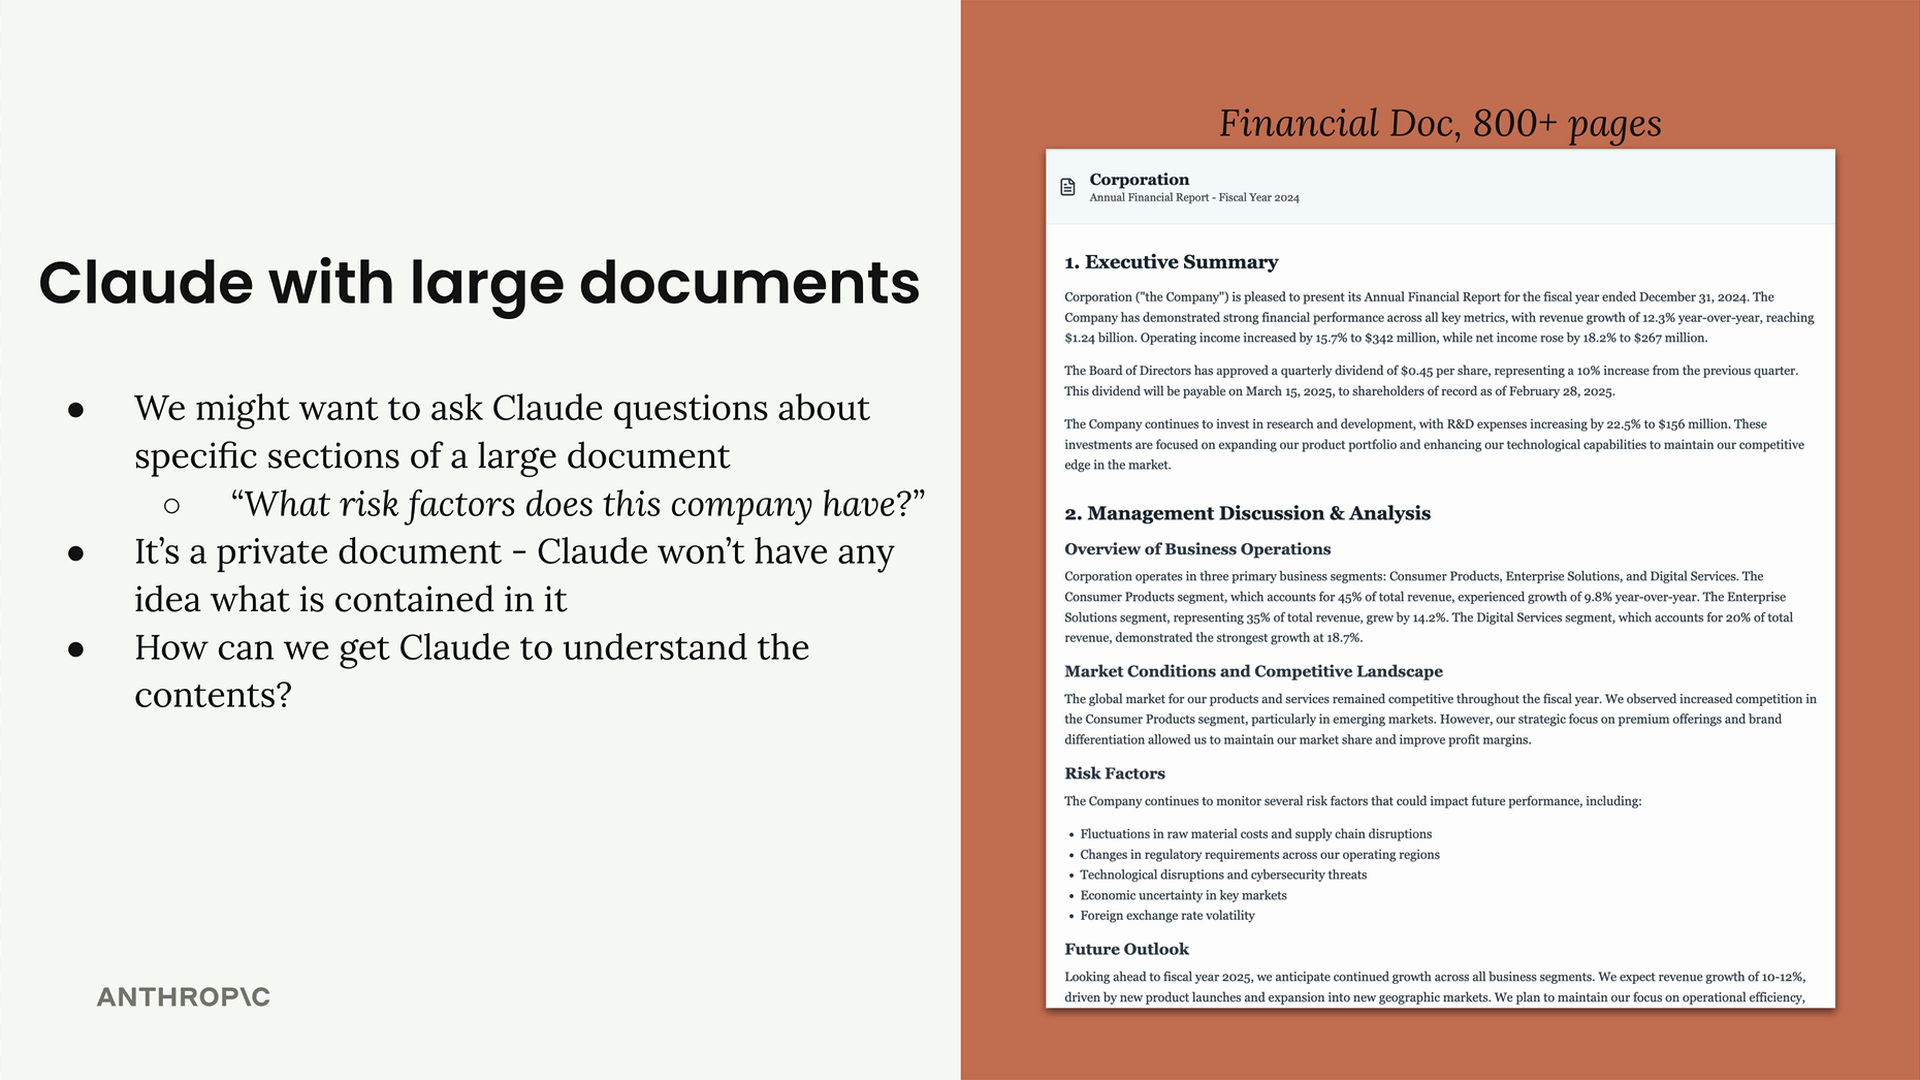
以針對一份冗長財務文件提出「這家公司有哪些風險因素?」為例。文件中包含答案,但 Claude 需要存取相關內容才能協助您。
選項一:在提示中包含所有內容
最直接的做法是從文件中擷取所有文字,並將其塞入單一提示中:
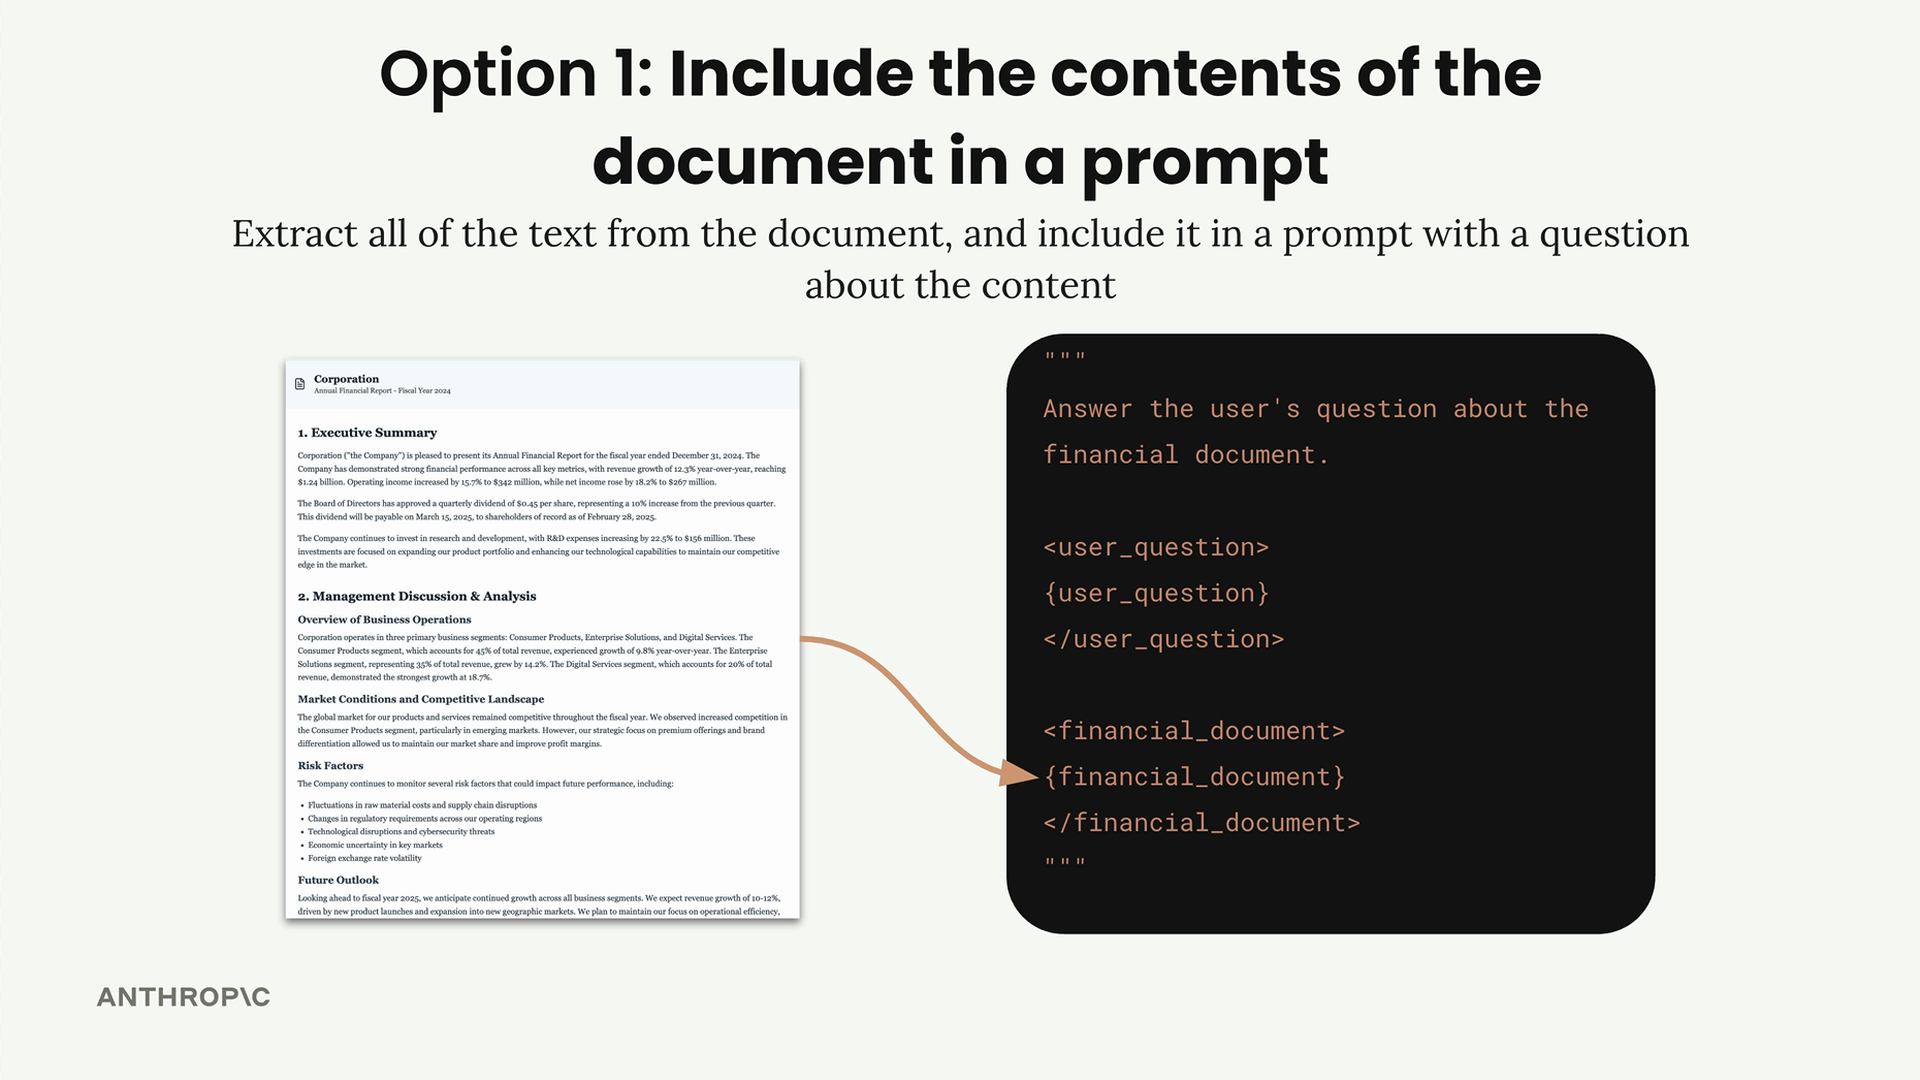
這種方法有嚴重的限制:
- 硬性的 token 限制意味著非常長的文件根本放不下
- 在極長的提示下,Claude 的效果會變差
- 較大的提示會花費更多金錢,且處理時間更長
- 當需要篩選的資訊過多時,效能會下降
選項二:將文件拆分成片段
RAG 採用更聰明的方法,先將文件預先處理成可管理的片段,然後針對每個問題僅檢索相關的片段。
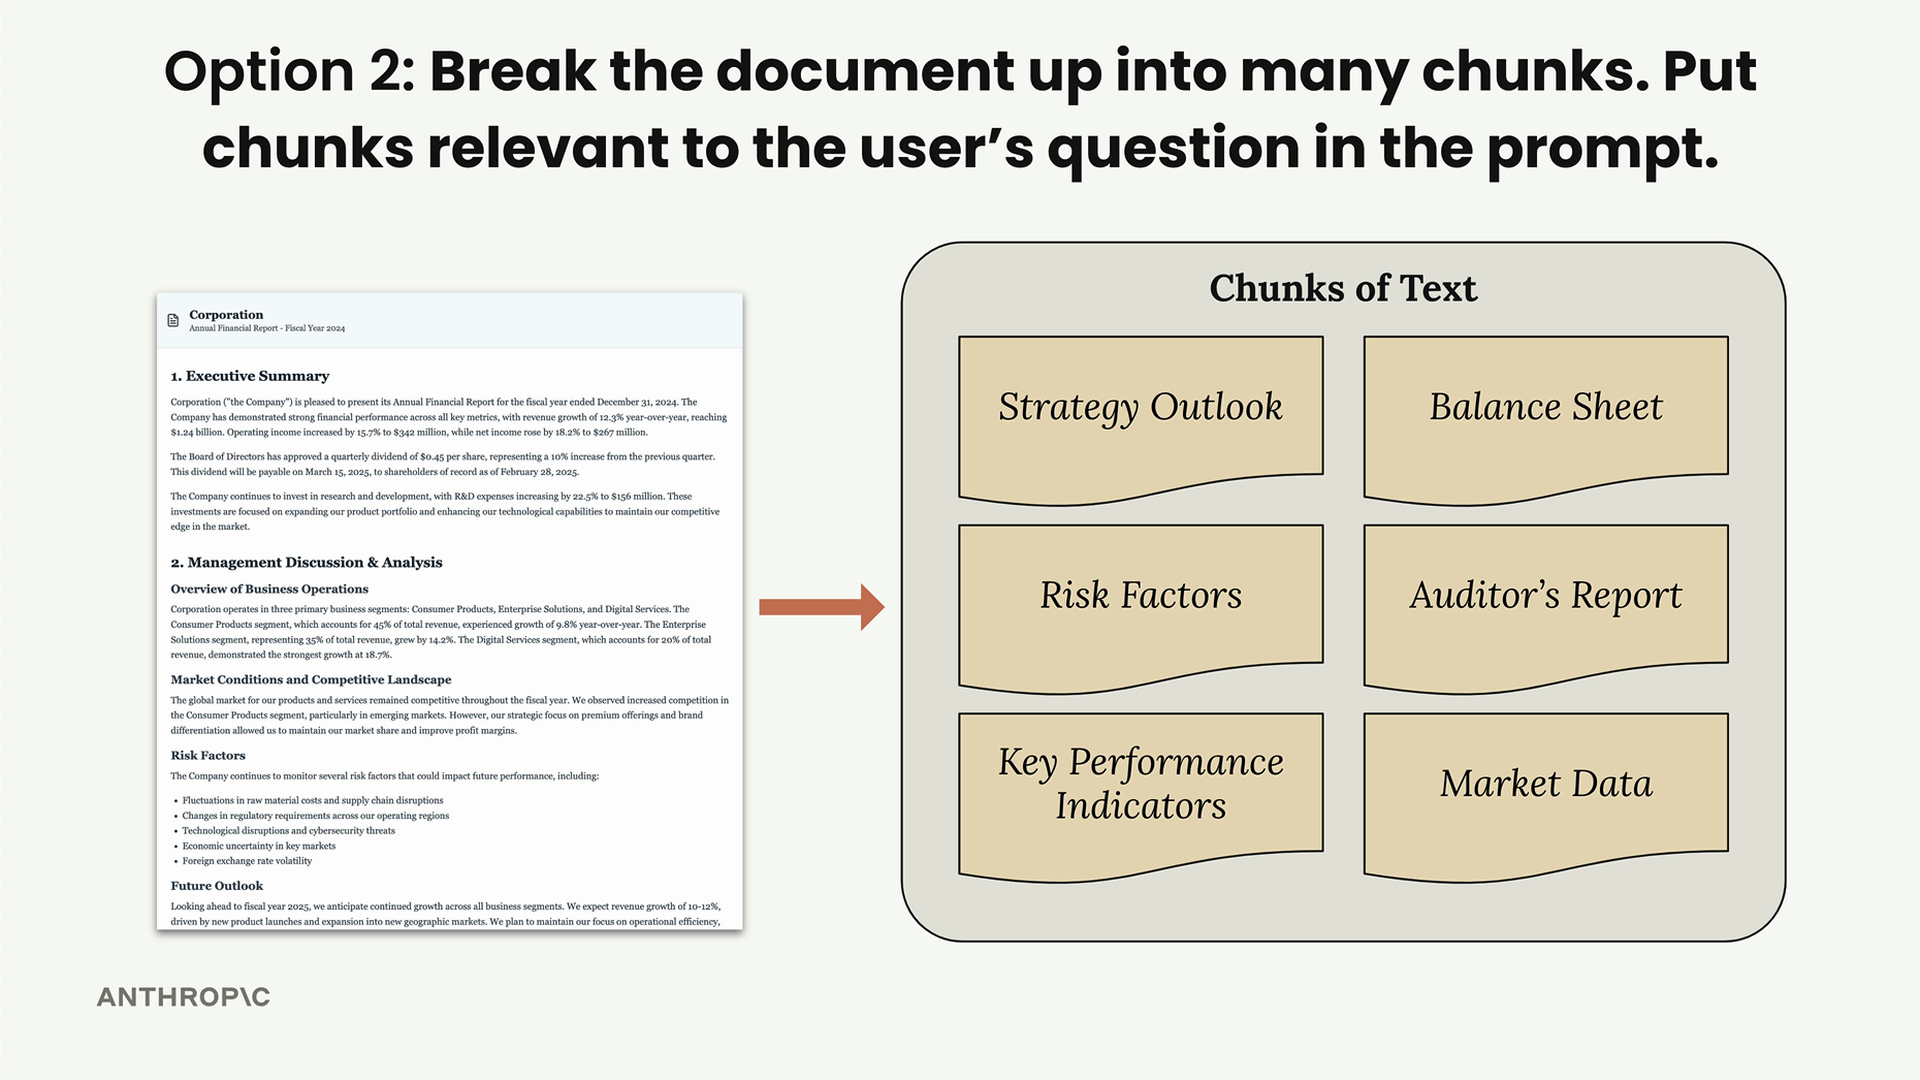
運作方式如下:
- 將文件拆分成較小的片段(策略展望、風險因素、資產負債表等)
- 當使用者提出問題時,分析他們想要尋找的內容
- 找出與其問題最相關的片段
- 在提供給 Claude 的提示中,僅納入那些相關的片段
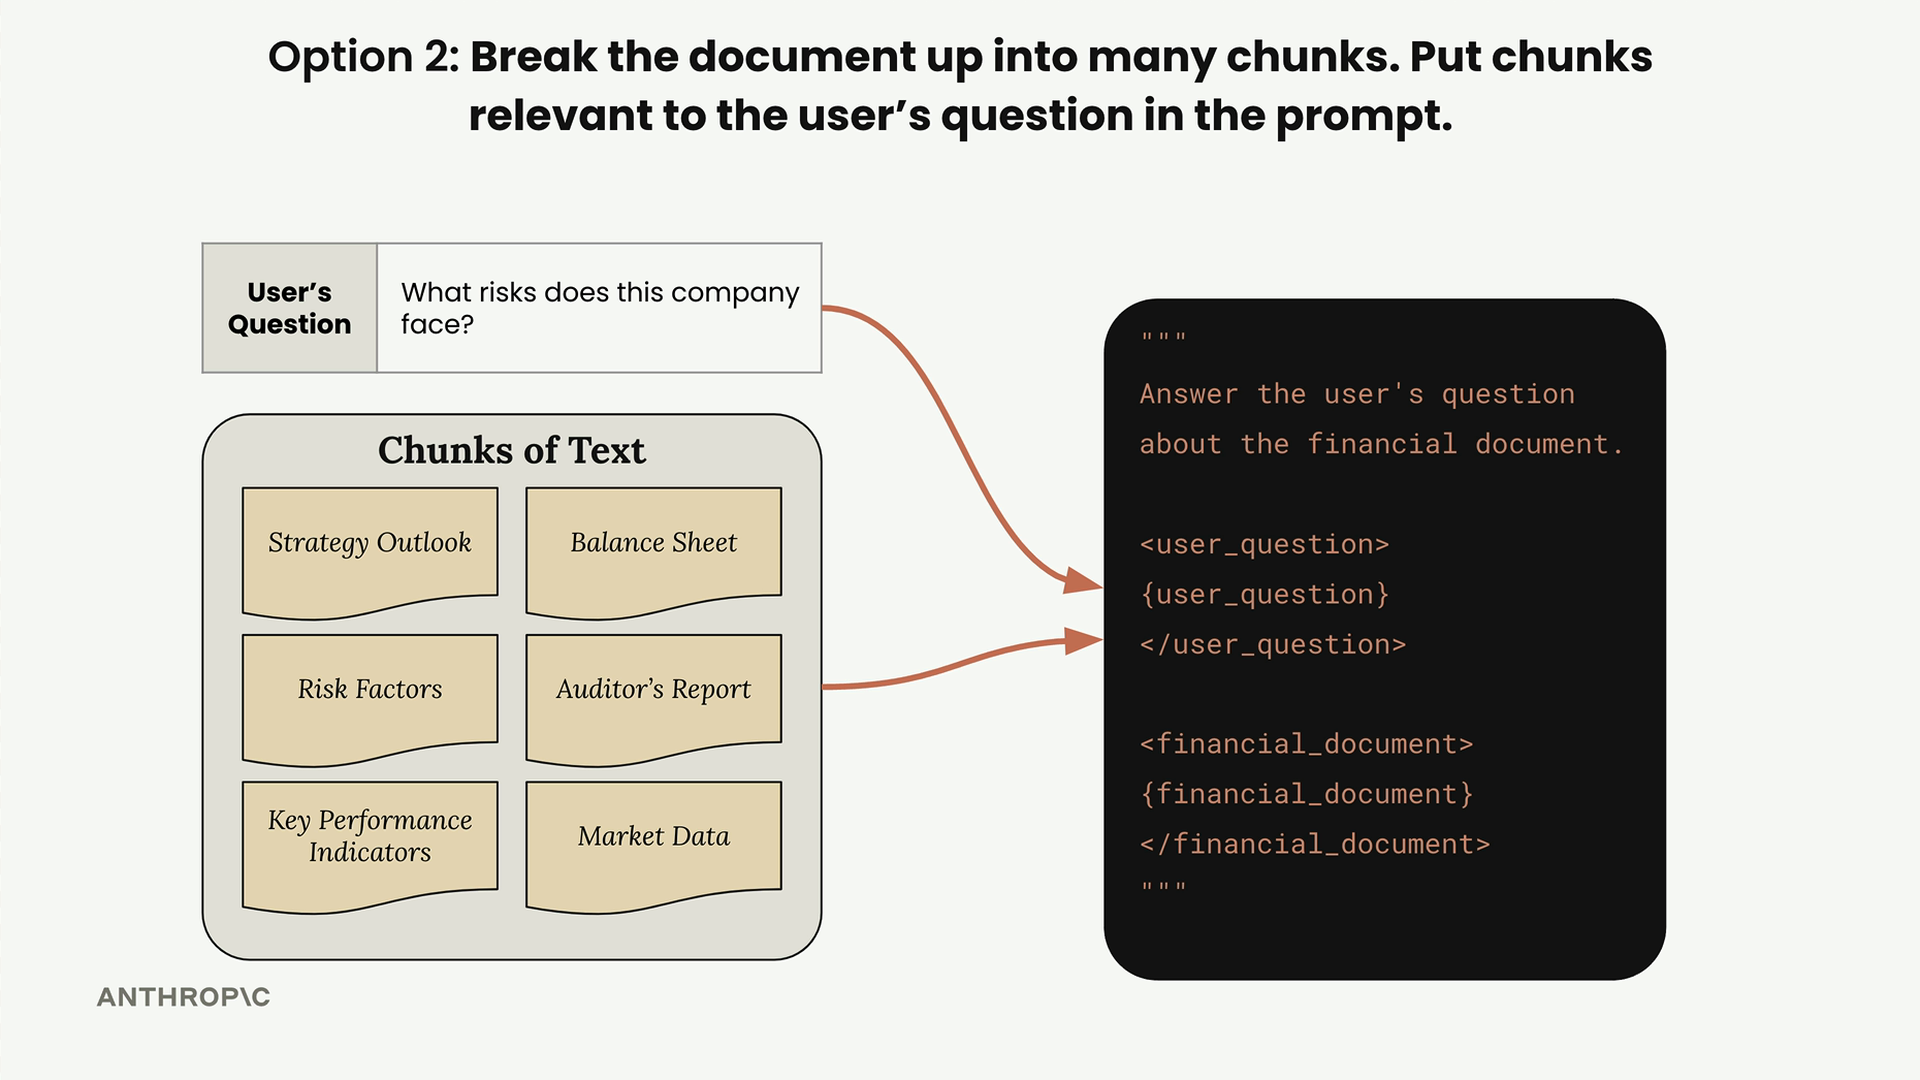
針對有關公司風險的問題,系統會識別並檢索「風險因素」片段,為 Claude 提供聚焦且相關的上下文,而非整份文件。
RAG 的優點
- Claude 能夠僅專注於最相關的內容
- 可擴展至非常大型的文件及多份文件
- 可跨文件集合運作,而不僅限於單一檔案
- 較小的提示意味著處理速度更快、成本更低
RAG 的挑戰
RAG 會引入您需要管理的複雜性:
- 需要一個預處理步驟來分割文件
- 需要一套搜尋機制來找出相關片段
- 檢索到的片段可能無法包含所有必要的上下文
- 文字切割的方式有許多種——哪種方法最有效?
您可以依照等量比例、標題與章節、語意意義或其他策略來分割文件。每種方法都有取捨,您需要針對您的特定使用情境加以評估。
何時使用 RAG
當您處理大型文件或文件集合,且使用者提出的特定問題只需要部分內容即可回答時,RAG 便能發揮優勢。當您需要擴展超出單一提示所能容納的範圍、想要更快的回應速度,或是需要在大量查詢中管理成本時,預處理的複雜度便是值得的投資。
關鍵在於分析實作切割、搜尋與檢索所帶來的技術開銷,對您的特定應用而言是否合理。有時簡單的「把所有內容都塞進一個提示」的做法就已經足夠——但在其他情況下,RAG 則會成為讓系統實用且高效運作的關鍵。