載入中
建立自訂提示評估工作流程,首先要設定一個明確的目標並生成測試資料。在此案例中,我們正在建立一個提示,協助使用者撰寫 AWS 特定程式碼——可能是 Python 函式、JSON 配置,或正規表示式——不需要額外的說明或格式化。
設定目標
這個提示應該接收使用者的任務描述,並回傳以下三種輸出類型之一:
- Python 程式碼
- JSON 配置
- 正規表示式
關鍵要求是回應應只包含要求的程式碼,不含標頭、頁尾或說明。
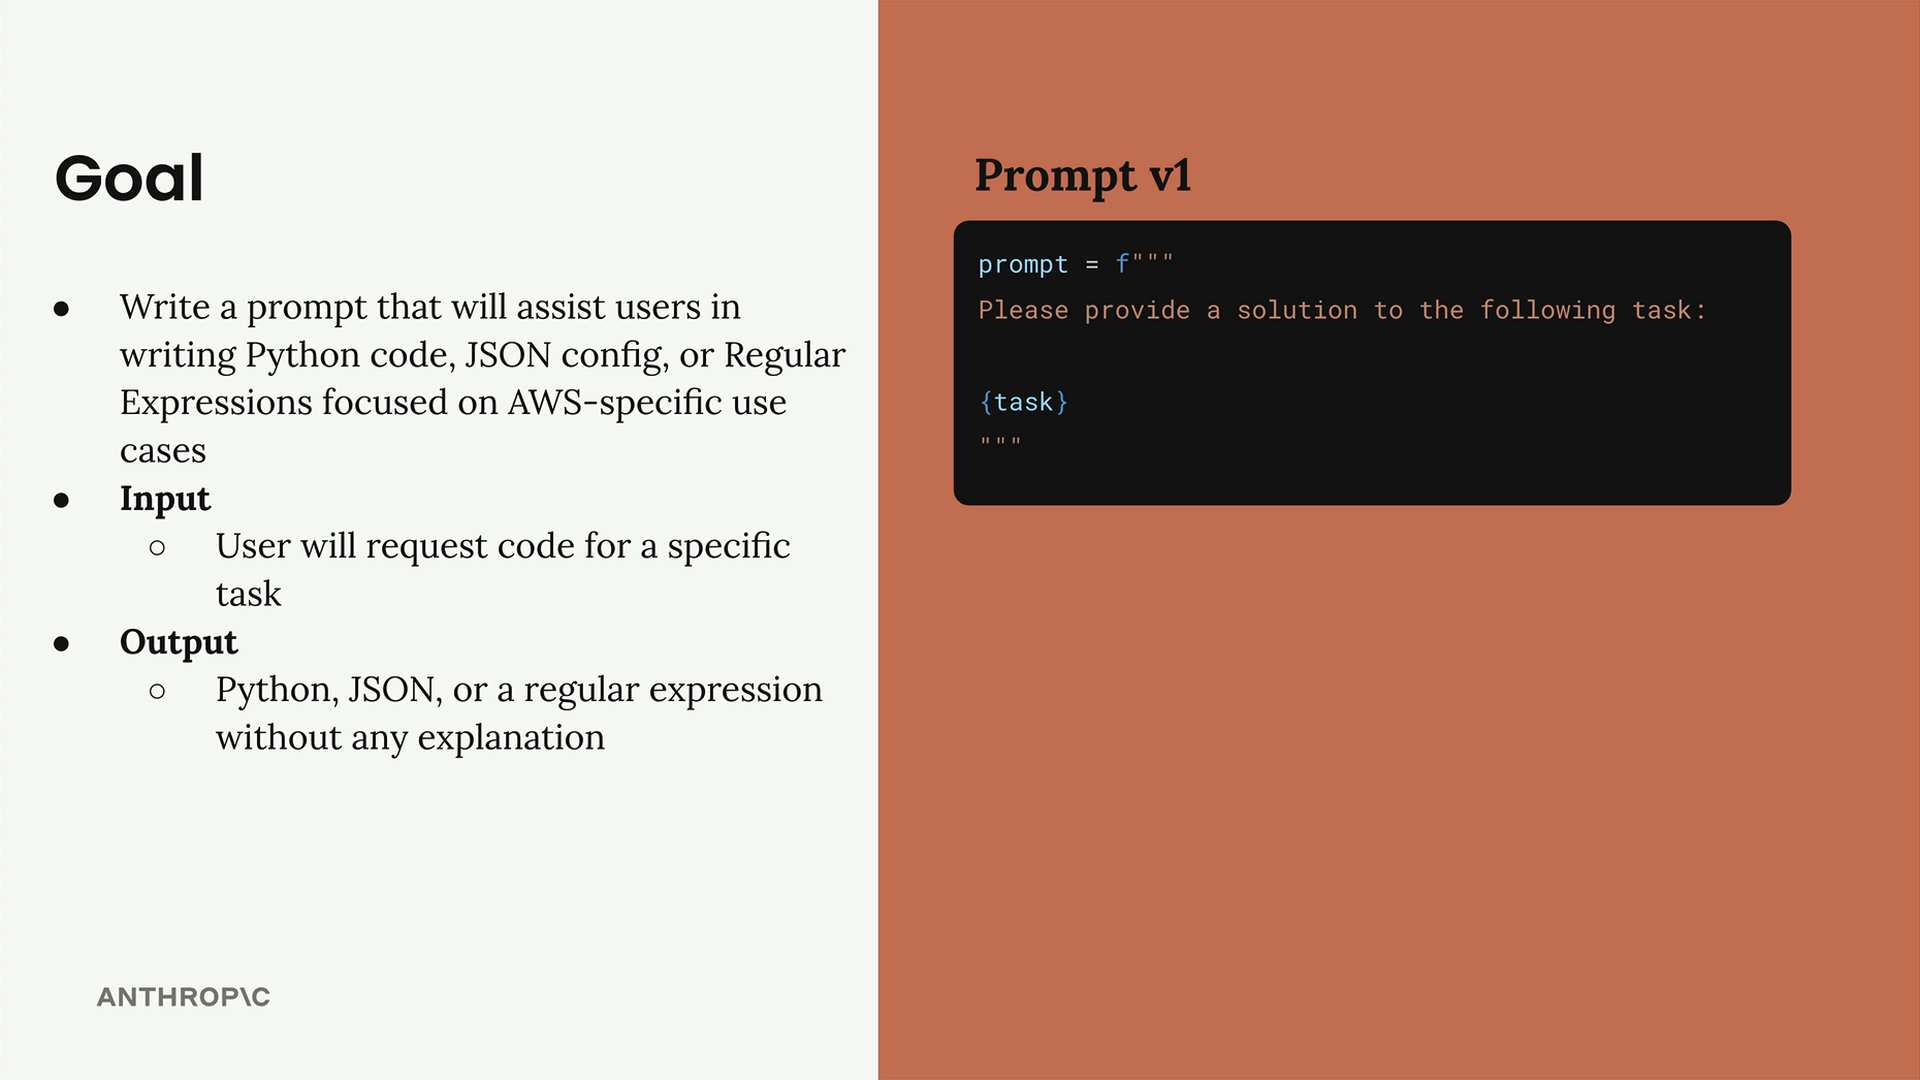
從一個簡單的初版開始,可以讓事情更容易掌控。初始提示範本很簡單:「請為以下任務提供解決方案:{task}」
建立評估資料集
評估資料集包含您將輸入提示的輸入範例。每個測試案例會與您的提示結合並傳送給 Claude,讓您能看出該提示在不同情境下的表現如何。
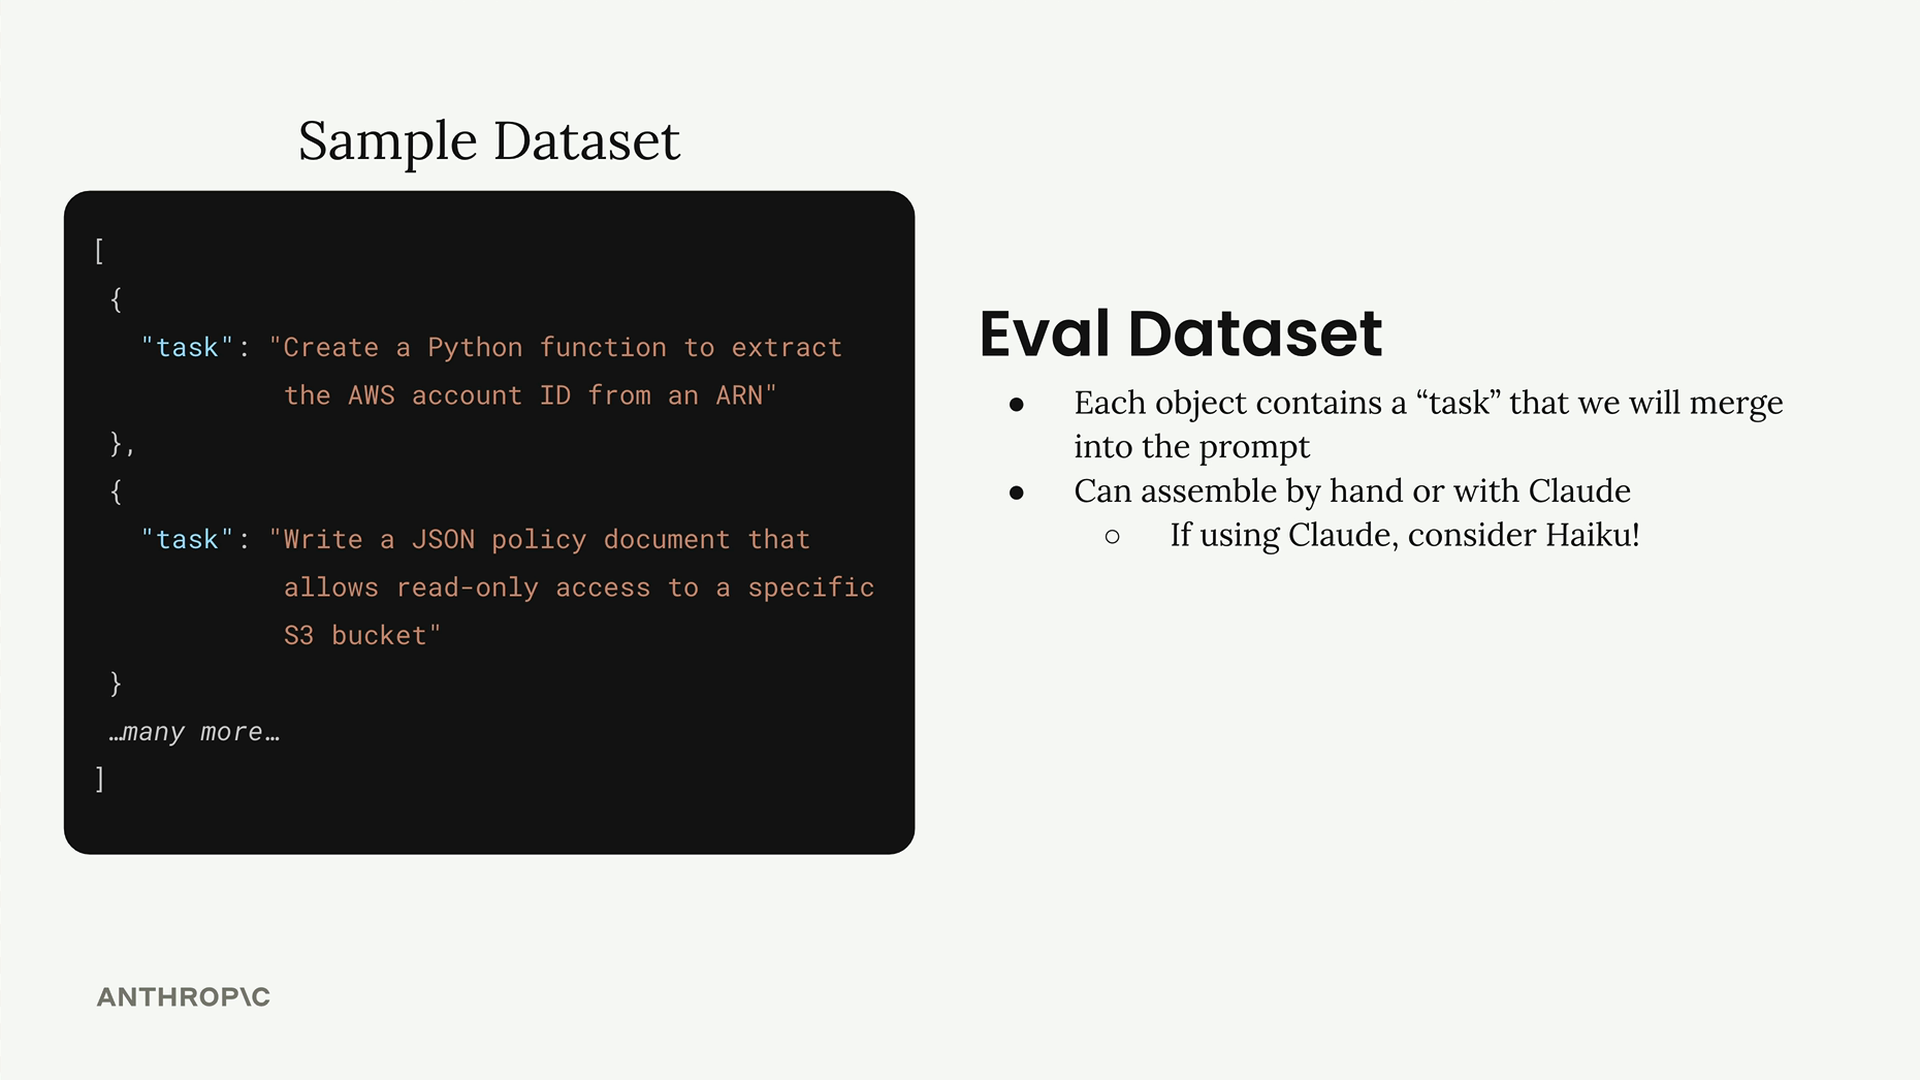
您可以用兩種方式建立資料集:
- 手動編寫測試案例
- 使用 Claude 自動生成
若要自動生成,使用像 Haiku 這樣較快的模型是合理的,因為您會需要生成多個測試案例。
使用程式碼生成測試資料
資料集生成函式使用 Claude 來建立逼真的測試情境。以下是基本結構:
python
def generate_dataset():
    prompt = """
    Generate 3 AWS-related tasks that require Python, JSON, or Regex solutions.

    Focus on tasks that can be solved by writing a single Python function,
    a single JSON object, or tasks that do not require writing much code.

    Example output:
    [
        {
            "task": "Description of task"
        },
        ...additional
    ]

    Please generate 3 objects.
    """

    messages = []
    add_user_message(messages, prompt)
    add_assistant_message(messages, "```json")
    text = chat(messages, stop_sequences=["```"])
    return json.loads(text)
此方法使用預先填入的助理訊息技巧搭配停止序列,以擷取乾淨的 JSON 回應。助理訊息以 ```json 開頭,並在結束的 ``` 處停止,確保您能取得格式正確的資料。
儲存您的資料集
生成後,請儲存資料集以避免不斷重新生成:
python
dataset = generate_dataset()
with open("dataset.json", "w") as f:
    json.dump(dataset, f, indent=2)
生成的資料集會建立逼真的 AWS 任務,例如從 ARN 中擷取帳戶 ID、為 EC2 配置撰寫 JSON schema,以及為 S3 儲存桶名稱建立正規表示式模式。雖然三個測試案例足以用於初期開發,但正式的評估會需要更多、更多樣化的範例。
這個基礎為您提供了一個可重複的流程,用以建立符合您特定使用情境的評估資料集,並為下一步——執行評估與衡量提示表現——做好準備。