擴展思考是 Claude 的進階功能,讓模型在生成最終回應之前有時間對複雜問題進行推理。可以把它想像成 Claude 的內心獨白——您可以看到它如何逐步處理您的問題。
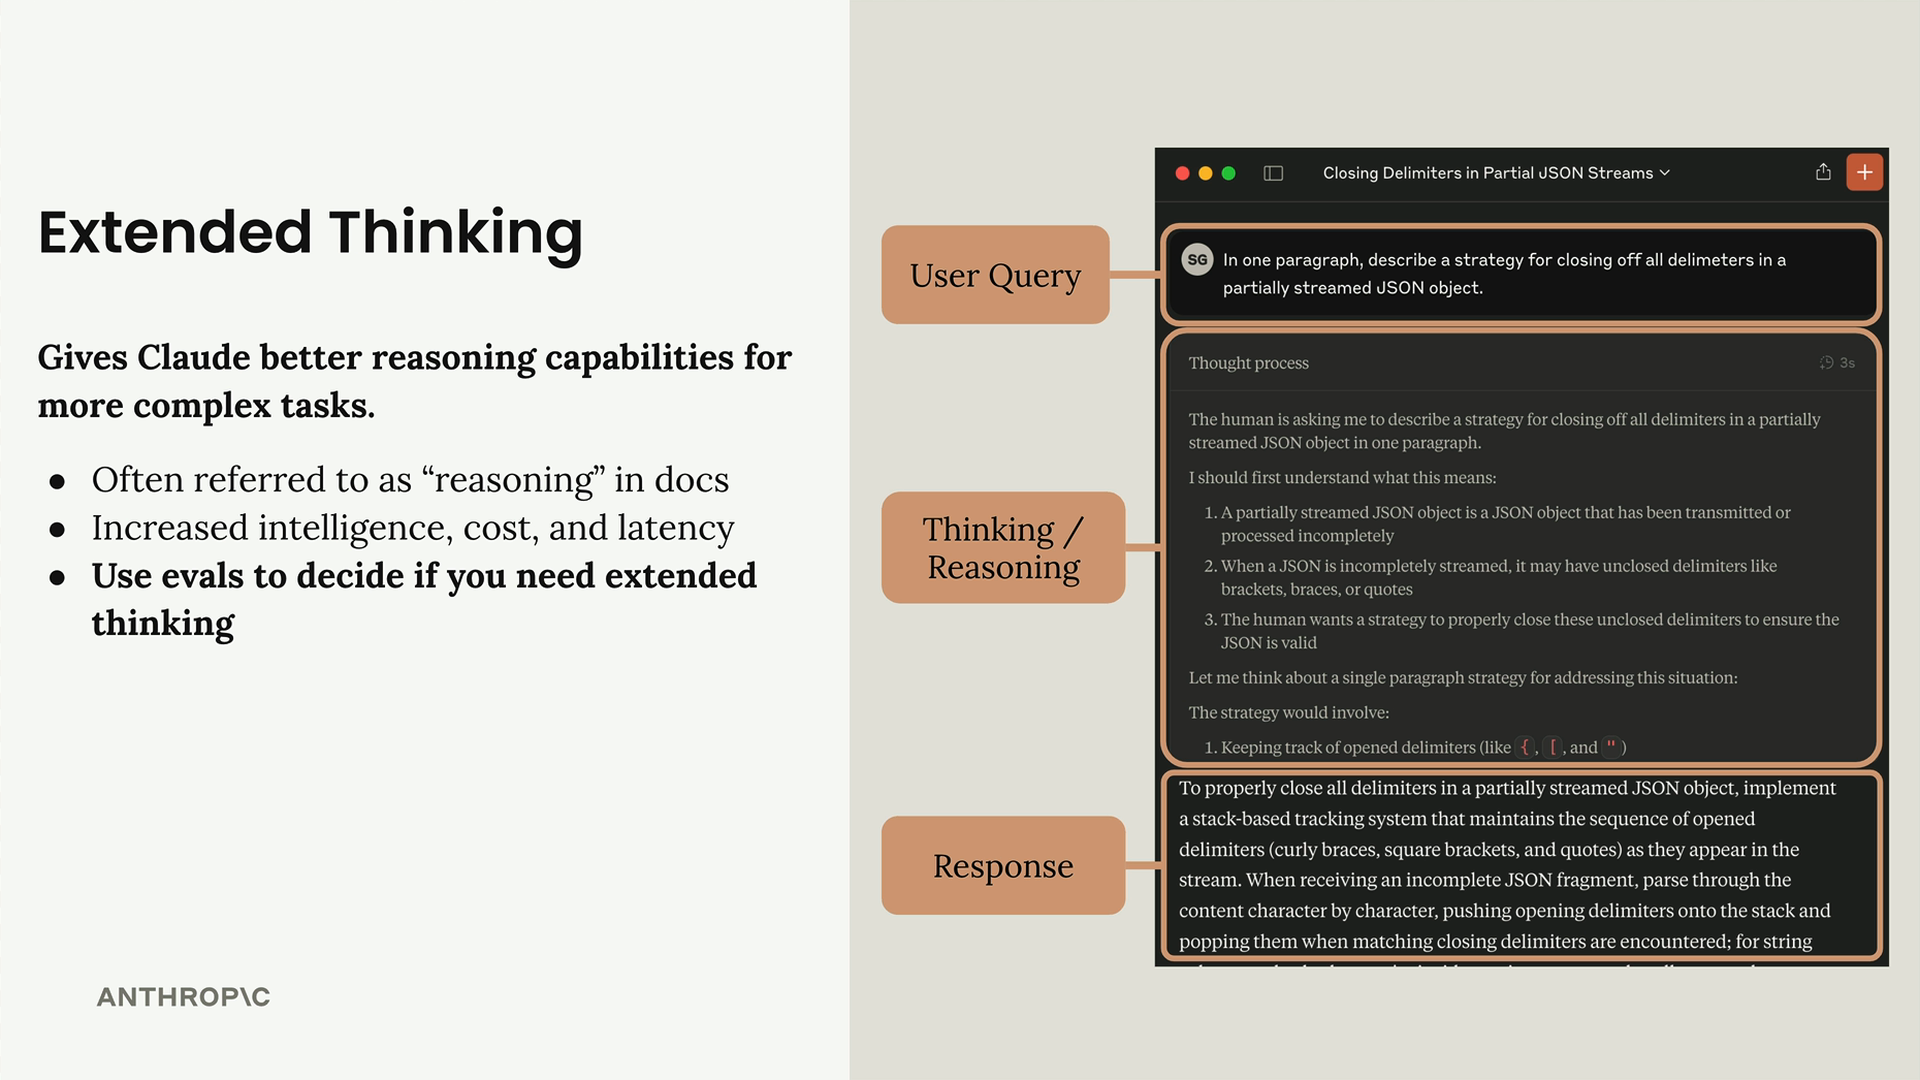
擴展思考如何運作
當您啟用擴展思考時,Claude 的回應會包含兩個部分,而不是一個:
- 推理內容部分——Claude 的內部思考過程
- 文字部分——您實際想要的最終回應
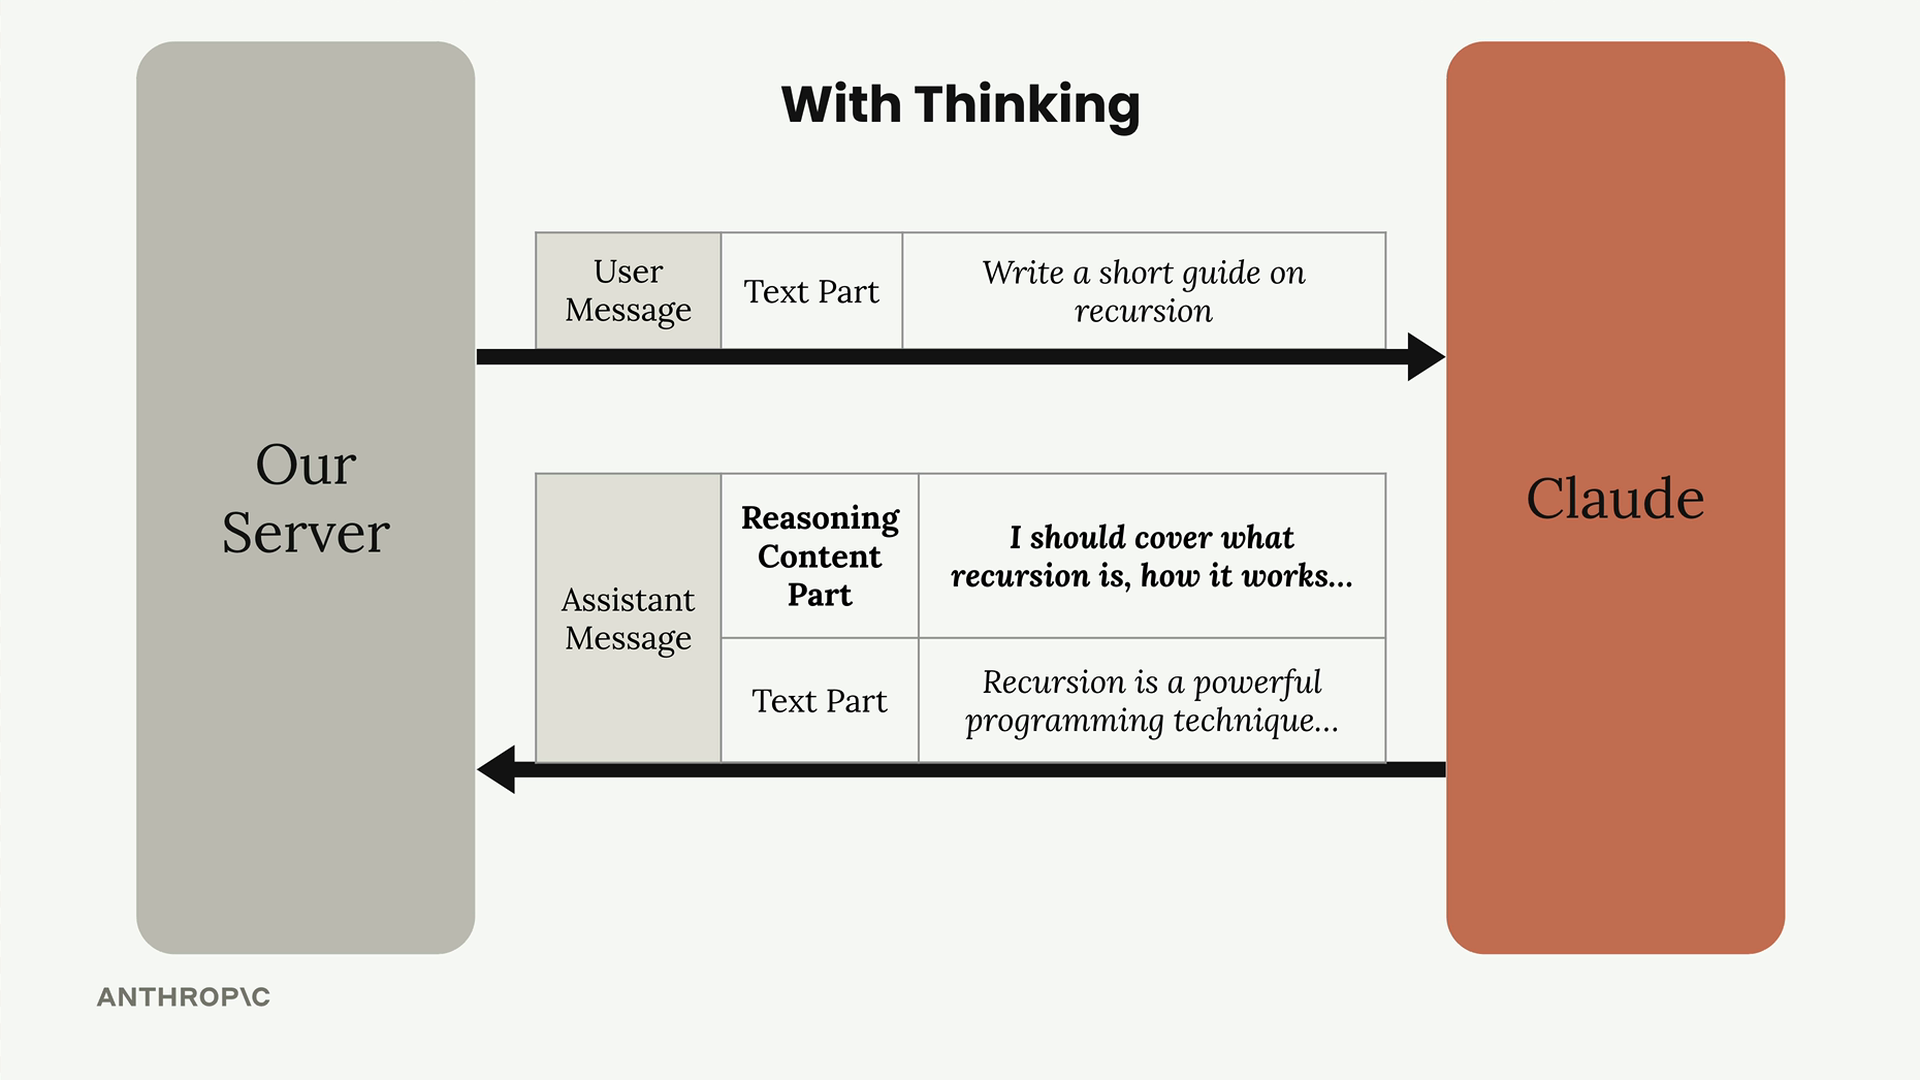
推理內容準確地向您展示了 Claude 如何分解您的問題、考慮了哪些因素,以及如何得出最終答案。這種透明度對於理解和除錯複雜任務來說極具價值。
需要考量的取捨
擴展思考具有明確的優點和成本:
- 在複雜任務上更高的準確度
- 更高的成本——您需要為所有思考 token 付費
- 增加的延遲——思考需要時間
關鍵的決策點很簡單:使用您的評估。如果您已經優化了提示,但仍然沒有獲得所需的準確度,那就是該考慮使用擴展思考的時候了。
簽章系統
您會立即注意到的一個重要細節是附加在推理內容上的加密簽章:
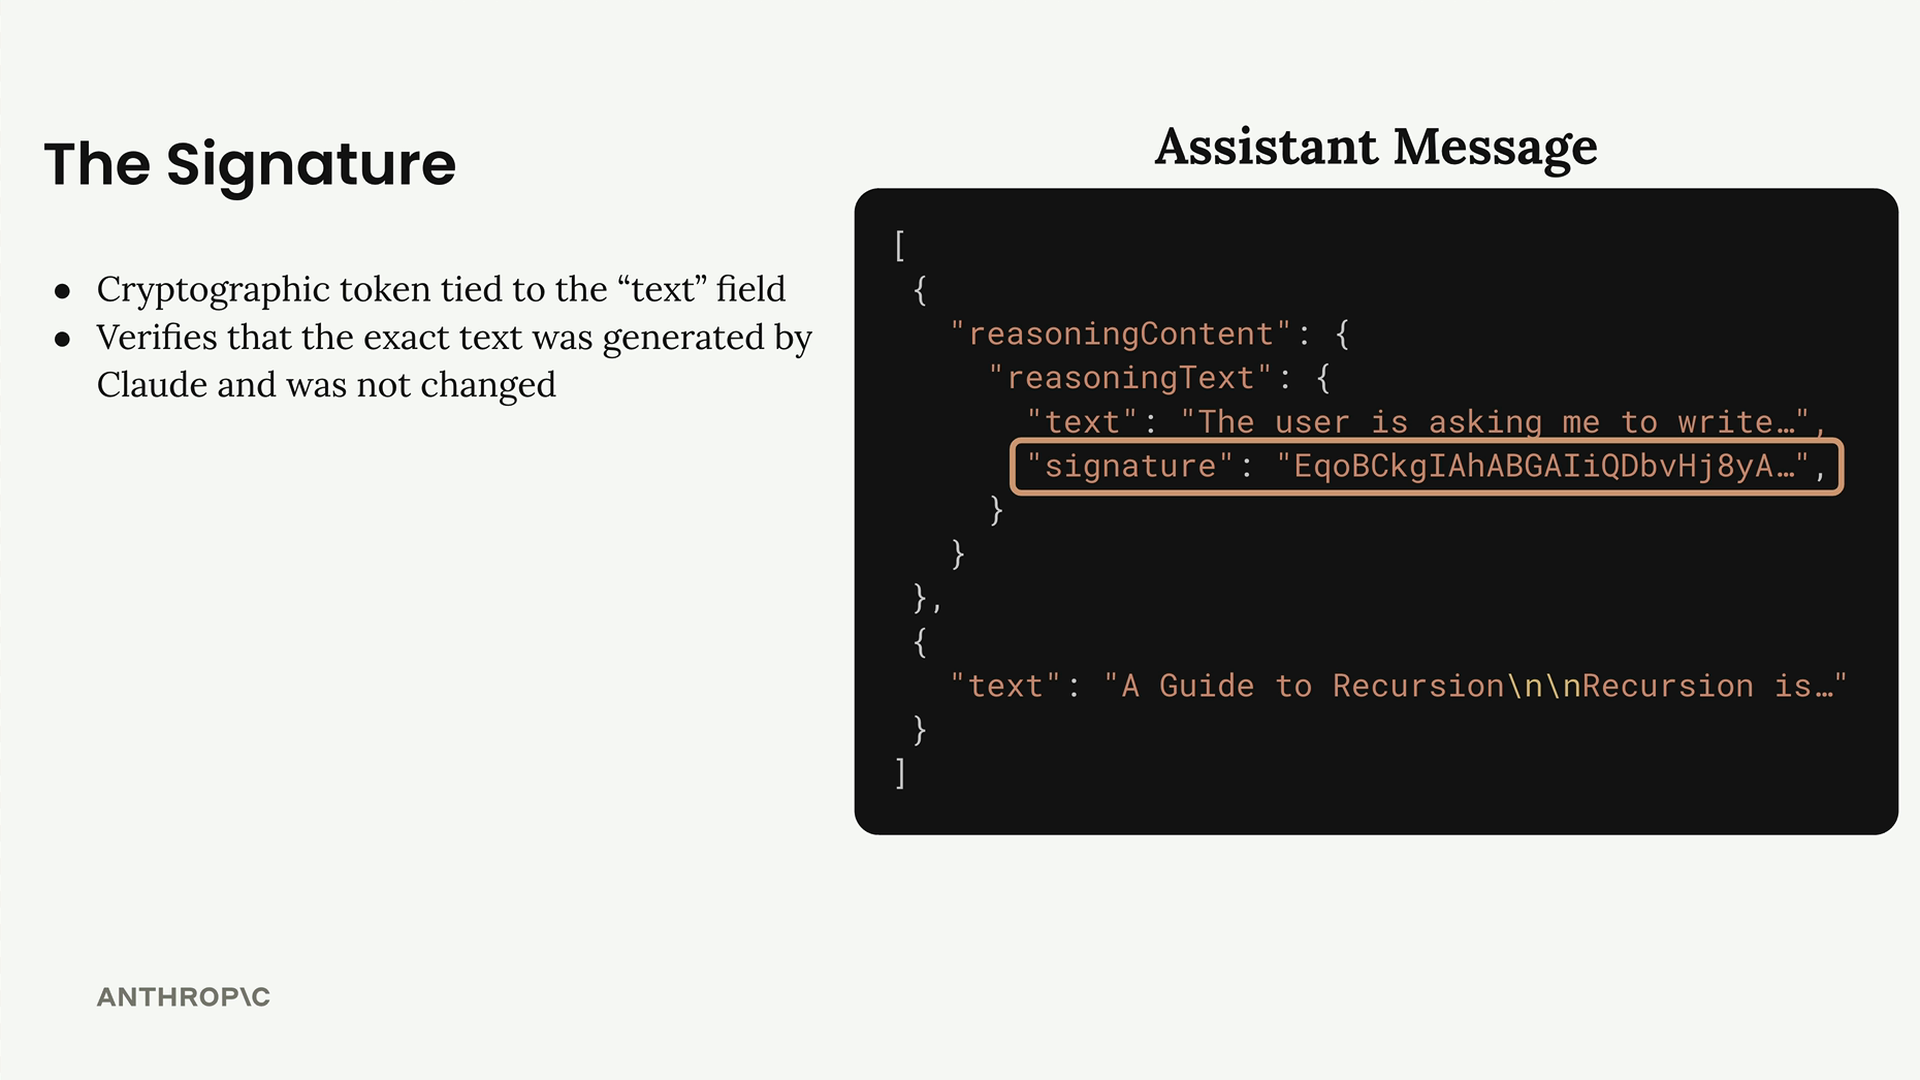
此簽章確保您無法修改思考文字。如果您想在後續對話中納入 Claude 先前的推理內容,此簽章會驗證內容未遭篡改。這可防止修改過的推理文字帶來潛在的安全問題。
經過編輯的內容
有時 Claude 的思考內容會被安全系統標記。發生這種情況時,您會收到一個 redactedContent 欄位,而不是可讀的思考文字:
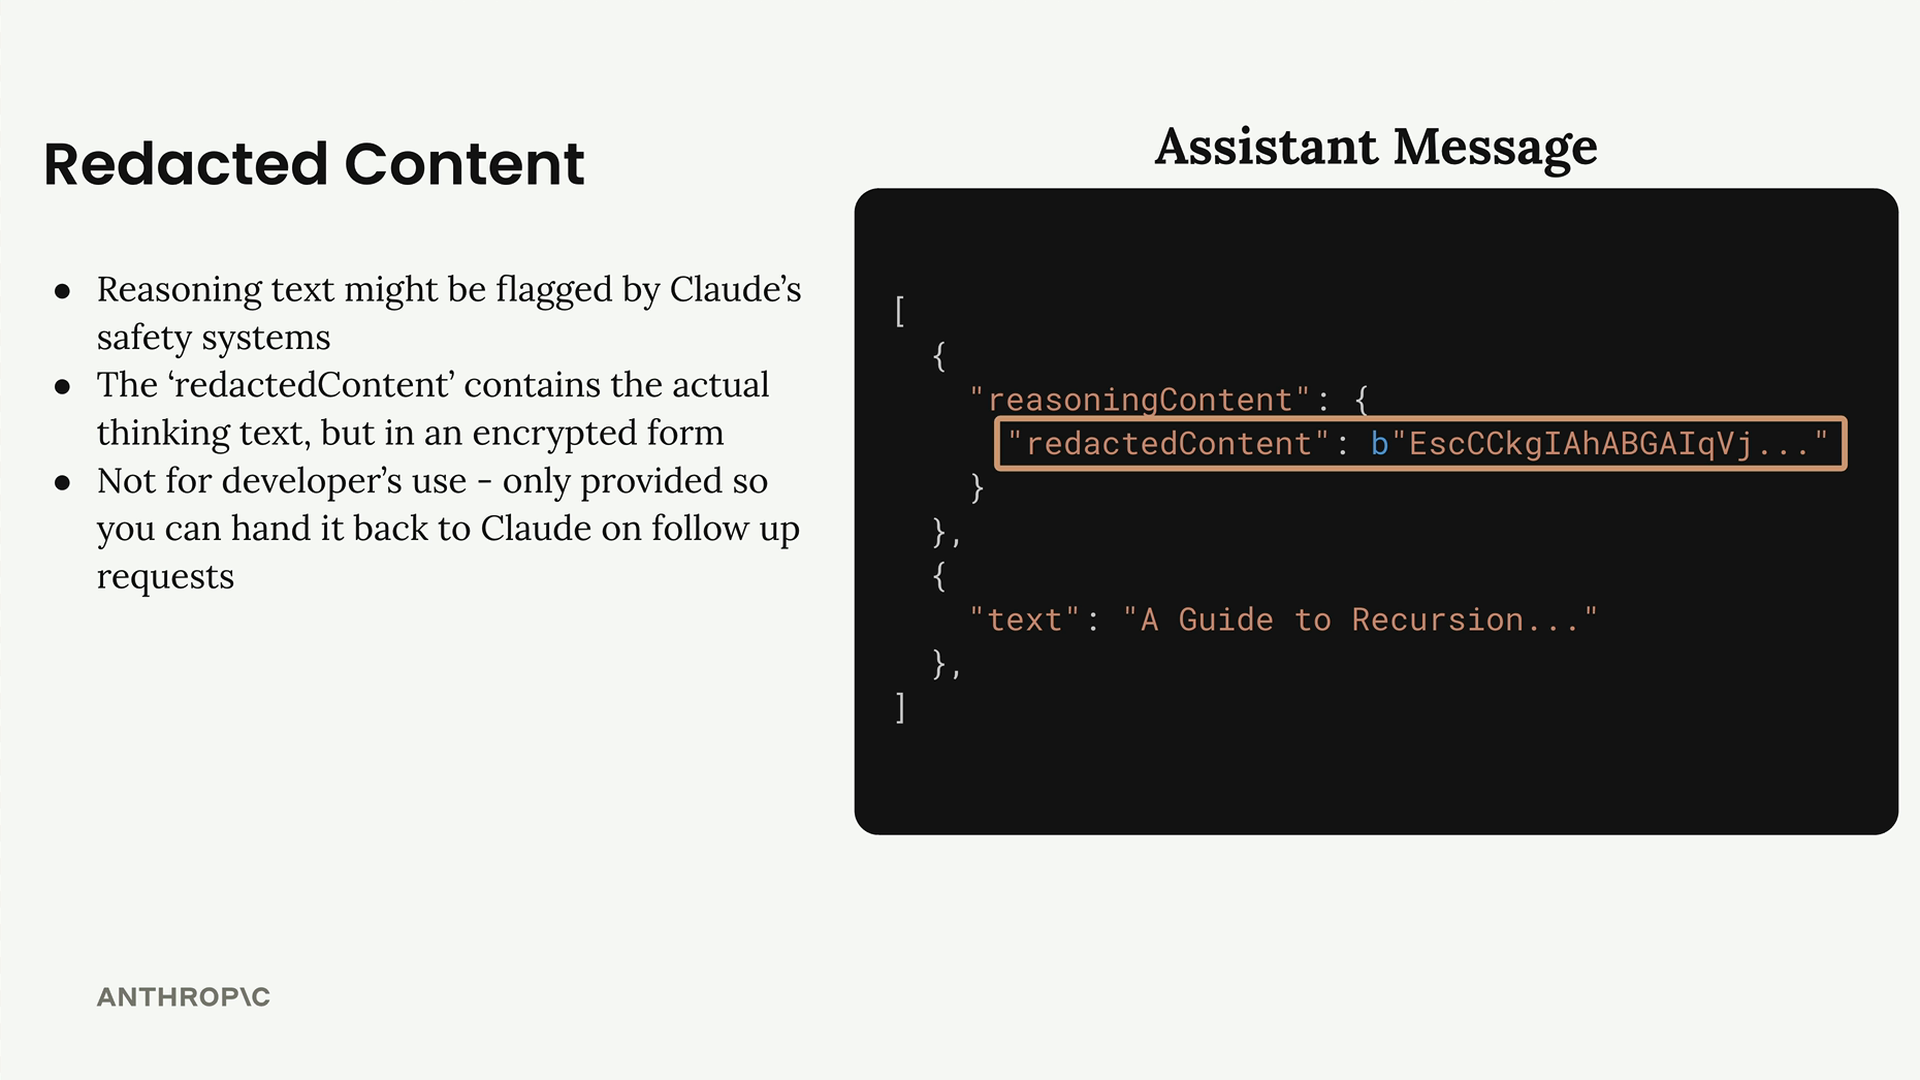
經過編輯的內容是加密的,但仍然可運作——您可以在未來的對話中將其傳回給 Claude,而不會失去脈絡。只是身為開發人員的您無法讀取它。
實作
在目前的 Claude 模型上,例如 Claude Opus 5 和 Claude Sonnet 5,思考是以自適應思考的方式執行,且預設為開啟:Claude 會自行決定每個請求需要多少推理,無需管理任何 token 預算。除非您要求,否則這些模型會省略推理文字,因此請將 display 設為 summarized 以查看它:
additional_model_fields["thinking"] = {
    "type": "adaptive",
    "display": "summarized"
}
啟用自適應思考後,簡單的問題通常會很快得到回應,而較困難的問題則會獲得更多的推理時間。若要引導 Claude 思考的程度,您可以將自適應思考與 effort 參數結合使用。努力程度的設定可作為 Claude 思考配置的軟性指引,取代您原本需要手動管理的 token 預算。
如果您以前使用過擴展思考,請注意手動設定正在逐步淘汰:thinking.type: "enabled" 搭配 budget_tokens 在 Claude Opus 4.6 和 Claude Sonnet 4.6 上已被棄用,而 Claude Opus 4.7 及更新版本的模型(包括 Claude Opus 5 和 Claude Sonnet 5)不再支援此功能,並會以 400 錯誤拒絕此類請求。請改用 thinking.type: "adaptive" 搭配 effort 參數。
不具備自適應思考的模型
Claude 4.5 系列模型(Claude Haiku 4.5、Claude Sonnet 4.5 和 Claude Opus 4.5)及更早的模型不支援自適應思考。在這些模型上,您需要透過手動設定 token 預算來啟用擴展思考:
additional_model_fields["thinking"] = {
    "type": "enabled",
    "budget_tokens": thinking_budget
}
thinking_budget 控制 Claude 可以花在推理上的 token 數量。最小值為 1024 個 token,但對於複雜問題,您可能需要更多。就像使用 Claude 的其他一切一樣,請使用您的評估來為您的使用情境找出合適的預算。
以下是更新後的聊天函式外觀:
def chat(
    messages,
    system=None,
    temperature=1.0,
    stop_sequences=[],
    tools=None,
    tool_choice="auto",
    text_editor=None,
    thinking=False,
    thinking_budget=1024
):
測試您的實作
在建構處理擴展思考的應用程式時,您會想要測試一般推理內容和經過編輯的內容這兩種情境。實際上有一個特殊的測試字串,可以強制 Claude 回傳經過編輯的內容——這對於確保您的程式碼能正確處理這兩種情況很有幫助。
關於擴展思考,最重要的收穫是:是否使用它的決定應該始終基於數據。先執行您的評估,優化您的提示,只有在複雜任務需要額外的準確度提升時,才考慮使用擴展思考。這種紀律仰賴一個簡單的習慣:在追求更強大的能力之前,先決定什麼才算是「好」。當您知道任務所需的準確度時,您就能判斷擴展思考是否值得其成本,而不是憑空猜測。
練習:親自執行自適應思考
觀察自適應思考做決策的過程,是理解它最簡單的方式。在您一直在建構聊天函式的程式碼中,將它開啟:
additional_model_fields["thinking"] = {
    "type": "adaptive",
    "display": "summarized"
}
現在透過這個相同的設定傳送兩個請求。首先問一個您已經知道答案的簡單事實性問題。然後問一個真正困難的問題,例如您自己工作中的多步驟分析問題。如果您使用的模型不支援自適應思考,請使用上一節中的手動 budget_tokens 設定來啟用思考,並執行相同的兩個請求。
檢查思考的結果
設定旗標只能證明請求被接受。以下這些檢查能告訴您思考實際做了什麼:
- 確認思考已啟動。 每個回應現在應該包含兩個部分——推理內容和最終文字,而不僅僅是文字。唯一的例外是您之前看到的經過編輯的內容:
redactedContent欄位表示思考已執行,但文字已加密。 - 閱讀推理內容。 檢查它是否真正針對您提出的問題進行推理,而不只是重述問題。這正是您日後除錯複雜任務時所仰賴的同一種透明度。
- 比較這兩個請求。 簡單的問題通常會很快得到回應,且推理內容較少,而困難的問題則會得到明顯更多的推理內容。這種差異正是自適應思考為您做出配置決策的體現。
- 權衡成本。 您需要為每個思考 token 付費,因此請檢查較困難的答案是否比不使用思考時得到的結果更好。您的評估才是判斷的依據,光是看到推理文字出現並不能取代它們。
值得從本課程保留的行為是:每當您在新任務上啟用擴展思考時,先在幾個具代表性的請求上閱讀推理內容,並重新執行您的評估,然後再決定是否保留此設定。