載入中
將文件分割成區塊之後,RAG 管線的下一步是找出哪些區塊與使用者的問題最相關。這基本上是一個搜尋問題——您需要瀏覽所有的文字區塊,並找出與使用者所詢問內容相關的那些。
尋找相關區塊
挑戰在於判斷哪些區塊與使用者的問題「相關」。這不像關鍵字比對那麼簡單——您需要理解問題和區塊兩者的含義與脈絡。
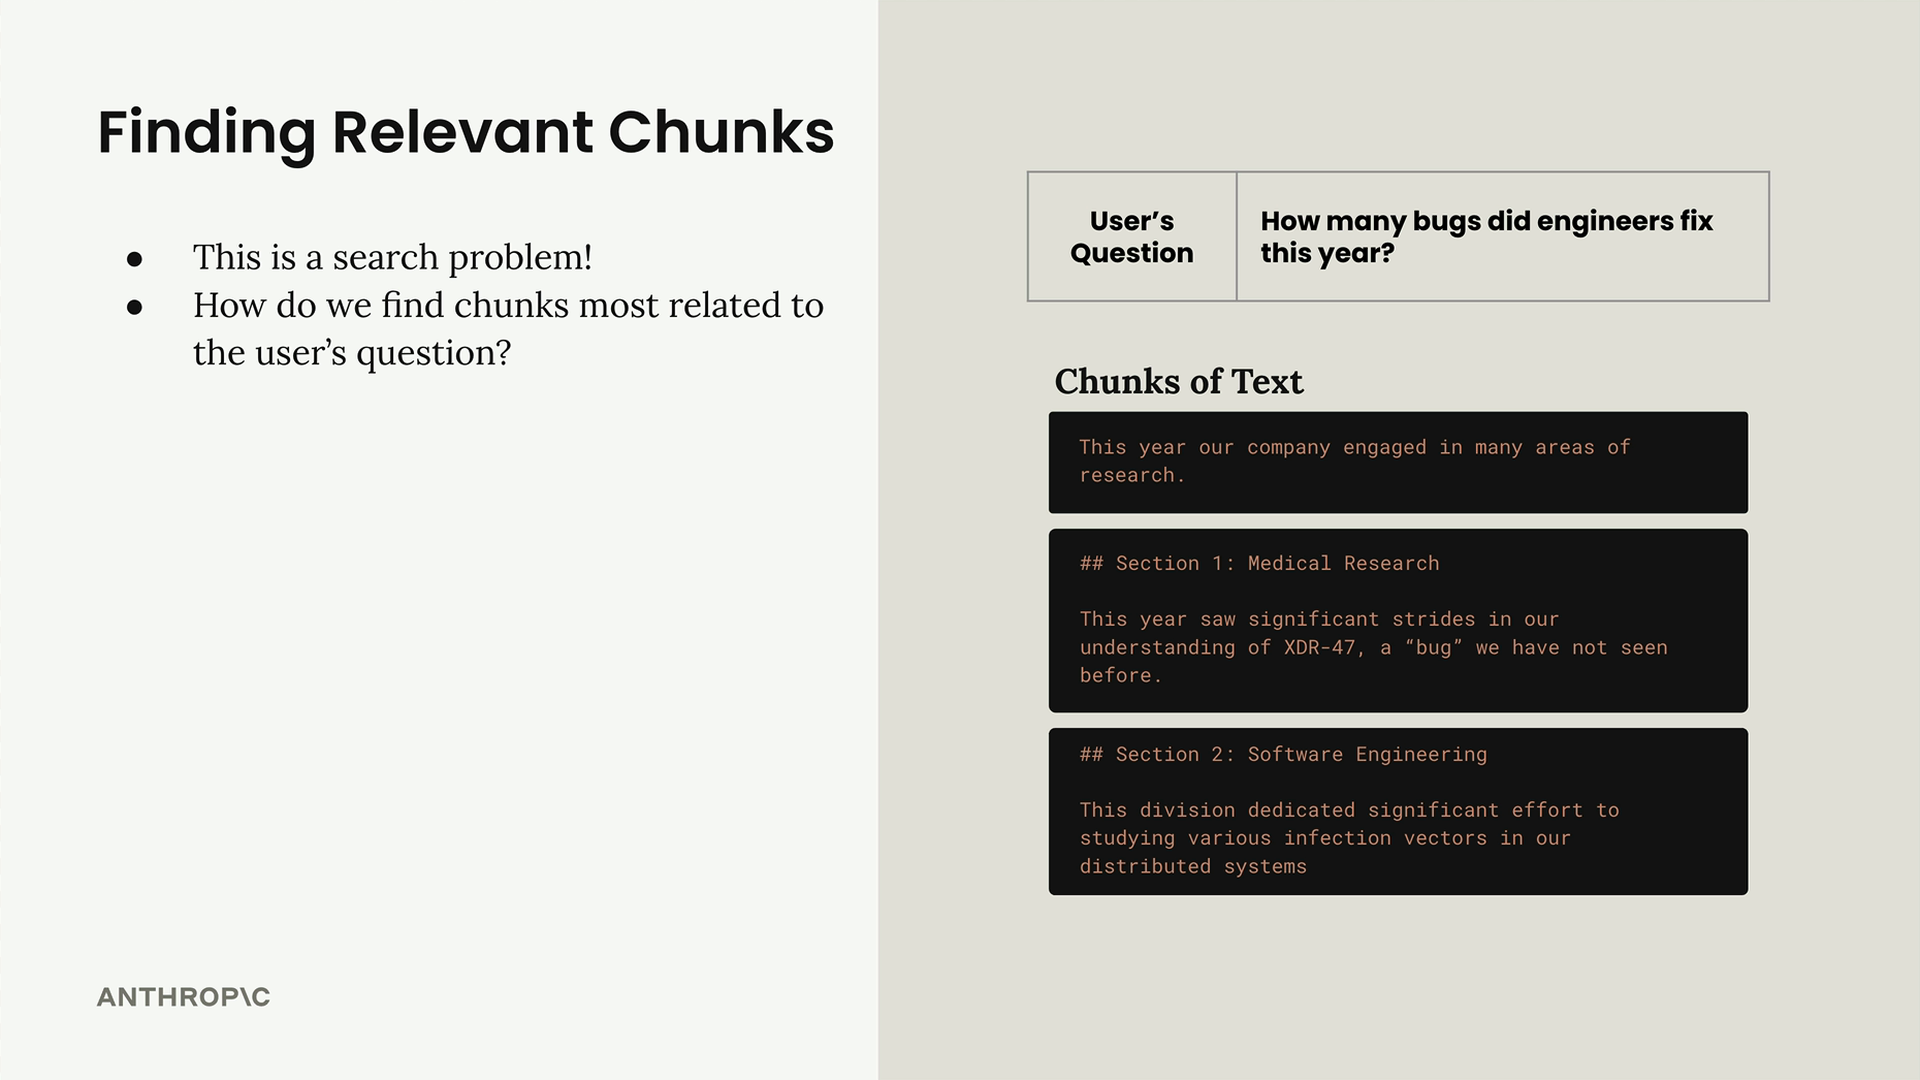
最常見的解決方案是語意搜尋,它使用文本嵌入來理解每段文字實際上在講什麼,而不只是尋找完全相符的字詞。
什麼是文本嵌入?
文本嵌入是某段文字所包含意義的數值表示。可以將其想成是把文字和句子轉換成電腦可以進行數學運算的格式。
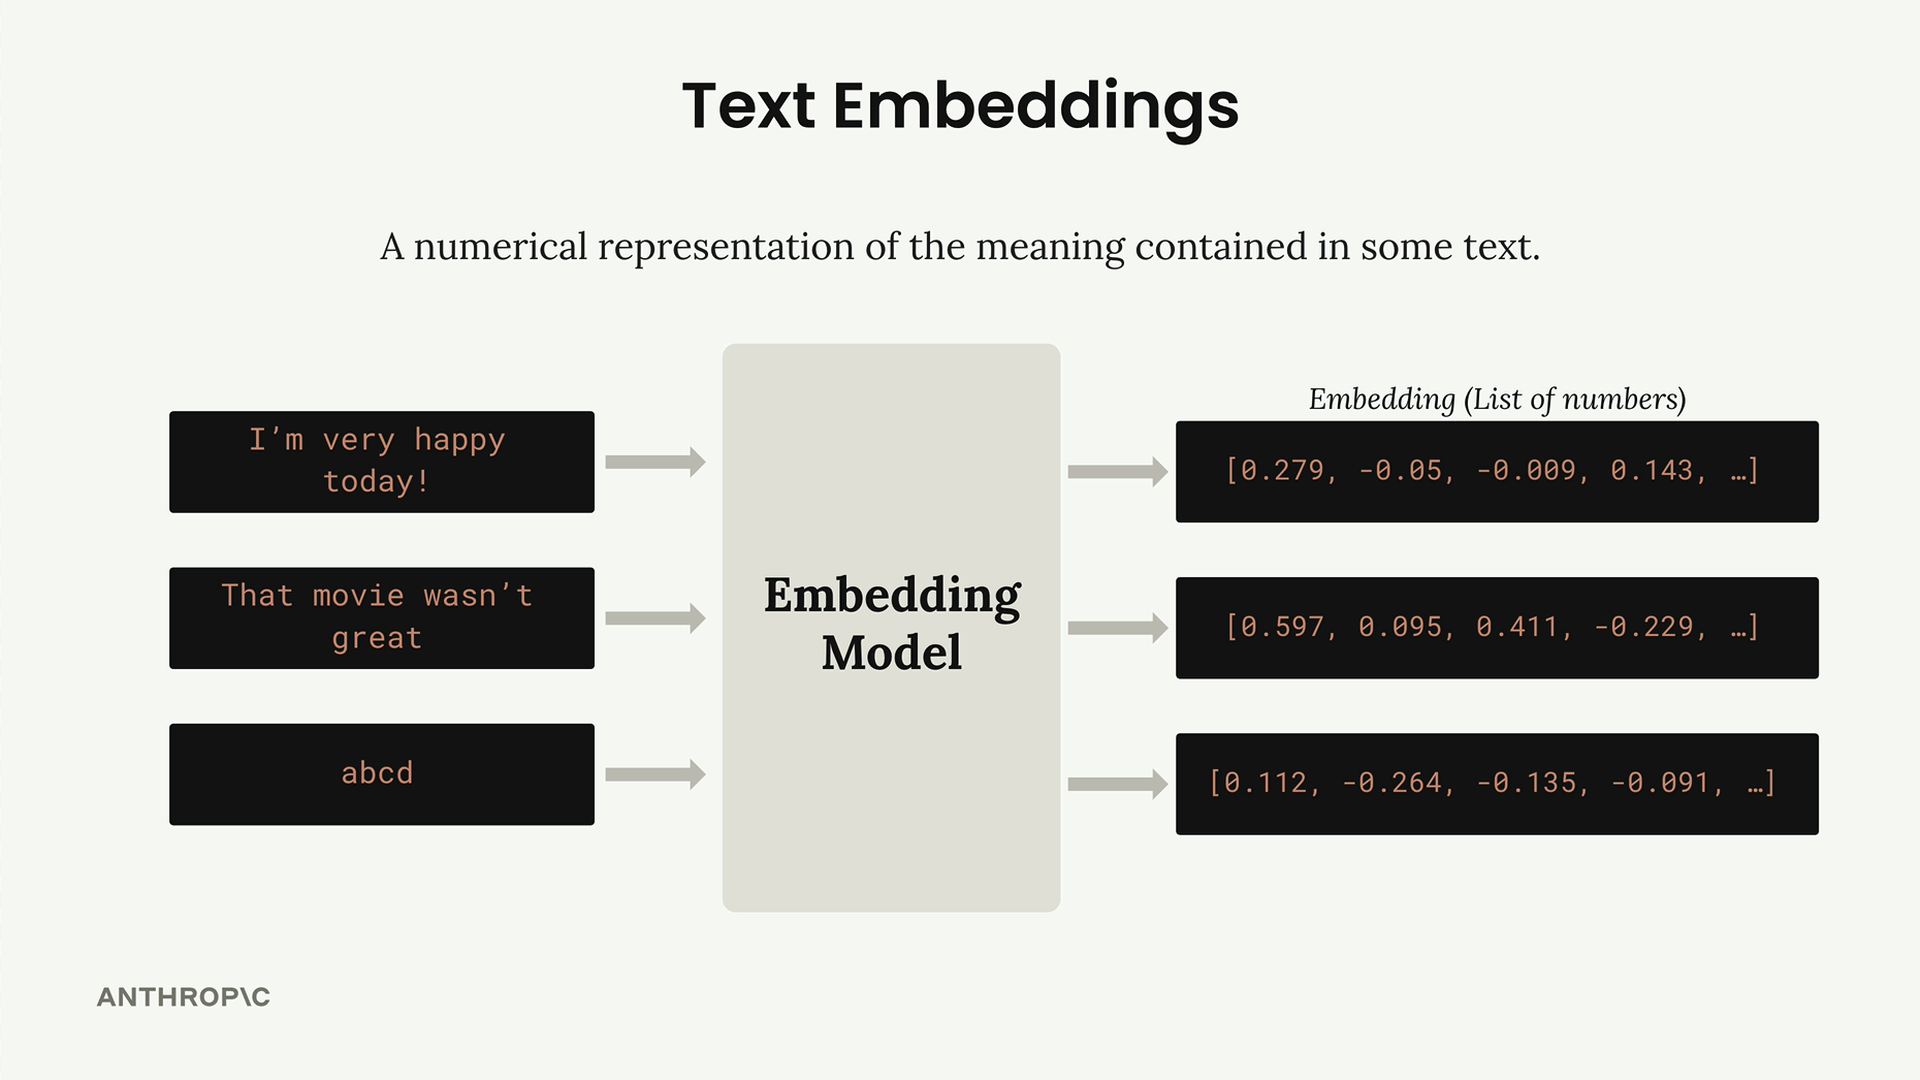
運作方式如下:
- 您將文字輸入嵌入模型
- 模型會輸出一長串數字(通常是 1024 個數字)
- 每個數字代表輸入文字某項特質的「分數」
- 這些數字的範圍是 -1 到 +1
理解這些數字
嵌入中的每個數字就像是文字某個面向的分數。雖然我們不確切知道每個位置代表什麼,但把它們想成是在測量不同的特質會有所幫助。
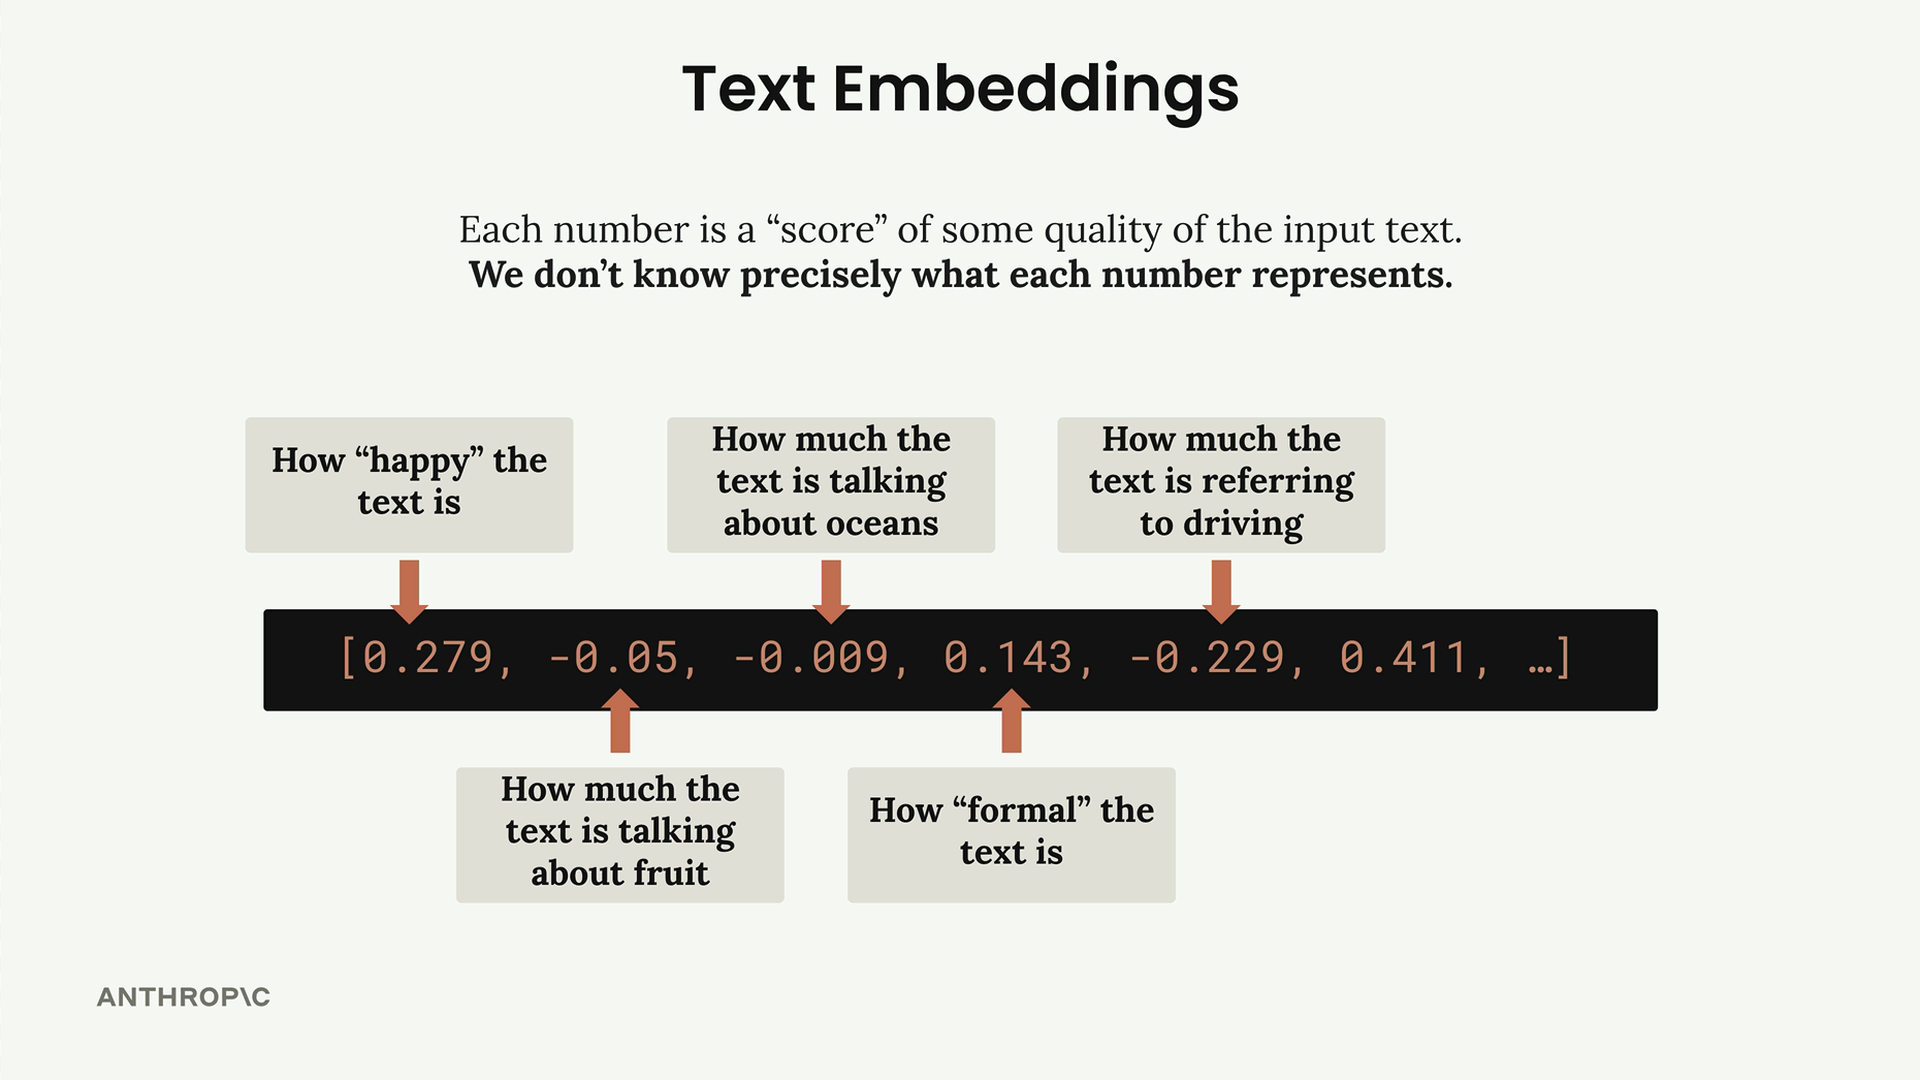
舉例來說,其中一個數字可能是為「文字有多快樂」評分,而另一個數字可能是在測量「文字談論海洋的程度」。關鍵在於,我們實際上並不知道每個數字代表什麼——嵌入模型是在訓練過程中學會這些模式的,而且這些並非人類可以直接解讀的。
用程式碼產生嵌入
建立嵌入的方式很直接。以下是基本流程:
python
def generate_embedding(
    text,
    embedding_model_id="amazon.titan-embed-text-v2:0",
    dimensions=1024,
    normalize=True,
):
    request_body = {
        "inputText": text,
        "dimensions": dimensions,
        "normalize": normalize,
    }

    request_json = json.dumps(request_body)
    response = client.invoke_model(
        modelId=embedding_model_id,
        body=request_json,
        accept="application/json",
        contentType="application/json",
    )

    response_body = json.loads(response.get("body").read())
    return response_body["embedding"]
當您對一個文字區塊執行這個函式時,您會得到一個由 1024 個數字組成的列表,代表該文字的語意。
請注意,您可能需要在 AWS Bedrock 主控台中申請存取 Titan 嵌入模型的權限。如果第 2 版無法使用,第 1 版在學習用途上同樣效果良好。
為什麼嵌入對 RAG 很重要
當您意識到相似的文字會有相似的嵌入數值時,嵌入的威力就顯而易見了。這代表您可以用數學方式將使用者的問題與您的文件區塊進行比較,並找出語意上最相似的那些——即使它們並沒有使用完全相同的詞語。
這種數值表示正是讓語意搜尋成為可能的關鍵,而且在 RAG 系統中尋找相關內容時,它遠比簡單的關鍵字比對更有效。