載入中
基於程式碼的評分為您的提示評估增添了額外的驗證層,用於檢查模型輸出是否遵循正確的格式並具有有效的語法。當您要求模型生成程式碼、JSON 或正規表達式時,這特別有用。
程式碼評分的運作方式
程式碼評分器評估兩個主要標準:
- 格式合規性 - 輸出是否只包含所要求的格式(Python、JSON 或正規表達式)而沒有任何解釋?
- 有效語法 - 輸出是否真的能夠成功解析或編譯?
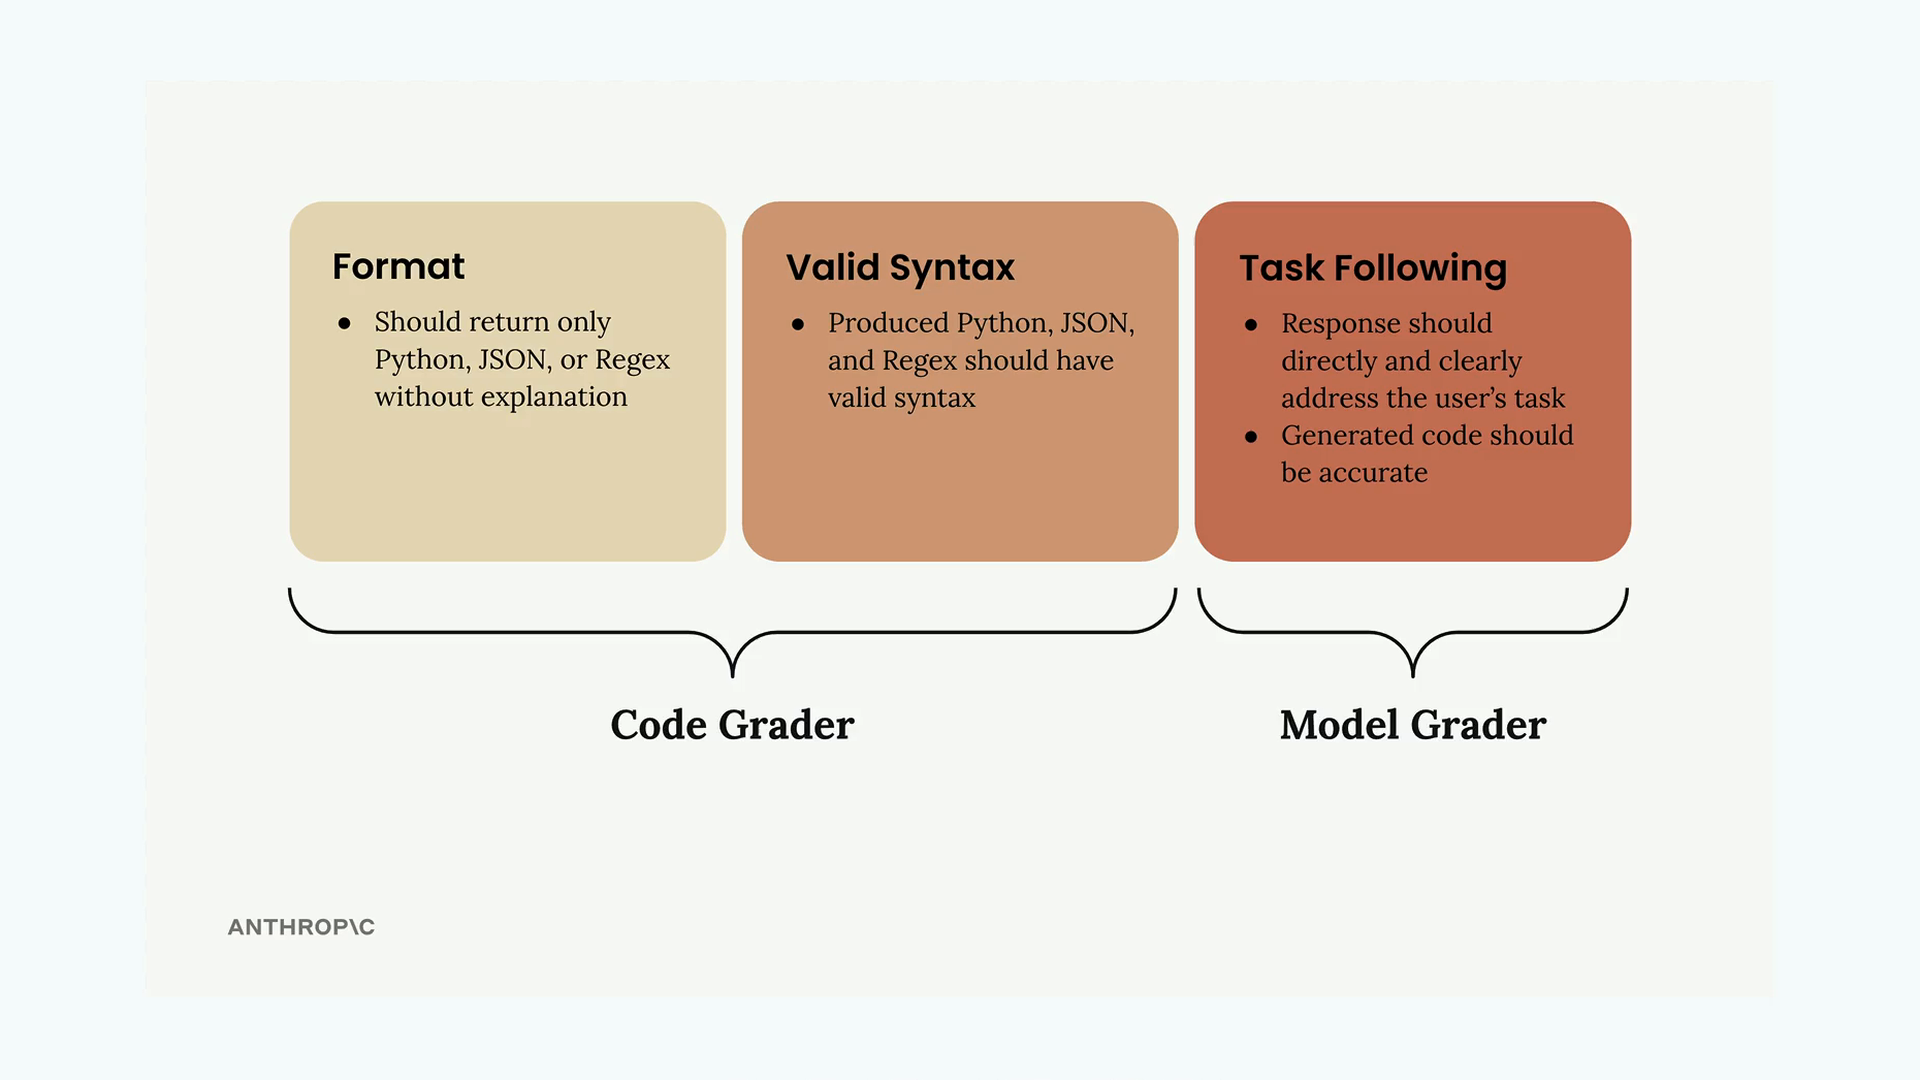
系統針對每種格式類型使用獨立的驗證函式。如果程式碼成功解析,就會獲得滿分 10 分。如果解析時出現錯誤,就會得到 0 分。
設定驗證函式
您需要三個輔助函式來驗證不同的輸出類型:
python
import ast
import json
import re

def validate_json(text):
    try:
        json.loads(text.strip())
        return 10
    except json.JSONDecodeError:
        return 0

def validate_python(text):
    try:
        ast.parse(text.strip())
        return 10
    except SyntaxError:
        return 0

def validate_regex(text):
    try:
        re.compile(text.strip())
        return 10
    except re.error:
        return 0
這些函式使用 Python 內建的解析功能來檢查語法有效性。json.loads() 函式驗證 JSON,ast.parse() 建立 Python 抽象語法樹,而 re.compile() 則驗證正規表達式。
為測試案例加入格式資訊
您的測試資料集需要為每個任務指定預期的輸出格式。請更新您的資料集生成提示,加入一個 format 欄位:
json
{
    "task": "Description of task",
    "format": "python"
}
format 欄位應包含「json」、「python」或「regex」,具體取決於您期望該特定任務輸出的類型。
改善您的提示
為了從程式碼評分器取得更好的結果,請讓您的提示指令更加具體:
* Respond only with Python, JSON, or a plain Regex
* Do not add any comments or commentary or explanation您也可以使用帶有程式碼區塊和停止序列的預先填入助手訊息,以確保輸出格式乾淨整潔。
合併分數
首先,挑選符合每個測試案例的驗證器:
python
def grade_syntax(output, test_case):
    if test_case["format"] == "json":
        return validate_json(output)
    if test_case["format"] == "python":
        return validate_python(output)
    return validate_regex(output)
最後一步是將您的模型評分器分數與語法評分器分數合併。一種簡單的方法是在 run_test_case 內取兩個分數的平均值:
python
model_grade = grade_by_model(test_case, output)
model_score = model_grade["score"]
syntax_score = grade_syntax(output, test_case)

score = (model_score + syntax_score) / 2
這讓內容品質(來自模型評分器)和技術正確性(來自程式碼評分器)獲得同等的權重。您可以根據對您特定使用案例而言何者更為重要,來調整這個權重分配。
解讀結果
執行評估後,您會得到一個綜合分數,反映出所生成程式碼的語意品質和技術正確性。請記住,單獨一個分數本身並不能告訴您太多資訊——真正的價值在於隨著您迭代提示設計時,比較這些分數的變化。
使用這個基準分數來測試提示的改進,看看您的變更是否真的能帶來更好、更可靠的程式碼生成。