在建構 RAG 管線時,您很快就會發現,僅靠語義搜尋並不總能返回最佳結果。有時您需要精確的關鍵字匹配,而這正是語義搜尋可能會遺漏的。解決方案是使用一種稱為 BM25 的技術,將語義搜尋與詞彙搜尋結合起來。
僅使用語義搜尋的問題
假設您要在文件中搜尋特定的事件 ID,例如「INC-2023-Q4-011」。雖然這個確切的詞彙在相關章節中多次出現,但語義搜尋可能會返回看似語義相似但實際上不包含您所需特定資訊的不相關章節。
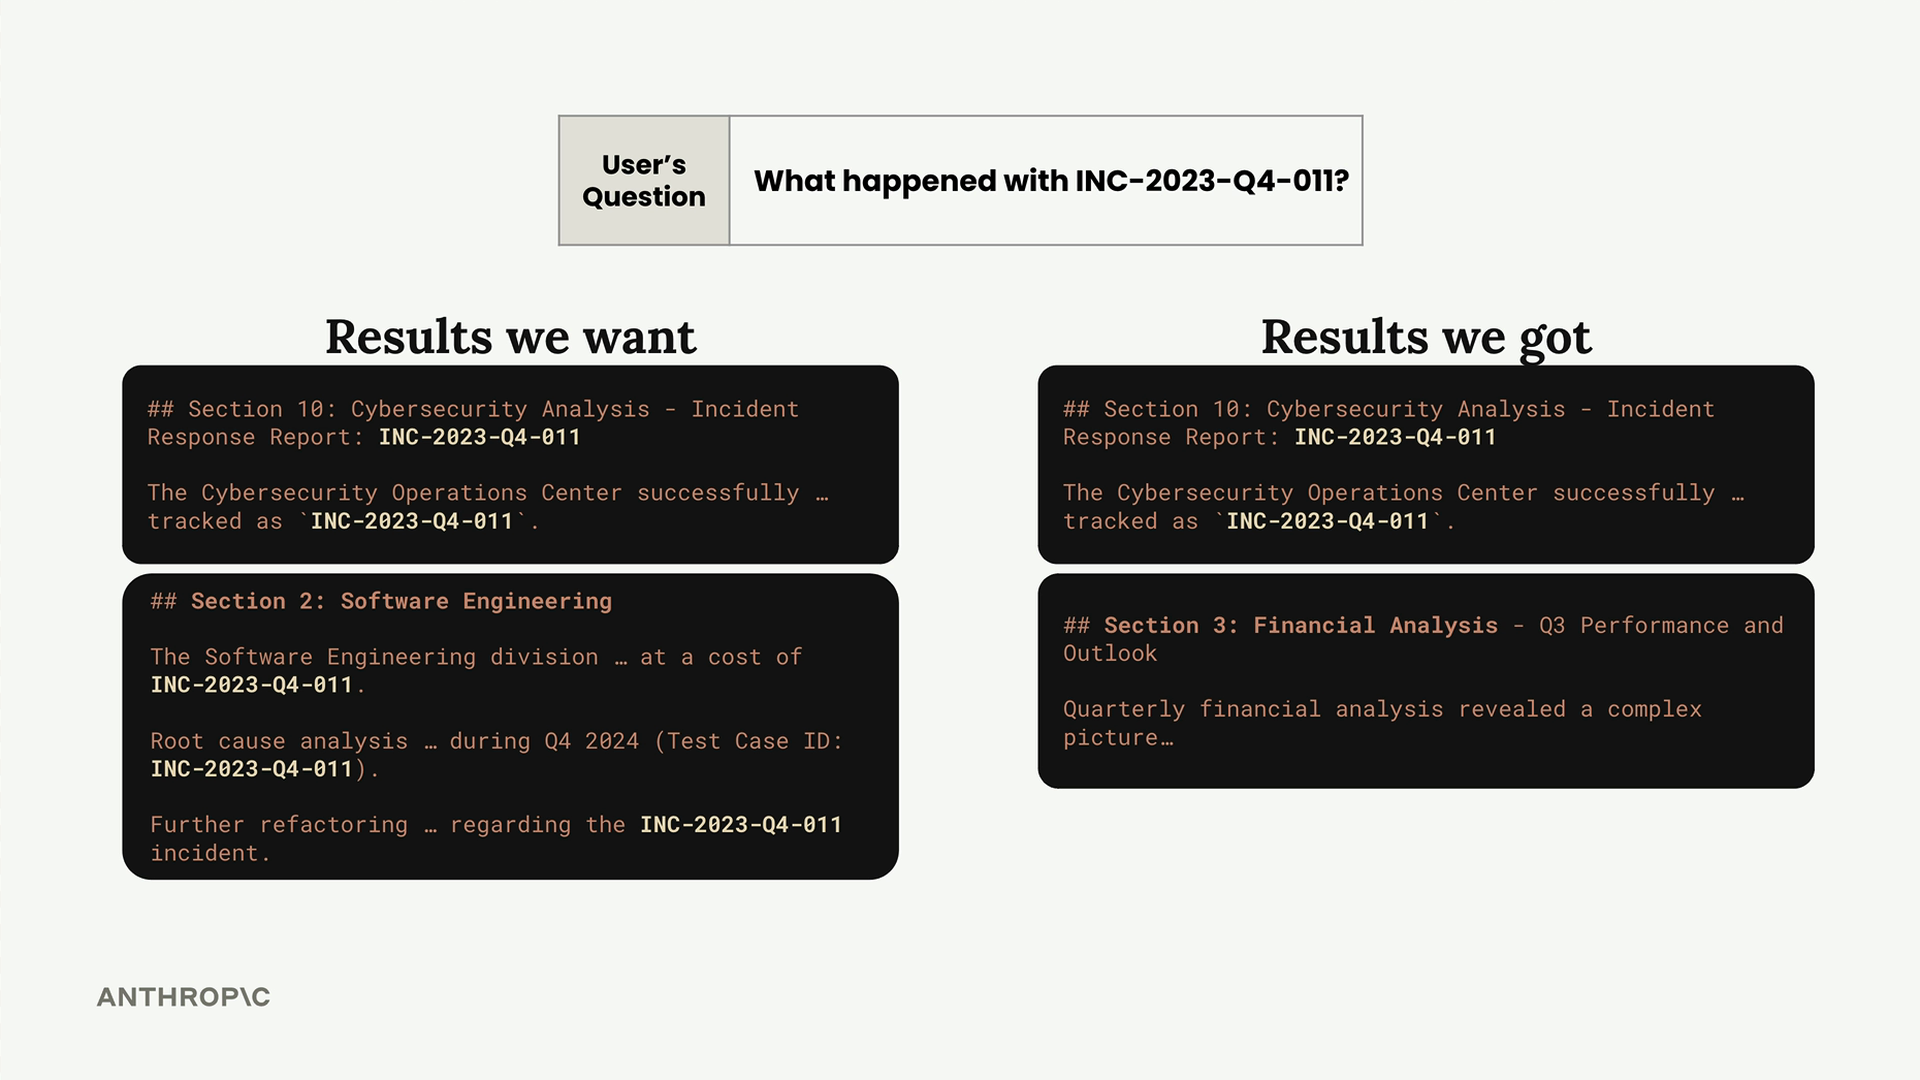
這是因為語義搜尋著重於意義而非精確的文字匹配。當您需要精確的關鍵字匹配時,就需要一種不同的方法。
混合搜尋策略
解決方案是並行執行語義搜尋和詞彙搜尋,然後合併結果。這樣可以兼顧兩者的優點:
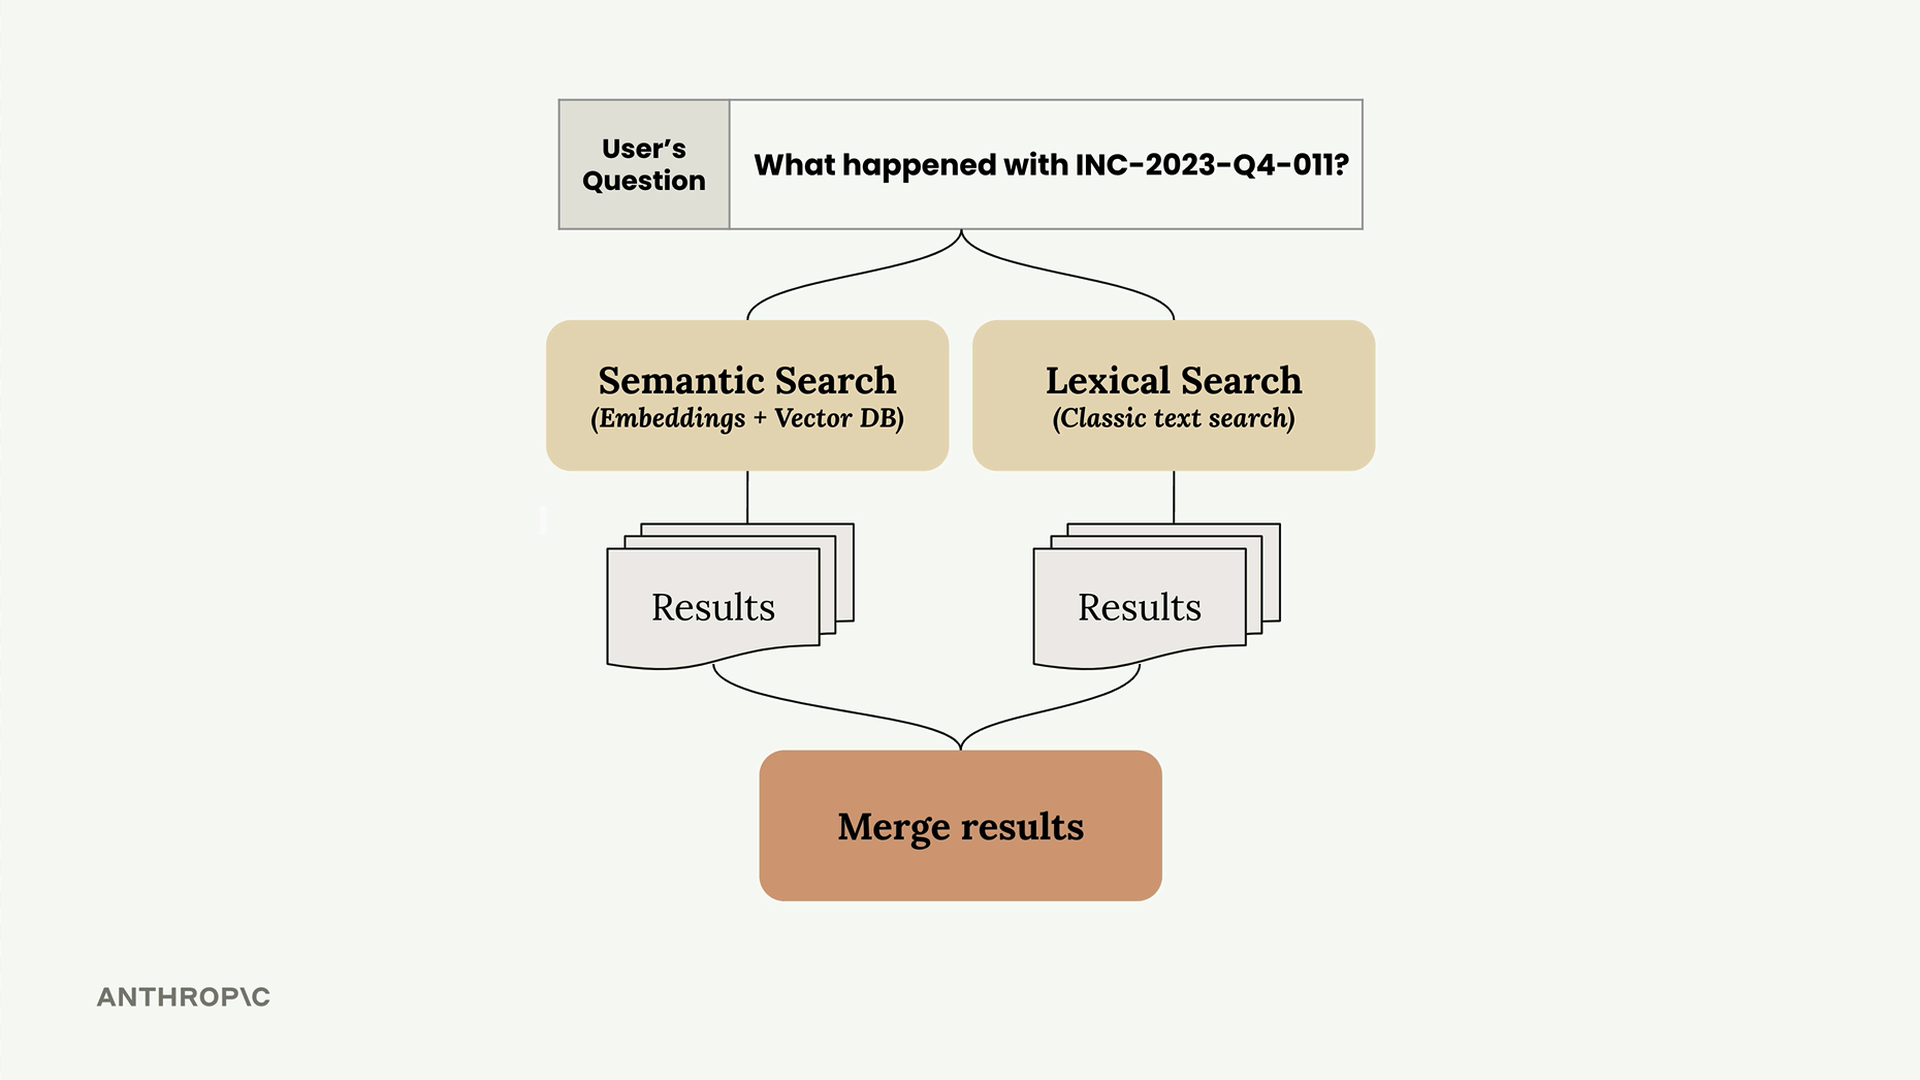
- 語義搜尋 - 使用嵌入來尋找概念上相關的內容
- 詞彙搜尋 - 使用傳統文字搜尋來尋找精確的關鍵字匹配
- 合併結果 - 結合兩種方法以獲得更好的整體相關性
BM25 的運作方式
BM25(Best Match 25)是 RAG 管線中用於詞彙搜尋的熱門演算法。以下是它處理搜尋查詢的方式:
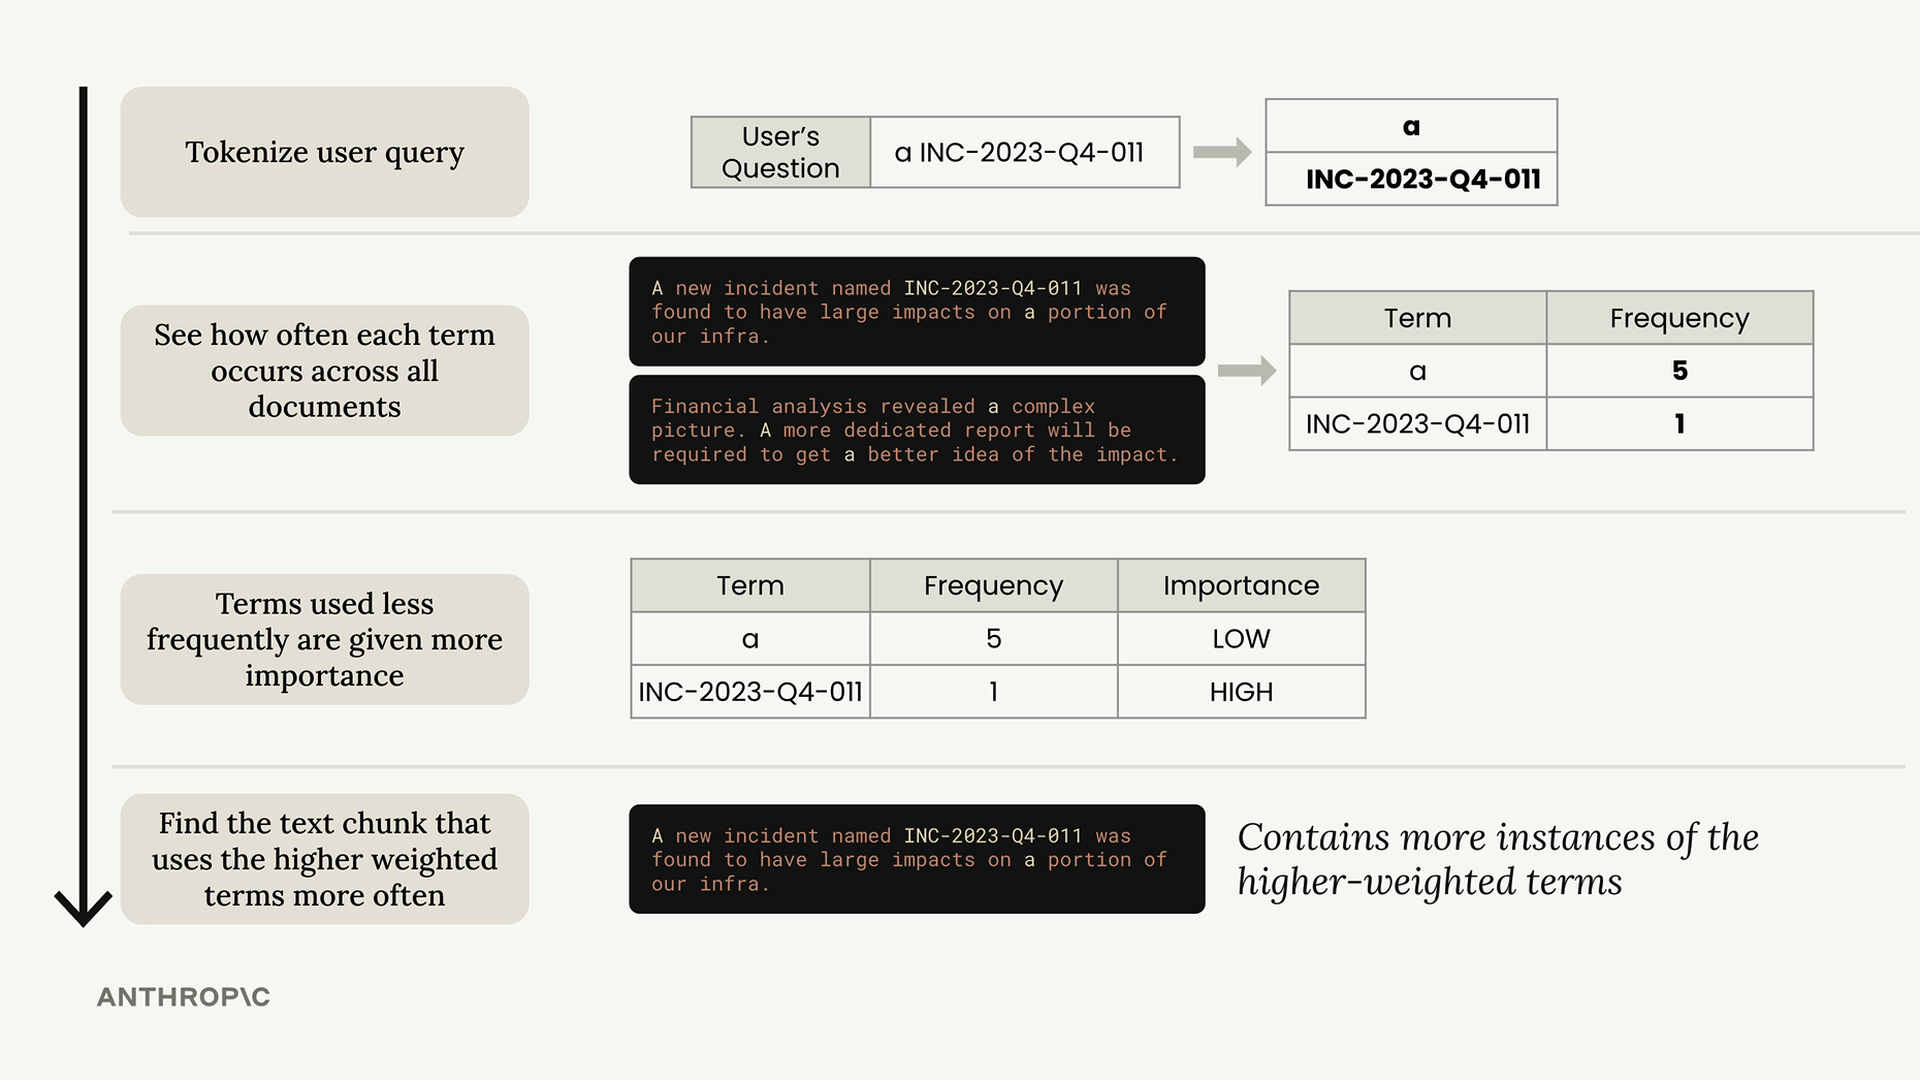
此演算法遵循以下關鍵步驟:
- 對查詢進行分詞 - 將使用者的問題拆分為個別詞彙
- 計算詞頻 - 查看每個詞彙在所有文件中出現的頻率
- 依稀有程度為詞彙加權 - 使用頻率較低的詞彙會獲得較高的重要性分數
- 為文件評分 - 找出包含較多高權重詞彙實例的文字區塊
關鍵洞見在於,像「INC-2023-Q4-011」這樣的稀有詞彙,在搜尋相關性上比「a」或「the」這類常見詞彙重要得多。
實作 BM25 搜尋
以下是如何建立 BM25 搜尋系統:
# 建立 BM25 儲存庫
store = BM25Index()

# 將文件加入儲存庫
for chunk in chunks:
    store.add_document({"content": chunk})

# 搜尋儲存庫
results = store.search("What happened with INC-2023-Q4-011?", 3)
BM25 的實作維持了與您的向量儲存區相似的 API,具備 add_document() 和 search() 方法。這種一致性使得同時使用這兩個系統變得容易。
更好的搜尋結果
當您對單靠語義搜尋失敗的相同查詢執行 BM25 時,會得到好得多的結果。該演算法能正確地優先處理包含精確事件 ID 的章節,將它們排在那些可能語義相關但不包含您所要尋找的特定詞彙的章節之前。
現在,搜尋結果能正確地顯示實際討論該事件的 Software Engineering 章節和 Cybersecurity 章節,而不是返回像 Financial Analysis 這樣不相關的內容。
後續步驟
既然您已經讓語義搜尋和詞彙搜尋系統獨立運作,下一步就是合併它們的結果。這種混合方法將為您帶來嵌入的語義理解,結合關鍵字匹配的精確性,為您的 RAG 管線打造更強健的搜尋體驗。