載入中
我們所建構的混合檢索方法運作良好,但仍有一些不夠完美之處。當您搜尋特定詞彙或使用縮寫時,結果可能無法完美排序。舉例來說,詢問「工程團隊對 INC-2023-Q4-011 做了什麼處理?」可能會優先回傳網路安全章節,即使軟體工程章節與該特定查詢更為相關。
基於 LLM 的重新排序
重新排序在合併向量索引(vector index)與 BM25 索引的結果之後,新增了另一個後處理步驟。其概念很簡單:取得您的搜尋結果,並請 Claude 根據與使用者問題的相關性重新排序。
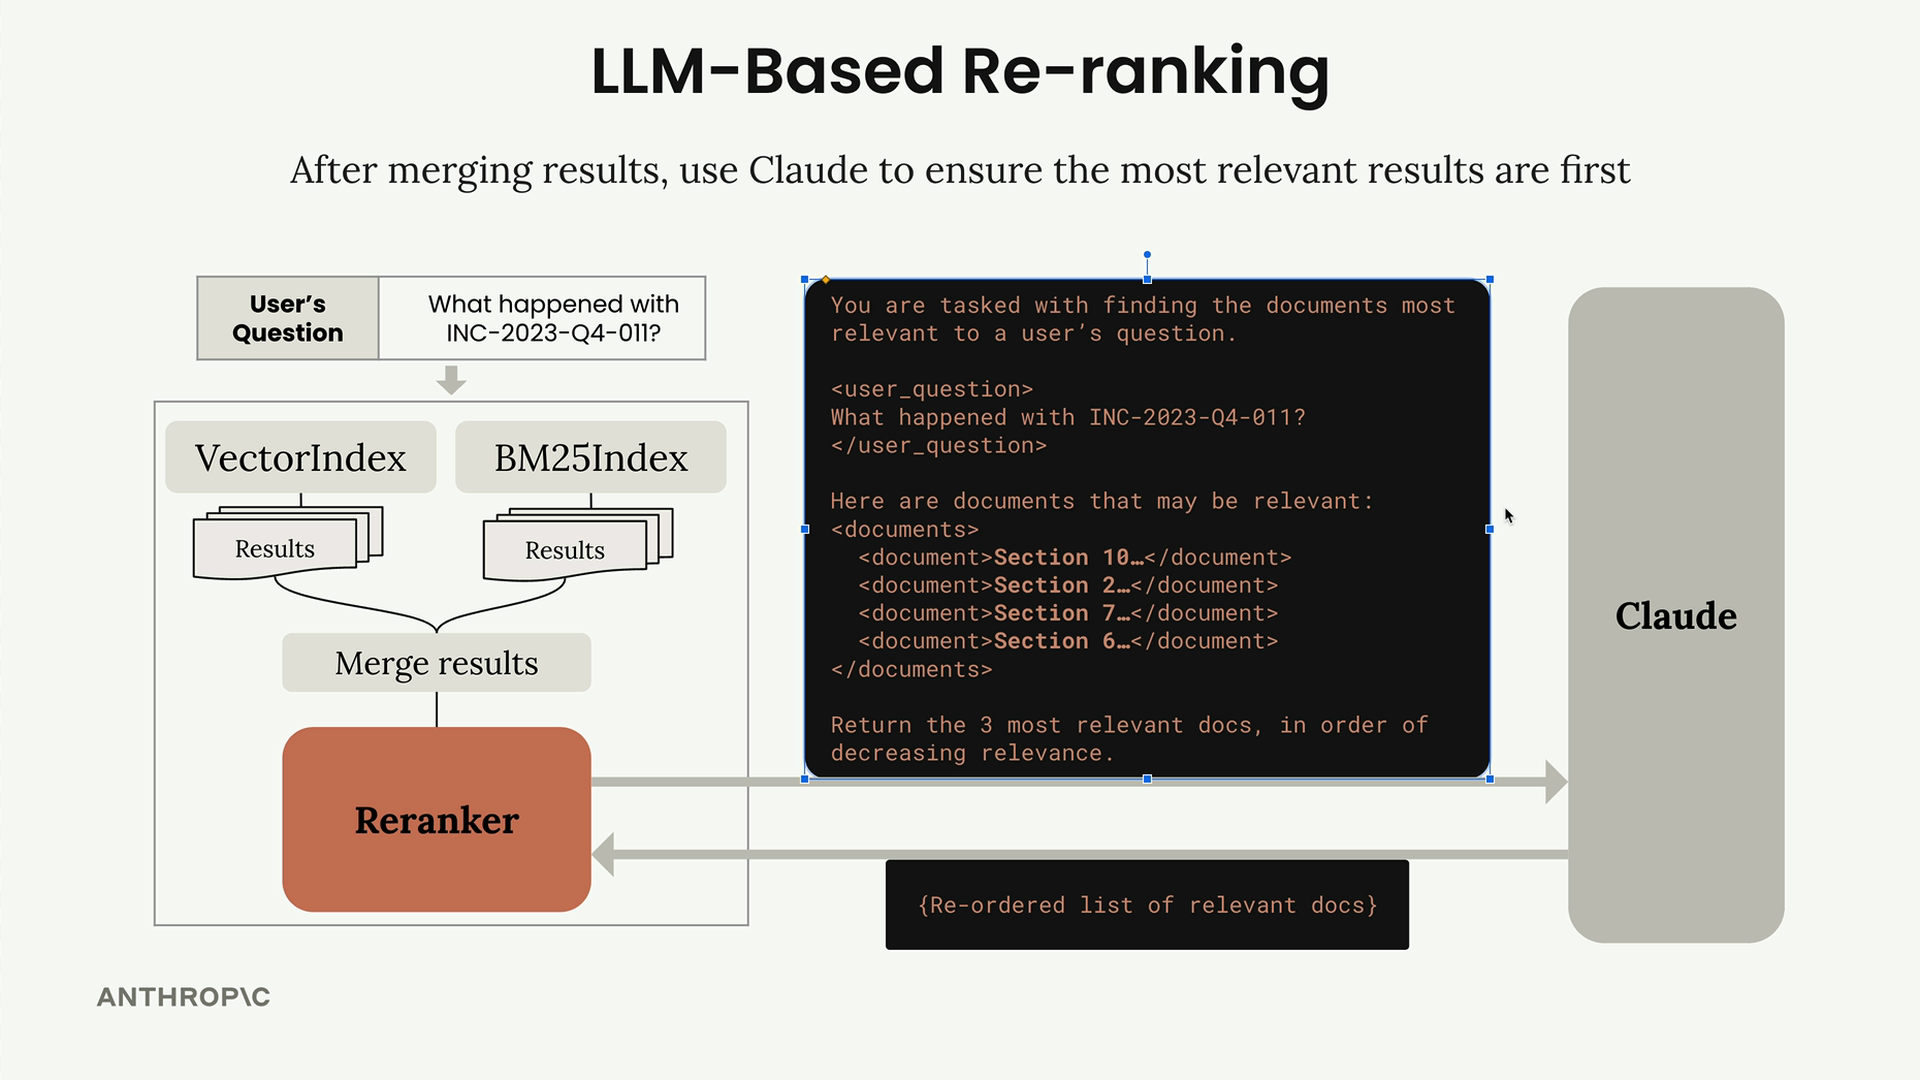
以下是此流程的運作方式:
- 照常執行您的混合搜尋(向量 + BM25)
- 如之前一樣合併結果
- 將合併後的結果傳遞給重新排序器函式
- 重新排序器以特定提示將所有內容傳送給 Claude
- Claude 回傳按相關性排序後的最相關文件清單
系統提示
重新排序提示的設計力求清晰明確。您向 Claude 提供使用者的問題,以及所有看似相關的文件,然後要求完成一項簡單的任務:依相關性遞減的順序回傳最相關的文件。
典型的提示結構如下所示:
You are tasked with finding the documents most relevant to a user's question.

<user_question>
What happened with INC-2023-Q4-011?
</user_question>

Here are documents that may be relevant:
<documents>
<document>Section 10...</document>
<document>Section 2...</document>
<document>Section 7...</document>
<document>Section 6...</document>
</documents>

Return the 3 most relevant docs, in order of decreasing relevance.效率考量
要求 Claude 回傳完整的文字區塊會很沒效率——您將需要等待 Claude 複製大量文字。因此,應事先為每個文字區塊指派一個唯一 ID,然後要求 Claude 僅以正確順序回傳這些 ID。
這種方法快得多,因為 Claude 只需回傳像 ["1p5g", "51n3", "ab83"] 這樣的簡單清單,而不必複製整份文件區段。
實作方式
重新排序器函式會在初始混合搜尋之後,由您的檢索器(retriever)自動呼叫。其基本結構如下:
python
def reranker_fn(docs, query_text, k):
    # 格式化帶有 ID 的文件
    joined_docs = "\n".join([
        f"<document><document_id>{doc['id']}</document_id>"
        f"<document_content>{doc['content']}</document_content></document>"
        for doc in docs
    ])

    # 建立包含使用者問題與文件的提示
    prompt = f"""You are about to be given a set of documents...
    {query_text}
    {joined_docs}
    """

    # 取得 Claude 的回應並解析文件 ID
    result = chat(messages, stop_sequences=["```"])
    return json.loads(result["text"])["document_ids"]
結果
當您使用像「工程團隊對 INC-2023-Q4-011 做了什麼處理?」這樣的查詢來測試重新排序器時,應該會看到更相關的結果排在最上方。Claude 能理解上下文,並識別出關於工程團隊的查詢應優先考慮軟體工程章節,而非其他僅僅提及該事件的章節。
這之中的取捨很明顯:重新排序會因為需要等待 Claude 的回應而增加延遲,但透過善用 Claude 對上下文與相關性的理解,能大幅提升搜尋準確度。