现在我们已经了解了RAG、文本分块和嵌入的基础知识,让我们一步步走完完整的RAG流水线。这个详细的示例将向您准确展示在实际实现中所有部分是如何组合在一起的。
步骤1:对源文本进行分块
首先,我们取源文档并将其分解成可管理的块。在这个示例中,我们将使用两个简单的文本片段:
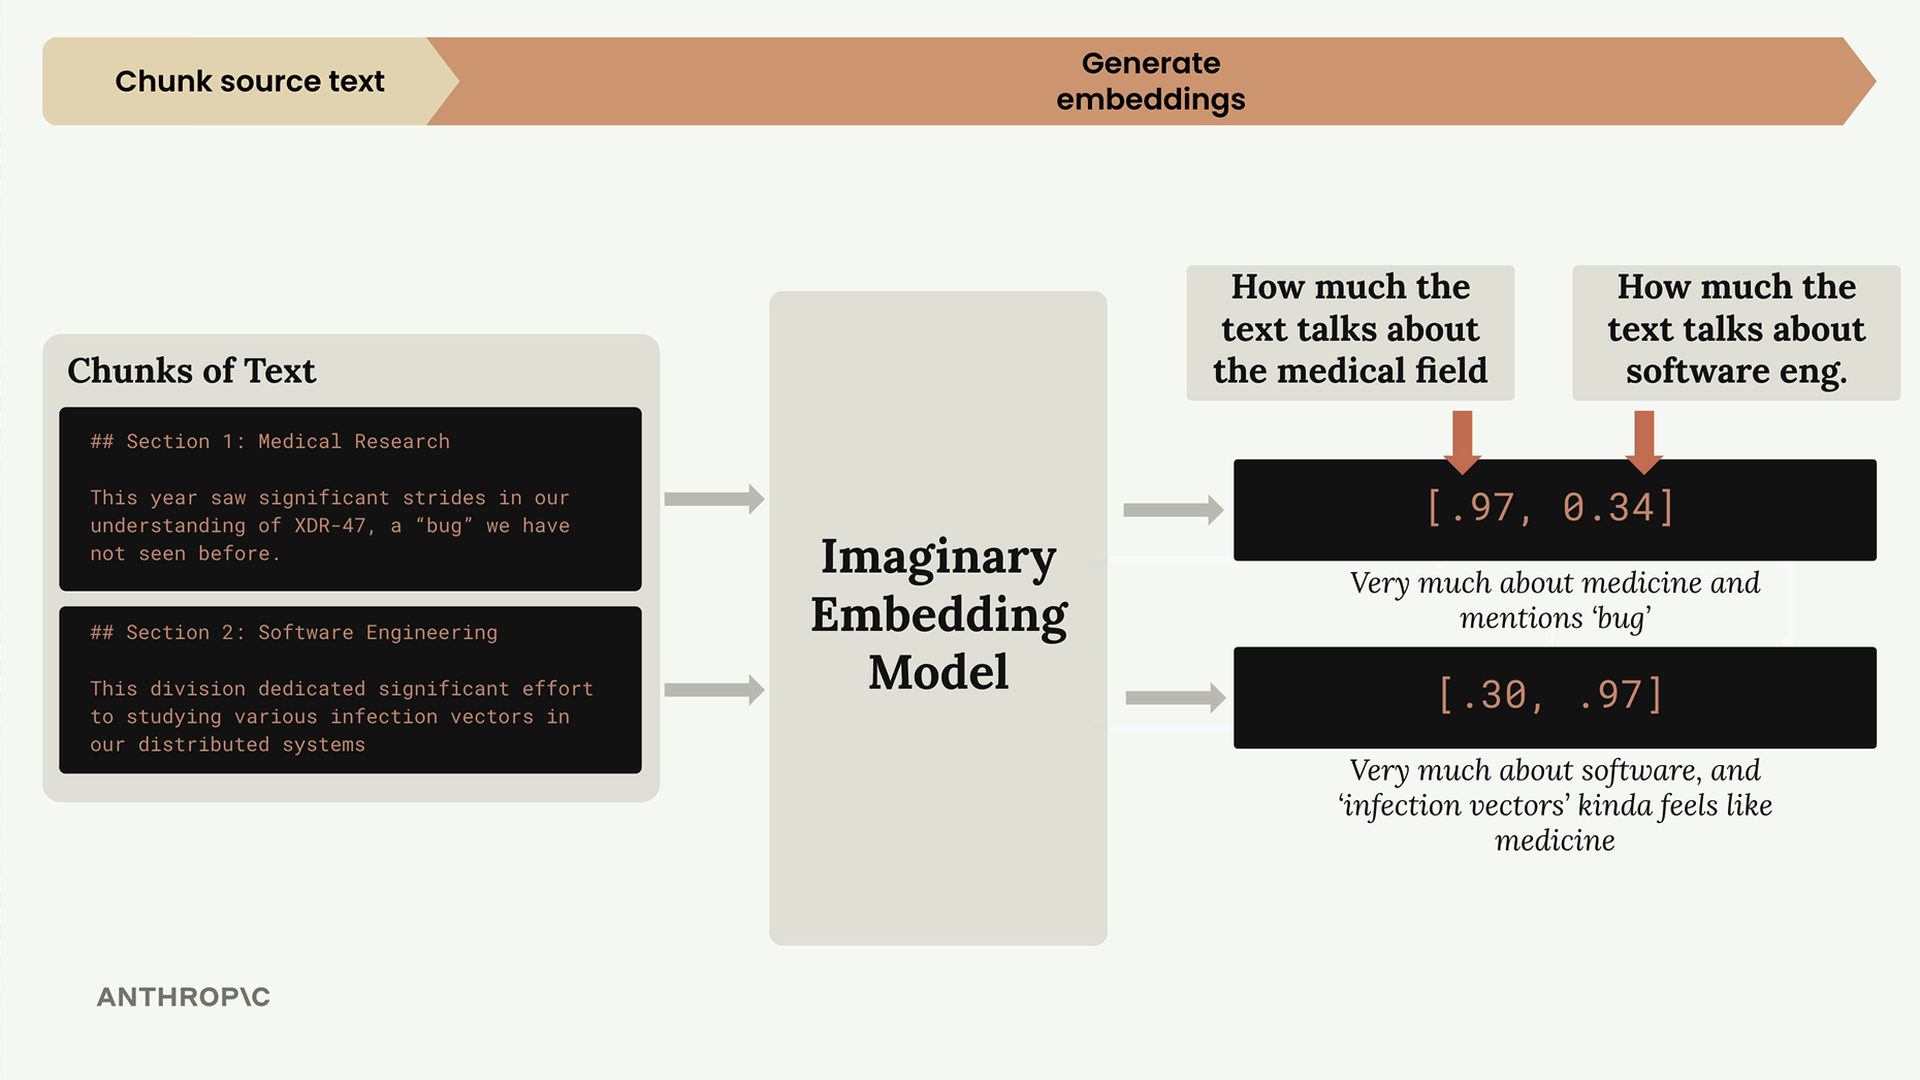
- 片段1:医学研究——"今年我们对XDR-47有了重大的理解进展,这是一种我们以前从未见过的'bug'。"
- 片段2:软件工程——"该部门投入了大量精力研究我们分布式系统中的各种感染向量"
步骤2:生成嵌入
接下来,我们将每个文本块转换为数值嵌入。为了更容易理解,假设我们有一个完美的嵌入模型,它总是恰好返回两个数字,并且我们知道每个数字代表什么:
在我们这个假想的模型中:
- 第一个数字:文本谈论医学的程度
- 第二个数字:文本谈论软件工程的程度
因此,我们的医学研究片段得到[0.97, 0.34]——非常偏医学,由于"bug"这个词也有一点软件相关性。软件工程片段得到[0.30, 0.97]——非常偏软件,但"感染向量"具有医学的含义。
归一化
在存储这些嵌入之前,它们会经过一个归一化过程,将每个向量的大小缩放为1.0。这通常由您的嵌入API自动处理,但了解它确实发生是很重要的。
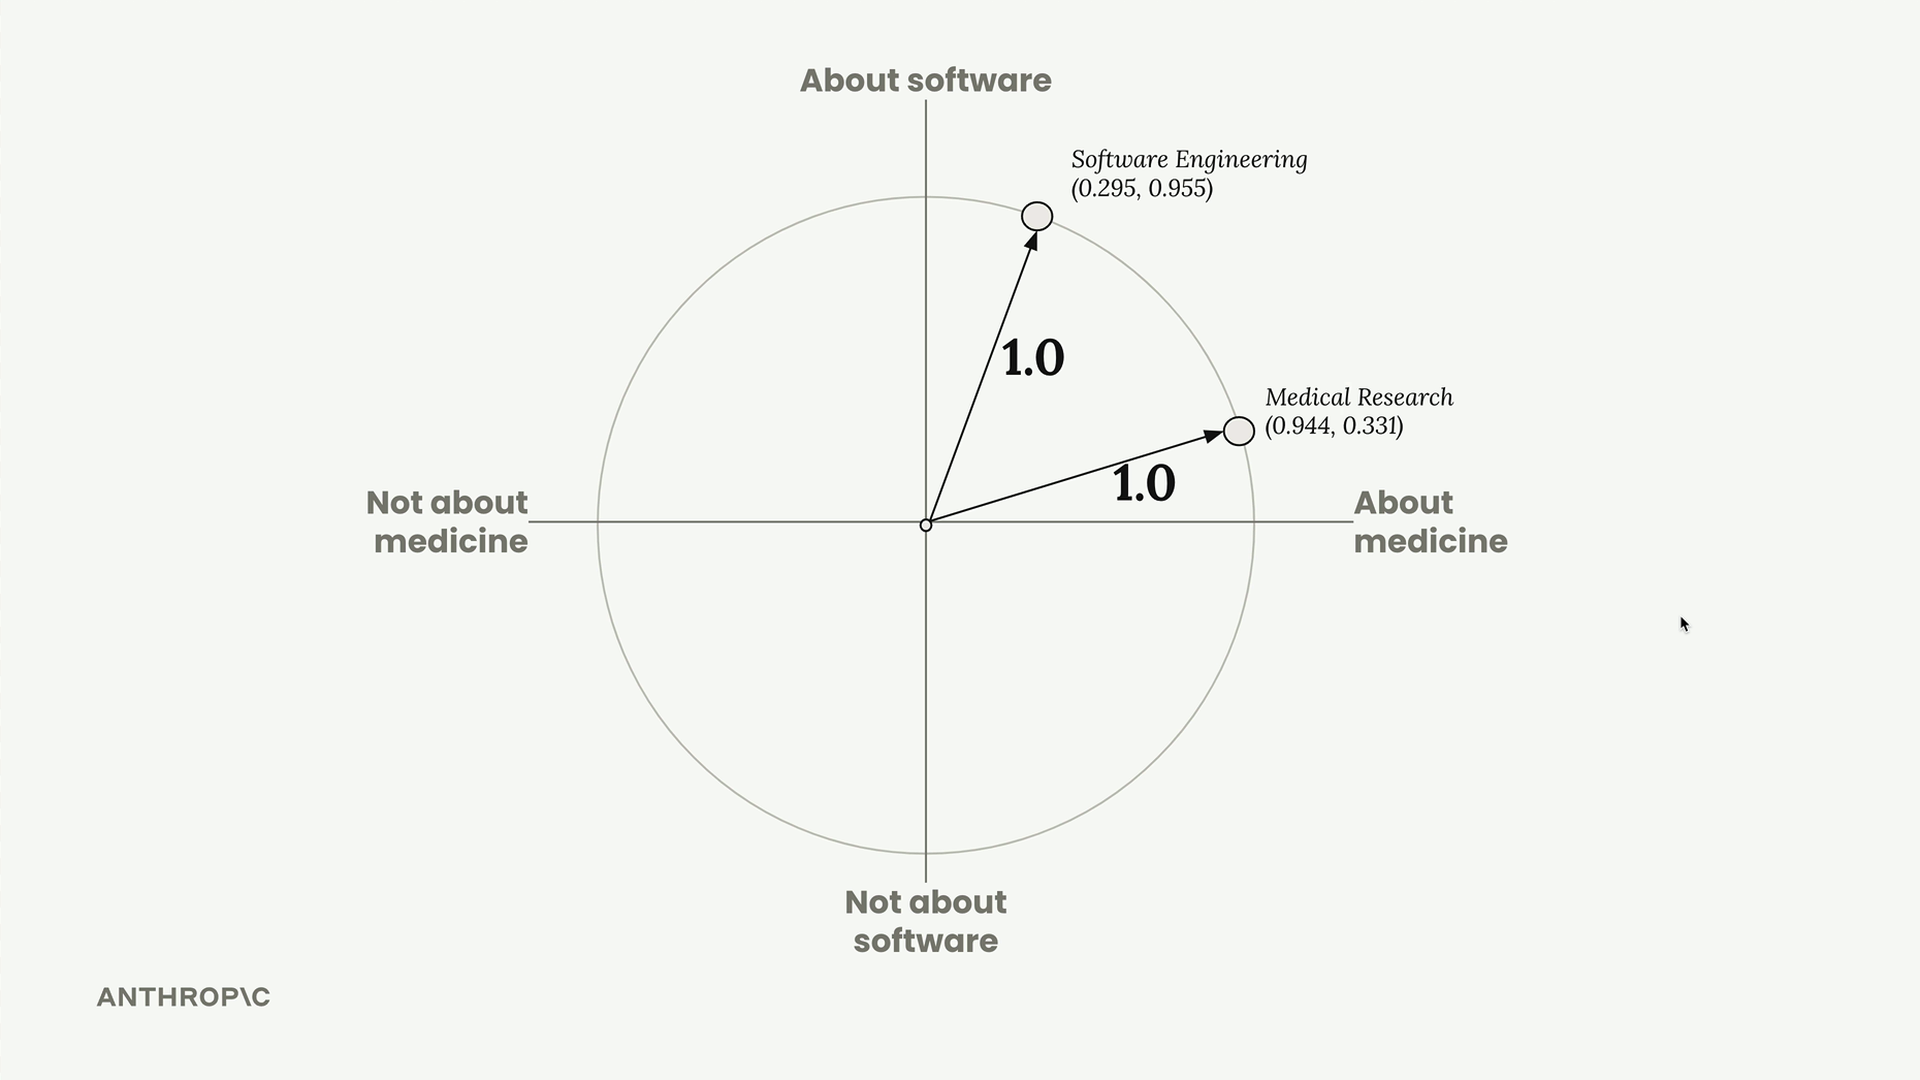
归一化后,我们的嵌入变为[0.944, 0.331]和[0.295, 0.955]。我们可以在一个单位圆上将它们可视化,两个点恰好都位于圆的边缘上。
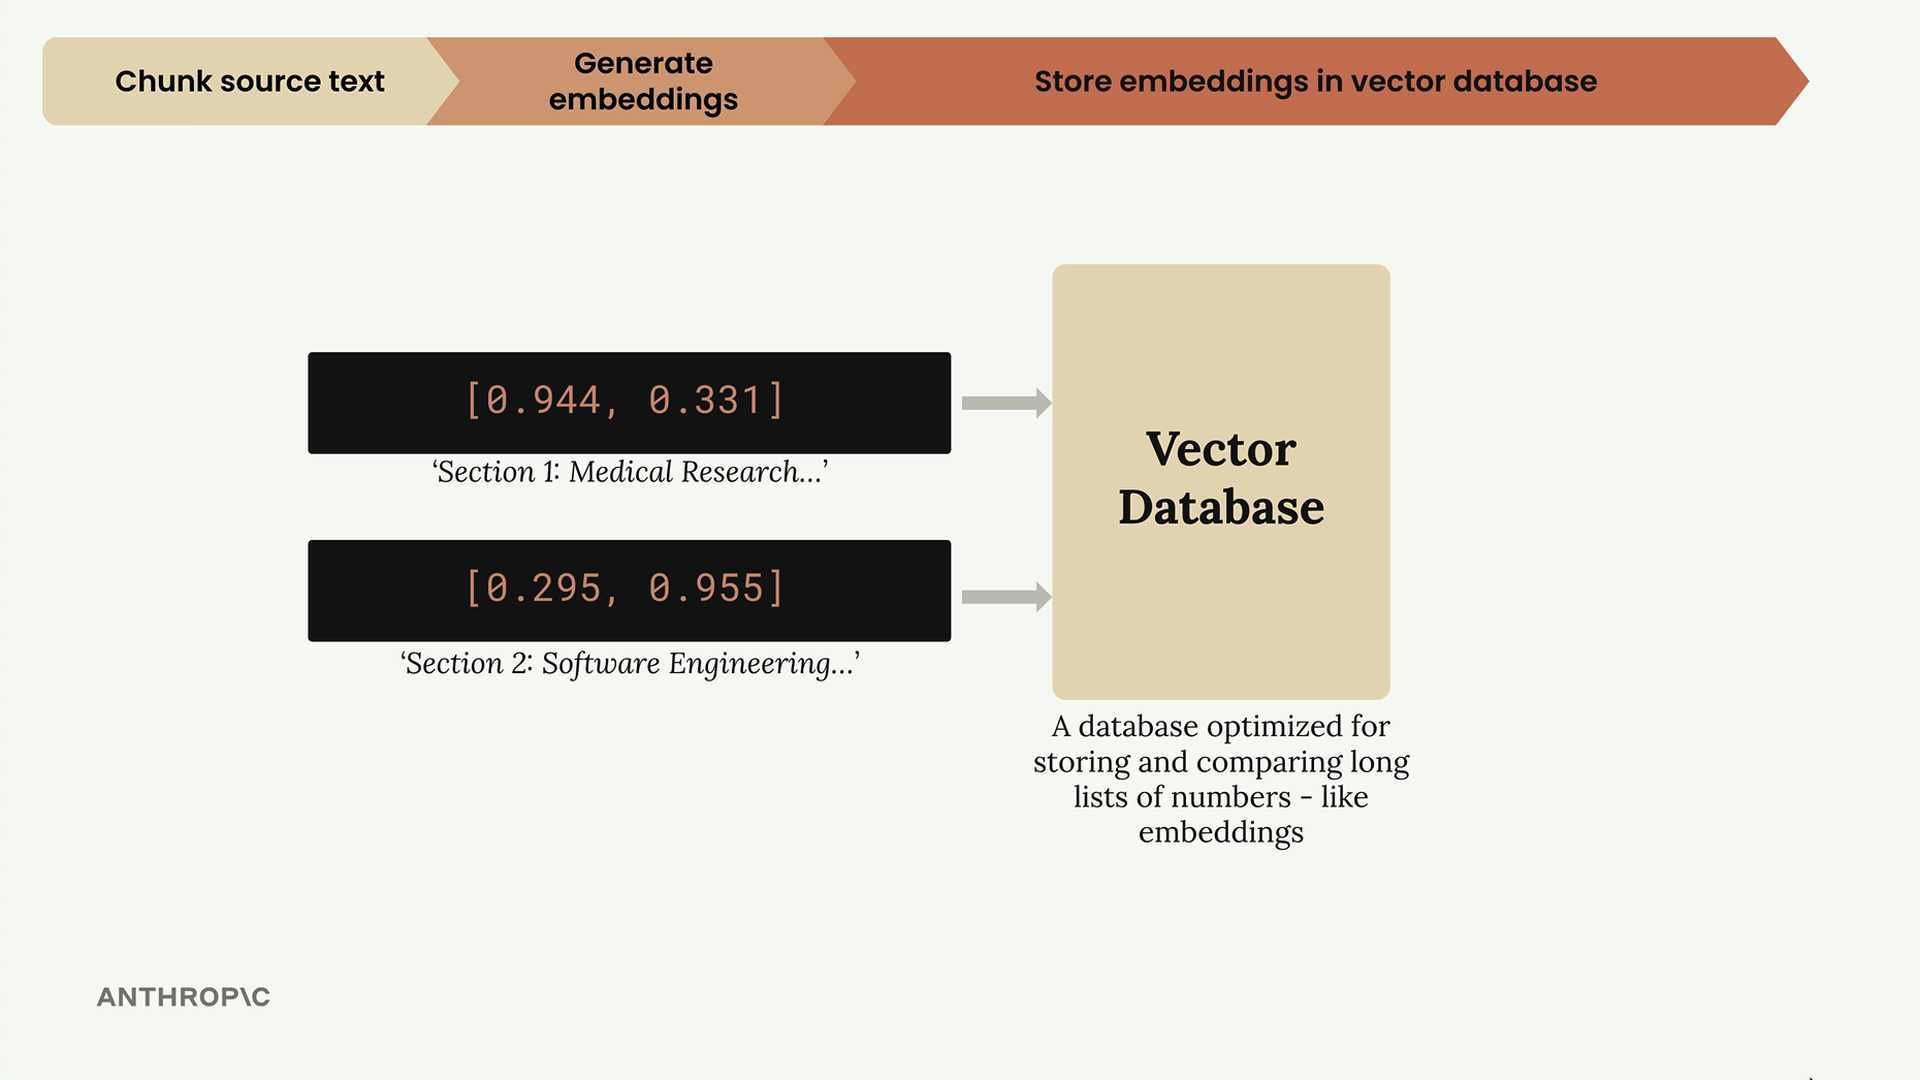
步骤3:存储到向量数据库中
归一化后的嵌入被存储到一个向量数据库中——这是一种专门为存储、比较和搜索像我们嵌入这样的长数字列表而优化的数据库。
到这里,我们暂停一下。迄今为止所做的所有工作都是预处理,这些工作是提前完成的。现在我们等待用户提交查询。
步骤4:处理用户查询
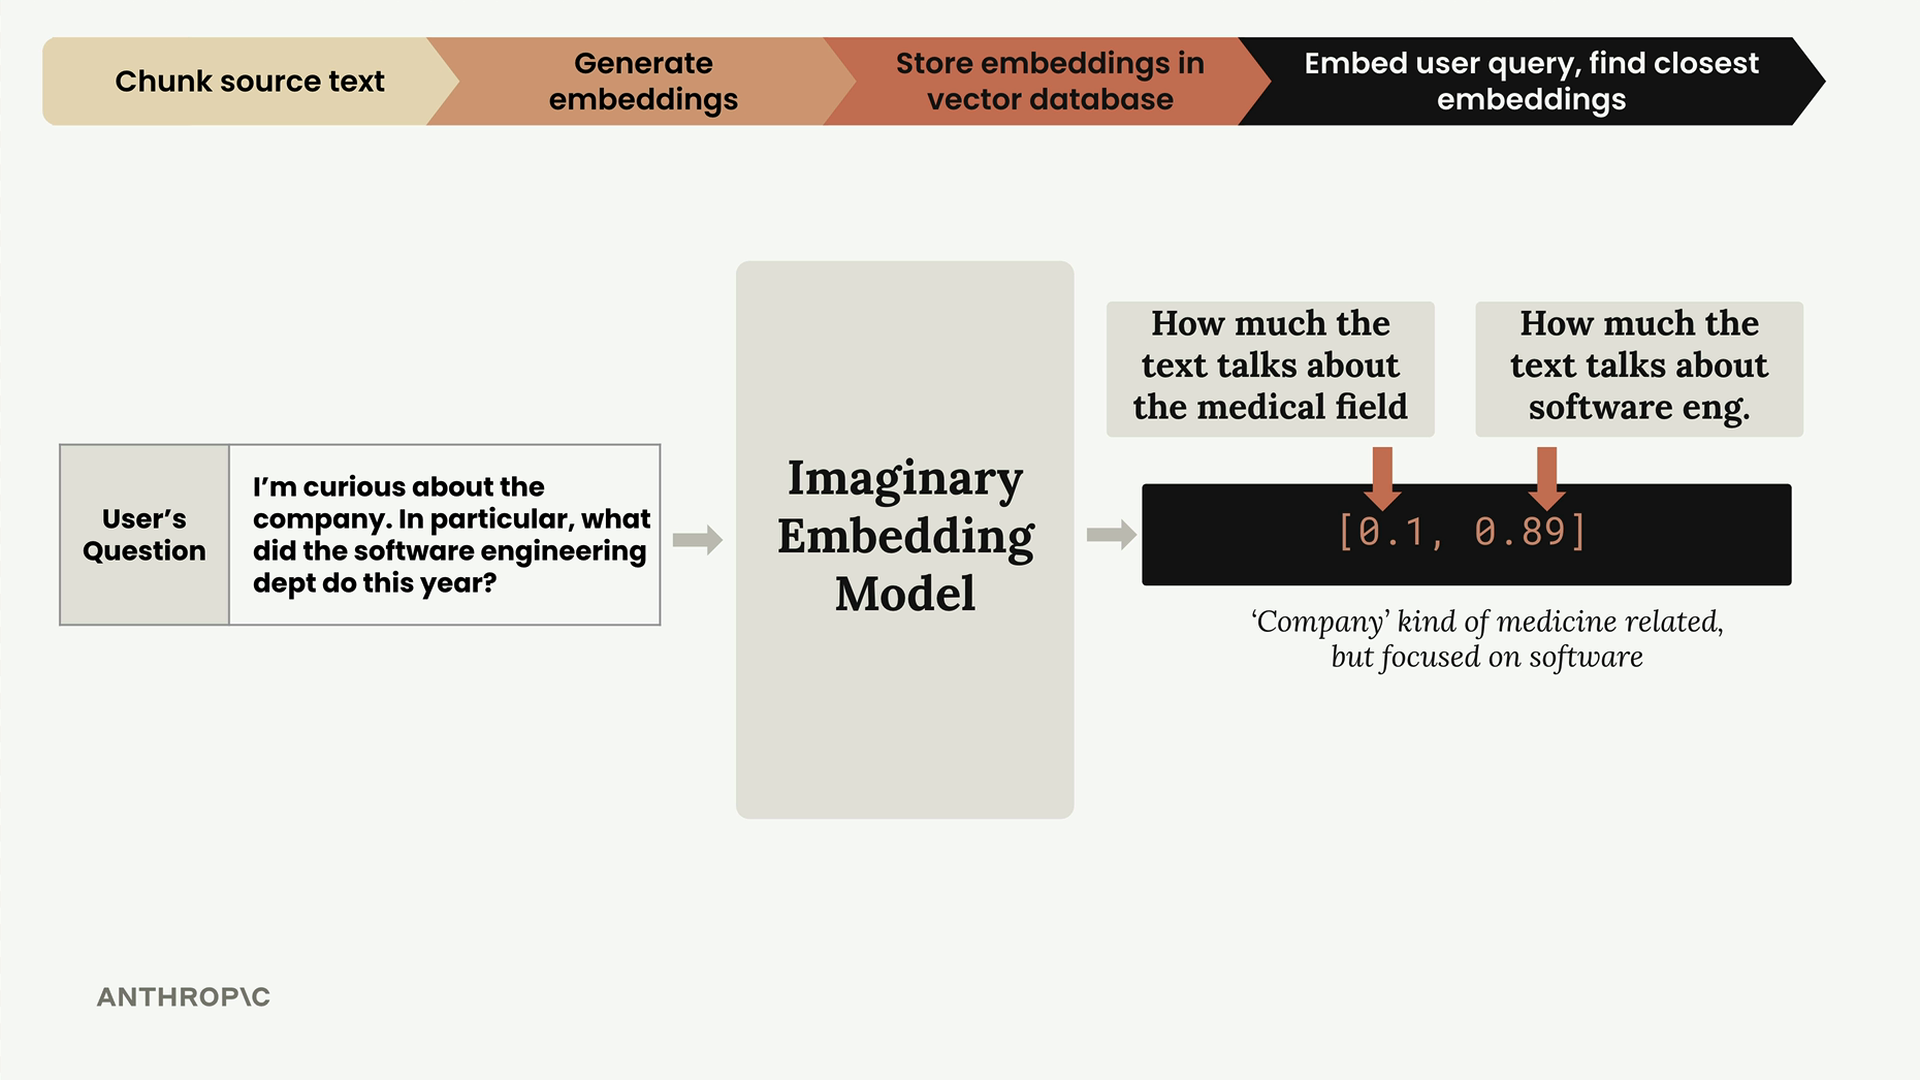
当用户问出类似"我对这家公司很好奇。特别是,软件工程部门今年做了什么?"这样的问题时,我们会将他们的查询通过同样的嵌入模型。
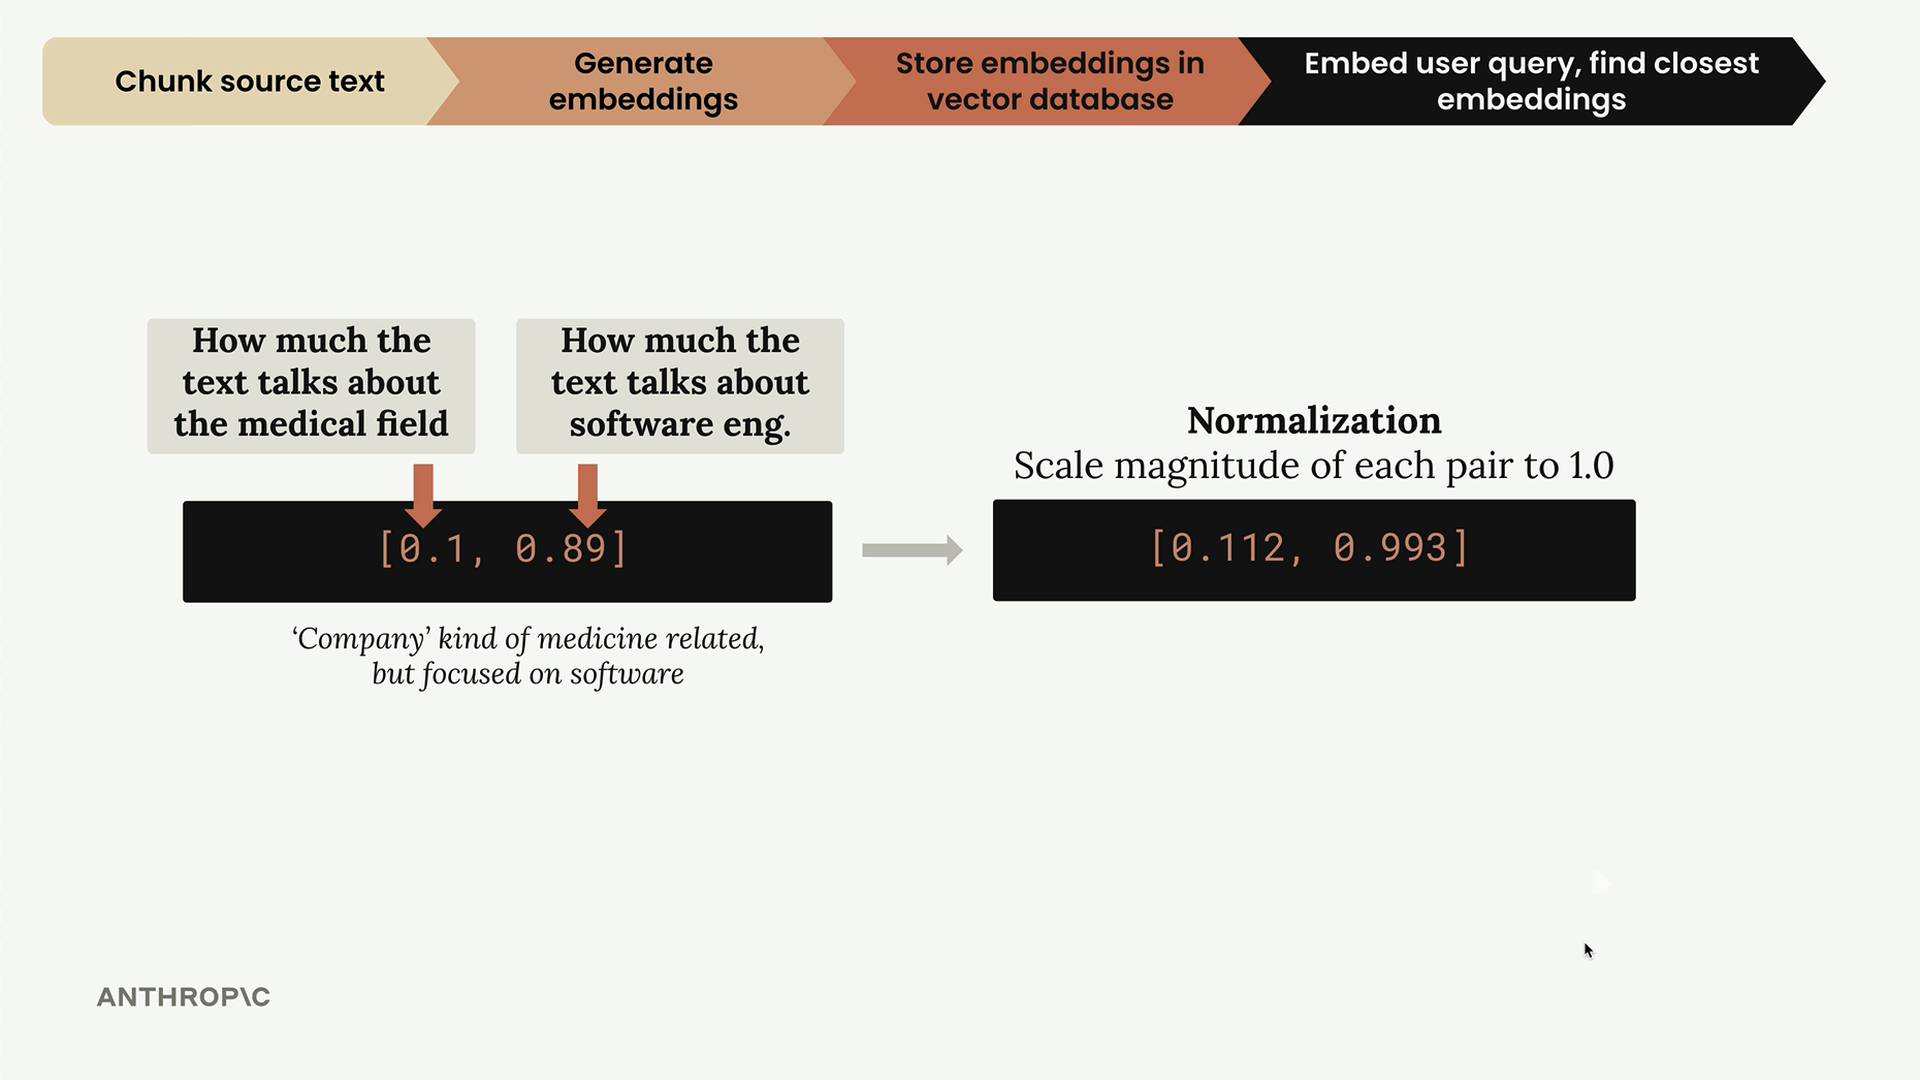
这个查询被嵌入为[0.1, 0.89]——医学得分低,软件工程得分高。归一化后,它变为[0.112, 0.993]。
步骤5:查找相似嵌入
现在我们向向量数据库提问:"找到与这个用户查询嵌入最接近的存储嵌入。"数据库返回软件工程片段,因为它最相似。
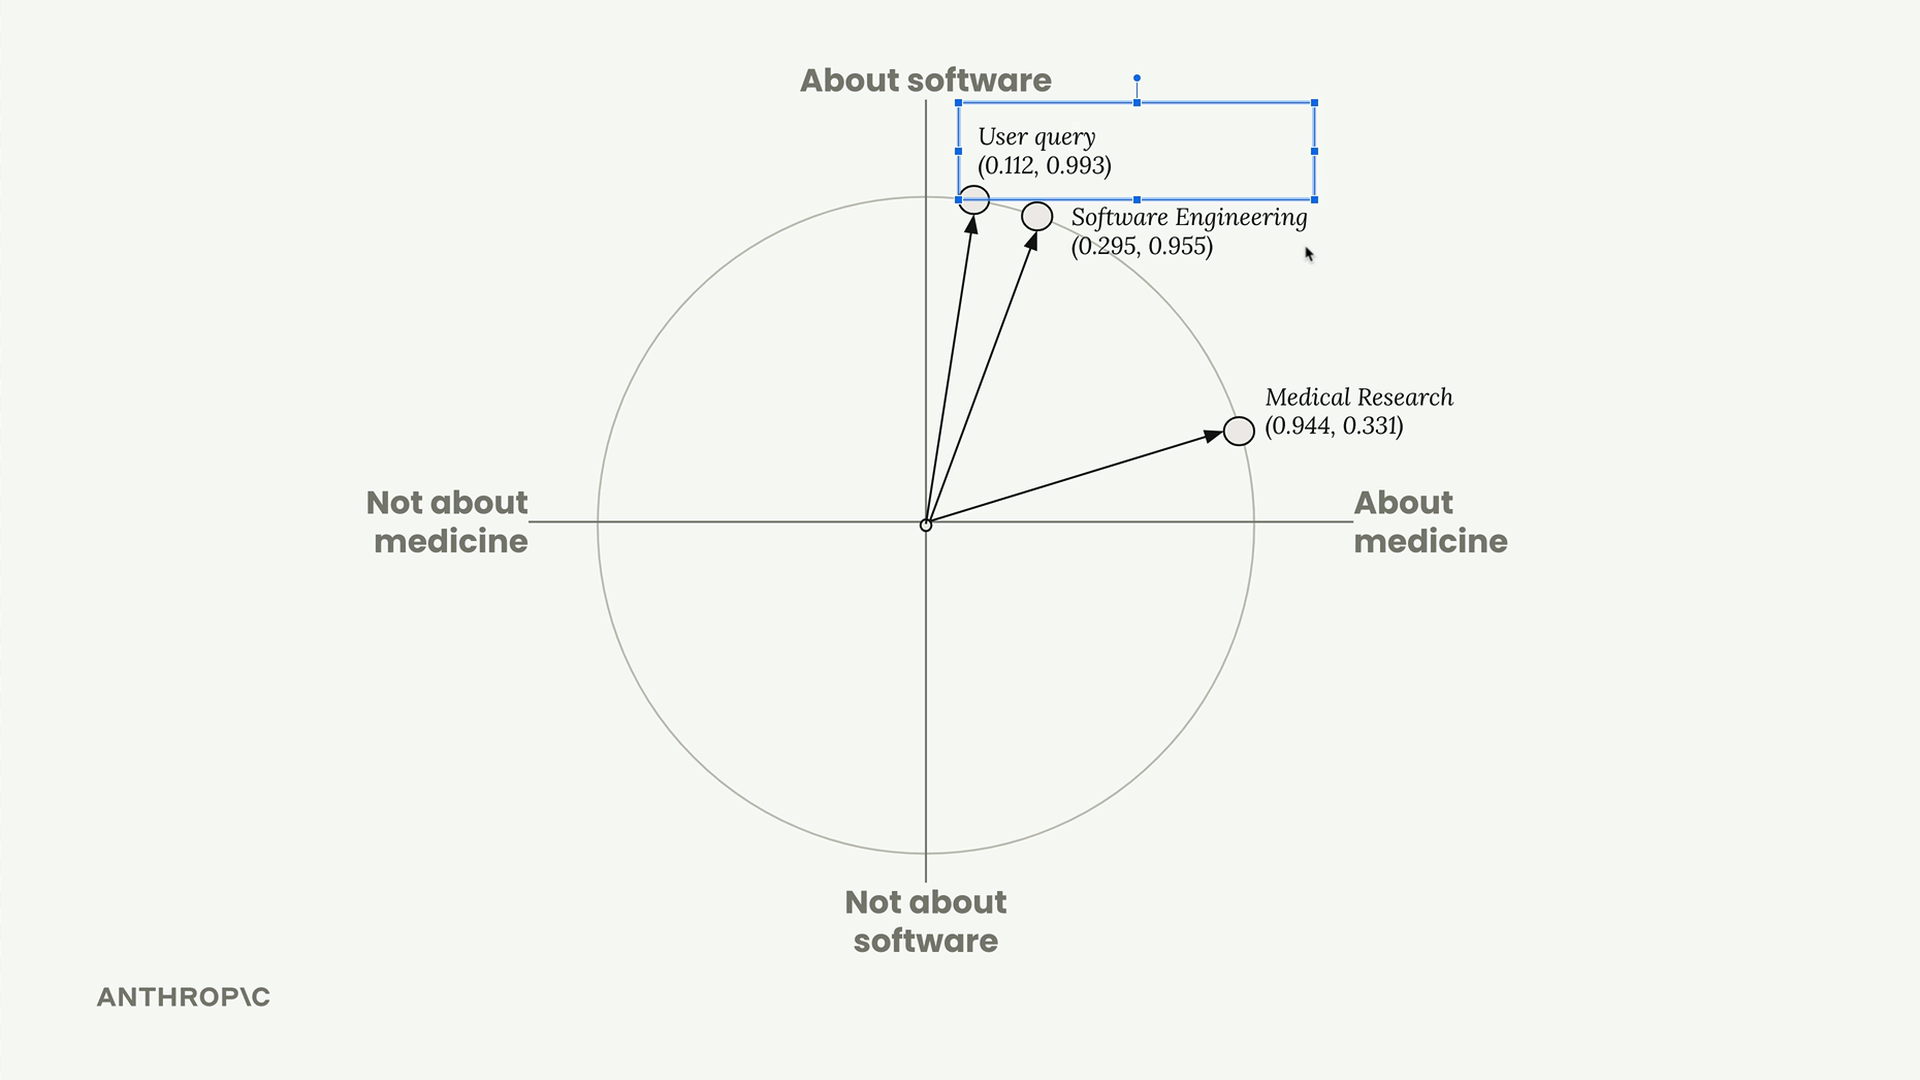
但数据库是如何判断"最接近"的呢?它使用余弦相似度。
余弦相似度
向量数据库通过计算向量之间夹角的余弦值来衡量相似度。这给出一个介于-1和1之间的数字:
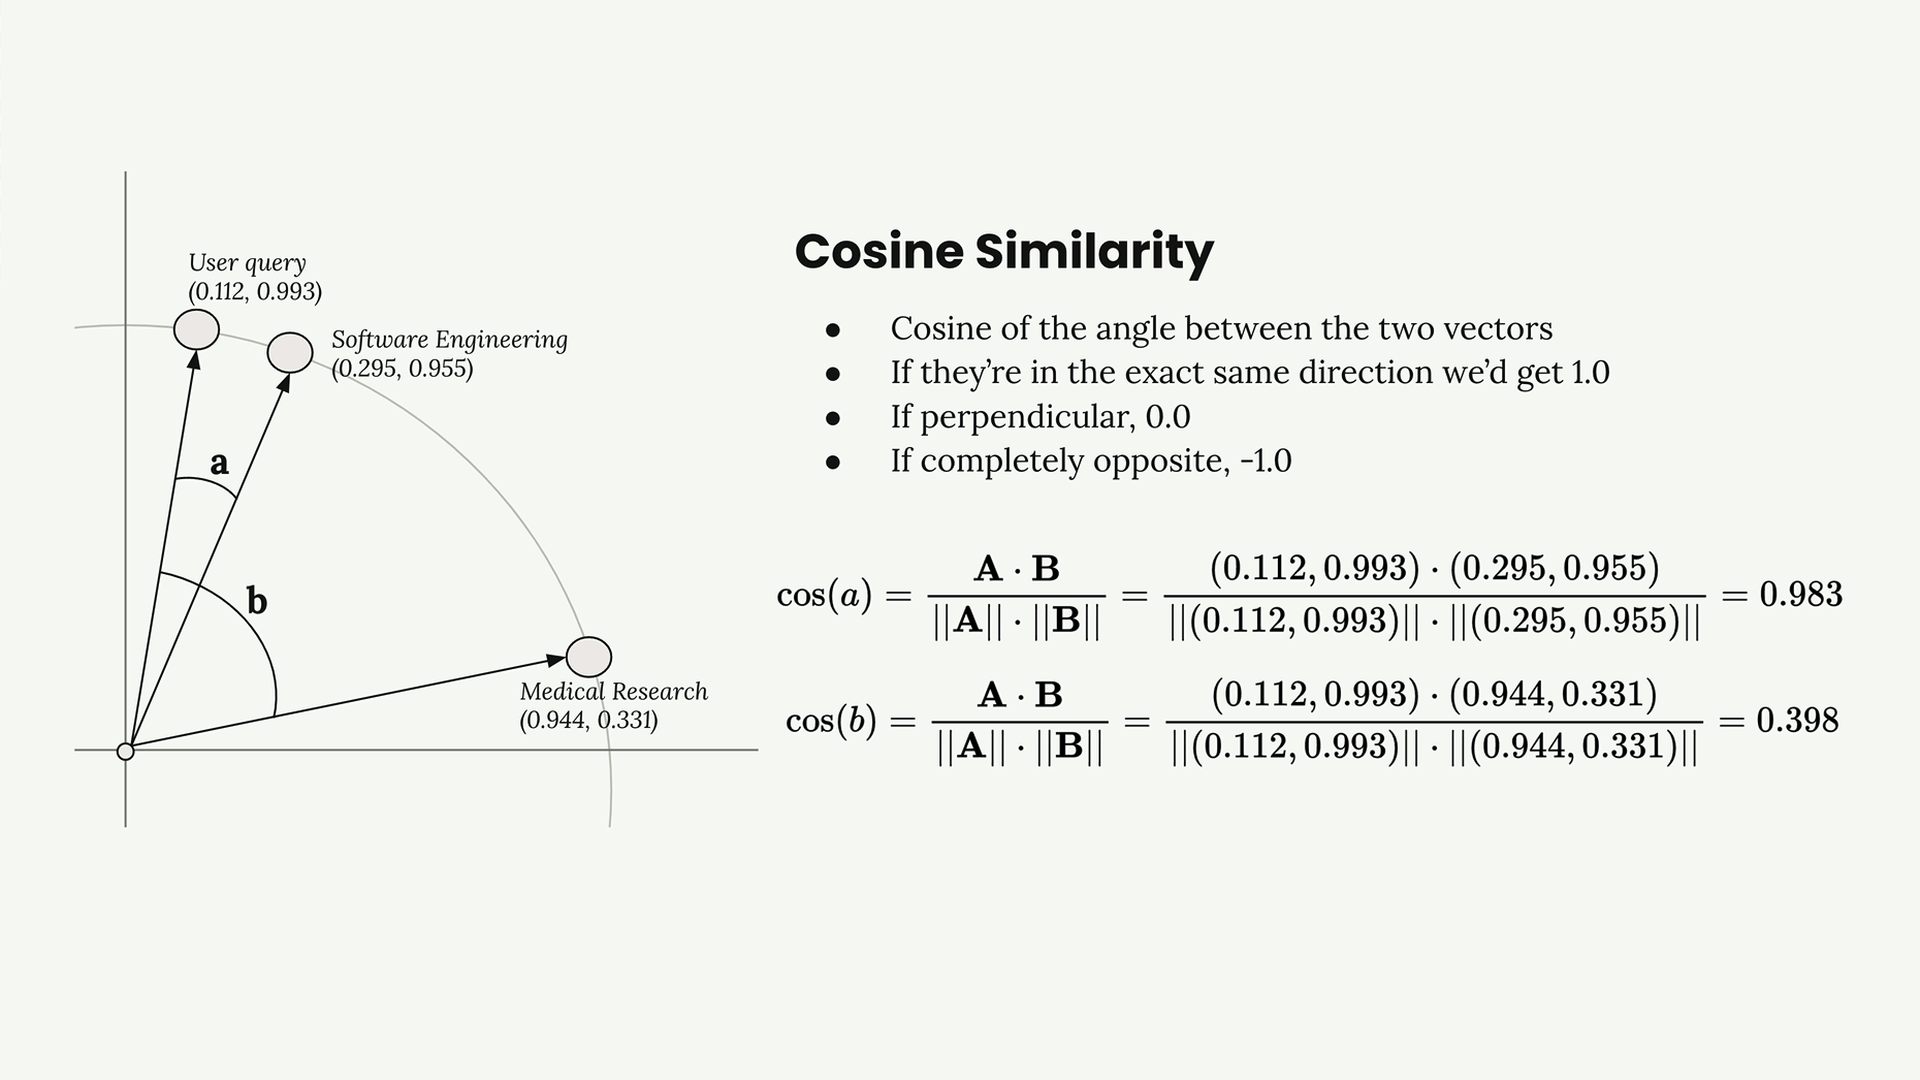
- 1.0 = 向量指向完全相同的方向(非常相似)
- 0.0 = 向量垂直(不相关)
- -1.0 = 向量指向相反的方向(非常不同)
在我们的示例中:
- 用户查询与软件工程:余弦相似度 = 0.983(非常相似!)
- 用户查询与医学研究:余弦相似度 = 0.398(不太相似)
余弦距离
您在向量数据库文档中经常会看到"余弦距离"。它就是1 - 余弦相似度,这将刻度反转,使得数字越小表示越相似:
- 0.0 = 非常相似
- 1.0 = 垂直
- 2.0 = 完全相反
步骤6:构建最终提示
最后,我们将用户的问题和最相关的文本块(软件工程片段)结合起来,构建给Claude的提示:
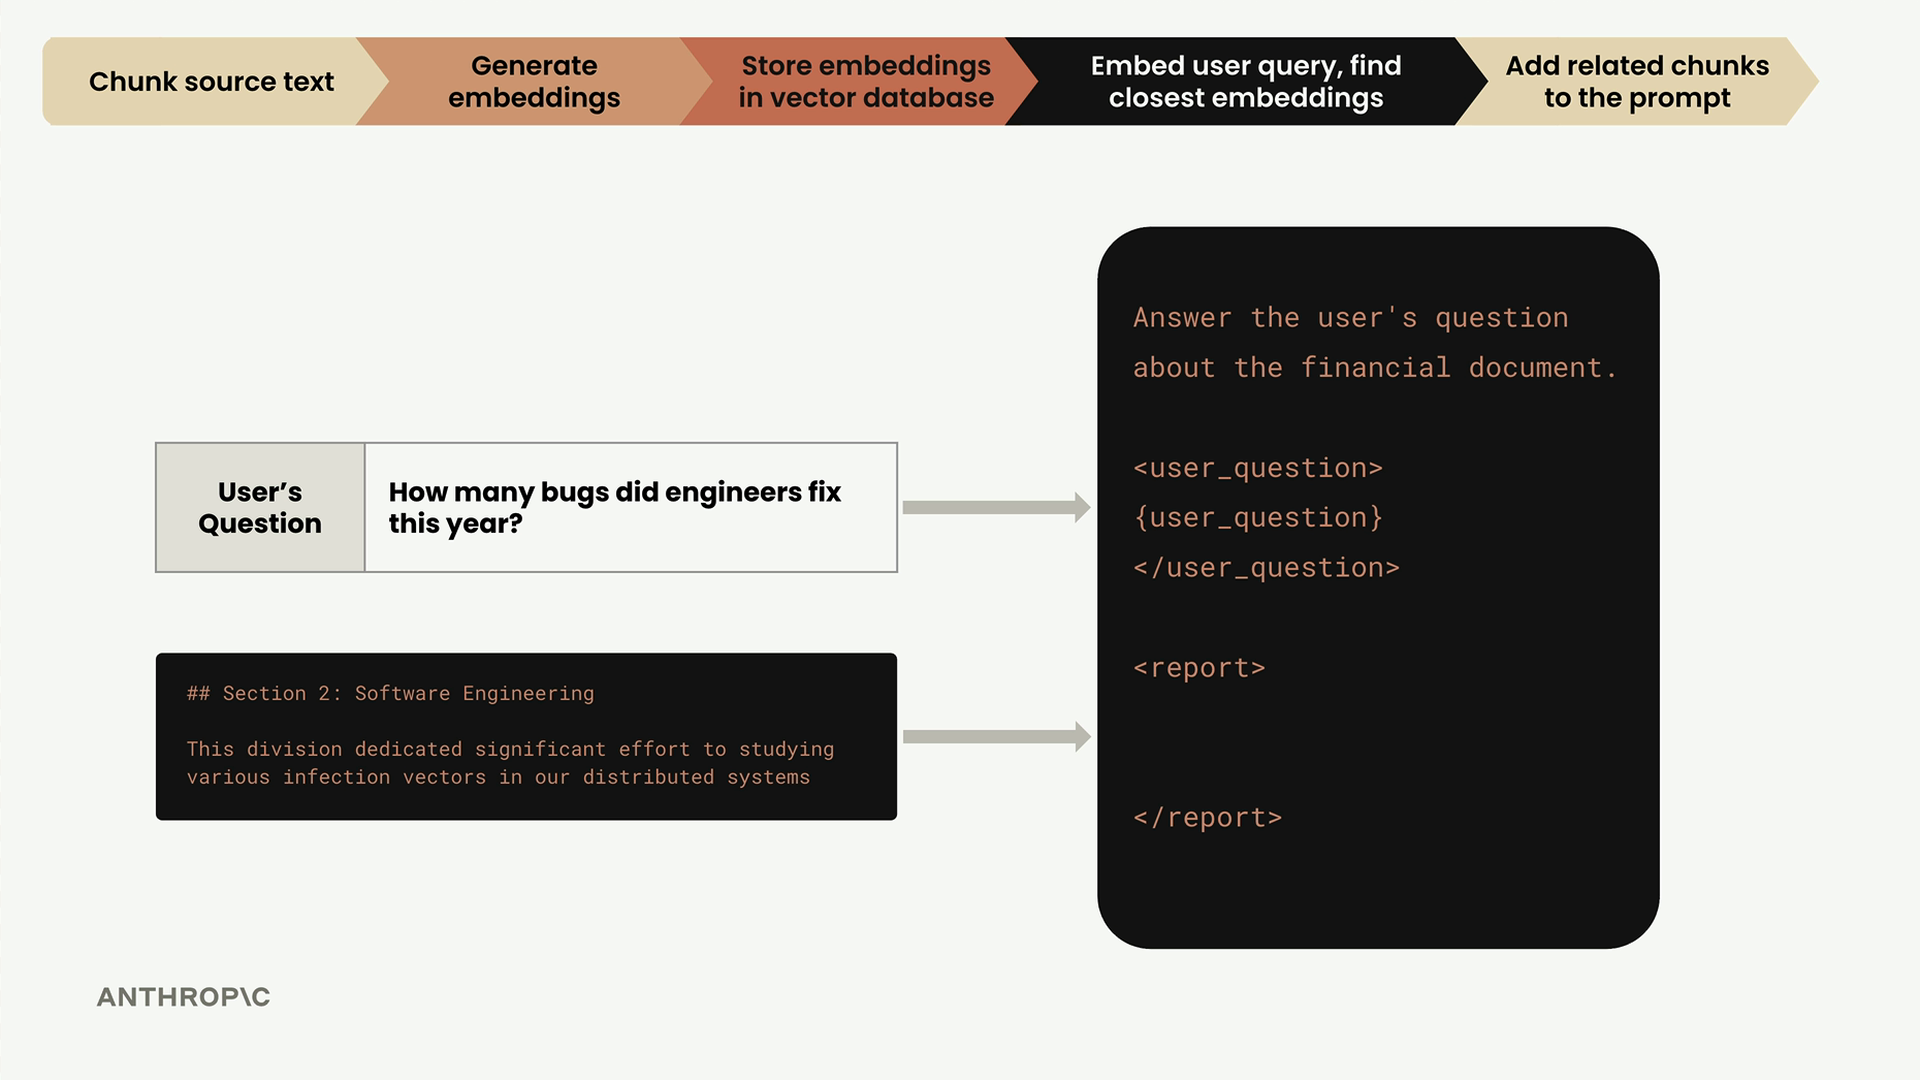
Answer the user's question about the financial document.

<user_question>
How many bugs did engineers fix this year?
</user_question>

<report>
## Section 2: Software Engineering
This division dedicated significant effort to studying various infection vectors in our distributed systems
</report>这就是完整的RAG流水线!该系统成功地为用户的软件工程问题找到了最相关的上下文,并将其提供给Claude以生成明智的回答。
每次用户提交查询时,这个过程都会自动发生,使Claude能够根据您的特定文档而不仅仅是其一般训练知识来回答问题。