加载中
上下文检索是一种通过解决一个根本性问题来提高RAG管道准确性的技术:当您将文档拆分成块时,每个块都会失去与更广泛文档上下文的联系。
标准分块的问题
当您将源文档拆分成多个块以存入向量数据库时,每个单独的片段都不再知道自己来自哪里,或者与文档其余部分的关系如何。这会损害检索准确性,因为这些块缺乏重要的上下文信息。
上下文检索的工作原理
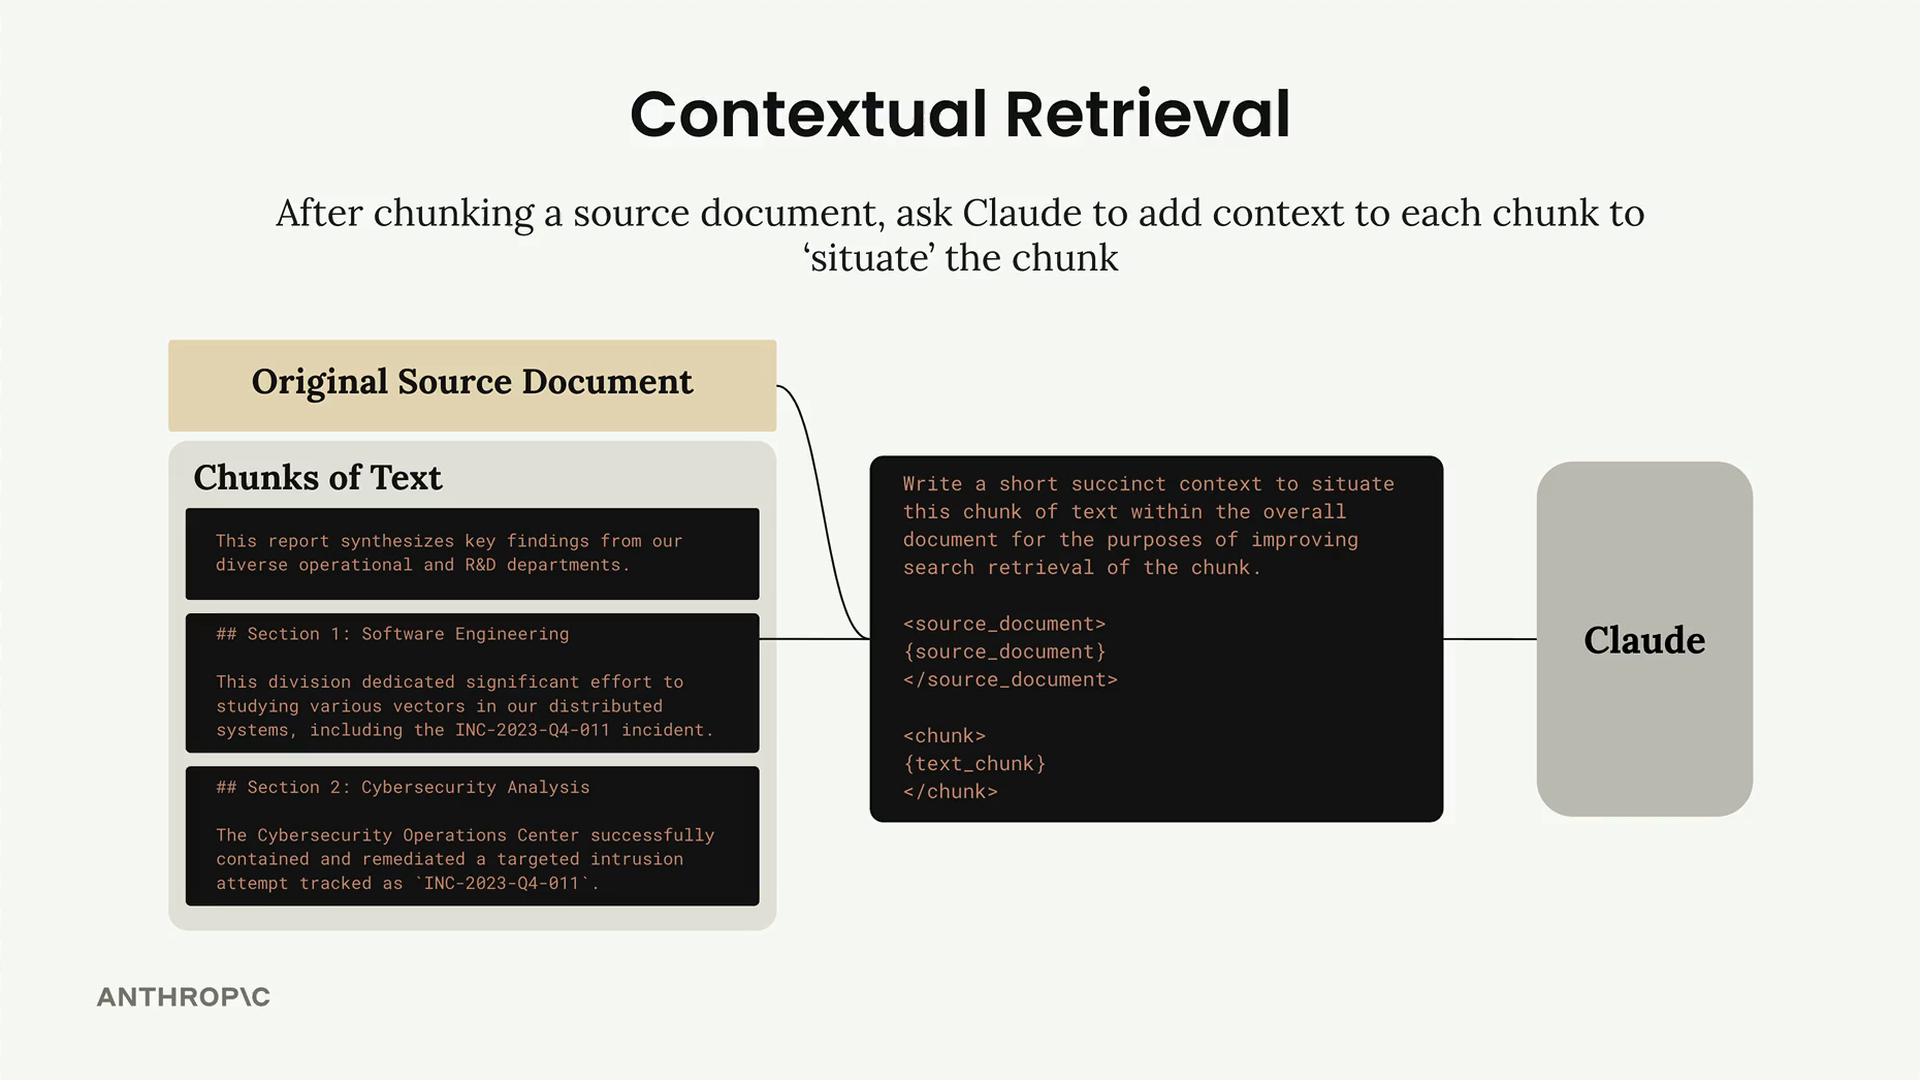
上下文检索在将块插入检索数据库之前添加了一个预处理步骤。以下是具体流程:
- 获取每个单独的块以及原始源文档
- 将两者一起发送给Claude,并附上一个要求其添加上下文的特定提示
- Claude生成一个简短的片段,将该块"定位"在更大的文档中
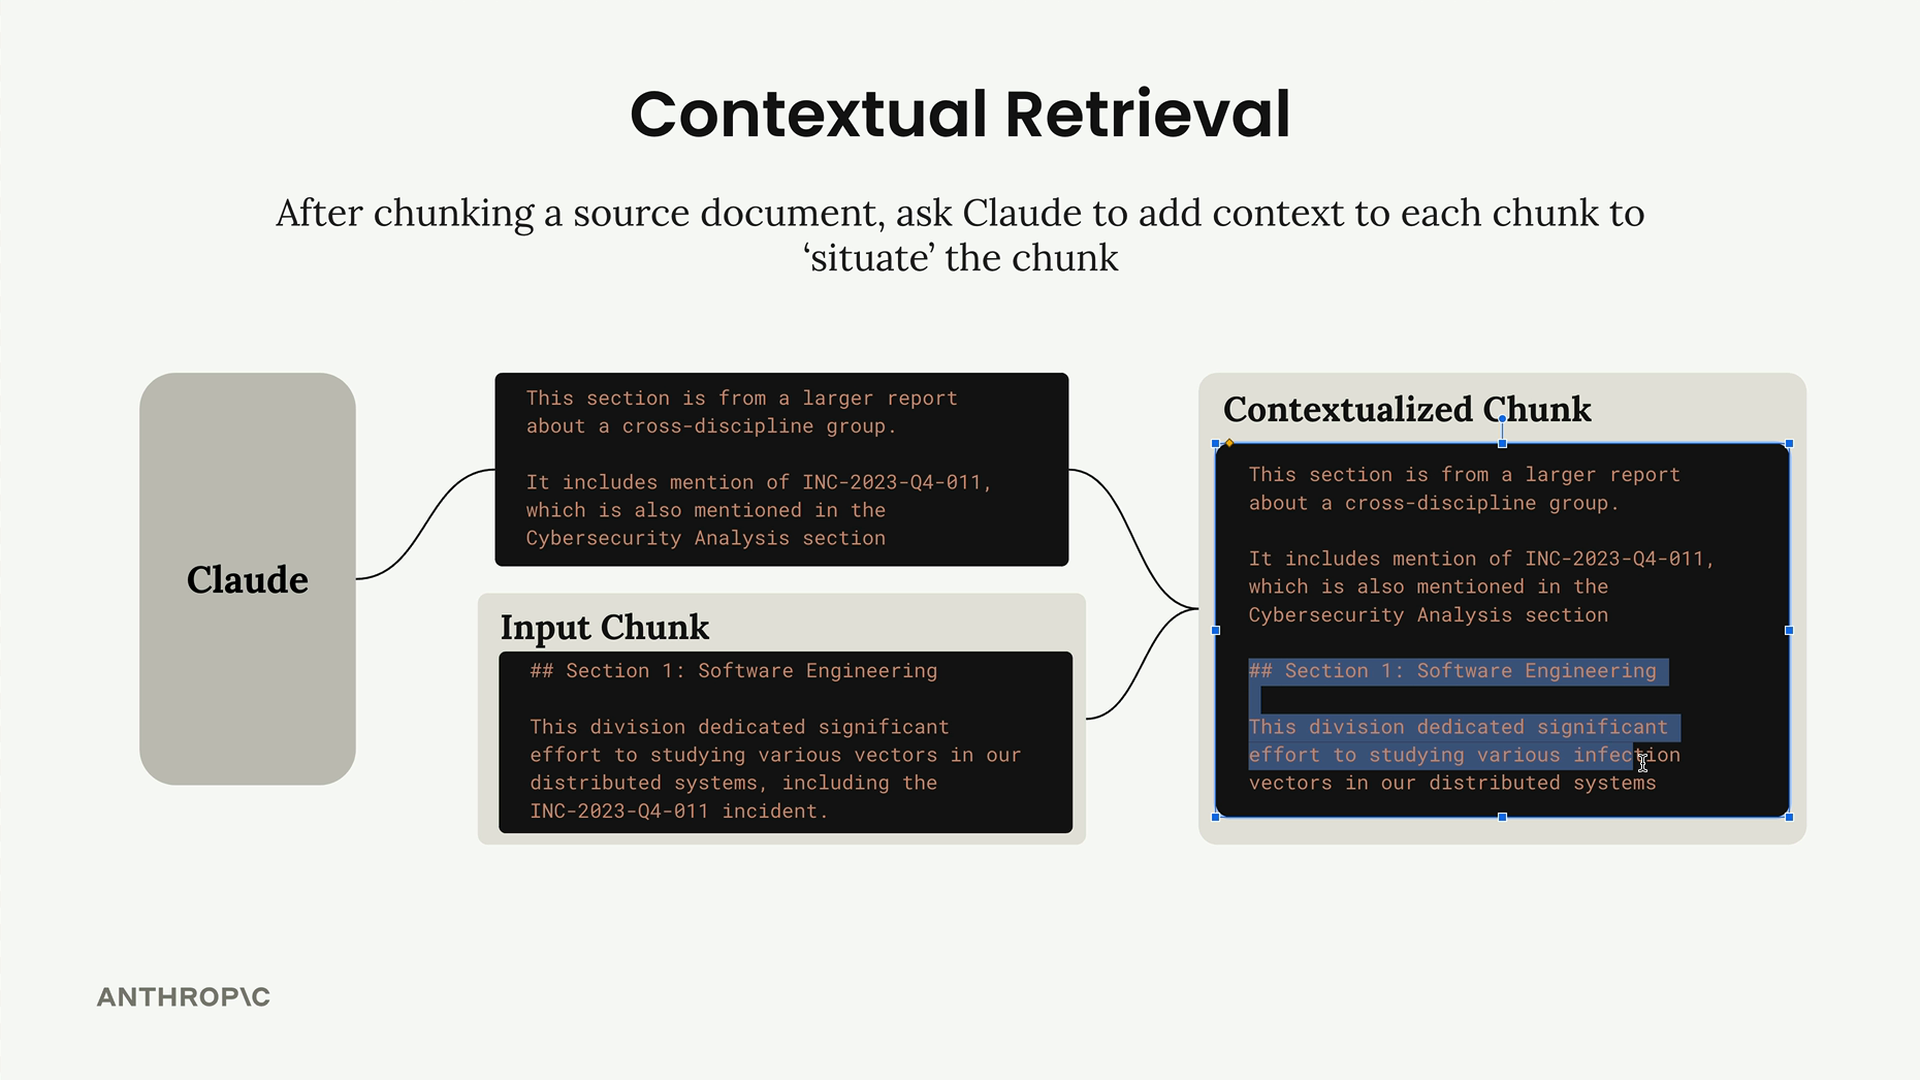
- 将此上下文与原始块结合,创建一个"带上下文的块"
- 在您的向量索引和BM25索引中使用带上下文的块
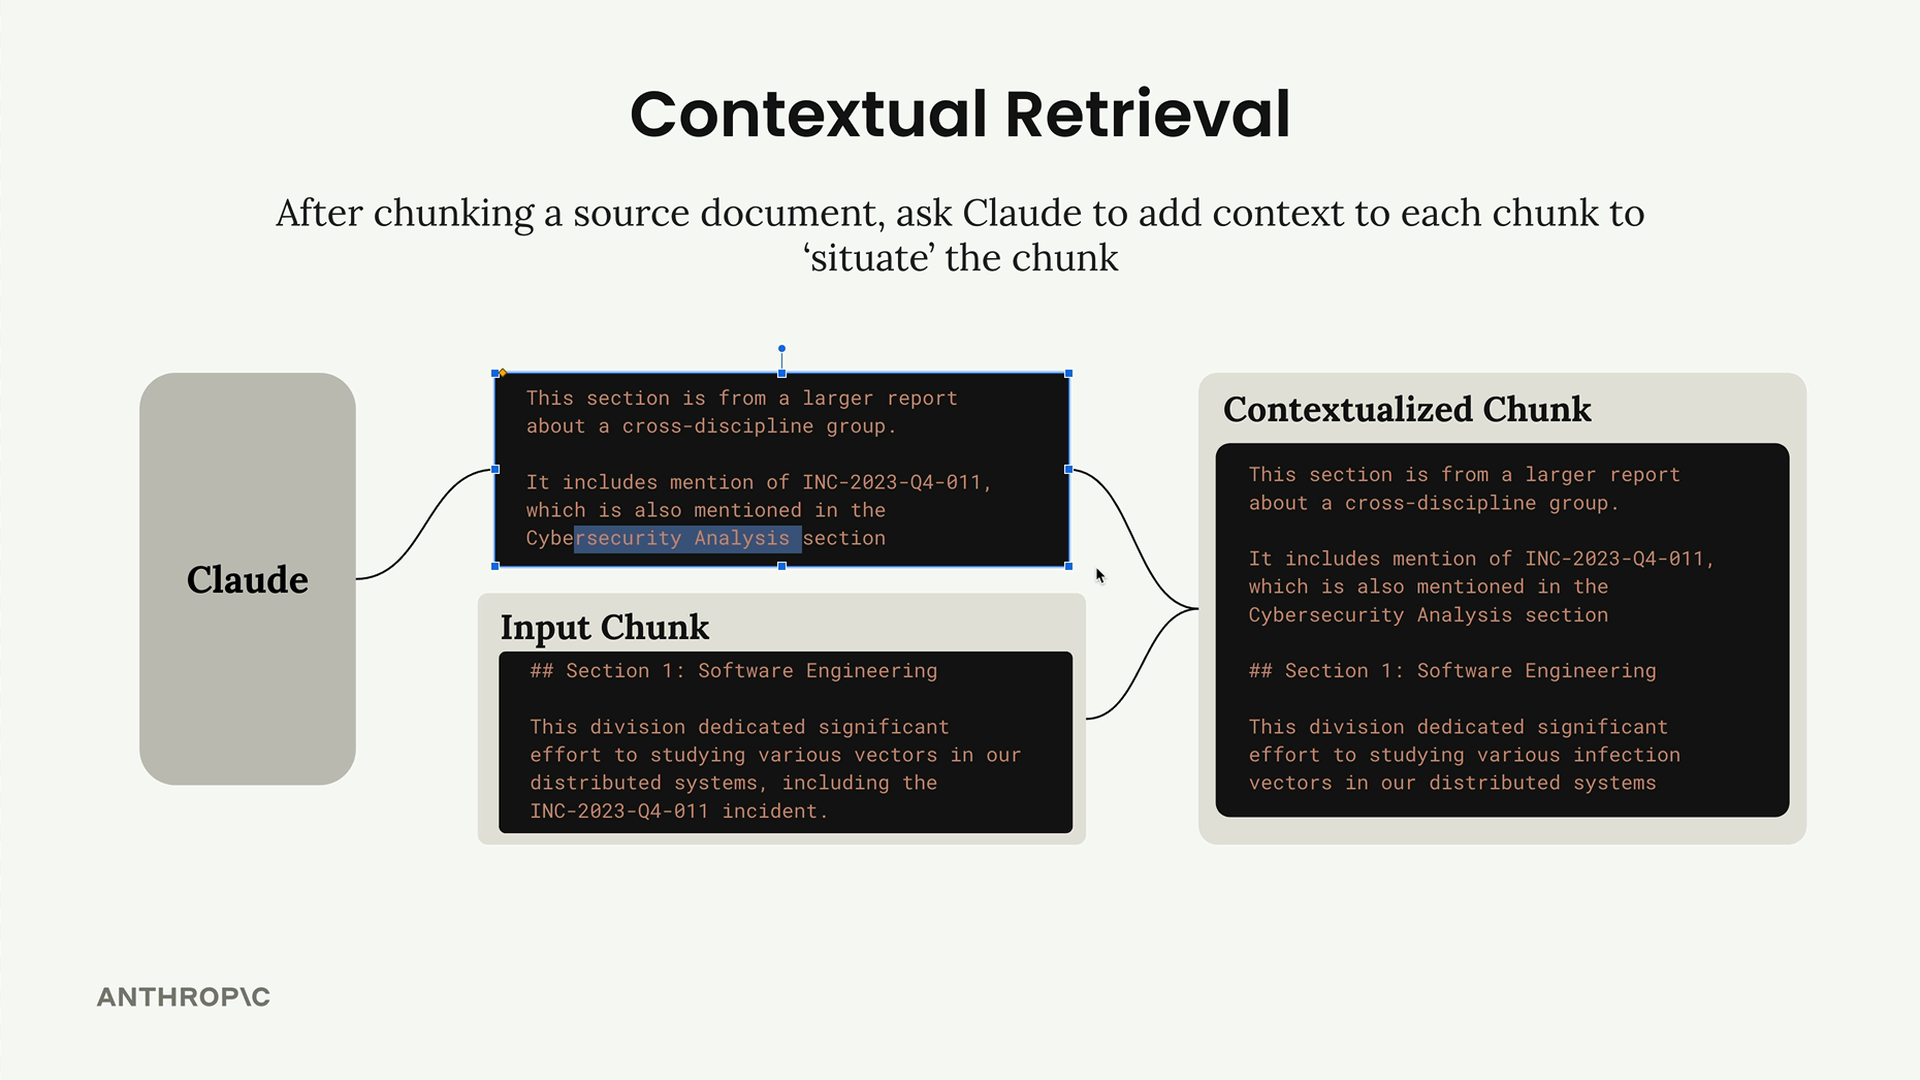
例如,如果您有一个关于软件工程的章节,其中提到了2023年的一次事件,Claude可能会生成这样的上下文:"本节内容摘自一份关于跨学科小组的更大报告。其中提到了INC-2023-04-011,该事件在网络安全分析章节中也有提及。"
处理大型文档
一个常见的问题是,当您的源文档过大,无法放入Claude的上下文窗口时。您仍然可以使用上下文检索,方法是提供一组精简后的上下文:
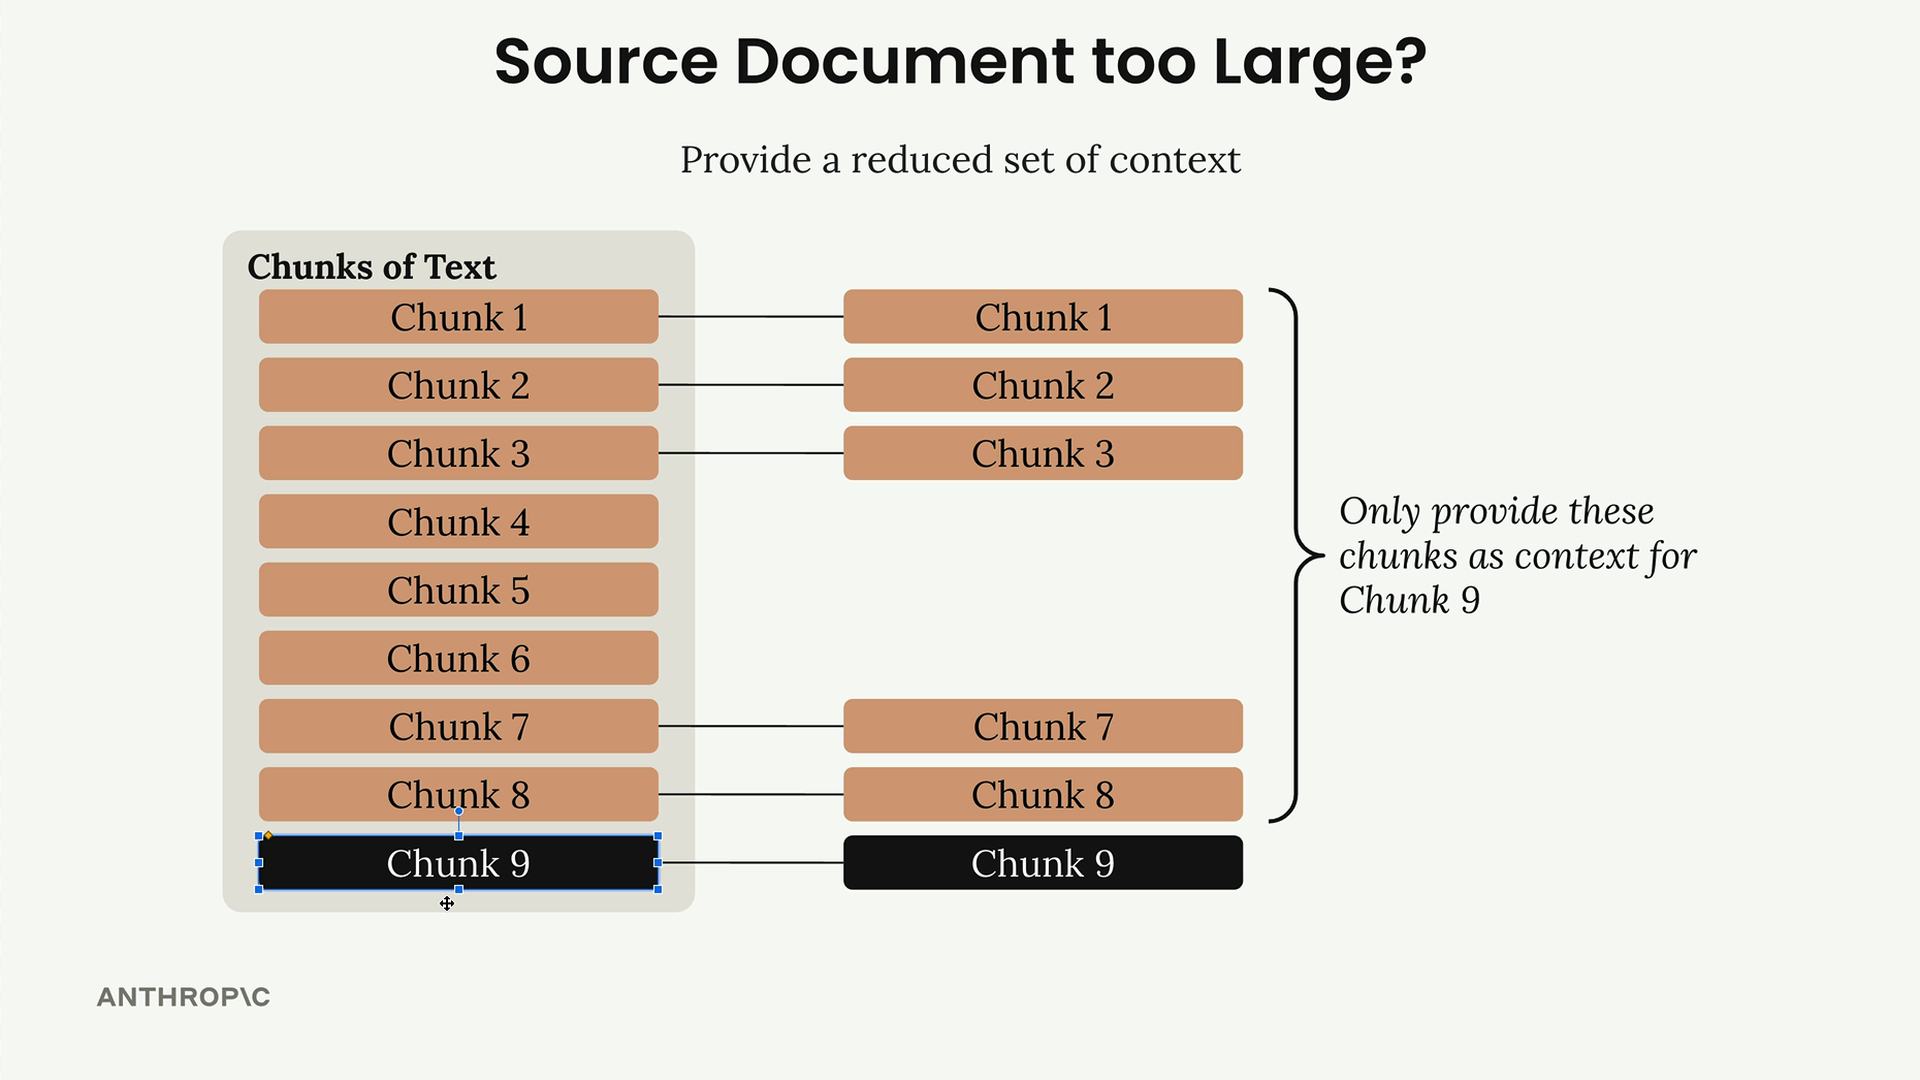
与其包含整个文档,不如提供:
- 文档开头的一些块(通常包含摘要或概要)
- 紧接在您正在添加上下文的块之前的若干块
这种方法为Claude提供了足够的信息,使其能够理解文档结构和即时上下文,而不会使提示负担过重。
实现示例
以下是一个用于为块添加上下文的基本函数:
python
def add_context(text_chunk, source_text):
    prompt = f"""
Write a short and succinct snippet of text to situate this chunk within the
overall source document for the purposes of improving search retrieval of the chunk.

Here is the original source document:
<document>
{source_text}
</document>

Here is the chunk we want to situate within the whole document:
<chunk>
{text_chunk}
</chunk>

Answer only with the succinct context and nothing else.
"""

    messages = []
    add_user_message(messages, prompt)
    result = chat(messages)

    return text_from_message(result) + "\n" + text_chunk
对于大型文档,您可以实现一种策略来选择相关的上下文块:
python
# 为每个块添加上下文,然后添加到检索器中
num_start_chunks = 2
num_prev_chunks = 2

for i, chunk in enumerate(chunks):
    context_parts = []

    # 文档开头的初始块集合
    context_parts.extend(chunks[: min(num_start_chunks, len(chunks))])

    # 当前正在添加上下文的块之前的额外块
    start_idx = max(0, i - num_prev_chunks)
    context_parts.extend(chunks[start_idx:i])

    context = "\n".join(context_parts)

    contextualized_chunk = add_context(chunk, context)
    retriever.add_document({"content": contextualized_chunk})
何时使用上下文检索
这种技术在以下情况下最有价值:
- 您的文档在各章节之间存在复杂的内部关系
- 块引用了文档其他地方定义的概念
- 理解文档结构对准确检索至关重要
- 您正在处理技术文档、报告或学术论文
虽然上下文检索会增加处理时间和成本(因为您需要进行额外的API调用),但对于上下文很重要的复杂文档而言,它可以显著提高检索准确性。