当您同时拥有独立运行的语义搜索(向量嵌入)和词法搜索(BM25)时,下一步就是将它们整合到一个统一的搜索管道中。这种混合方法结合了两种方法的优势,以提供更准确的结果。
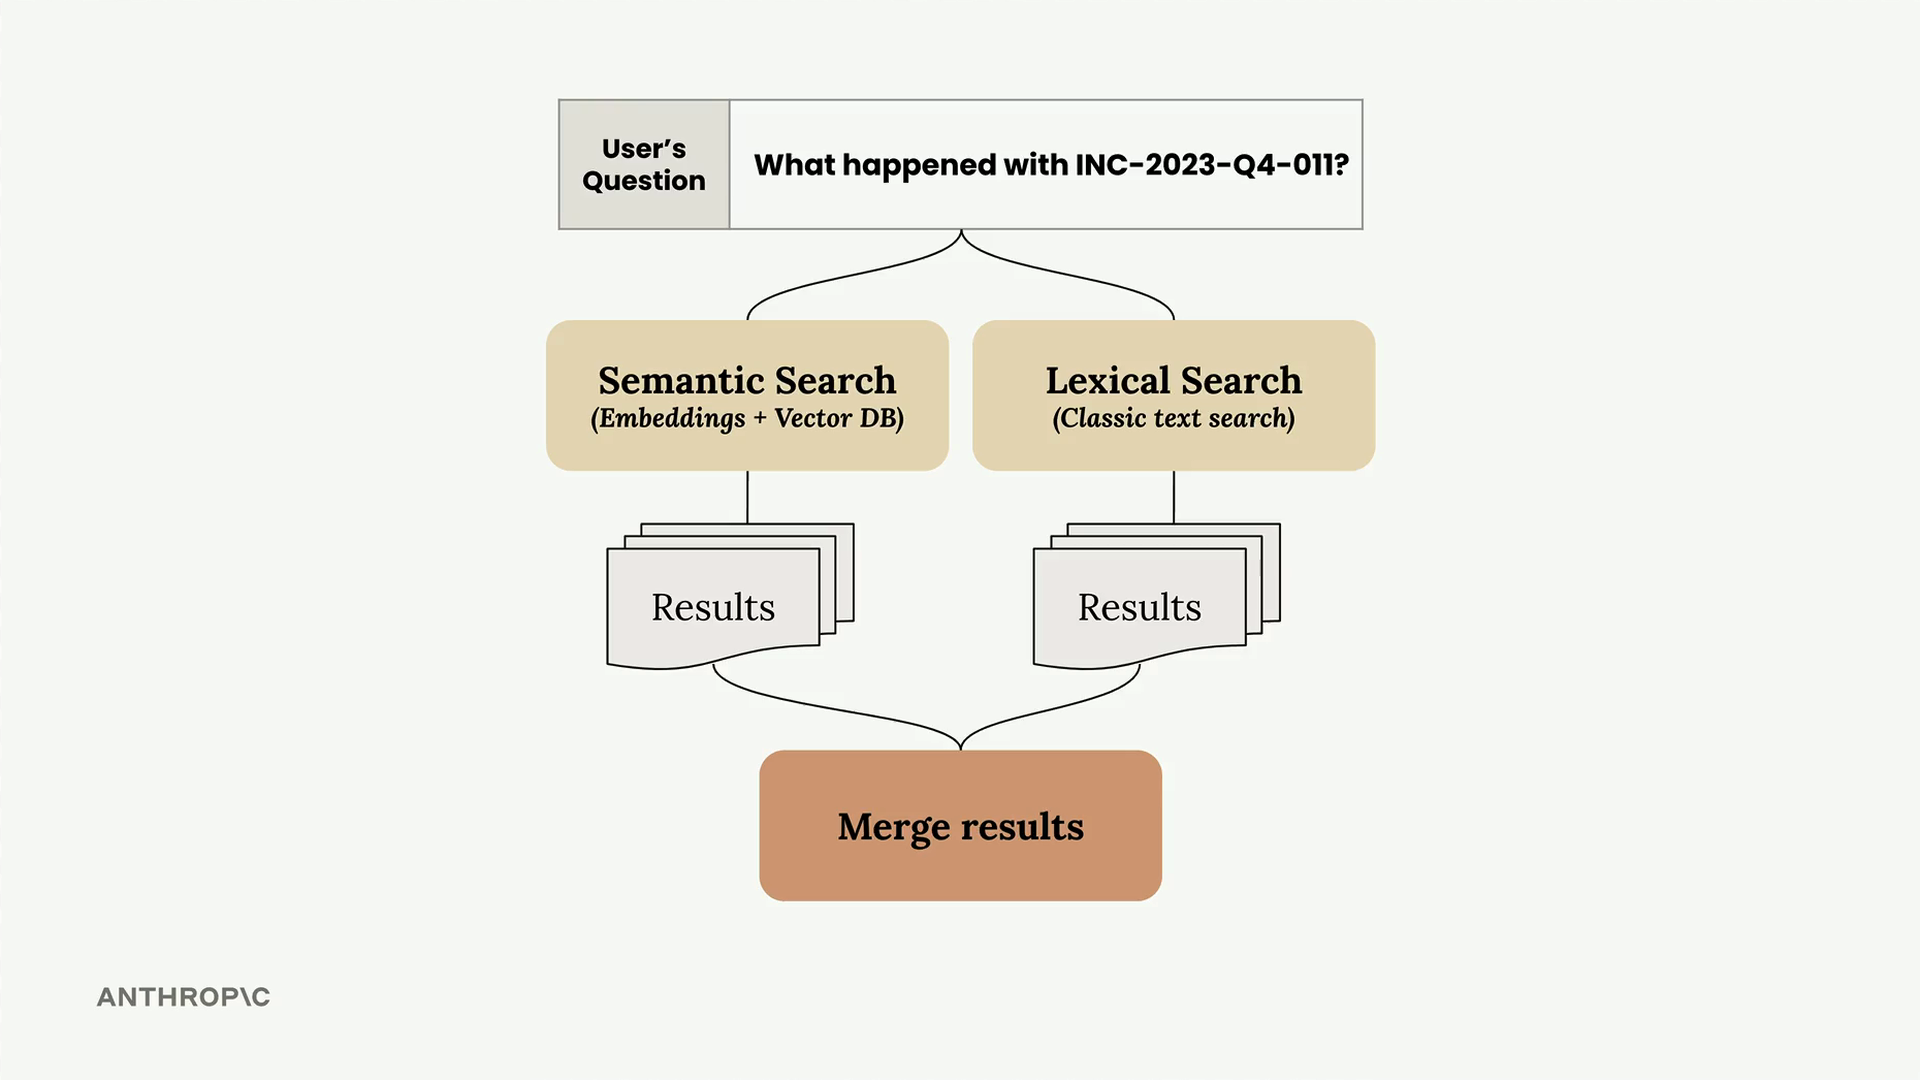
创建统一接口
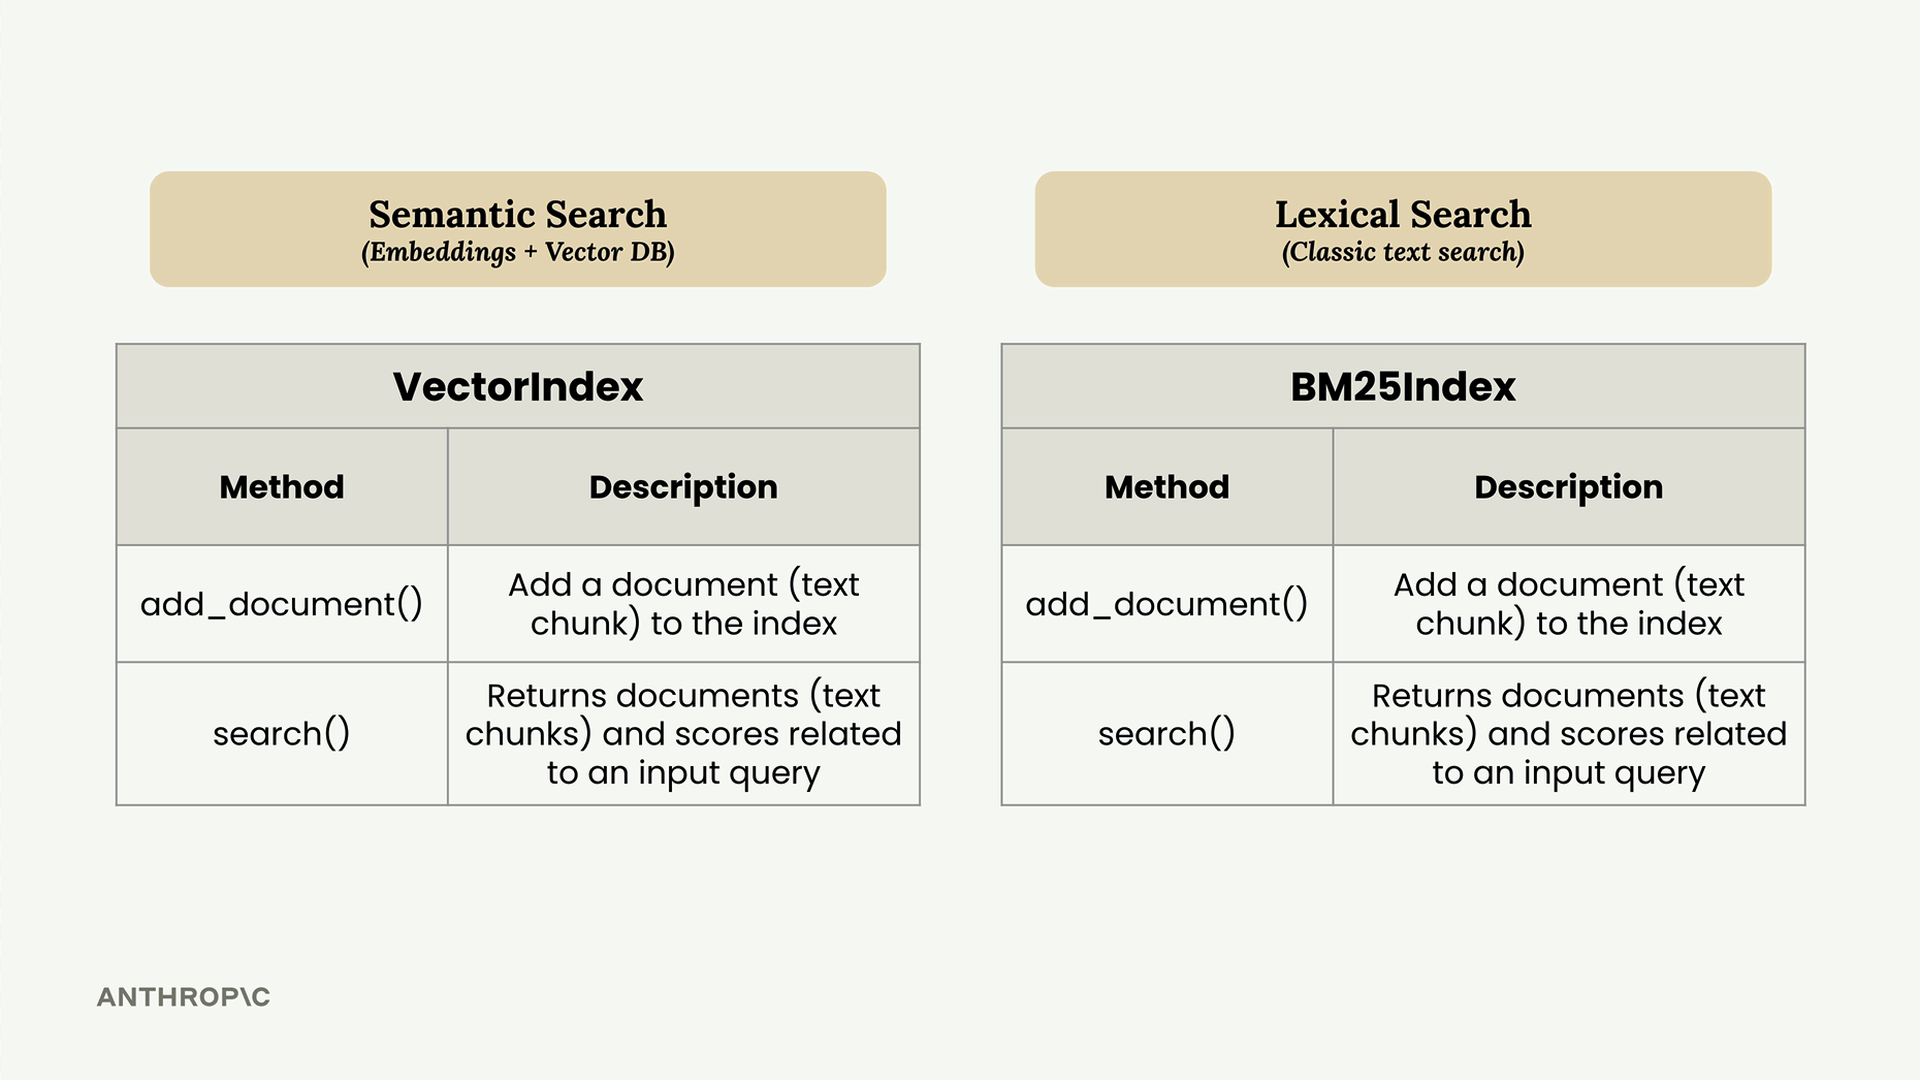
两种搜索实现共享几乎相同的 API——它们都具有以相同方式工作的 add_document() 和 search() 方法。这种一致性使得将它们封装到一个 Retriever 类中变得非常简单。
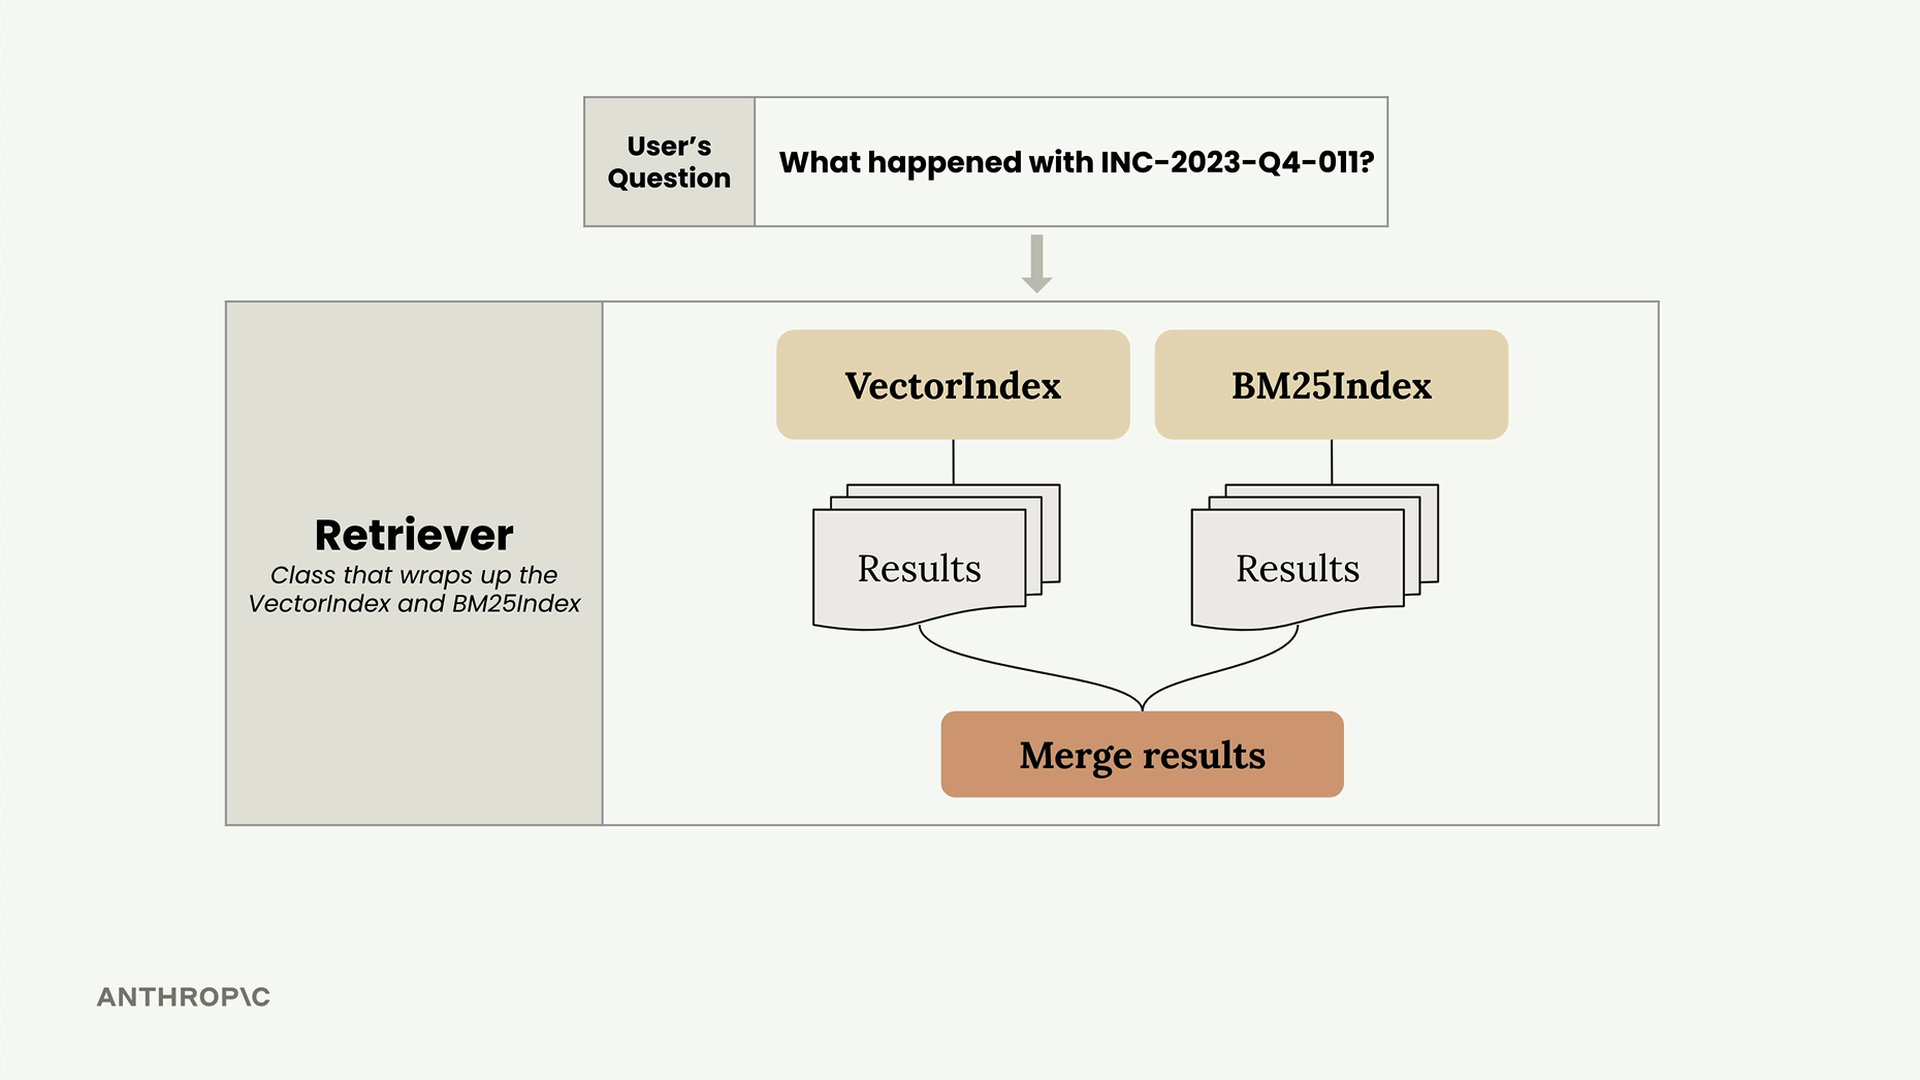
Retriever 充当协调者的角色,将用户查询转发给两个索引,收集它们的结果,并将其合并为单个排名列表。
倒数排名融合(Reciprocal Rank Fusion)
挑战在于合并来自不同搜索方法、使用不同评分系统的结果。向量搜索返回余弦相似度分数,而 BM25 返回相关性分数——您不能简单地直接合并这些数字。
因此,我们使用一种称为倒数排名融合(Reciprocal Rank Fusion,RRF)的技术。该方法关注的是结果的排名位置,而不是其原始分数。
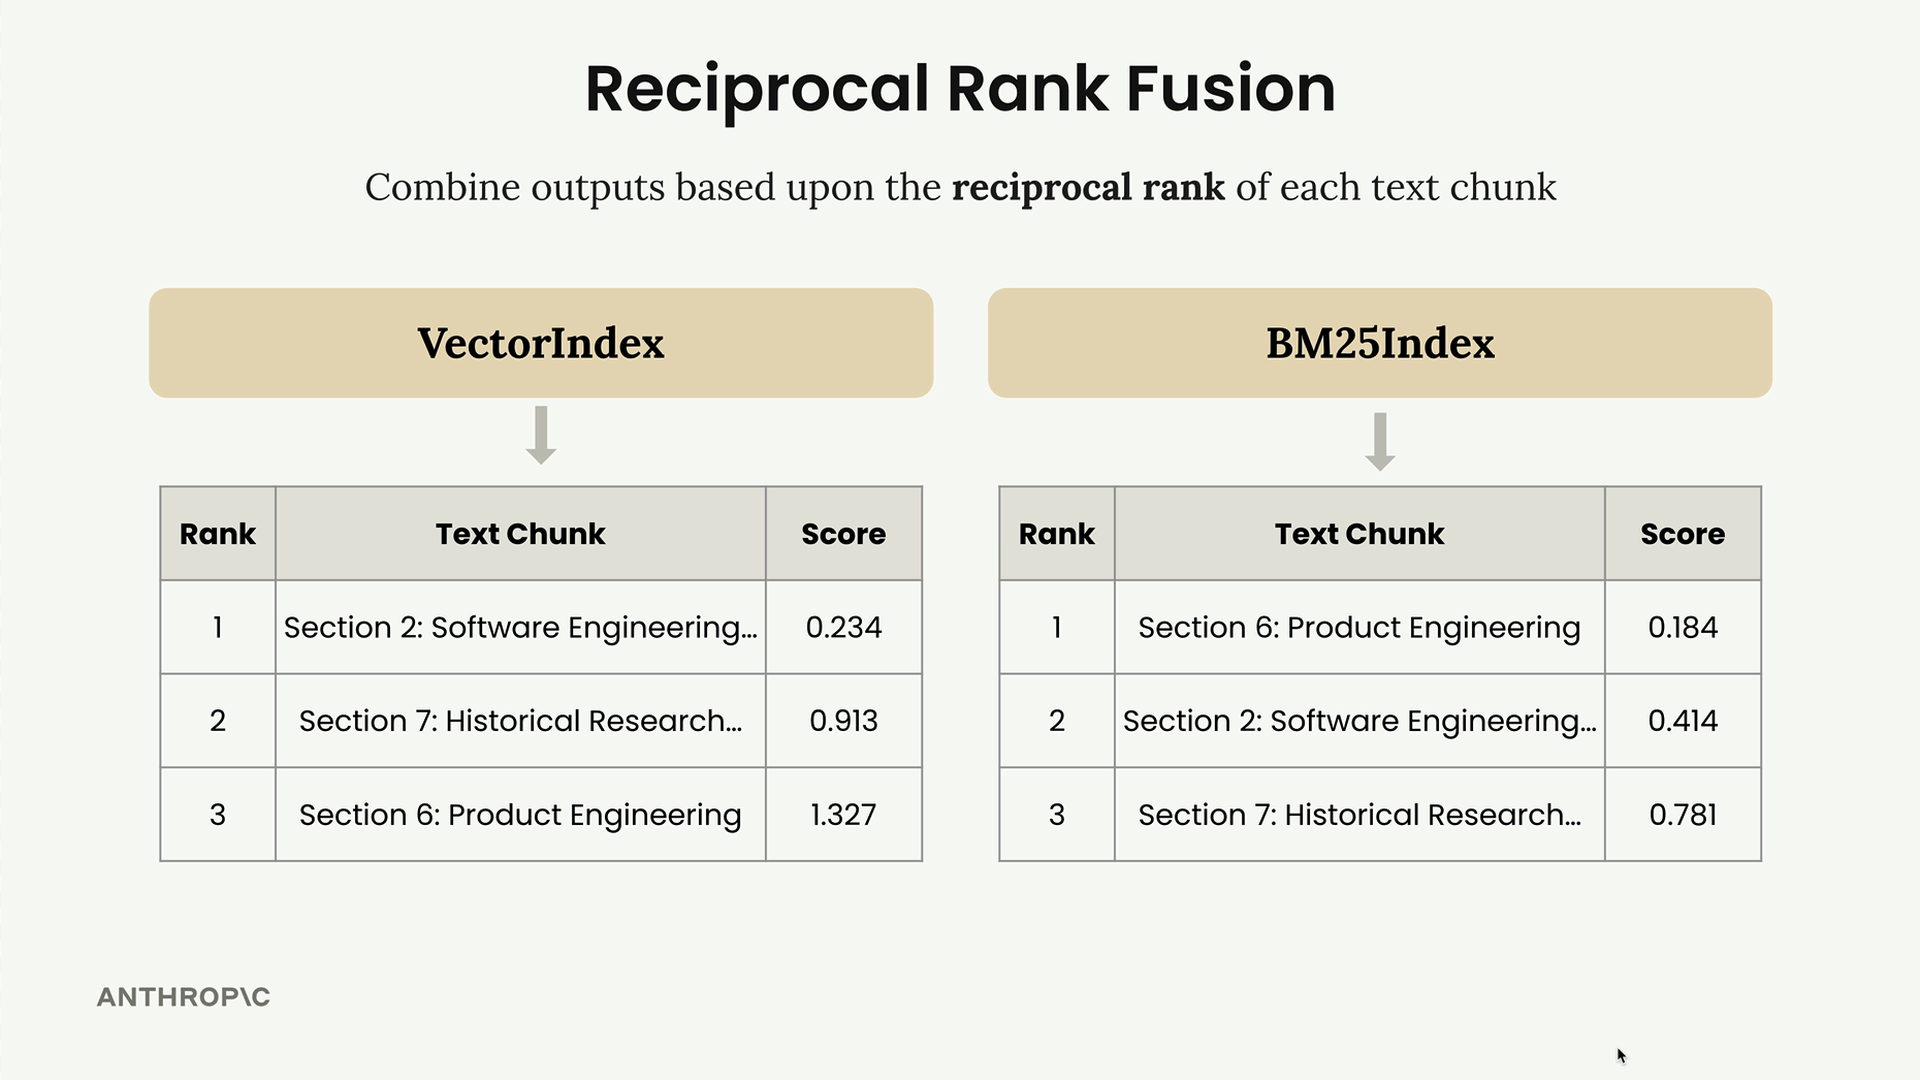
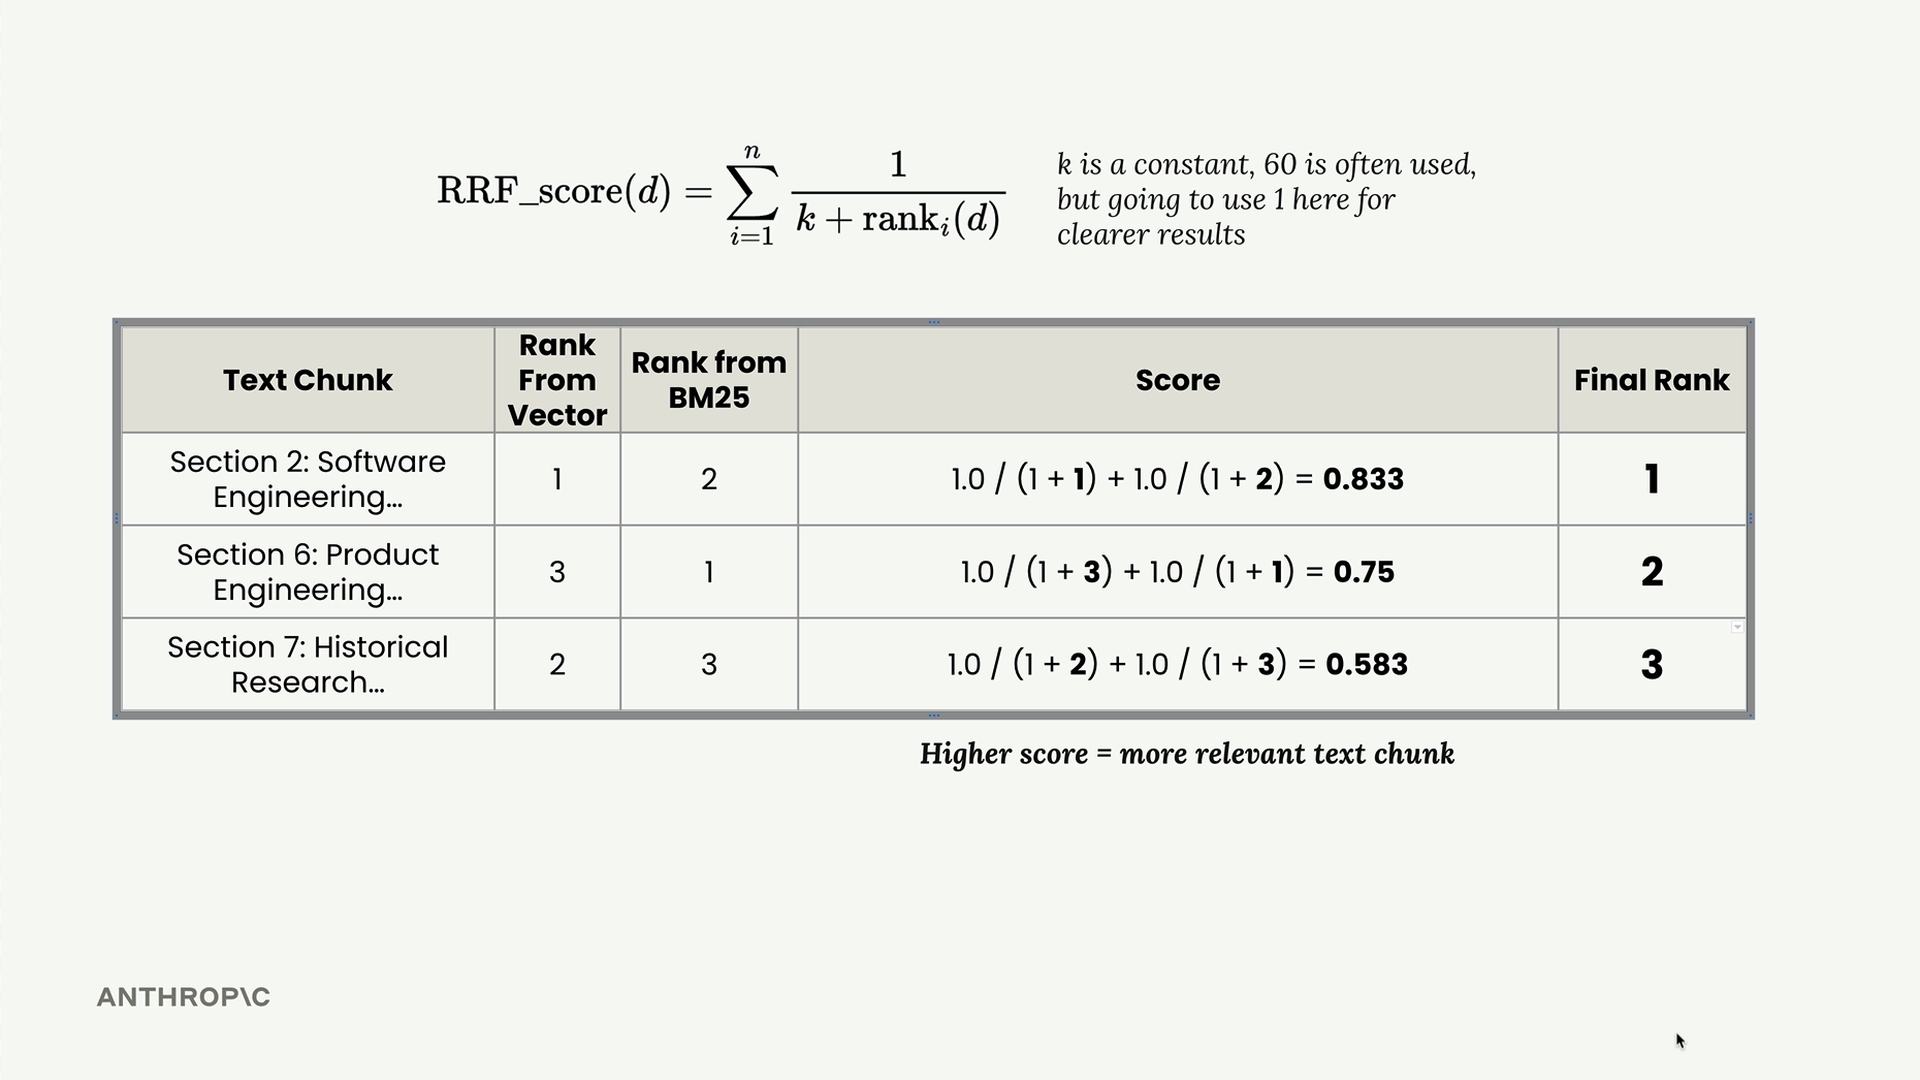
下面通过一个示例来说明其工作原理。假设您的向量搜索按顺序返回第 2、7、6 节,而 BM25 返回第 6、2、7 节。要合并这些结果:
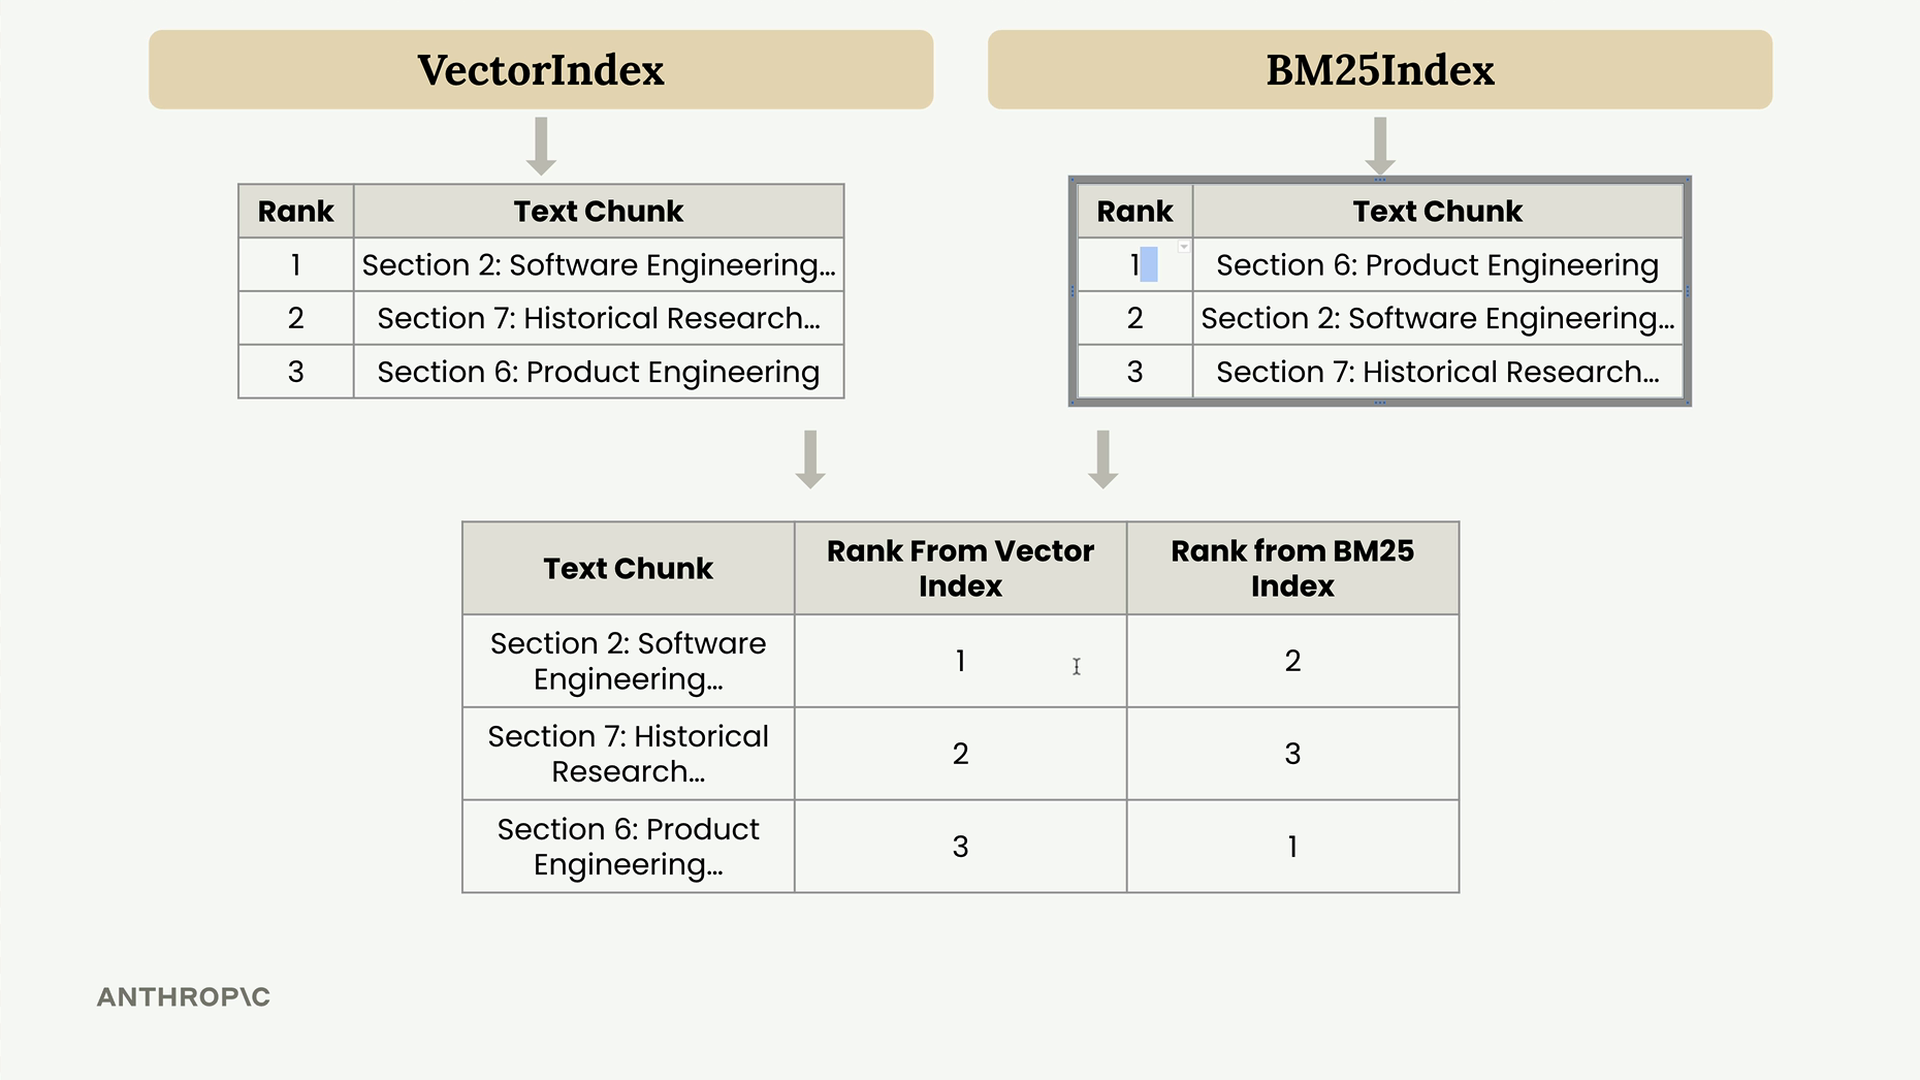
首先,创建一个表格,显示每个文本块及其在两种搜索方法中的排名:
- 第 2 节:向量排名 1,BM25 排名 2
- 第 7 节:向量排名 2,BM25 排名 3
- 第 6 节:向量排名 3,BM25 排名 1
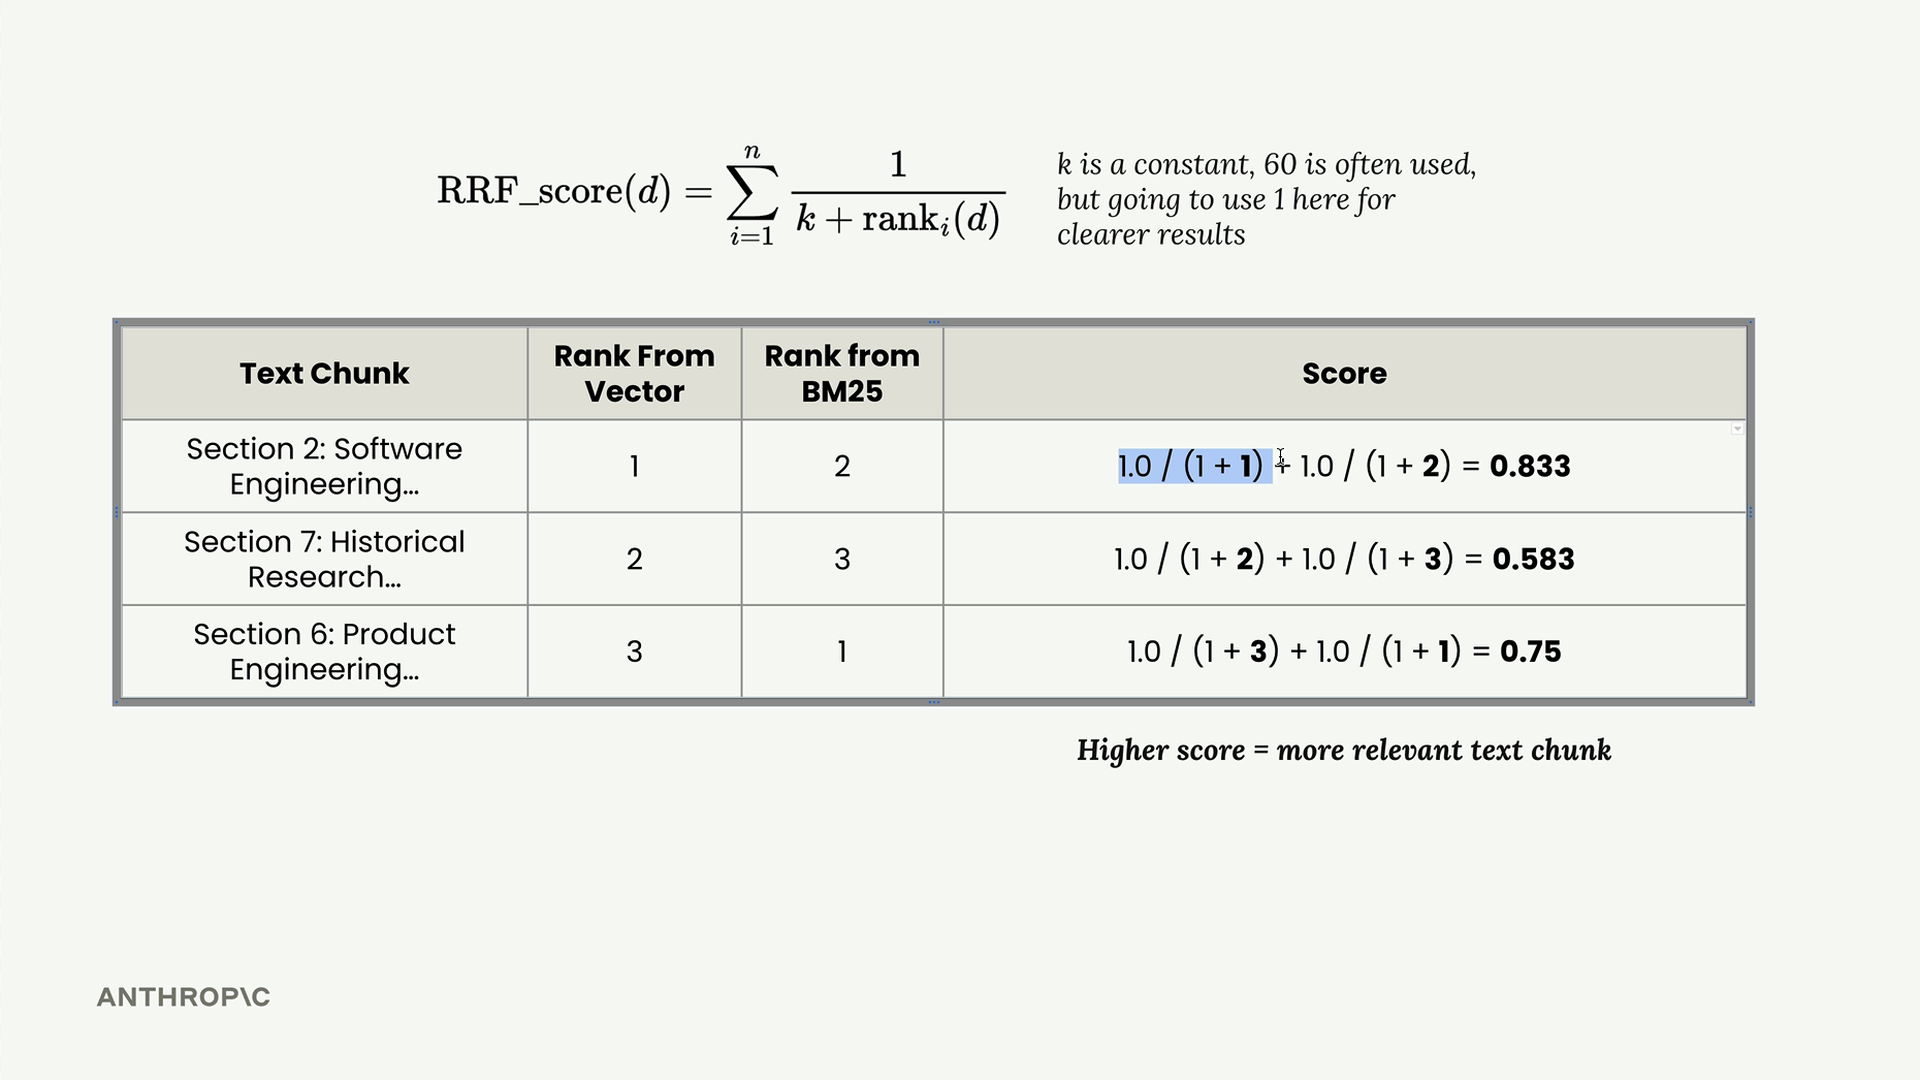
然后应用 RRF 公式为每个文本块计算一个综合分数:
RRF_score(d) = Σ(1 / (k + rank_i(d)))其中 k 是一个常数(通常为 60,但为了结果更清晰,我们将使用 1),rank_i(d) 是文档 d 在第 i 个搜索结果中的排名。
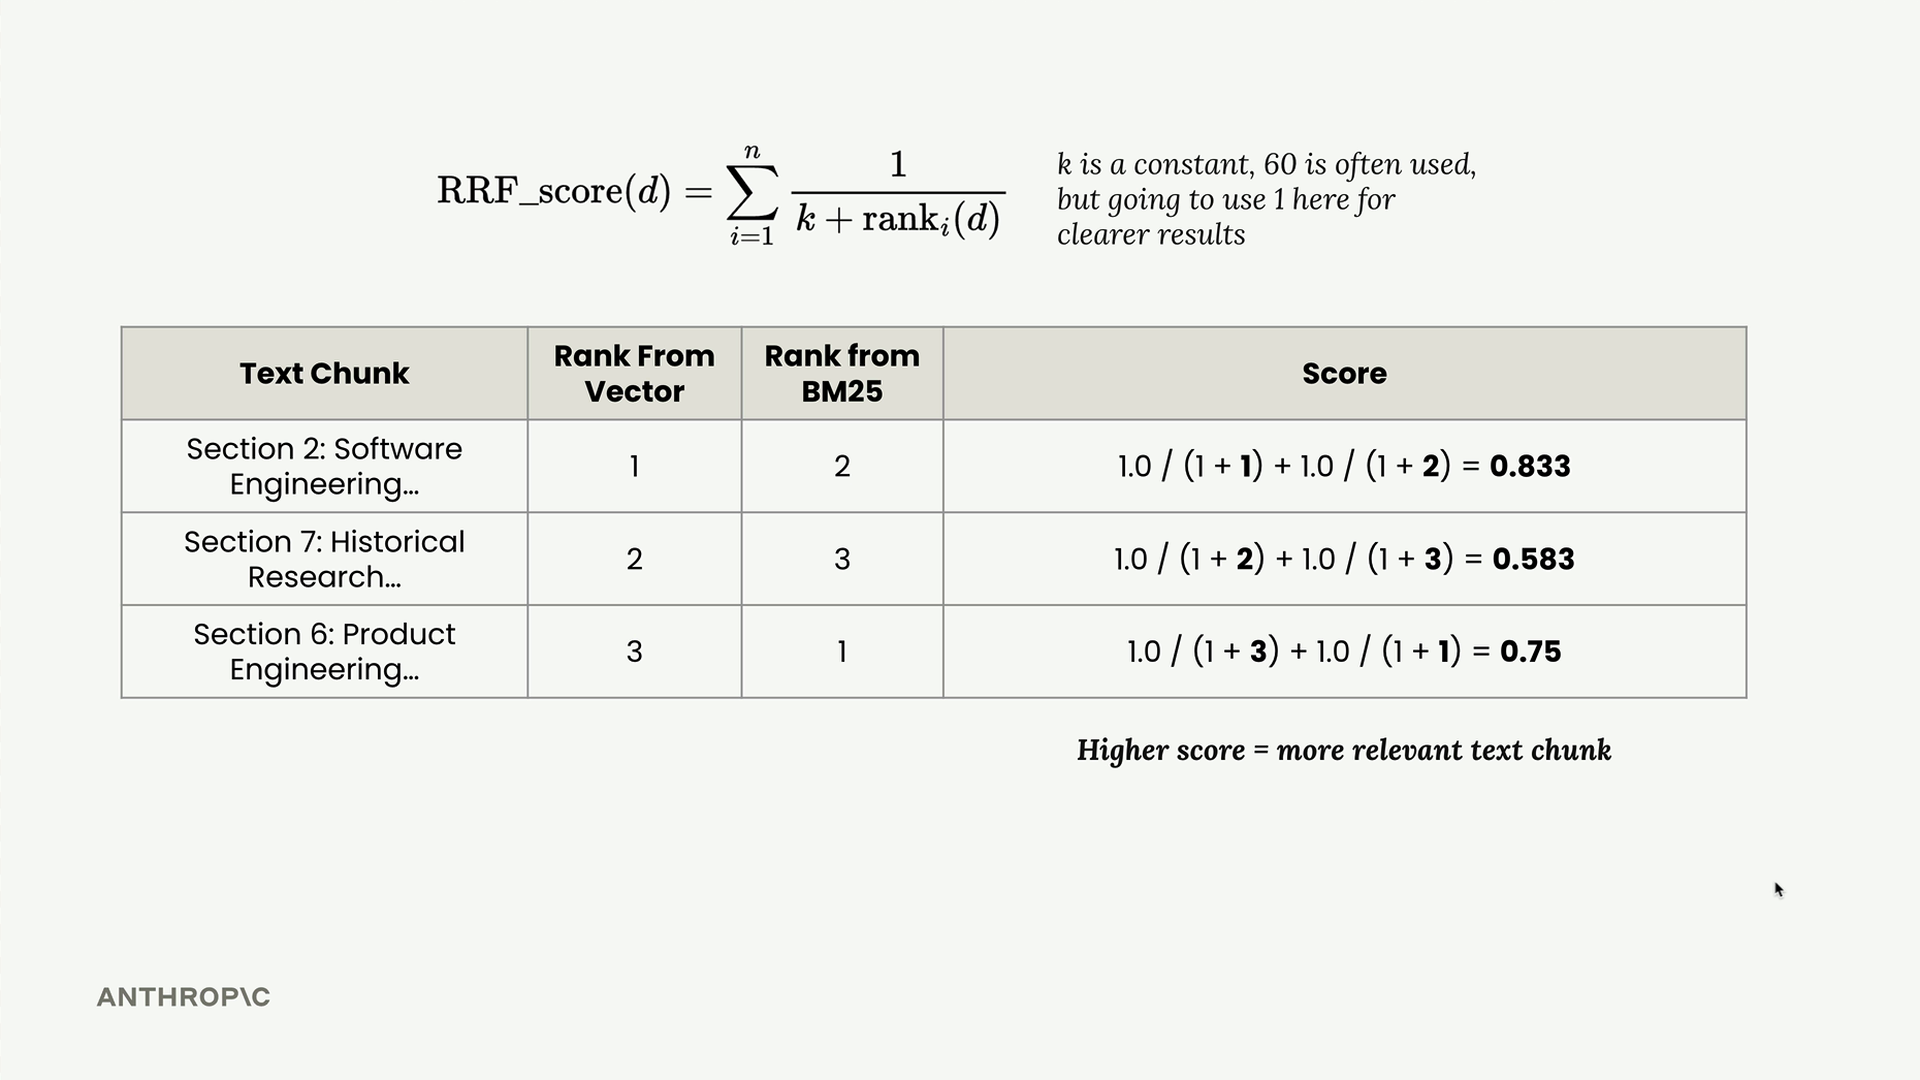
以我们的示例为例:
- 第 2 节:1.0/(1+1) + 1.0/(1+2) = 0.833
- 第 7 节:1.0/(1+2) + 1.0/(1+3) = 0.583
- 第 6 节:1.0/(1+3) + 1.0/(1+1) = 0.75
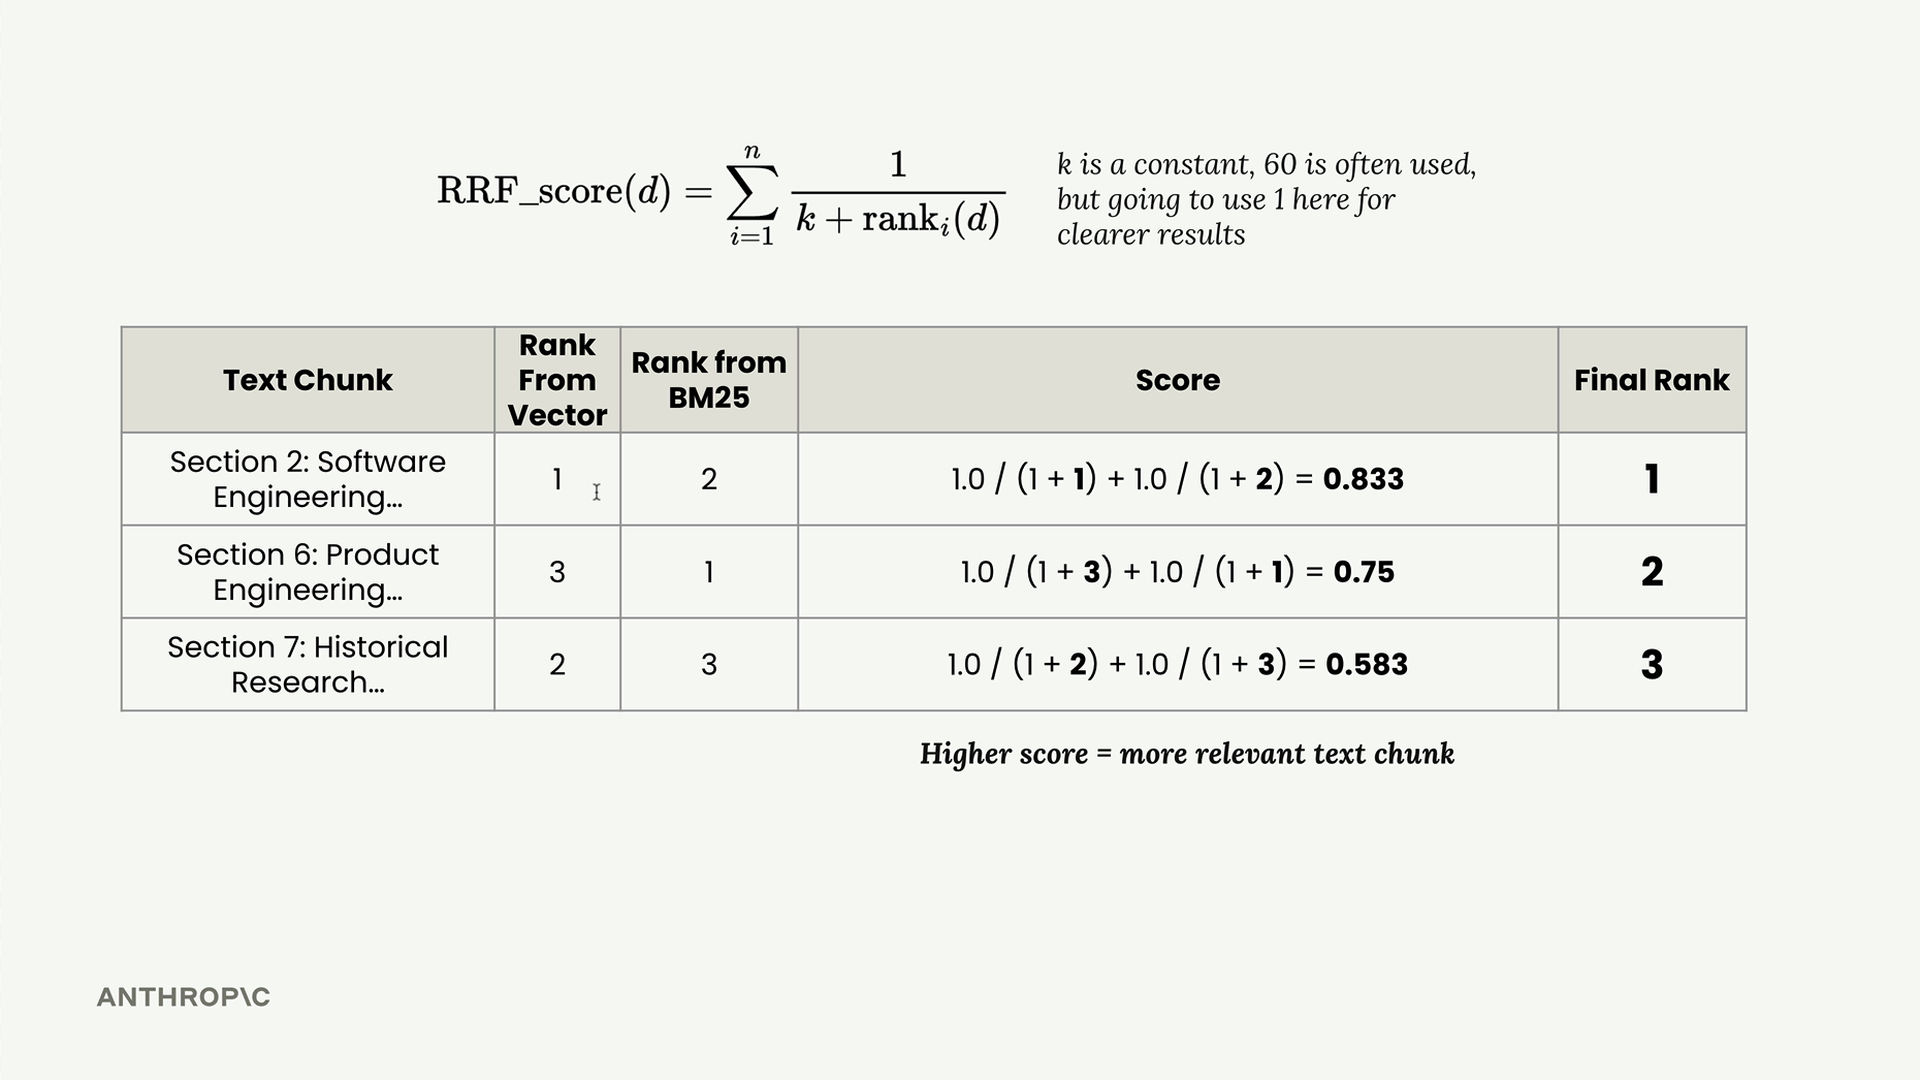
最终排名为:第 2 节(0.833)、第 6 节(0.75)、第 7 节(0.583)。这符合直觉——第 2 节在两次搜索中表现都很好,第 6 节结果参差不齐,而第 7 节整体排名较低。
实现
Retriever 类的实现非常简单:
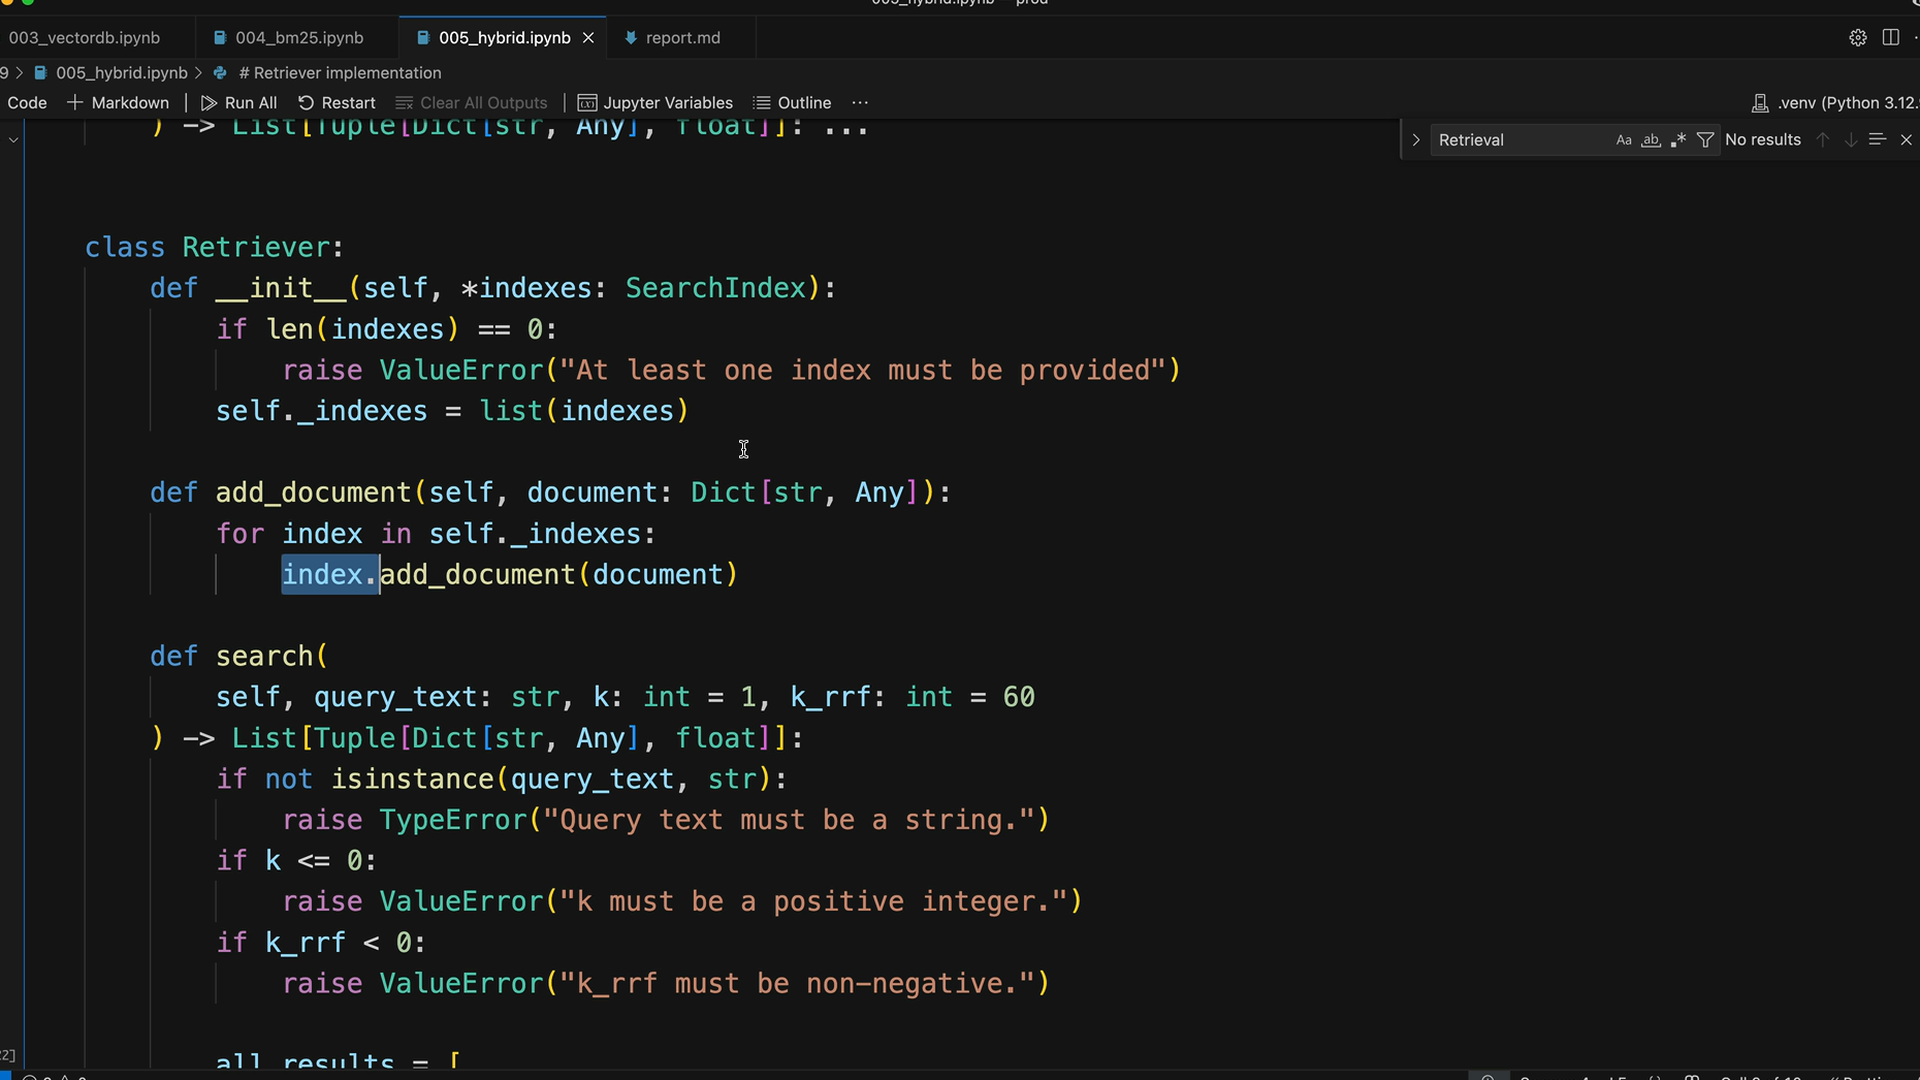
class Retriever:
    def __init__(self, *indexes):
        self._indexes = list(indexes)

    def add_document(self, document):
        for index in self._indexes:
            index.add_document(document)

    def search(self, query_text, k=1, k_rrf=60):
        # 从所有索引中获取结果
        all_results = [index.search(query_text, k) for index in self._indexes]

        # 应用倒数排序融合(reciprocal rank fusion)
        # ……此处为合并逻辑……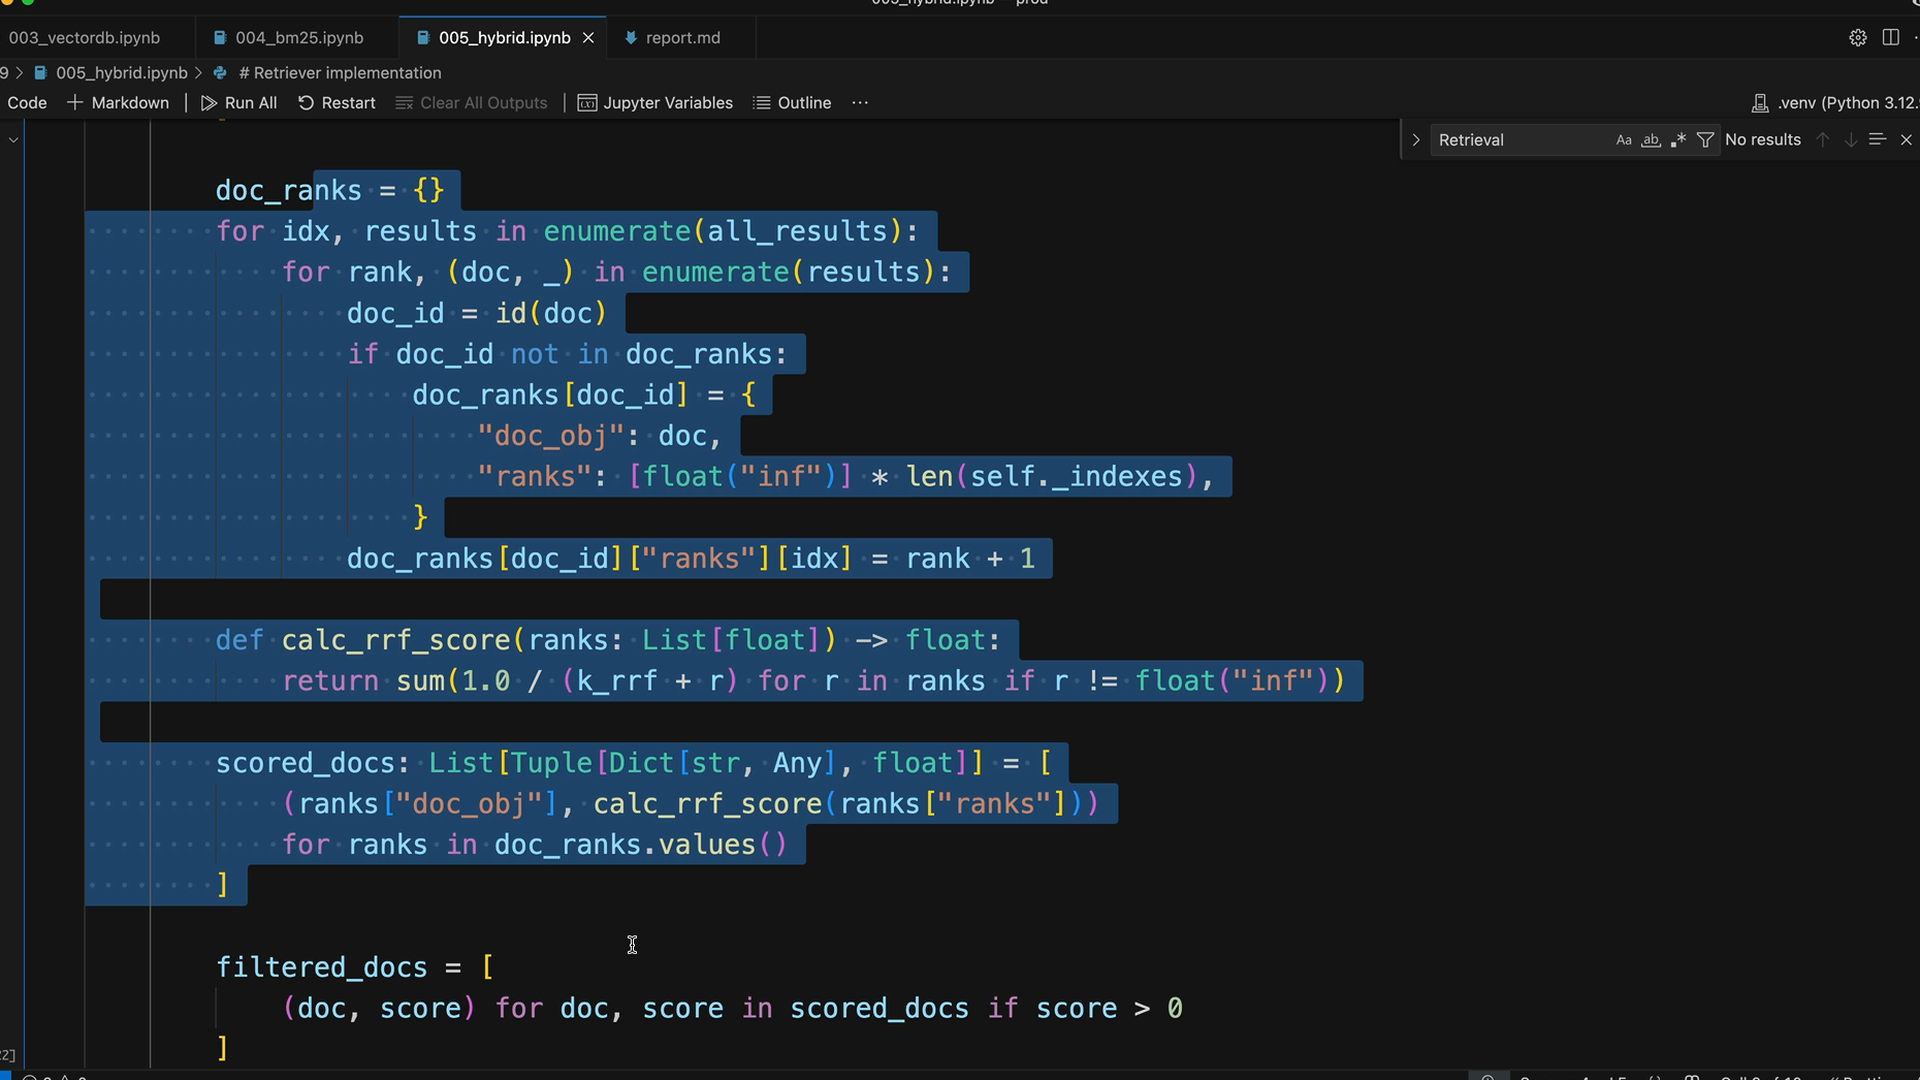
合并逻辑会跟踪所有搜索结果中的文档排名,计算 RRF 分数,并返回按综合分数排序的前 k 个文档。
测试混合方法
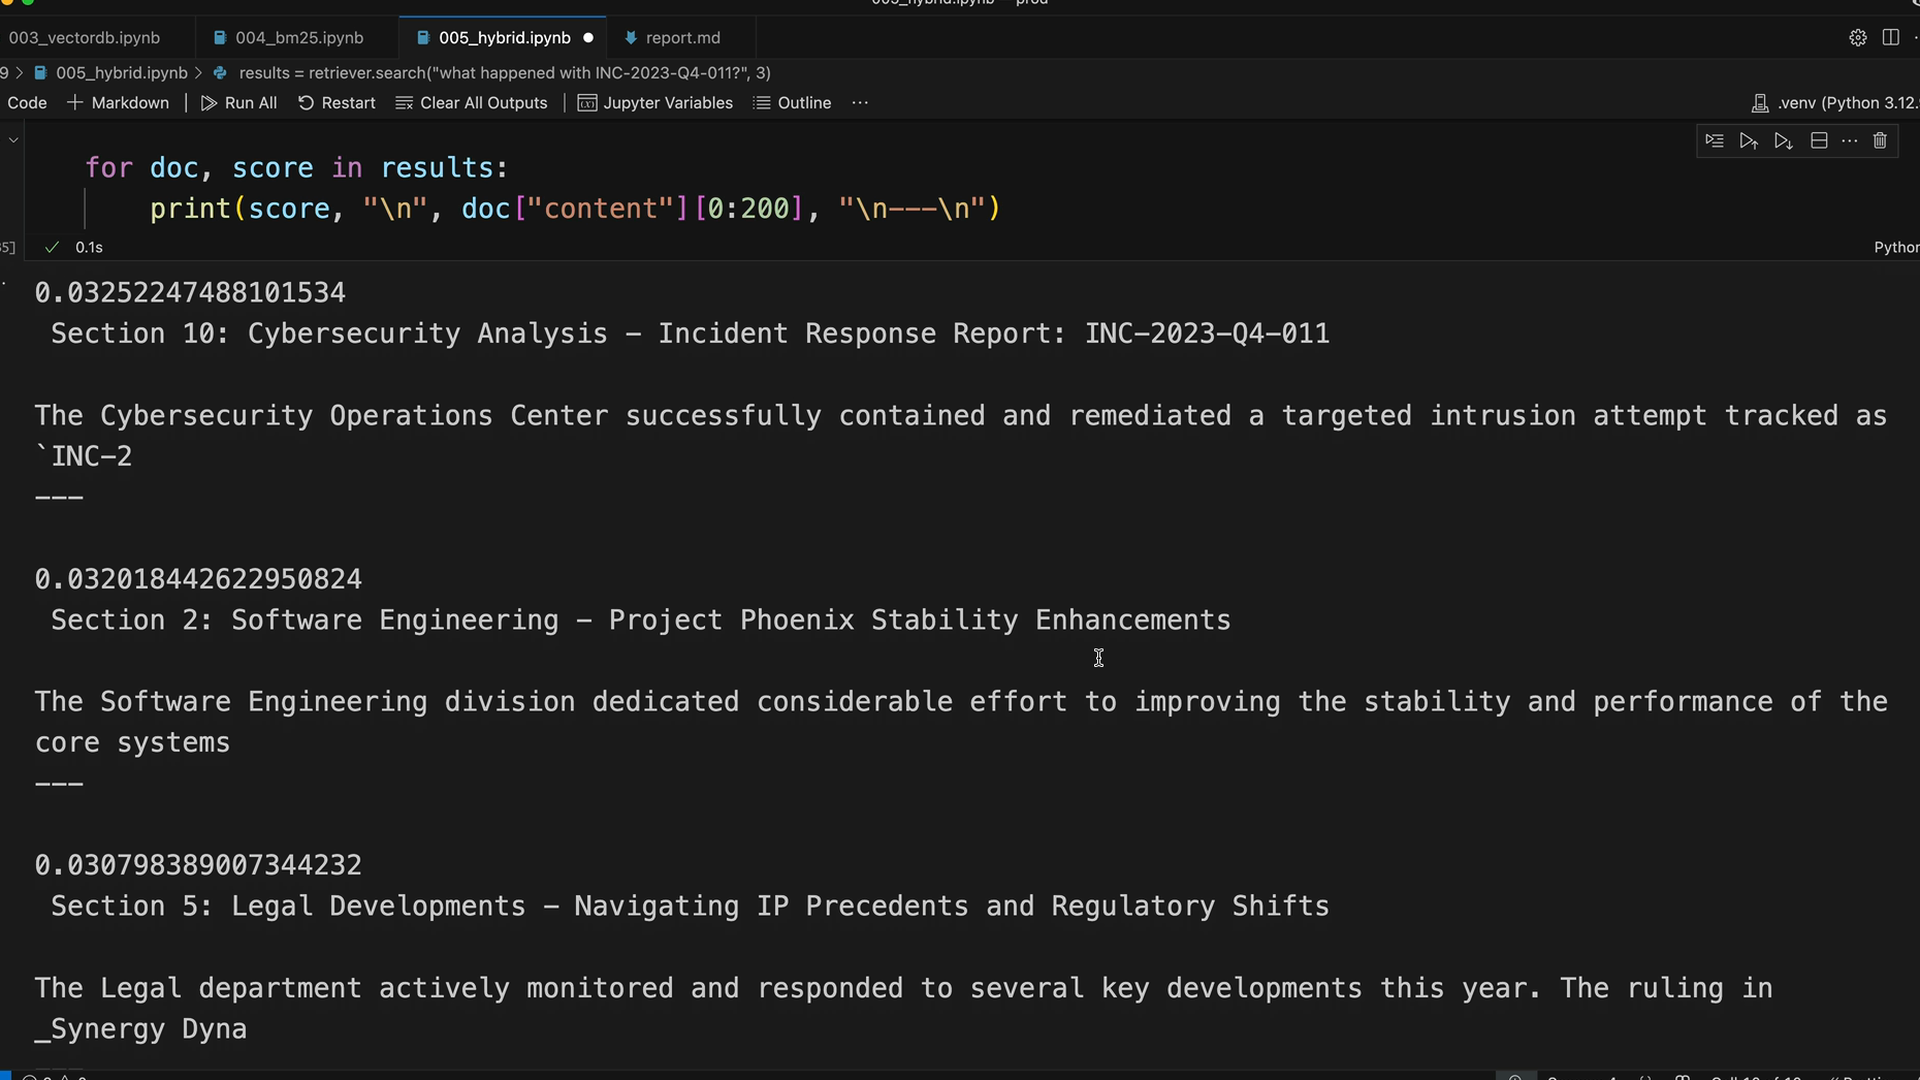
当使用查询"what happened with INC-2023-Q4-011?"(INC-2023-Q4-011 发生了什么?)进行测试时,混合方法提供的结果比单纯的向量搜索好得多:
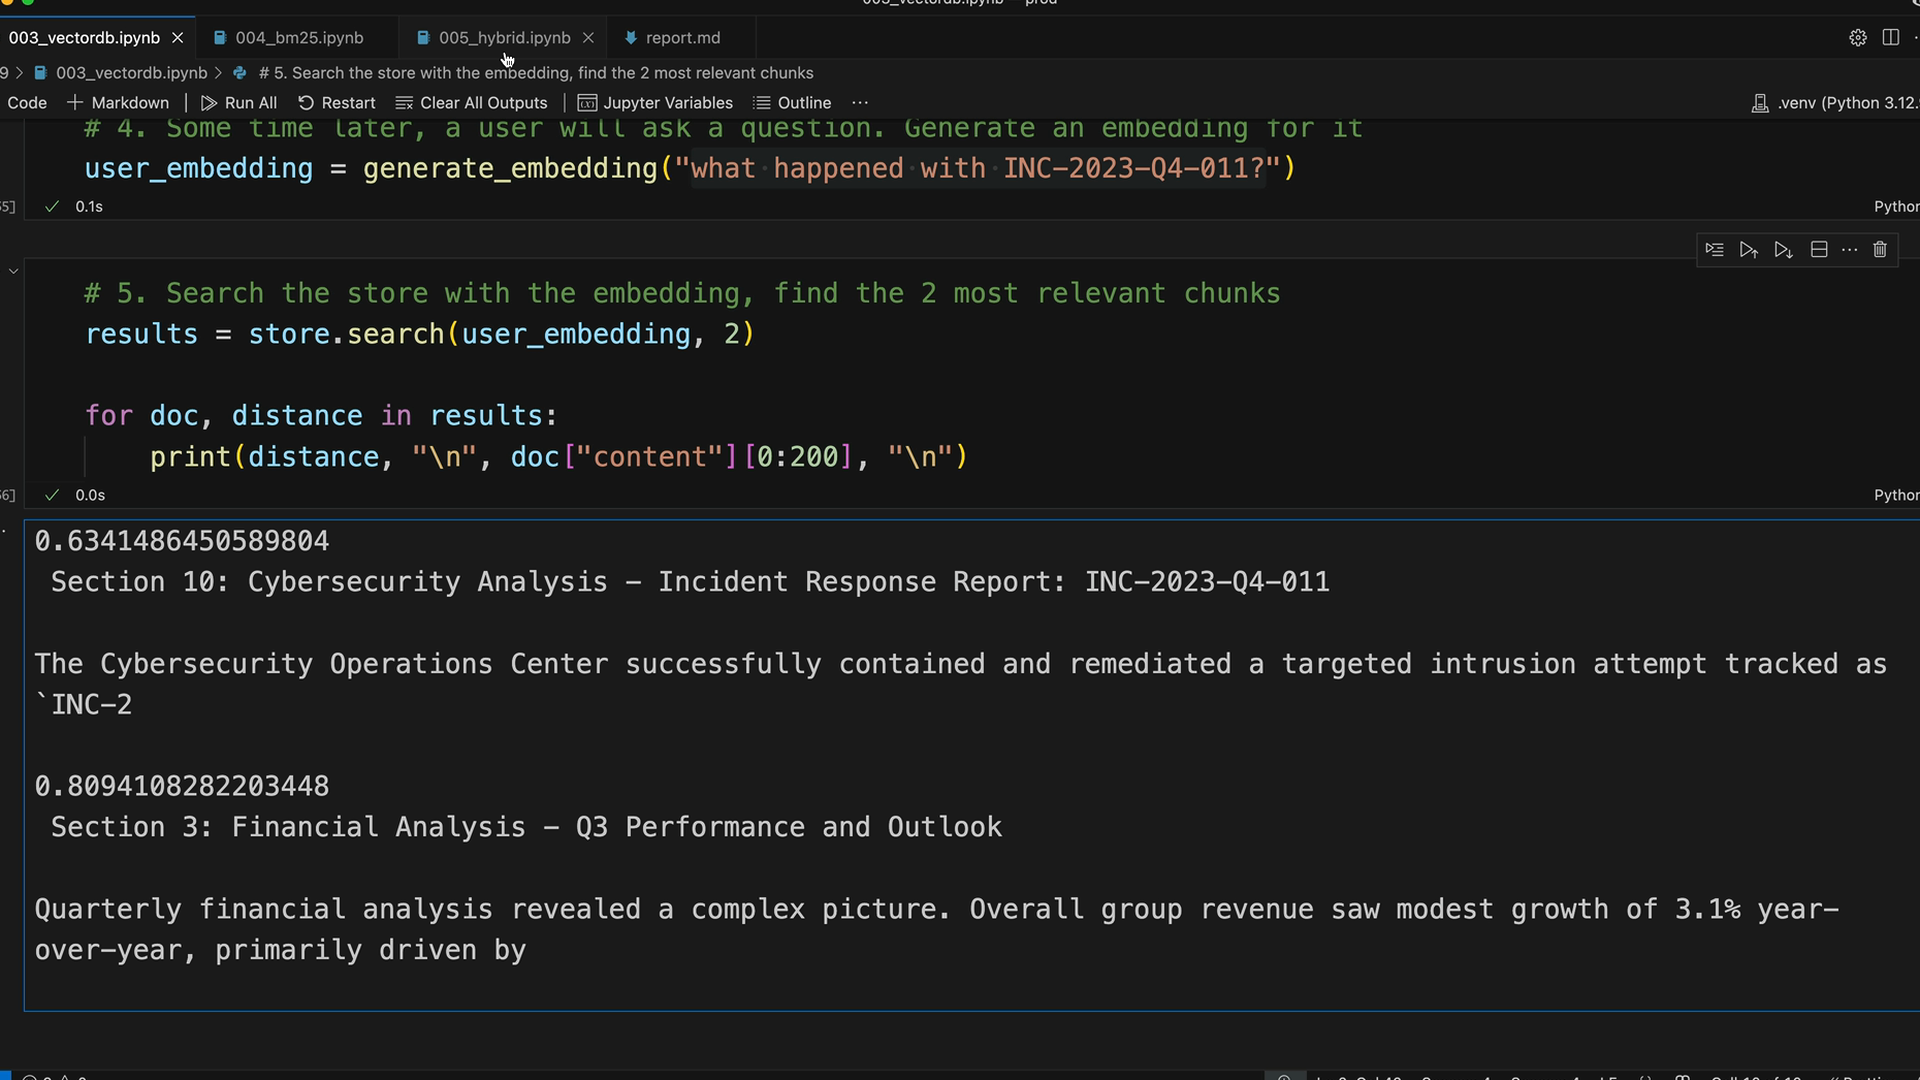
结果现在正确地优先排列为:
- 第 10 节:网络安全分析(实际的事件报告)
- 第 2 节:软件工程(相关背景信息)
- 第 5 节:法律动态(相关性较低但仍相关)
混合架构的优势
这种设计带来了若干优势:
- 模块化设计:每个搜索索引都以相同的 API 独立实现
- 易于扩展:您可以通过实现相同的
search()和add_document()接口来添加新的搜索方法 - 更高的准确性:将语义理解与精确关键词匹配相结合
- 灵活的融合:无论您合并多少个搜索索引,RRF 算法都能正常工作
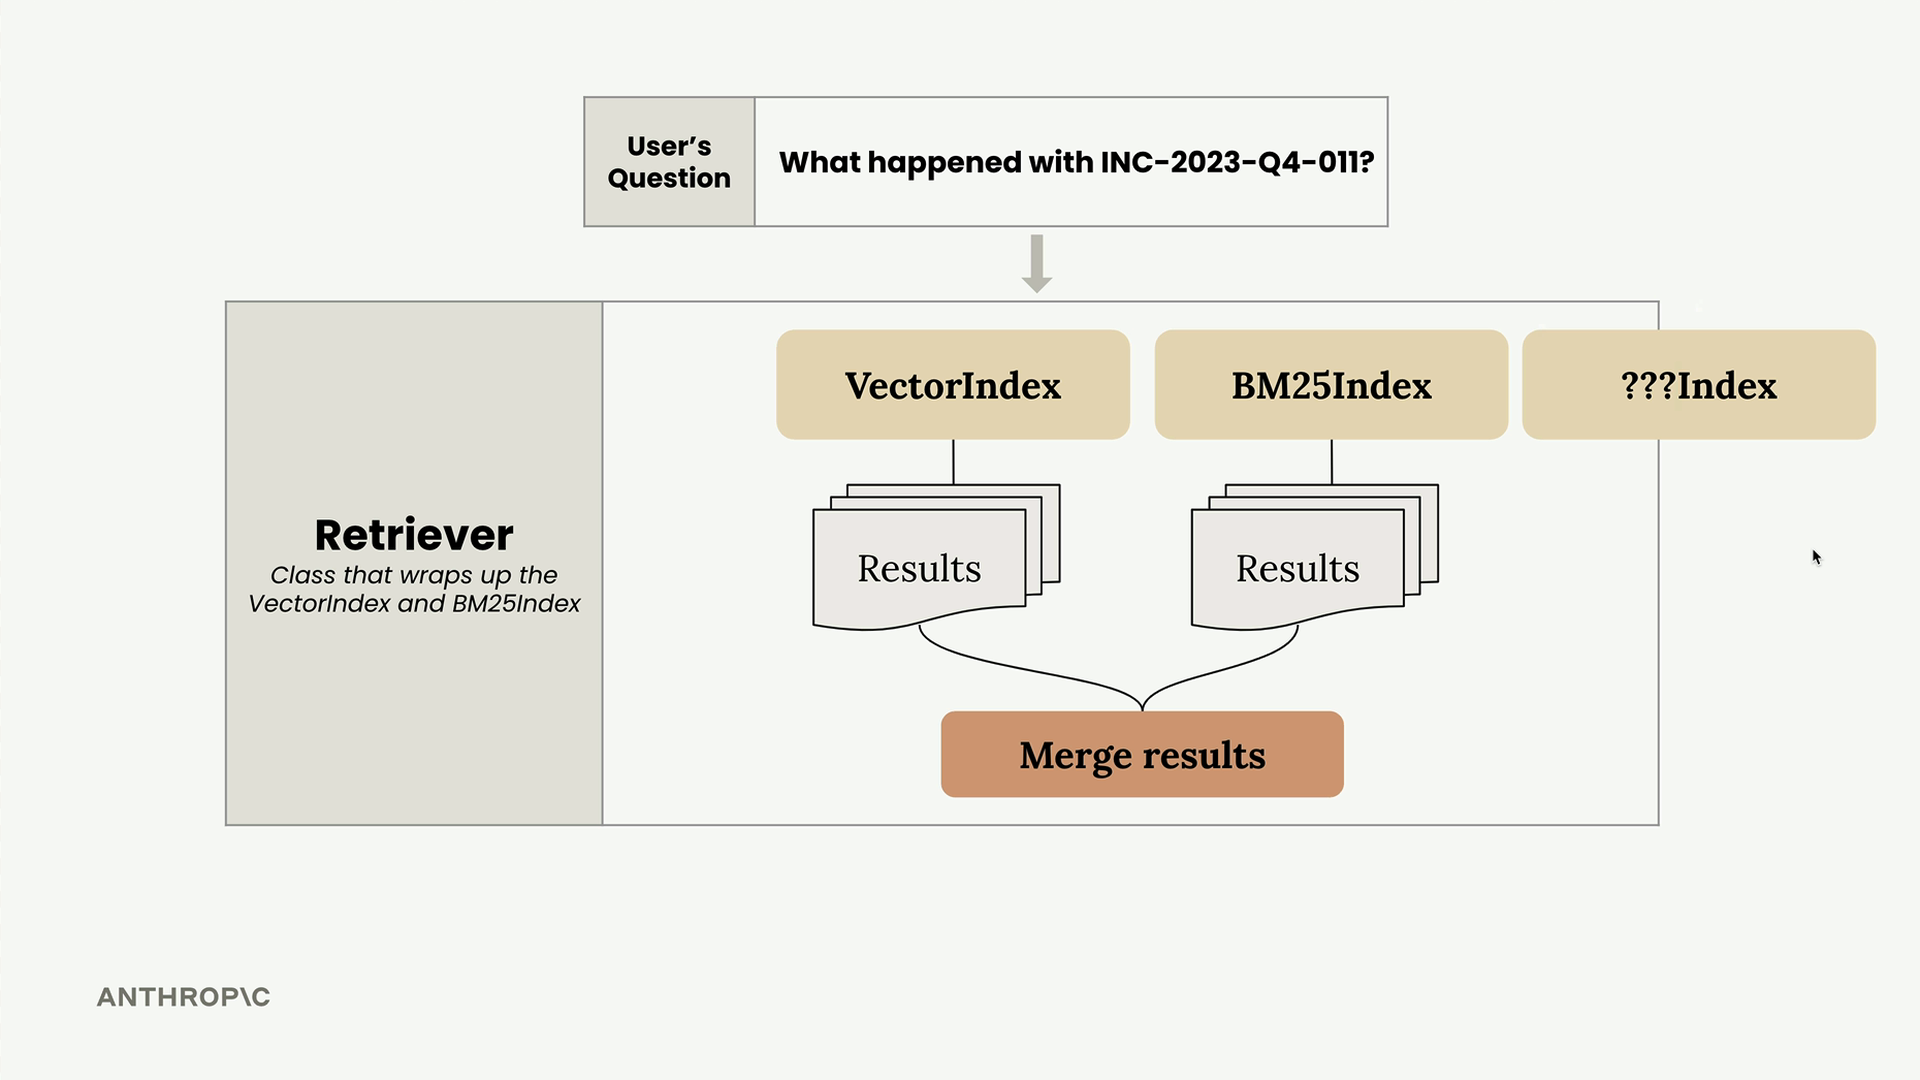
一致的 API 意味着您可以轻松添加第三个搜索索引——也许是专门用于命名实体识别或处理特定文档类型的索引——而 Retriever 会自动将其结果纳入最终排名中。
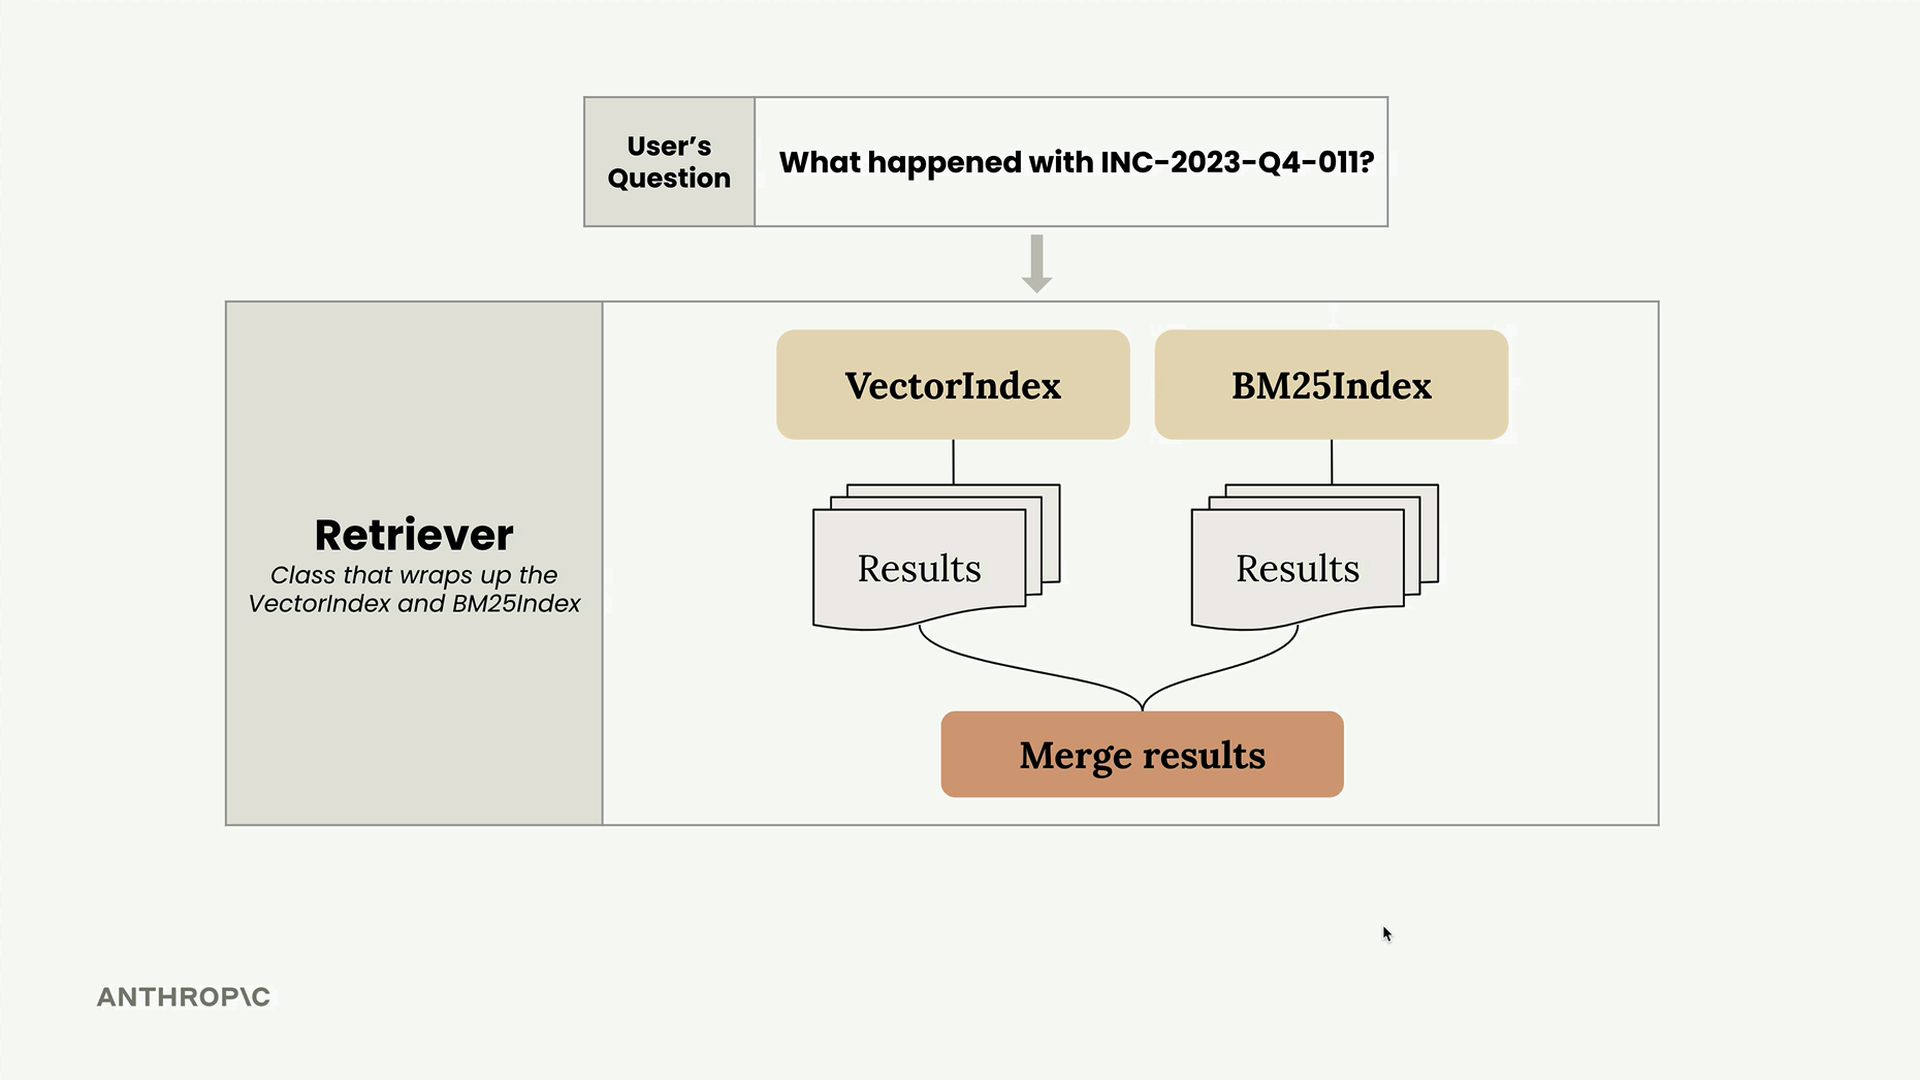
这种混合搜索基础架构提供的检索能力,比单独使用任一方法都要稳健得多,为您的 RAG 管道在更广泛的查询类型上实现更佳性能奠定了基础。