加载中
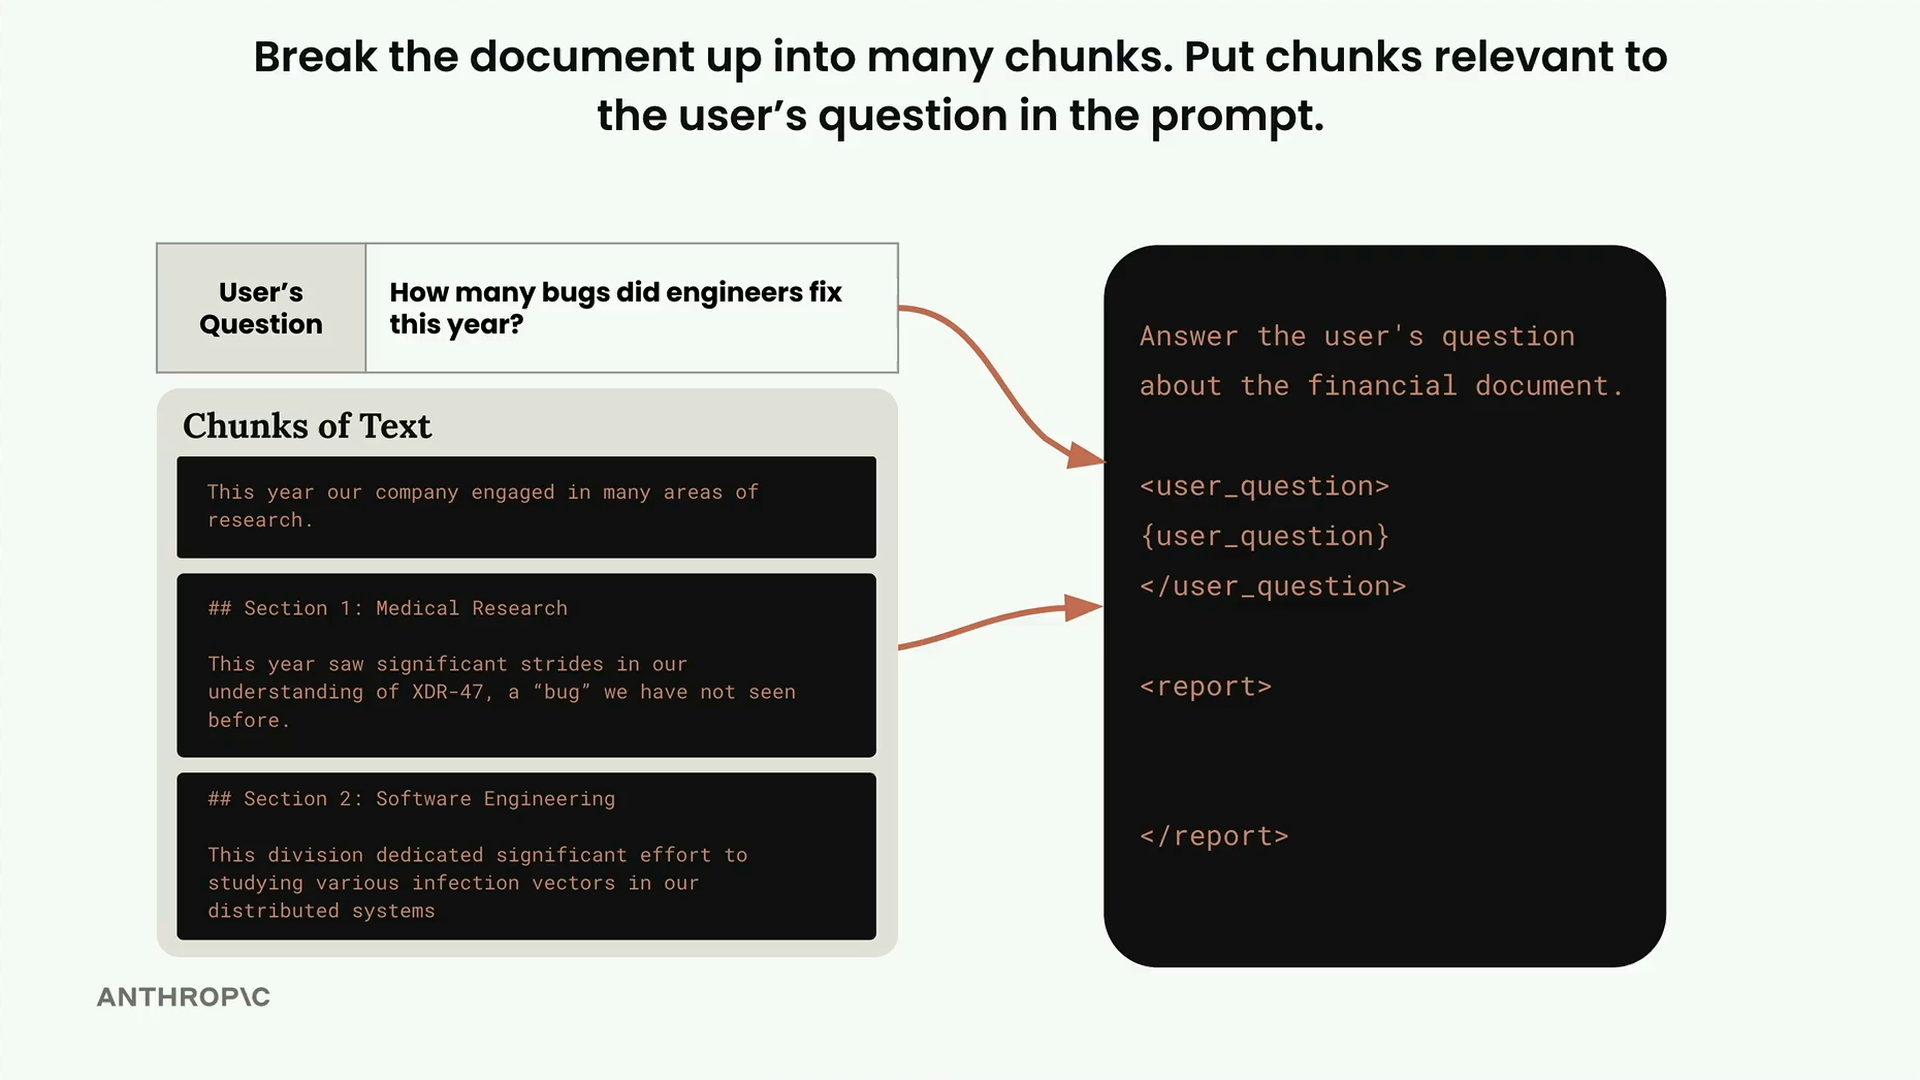
从文档中提取文本块之后,RAG 流程的下一步是找出哪些文本块与用户的问题最相关。这本质上是一个搜索问题——您需要遍历所有文本块,找出与用户所问内容相关的那些。
语义搜索
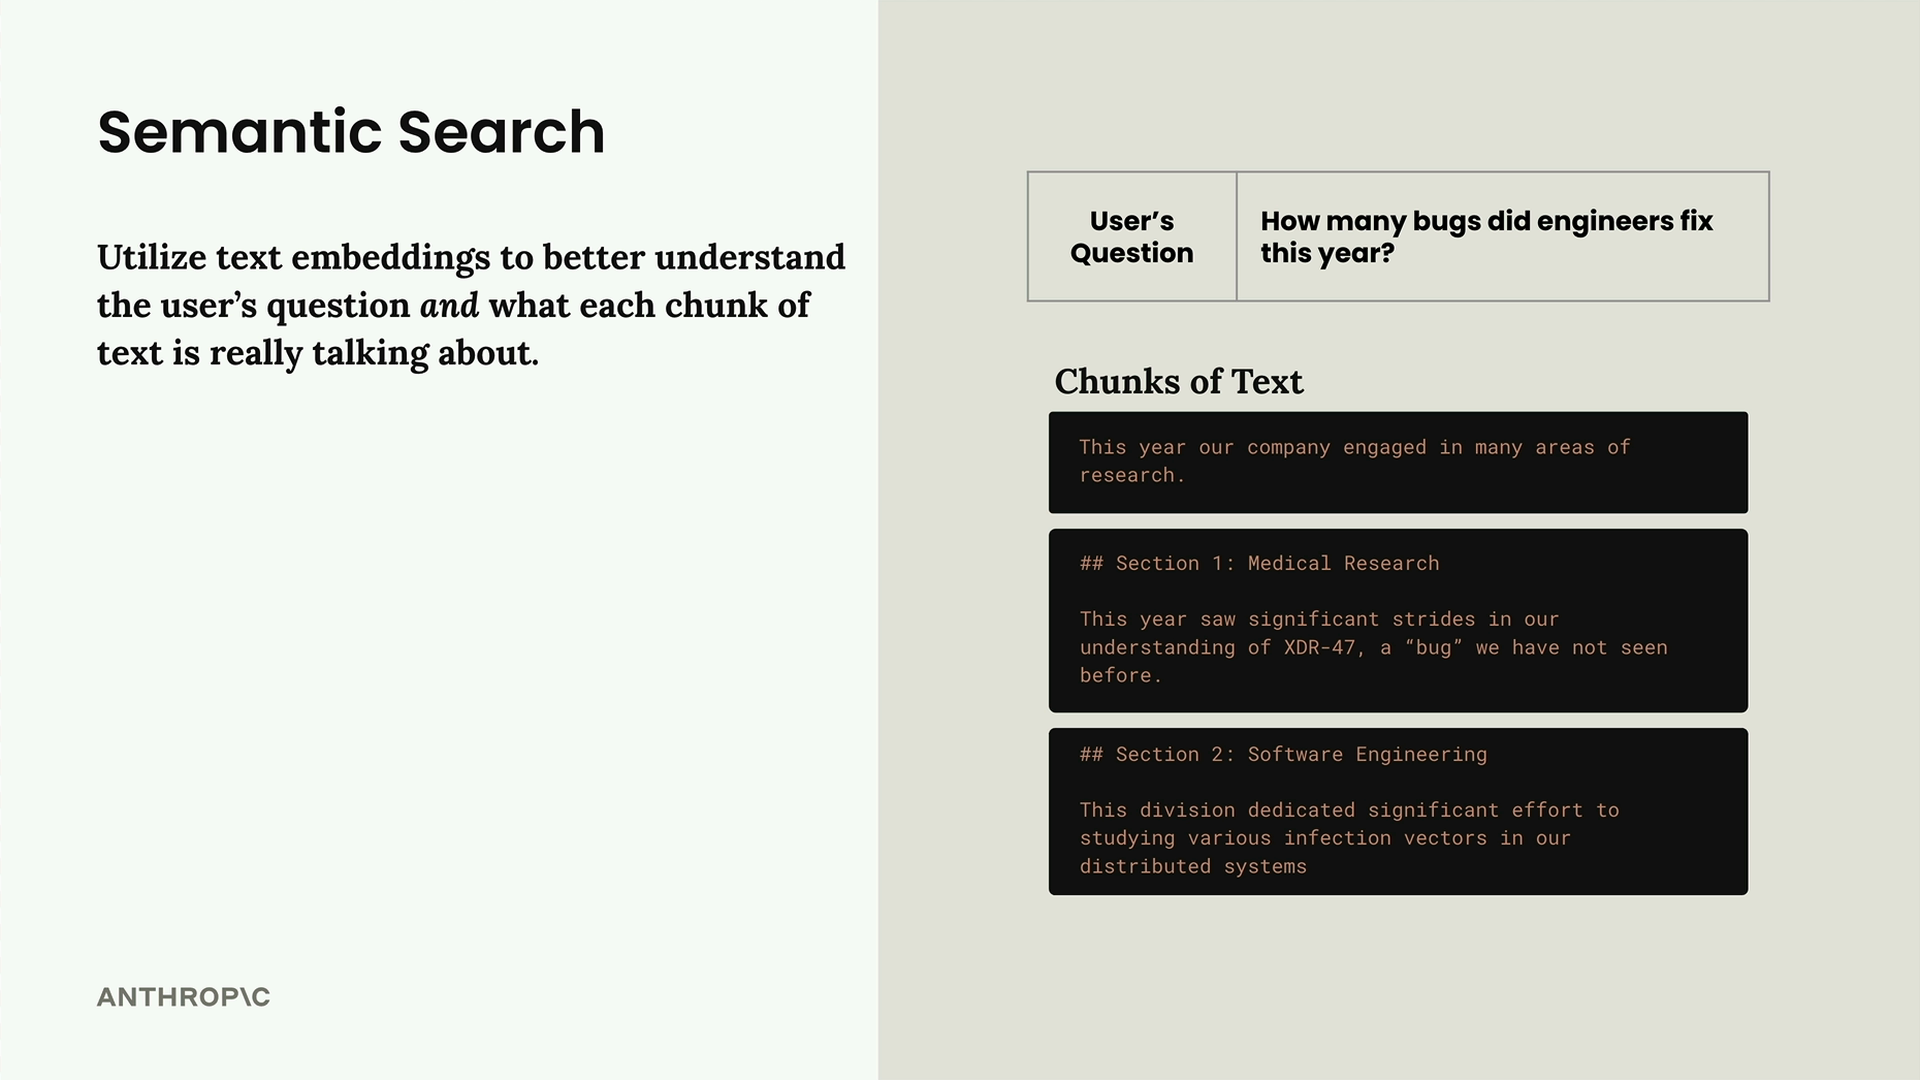
查找相关文本块最常见的方法是语义搜索。与传统的基于关键词的搜索不同,语义搜索使用文本嵌入来理解用户问题和每个文本块的实际含义。这使得系统即使在措辞不完全匹配的情况下,也能找到概念上相关的内容。
什么是文本嵌入?
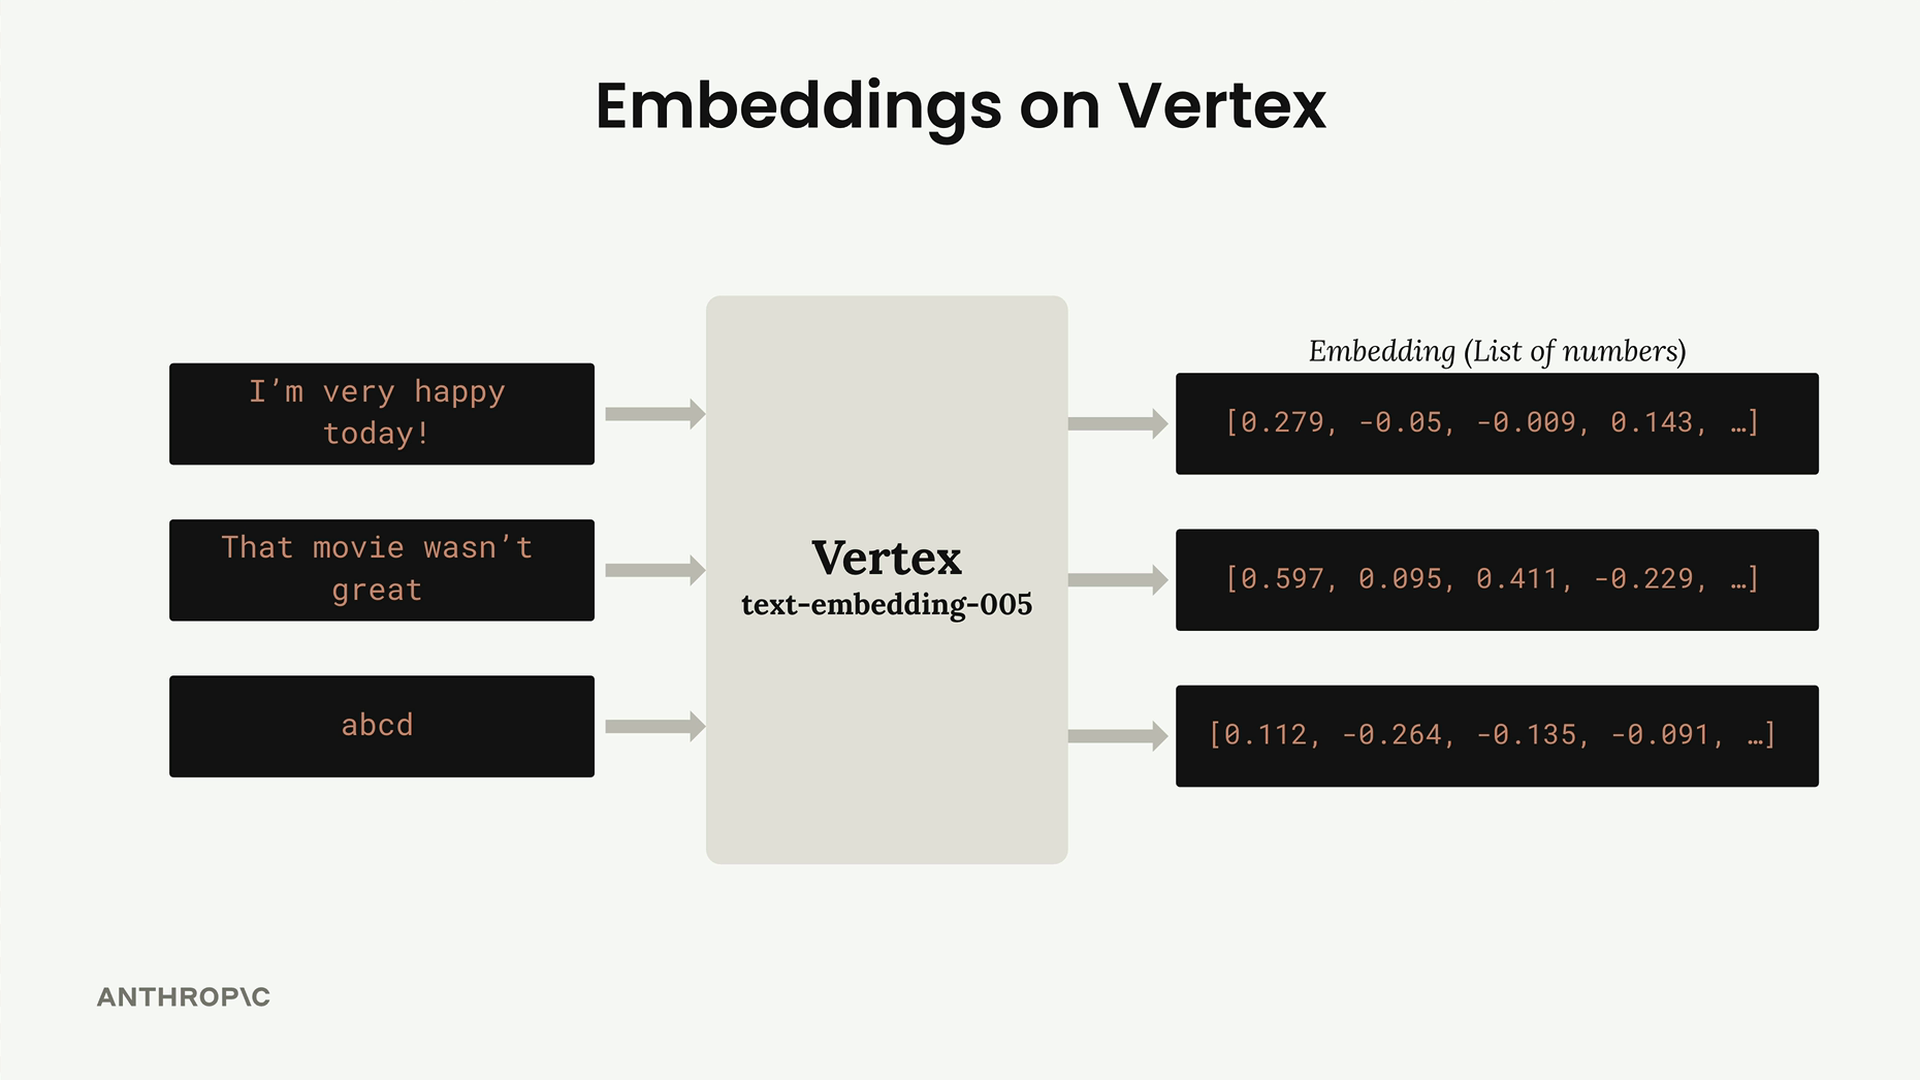
文本嵌入是对某段文本所包含含义的数值表示。可以把它理解为将单词和句子转换为计算机能够进行数学运算的格式。
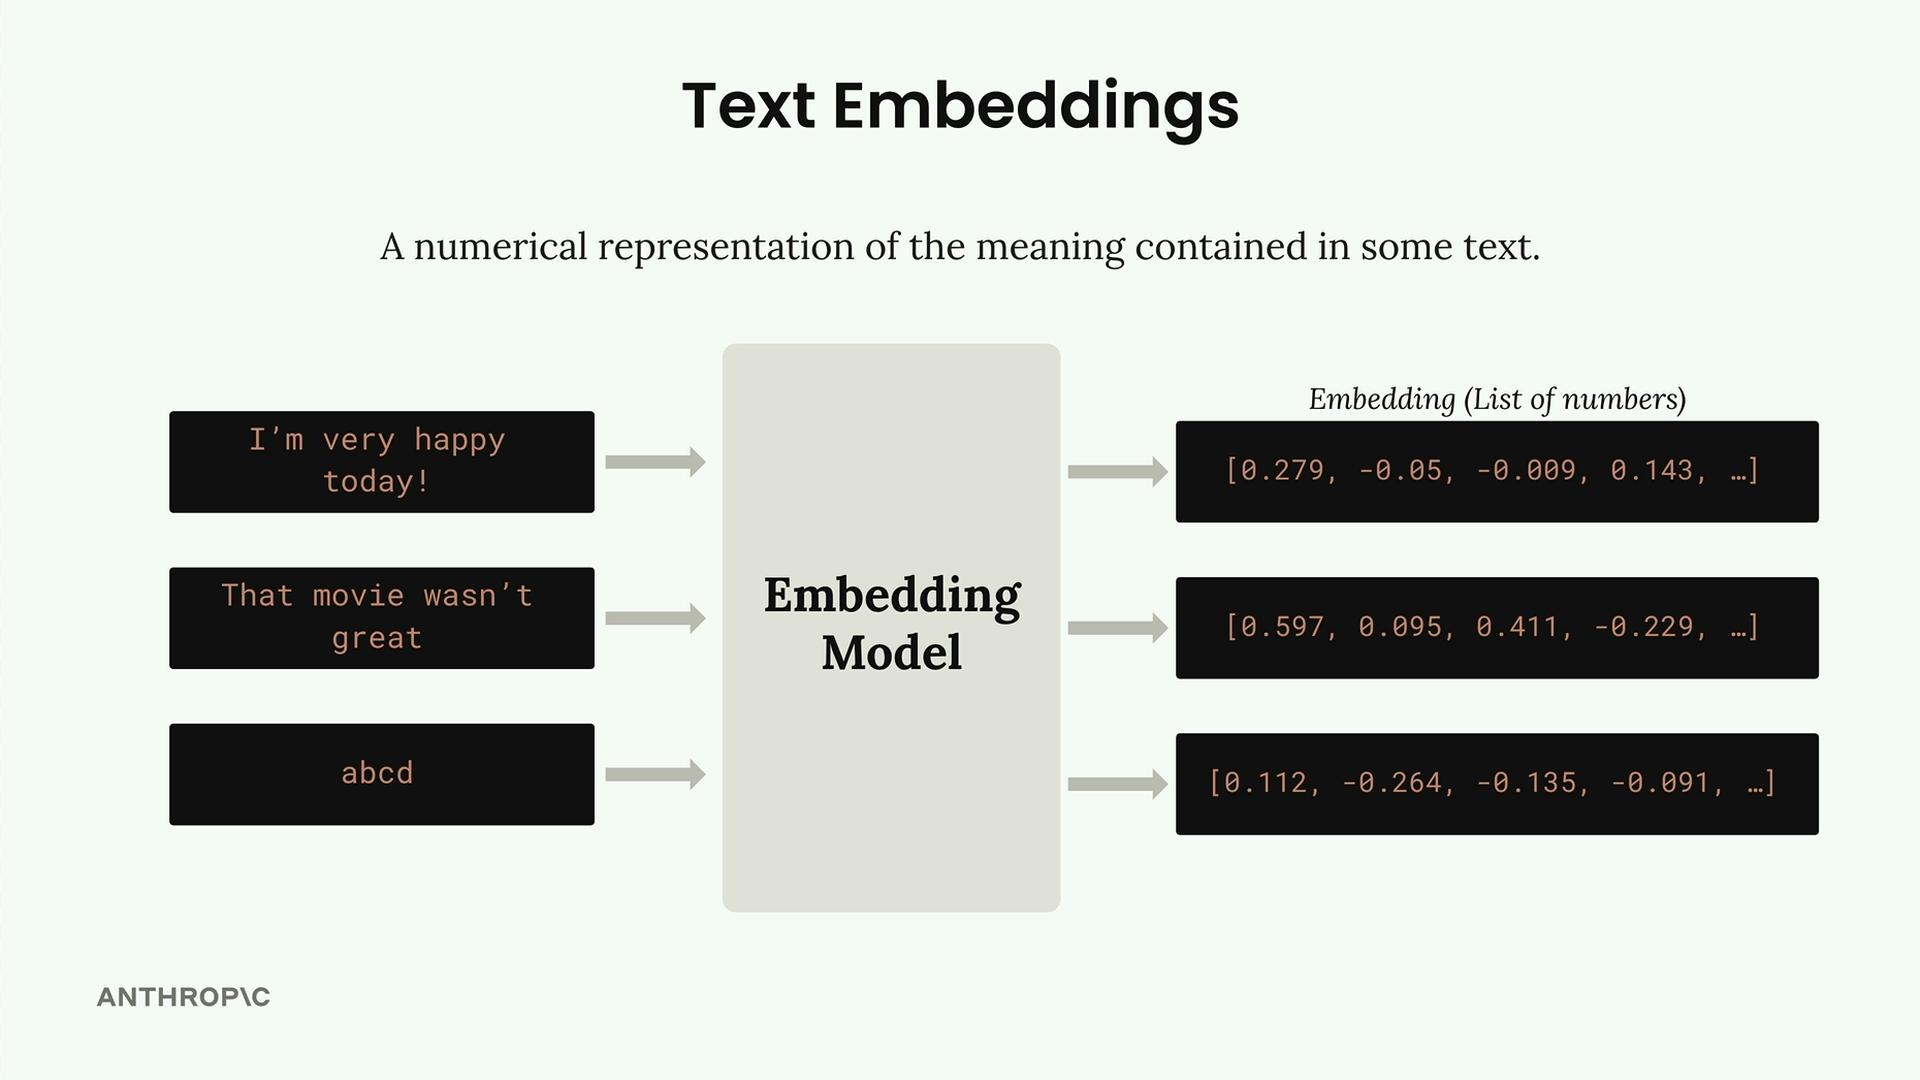
这一过程的工作原理如下:
- 将文本输入嵌入模型
- 模型输出一长串数字(即嵌入)
- 每个数字的范围在 -1 到 +1 之间
- 这些数字代表输入文本的不同性质或特征
理解这些数字
嵌入中的每个数字本质上都是输入文本某种性质的"得分"。但这里有一个重要的注意事项:我们实际上并不知道每个具体的数字代表什么。
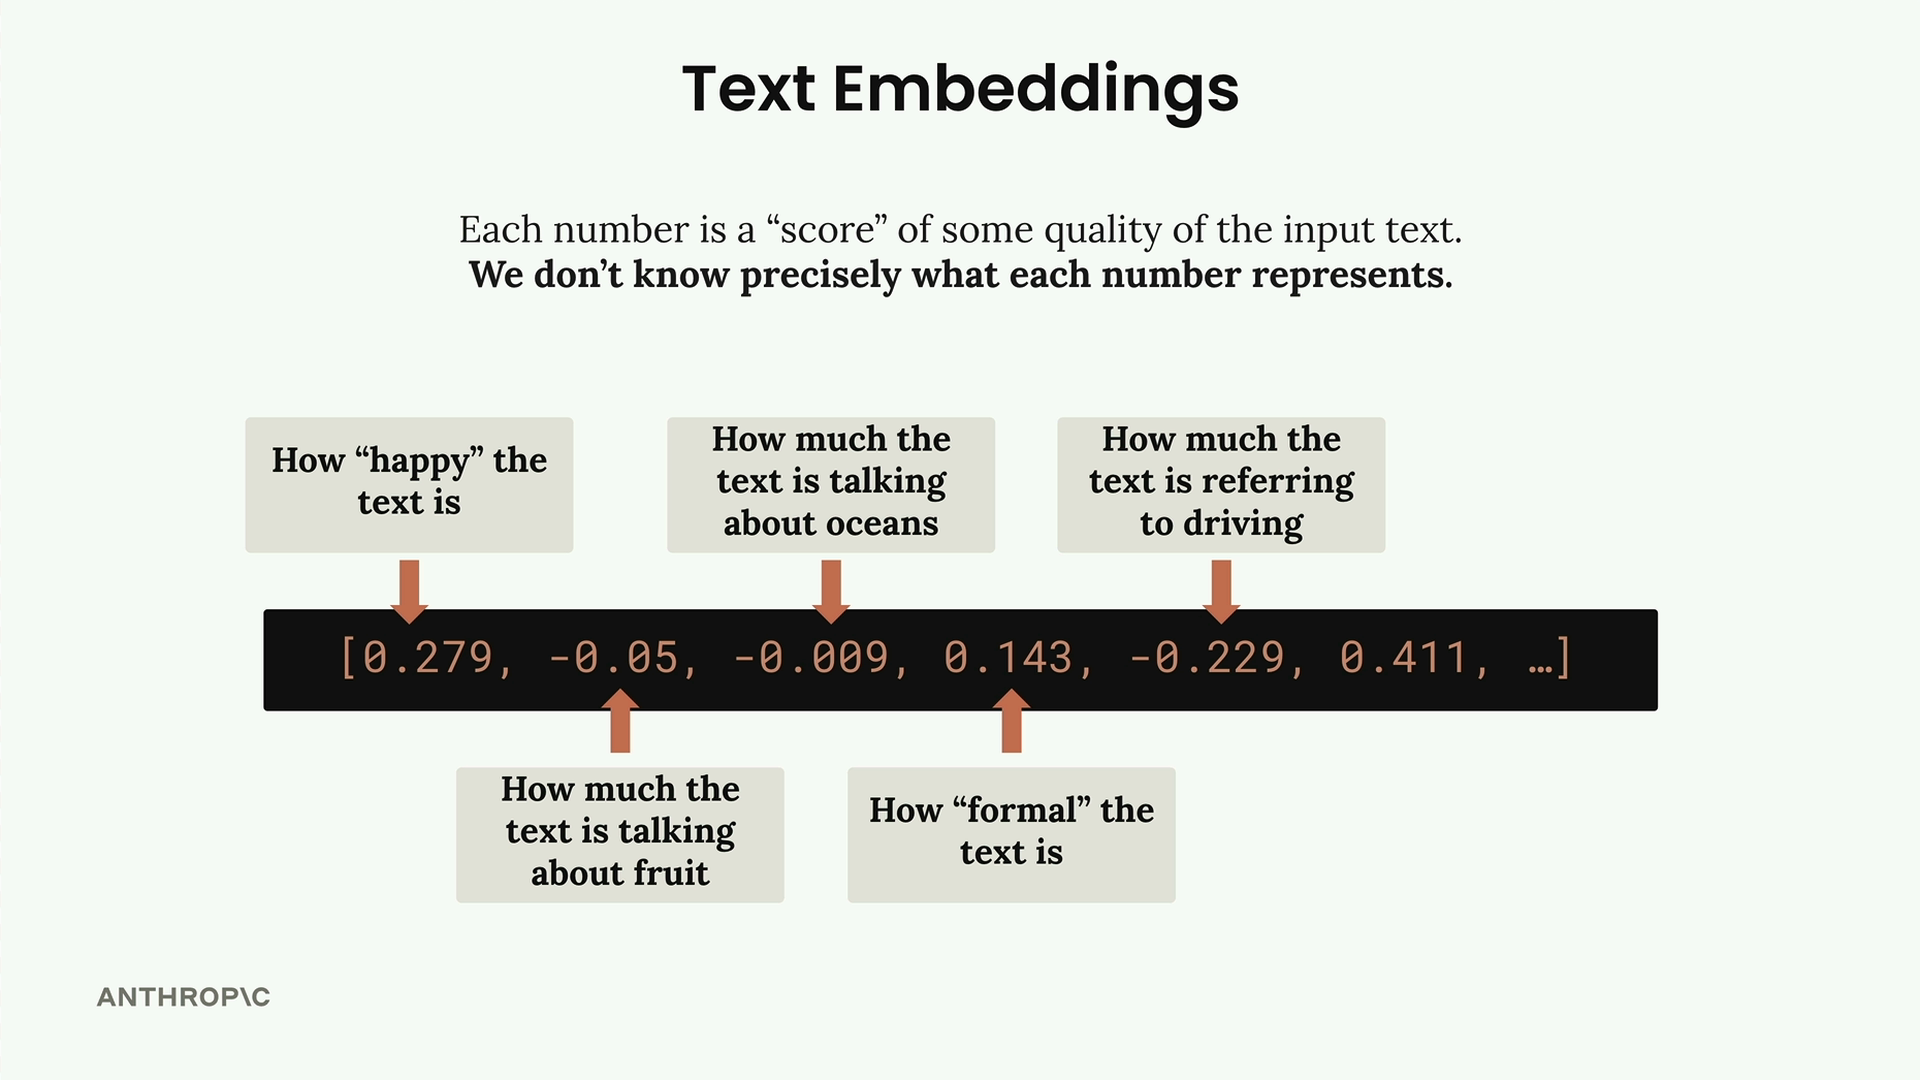
虽然可以方便地想象其中一个数字代表"文本有多快乐",另一个数字代表"文本多大程度上谈论海洋",但这些只是概念性的示例。嵌入模型在训练过程中学习到这些特征,但对我们来说,这些特征并没有被明确标注或可解释。
尽管存在这种不透明性,嵌入仍然非常强大,因为它们以一种能够在不同文本片段之间进行数学比较的方式捕捉了语义含义。
在 Vertex AI 上使用嵌入
Claude 无法直接生成嵌入。相反,您需要使用专门的嵌入模型。在 Vertex AI 上,我们将使用的模型名为 text-embedding-005。
实现方式
要在 Vertex AI 上使用嵌入,您需要安装 Google GenAI SDK:
bash
pip install google-genai以下是生成嵌入的基本设置:
python
from google import genai

client = genai.Client(
    project="YOUR_PROJECT_ID",
    location="global",
    vertexai=True
)

def generate_embedding(text):
    response = client.models.embed_content(
        model="text-embedding-005",
        contents=text
    )

    if not response.embeddings:
        return []

    return [e.values for e in response.embeddings]
当您对一个文本块运行此函数时,您将得到一组浮点数,代表该文本的语义含义。这些嵌入构成了在您的 RAG 系统中实现语义搜索的基础。
下一步是了解如何使用这些嵌入来实际找出与用户问题最相关的文本块,这涉及到通过数学方式比较嵌入以确定相似度。