加载中
我们构建的混合检索方法效果不错,但仍存在一些粗糙之处。当我们搜索"工程团队对INC-2023-Q4-011做了什么?"时,我们会期望Software Engineering部分排名更靠前,因为它明确提到了工程团队和该事件。然而,Cybersecurity部分仍然排在第一位。
这正是重排序(re-ranking)发挥作用的地方——这是一种后处理技术,可以显著提高检索的准确性。
重排序的工作原理
重排序在您的混合搜索流程之后增加了额外的一步。与仅仅返回向量索引和BM25索引的合并结果不同,您会将这些结果传递给LLM进行智能重新排序。
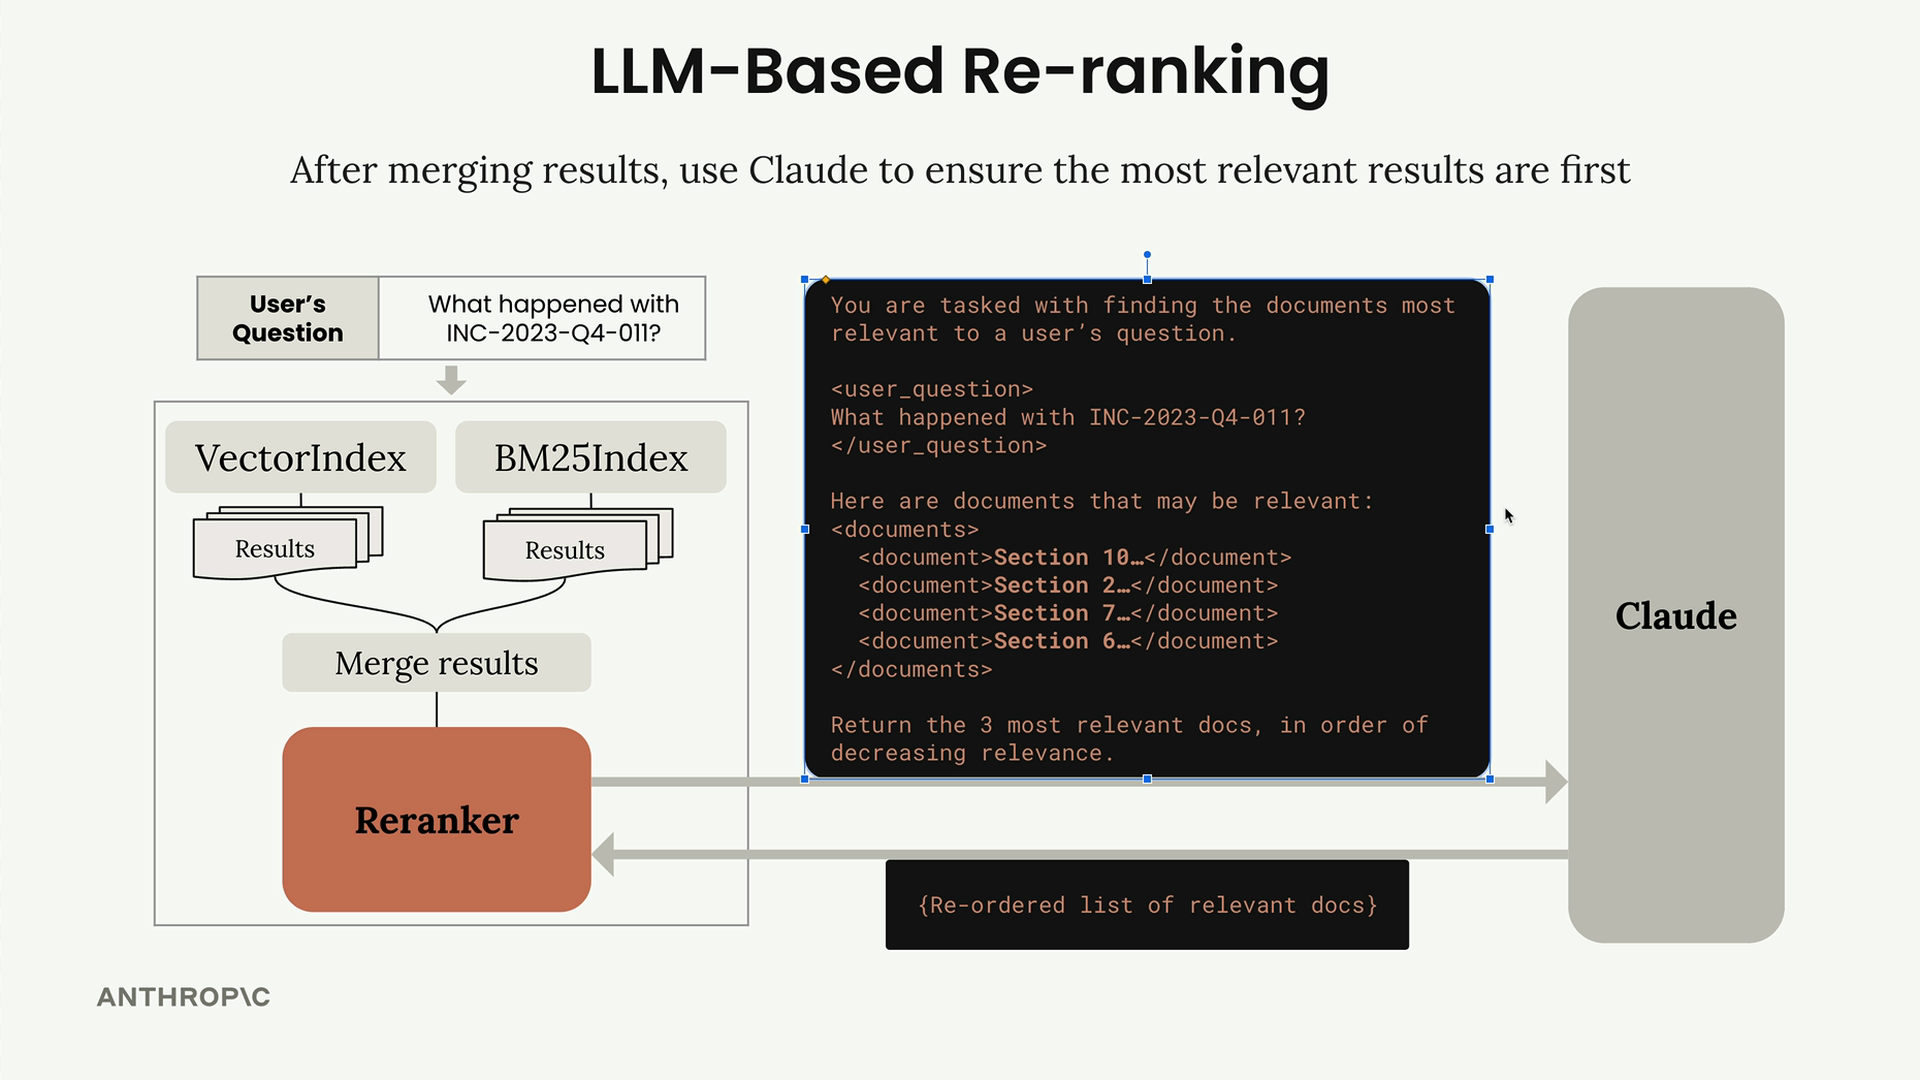
这个过程很简单:
- 运行您现有的混合搜索(向量 + BM25)
- 像之前一样合并结果
- 将合并后的结果连同重排序提示一起发送给Claude
- 获取按相关性重新排序后的文档列表
重排序提示
这个提示的结构简单但有效。您向Claude提供用户的问题以及所有候选文档,然后要求它按相关性递减的顺序返回最相关的文档。
You are about to be given a set of documents, along with an id of each.
Your task is to select the {k} most relevant documents to answer the user's question.

Here is the user's question:
<question>
{query_text}
</question>

Here are the documents to select from:
<documents>
{joined_docs}
</documents>

Respond in the following format:
```json
{
  "document_ids": str[] # List document ids, {k} elements long, sorted in order of decreasing relevance
}
```效率考量
一个关键的优化点是使用文档ID,而不是要求Claude返回完整的文本块。如果您要求Claude返回每个相关文档的完整文本,您将浪费时间等待它复制大量文本。
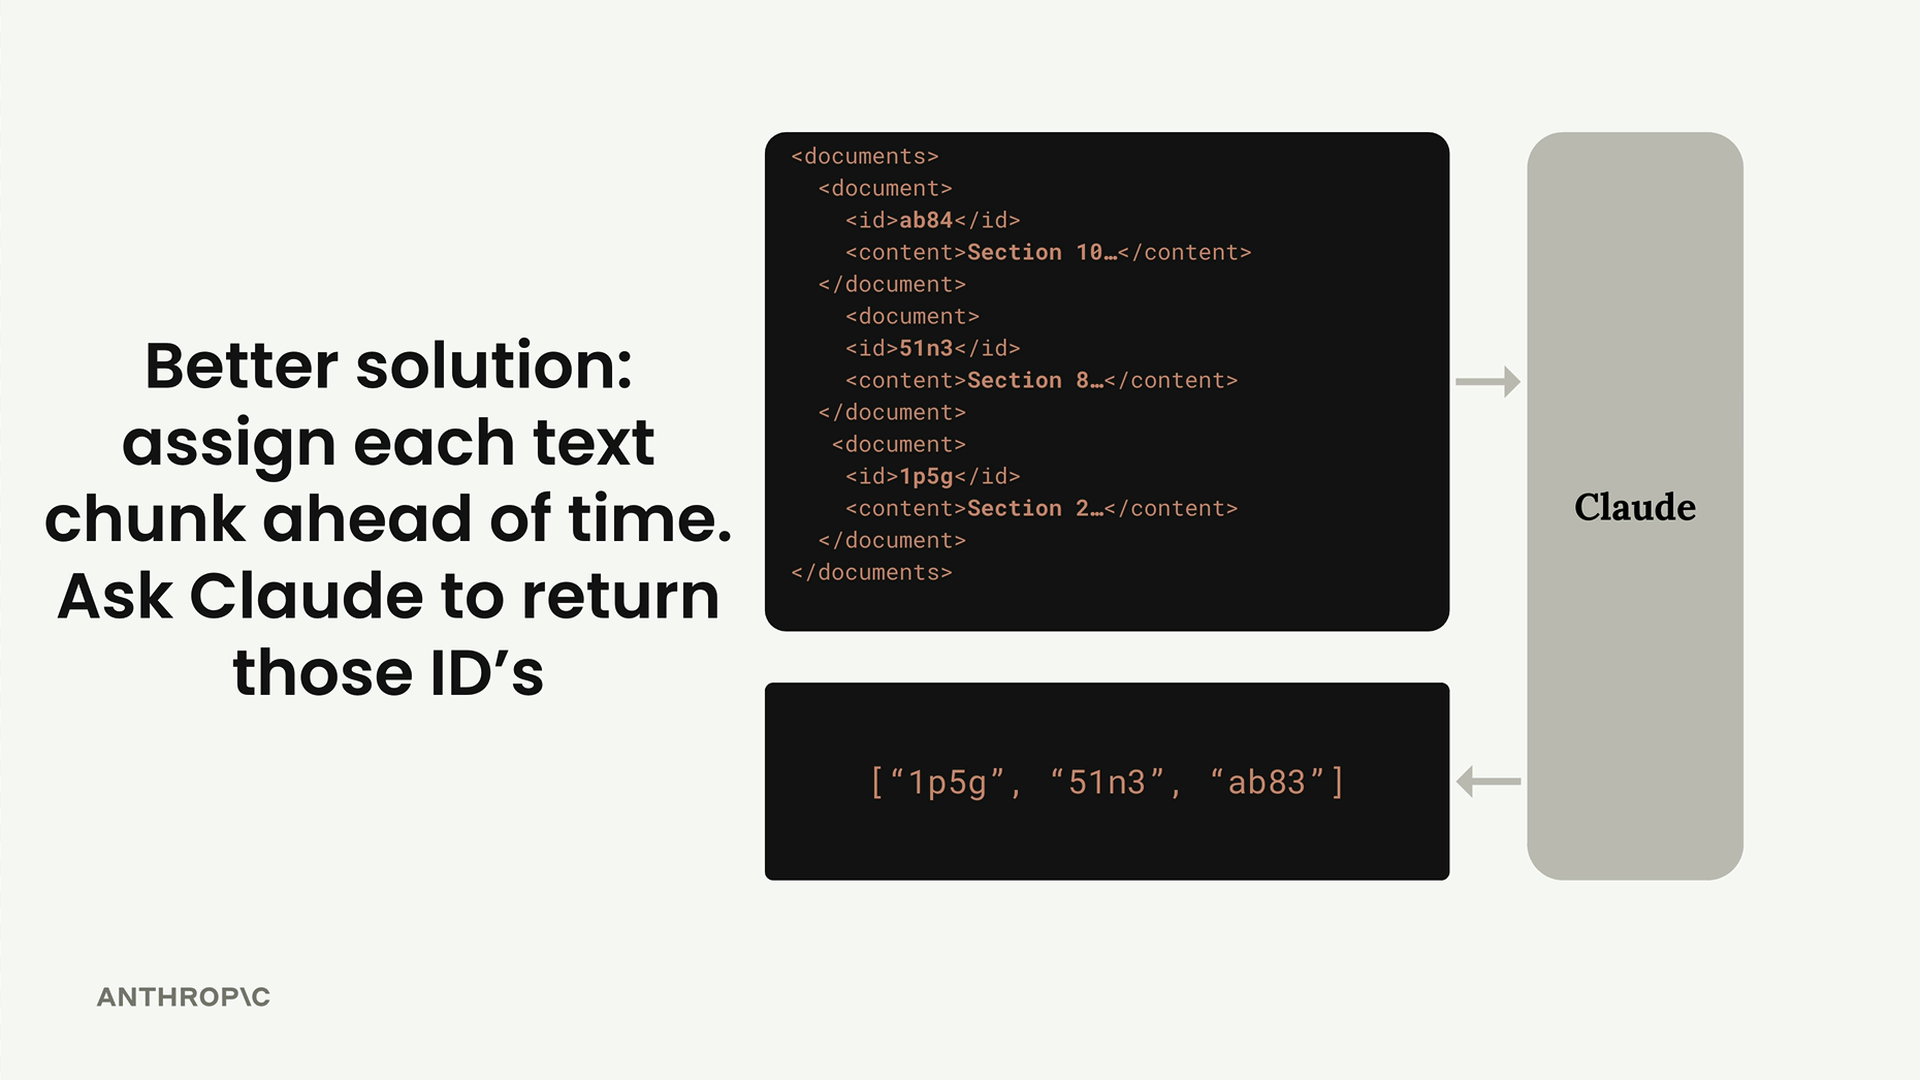
相反,应提前为每个文本块分配一个唯一的ID,然后要求Claude仅按照偏好顺序返回这些ID。这使得重排序过程快得多,同时仍能为您提供所需的重新排序结果。
实现
重排序器函数会在您最初的混合搜索完成后自动被调用。以下是基本结构:
python
def reranker_fn(docs, query_text, k):
    joined_docs = "\n".join([
        f"""
        <document>
        <document_id>{doc["id"]}</document_id>
        <document_content>{doc["content"]}</document_content>
        </document>
        """
        for doc in docs
    ])

    # 使用用户问题和文档构建提示
    # 以 JSON 响应格式发送给 Claude
    # 解析并返回重新排序后的文档 ID
您可以通过将重排序器函数作为参数传入,将其集成到您的检索器中:
python
retriever = Retriever(bm25_index, vector_index, reranker_fn=reranker_fn)结果
重排序方法展现出了明显的改善。在测试查询"工程团队对INC-2023-Q4-011做了什么?"时,Software Engineering部分现在正确地排在第一位,领先于Cybersecurity部分。Claude成功识别出用户具体询问的是工程团队在该事件中的参与情况。
权衡取舍
重排序需要考虑以下权衡:
- 延迟增加: 您现在需要等待一次额外的LLM调用完成
- 准确性提升: LLM能够比纯粹的相似度评分更好地理解上下文和意图
- 成本考量: 每次搜索现在都需要一次LLM API调用
对于许多应用而言,准确性的提升足以证明额外延迟和成本的合理性,尤其是当精确检索对您的使用场景至关重要时。