在使用 Claude 构建应用程序时,理解完整的请求生命周期有助于您设计更好的系统,并更有效地调试问题。让我们走一遍当用户向您的 AI 驱动的聊天应用程序发送消息时会发生什么。
完整的请求流程
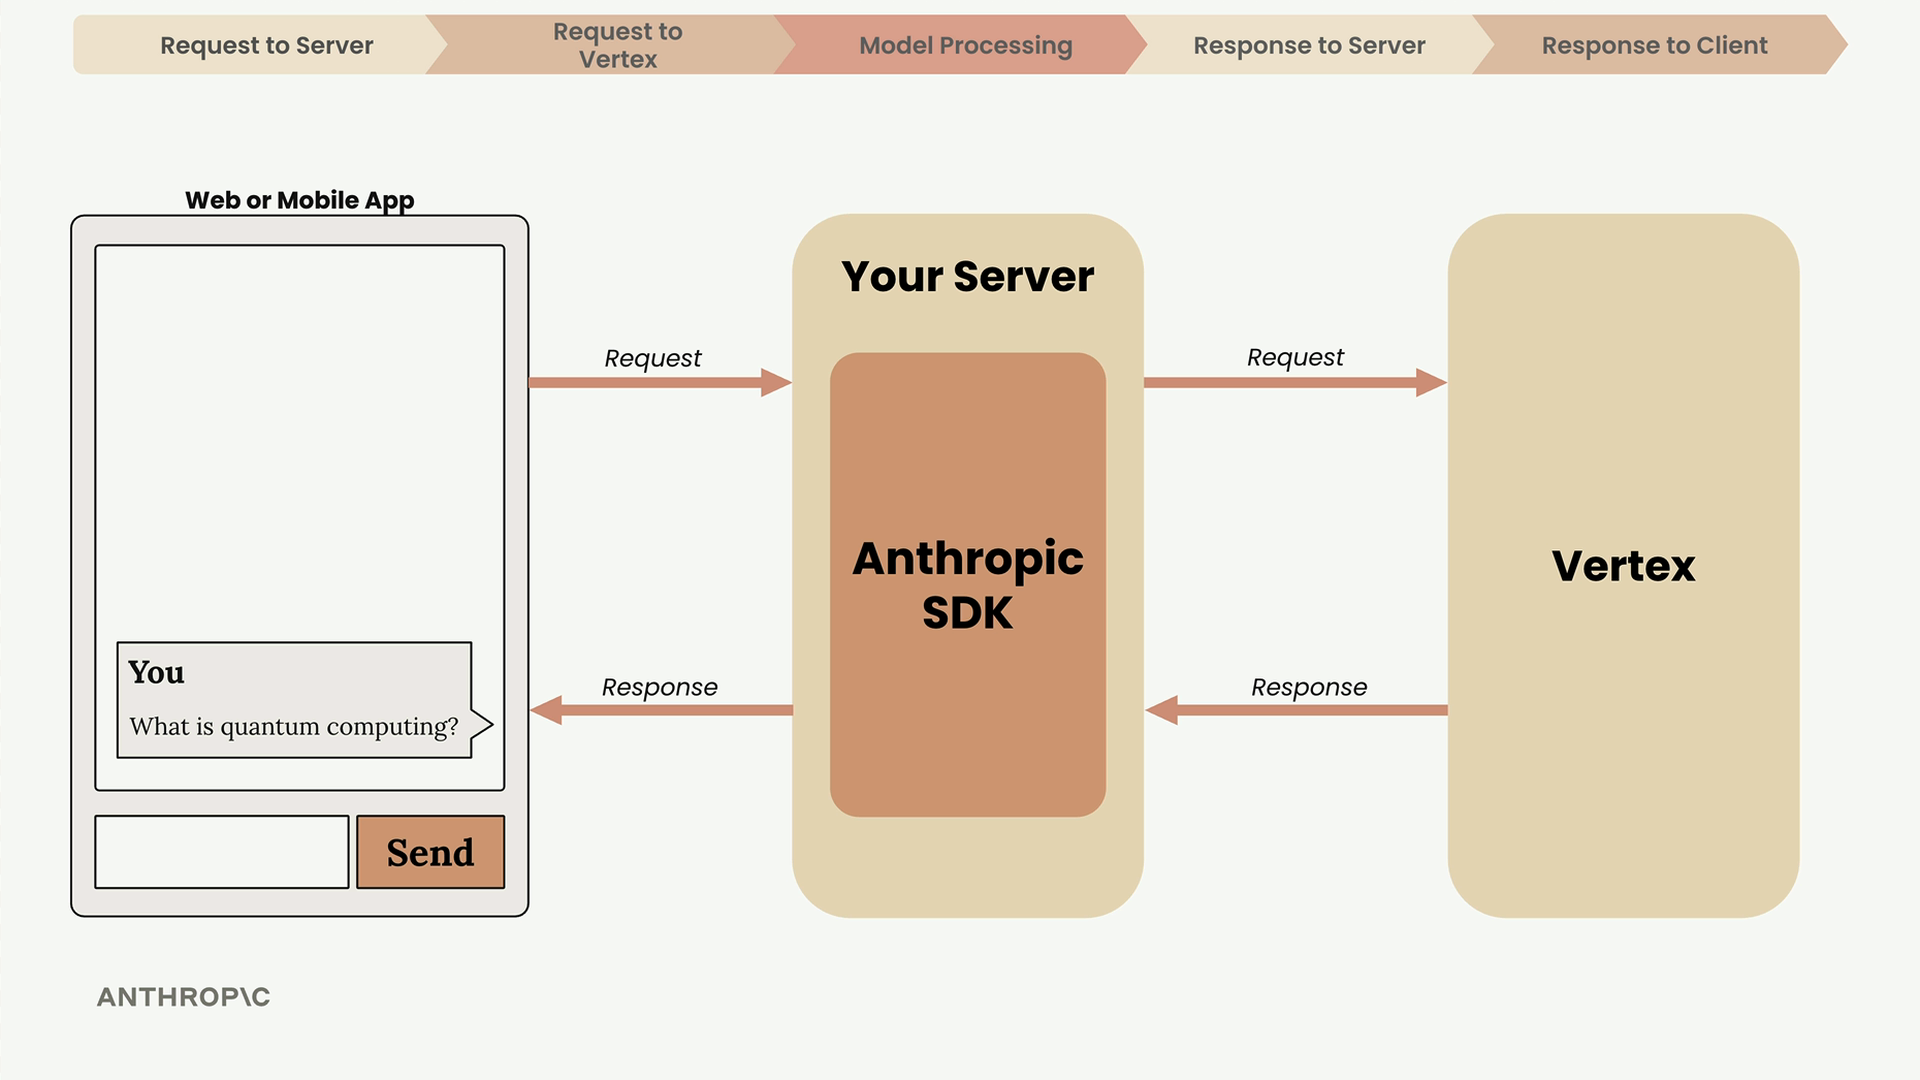
从用户输入到 AI 响应的旅程涉及五个不同的步骤:请求到服务器、请求到 Vertex、模型处理、响应到服务器和响应到客户端。每一步在提供用户所期望的那种"神奇"响应方面都发挥着至关重要的作用。
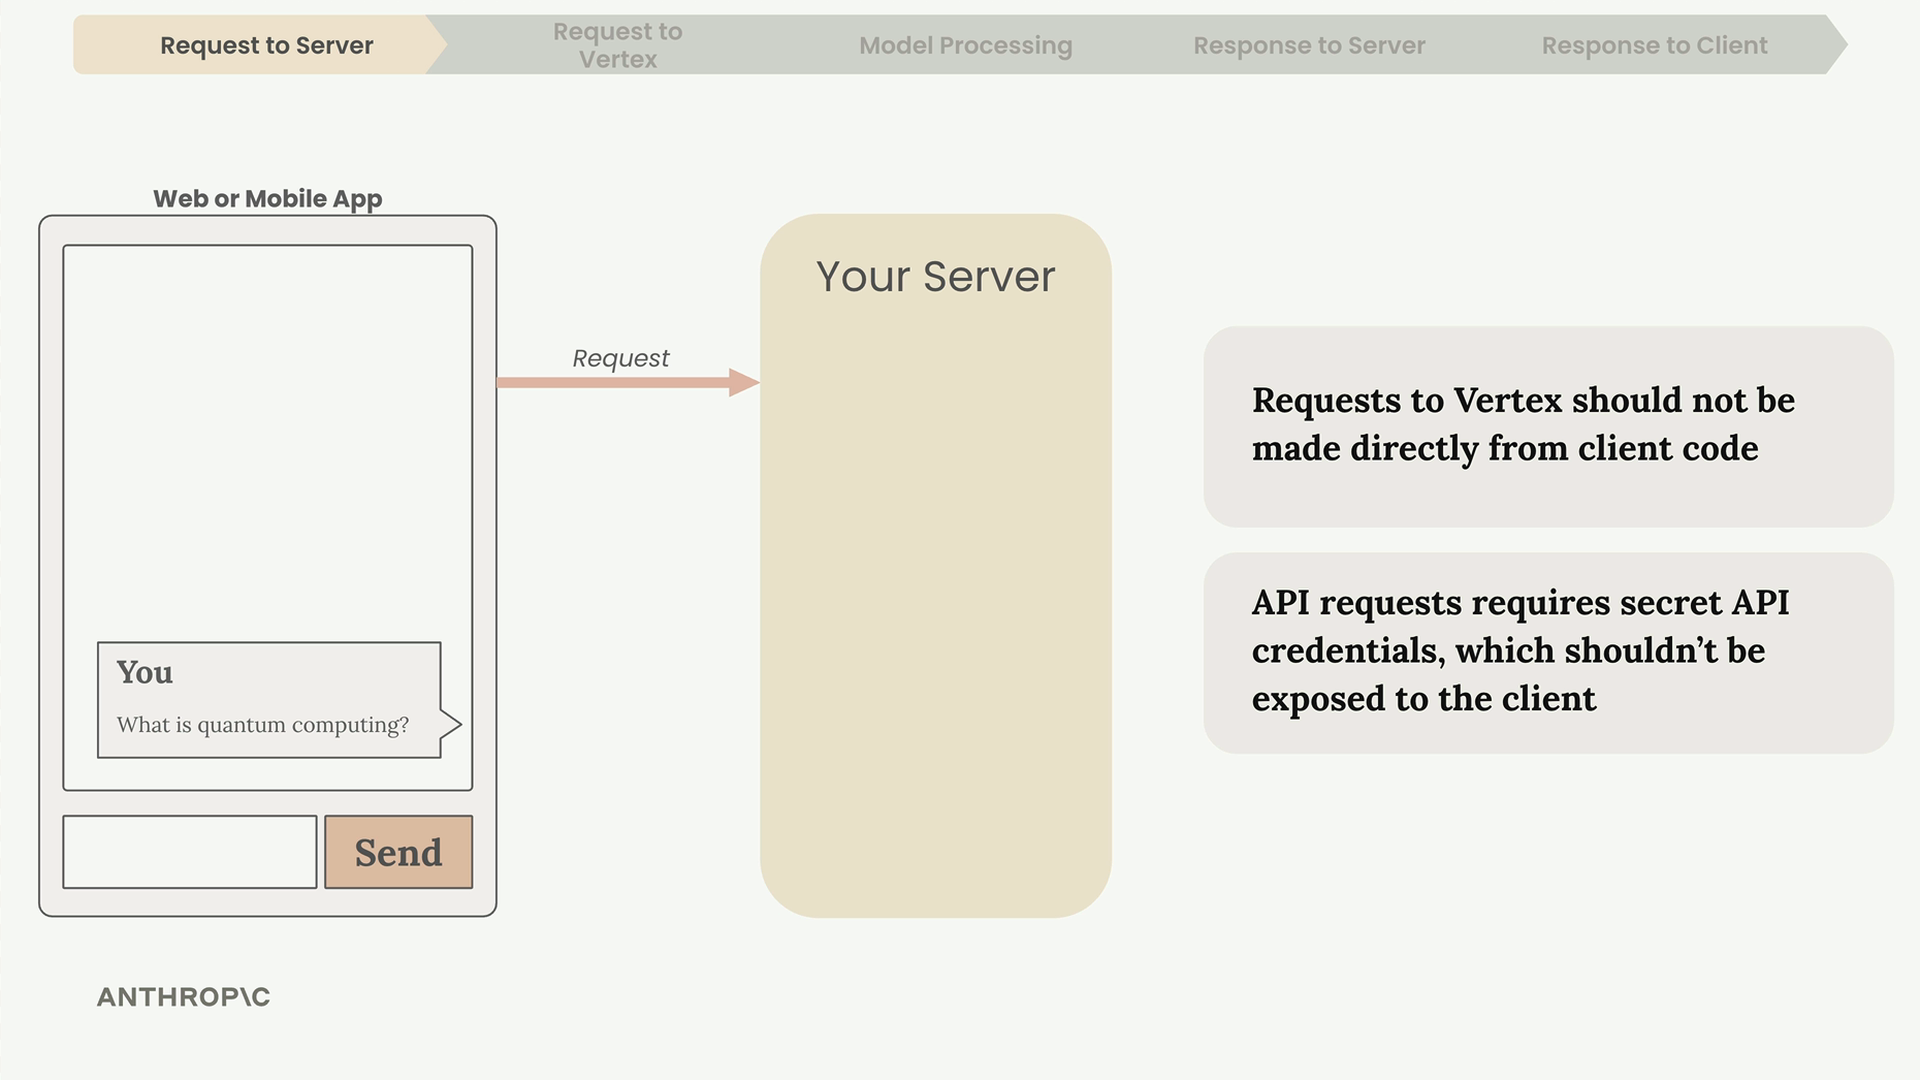
为什么您需要一个服务器
永远不要直接从客户端代码发出 API 请求。原因如下:
- API 请求需要必须保持安全的密钥凭据
- 在客户端代码中暴露凭据会使任何人都能看到它们
- 您的服务器充当您的应用和 Vertex 之间的安全中介
请始终通过您自己控制和保护的服务器来路由请求。
发出 API 请求
您的服务器使用 Anthropic 的 SDK 或 Google 的官方 Vertex SDK 与 Vertex 通信。Anthropic 提供适用于 Python、TypeScript、Go 和 Ruby 的官方 SDK。
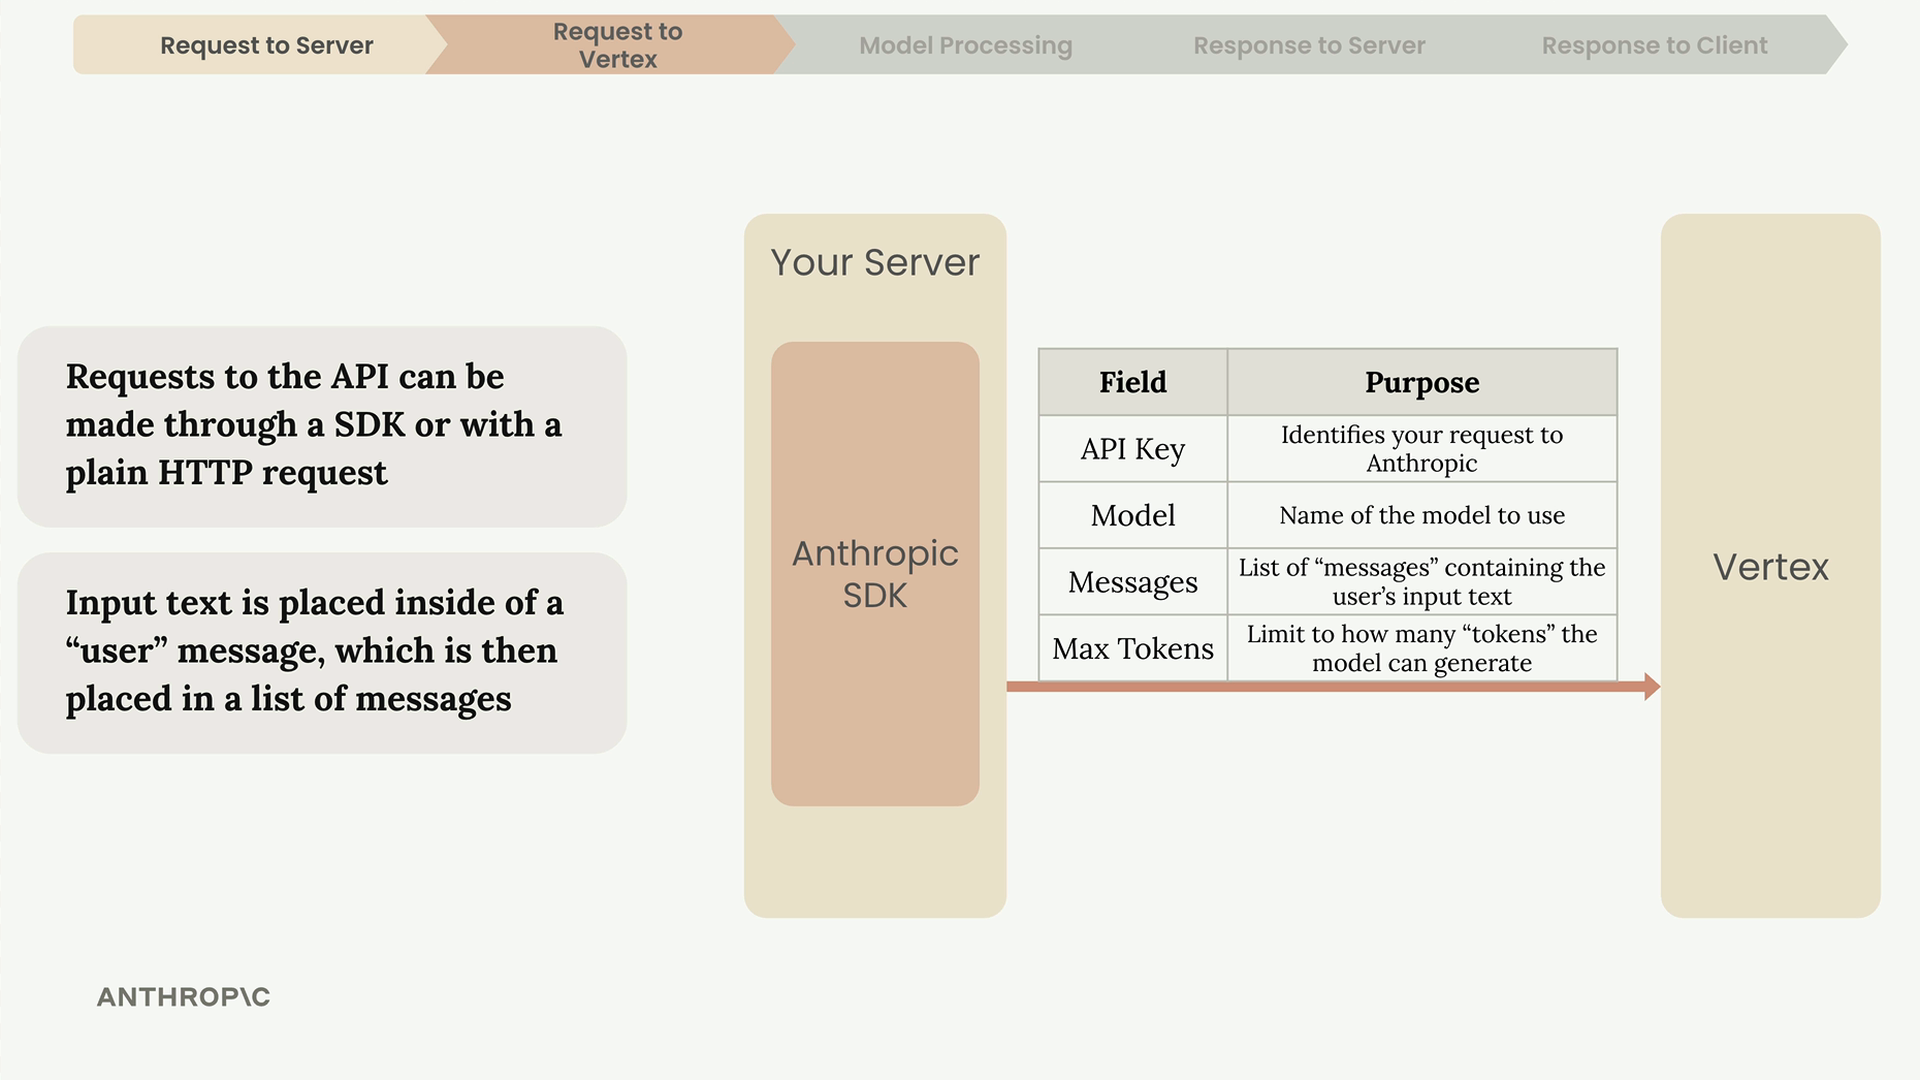
每个请求都必须包含以下关键字段:
- Google Cloud 凭据 - 授权您在 Google Cloud 上的请求
- 模型 - 要使用的具体模型名称
- 消息 - 包含用户输入文本的列表
- 最大令牌数 - 限制模型可以生成的令牌数量
用户的输入被放置在一条"user"消息中,然后该消息进入发送到 API 的消息列表中。
深入 Claude:文本生成过程
一旦 Vertex 收到您的请求,Claude 会通过四个阶段处理它:分词、嵌入、语境化和生成。
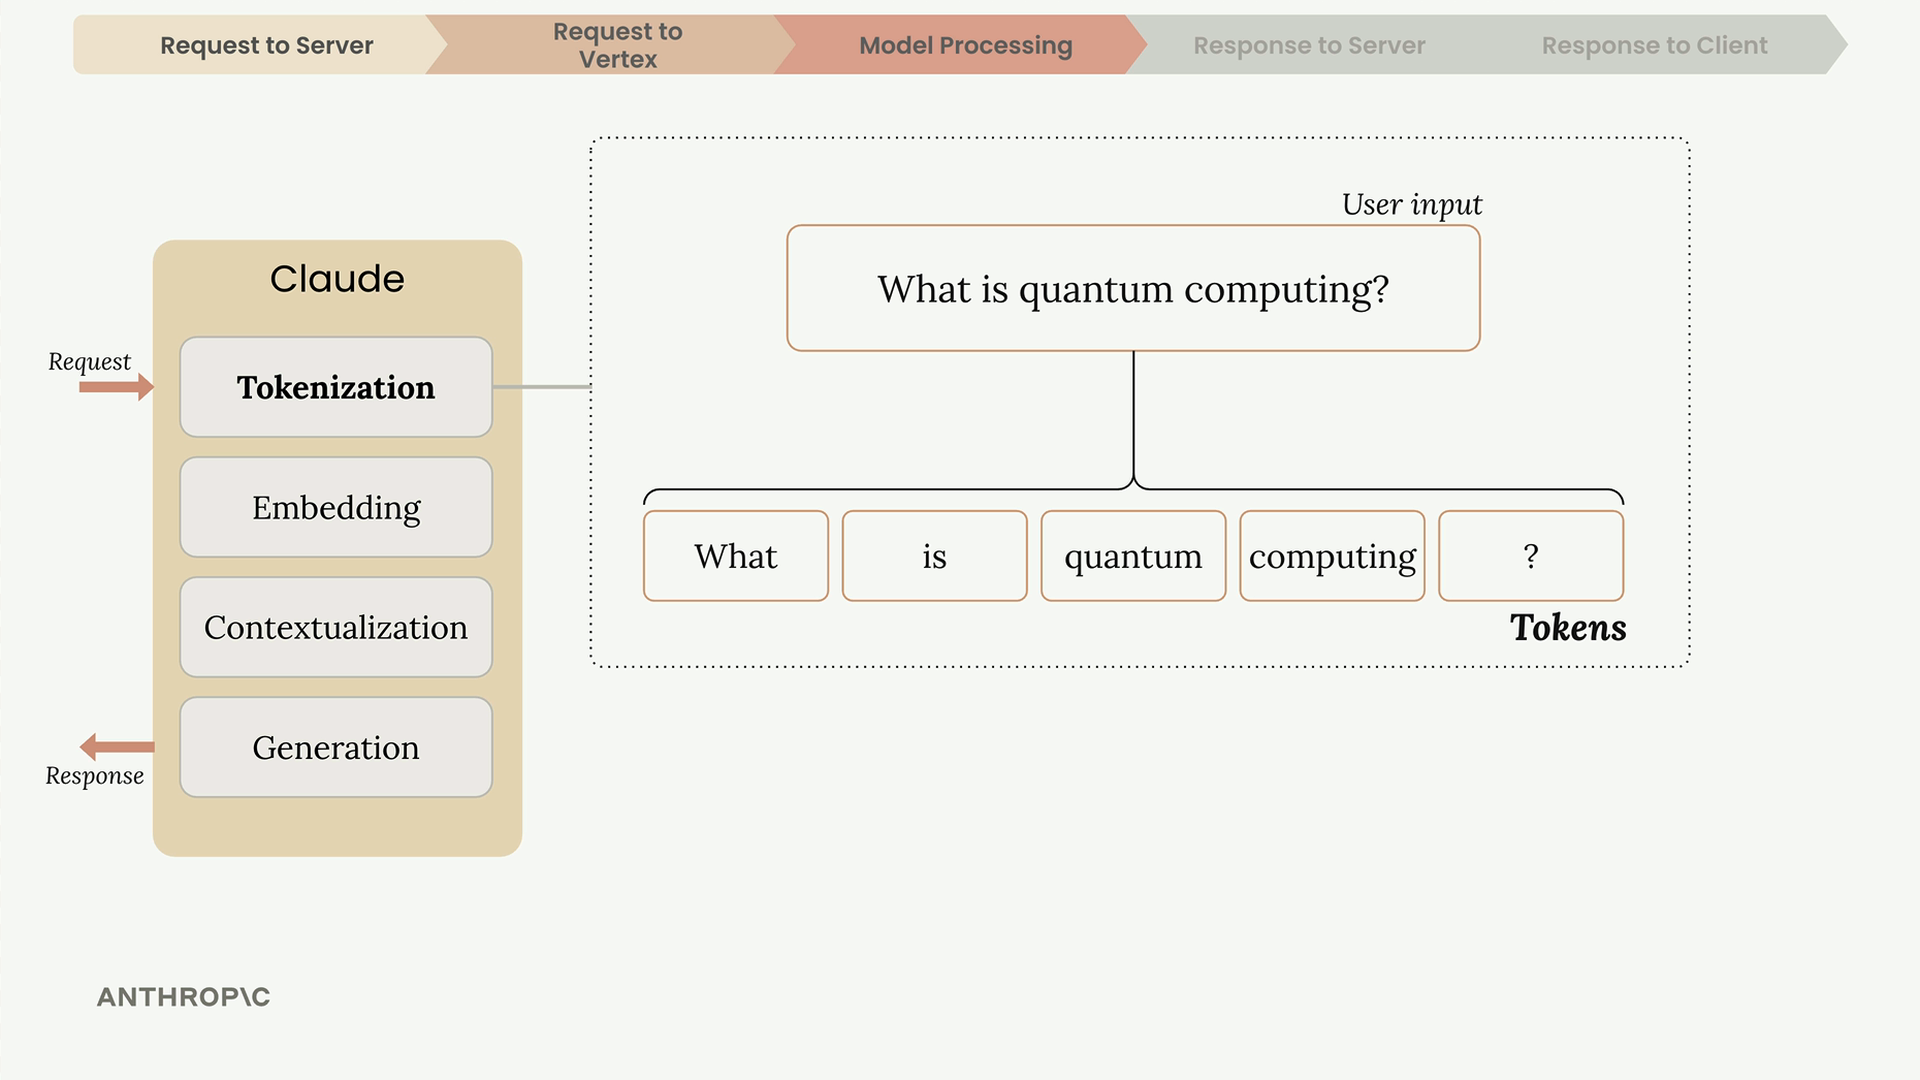
分词
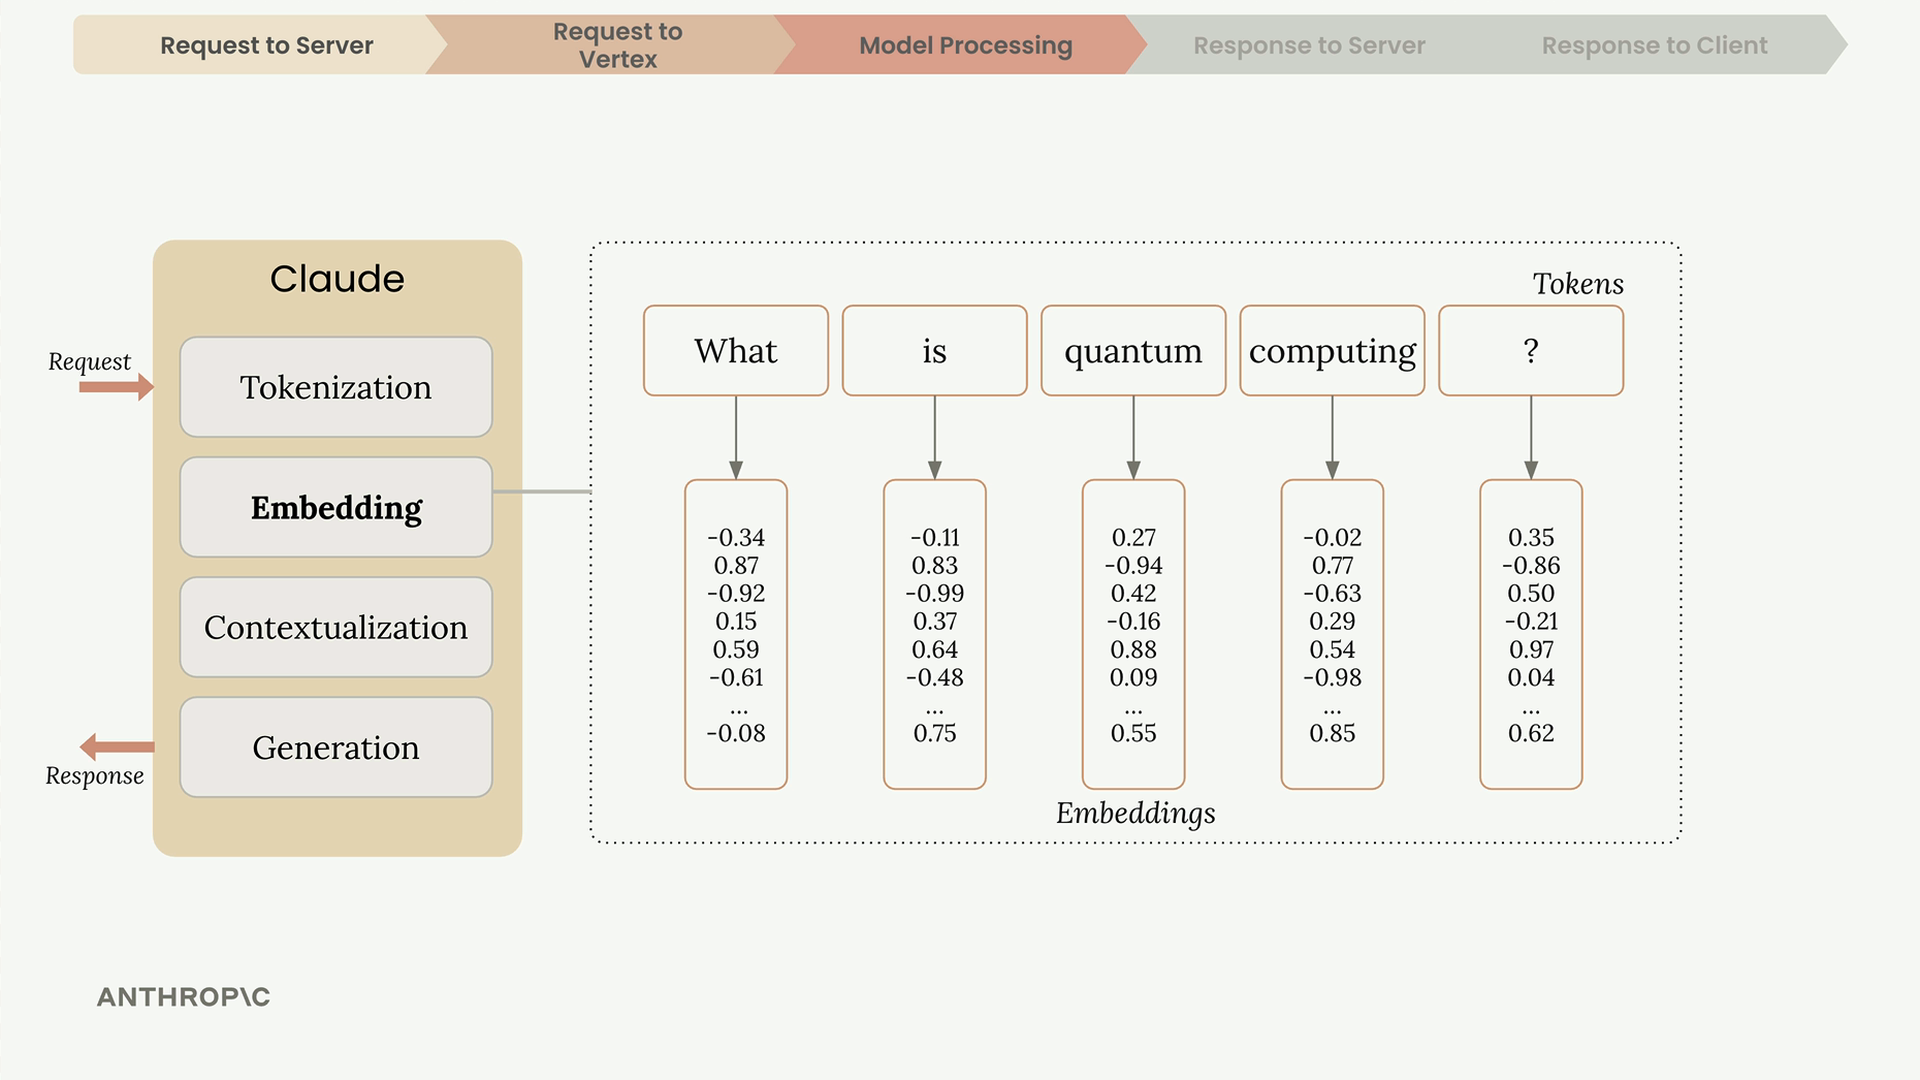
Claude 首先将输入文本分解为称为令牌的较小片段。这些可以是完整的单词、单词的一部分、空格或符号。为简单起见,可以将每个单词视为一个令牌。
嵌入
每个令牌被转换为一个嵌入向量——一长串代表该单词所有可能含义的数字。可以将嵌入视为基于数字的定义。
语境化
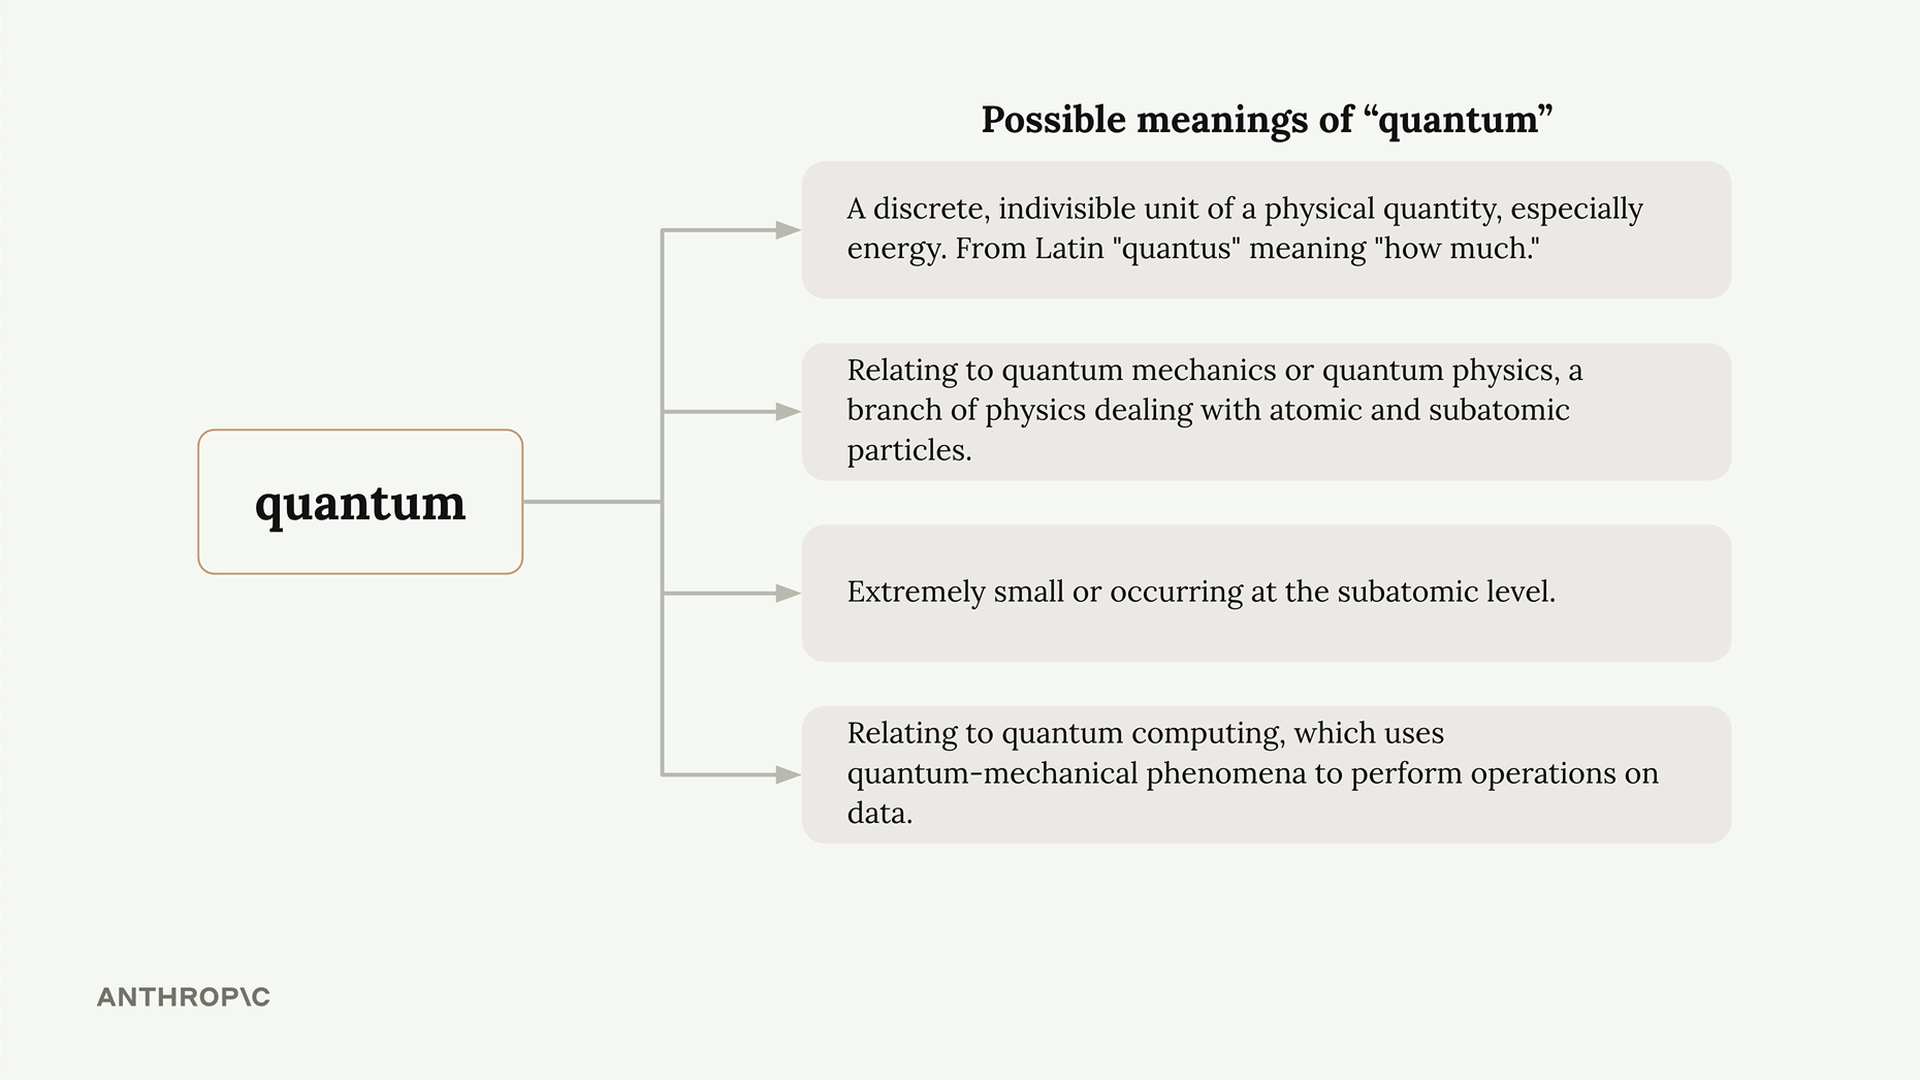
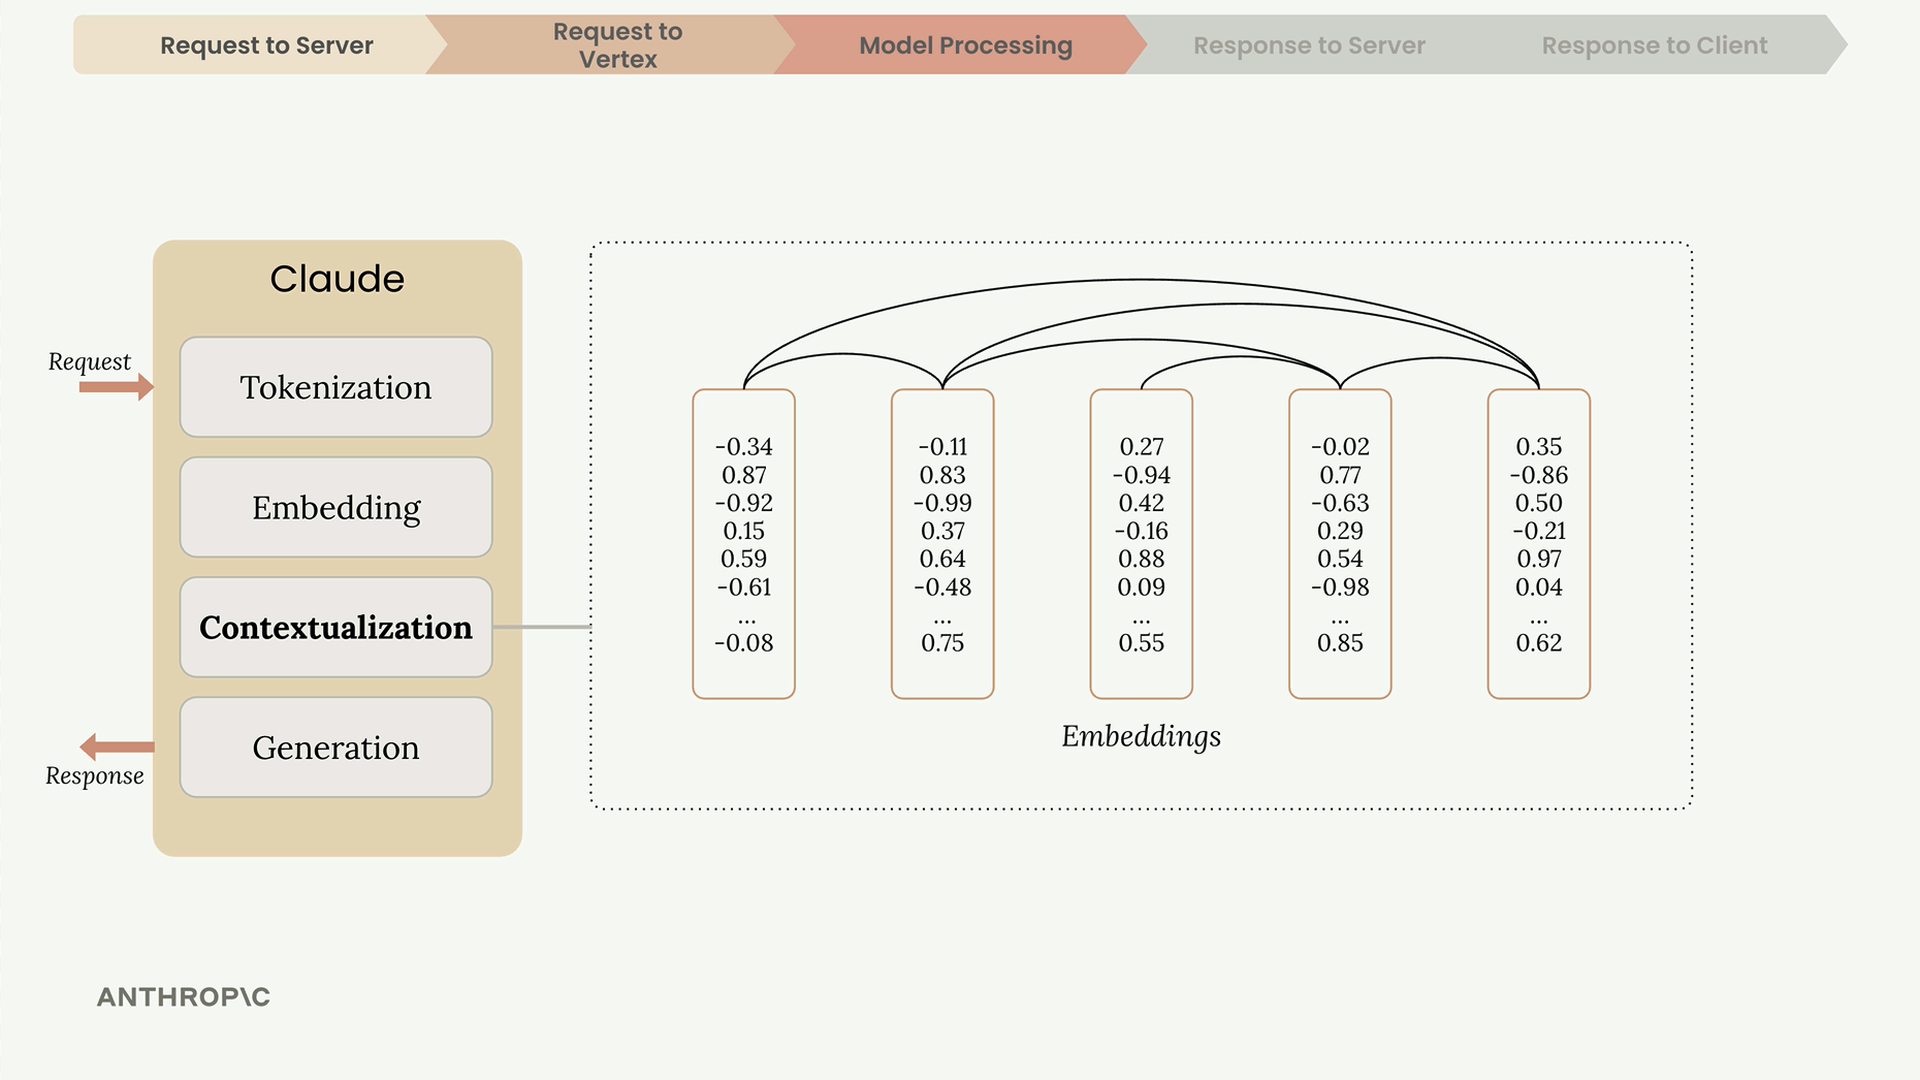
由于单词可以有多种含义,Claude 使用上下文来确定正确的解释。"quantum"一词可以指物理学、计算,或者仅仅意味着"非常小"——来自周围单词的上下文澄清了预期的含义。
在语境化过程中,每个嵌入都会根据其邻居进行调整,突出显示在给定上下文中最合理的含义。
生成
经过语境化的嵌入通过一个输出层,该输出层为每个可能的下一个词生成概率。Claude 不会总是选择概率最高的词——它使用概率和随机性的混合来创建更自然、更多样化的响应。
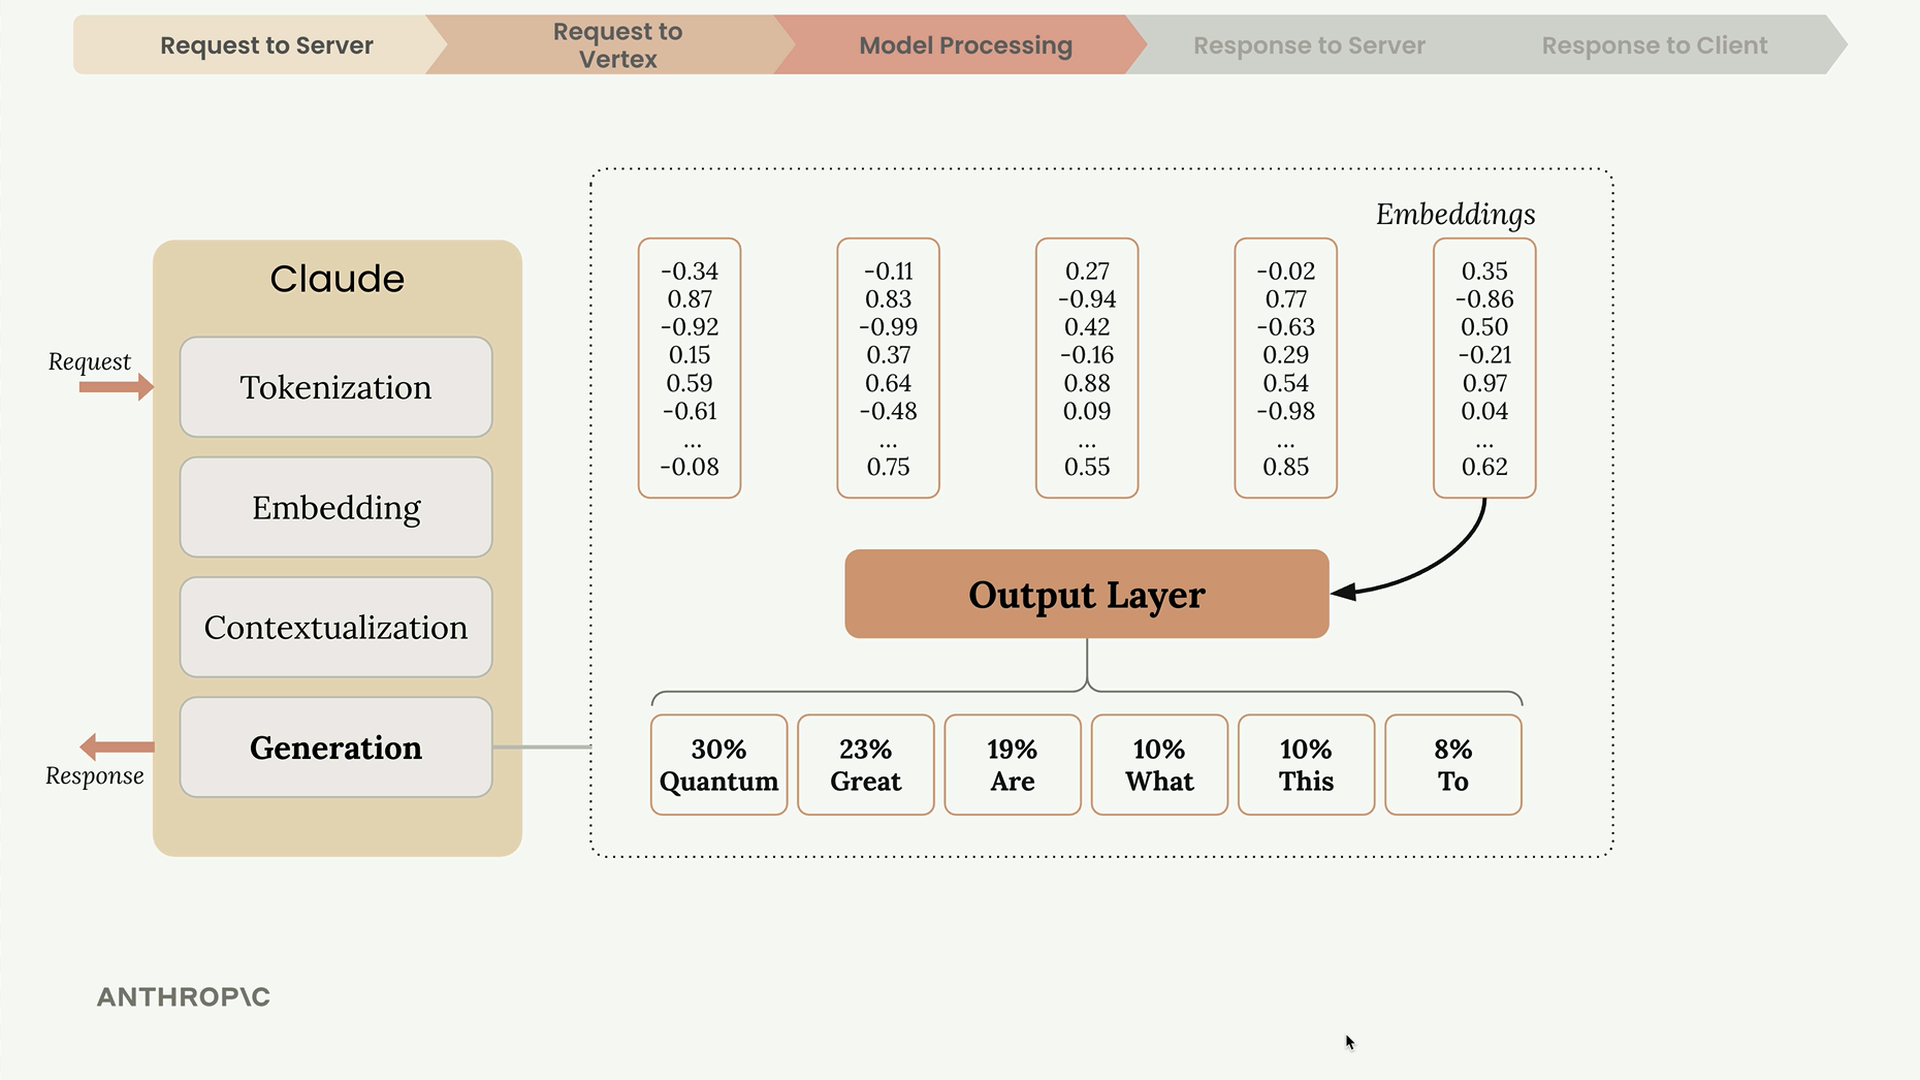
选定一个词后,Claude 将其添加到序列中,并对下一个词重复整个过程。
生成何时停止
在生成每个令牌后,Claude 会检查几个条件以决定是否继续:
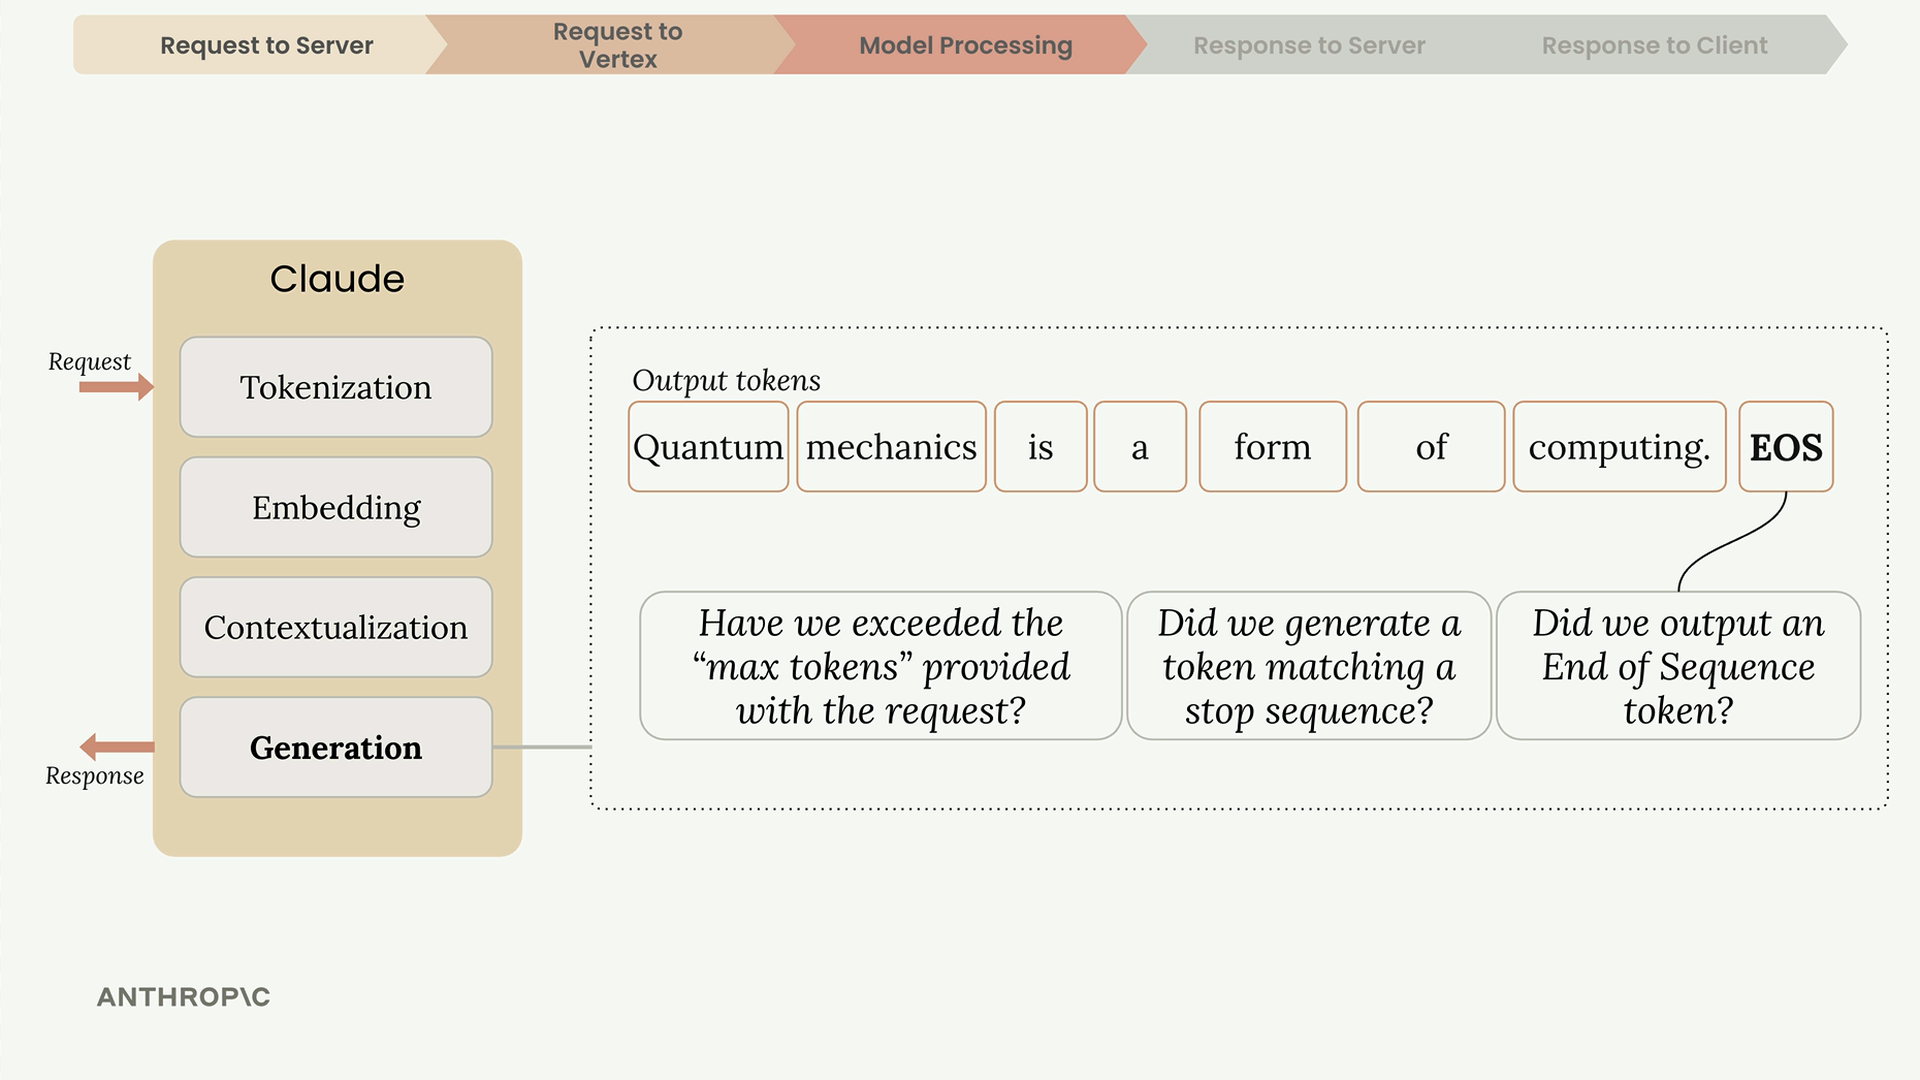
- 达到最大令牌数 - 是否达到了您指定的限制?
- 自然结束 - 它是否生成了序列结束令牌?
- 停止序列 - 它是否遇到了预定义的停止短语?
序列结束令牌是一个特殊信号(不可见文本),Claude 用它来表示已经达到了自然的结论。
响应
一旦生成完成,Vertex 会向您的服务器发回一个响应,其中包含:
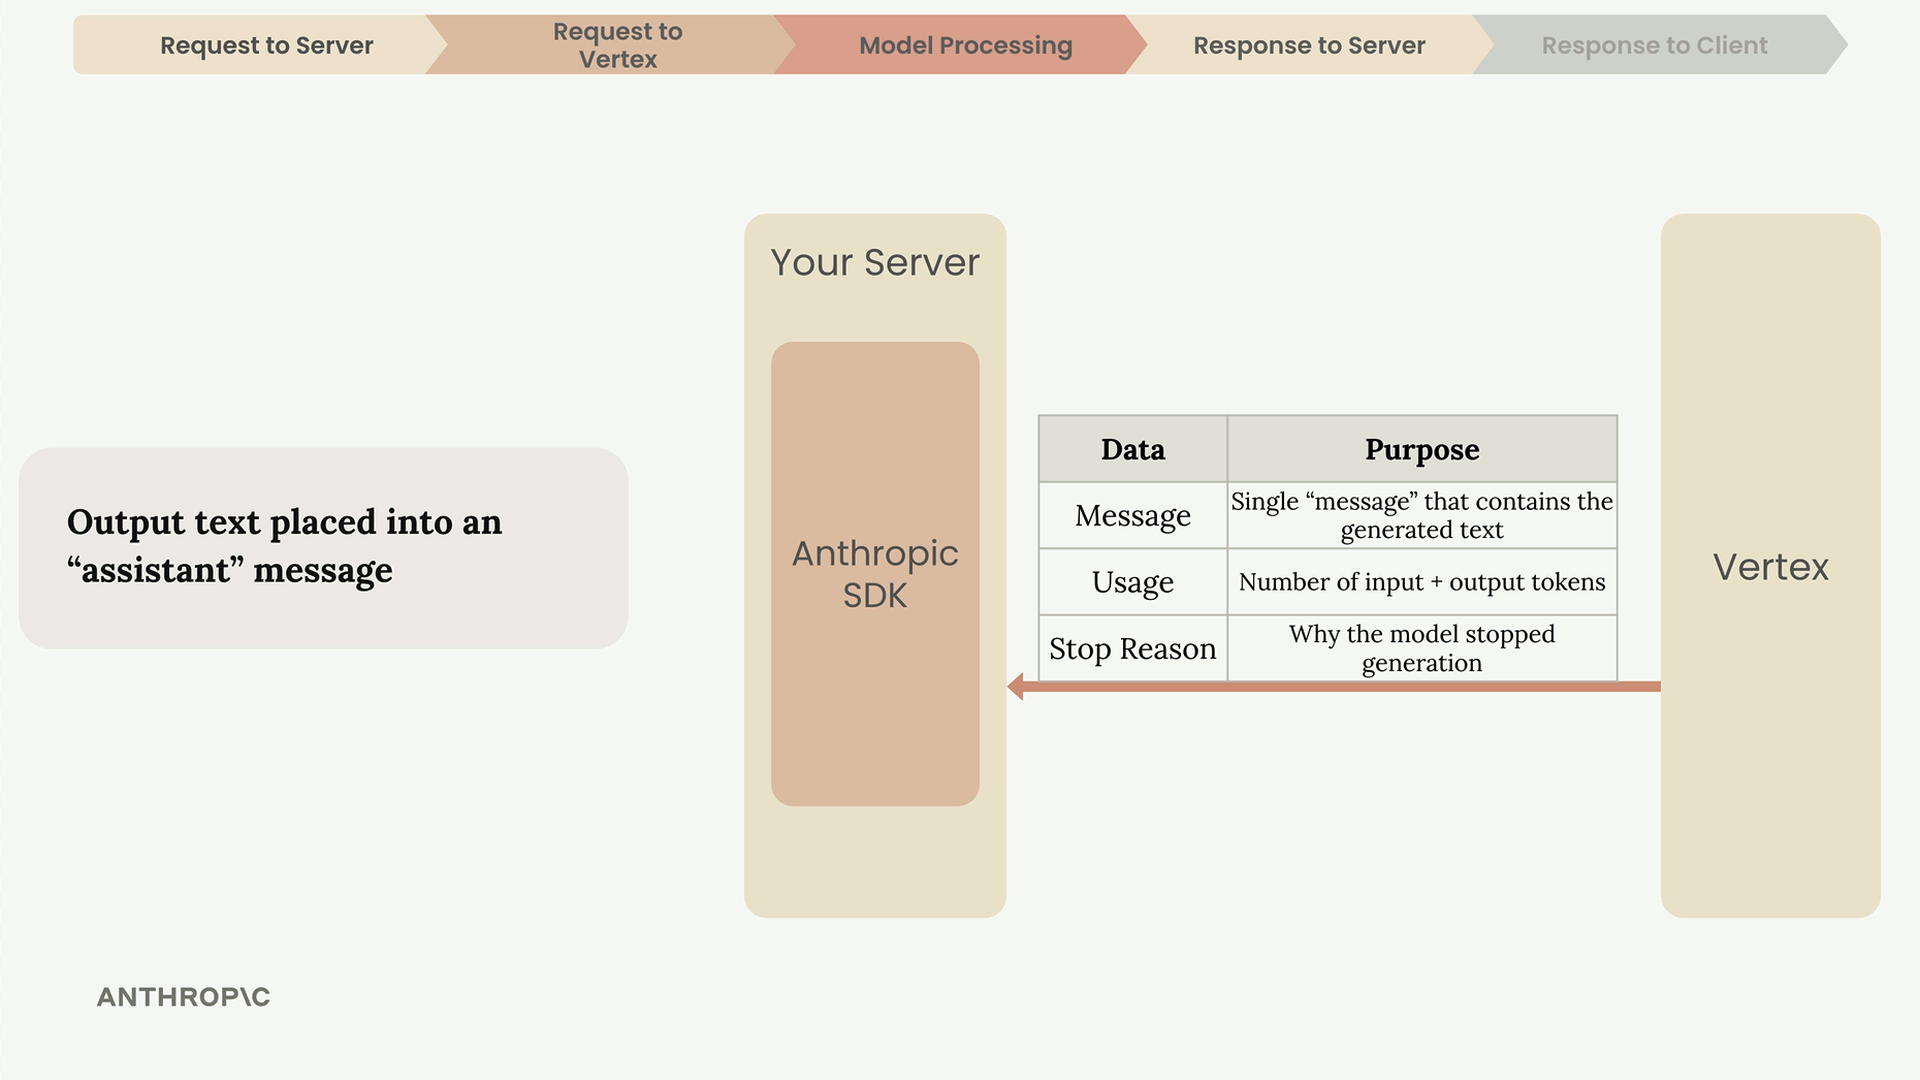
- 消息 - 生成的文本
- 用量 - 输入和输出令牌的计数
- 停止原因 - 模型停止生成的原因
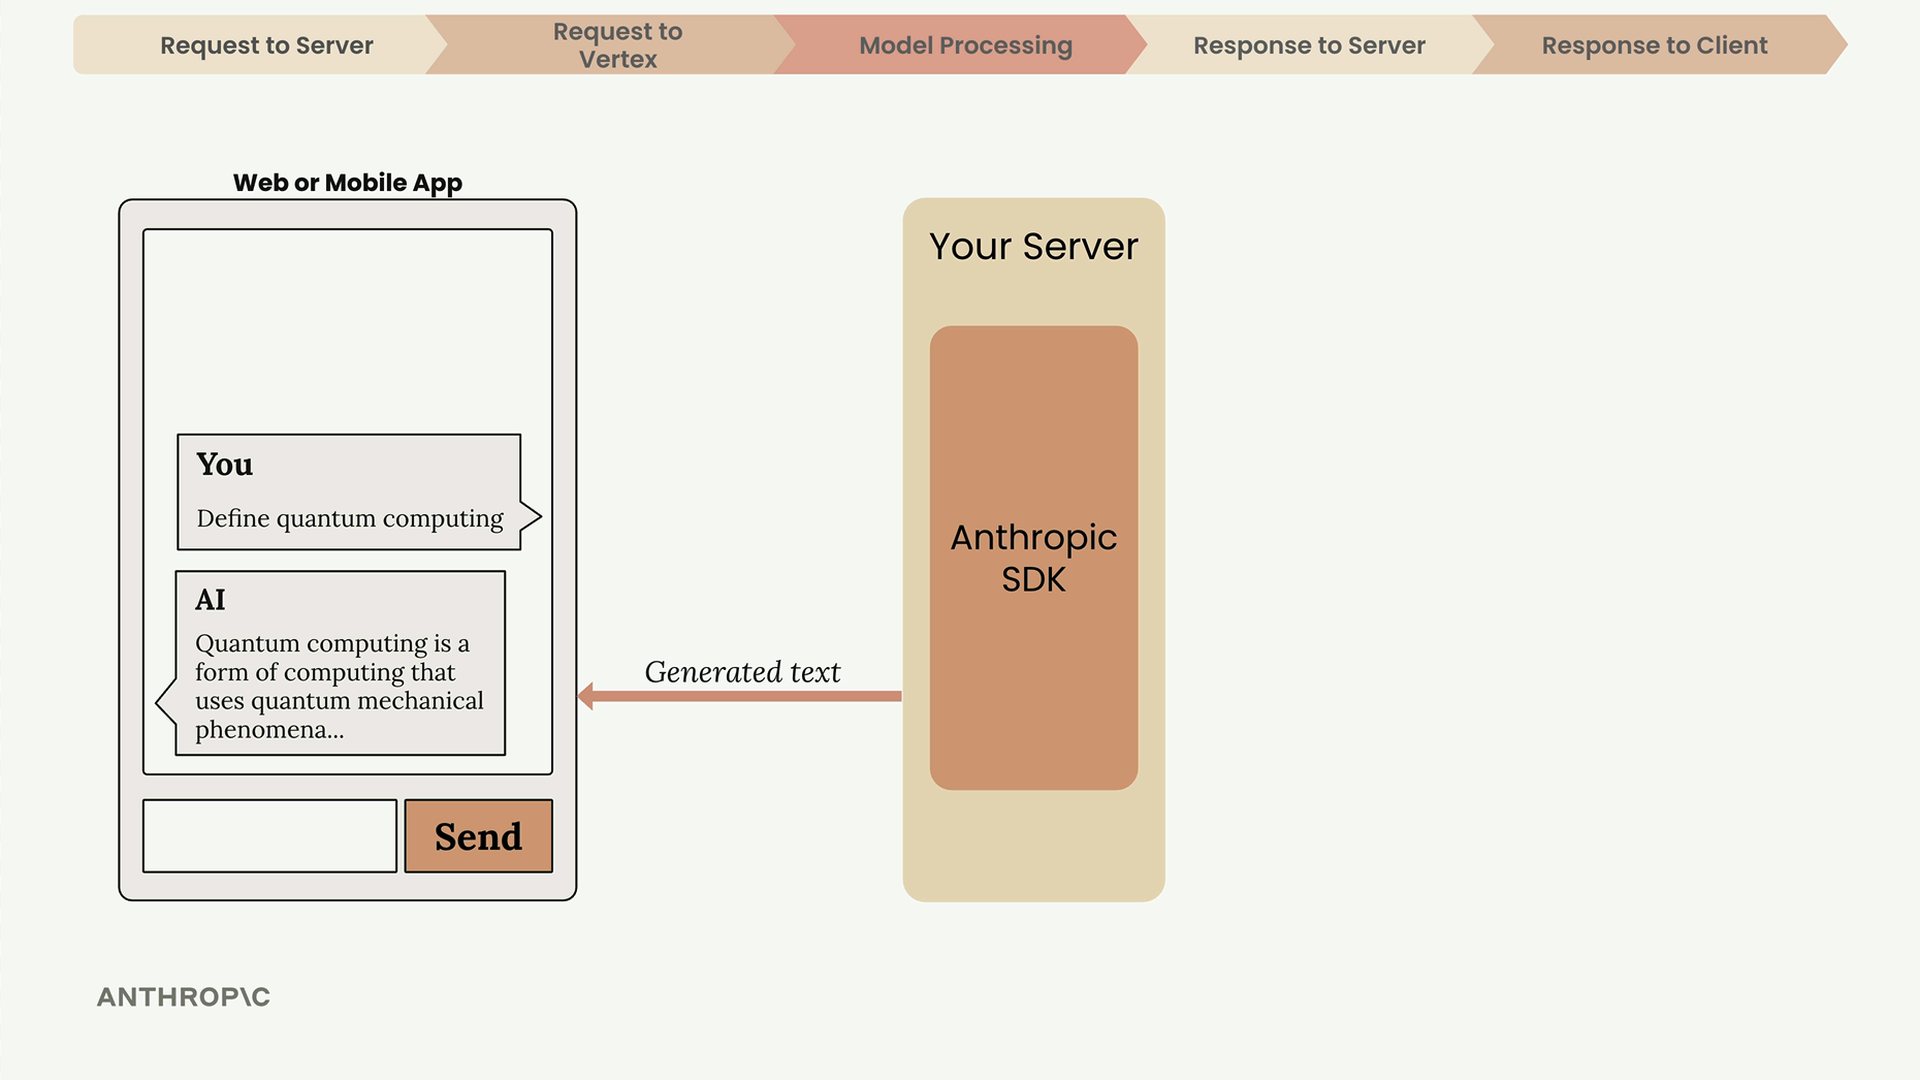
然后,您的服务器将生成的文本转发给您的客户端应用程序,它会显示在聊天界面中。
完整的画面
这整个过程——从用户输入经过分词、嵌入、语境化、生成,再回到用户——在几秒钟内就完成了。理解这一流程有助于您构建更健壮的应用程序,并在问题出现时进行排查。
关键要点:始终使用服务器作为中介,理解文本生成是一个迭代过程,并注意响应元数据以监控用量并理解模型行为。