加载中
提示缓存是一项功能,它通过重用先前请求中的计算工作来加快Claude的响应速度并降低文本生成的成本。与每次请求后都丢弃所有处理工作不同,当您再次发送类似内容时,Claude可以保存并重用这些工作。
Claude通常如何处理请求
为了理解提示缓存,我们先来看看在未启用缓存的典型请求中会发生什么。
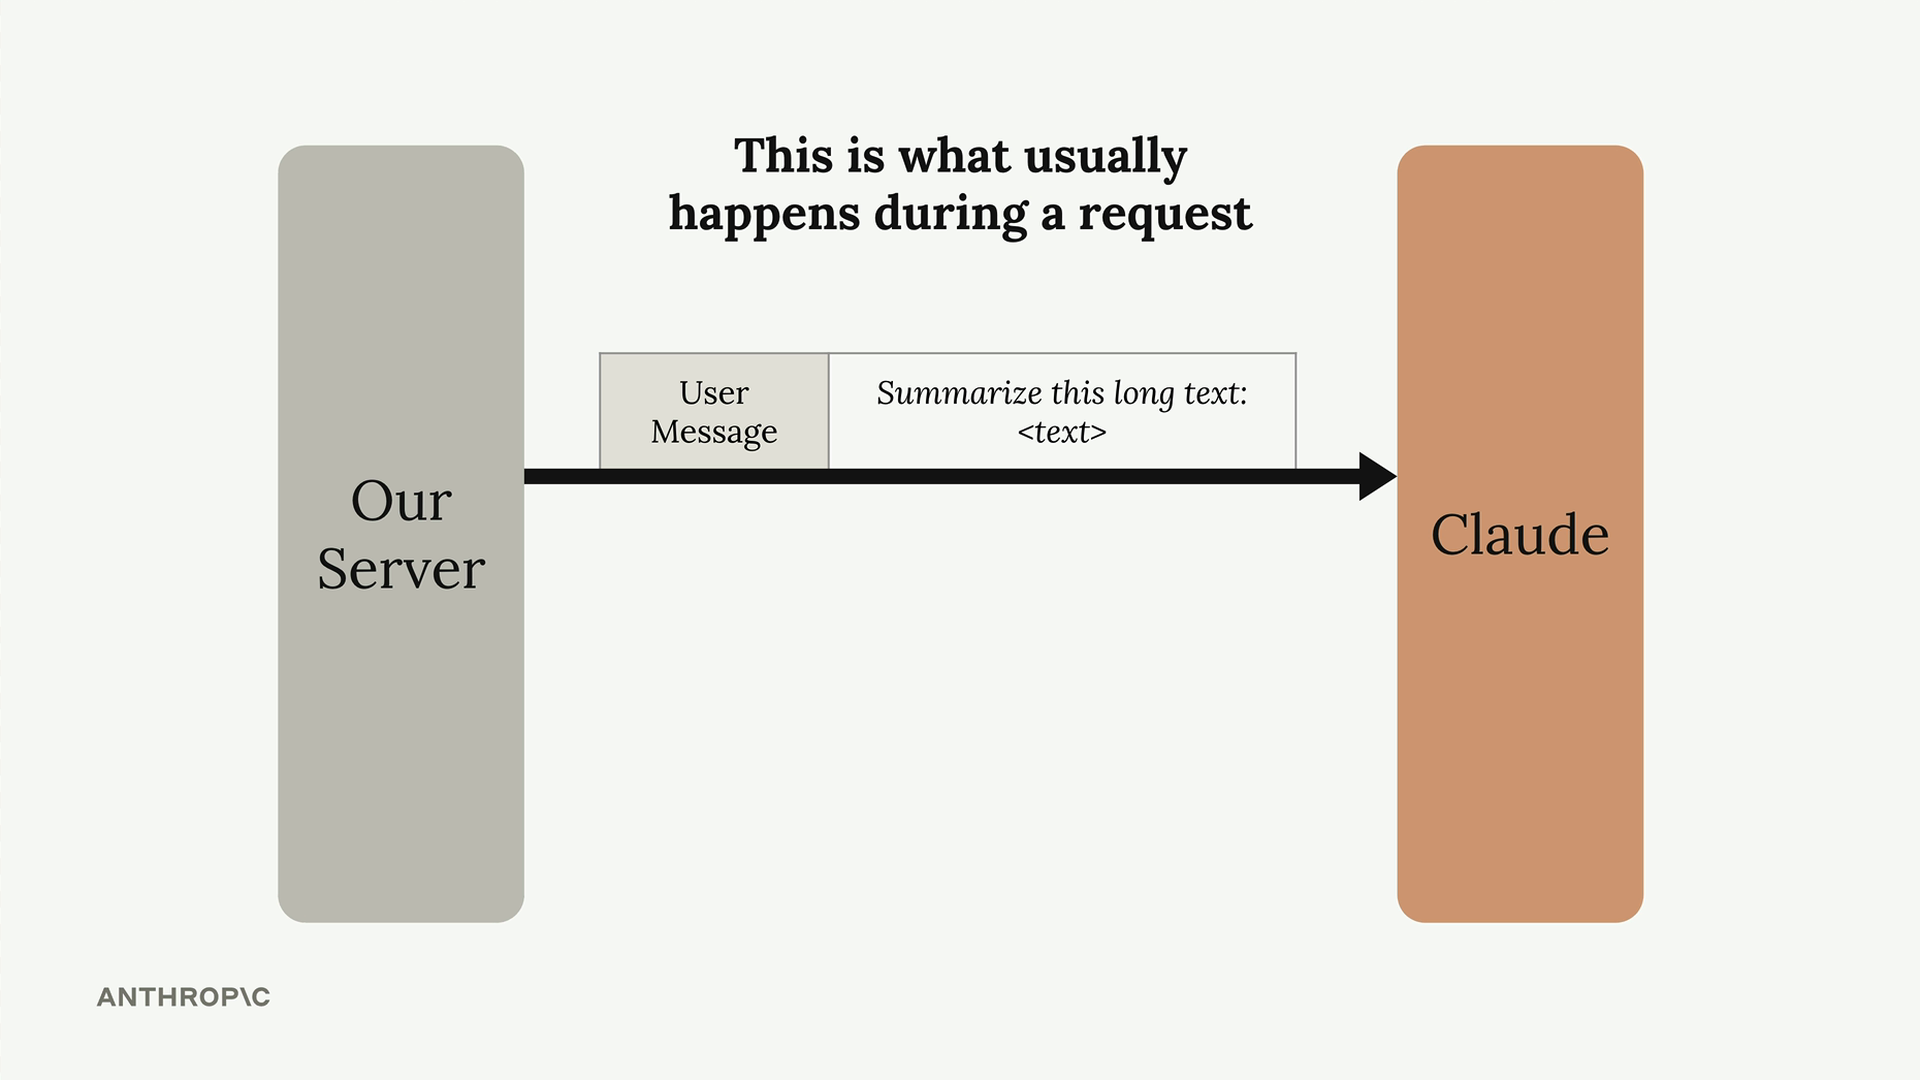
当您向Claude发送消息时,它不会立即开始生成响应。相反,Claude会对您的输入执行大量的预处理工作:
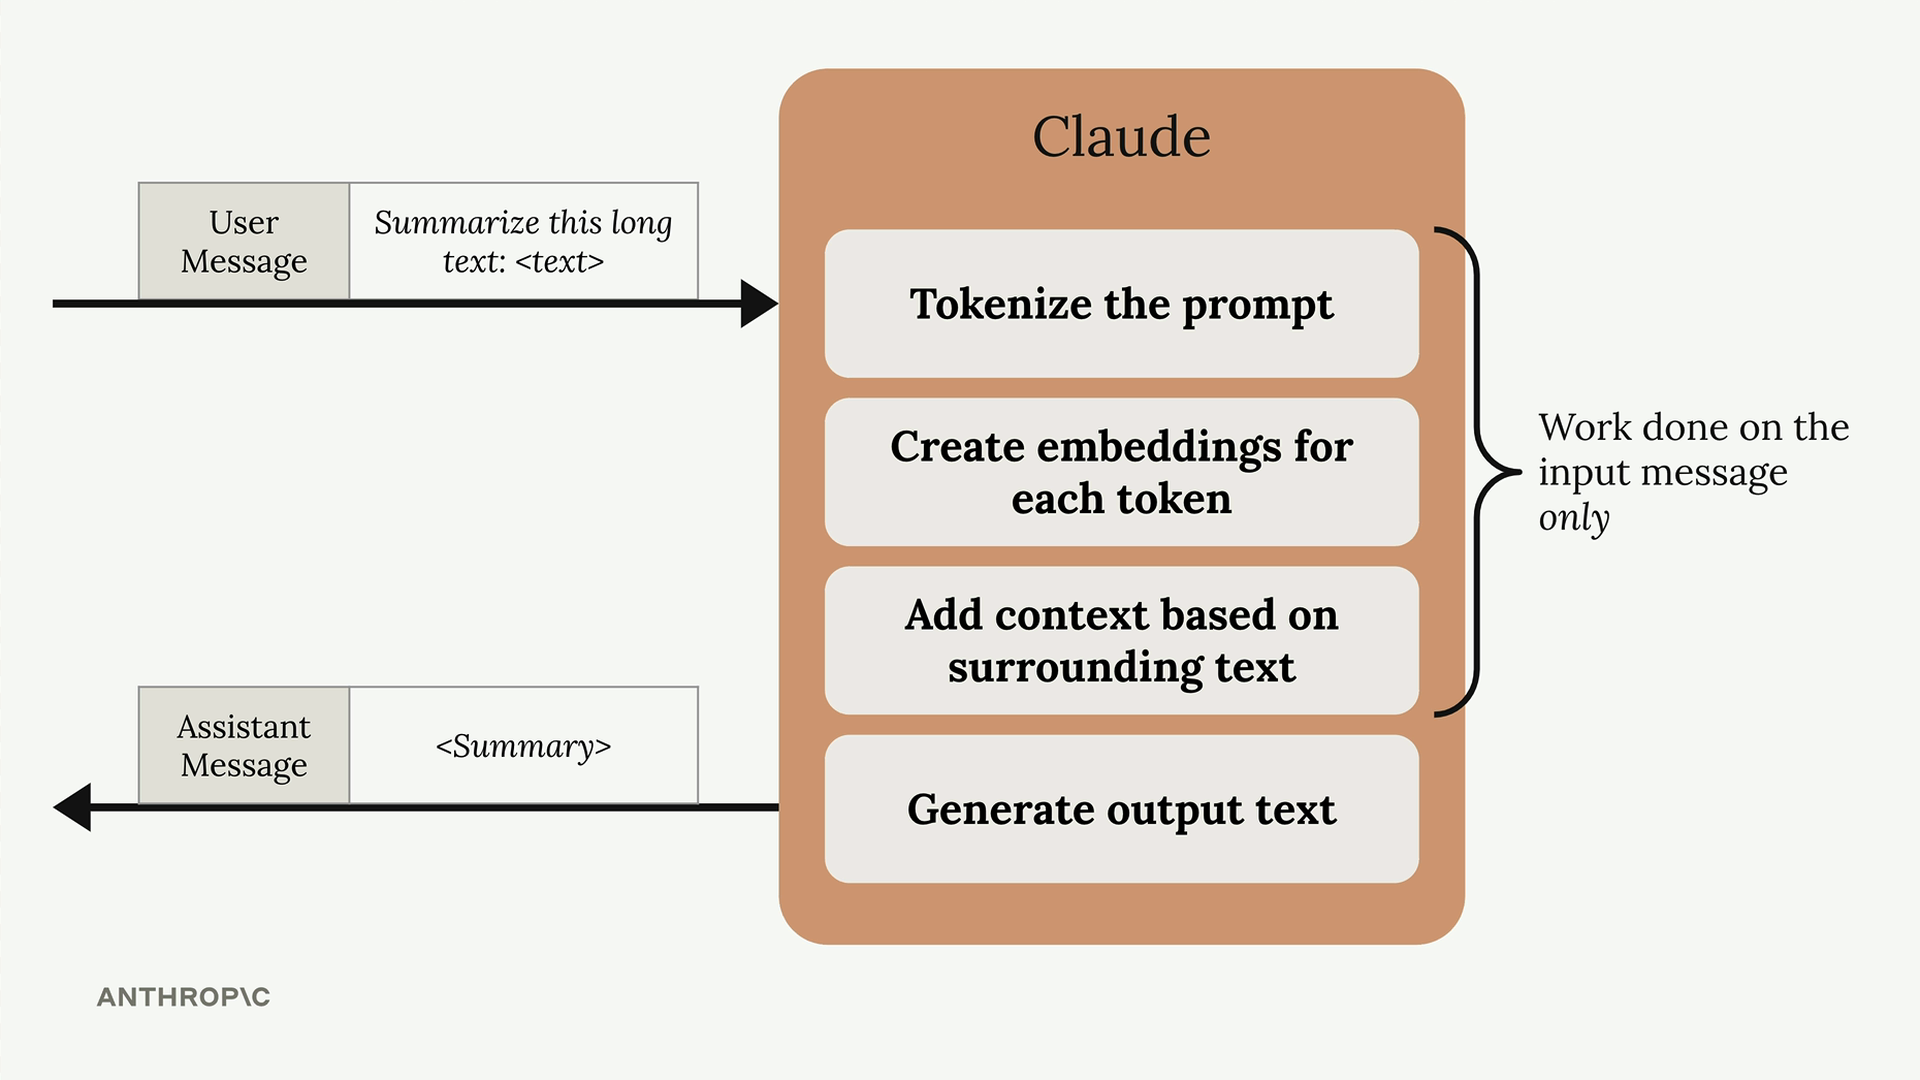
- 对提示进行分词(将文本拆分为更小的单元)
- 为每个token创建嵌入(数学表示)
- 根据周围文本添加上下文
- 只有此时才生成实际的输出文本
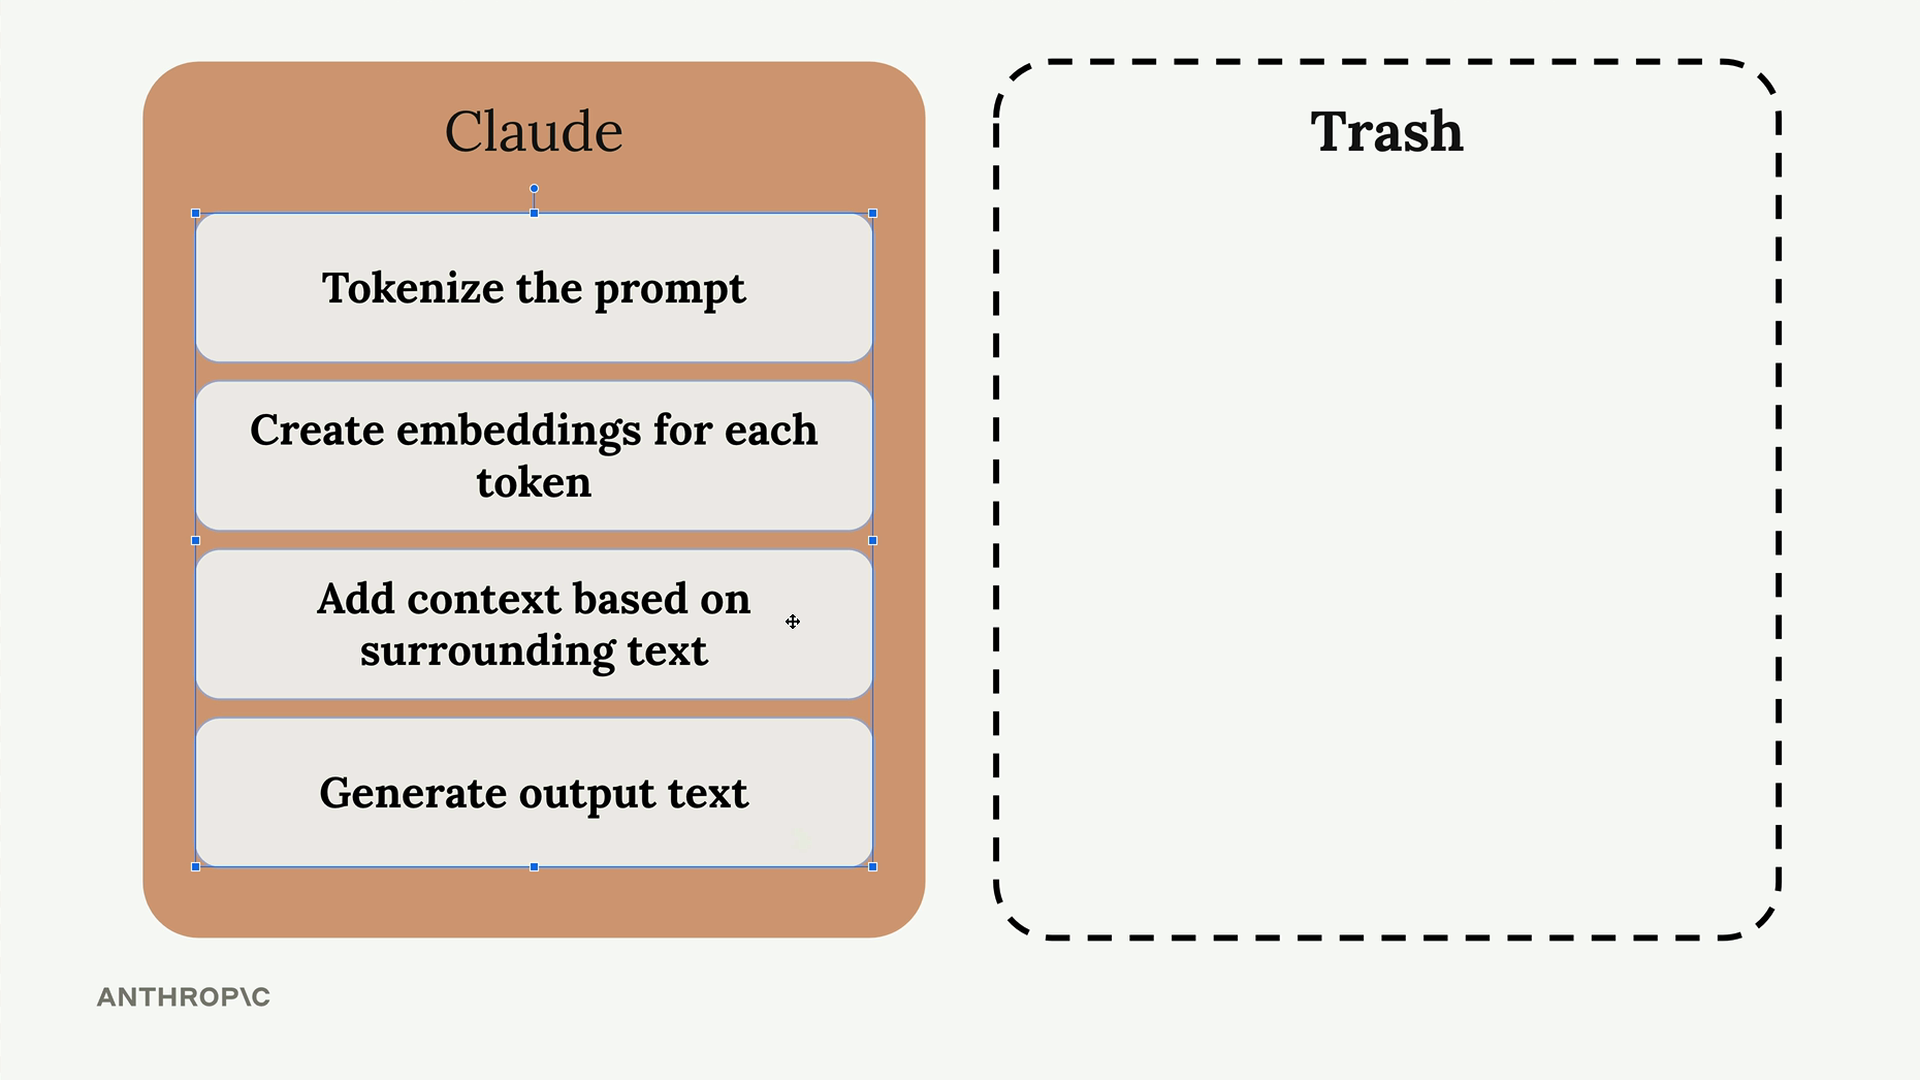
在将响应发送给您之后,Claude会丢弃所有这些计算工作。一切都被抛弃了,然后Claude宣布自己已准备好处理下一个请求。
重复内容带来的问题
问题就出在这里,效率低下。想象一下您正在与Claude对话,所以您的后续请求包括:
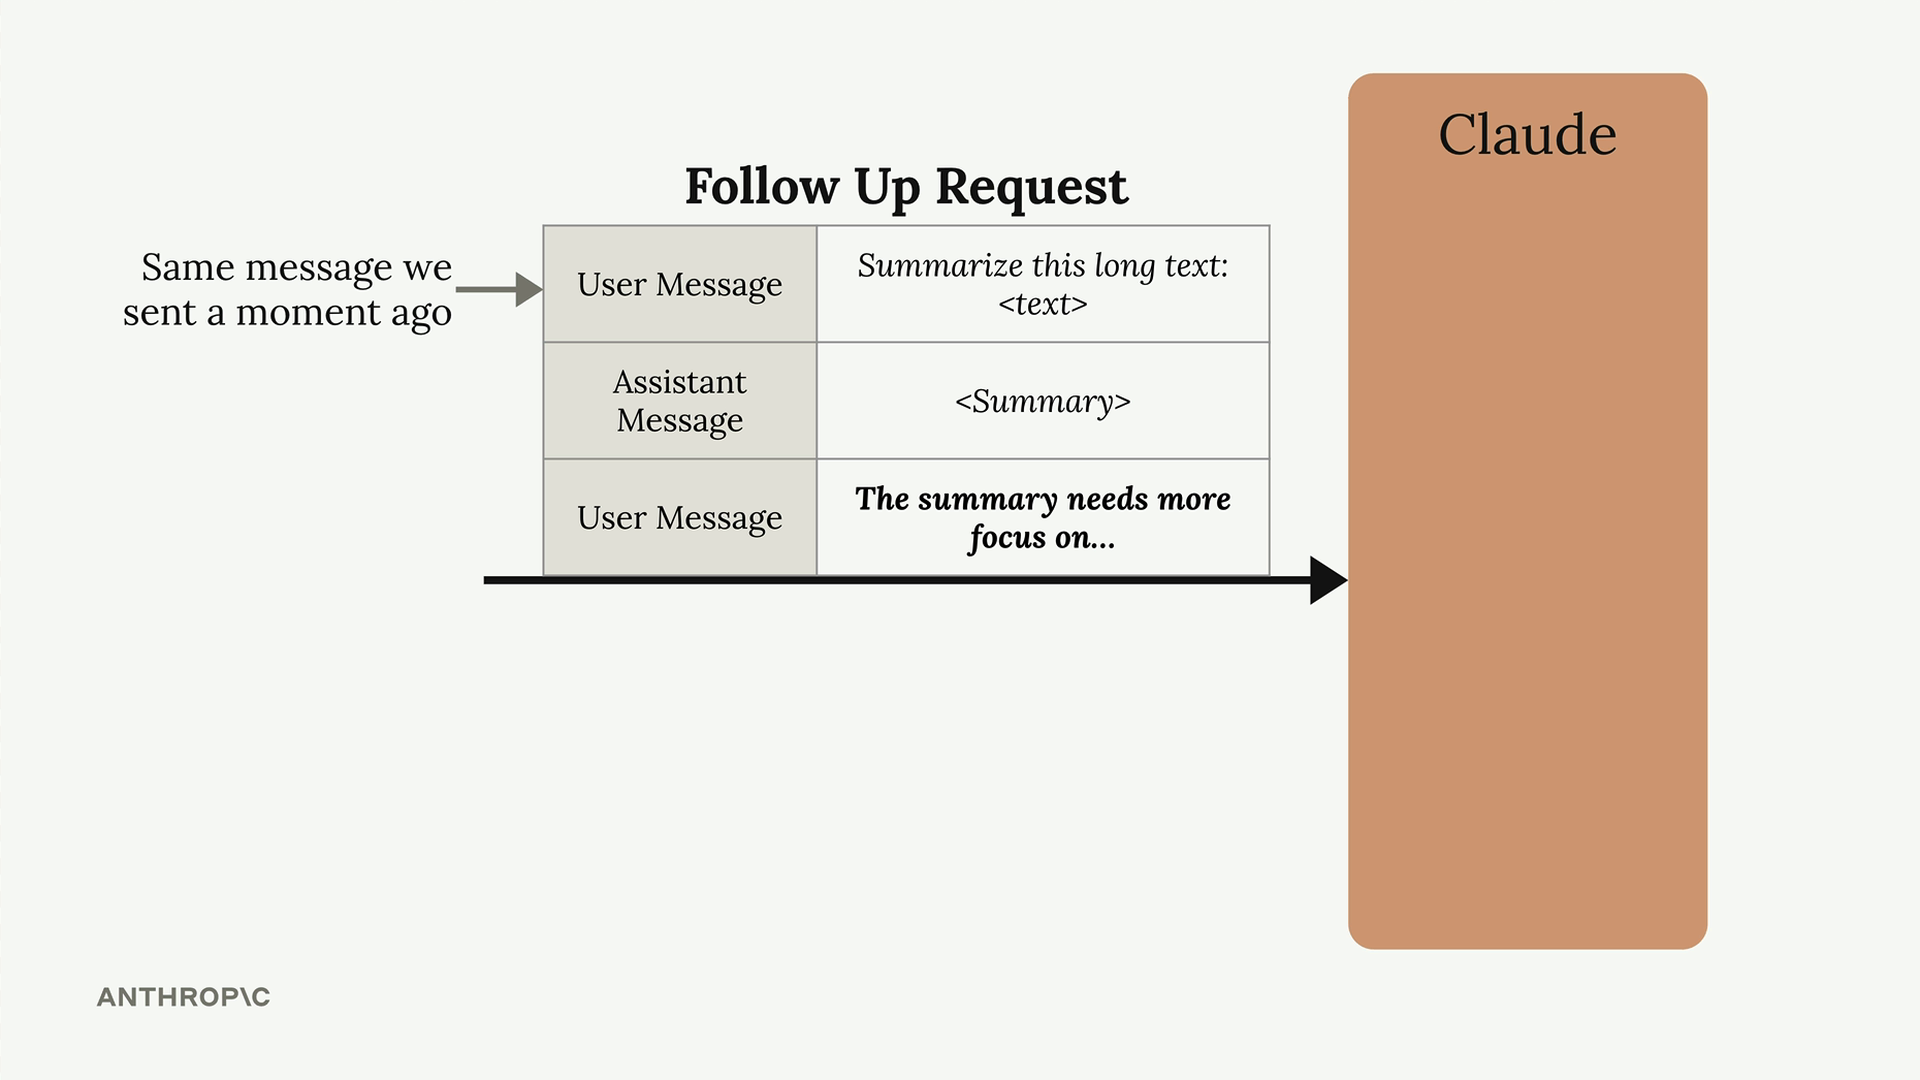
- 之前相同的原始用户消息
- Claude之前的响应
- 您的新后续消息
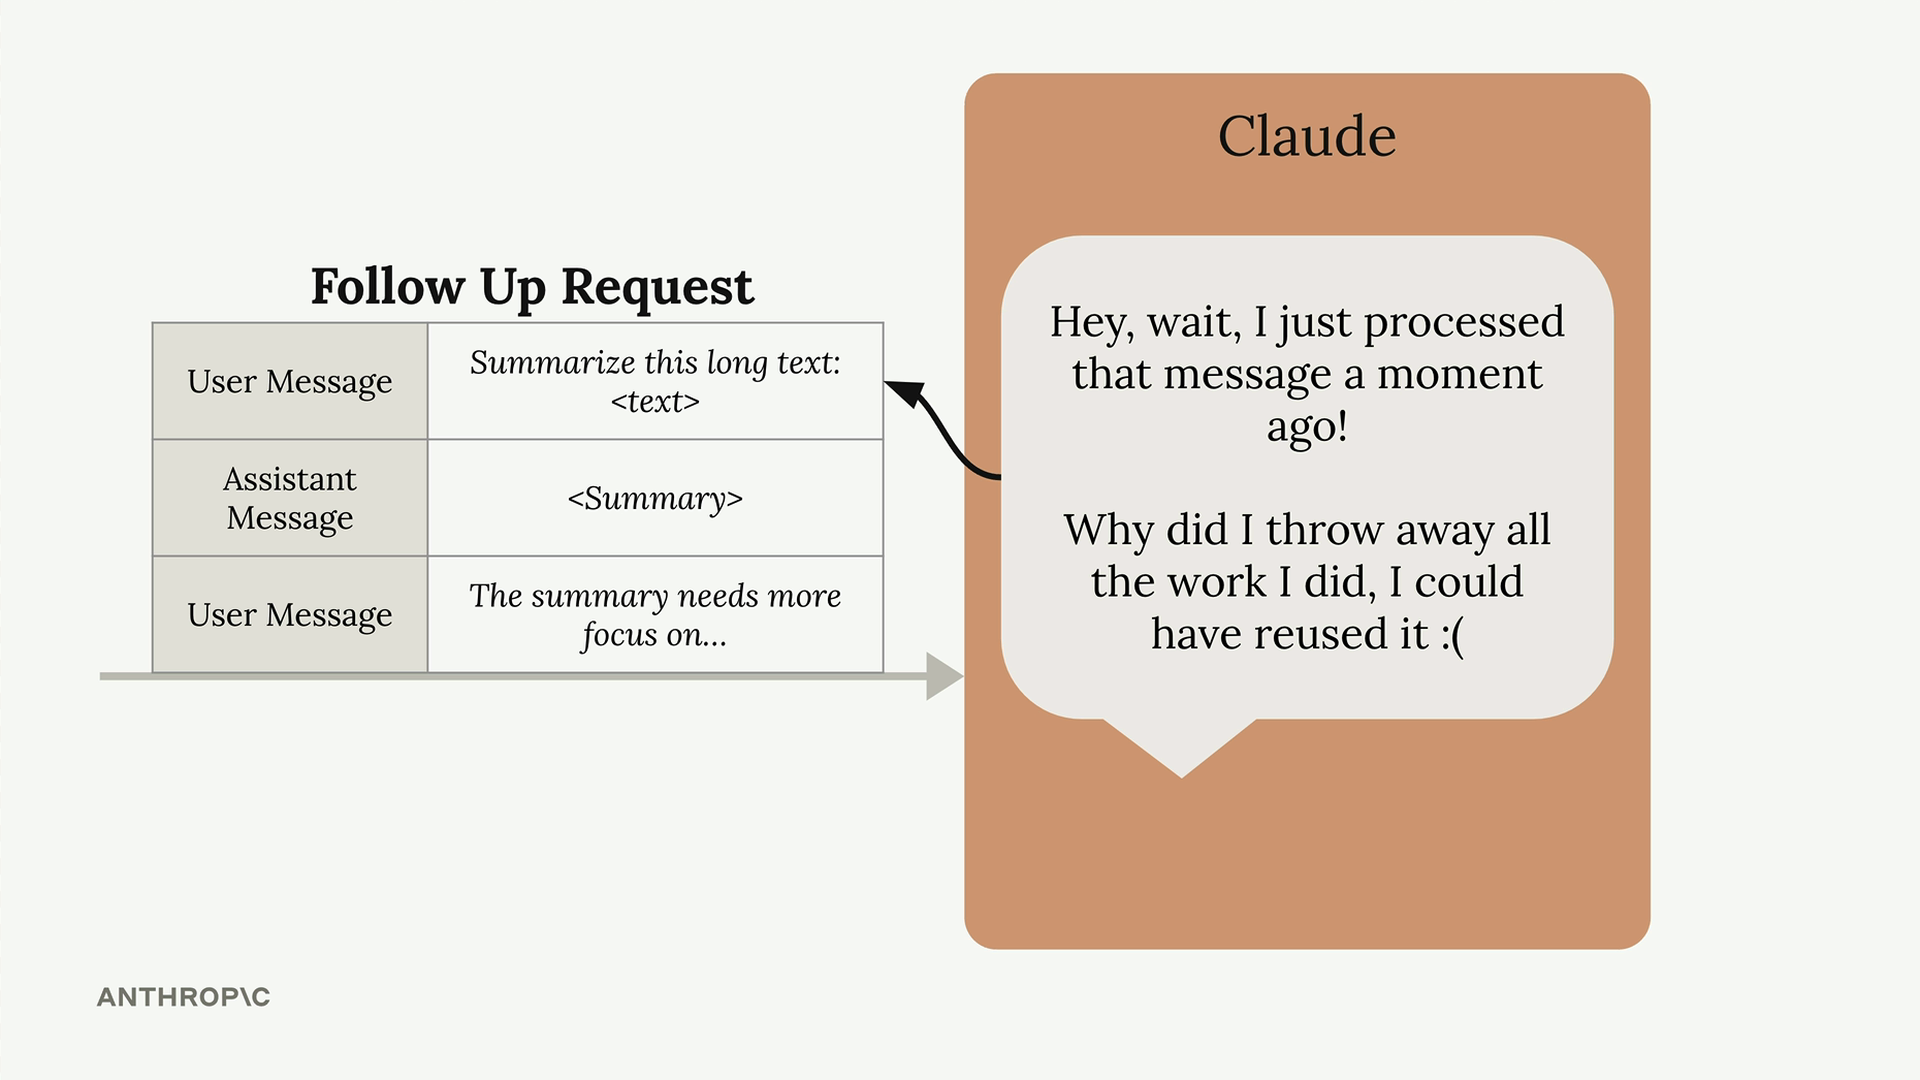
Claude必须重新处理那条原始消息,尽管它刚刚在片刻之前分析过完全相同的内容。Claude可能会这样想:"我刚刚处理过那条消息,然后把我所做的所有工作都扔掉了。我本可以重用它的!"
提示缓存如何解决这个问题
提示缓存改变了这种浪费的流程。Claude不再丢弃预处理工作,而是将其保存在缓存中。
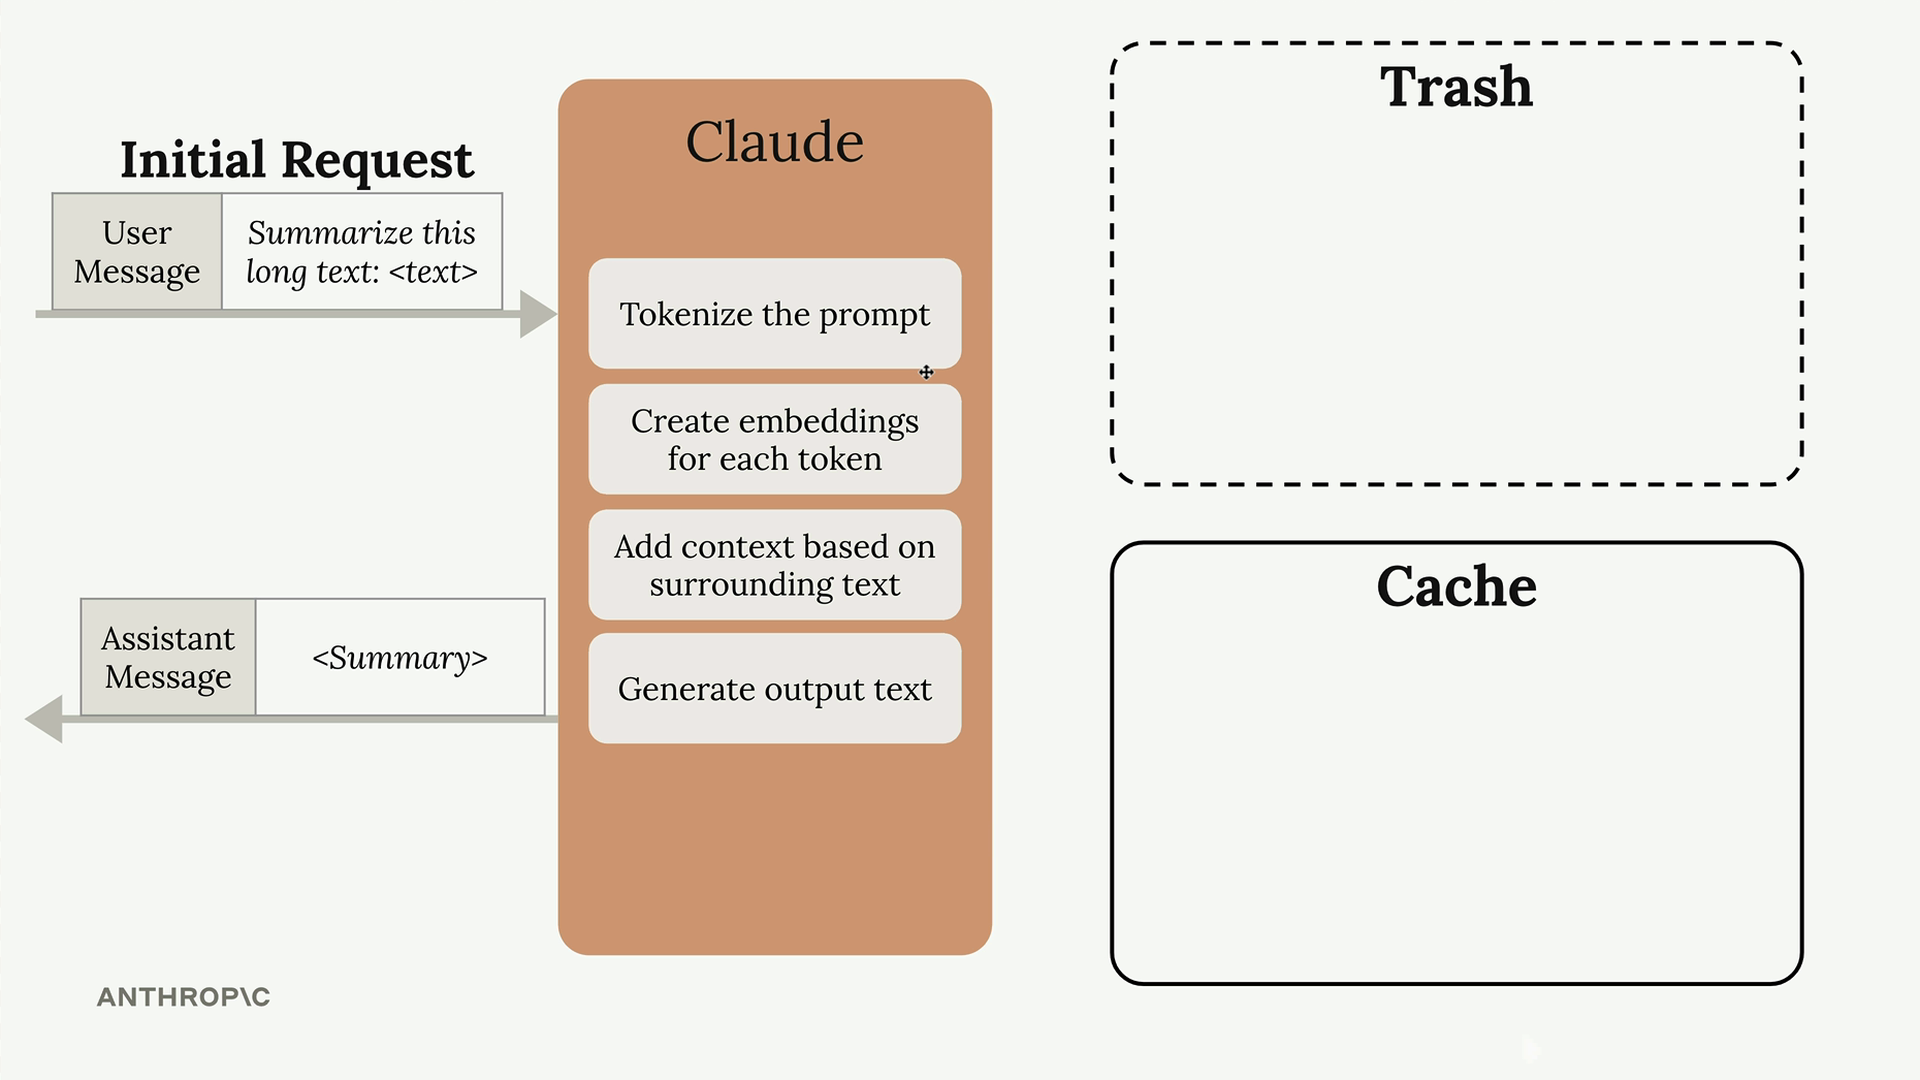
它的工作原理如下:
- 初始请求: Claude处理您的消息并将计算工作写入缓存
- 后续请求: 当Claude再次看到相同内容时,它会从缓存中读取之前处理过的工作,而不是从头开始
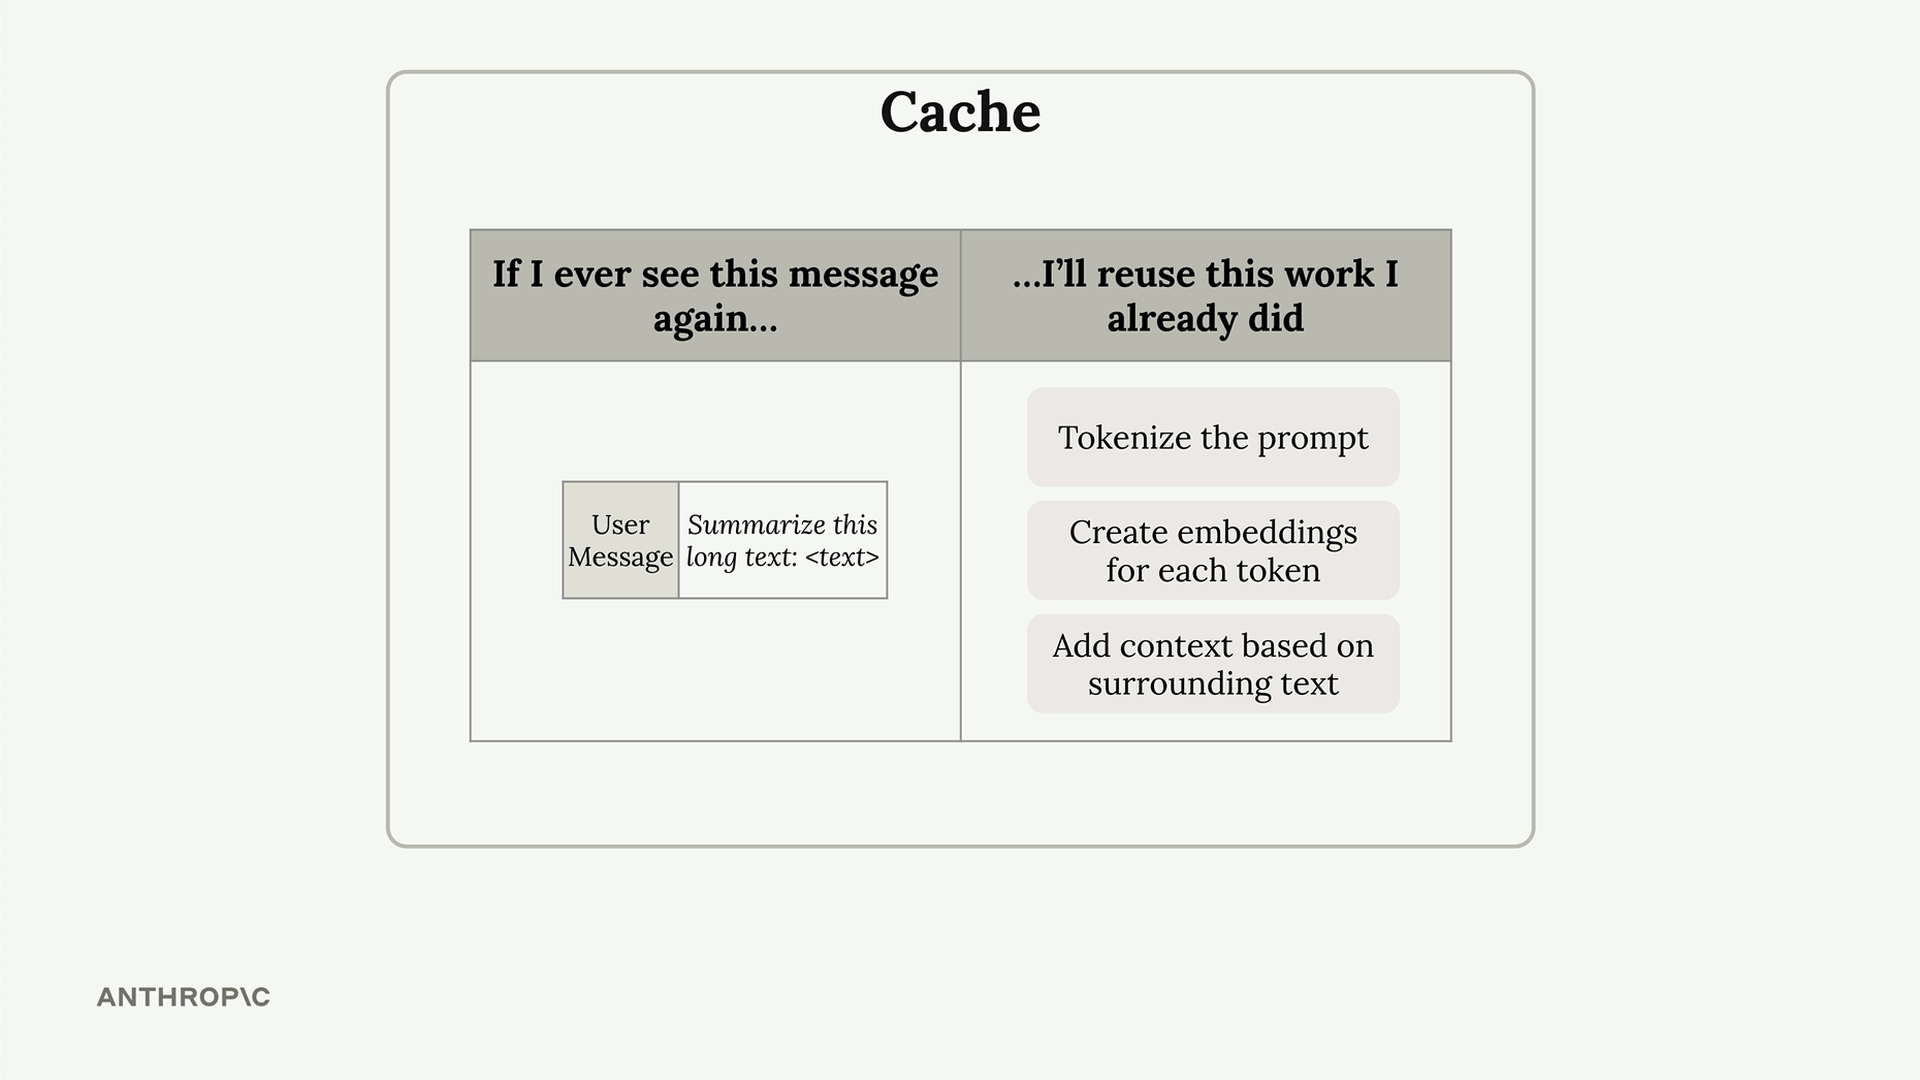
缓存的作用就像一个查找表:"如果我再次看到这条消息,我就会重用我已经完成的这项工作。"
主要优势和局限性
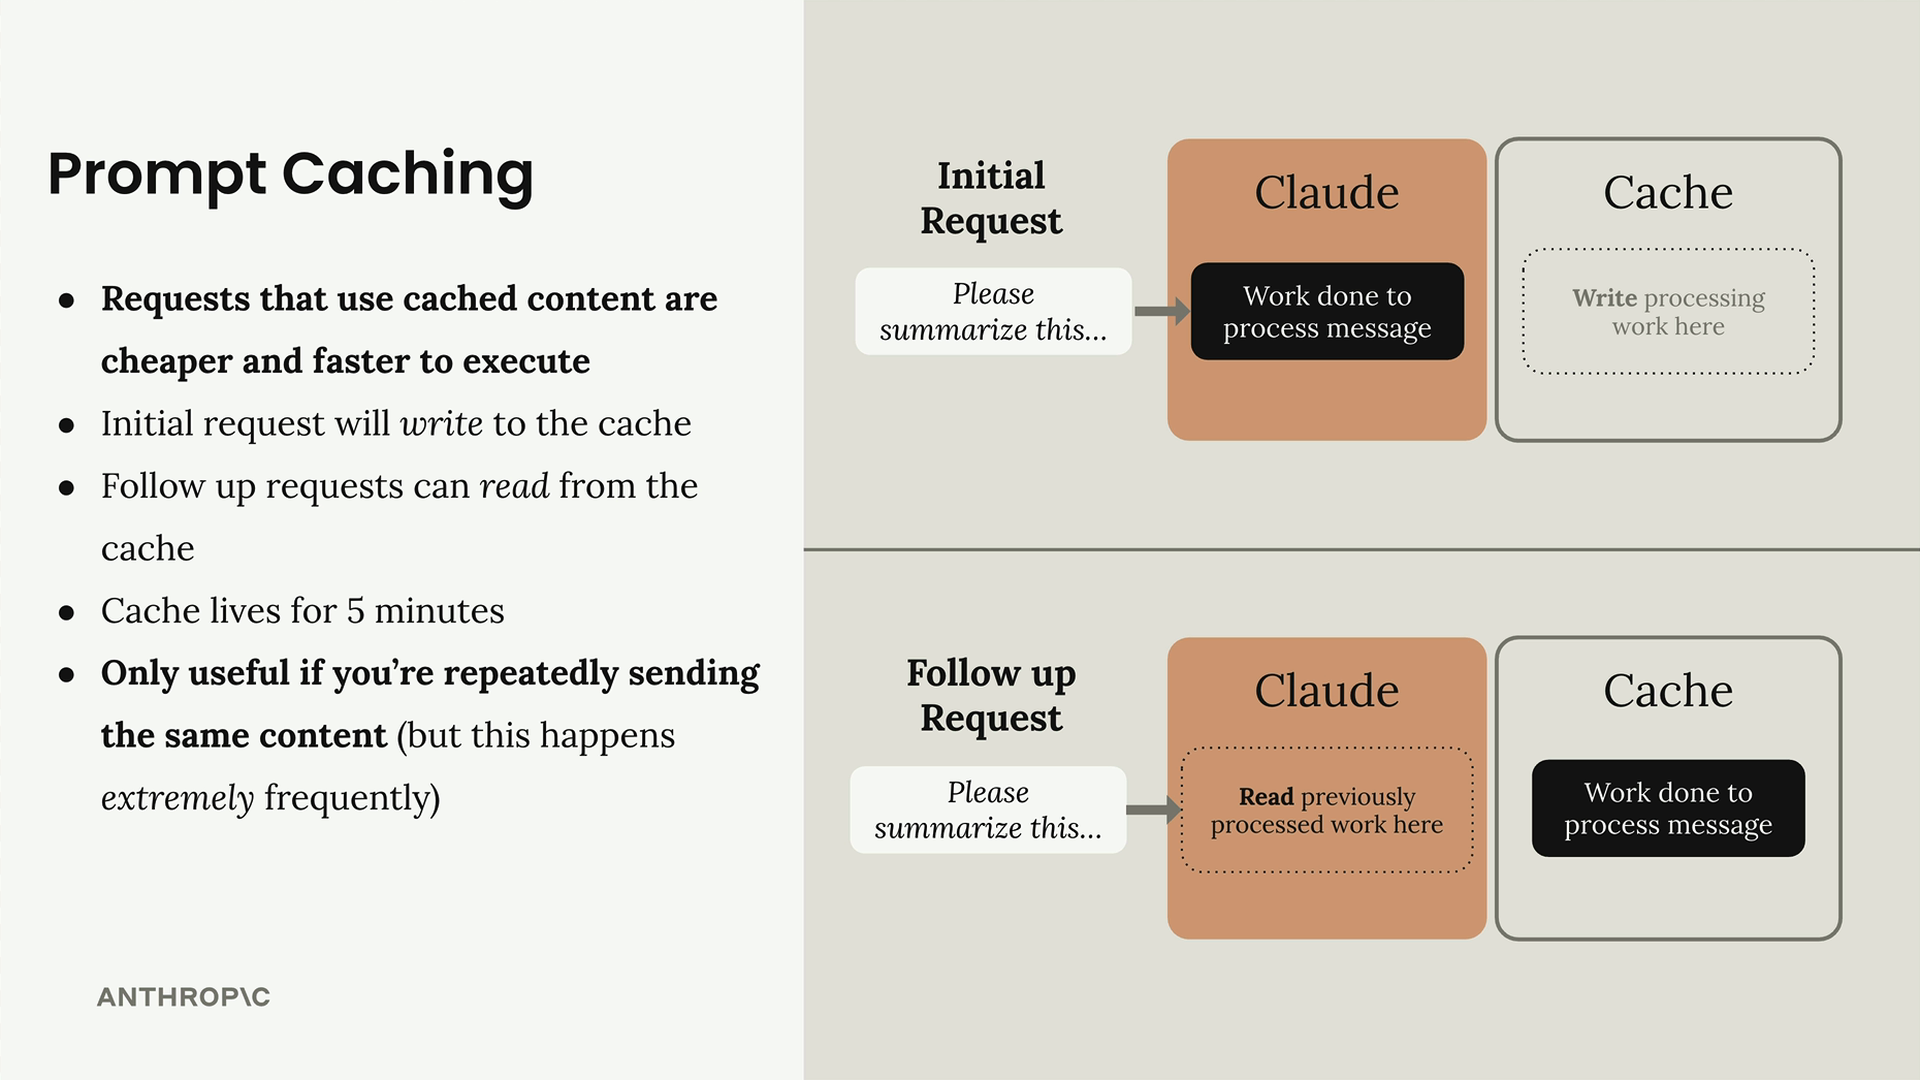
提示缓存具有以下几项优势:
- 更快的响应: 使用缓存内容的请求执行速度更快
- 更低的成本: 重用缓存工作的处理费用更低
- 自动优化: 初始请求写入缓存,后续请求从中读取
然而,有一些重要的局限性需要牢记:
- 生命周期短: 缓存仅存活5分钟
- 需要完全匹配: 仅在您重复发送相同内容时才有用
- 常见用例: 这种情况在对话式应用程序和文档分析工作流中极为常见
对于用户频繁引用相同文档、延续对话,或在短时间内对类似提示进行迭代的应用程序而言,提示缓存特别有价值。