Claude 中的提示缓存是通过存储对消息所做的计算工作以便在后续请求中重复使用来实现的。这使得使用缓存内容的请求执行起来既更便宜又更快。
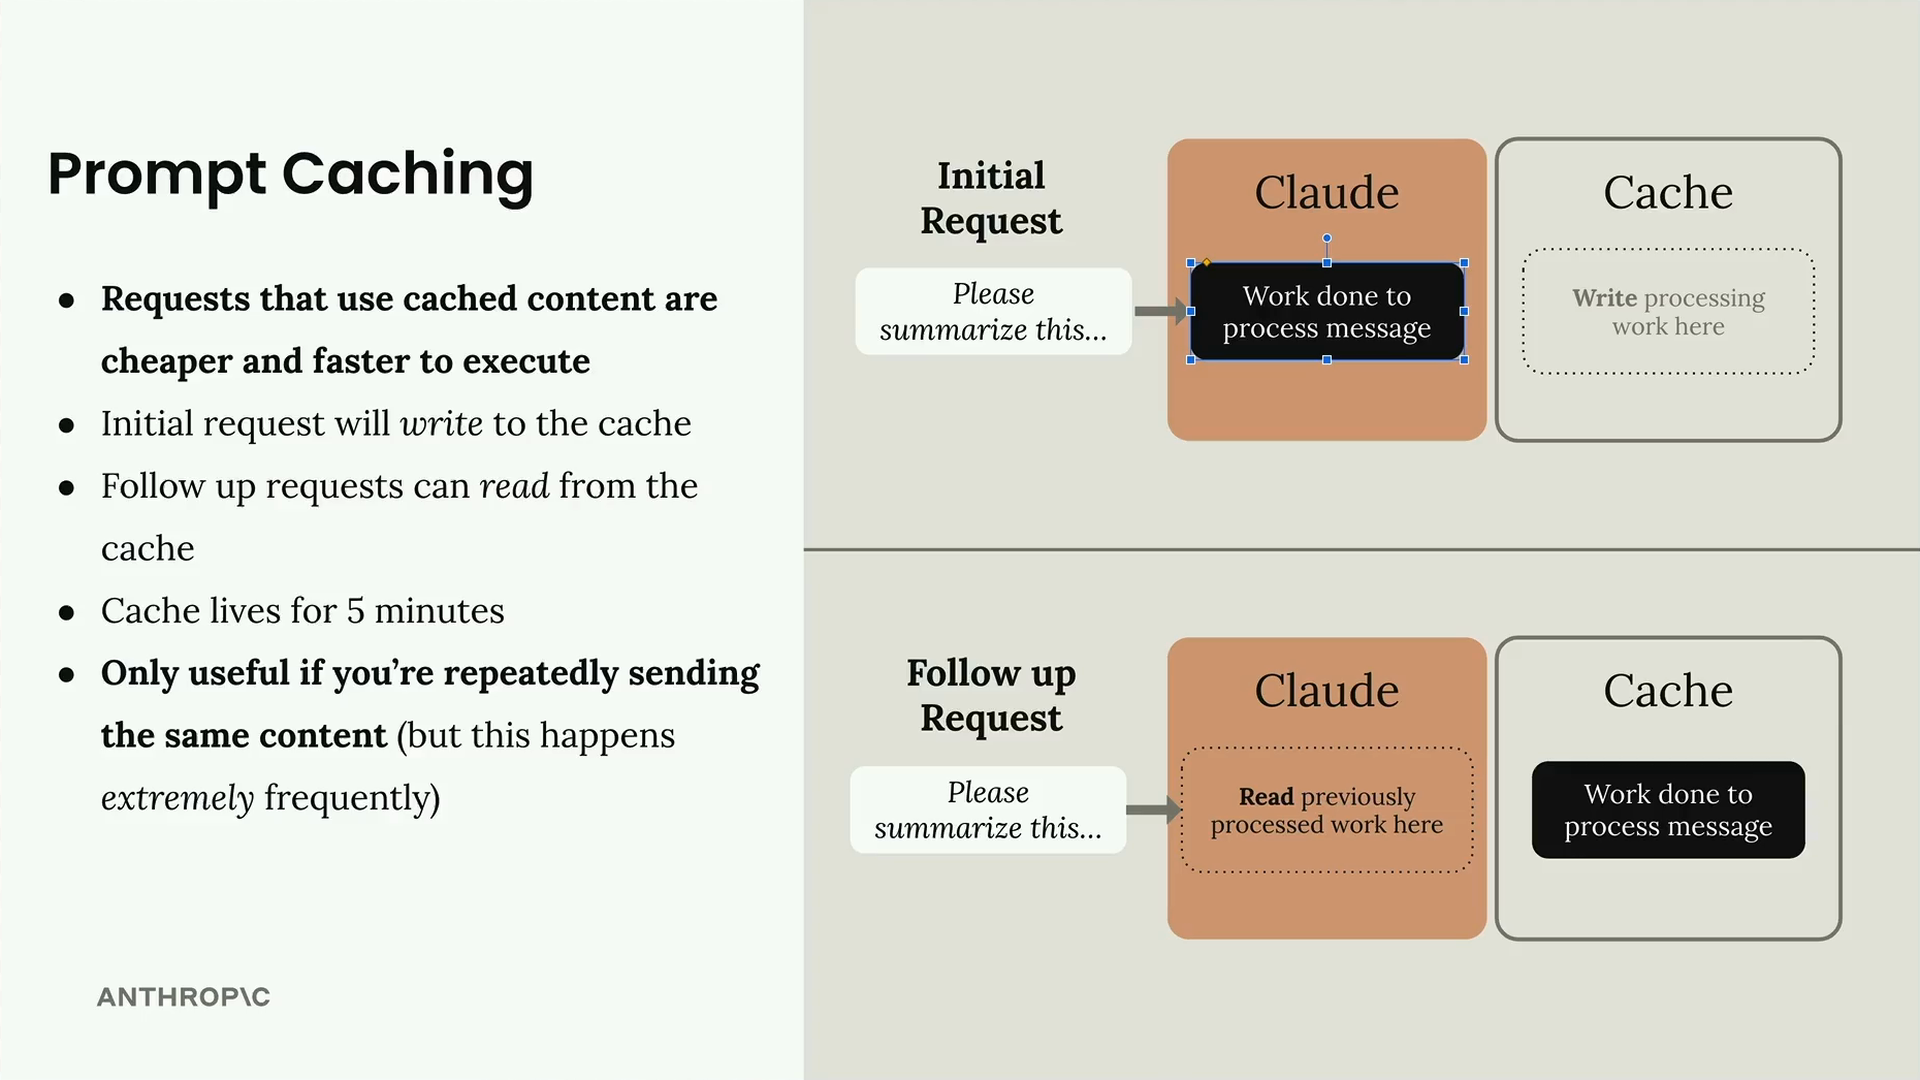
这个过程遵循一个简单的模式:您的初始请求会写入缓存,而后续请求可以从缓存中读取。缓存的存活时间为 5 分钟,因此只有当您反复发送相同的内容时,这个功能才有用——但这在实际应用中发生得非常频繁。
缓存断点
对消息所做的工作不会自动缓存。我们必须手动向某个块添加一个"缓存断点"。断点之前的所有工作都会被缓存,并且只有当断点及之前的内容完全相同时,后续请求才会使用缓存。
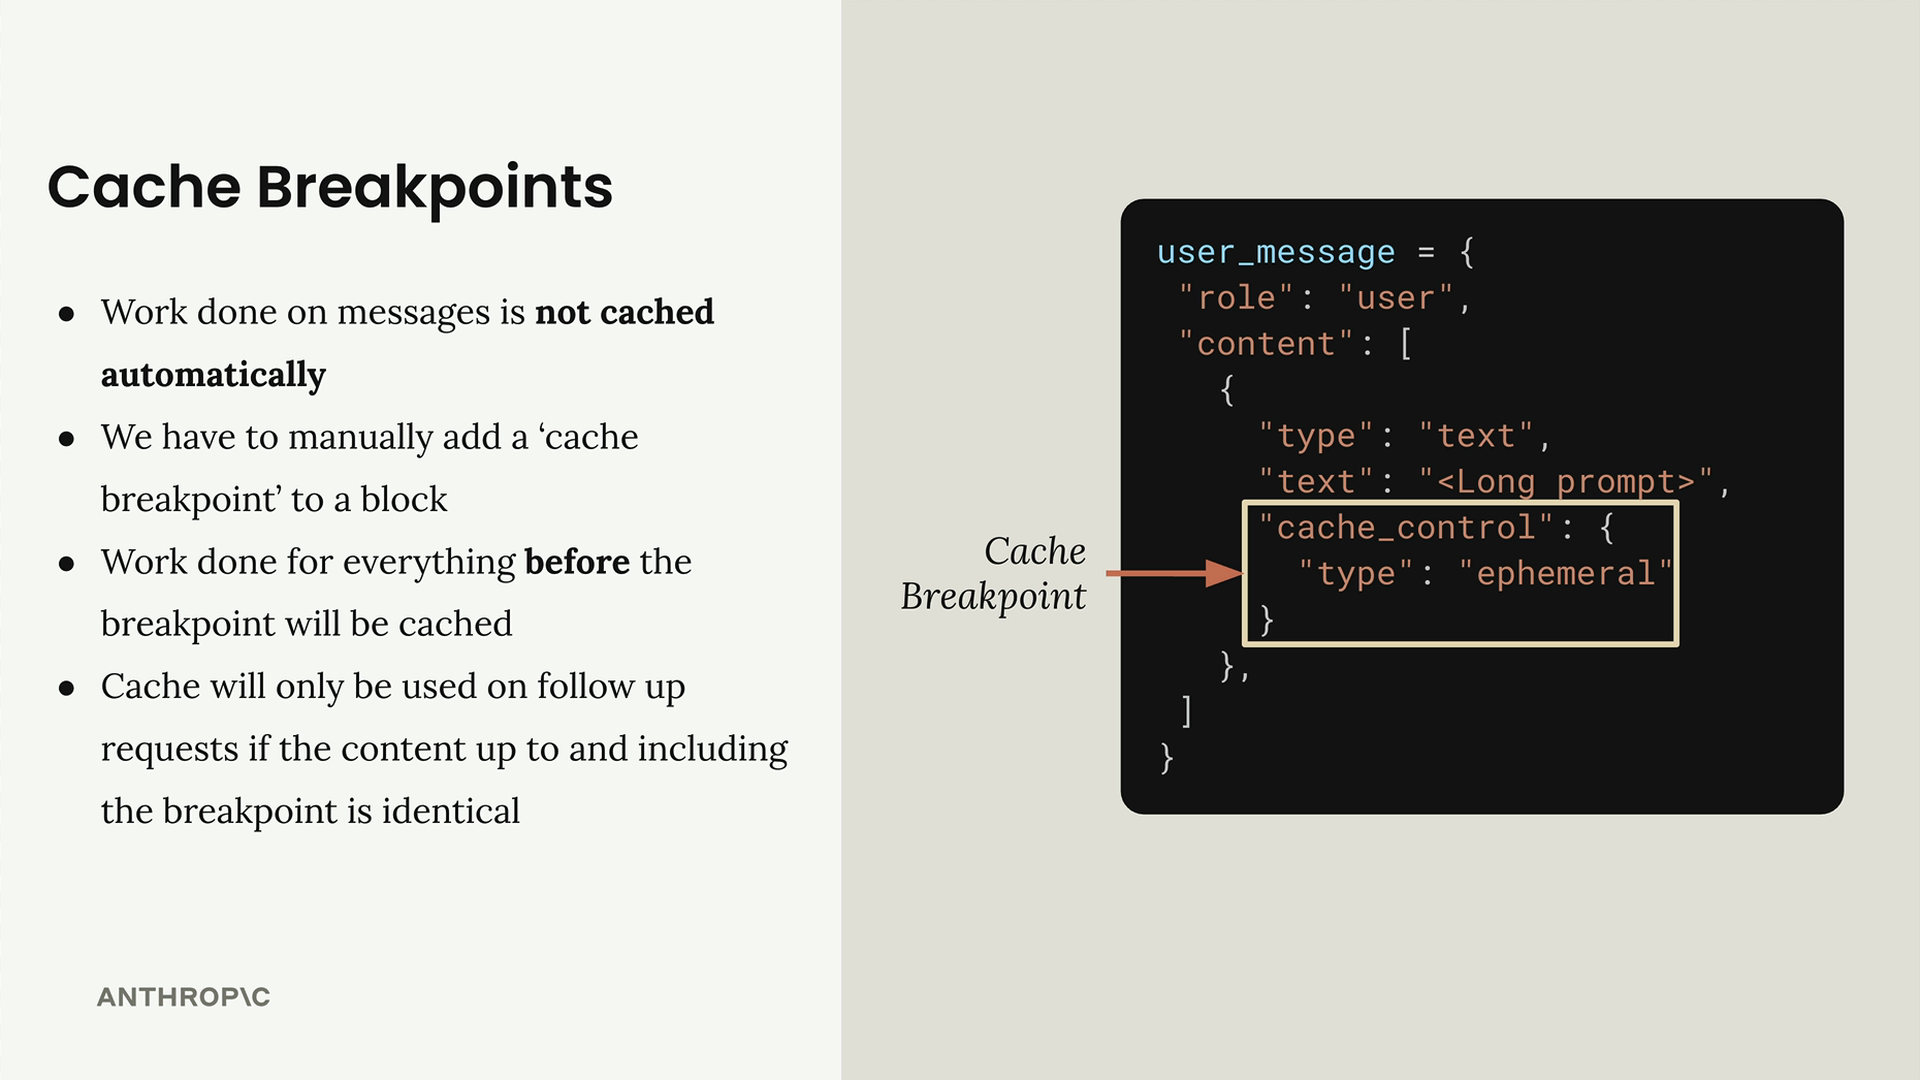
当您需要添加缓存断点时,必须使用编写文本块的长格式,而不是简写形式。以下是两者的区别:
# 简写方式——无法添加缓存断点
user_message = {
  "role": "user",
  "content": "Hi there!"
}

# 完整写法——缓存断点需要此方式
user_message = {
  "role": "user",
  "content": [
    {
      "type": "text",
      "text": "Hi there!",
      "cache_control": {
        "type": "ephemeral"
      }
    }
  ]
}
缓存断点的工作原理
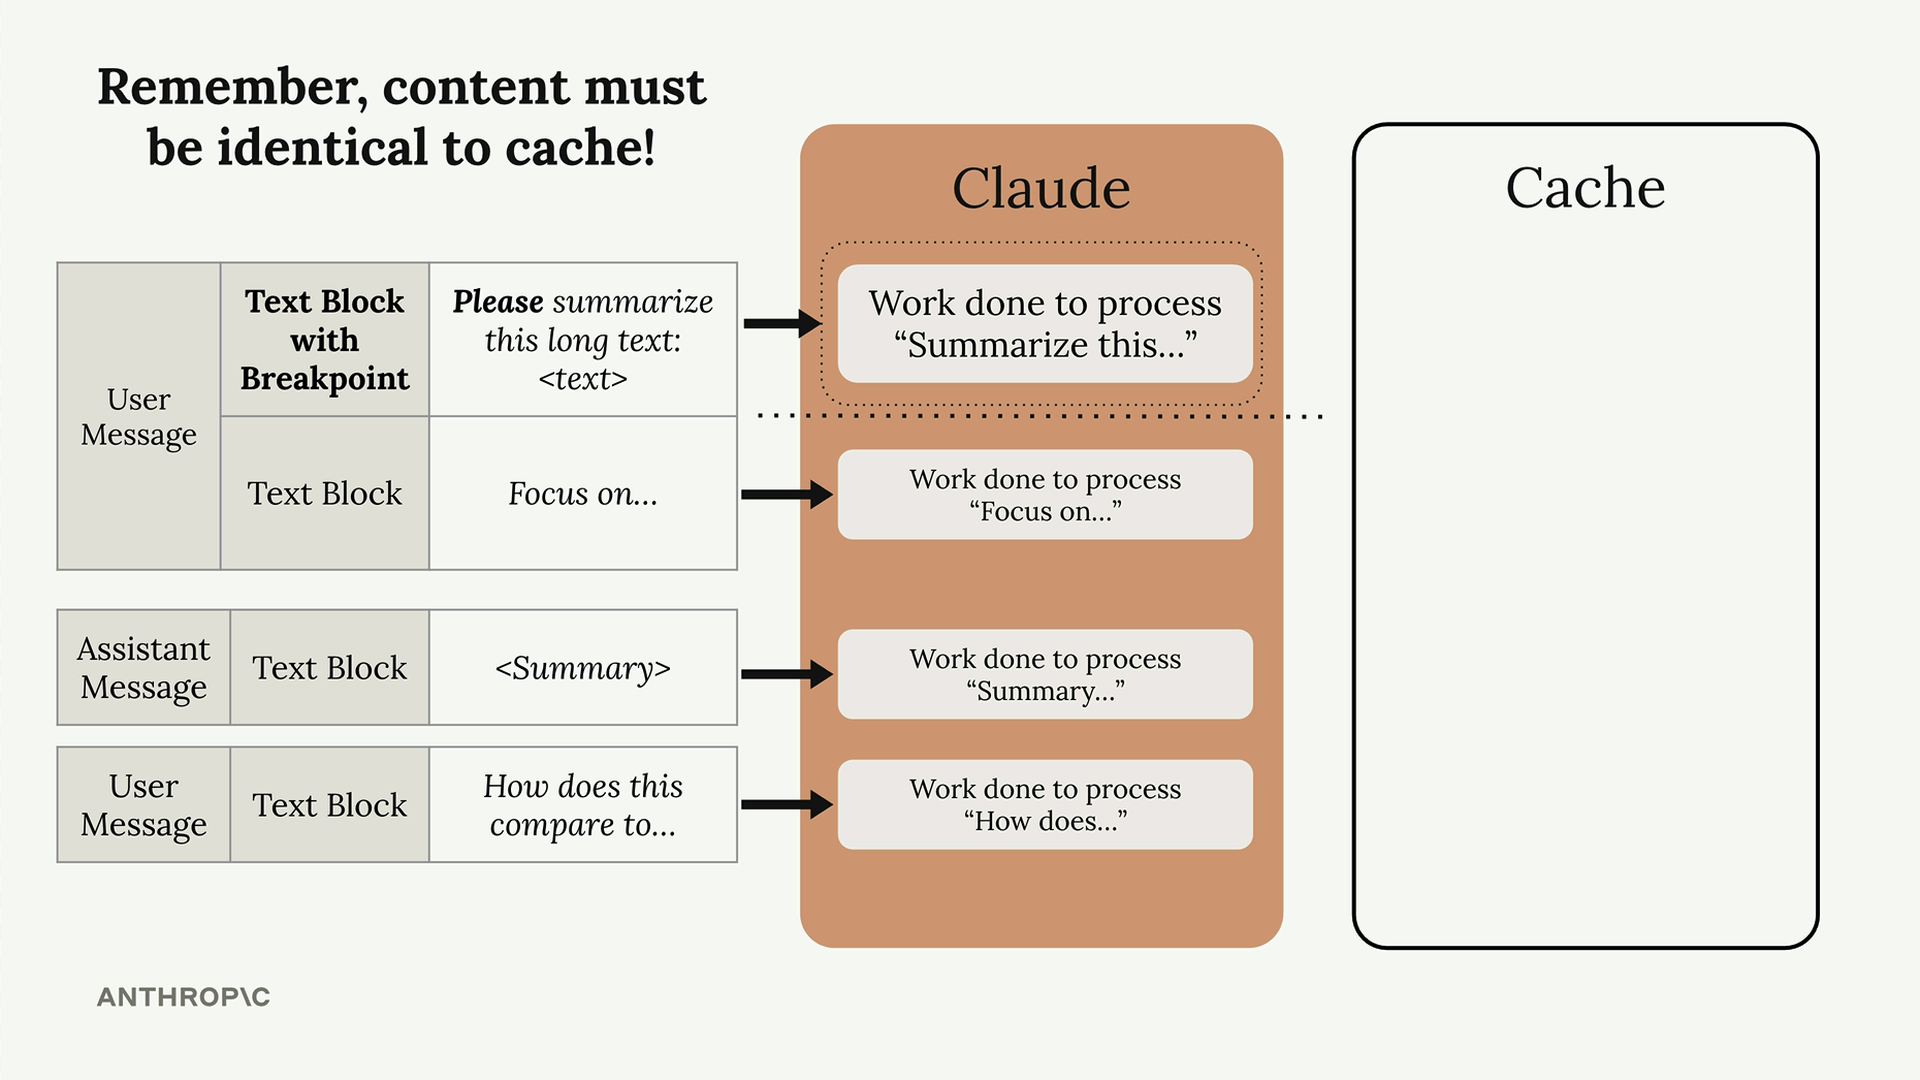
缓存断点跨越多条消息,也可以缓存助手消息。当您放置一个断点时,该点之前的所有内容都会被缓存。请记住,内容必须完全相同才能使用缓存!
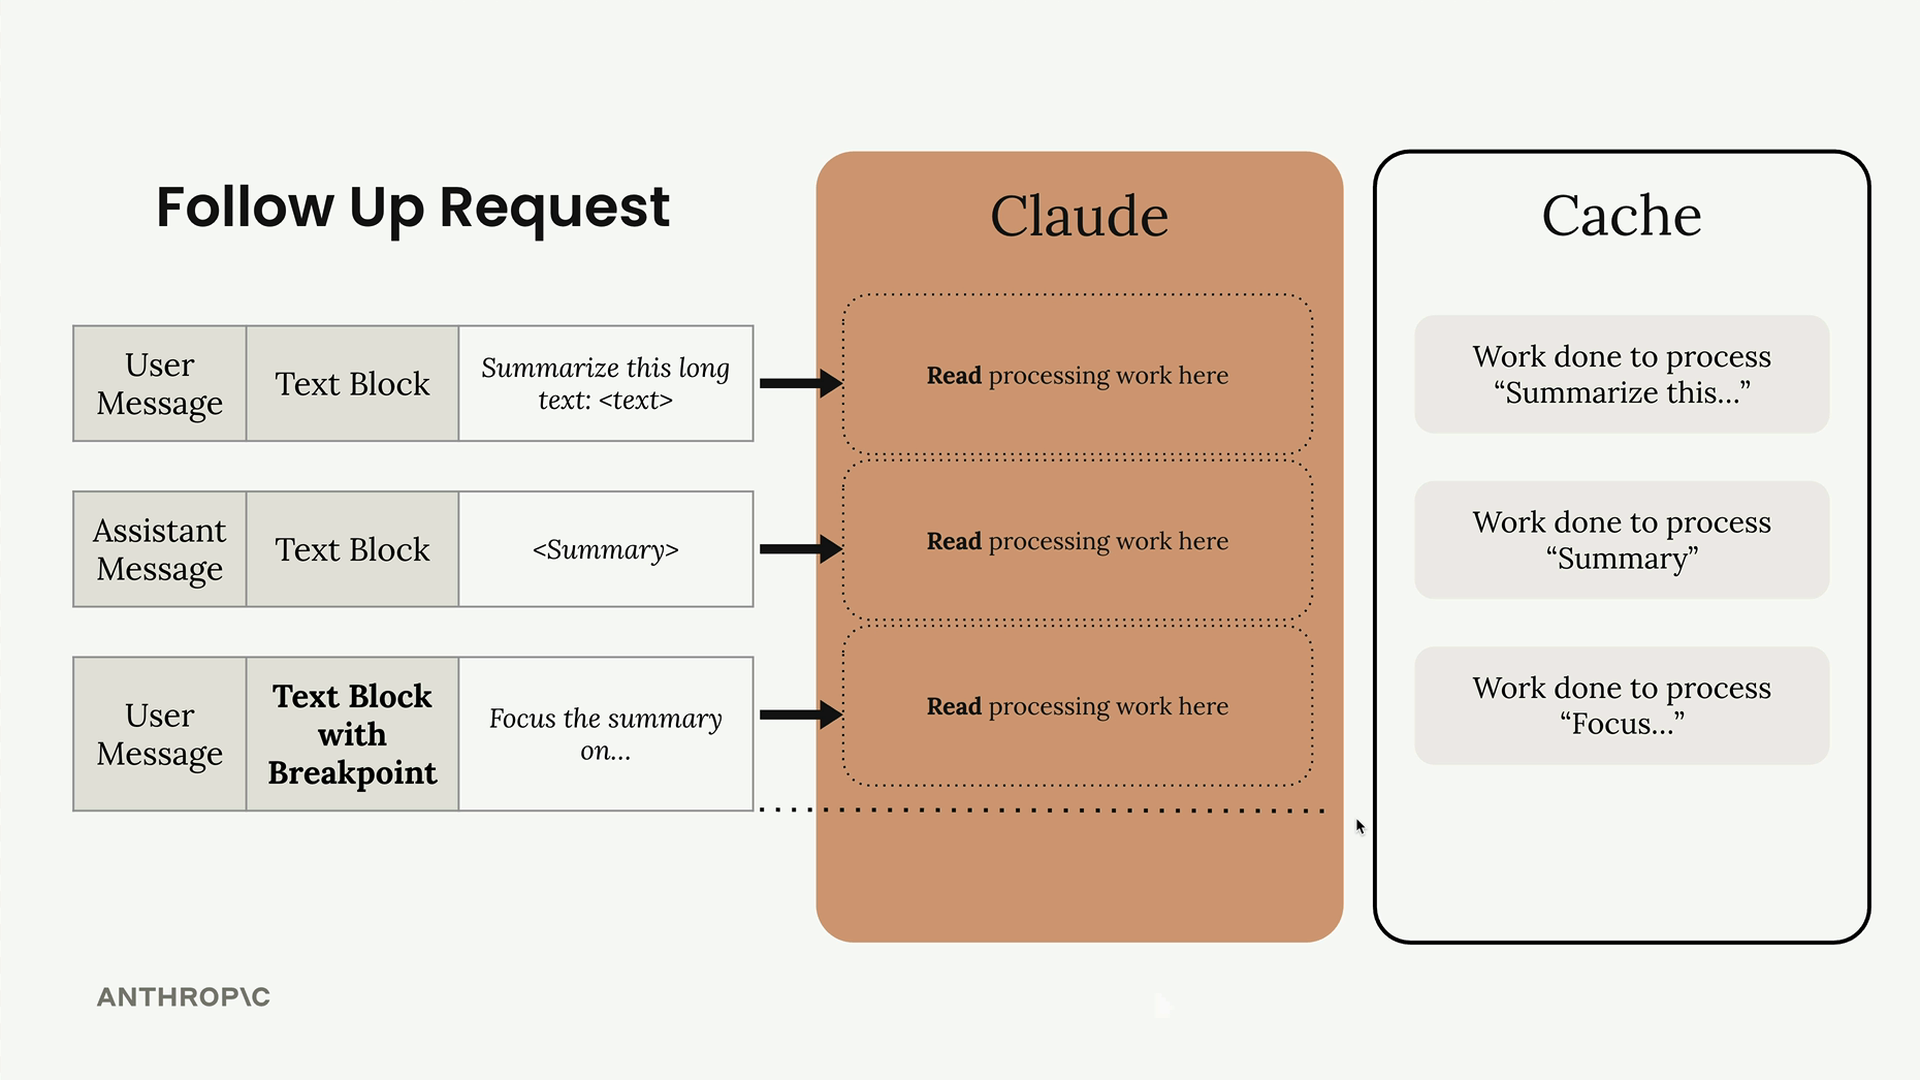
在后续请求中,Claude 会从缓存中读取之前处理过的工作,而不是重新处理它:
断点位置
您不限于只能在文本块上使用断点!您还可以将缓存断点添加到系统提示和工具定义中。实际上,这些是最常见的缓存机会,因为它们在请求之间很少发生变化。
# 带缓存断点的工具定义
tools = [
  add_duration_to_datetime_schema,
  get_current_datetime_schema,
  {
    "name": "set_reminder",
    "description": "Sets a reminder...",
    "input_schema": { ... },
    "cache_control": {"type": "ephemeral"}
  }
]

# 带缓存断点的系统提示
system = [
  {
    "type": "text",
    "text": "You are a senior software...",
    "cache_control": {"type": "ephemeral"}
  }
]
缓存顺序
在幕后,当输入 Claude 时,工具、系统提示和消息会按照这个特定顺序拼接在一起。这会影响缓存断点的工作方式。
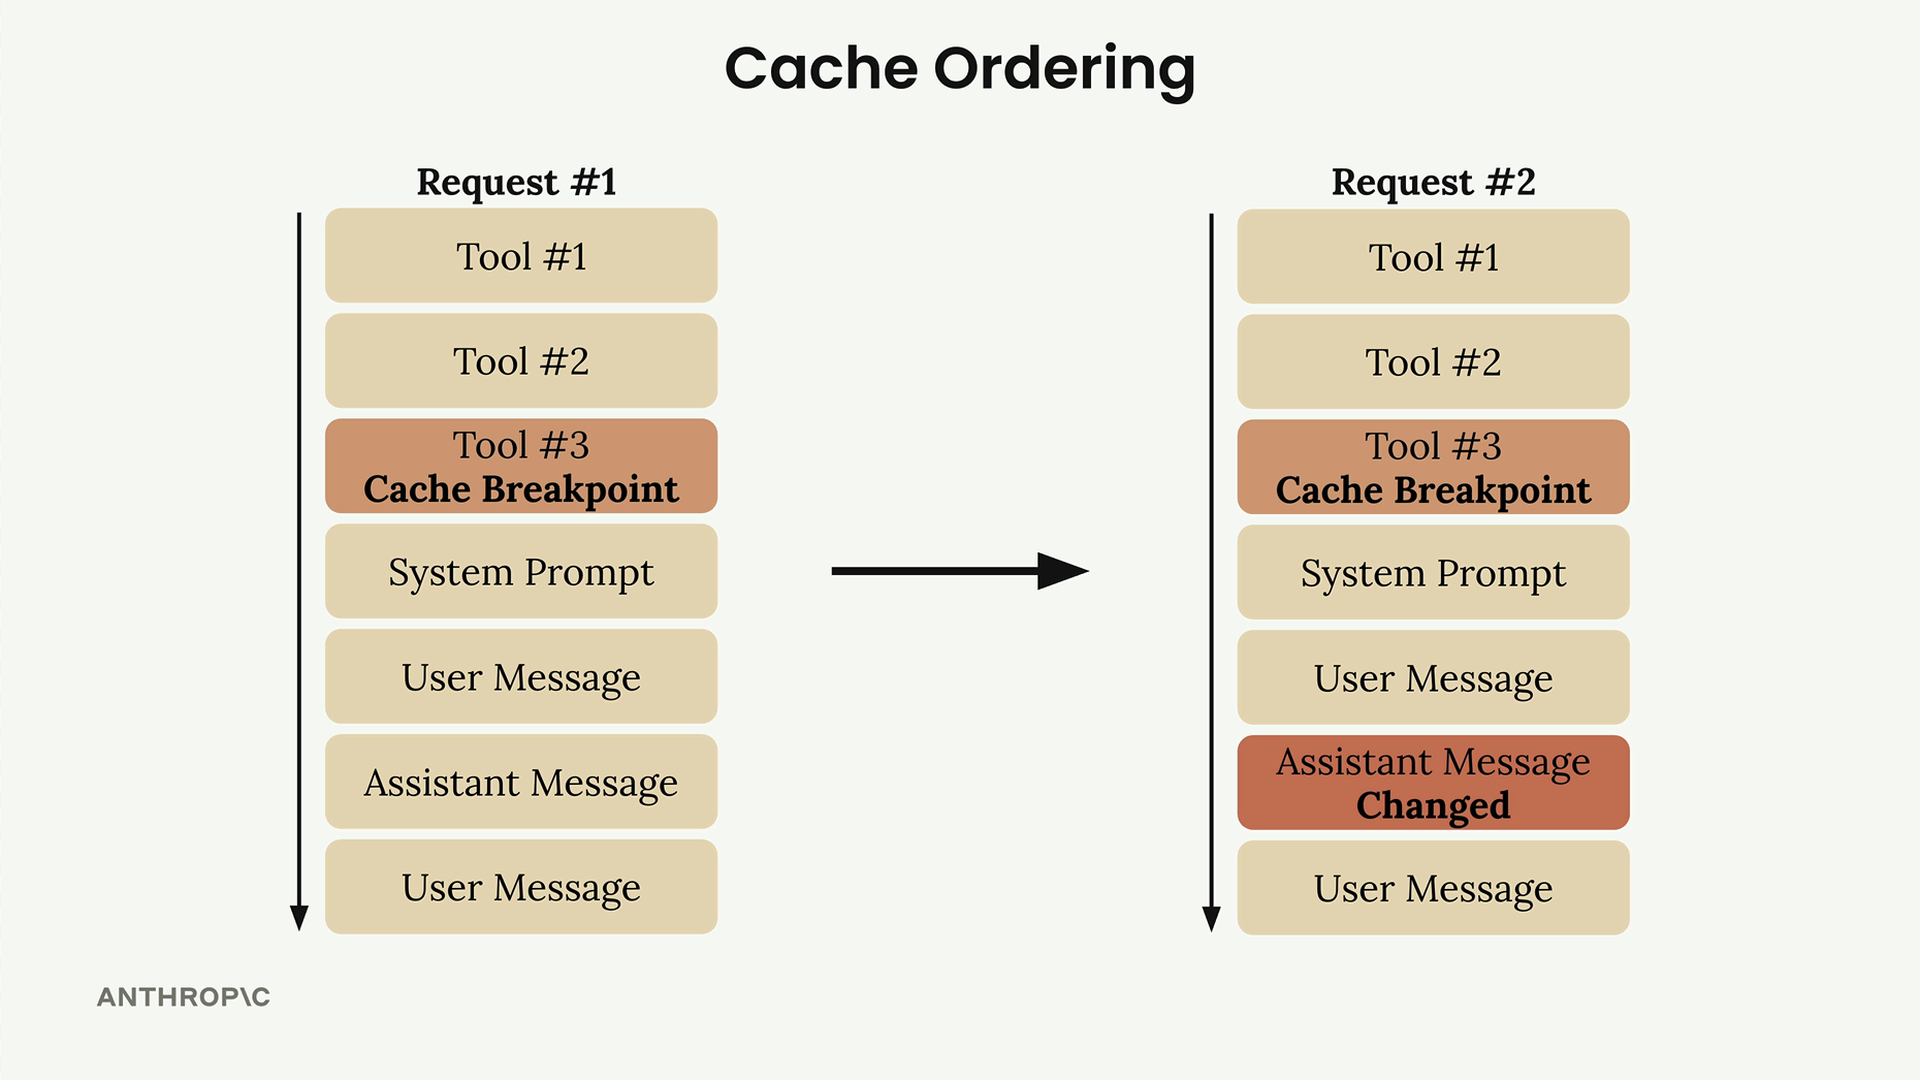
您最多可以添加四个缓存断点。如果您将断点放在最后一个工具上,那么截至该工具为止的所有内容都会被缓存,但系统提示和消息不会被缓存。这使您能够根据应用程序中发生变化的内容,细粒度地控制哪些内容会被缓存。
最小内容长度
缓存存在一个最小长度限制,这取决于所使用的模型。对于本课程所使用的模型 Claude Haiku 4.5,内容必须至少达到 4,096 个 token 才能被缓存。这是您尝试缓存的所有消息和块的总和,而不是单个块的长度。
像"你好!"这样的消息实在太短,无法被缓存,但一个真正很长的提示则能达到最小长度要求。低于最小长度的内容只会被正常处理而不会被缓存,并且不会返回任何错误。要判断是否发生了缓存,可以查看响应中的用量信息:cache_creation_input_tokens 和 cache_read_input_tokens 都会是 0。
有效使用提示缓存的关键在于识别您请求中保持一致的部分——通常是您的系统提示和工具定义——并通过策略性地放置断点,在最大化缓存命中的同时尽量减少重新处理。