加载中
在构建提示评估工作流程时,评分系统可以提供关于输出质量的客观信号。评分器会获取模型输出,并返回某种可衡量的反馈——通常是 1 到 10 之间的一个数字,其中 10 代表高质量,1 代表质量不佳。
评分器的类型
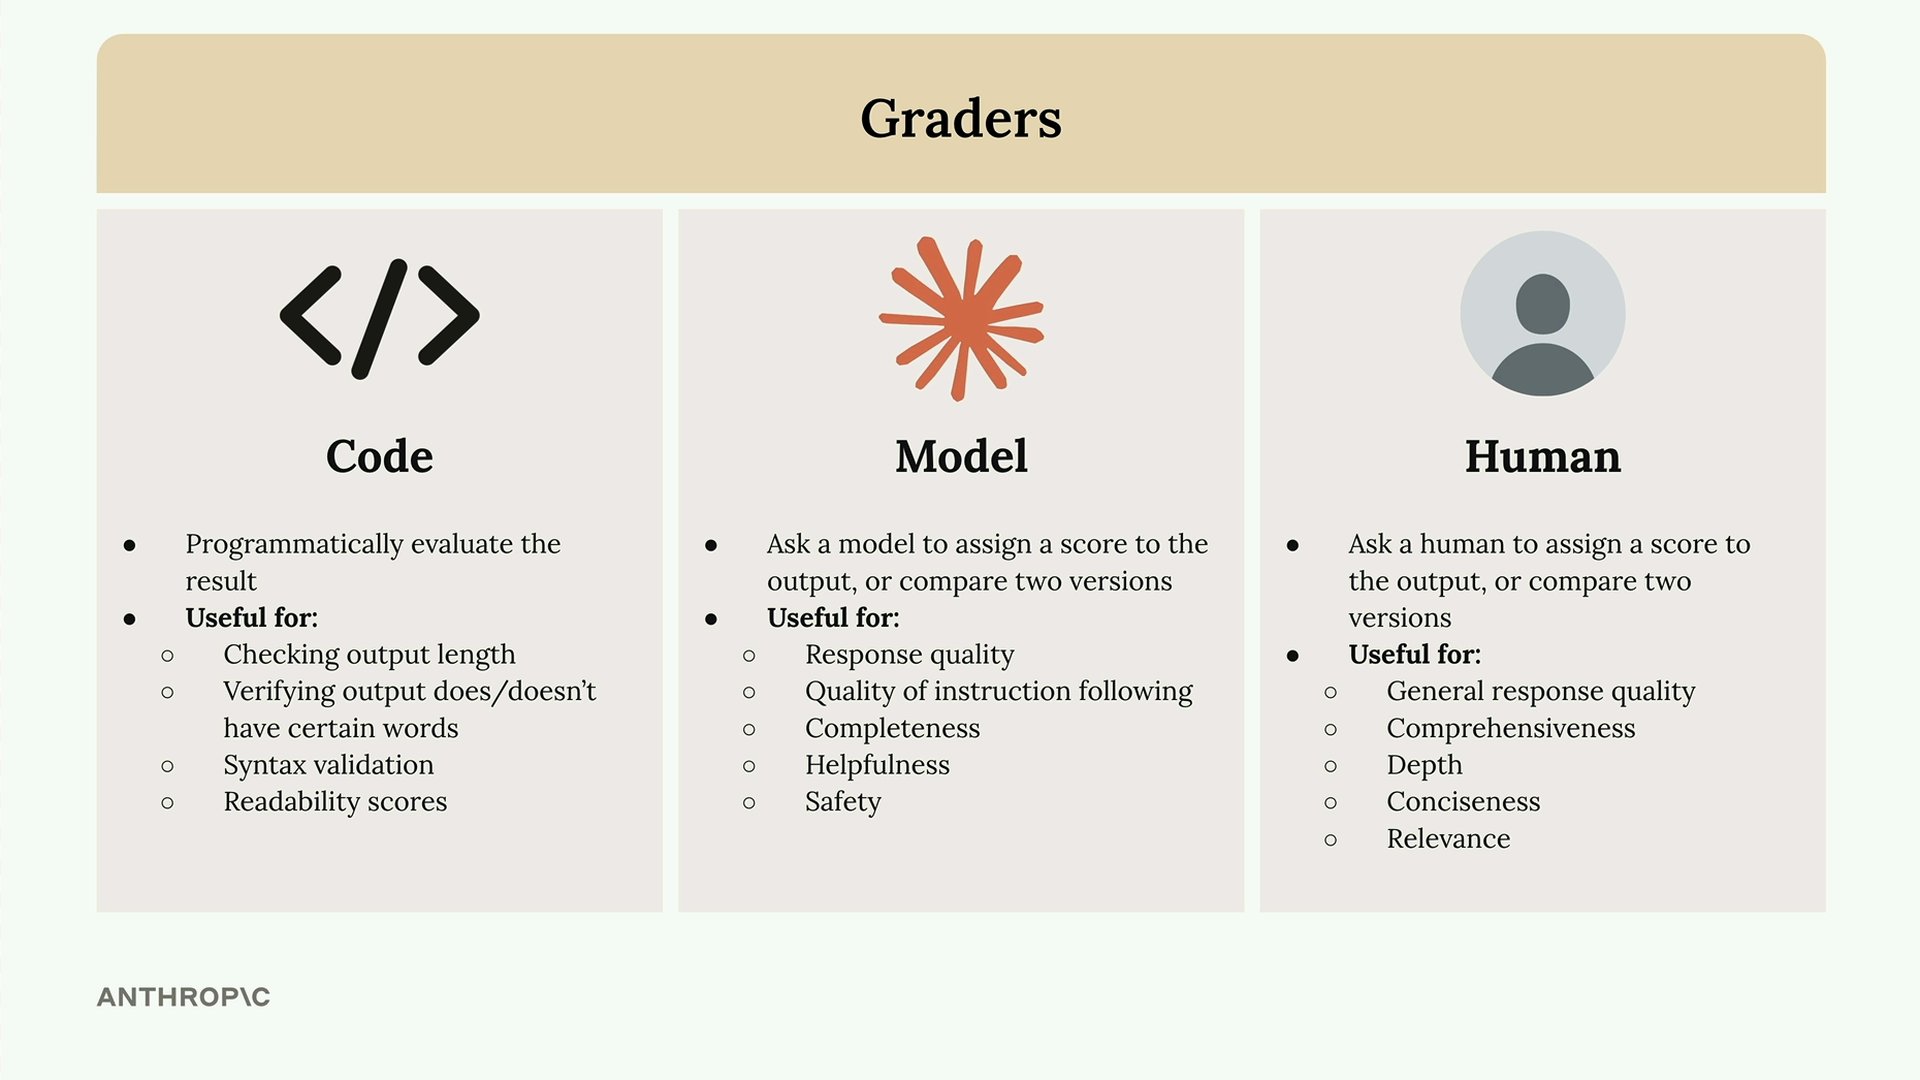
评估模型输出主要有三种方法:
- 代码评分器(Code graders) - 使用自定义代码以编程方式评估输出
- 模型评分器(Model graders) - 使用另一个 AI 模型来评估质量
- 人工评分器(Human graders) - 由人工手动审查并打分
代码评分器
代码评分器让您可以实现您能想到的任何程序化检查。常见用途包括:
- 检查输出长度
- 验证输出是否包含或不包含某些词语
- 对 JSON、Python 或正则表达式进行语法验证
- 可读性评分,以确保适当的阅读难度水平
模型评分器
模型评分器通过额外的一次 API 调用来评估输出,提供了极大的灵活性。它们适用于评估:
- 响应质量
- 指令遵循的质量
- 完整性
- 有帮助性
- 安全性
人工评分器
人工评分器提供了最大的灵活性,但也伴随着明显的弊端。虽然人类可以根据任何可以想到的标准来评估回应,但这个过程耗时且繁琐。
定义评估标准
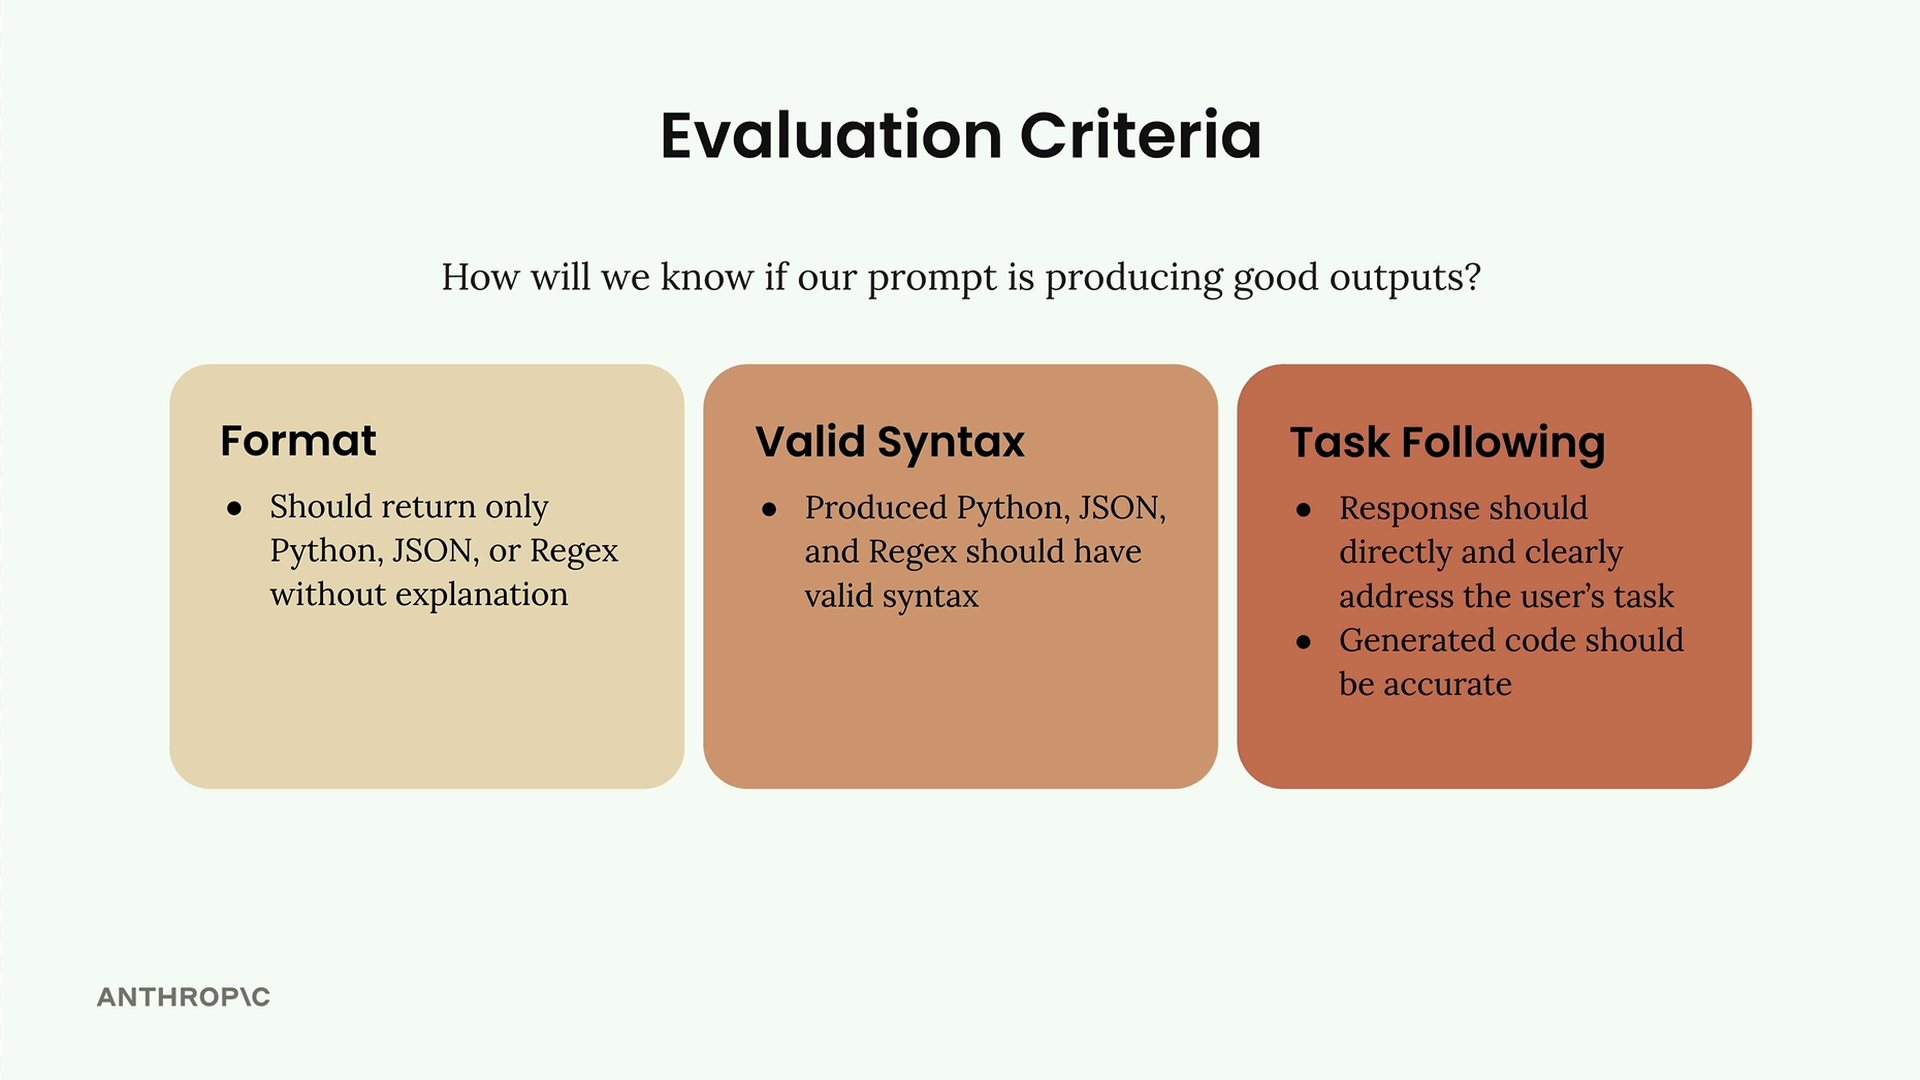
在实现任何评分器之前,您需要明确的评估标准。对于代码生成提示,您可能会关注以下几点:
- 格式 - 应仅返回 Python、JSON 或正则表达式,不带解释说明
- 有效语法 - 生成的代码应具有有效的语法
- 任务遵循 - 响应应直接针对用户的任务给出准确的代码
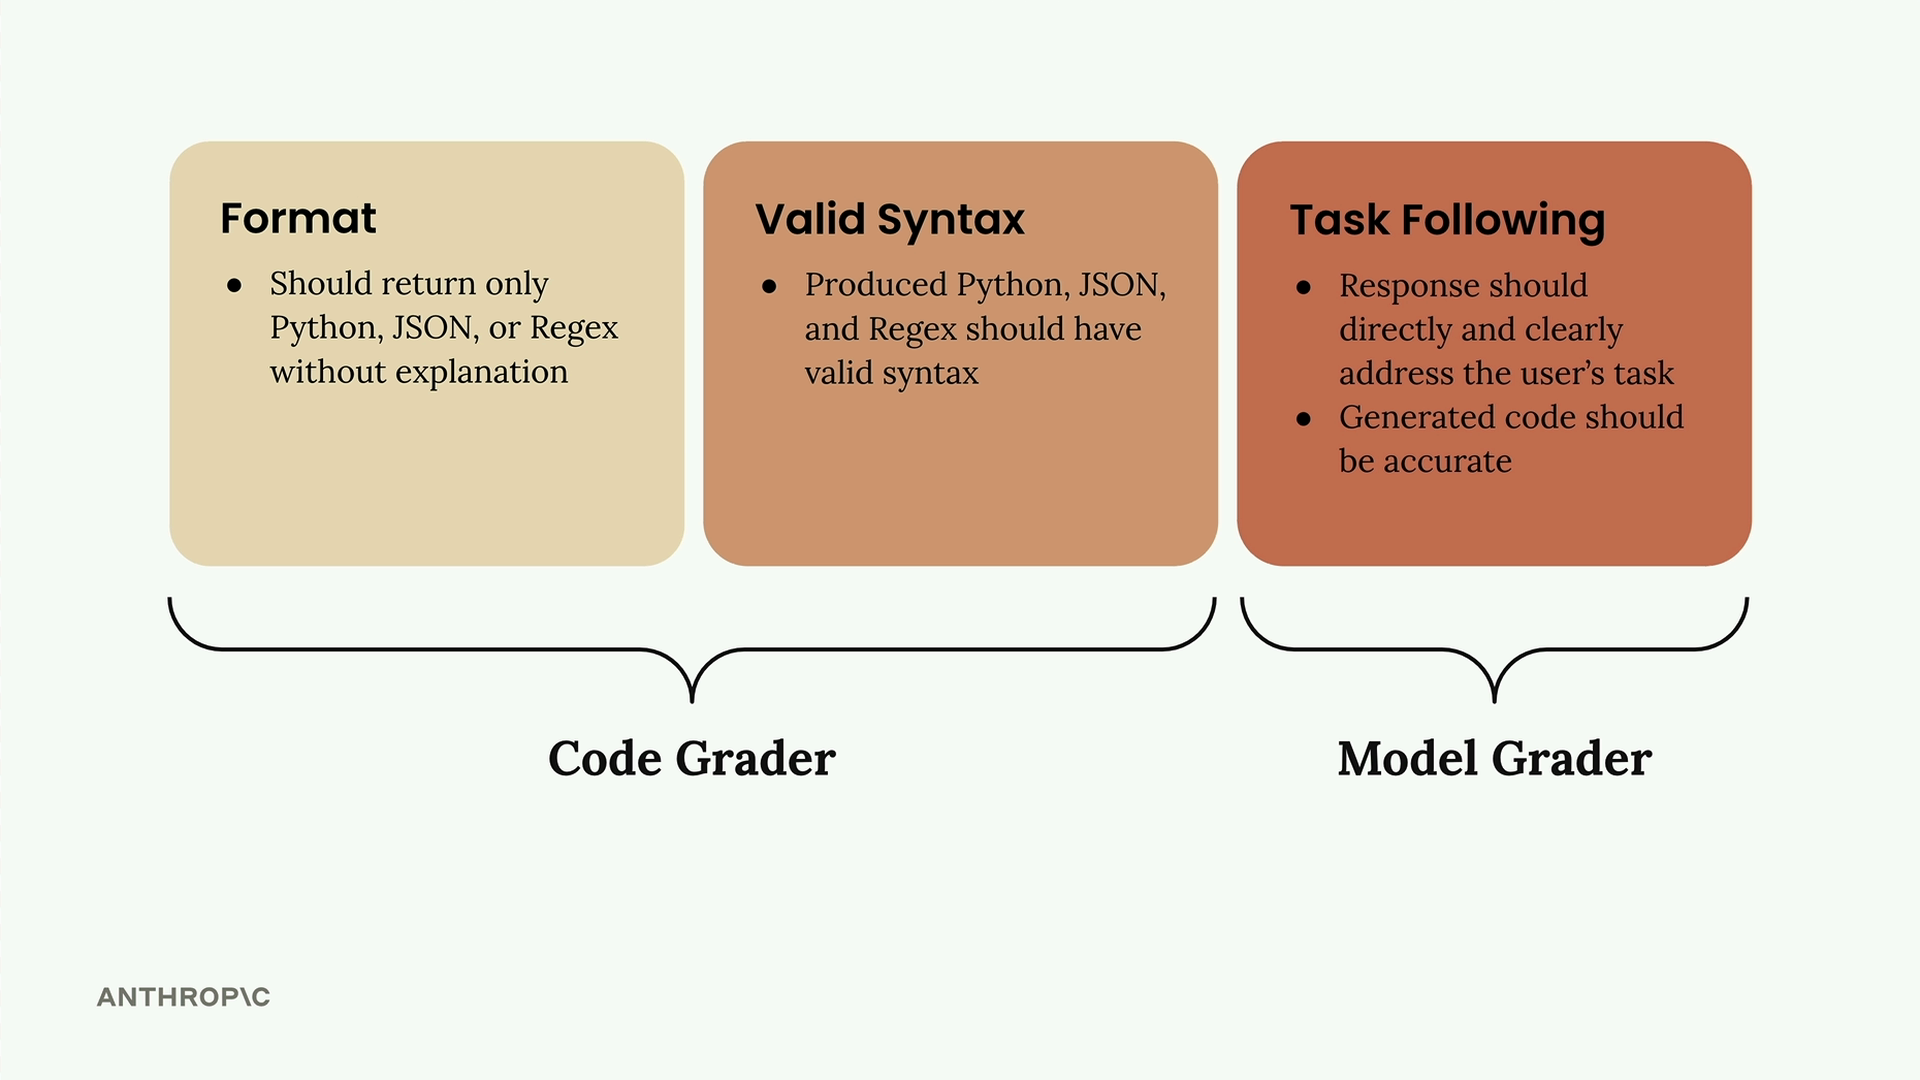
前两个标准非常适合代码评分器,而任务遵循由于其灵活性,更适合使用模型评分器。
实现一个模型评分器
模型评分器往往是最容易实现的。以下是一个基本结构:
python
def grade_by_model(test_case, output):
    eval_prompt = f"""
    You are an expert code reviewer. Evaluate this AI-generated solution.

    Task: {test_case["task"]}
    Solution: {output}

    Provide your evaluation as a structured JSON object with:
    - "strengths": An array of 1-3 key strengths
    - "weaknesses": An array of 1-3 key areas for improvement
    - "reasoning": A concise explanation of your assessment
    - "score": A number between 1-10
    """

    messages = []
    add_user_message(messages, eval_prompt)
    add_assistant_message(messages, "```json")
    eval_text = chat(messages, stop_sequences=["```"])
    return json.loads(eval_text)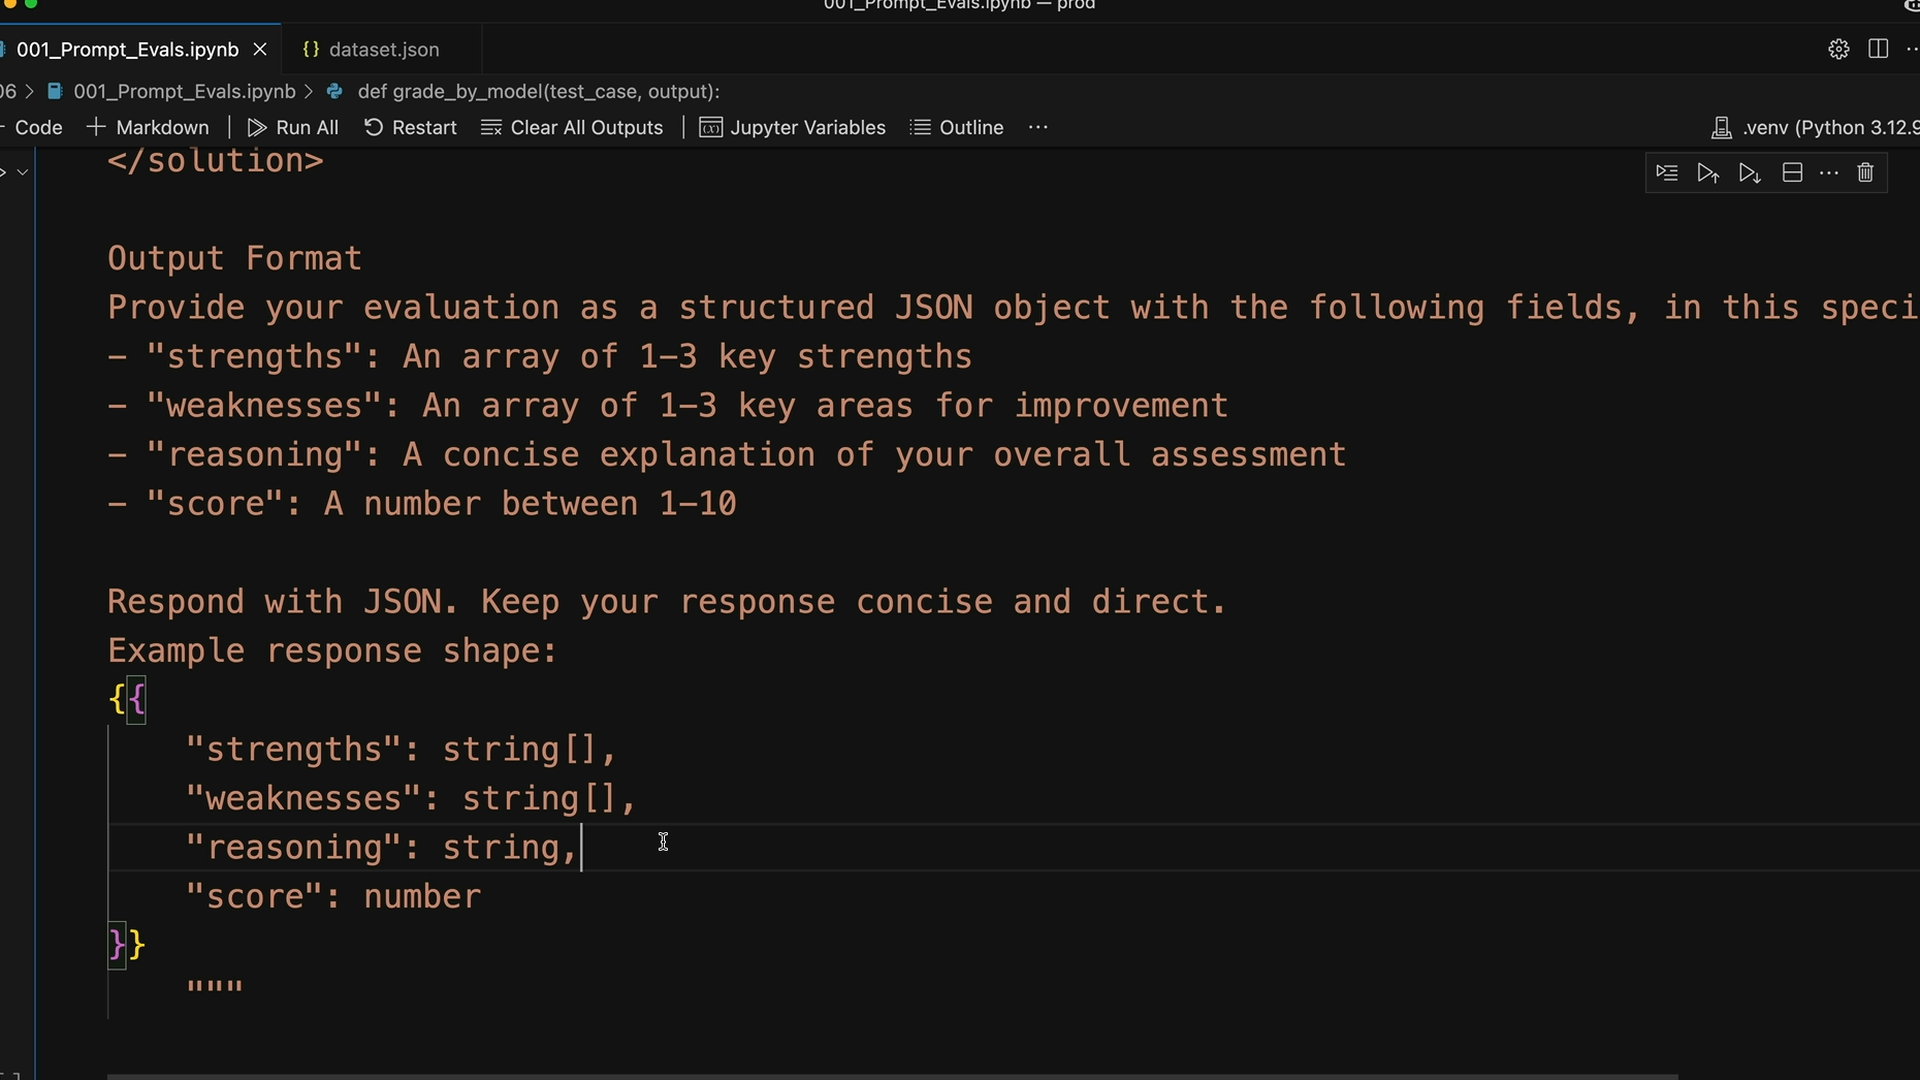
评分提示应当全面,并包含以下内容:
- 对评分器角色的清晰定义
- 原始任务
- 待评估的 AI 生成解决方案
- 具体的输出格式要求
不要只要求一个分数。在给出数字分数的同时,要求提供优点、缺点和推理过程。这可以防止模型默认给出诸如 6 分之类平庸的分数,并促使它进行更深思熟虑的评估。
将评分器集成到您的工作流程中
一旦您有了一个评分器函数,就可以将其集成到您的测试用例运行器中:
python
def run_test_case(test_case):
    output = run_prompt(test_case)

    # 调用模型评分器
    model_grade = grade_by_model(test_case, output)
    score = model_grade["score"]
    reasoning = model_grade["reasoning"]

    return {
        "output": output,
        "test_case": test_case,
        "score": score,
        "reasoning": reasoning
    }
在运行完所有测试用例后,计算一个平均分数,以获得衡量提示性能的客观指标:
python
from statistics import mean

def run_eval(dataset):
    results = []
    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    average_score = mean([result["score"] for result in results])
    print(f"Average score: {average_score}")

    return results
这为您提供了一个具体的数字,可以据此着手改进。虽然模型评分器有时可能有些反复无常,可能需要更好的引导,但它们为客观评估提供了一个起点,您可以在此基础上反复迭代和改进。