문서에서 텍스트 청크를 추출한 후, RAG 파이프라인의 다음 단계는 사용자의 질문과 가장 관련성이 높은 청크를 찾는 것입니다. 이는 본질적으로 검색 문제입니다. 모든 청크를 살펴보고 사용자가 묻고 있는 내용과 관련된 것을 식별해야 합니다.
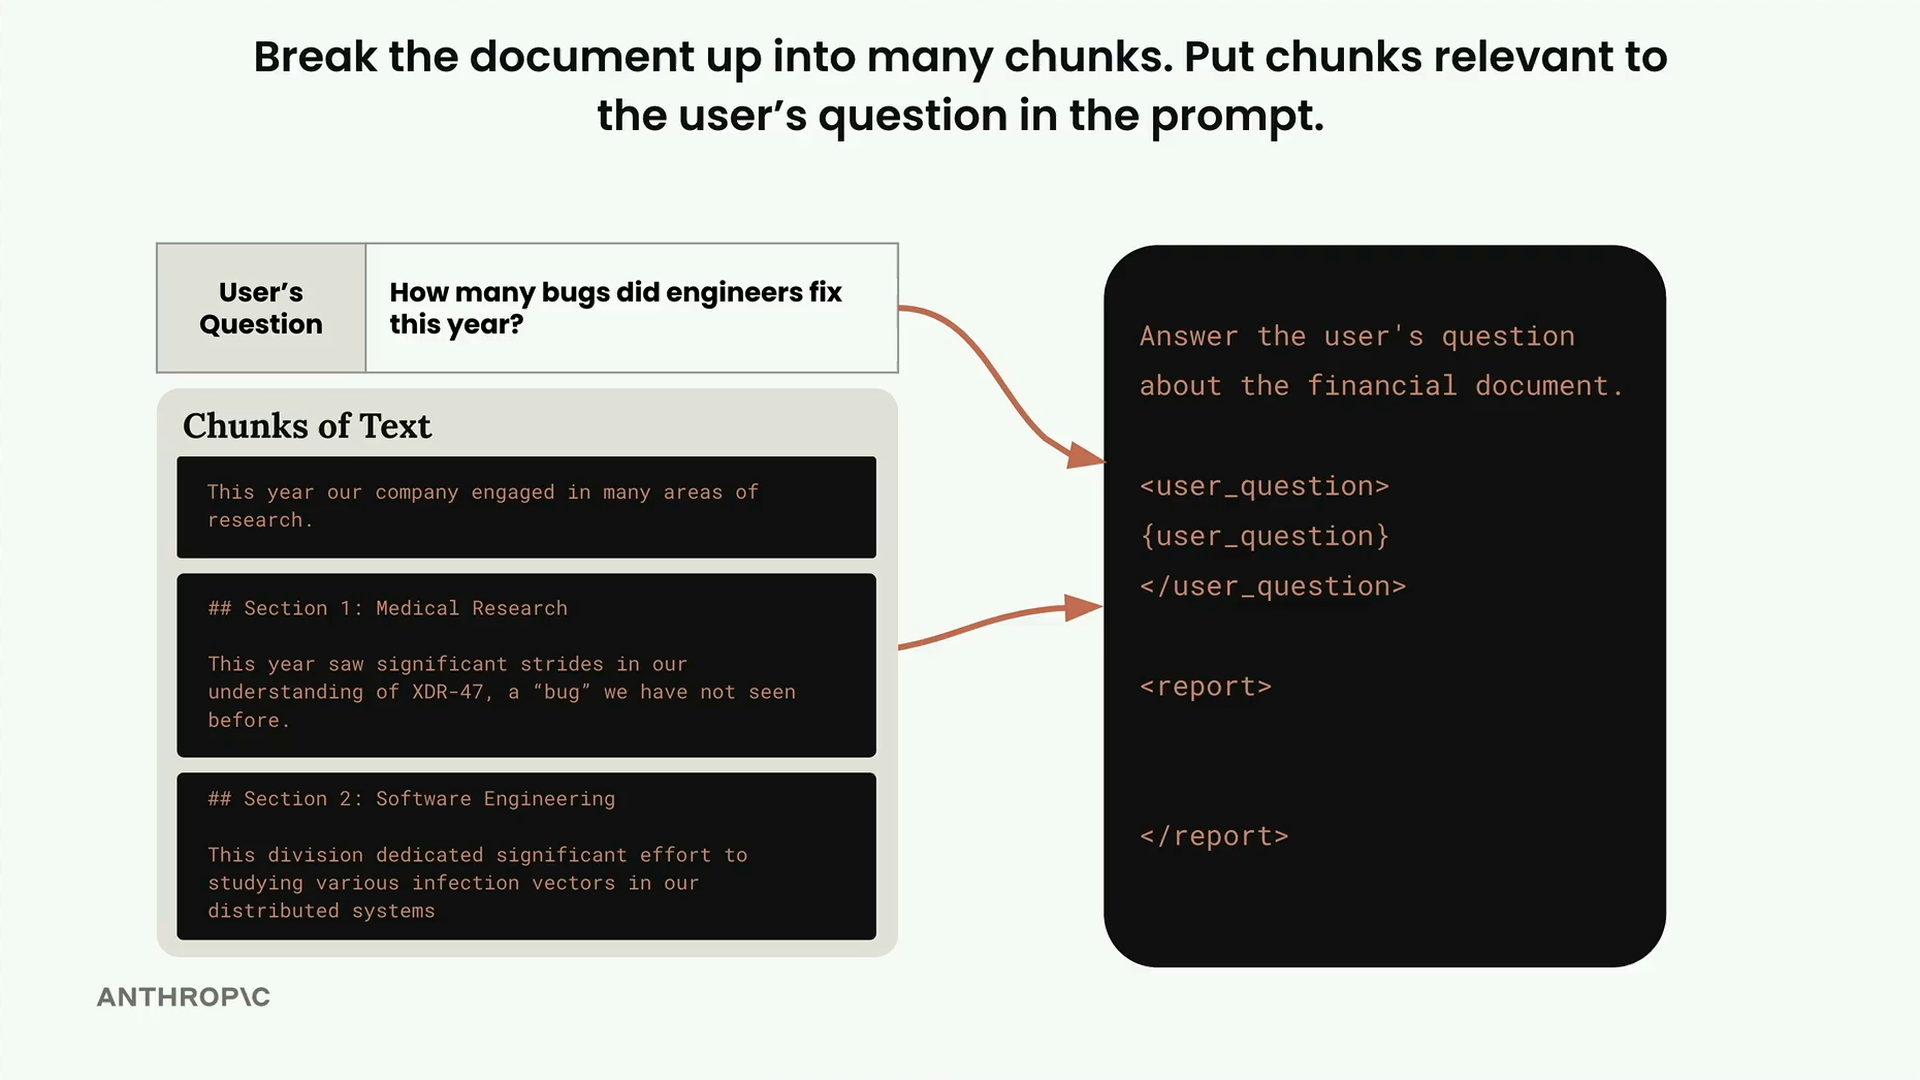
시맨틱 검색
관련 청크를 찾는 가장 일반적인 접근 방식은 시맨틱 검색입니다. 전통적인 키워드 기반 검색과 달리, 시맨틱 검색은 텍스트 임베딩을 사용하여 사용자의 질문과 각 텍스트 청크의 실제 의미를 이해합니다. 이를 통해 정확한 단어가 일치하지 않더라도 개념적으로 관련된 콘텐츠를 찾을 수 있습니다.
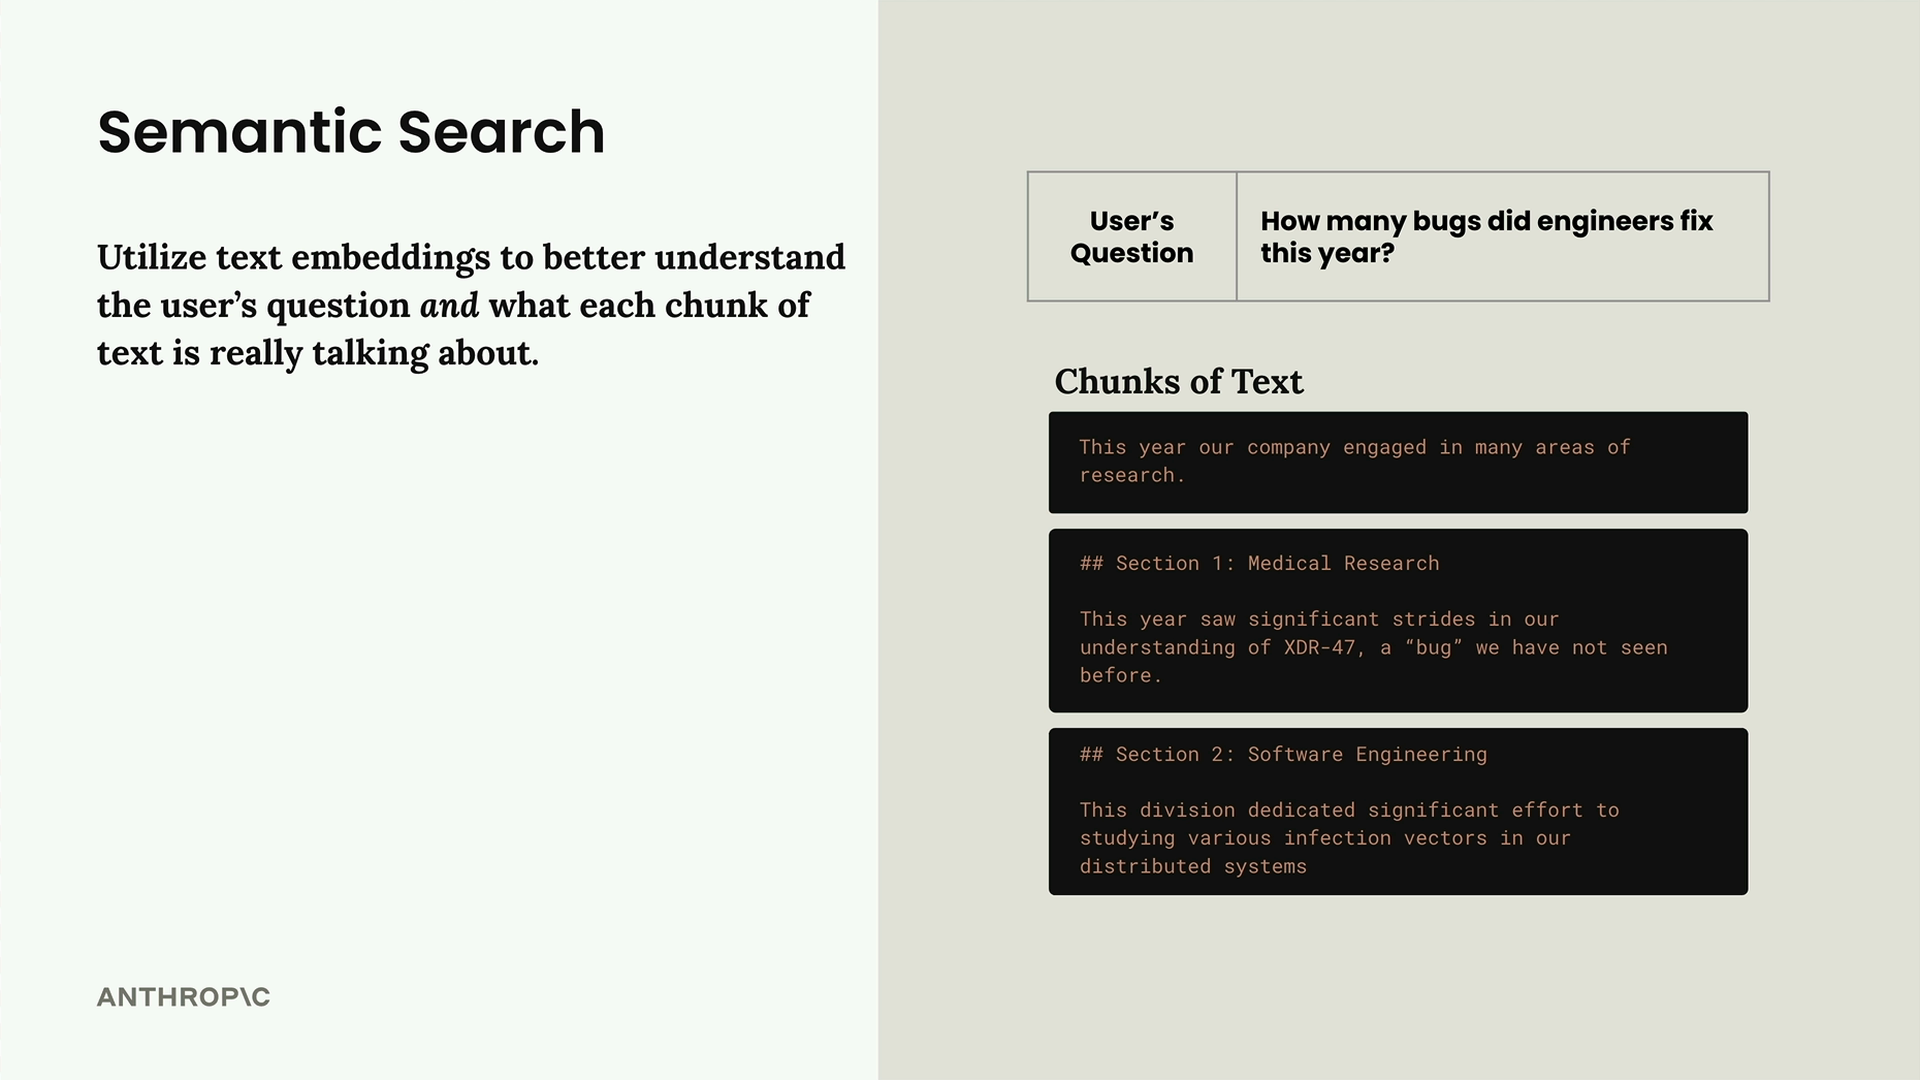
텍스트 임베딩이란 무엇인가요?
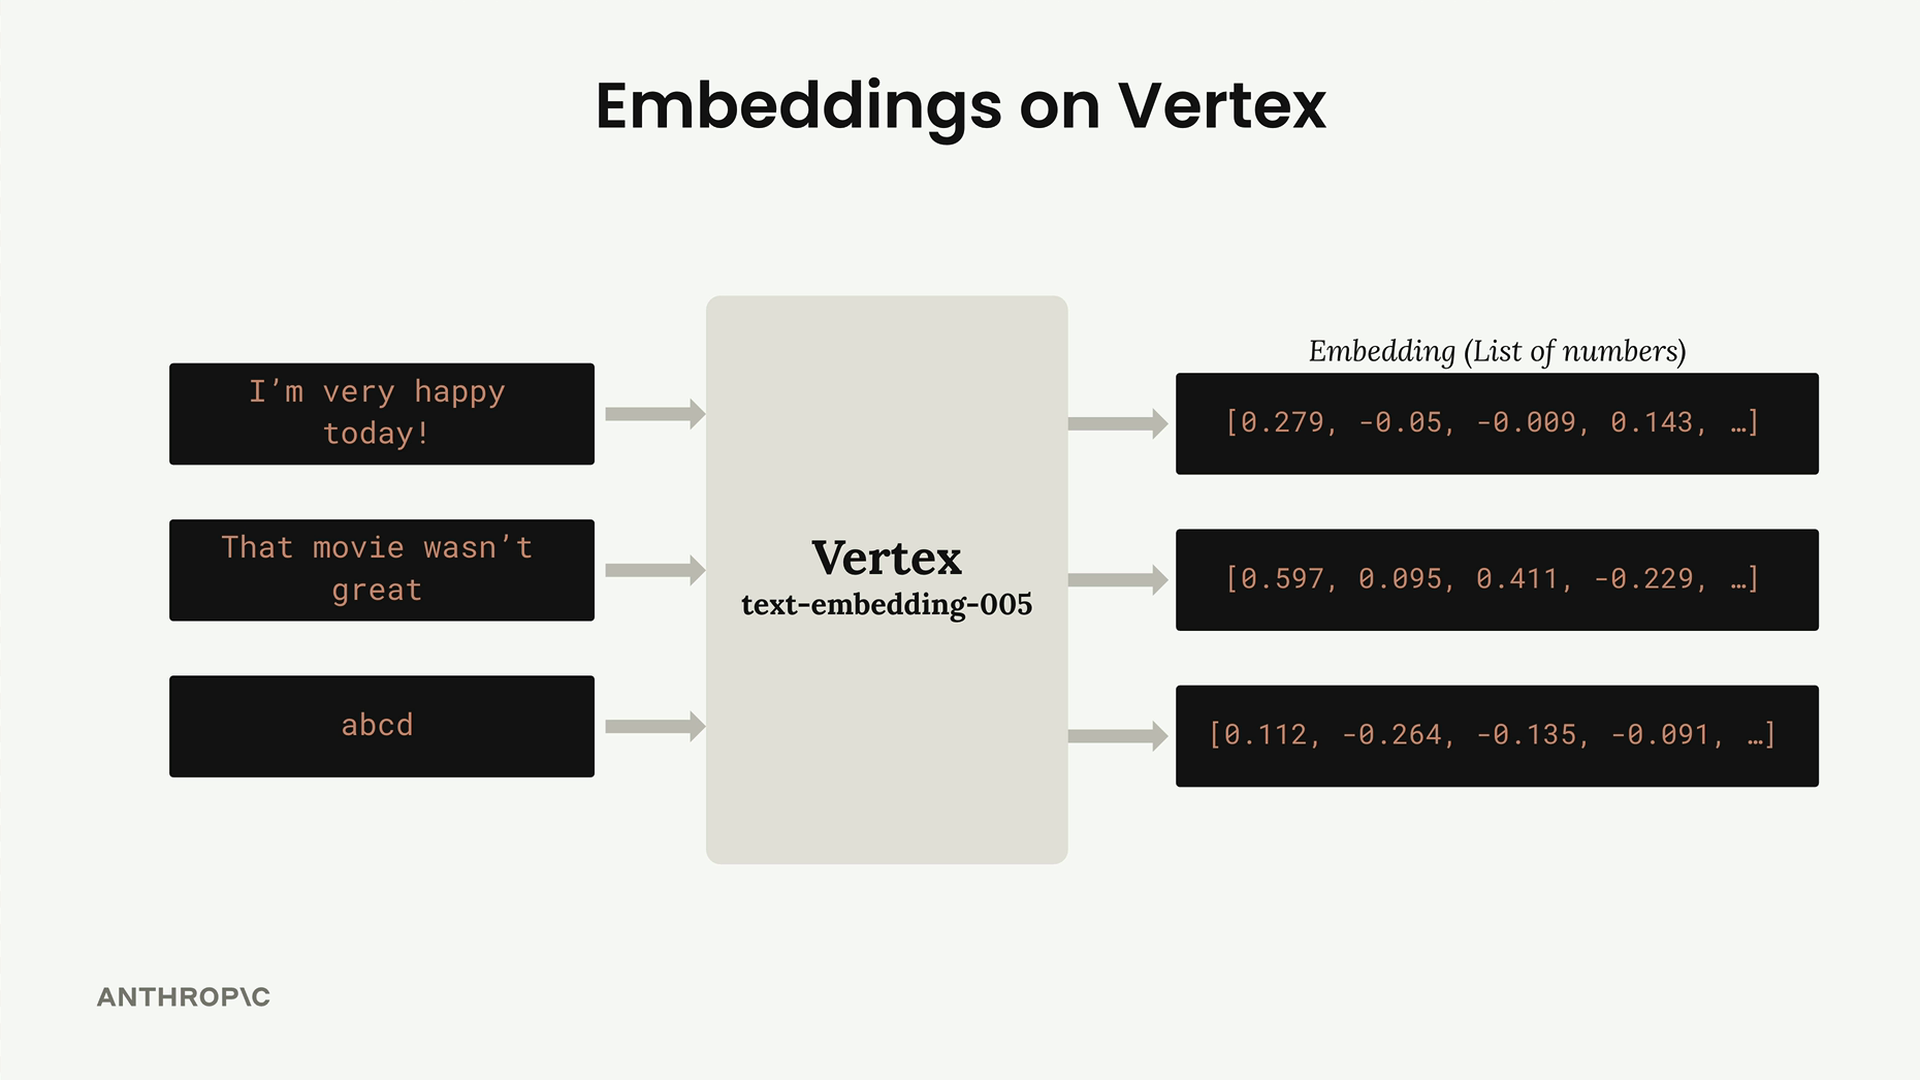
텍스트 임베딩은 어떤 텍스트에 담긴 의미를 수치로 표현한 것입니다. 단어와 문장을 컴퓨터가 수학적으로 처리할 수 있는 형식으로 변환한다고 생각하면 됩니다.
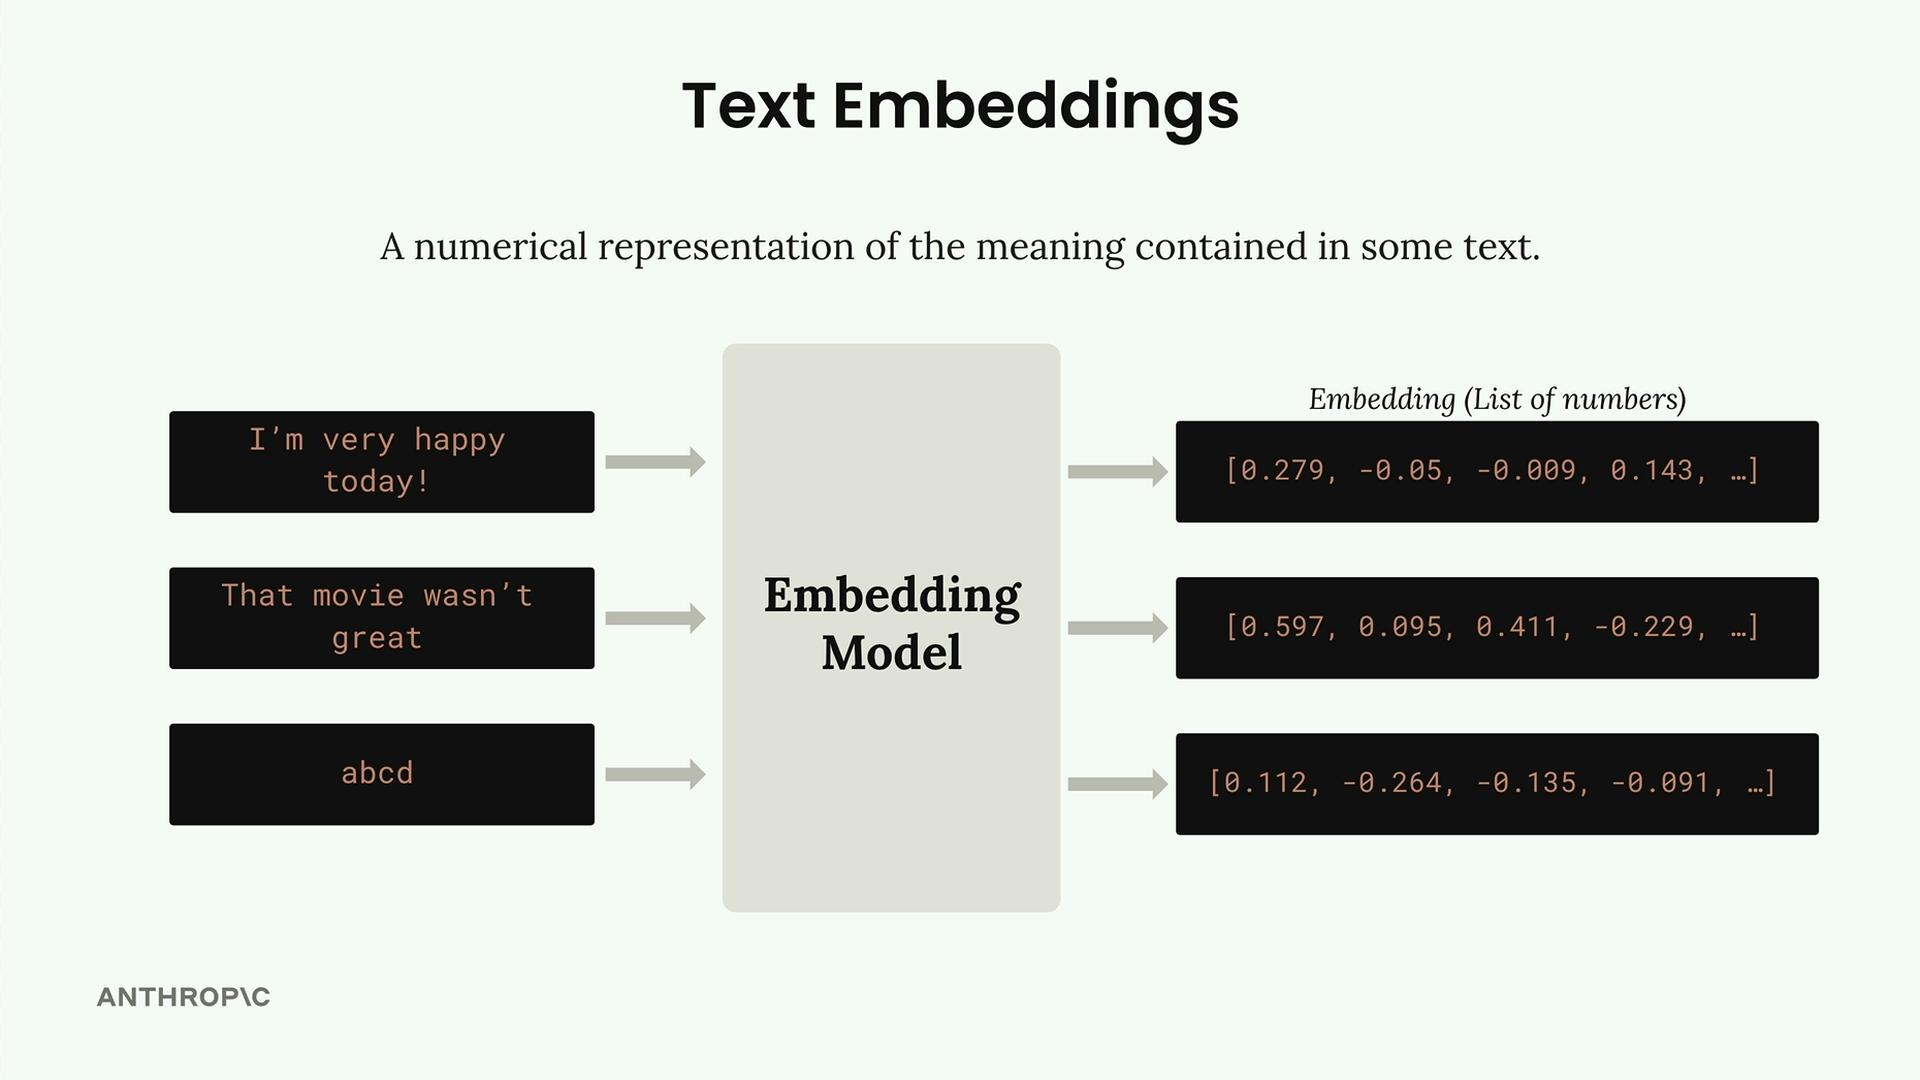
과정은 다음과 같이 진행됩니다:
- 텍스트를 임베딩 모델에 입력합니다
- 모델은 긴 숫자 목록(임베딩)을 출력합니다
- 각 숫자는 -1에서 +1 사이의 범위를 가집니다
- 이 숫자들은 입력 텍스트의 다양한 특성이나 특징을 나타냅니다
숫자 이해하기
임베딩의 각 숫자는 본질적으로 입력 텍스트의 어떤 특성에 대한 "점수"입니다. 하지만 여기서 중요한 주의사항이 있습니다. 우리는 각 숫자가 구체적으로 무엇을 나타내는지 실제로는 알지 못합니다.
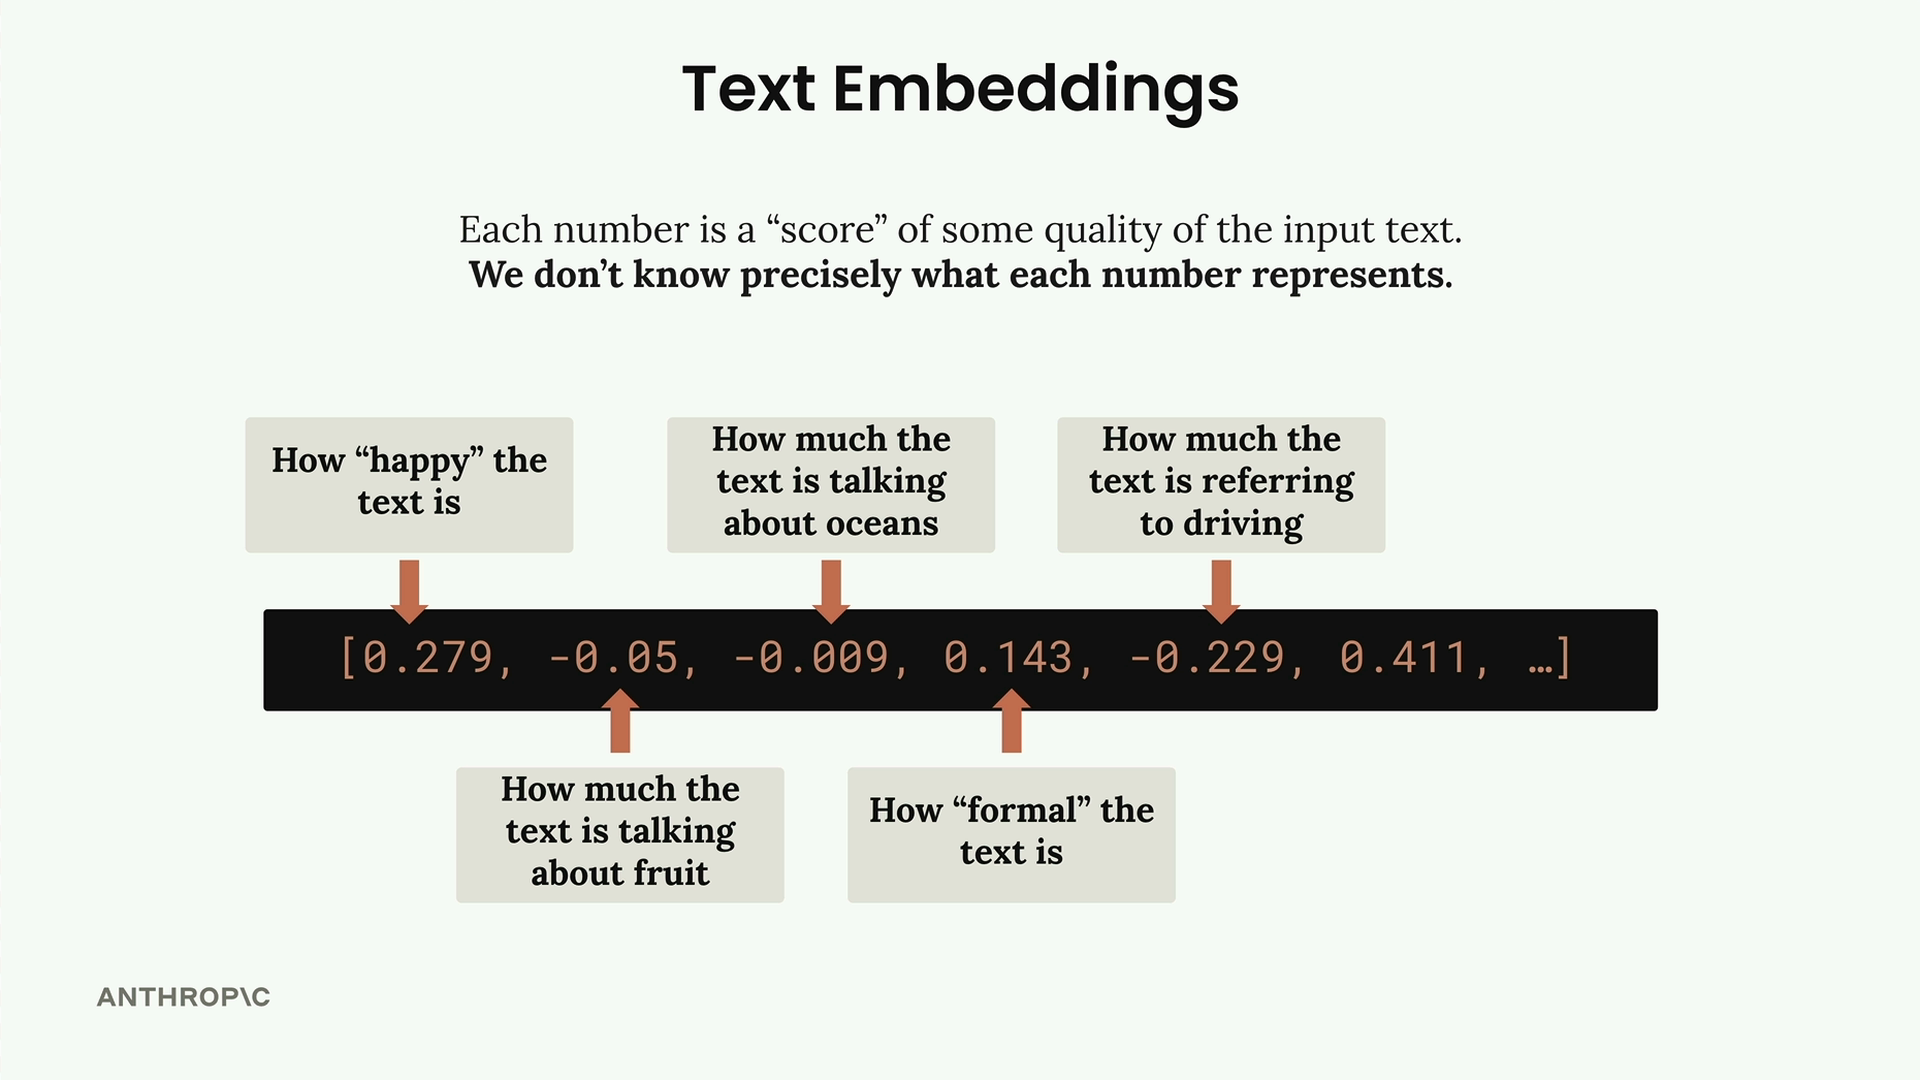
하나의 숫자는 "텍스트가 얼마나 행복한지"를, 다른 숫자는 "텍스트가 바다에 대해 얼마나 이야기하는지"를 나타낼 수 있다고 상상해보는 것이 도움이 되긴 하지만, 이는 단지 개념적인 예시일 뿐입니다. 임베딩 모델은 학습 과정에서 이러한 특징들을 학습하지만, 이 특징들은 명시적으로 라벨링되어 있거나 우리가 해석할 수 있는 것은 아닙니다.
이러한 불투명성에도 불구하고, 임베딩은 서로 다른 텍스트 조각 간의 수학적 비교를 가능하게 하는 방식으로 의미론적 의미를 포착하기 때문에 매우 강력합니다.
Vertex AI에서의 임베딩
Claude는 직접 임베딩을 생성할 수 없습니다. 대신, 전문화된 임베딩 모델을 사용해야 합니다. Vertex AI에서 우리가 사용할 모델은 text-embedding-005라고 합니다.
구현
Vertex AI에서 임베딩을 사용하려면 Google GenAI SDK를 설치해야 합니다:
pip install google-genai다음은 임베딩을 생성하기 위한 기본 설정입니다:
from google import genai

client = genai.Client(
    project="YOUR_PROJECT_ID",
    location="global",
    vertexai=True
)

def generate_embedding(text):
    response = client.models.embed_content(
        model="text-embedding-005",
        contents=text
    )

    if not response.embeddings:
        return []

    return [e.values for e in response.embeddings]
텍스트 청크를 가지고 이 함수를 실행하면 해당 텍스트의 의미론적 의미를 나타내는 부동소수점 숫자 목록을 반환받게 됩니다. 이러한 임베딩은 RAG 시스템에서 시맨틱 검색을 구현하기 위한 기반을 형성합니다.
다음 단계는 이러한 임베딩을 사용하여 사용자의 질문에 가장 관련성이 높은 청크를 실제로 찾는 방법을 이해하는 것이며, 이는 유사성을 판단하기 위해 임베딩을 수학적으로 비교하는 작업을 포함합니다.