지금까지 구축한 하이브리드 검색 방식은 잘 작동하지만, 여전히 다듬어야 할 부분이 있습니다. "eng 팀이 INC-2023-Q4-011에 대해 무엇을 했는가?"라는 질문으로 검색할 때, Software Engineering 섹션이 엔지니어링 팀과 해당 인시던트를 구체적으로 언급하고 있으므로 더 높은 순위에 오를 것으로 예상됩니다. 하지만 Cybersecurity 섹션이 여전히 먼저 나옵니다.
이때 등장하는 것이 바로 재순위화(re-ranking)입니다. 이는 검색 정확도를 크게 향상시킬 수 있는 후처리 기법입니다.
재순위화의 작동 방식
재순위화는 하이브리드 검색 과정 이후에 추가 단계를 더합니다. 벡터 및 BM25 인덱스에서 병합된 결과를 그대로 반환하는 대신, 이 결과를 LLM에 전달하여 지능적으로 재정렬합니다.
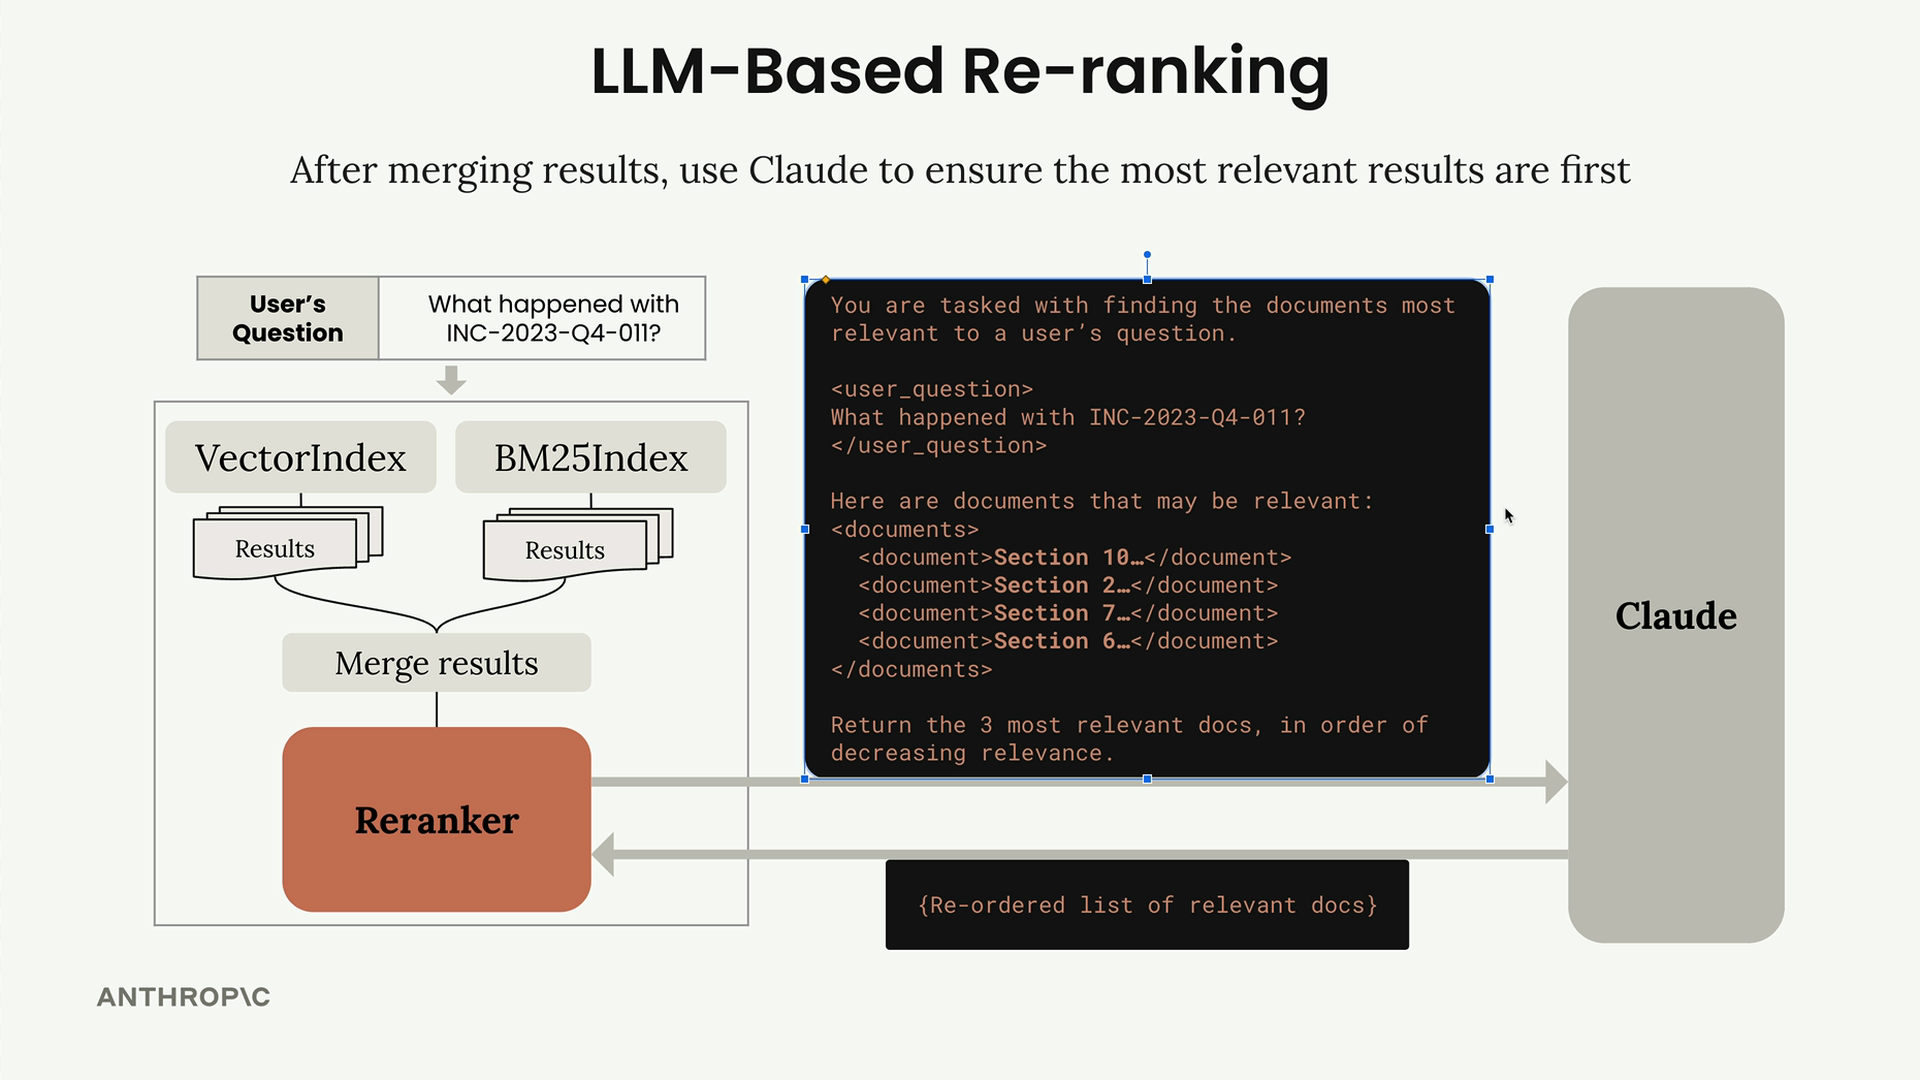
이 과정은 다음과 같이 간단합니다:
- 기존 하이브리드 검색(벡터 + BM25)을 실행합니다
- 이전과 같이 결과를 병합합니다
- 재순위화 프롬프트와 함께 병합된 결과를 Claude에 전송합니다
- 가장 관련성 높은 문서들로 재정렬된 목록을 받습니다
재순위화 프롬프트
프롬프트 구조는 단순하지만 효과적입니다. 사용자의 질문과 모든 후보 문서를 Claude에 제공한 다음, 관련성이 높은 순서대로 가장 관련성 높은 문서들을 반환하도록 요청합니다.
You are about to be given a set of documents, along with an id of each.
Your task is to select the {k} most relevant documents to answer the user's question.

Here is the user's question:
<question>
{query_text}
</question>

Here are the documents to select from:
<documents>
{joined_docs}
</documents>

Respond in the following format:
```json
{
  "document_ids": str[] # List document ids, {k} elements long, sorted in order of decreasing relevance
}
```효율성 고려 사항
핵심 최적화 방법은 Claude에게 전체 텍스트 청크를 반환하도록 요청하는 대신 문서 ID를 사용하는 것입니다. Claude에게 각 관련 문서의 전체 텍스트를 반환하도록 요청하면, 대량의 텍스트를 복사하는 데 걸리는 시간을 낭비하게 됩니다.
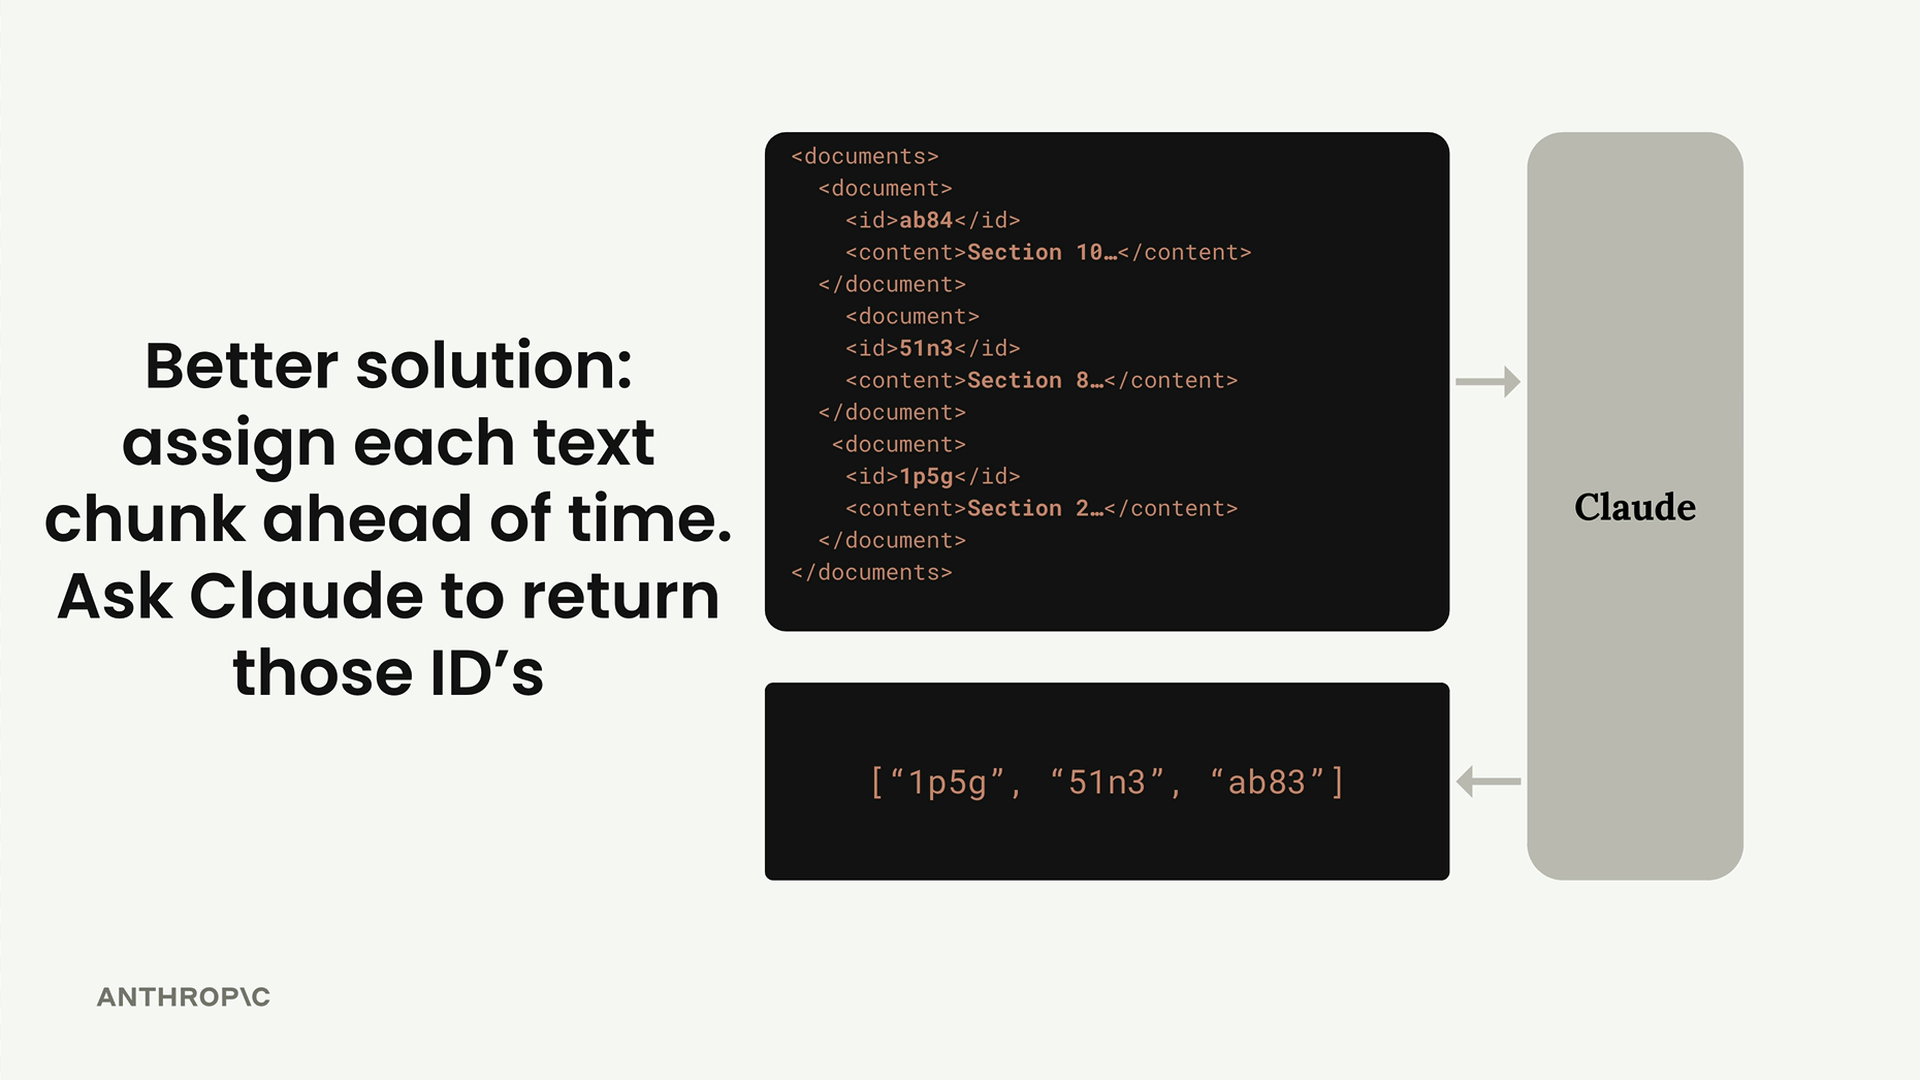
대신, 각 텍스트 청크에 미리 고유 ID를 할당한 다음, Claude에게 선호하는 순서대로 해당 ID만 반환하도록 요청합니다. 이렇게 하면 필요한 재정렬된 결과를 얻으면서도 재순위화 과정이 훨씬 빨라집니다.
구현
재순위화기 함수는 초기 하이브리드 검색이 완료된 후 자동으로 호출됩니다. 기본 구조는 다음과 같습니다:
def reranker_fn(docs, query_text, k):
    joined_docs = "\n".join([
        f"""
        <document>
        <document_id>{doc["id"]}</document_id>
        <document_content>{doc["content"]}</document_content>
        </document>
        """
        for doc in docs
    ])

    # 사용자 질문과 문서로 프롬프트 구성
    # JSON 응답 형식으로 Claude에 전송
    # 파싱하여 재정렬된 문서 ID 반환
재순위화기 함수를 매개변수로 전달하여 이를 검색기(retriever)에 통합할 수 있습니다:
retriever = Retriever(bm25_index, vector_index, reranker_fn=reranker_fn)결과
재순위화 방식은 명확한 개선을 보여줍니다. "eng 팀이 INC-2023-Q4-011에 대해 무엇을 했는가?"라는 쿼리를 테스트했을 때, 이제 Software Engineering 섹션이 Cybersecurity 섹션보다 앞서 정확하게 첫 번째로 나타납니다. Claude는 사용자가 구체적으로 엔지니어링 팀이 해당 인시던트에 관여한 내용에 대해 묻고 있다는 것을 성공적으로 파악했습니다.
트레이드오프
재순위화에는 고려해야 할 트레이드오프가 따릅니다:
- 지연 시간 증가: 이제 추가 LLM 호출이 완료될 때까지 기다려야 합니다
- 정확도 향상: LLM은 순수한 유사도 점수보다 맥락과 의도를 더 잘 이해할 수 있습니다
- 비용 고려 사항: 이제 각 검색마다 LLM API 호출이 필요합니다
많은 애플리케이션에서, 특히 정확한 검색이 사용 사례에 중요한 경우, 정확도 향상은 추가적인 지연 시간과 비용을 정당화합니다.