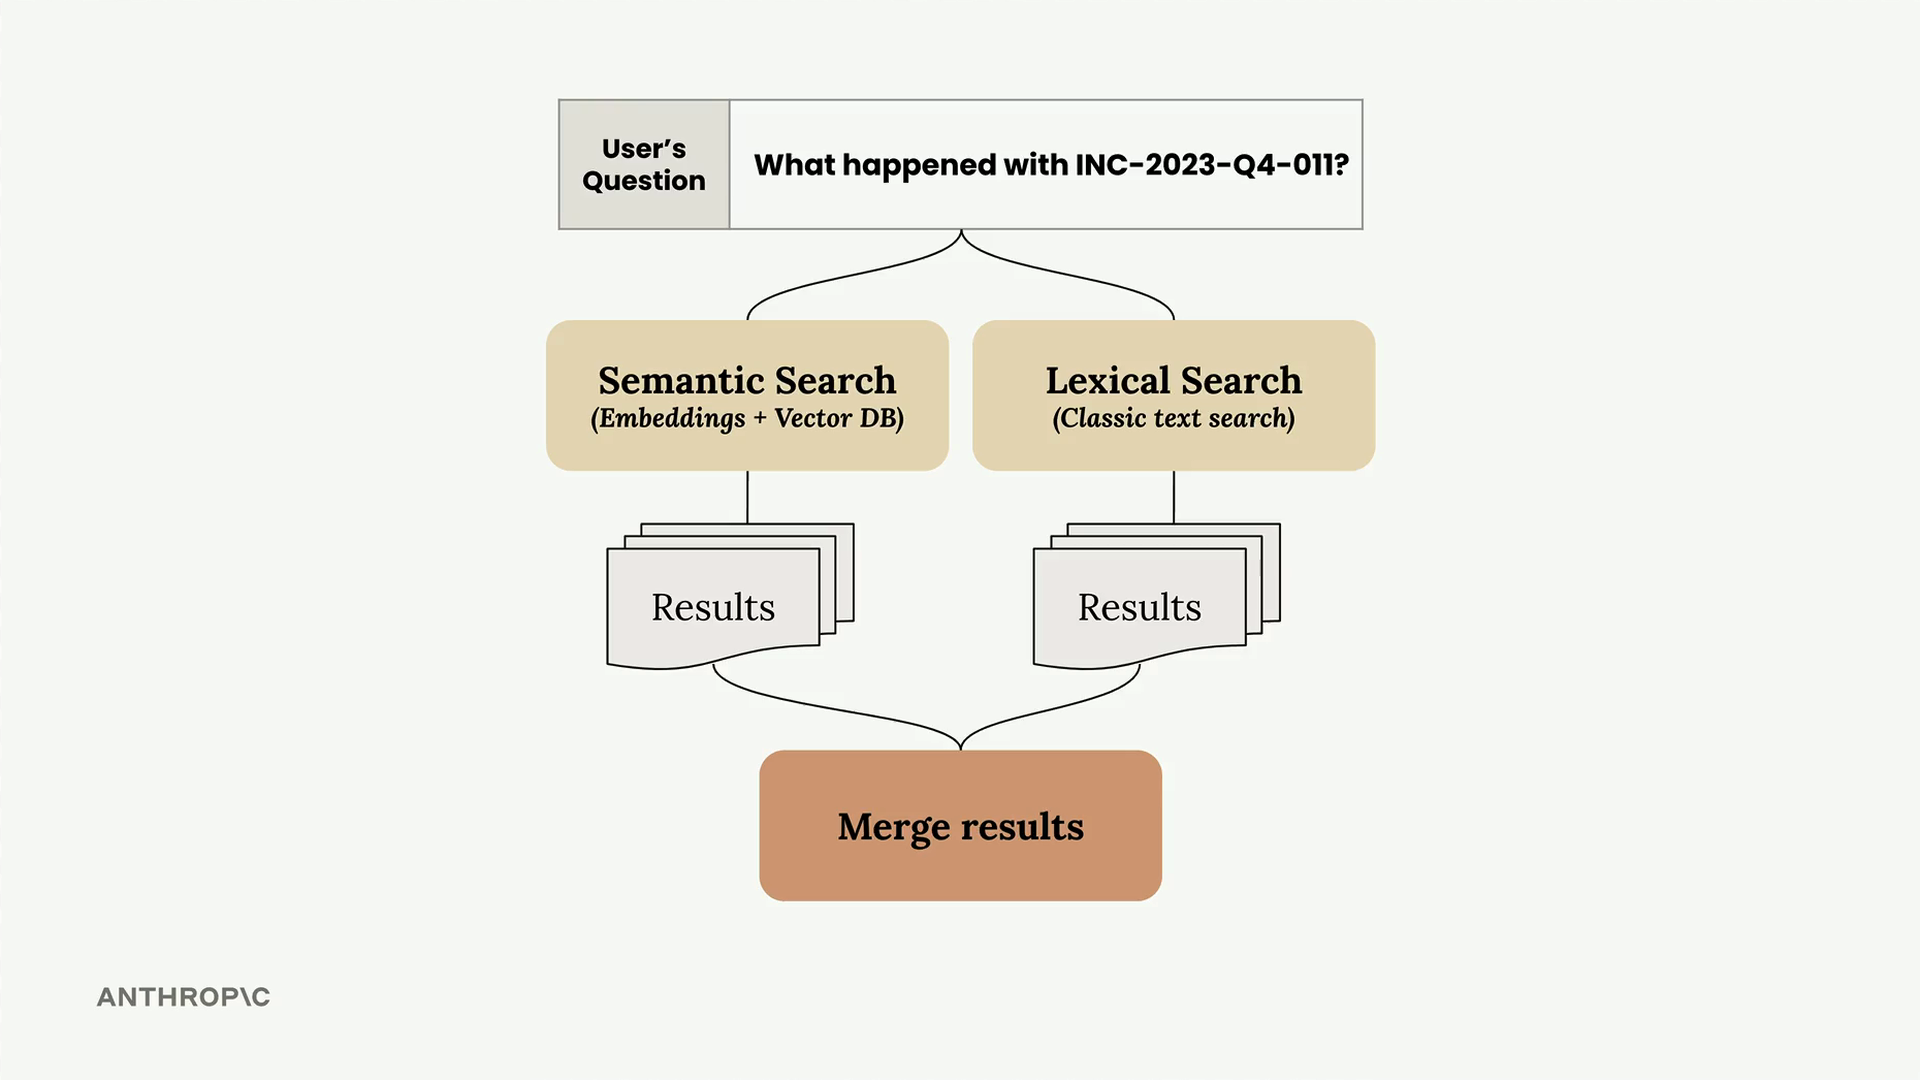
시맨틱 검색(벡터 임베딩)과 어휘 검색(BM25)이 각각 독립적으로 작동하게 되면, 다음 단계는 이 둘을 통합된 검색 파이프라인으로 결합하는 것입니다. 이 하이브리드 접근 방식은 두 방법의 강점을 모두 활용하여 더 정확한 결과를 제공합니다.
통합 인터페이스 만들기
두 검색 구현은 거의 동일한 API를 공유합니다. 둘 다 동일한 방식으로 작동하는 add_document()와 search() 메서드를 가지고 있습니다. 이러한 일관성 덕분에 이 둘을 단일 Retriever 클래스로 감싸는 작업이 간단해집니다.
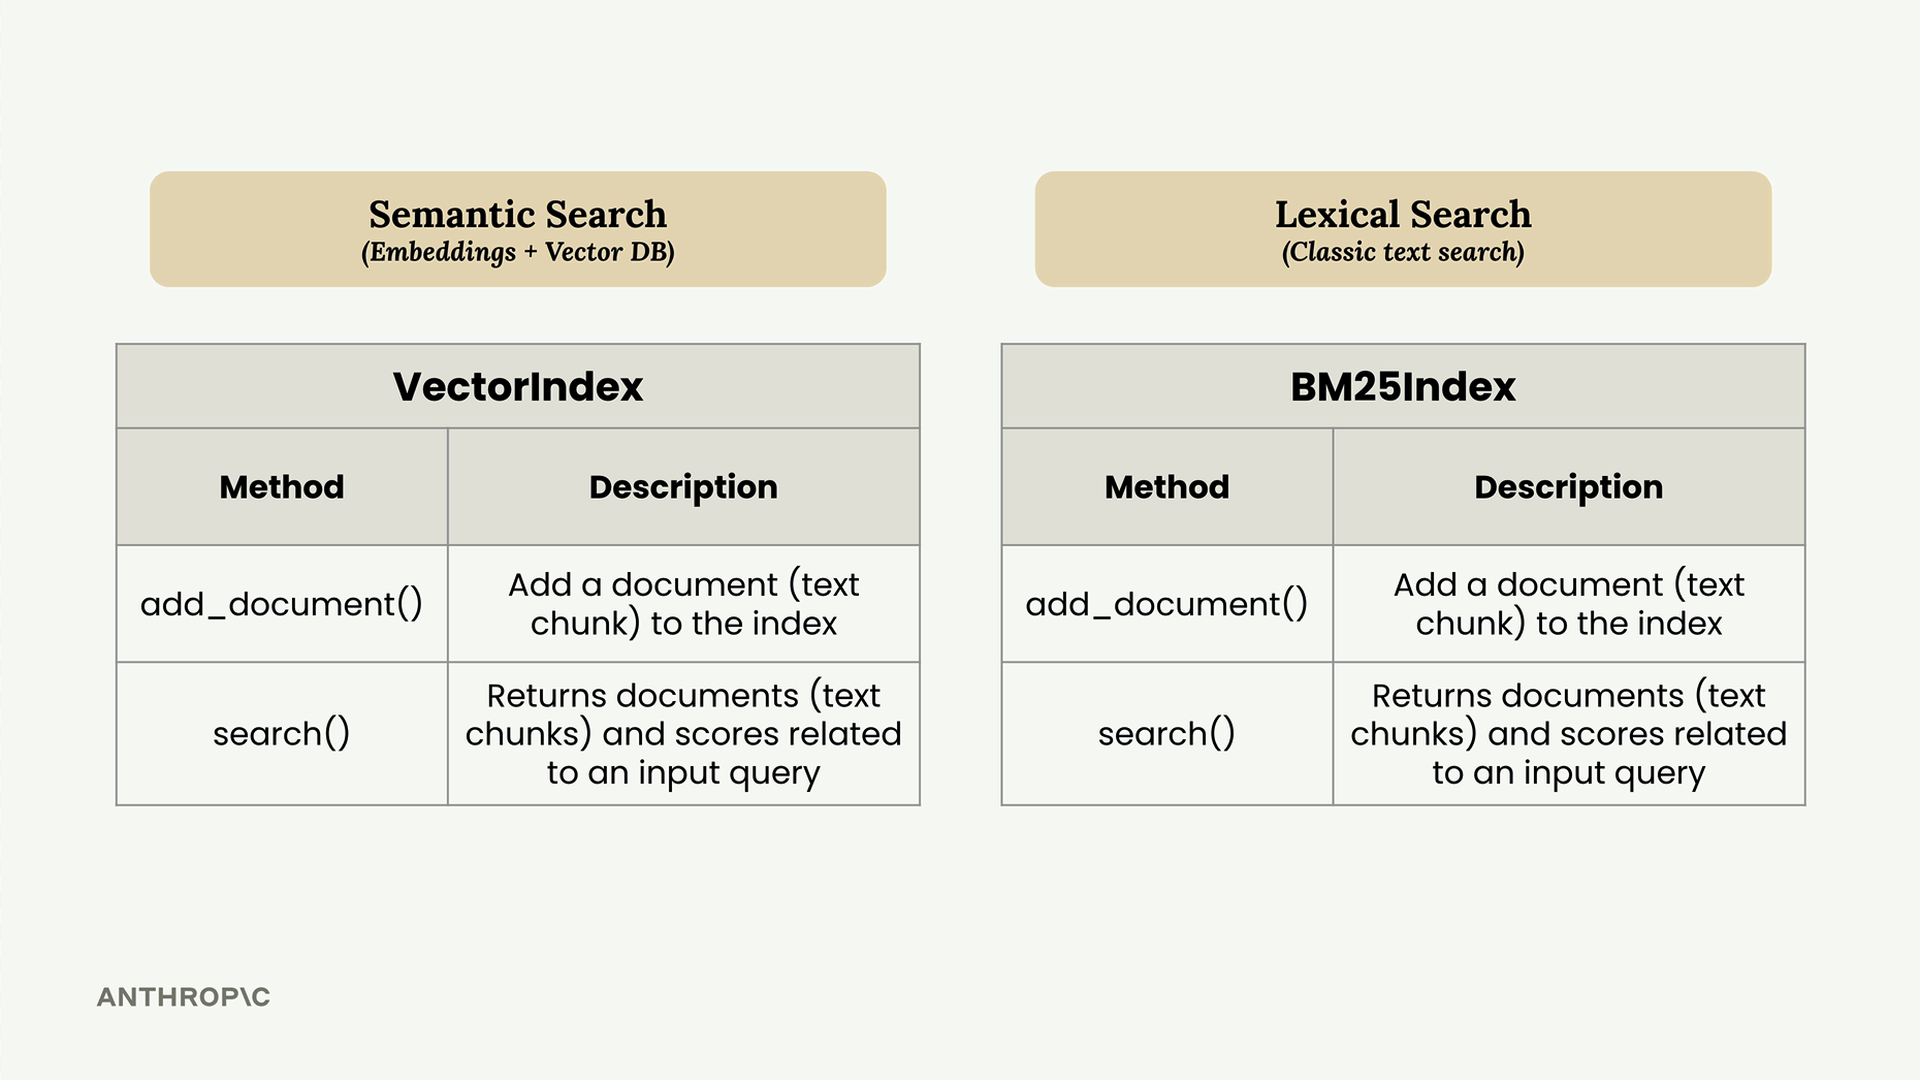
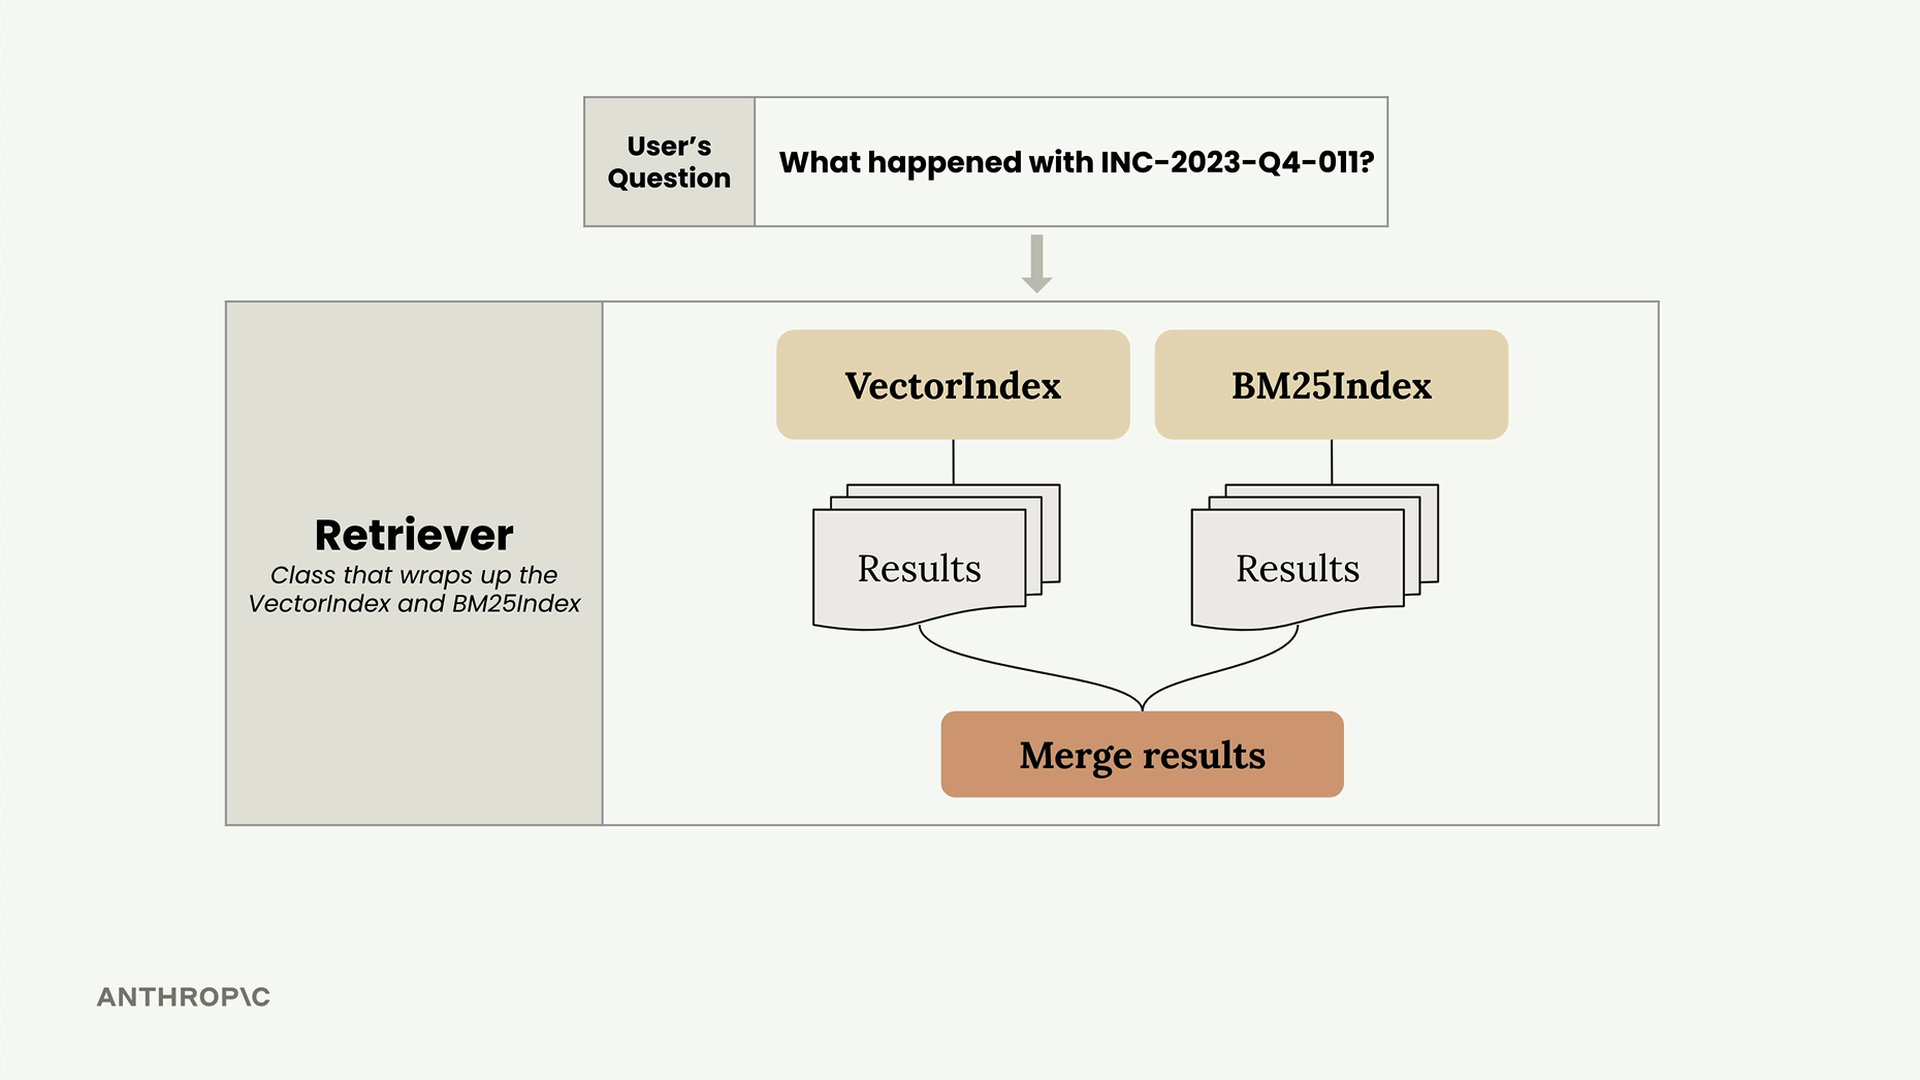
Retriever는 사용자 쿼리를 두 인덱스 모두에 전달하고, 각각의 결과를 수집한 다음, 이를 하나의 순위가 매겨진 리스트로 병합하는 조정자 역할을 합니다.
Reciprocal Rank Fusion
과제는 서로 다른 채점 체계를 사용하는 서로 다른 검색 방법의 결과를 병합하는 것입니다. 벡터 검색은 코사인 유사도 점수를 반환하는 반면, BM25는 관련성 점수를 반환하므로, 이 숫자들을 단순히 직접 합칠 수는 없습니다.
대신, Reciprocal Rank Fusion(RRF)이라는 기법을 사용합니다. 이 방법은 결과의 원점수가 아니라 순위 위치에 초점을 맞춥니다.
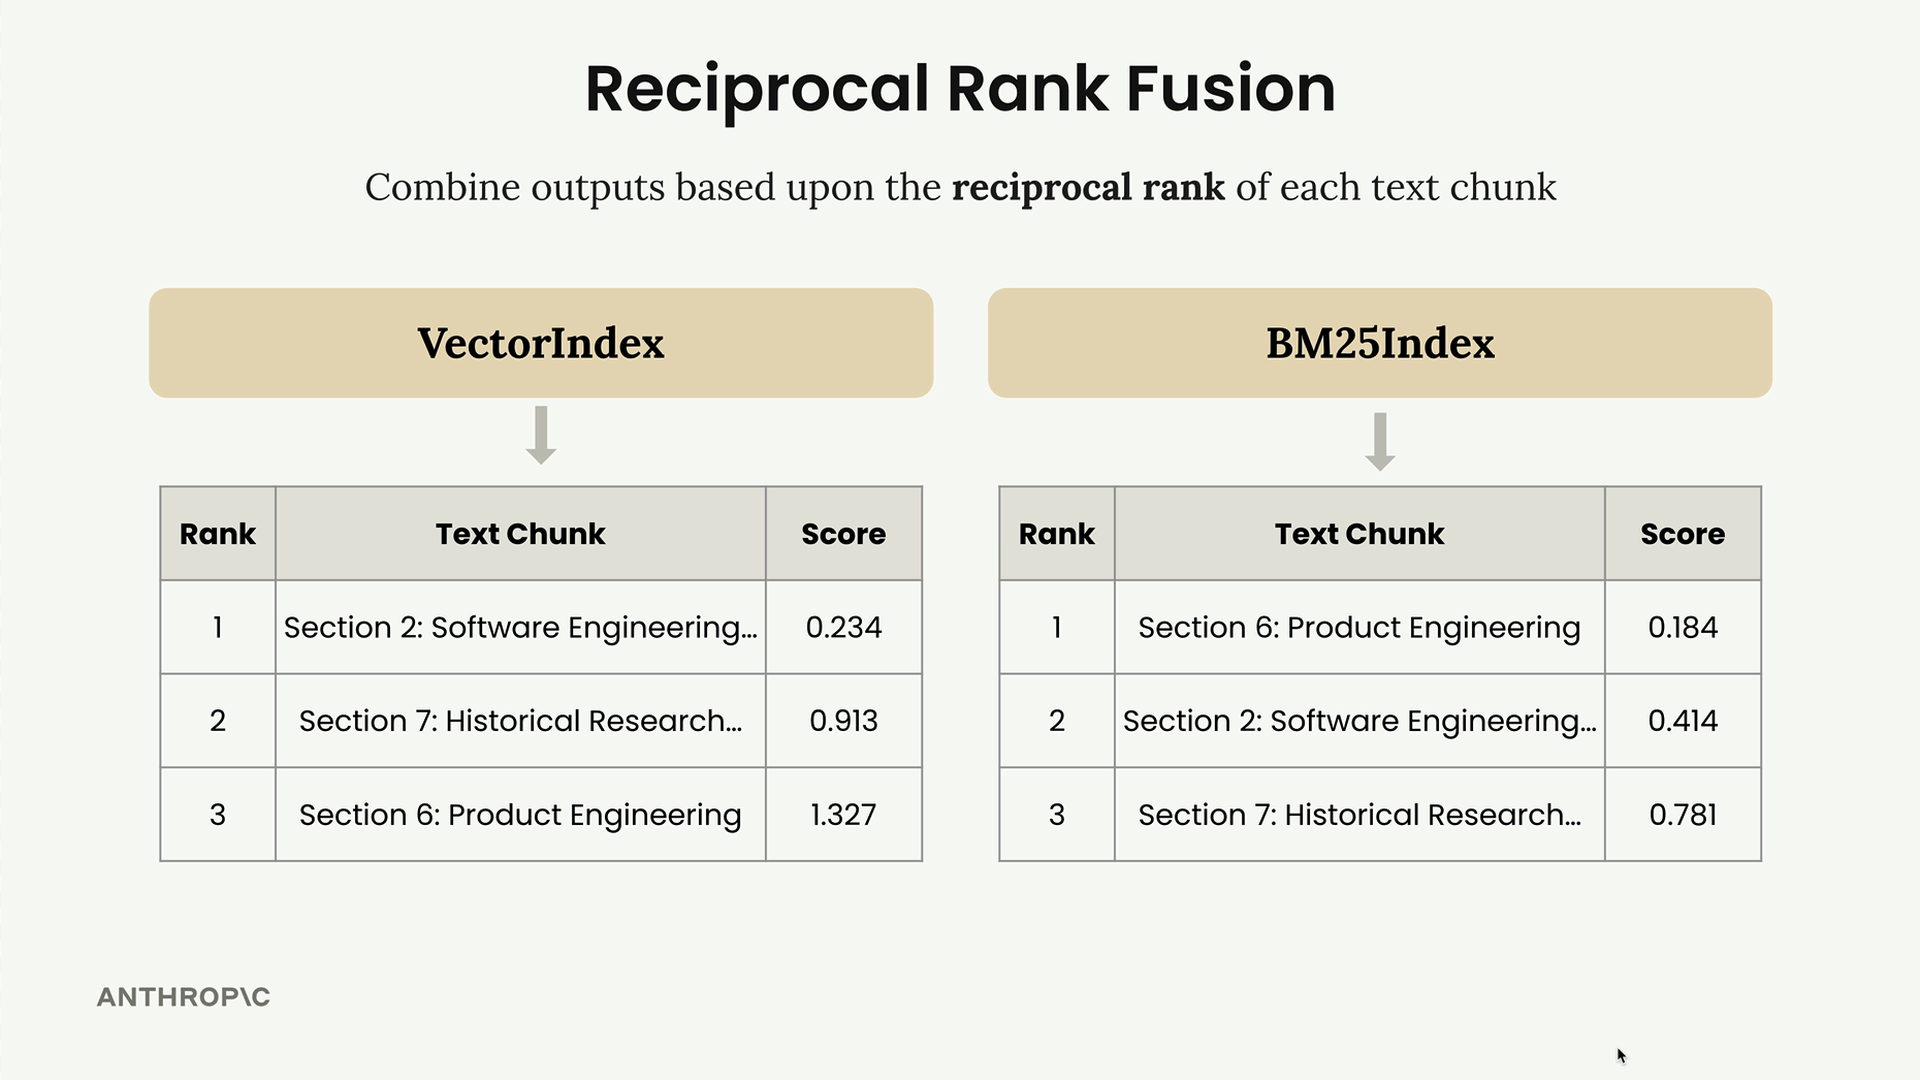
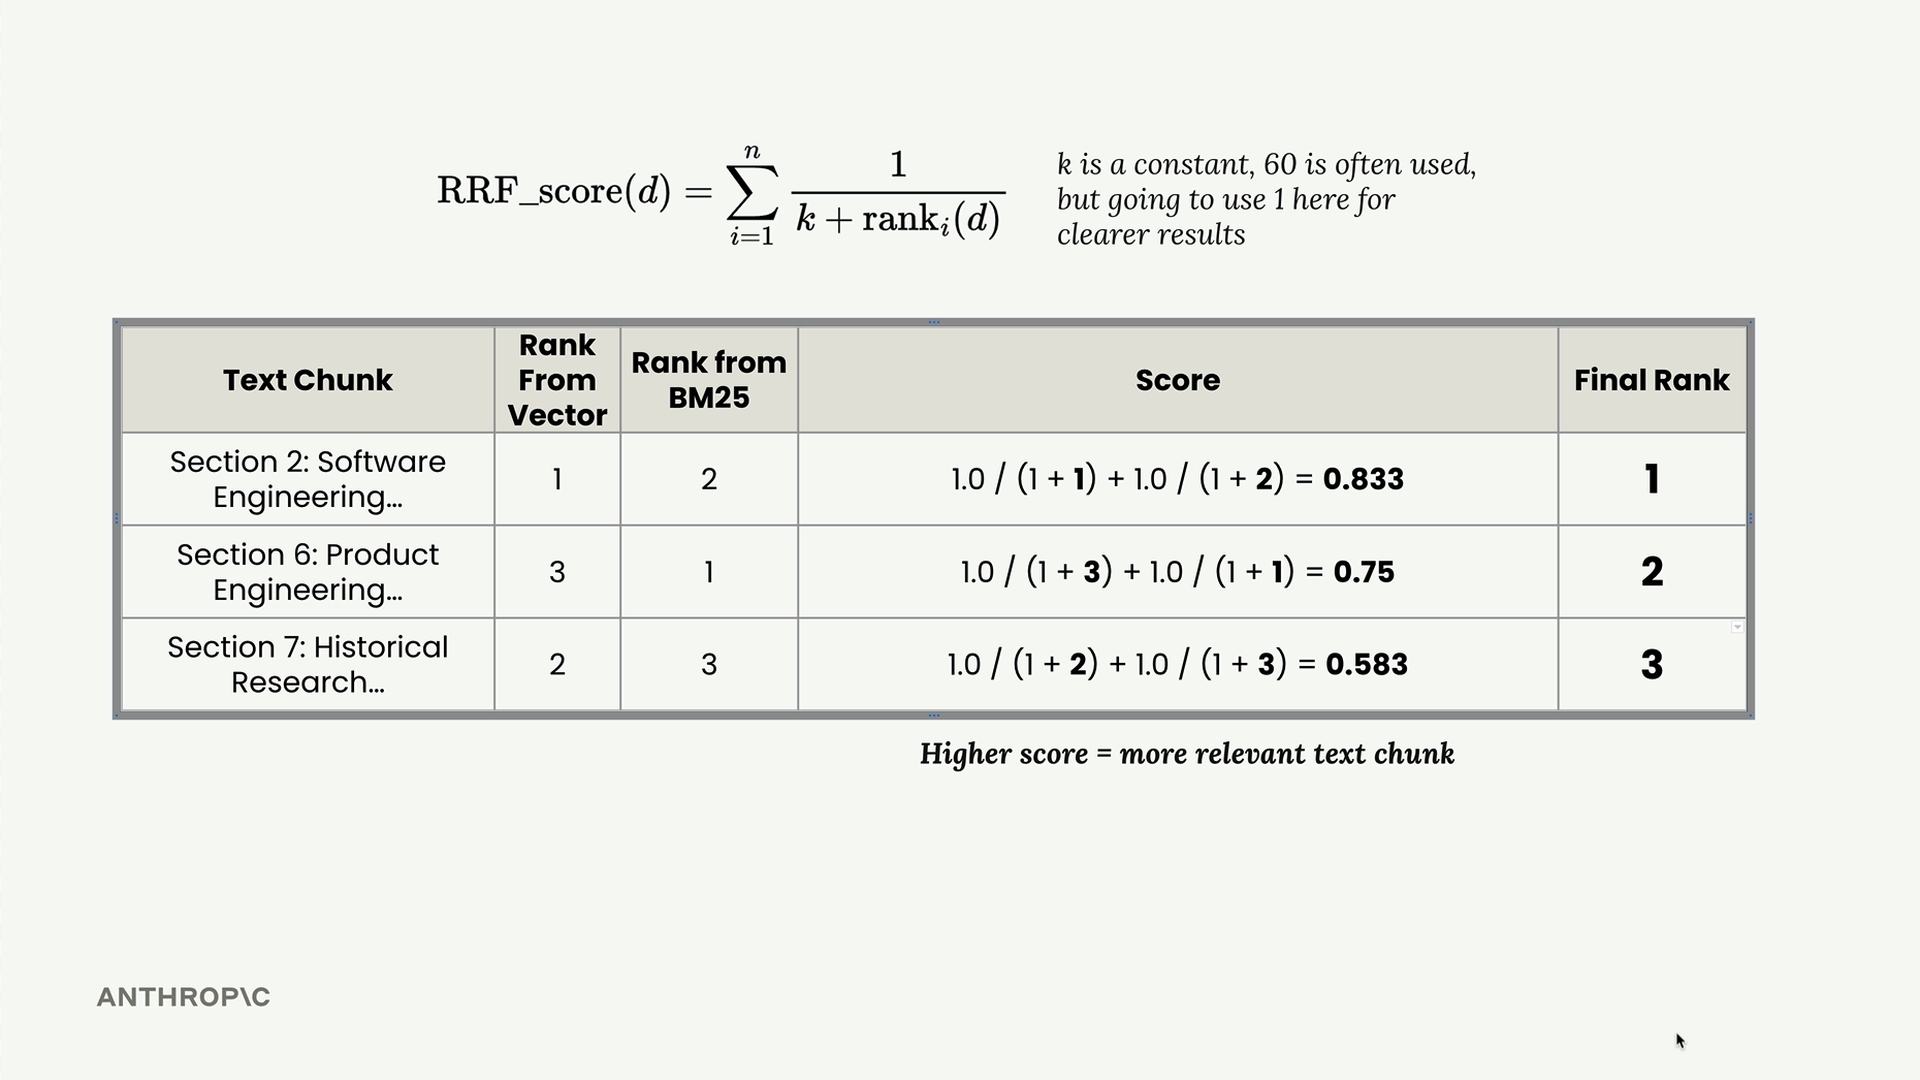
예시를 통해 작동 방식을 살펴보겠습니다. 벡터 검색이 섹션 2, 7, 6 순서로 반환하고, BM25는 섹션 6, 2, 7 순서로 반환한다고 가정해 보겠습니다. 이를 병합하려면:
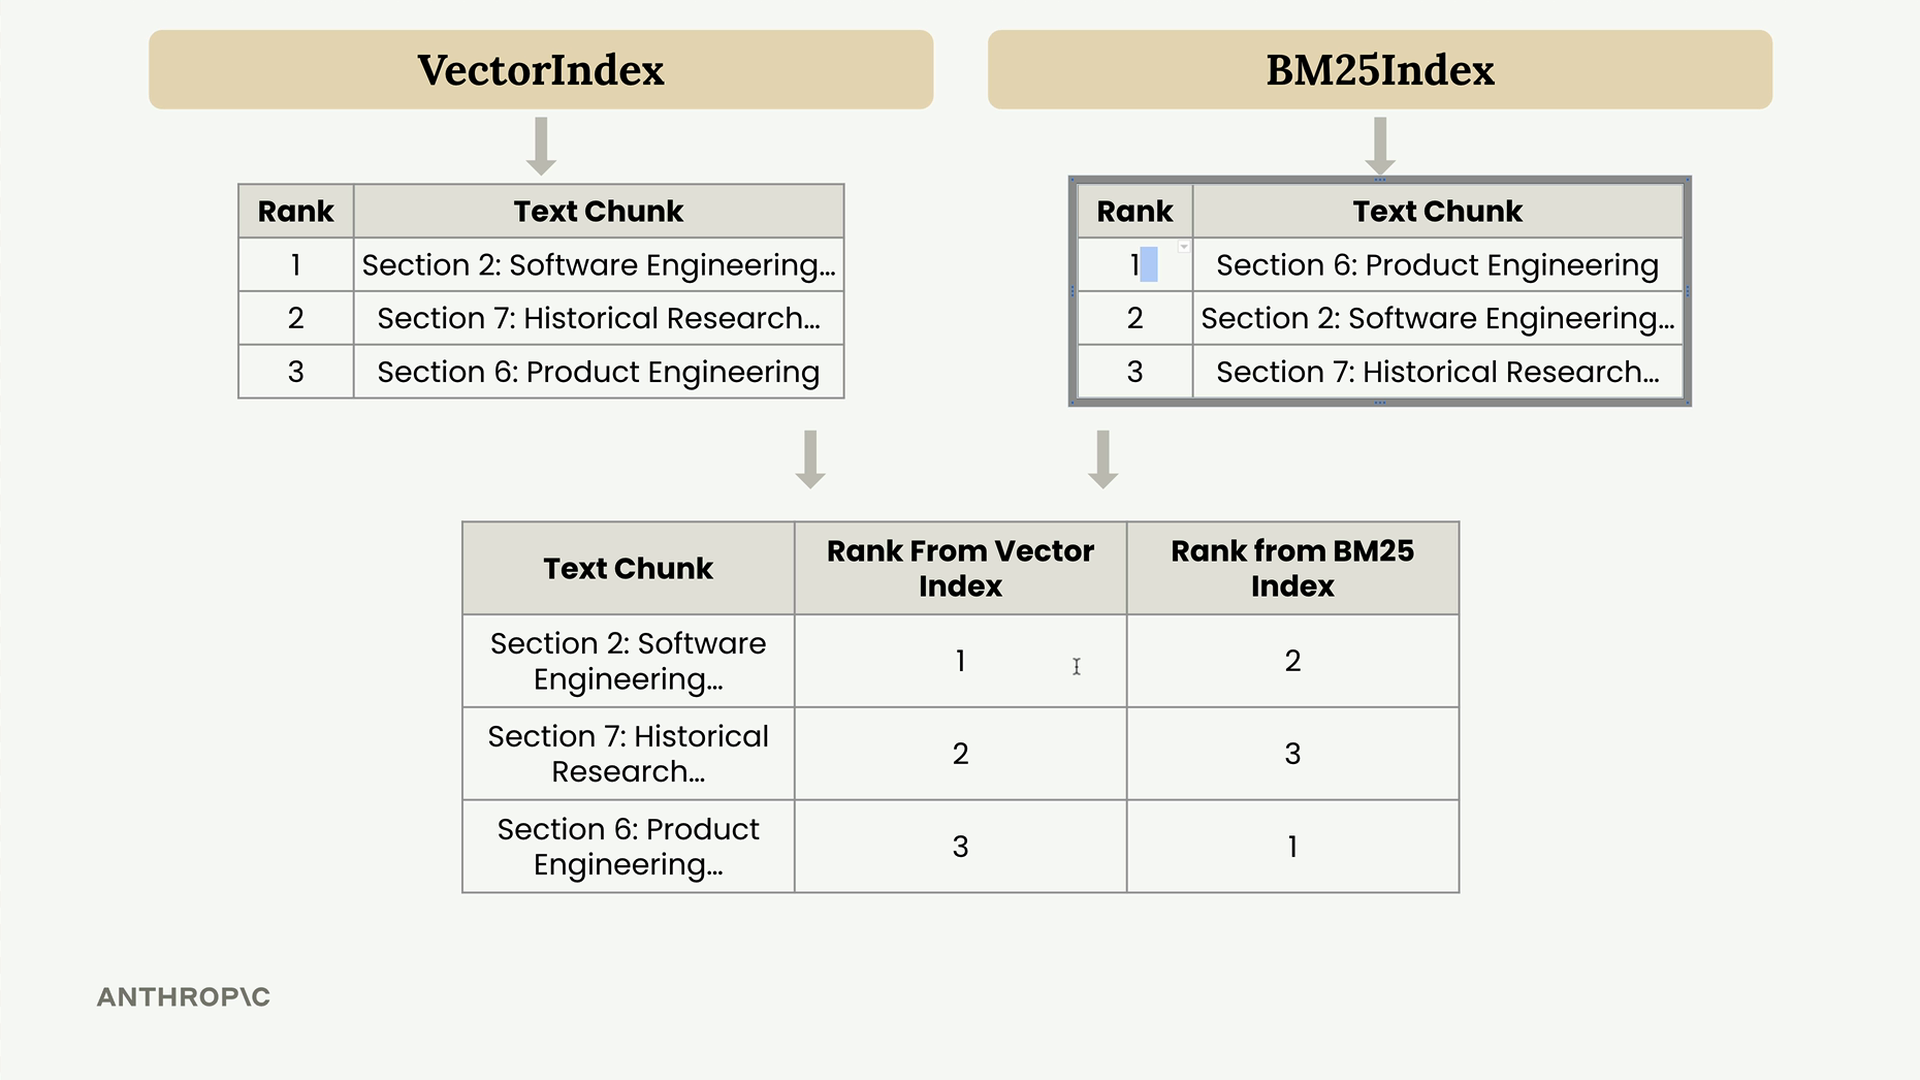
먼저, 각 텍스트 청크와 두 검색 방법에서의 순위를 보여주는 표를 만듭니다:
- 섹션 2: 벡터에서 순위 1, BM25에서 순위 2
- 섹션 7: 벡터에서 순위 2, BM25에서 순위 3
- 섹션 6: 벡터에서 순위 3, BM25에서 순위 1
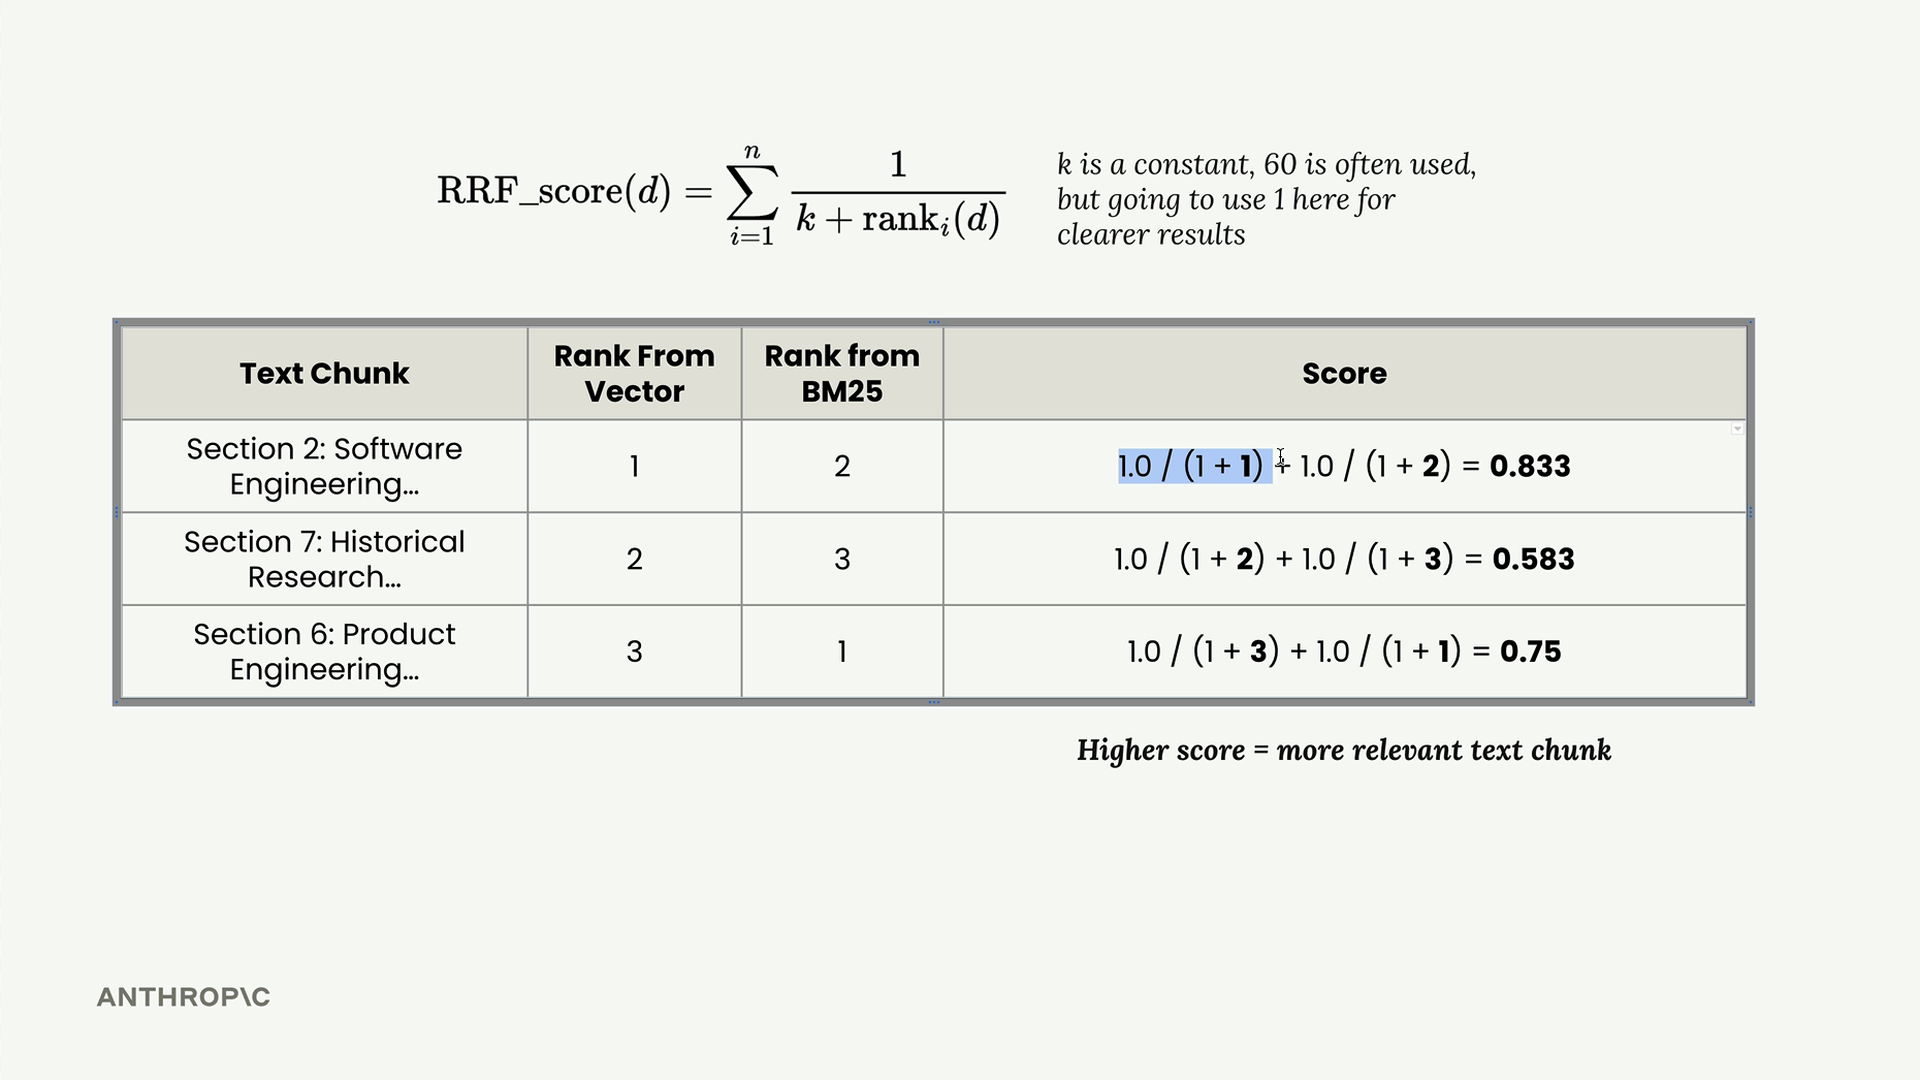
그런 다음 RRF 공식을 적용하여 각 청크에 대한 결합 점수를 계산합니다:
RRF_score(d) = Σ(1 / (k + rank_i(d)))여기서 k는 상수(일반적으로 60이지만, 더 명확한 결과를 위해 1을 사용하겠습니다)이고, rank_i(d)는 i번째 검색 결과에서 문서 d의 순위입니다.
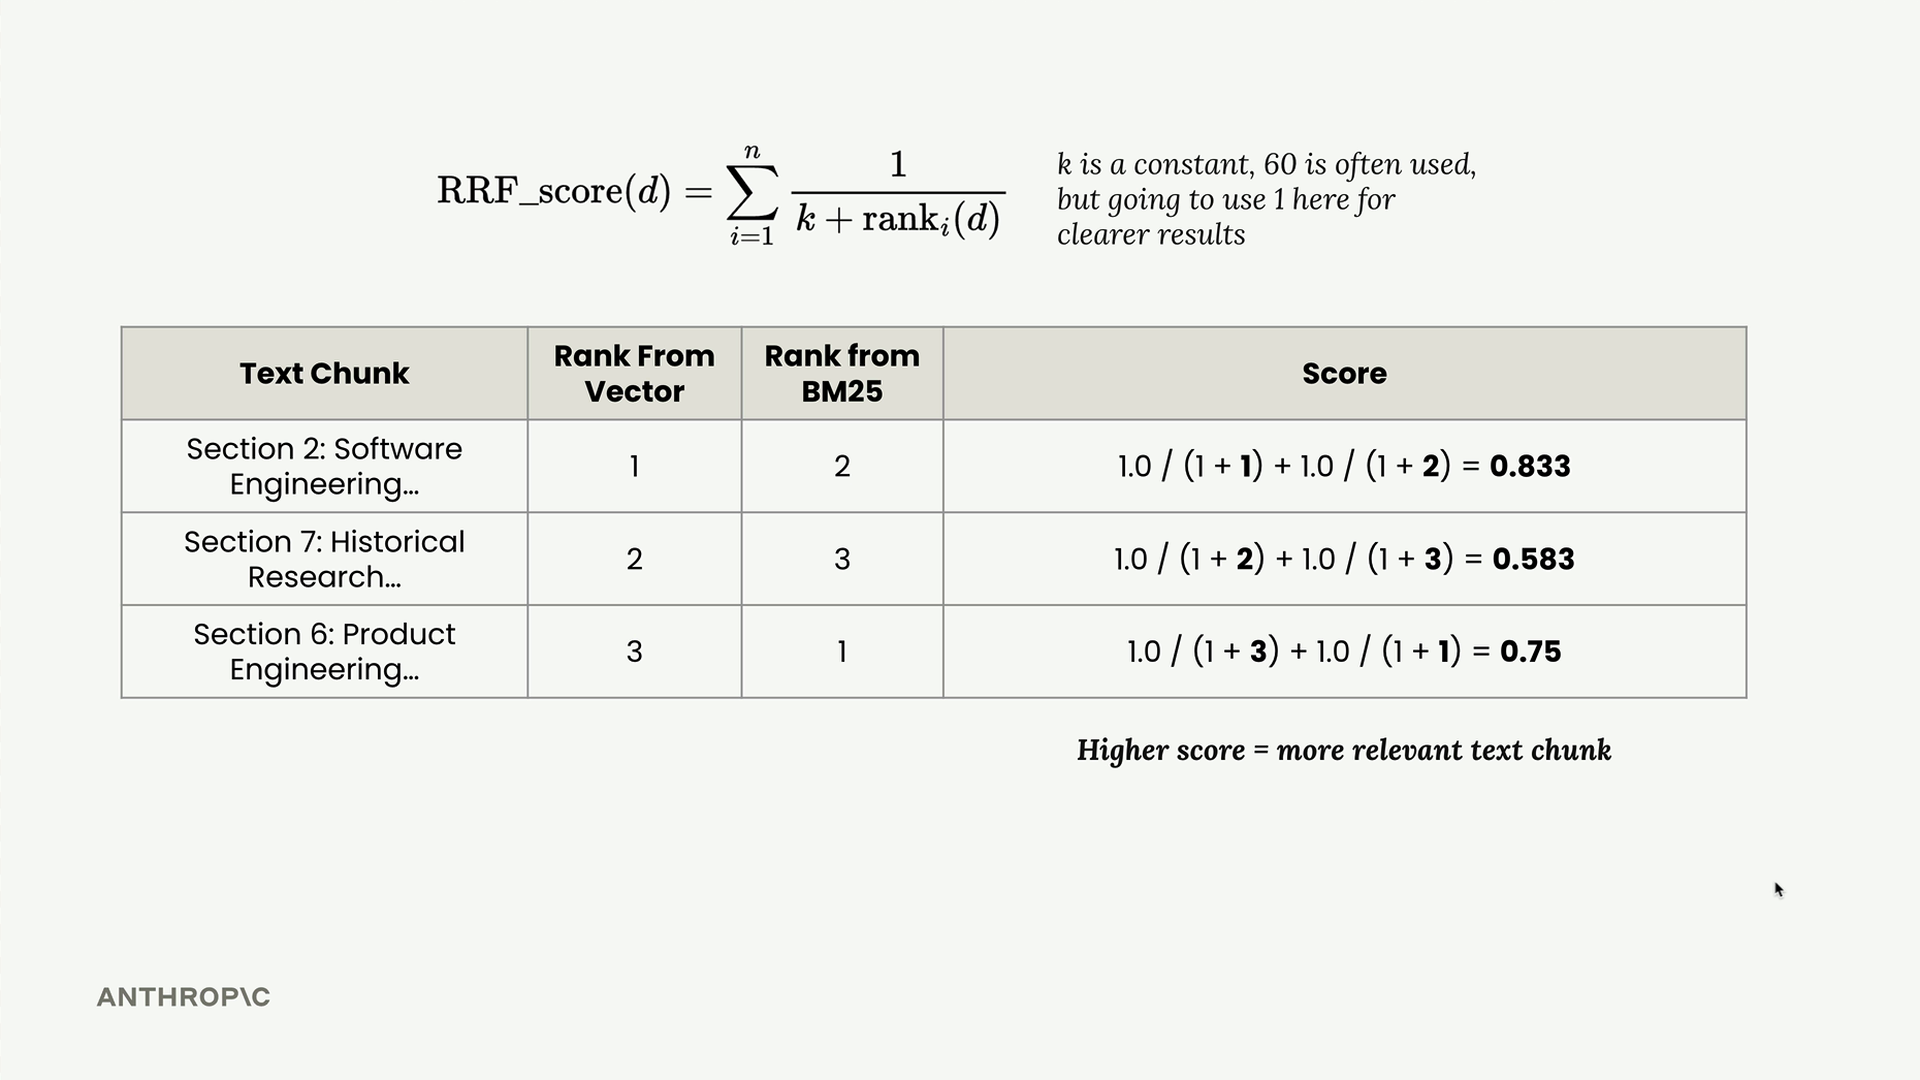
우리의 예시에서:
- 섹션 2: 1.0/(1+1) + 1.0/(1+2) = 0.833
- 섹션 7: 1.0/(1+2) + 1.0/(1+3) = 0.583
- 섹션 6: 1.0/(1+3) + 1.0/(1+1) = 0.75
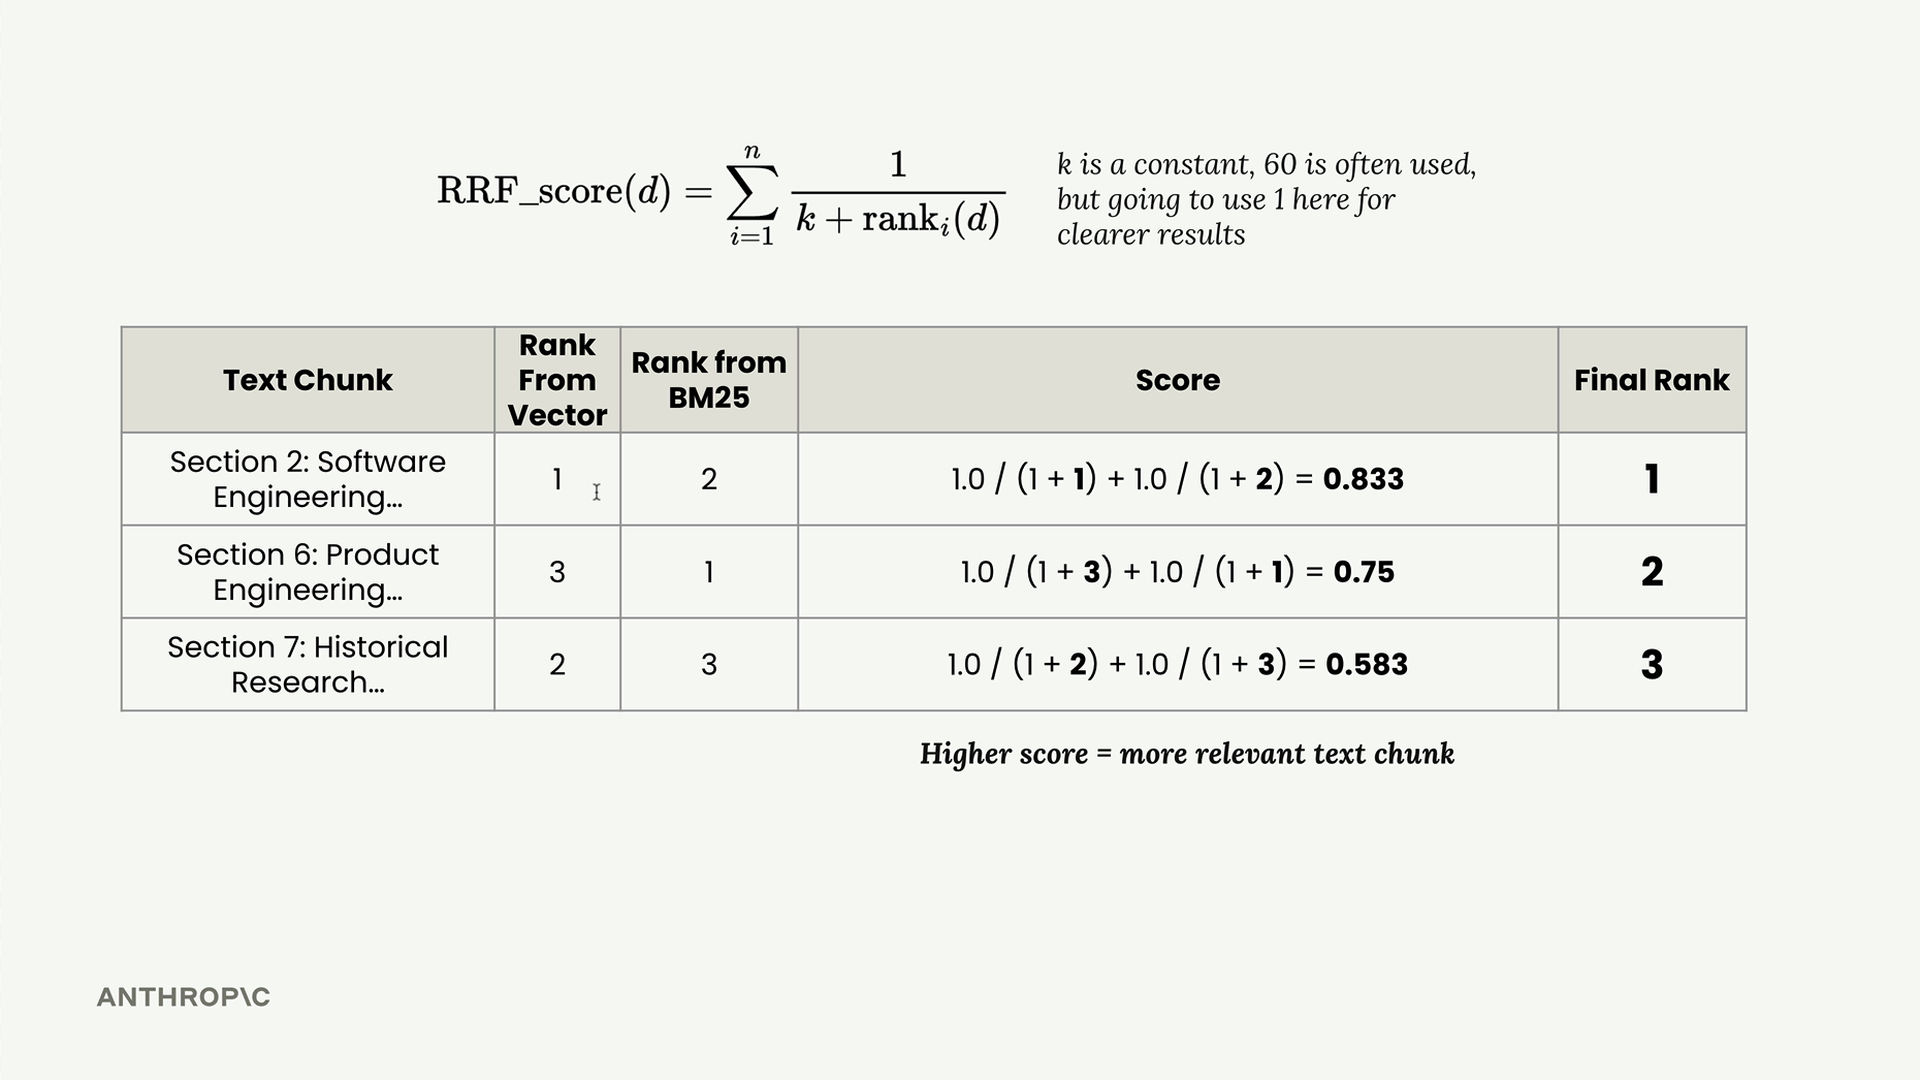
최종 순위는 다음과 같이 됩니다: 섹션 2(0.833), 섹션 6(0.75), 섹션 7(0.583). 이는 직관적으로도 타당합니다 - 섹션 2는 두 검색 모두에서 좋은 성과를 보였고, 섹션 6은 혼재된 결과를 보였으며, 섹션 7은 전체적으로 더 낮은 순위를 받았습니다.
구현
Retriever 클래스 구현은 간단합니다:
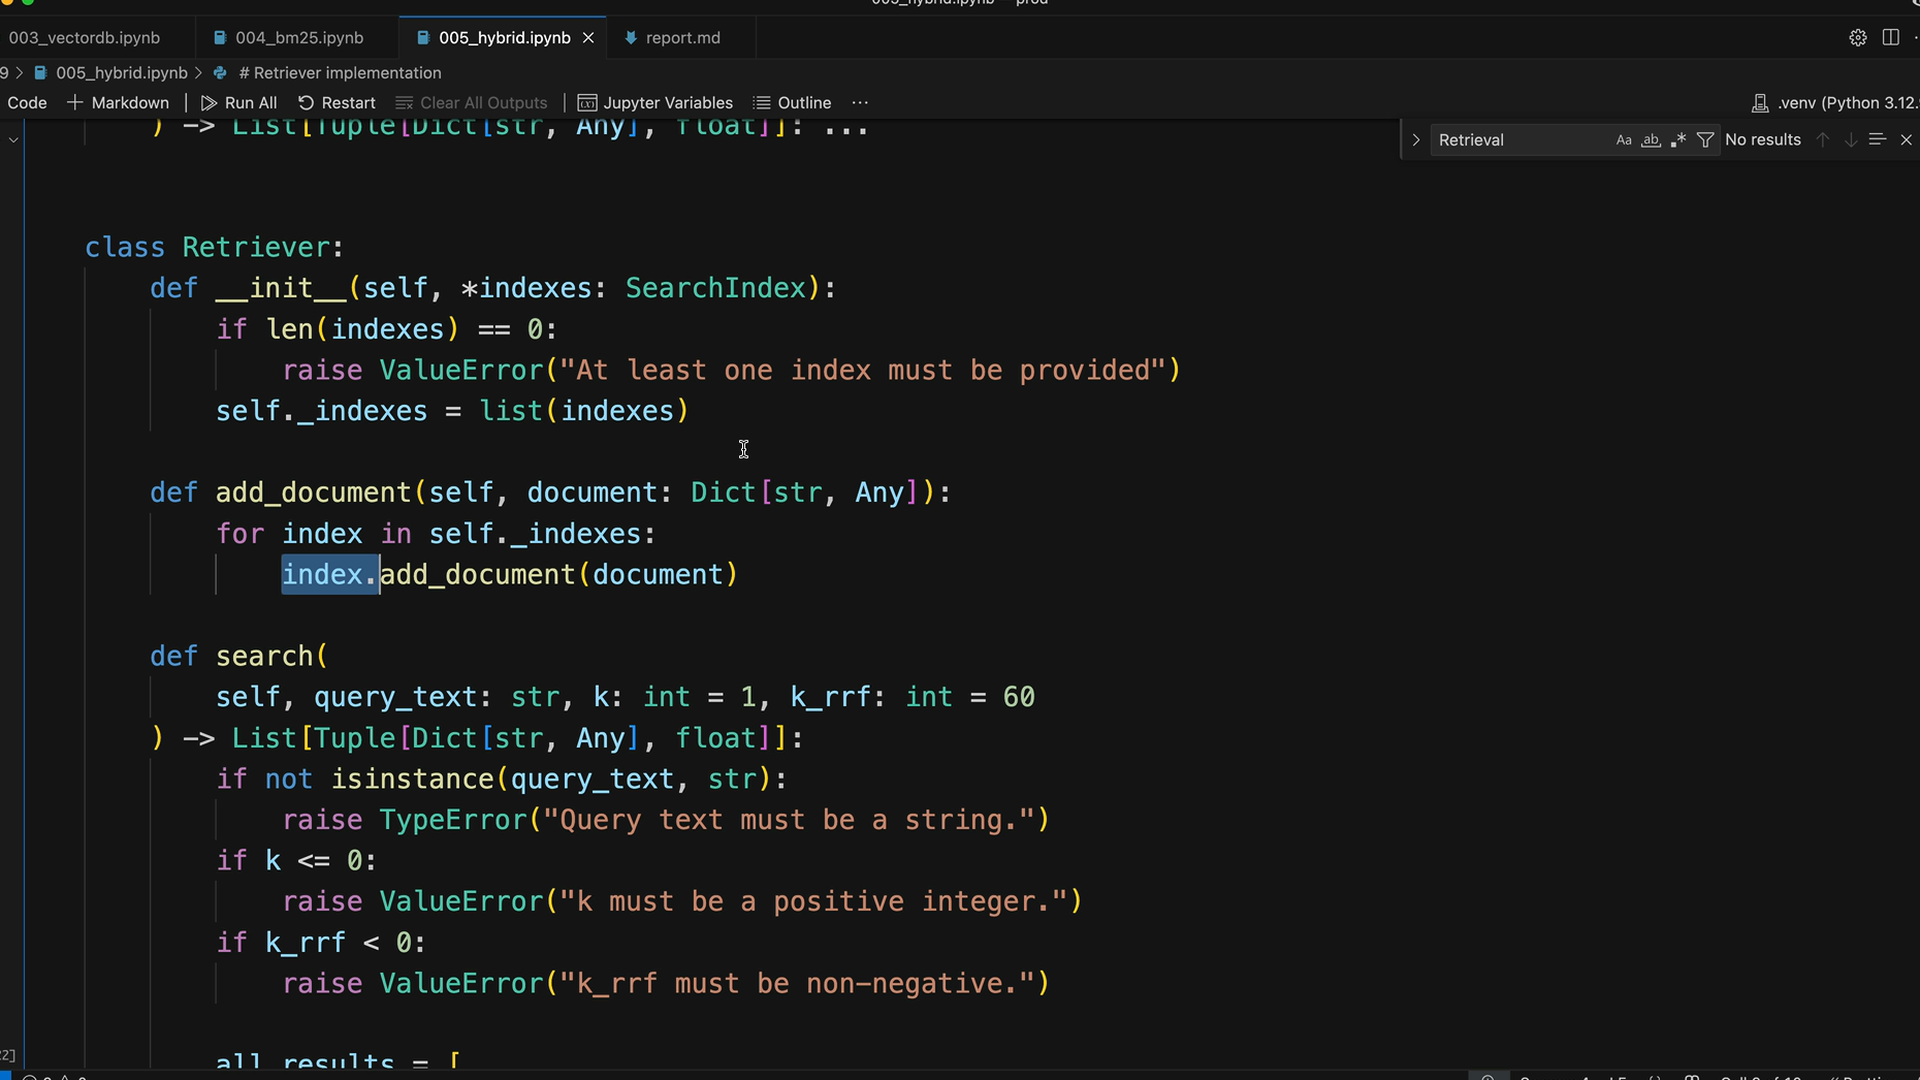
class Retriever:
    def __init__(self, *indexes):
        self._indexes = list(indexes)

    def add_document(self, document):
        for index in self._indexes:
            index.add_document(document)

    def search(self, query_text, k=1, k_rrf=60):
        # 모든 인덱스에서 결과 가져오기
        all_results = [index.search(query_text, k) for index in self._indexes]

        # 상호 순위 융합(reciprocal rank fusion) 적용
        # ... 여기에 병합 로직 ...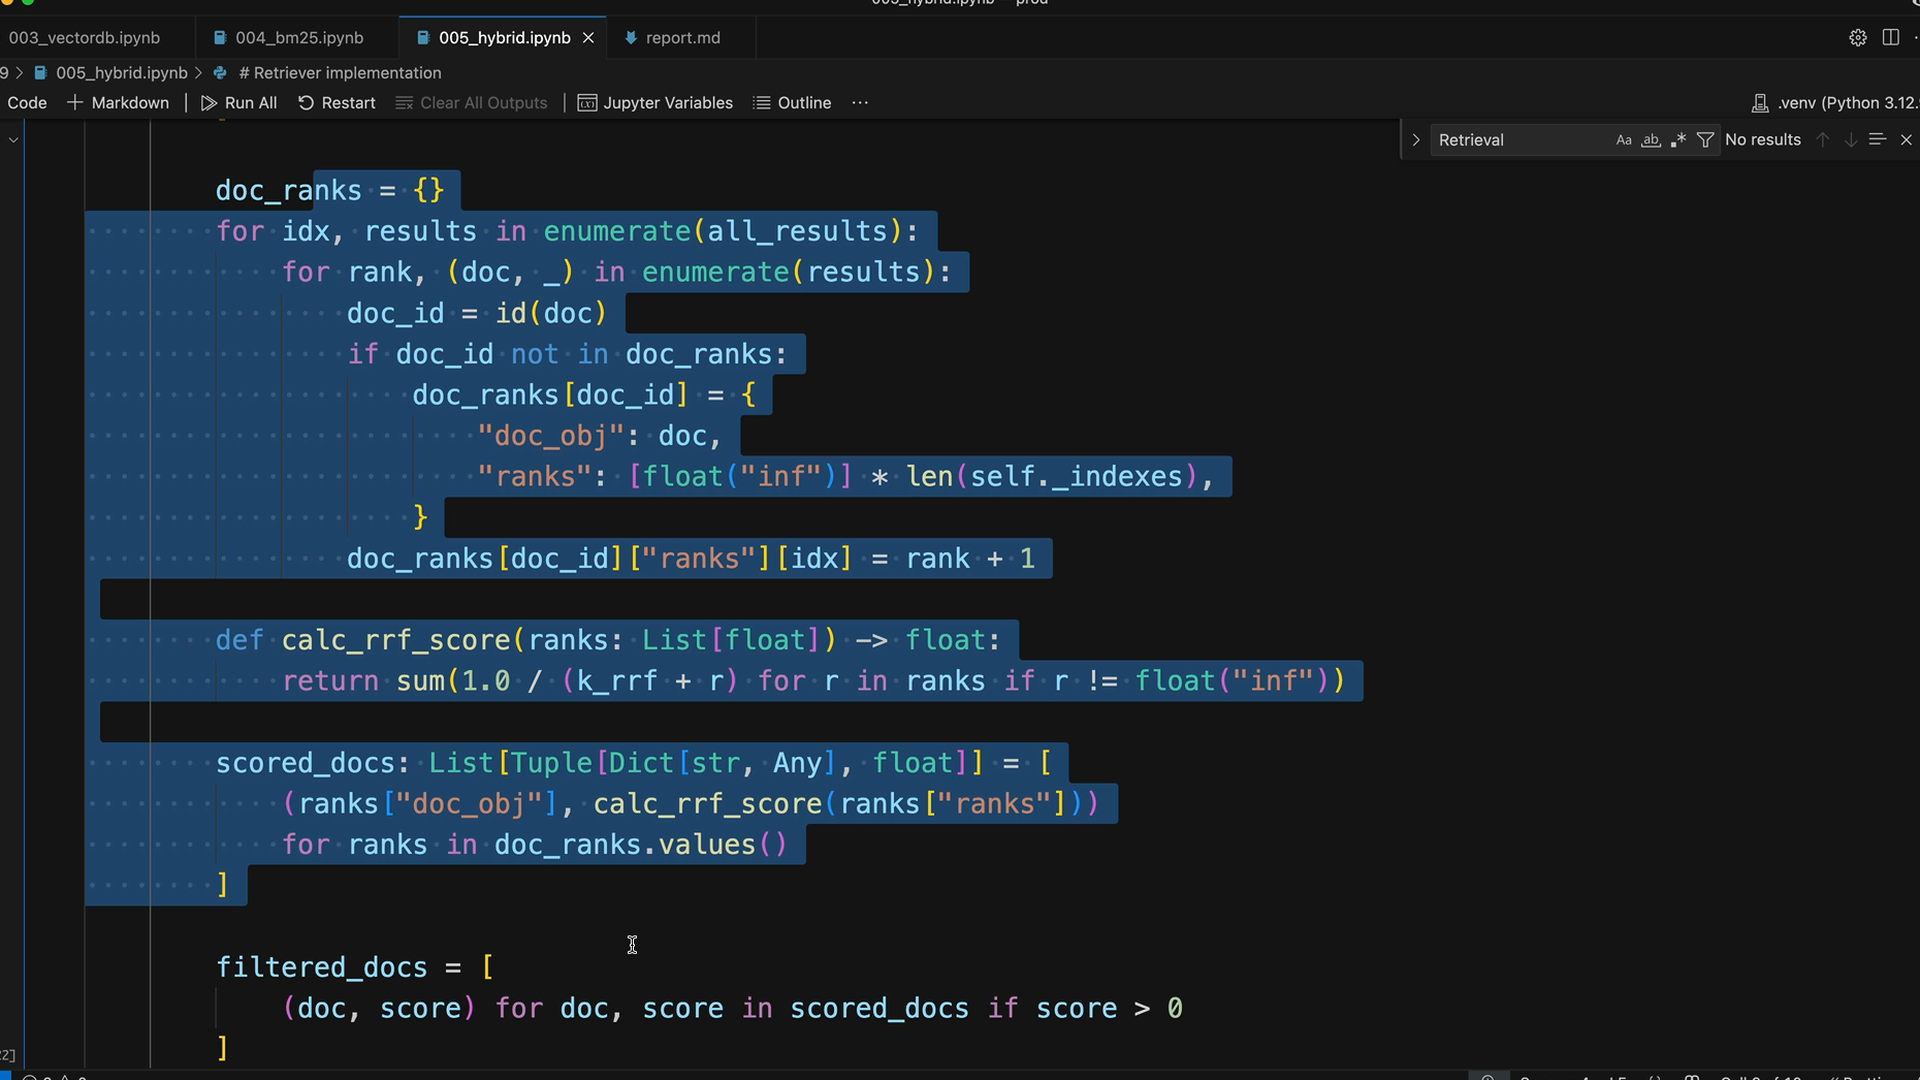
병합 로직은 모든 검색 결과에 걸쳐 문서 순위를 추적하고, RRF 점수를 계산한 다음, 결합 점수에 따라 정렬된 상위 k개의 문서를 반환합니다.
하이브리드 접근 방식 테스트하기
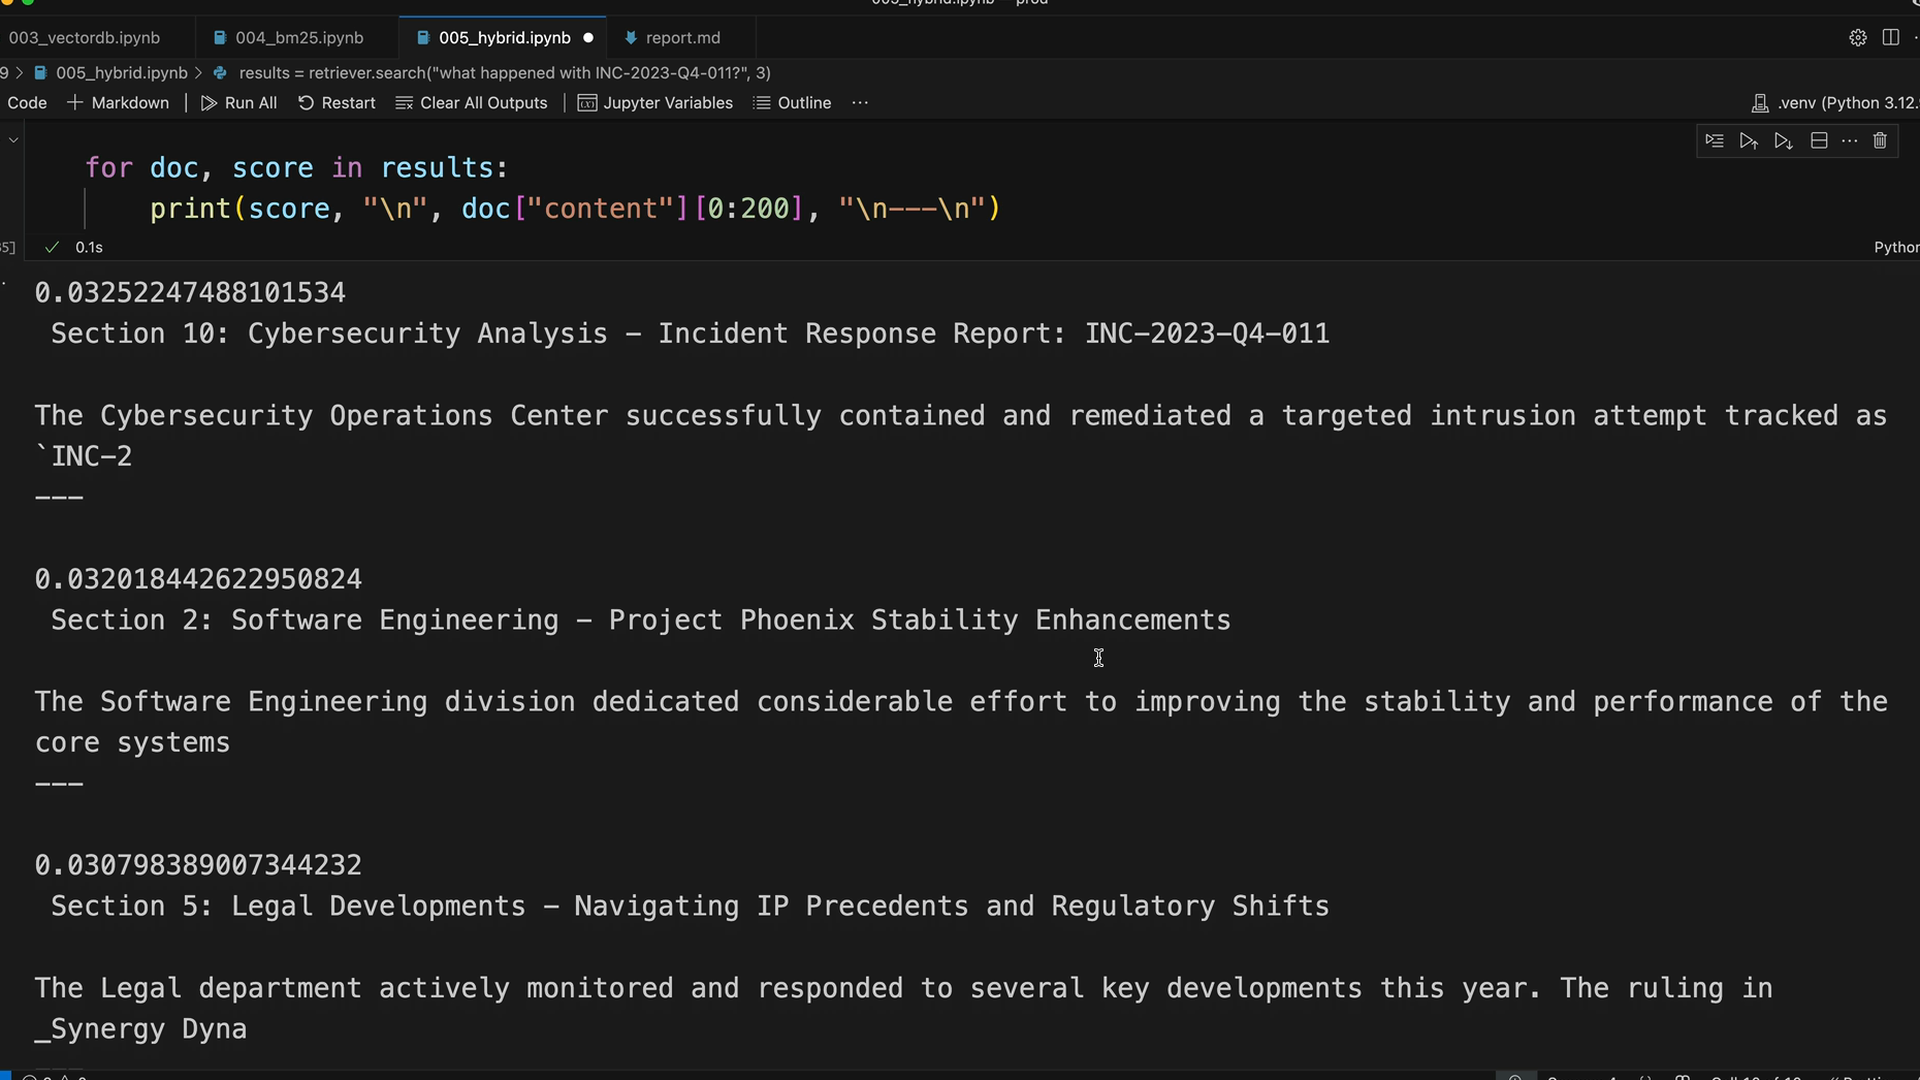
"what happened with INC-2023-Q4-011?"라는 쿼리로 테스트할 때, 하이브리드 접근 방식은 벡터 검색 단독보다 훨씬 더 나은 결과를 제공합니다:
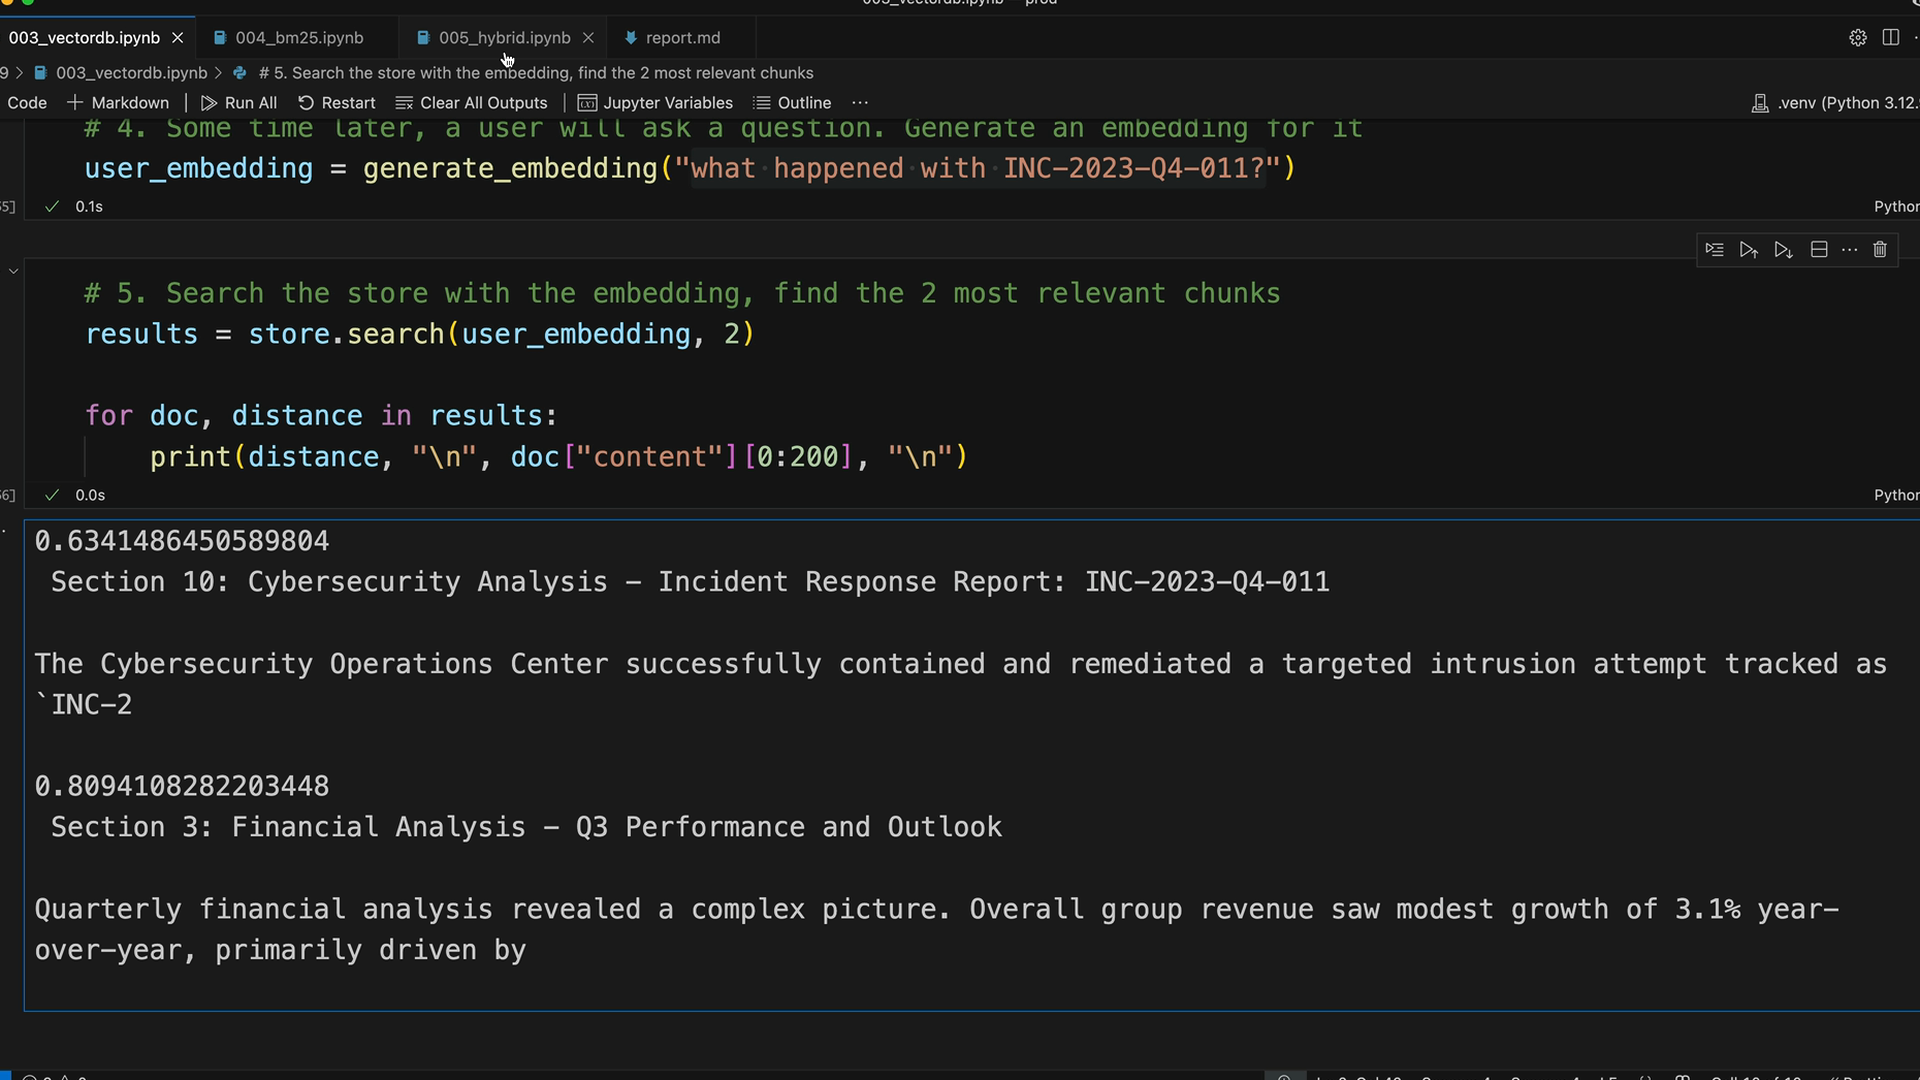
이제 결과는 다음과 같이 올바르게 우선순위가 매겨집니다:
- 섹션 10: Cybersecurity Analysis(실제 인시던트 보고서)
- 섹션 2: Software Engineering(관련 맥락)
- 섹션 5: Legal Developments(관련성은 낮지만 여전히 연관됨)
하이브리드 아키텍처의 이점
이 설계는 여러 가지 이점을 제공합니다:
- 모듈형 설계: 각 검색 인덱스는 동일한 API로 독립적으로 구현됩니다
- 쉬운 확장성: 동일한
search()및add_document()인터페이스를 구현하여 새로운 검색 방법을 추가할 수 있습니다 - 더 나은 정확도: 시맨틱 이해와 정확한 키워드 매칭을 결합합니다
- 유연한 융합: RRF 알고리즘은 결합하는 검색 인덱스의 개수와 관계없이 작동합니다
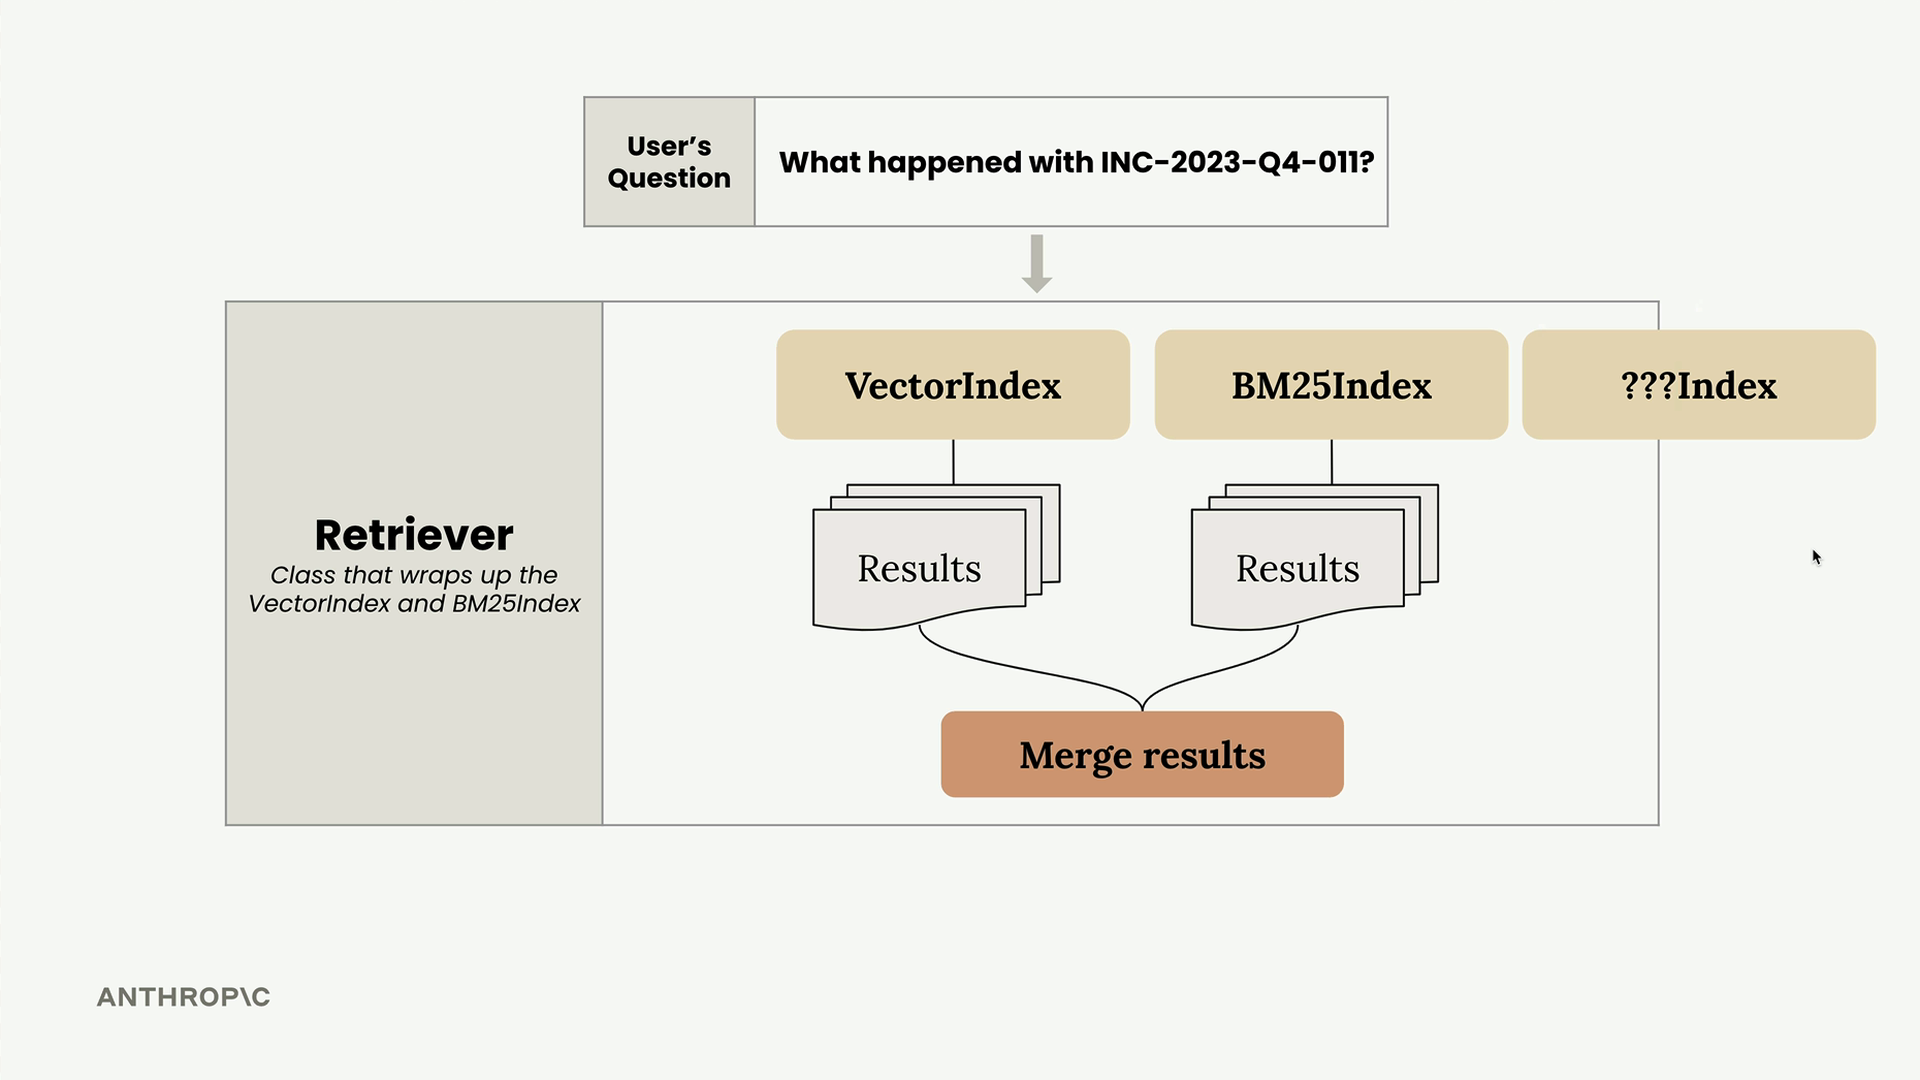
일관된 API 덕분에 세 번째 검색 인덱스(예를 들어 개체명 인식에 특화되었거나 특정 문서 유형을 처리하는 인덱스)를 손쉽게 추가할 수 있으며, Retriever는 그 결과를 자동으로 최종 순위에 반영합니다.
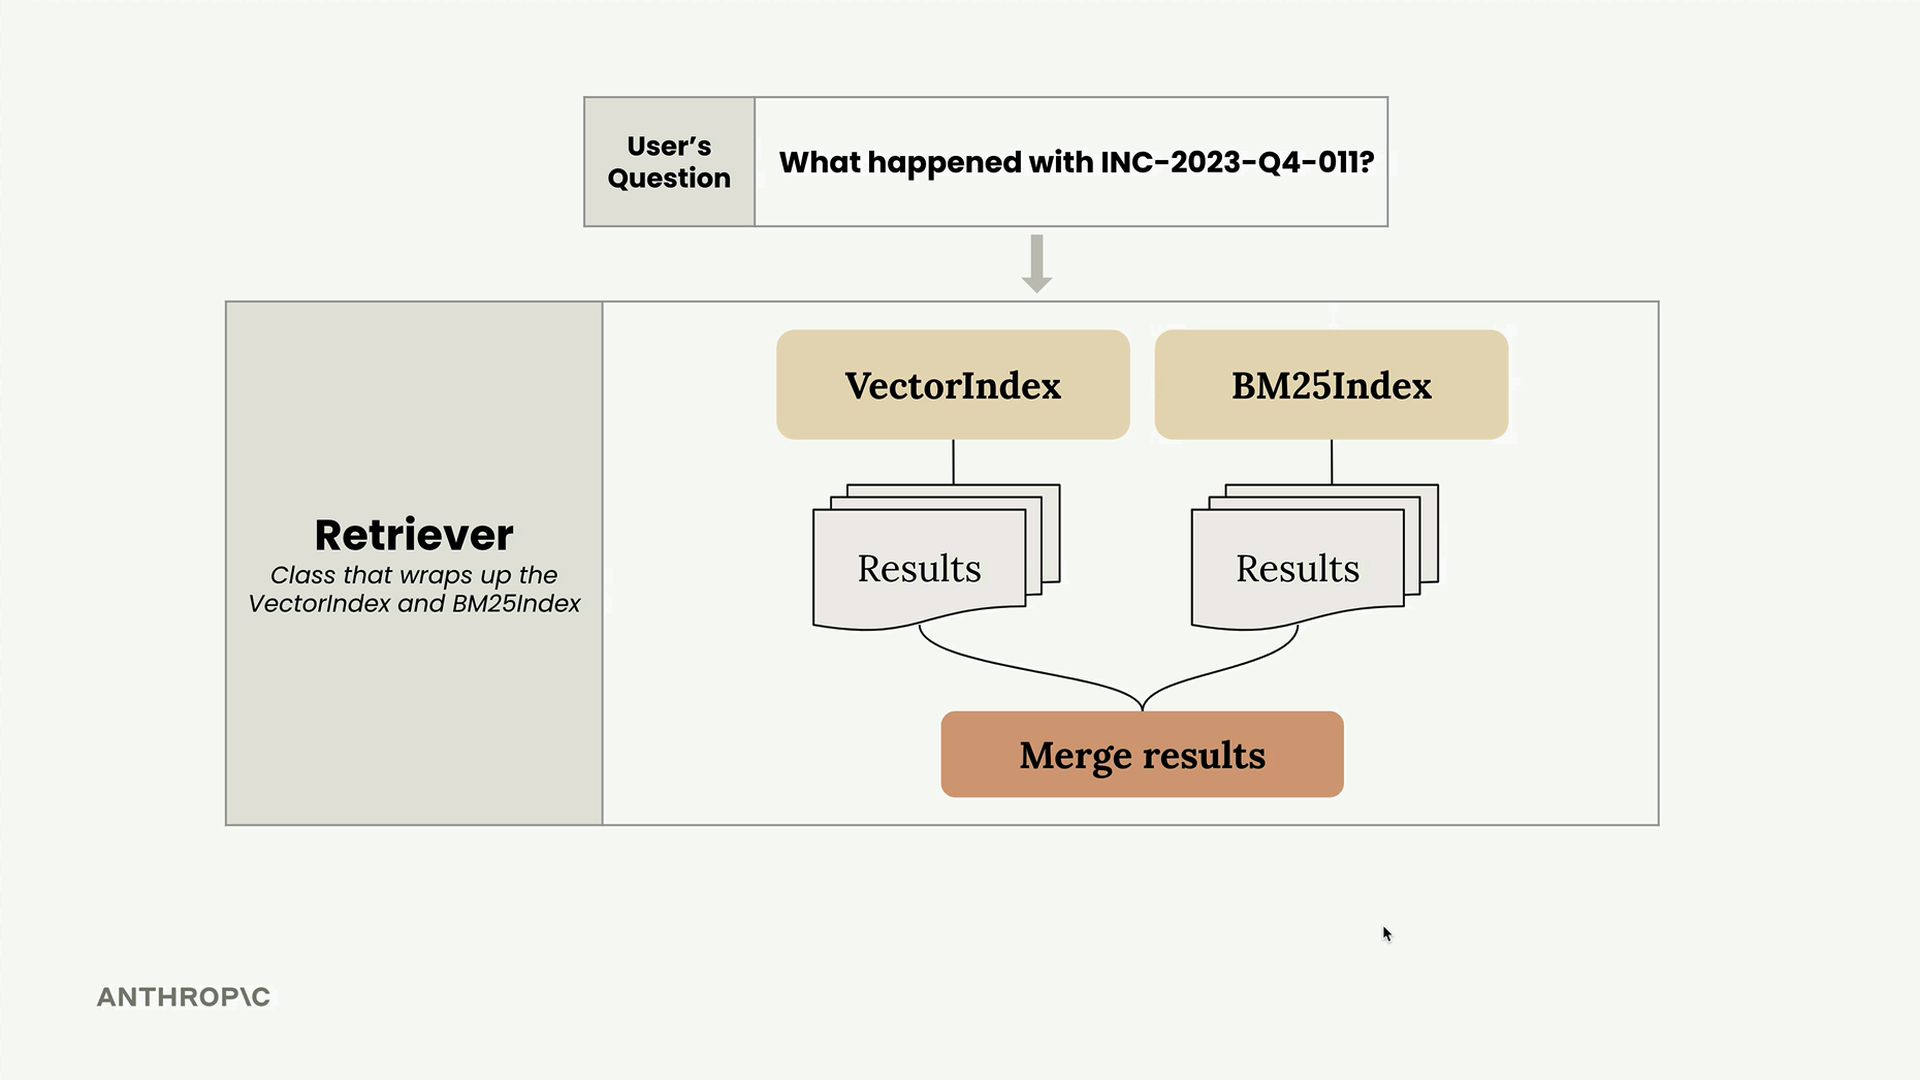
이 하이브리드 검색 기반은 둘 중 어느 한 방법만 사용할 때보다 훨씬 더 견고한 검색을 제공하여, RAG 파이프라인이 더 넓은 범위의 쿼리 유형에서 더 나은 성능을 발휘할 수 있도록 기반을 마련합니다.