Claude로 애플리케이션을 구축할 때, 전체 요청 라이프사이클을 이해하면 더 나은 시스템을 설계하고 문제를 더 효과적으로 디버깅하는 데 도움이 됩니다. 사용자가 AI 기반 채팅 애플리케이션에 메시지를 보낼 때 어떤 일이 일어나는지 살펴보겠습니다.
전체 요청 흐름
사용자 입력에서 AI 응답까지의 여정은 다섯 가지 뚜렷한 단계를 포함합니다: 서버로의 요청, Vertex로의 요청, 모델 처리, 서버로의 응답, 클라이언트로의 응답입니다. 각 단계는 사용자가 기대하는 "마법 같은" 응답을 전달하는 데 중요한 역할을 합니다.
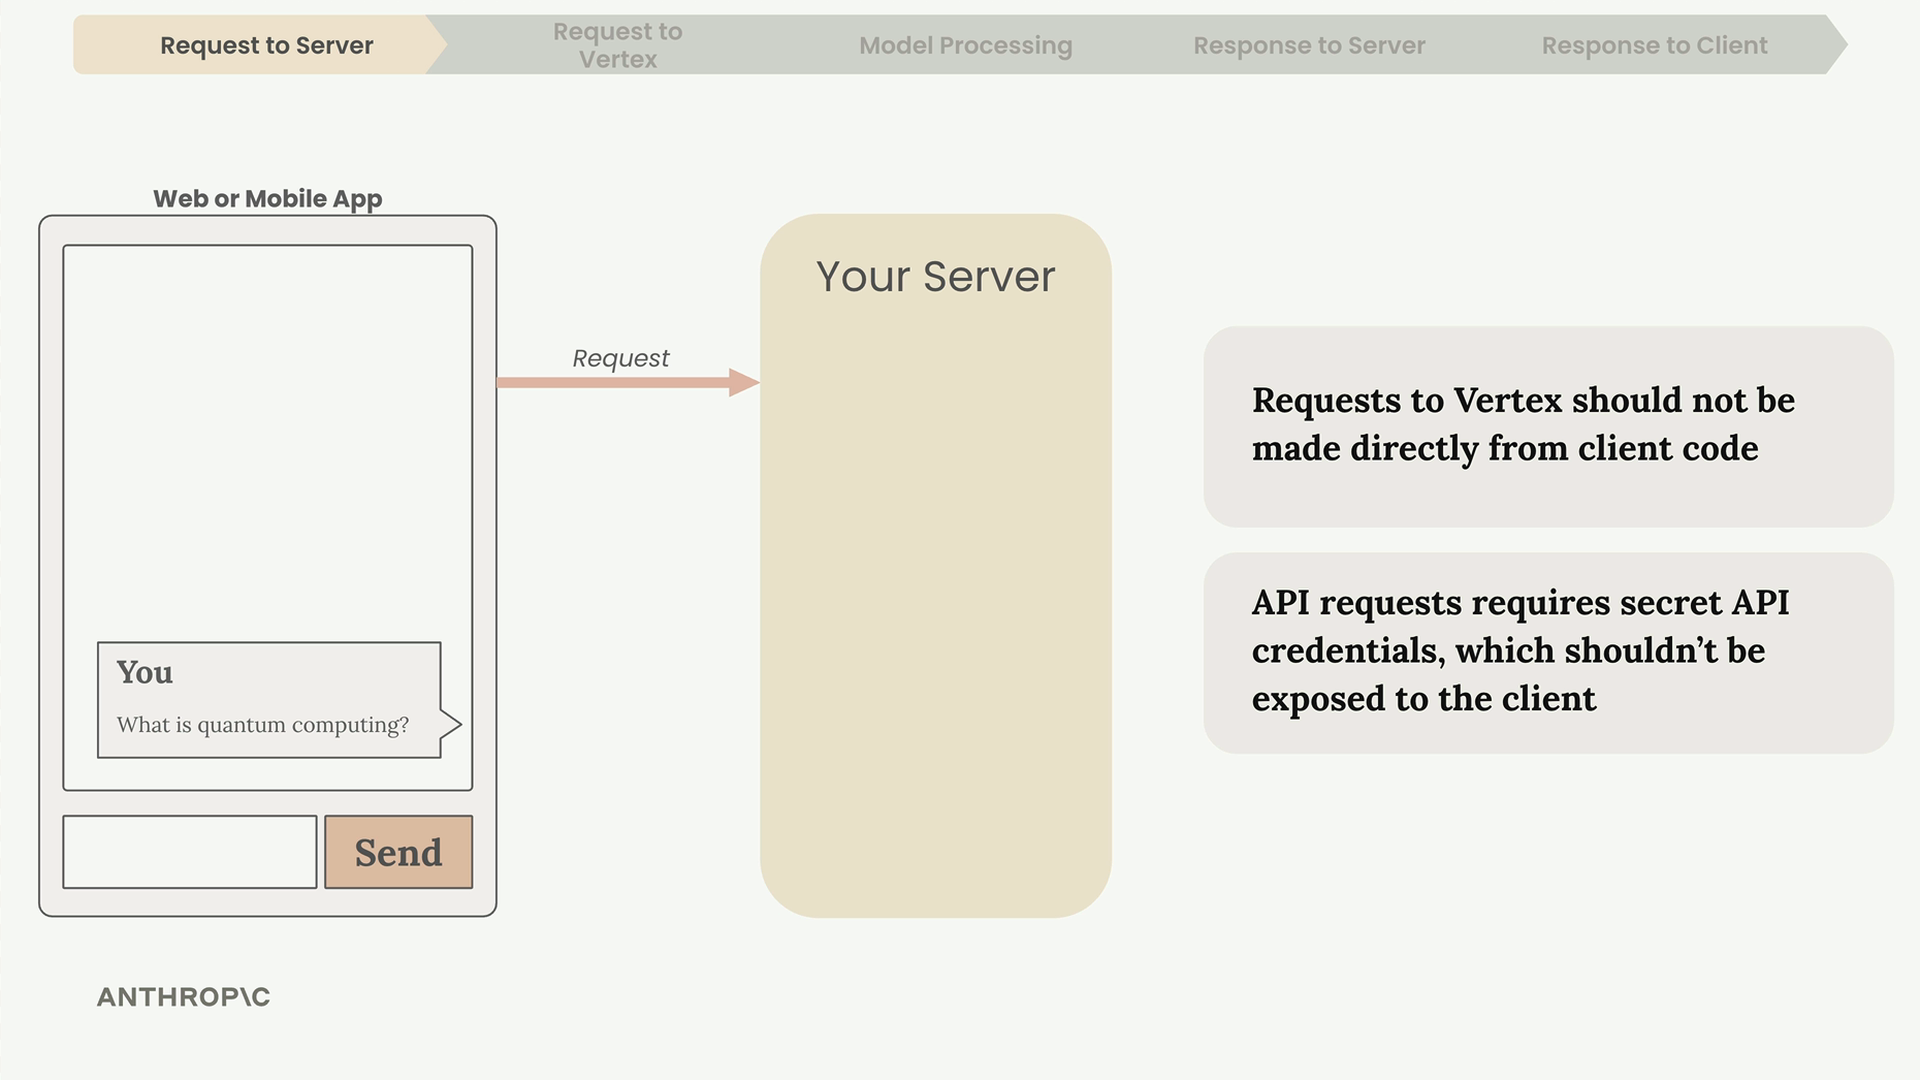
서버가 필요한 이유
클라이언트 측 코드에서 직접 API 요청을 하지 마세요. 그 이유는 다음과 같습니다:
- API 요청에는 안전하게 유지되어야 하는 비밀 자격 증명이 필요합니다
- 클라이언트 코드에 자격 증명을 노출하면 누구나 이를 볼 수 있게 됩니다
- 서버는 앱과 Vertex 사이의 안전한 중개자 역할을 합니다
항상 직접 제어하고 보호하는 자체 서버를 통해 요청을 라우팅하세요.
API 요청하기
서버는 Anthropic의 SDK 또는 Google의 공식 Vertex SDK를 사용하여 Vertex와 통신합니다. Anthropic은 Python, TypeScript, Go, Ruby용 공식 SDK를 제공합니다.
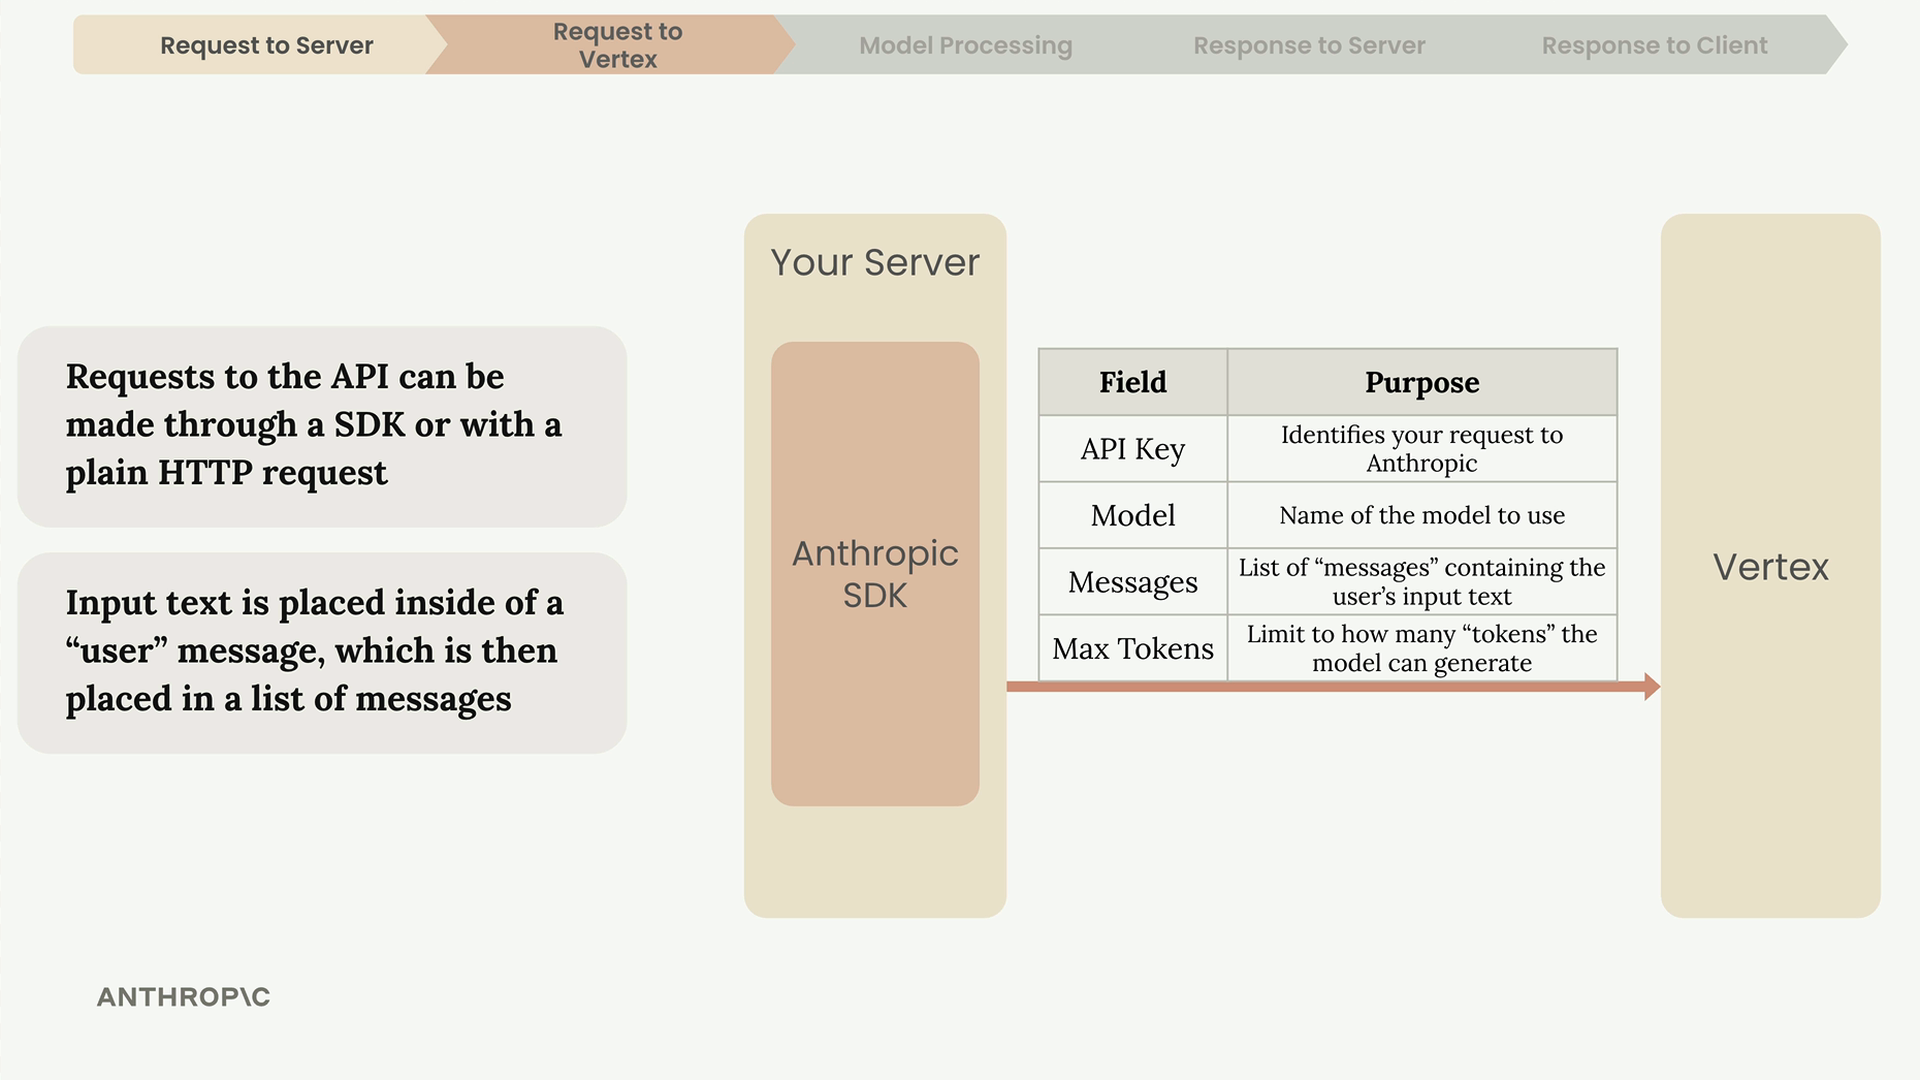
모든 요청에는 다음과 같은 주요 필드가 포함되어야 합니다:
- Google Cloud Credentials - Google Cloud에서 요청을 인증합니다
- Model - 사용할 특정 모델의 이름
- Messages - 사용자의 입력 텍스트를 포함하는 목록
- Max Tokens - 모델이 생성할 수 있는 토큰 수를 제한합니다
사용자의 입력은 "user" 메시지 안에 배치되며, 이는 이후 API로 전송되는 메시지 목록에 포함됩니다.
Claude 내부: 텍스트 생성 과정
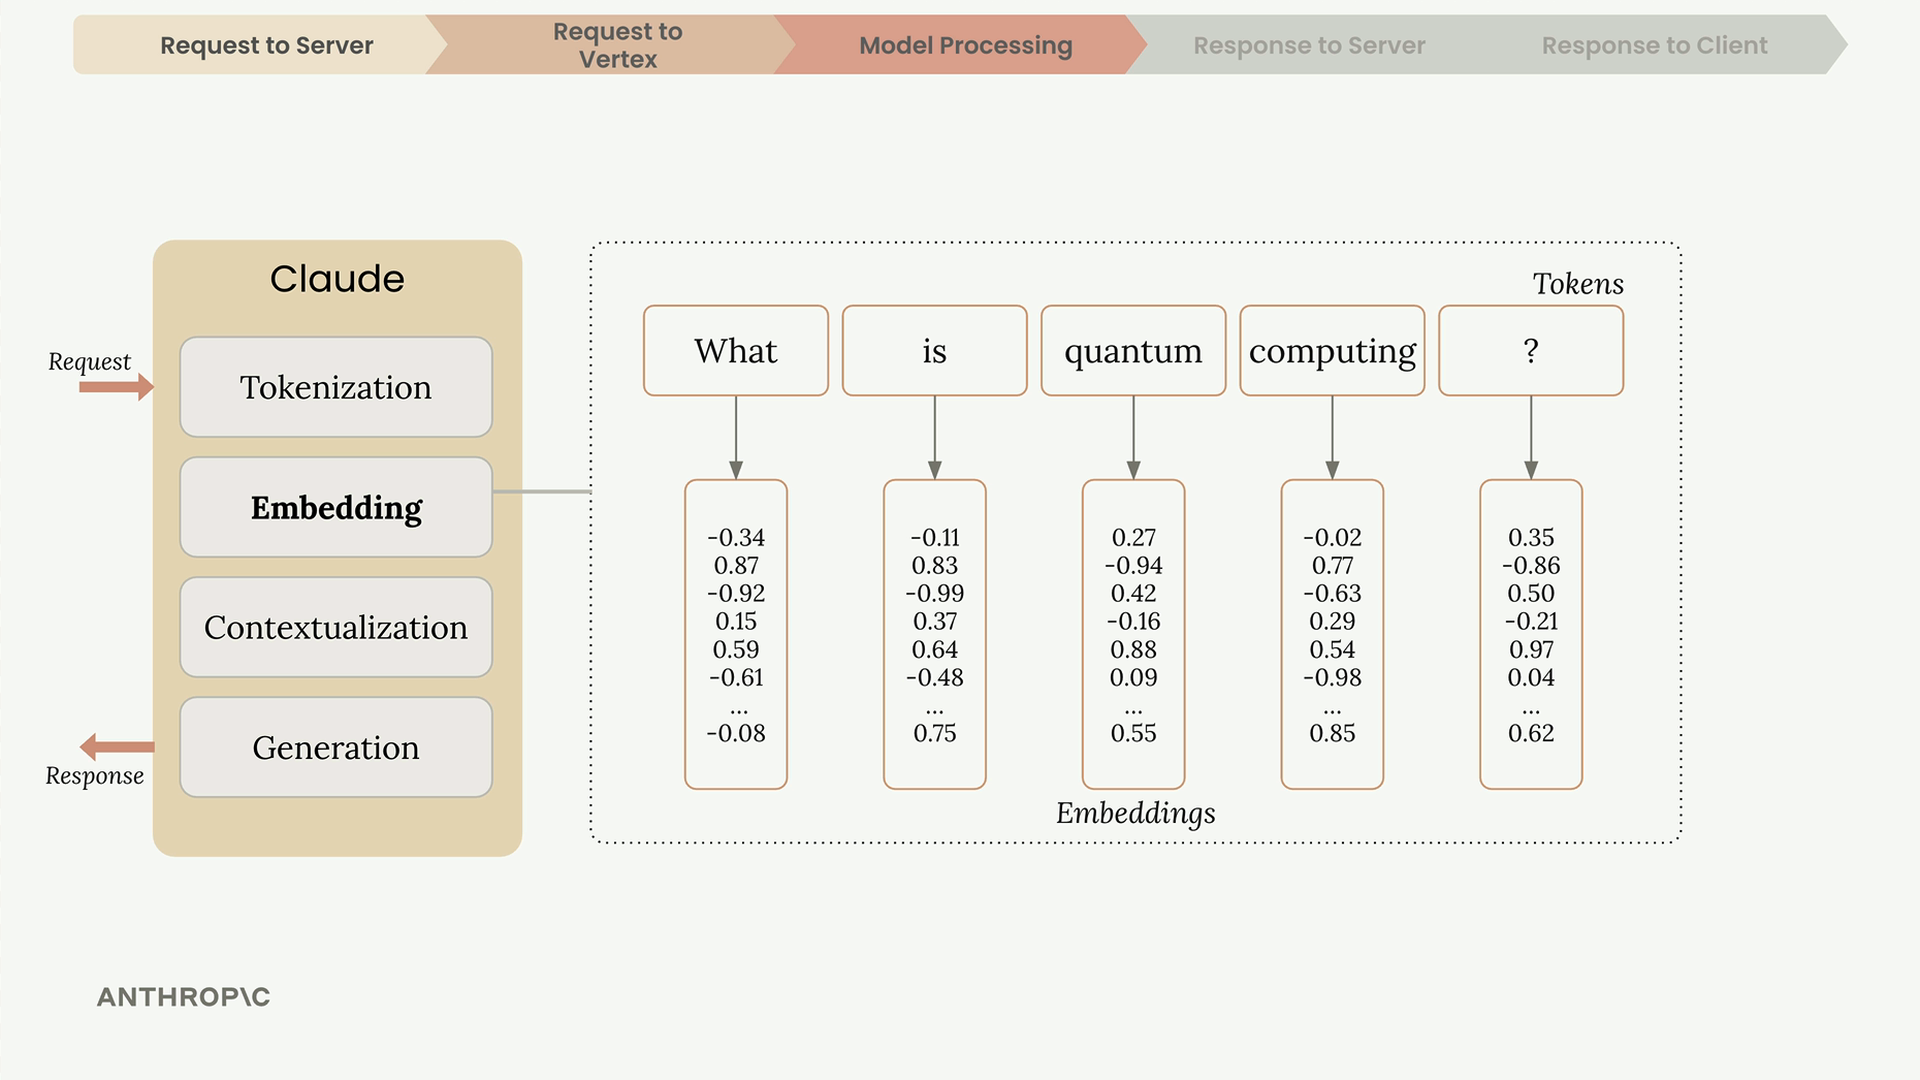
Vertex가 요청을 받으면, Claude는 이를 토큰화, 임베딩, 맥락화, 생성의 네 단계를 통해 처리합니다.
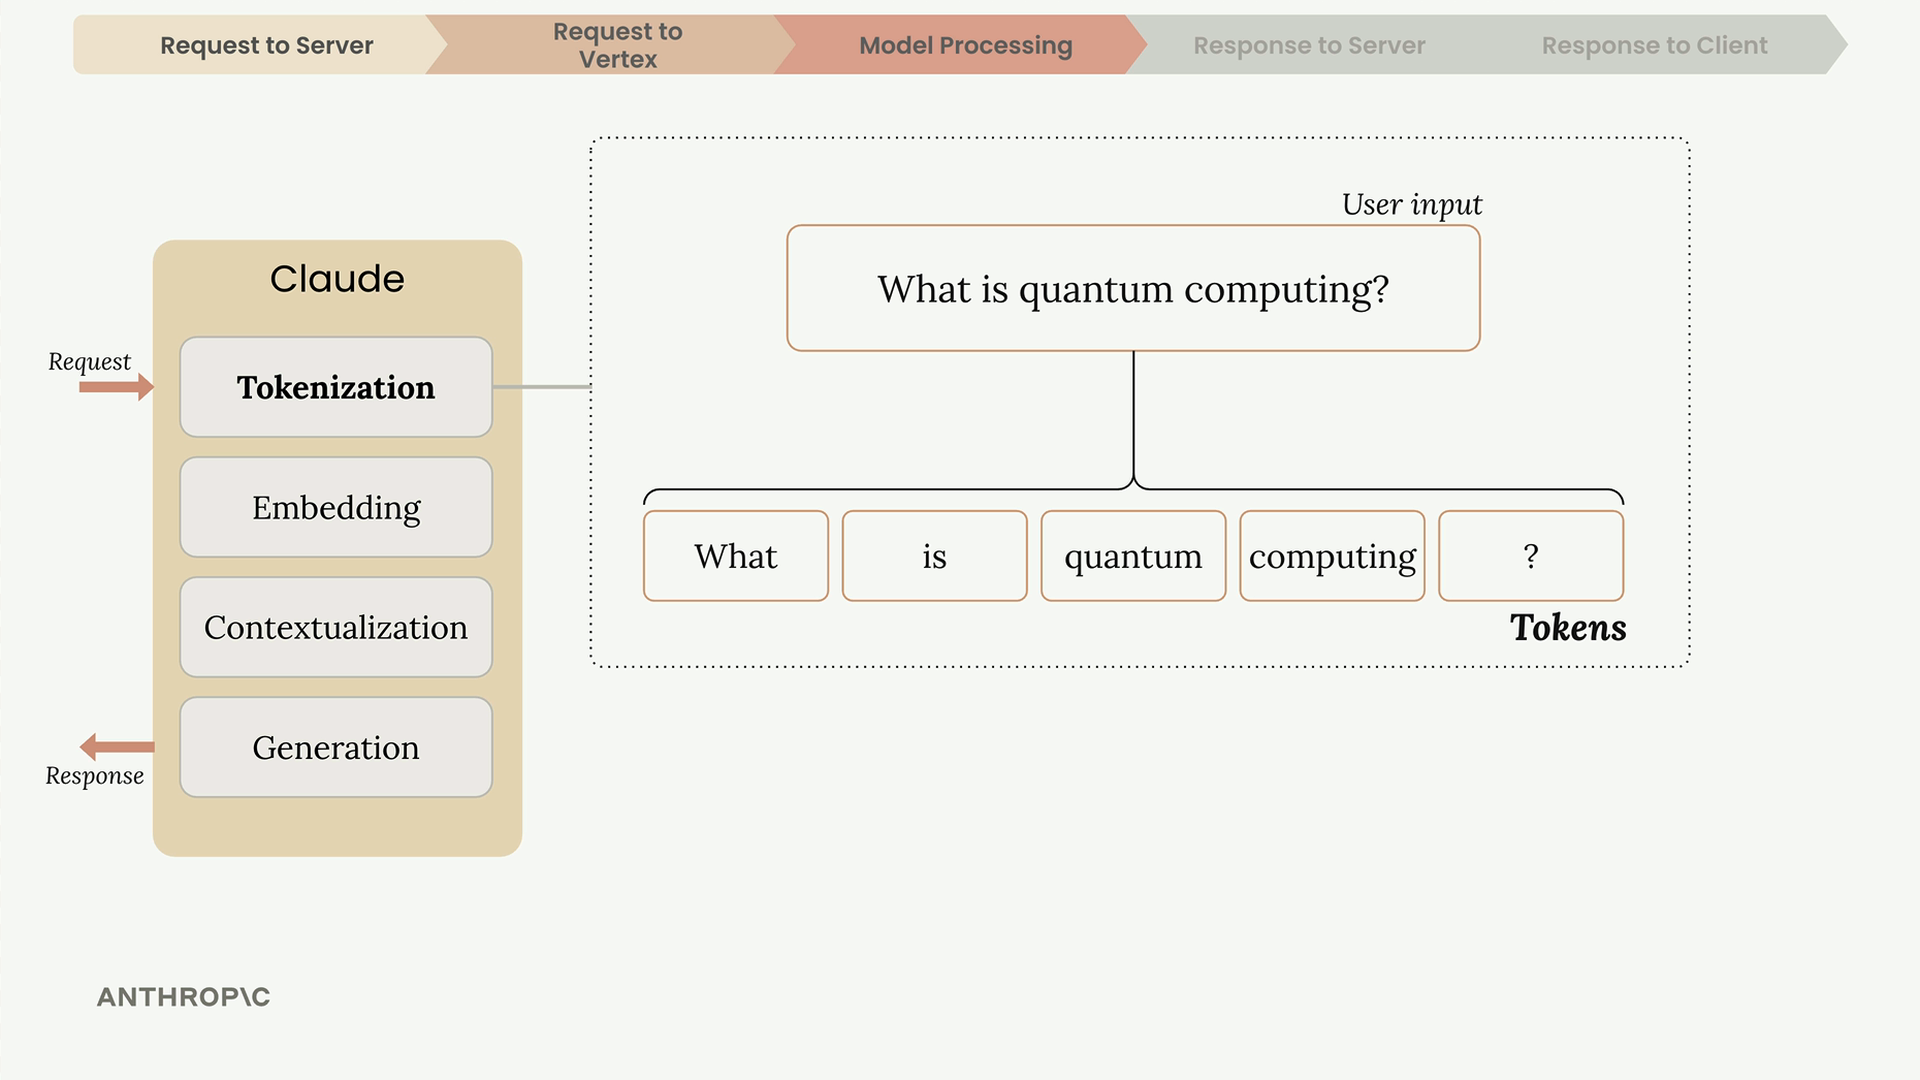
토큰화
Claude는 먼저 입력 텍스트를 토큰이라고 불리는 더 작은 덩어리로 분해합니다. 이는 단어 전체, 단어의 일부, 공백, 또는 기호일 수 있습니다. 단순화를 위해, 각 단어를 하나의 토큰으로 생각하세요.
임베딩
각 토큰은 임베딩으로 변환됩니다. 임베딩이란 해당 단어의 가능한 모든 의미를 나타내는 긴 숫자 목록입니다. 임베딩을 숫자 기반의 정의라고 생각하세요.
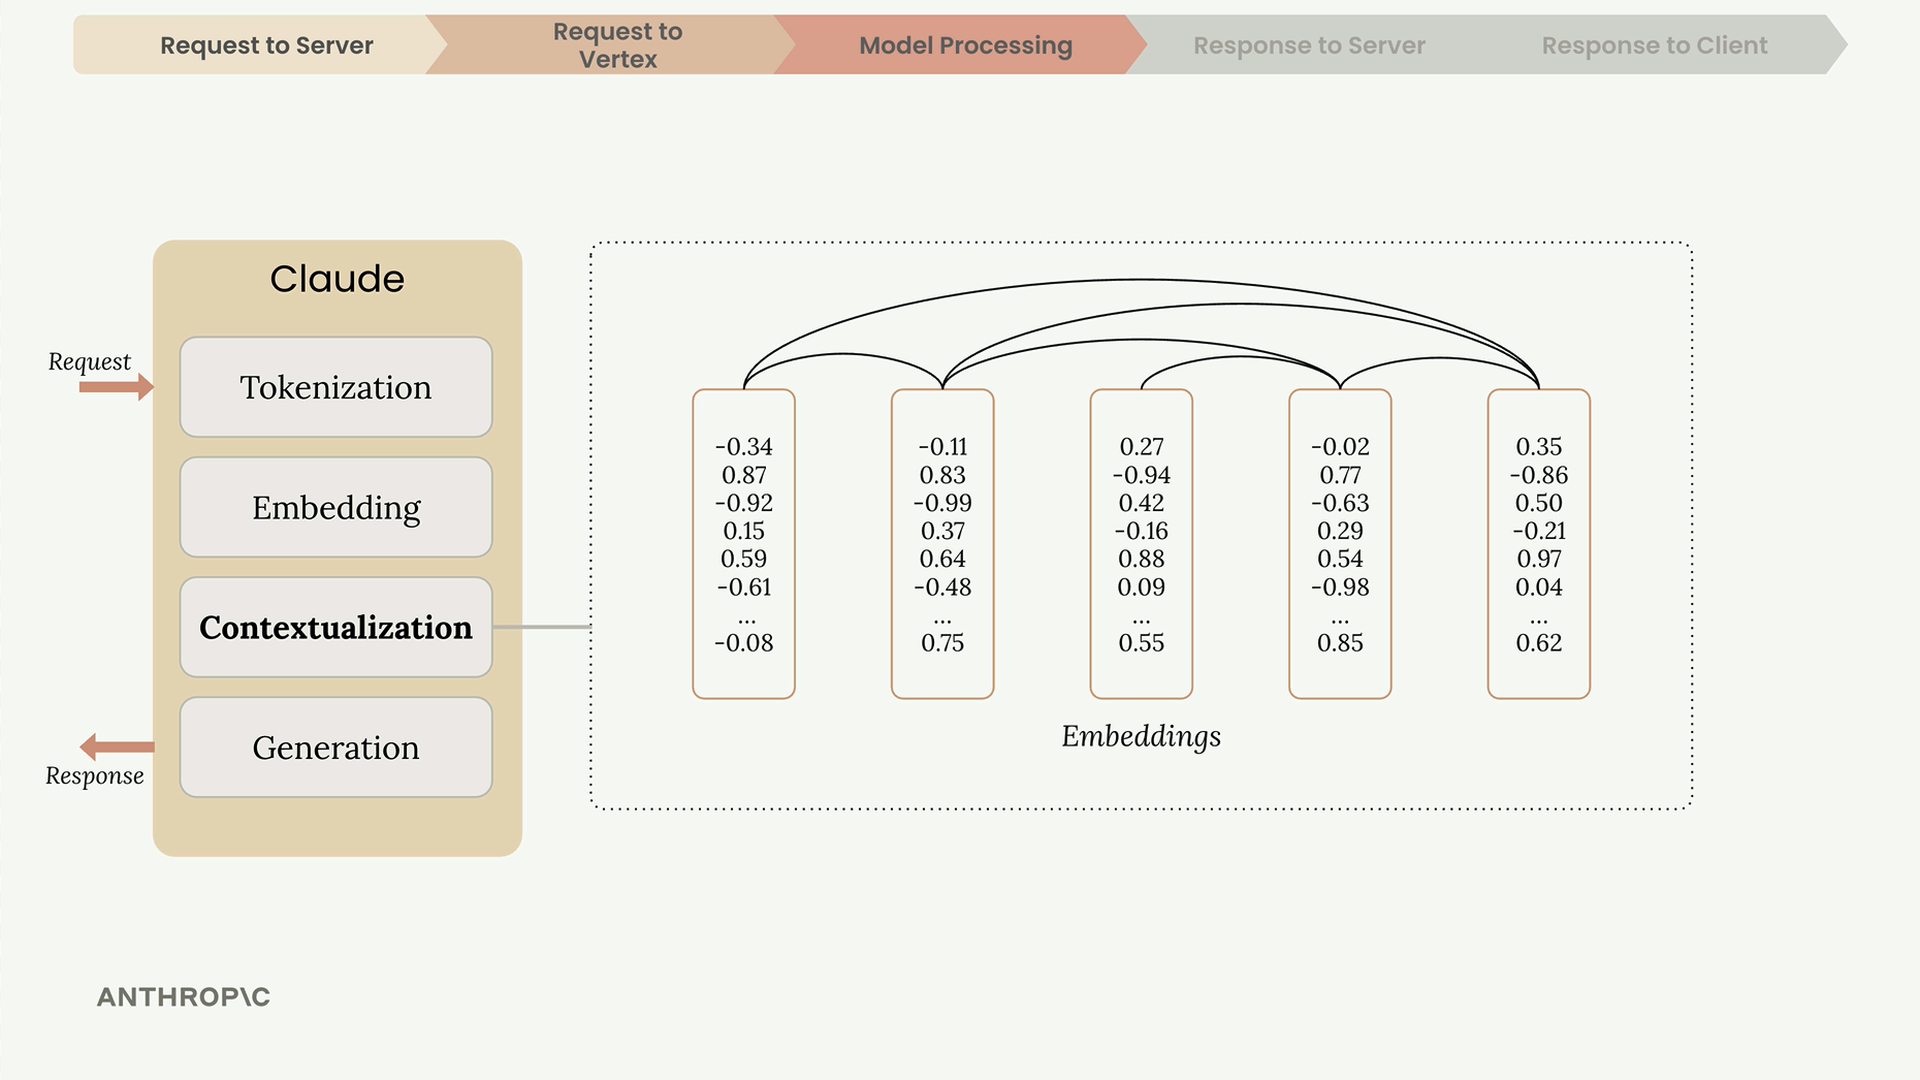
맥락화
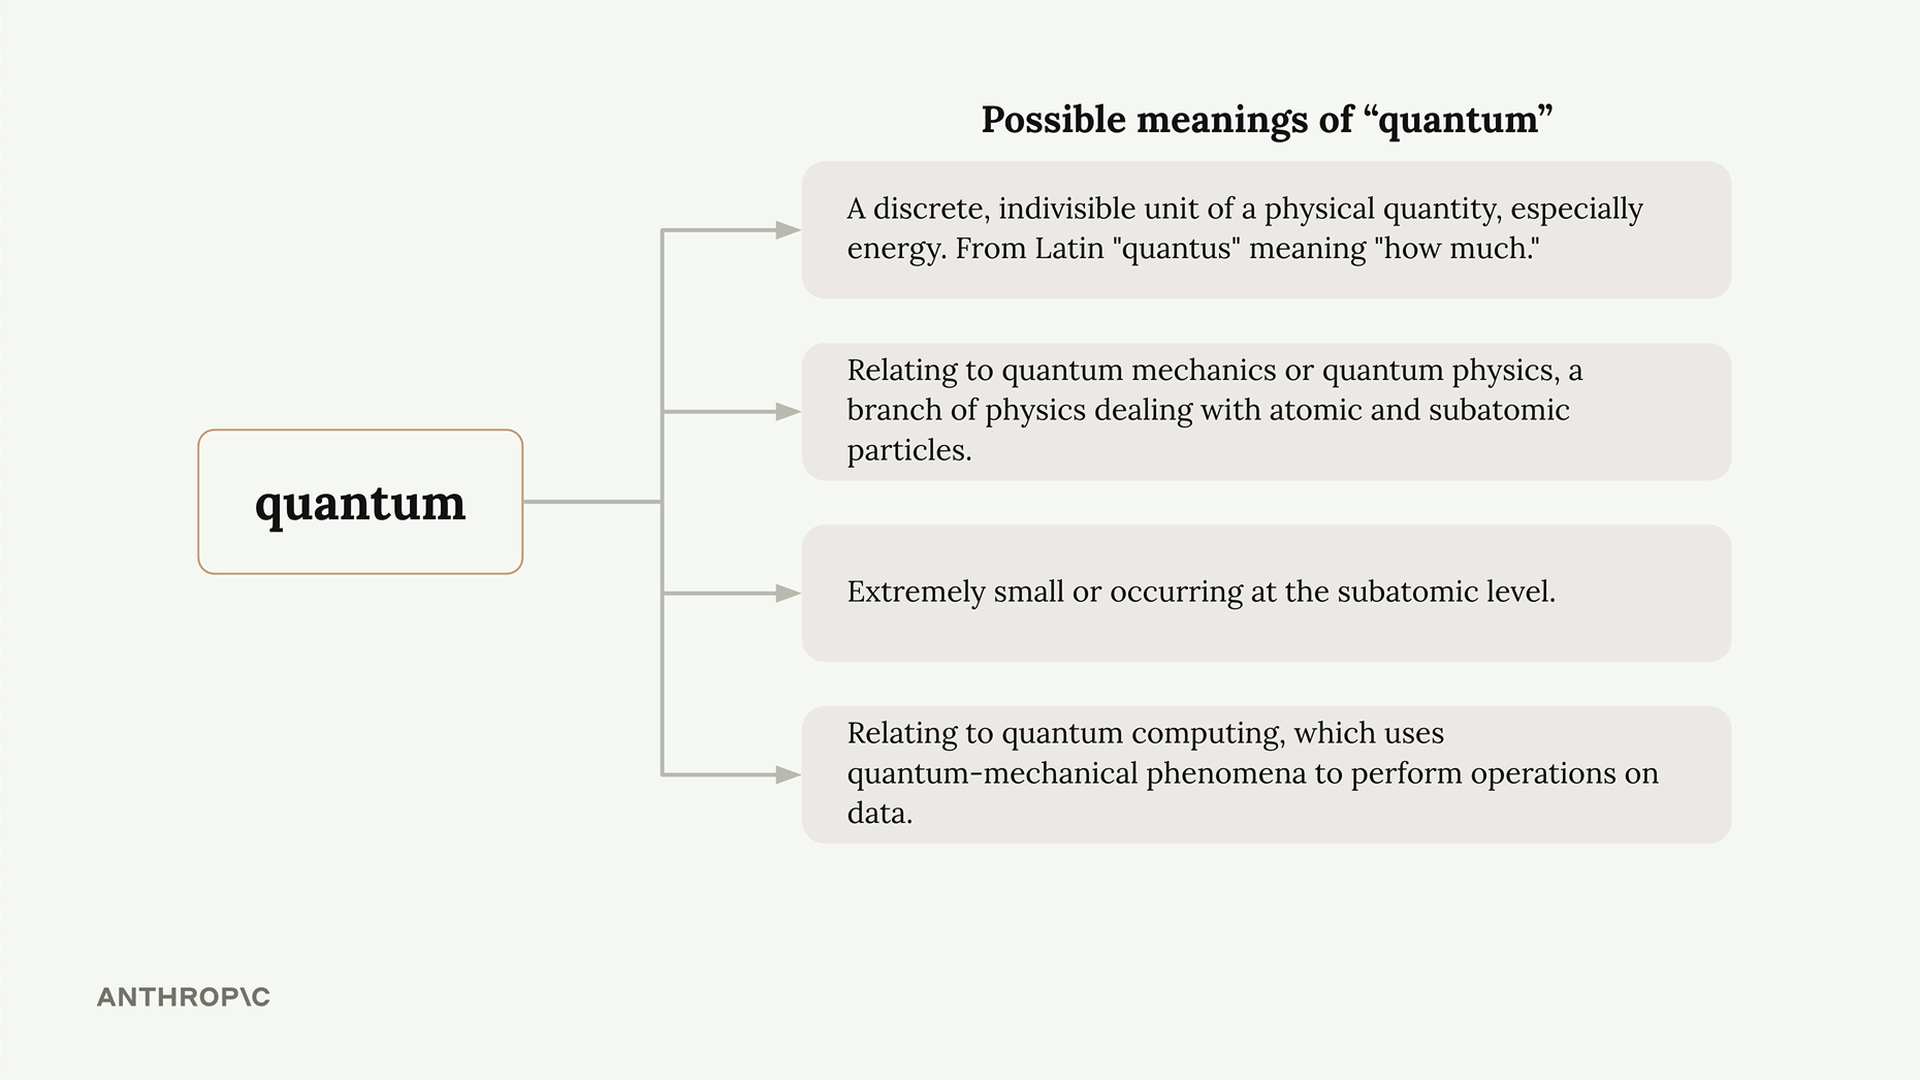
단어는 여러 의미를 가질 수 있기 때문에, Claude는 맥락을 사용하여 올바른 해석을 결정합니다. "quantum"이라는 단어는 물리학, 컴퓨팅을 의미하거나 단순히 "매우 작은"을 의미할 수 있습니다. 주변 단어의 맥락이 의도된 의미를 명확하게 해줍니다.
맥락화 과정에서 각 임베딩은 주변 단어를 기반으로 조정되어, 맥락상 가장 타당한 의미를 강조합니다.
생성
맥락화된 임베딩은 출력 레이어를 통과하여 가능한 각 다음 단어에 대한 확률을 생성합니다. Claude는 항상 가장 높은 확률의 단어를 선택하지는 않으며, 확률과 무작위성을 혼합하여 더 자연스럽고 다양한 응답을 만듭니다.
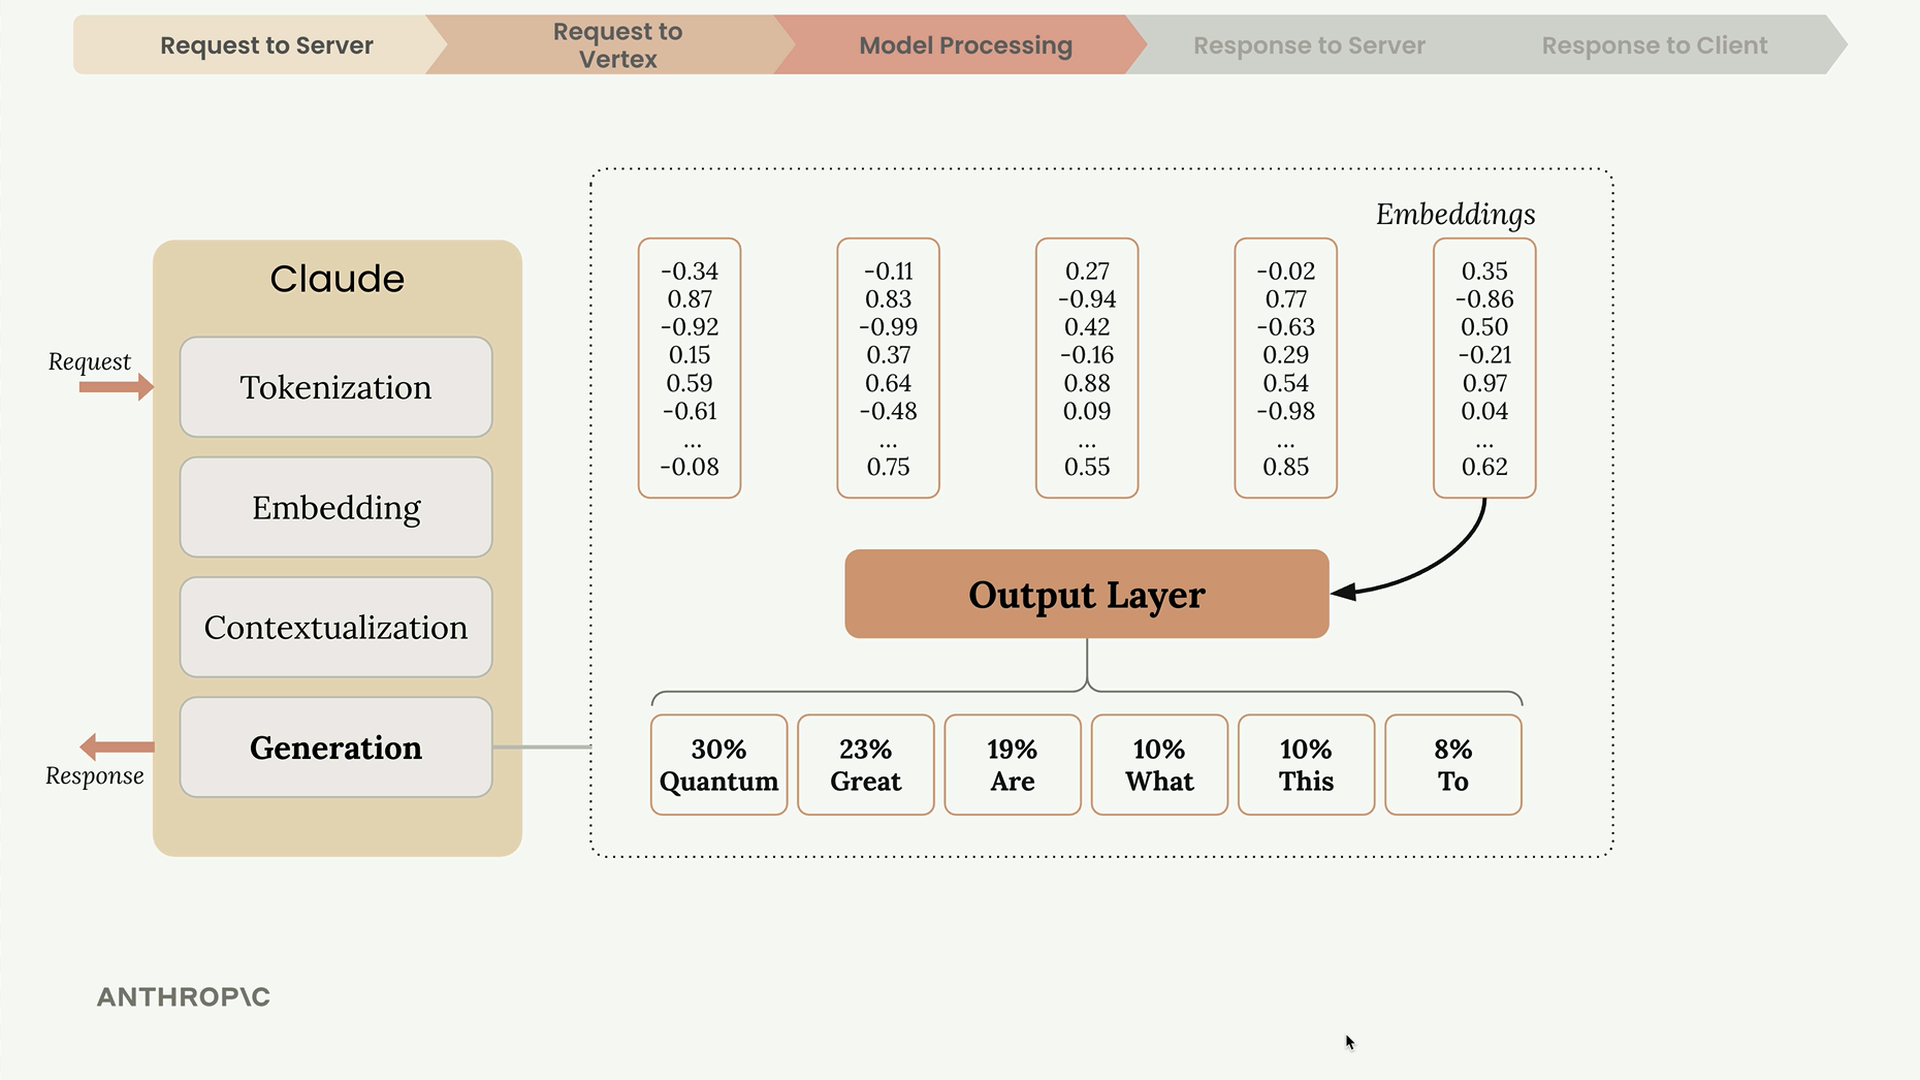
단어를 선택한 후, Claude는 이를 시퀀스에 추가하고 다음 단어에 대해 전체 과정을 반복합니다.
생성이 멈출 때
각 토큰을 생성한 후, Claude는 계속할지 여부를 결정하기 위해 여러 조건을 확인합니다:
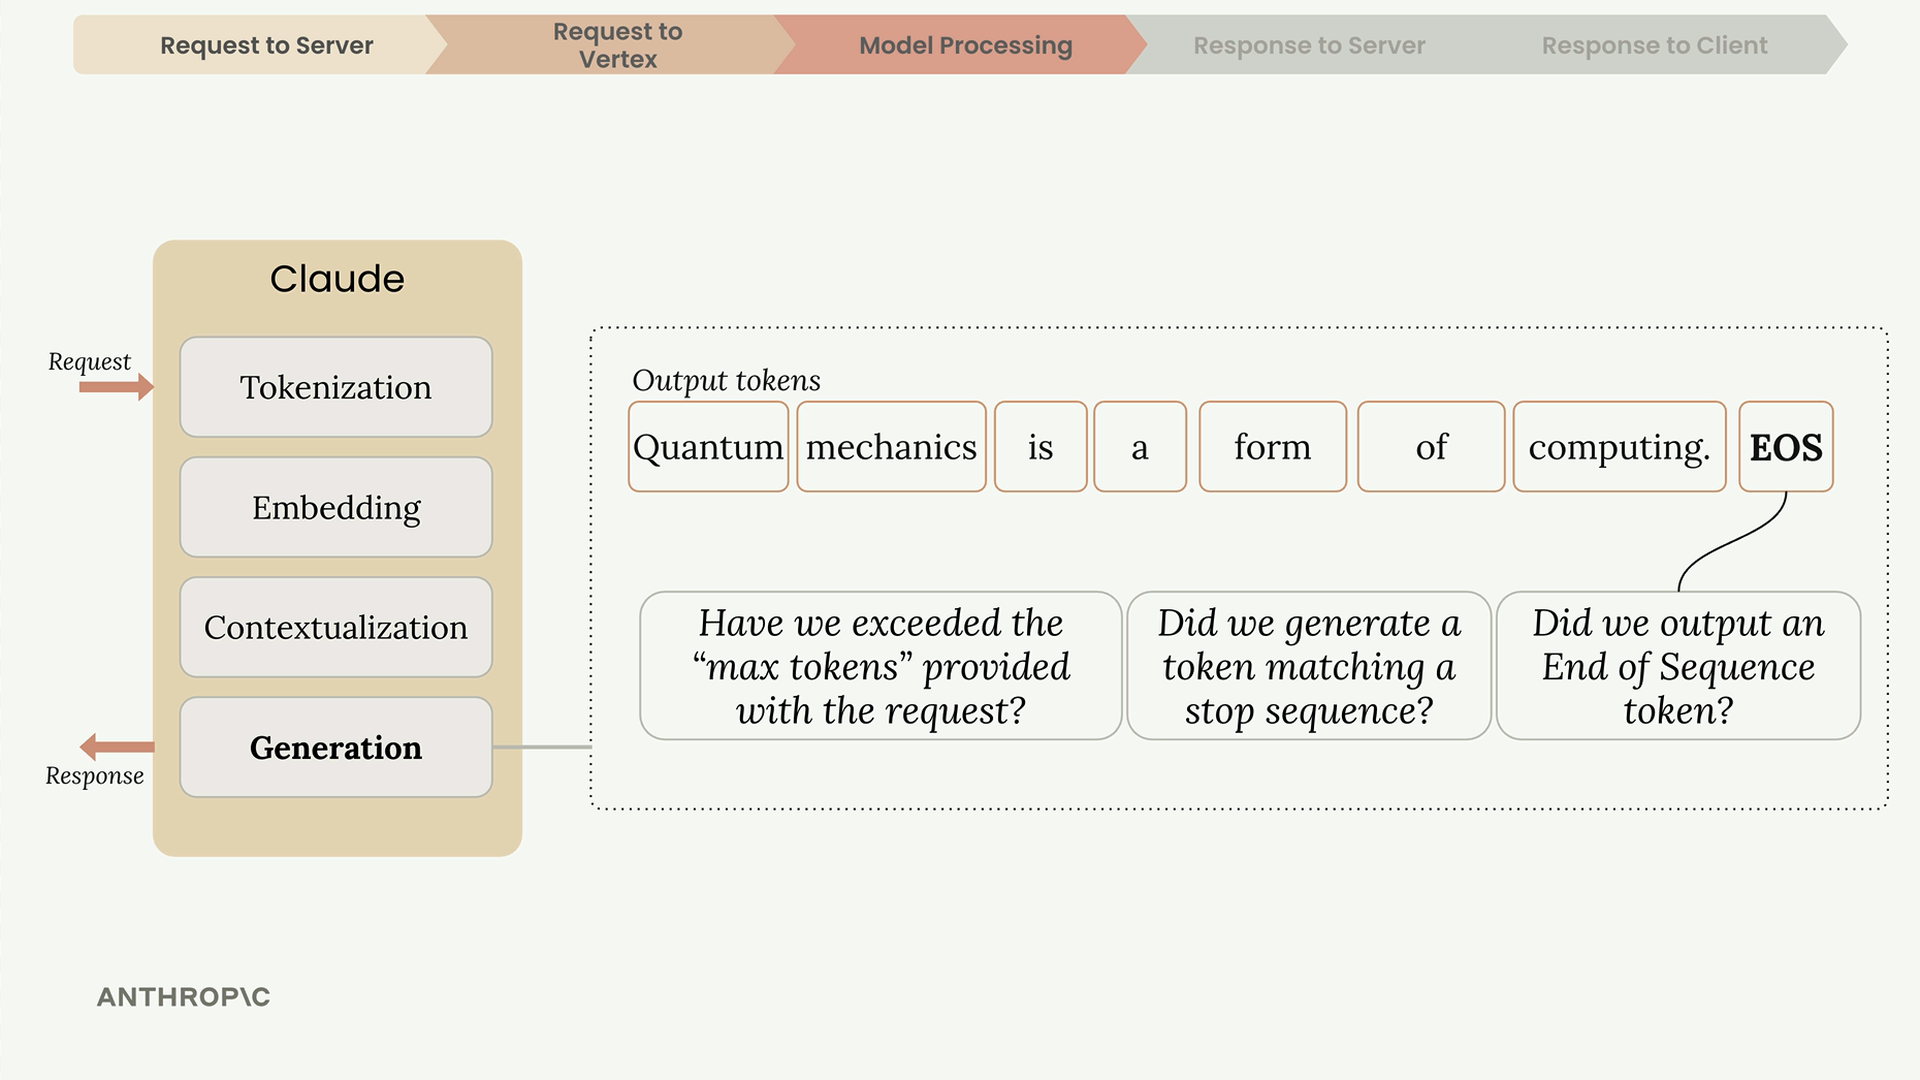
- 최대 토큰 도달 - 지정한 한도에 도달했습니까?
- 자연스러운 종료 - 시퀀스 종료 토큰을 생성했습니까?
- 중단 시퀀스 - 미리 정의된 중단 구문을 만났습니까?
시퀀스 종료 토큰은 (보이는 텍스트가 아닌) 특수 신호로, Claude가 자연스러운 결론에 도달했음을 나타내는 데 사용됩니다.
응답
생성이 완료되면, Vertex는 다음을 포함하는 응답을 서버로 다시 보냅니다:
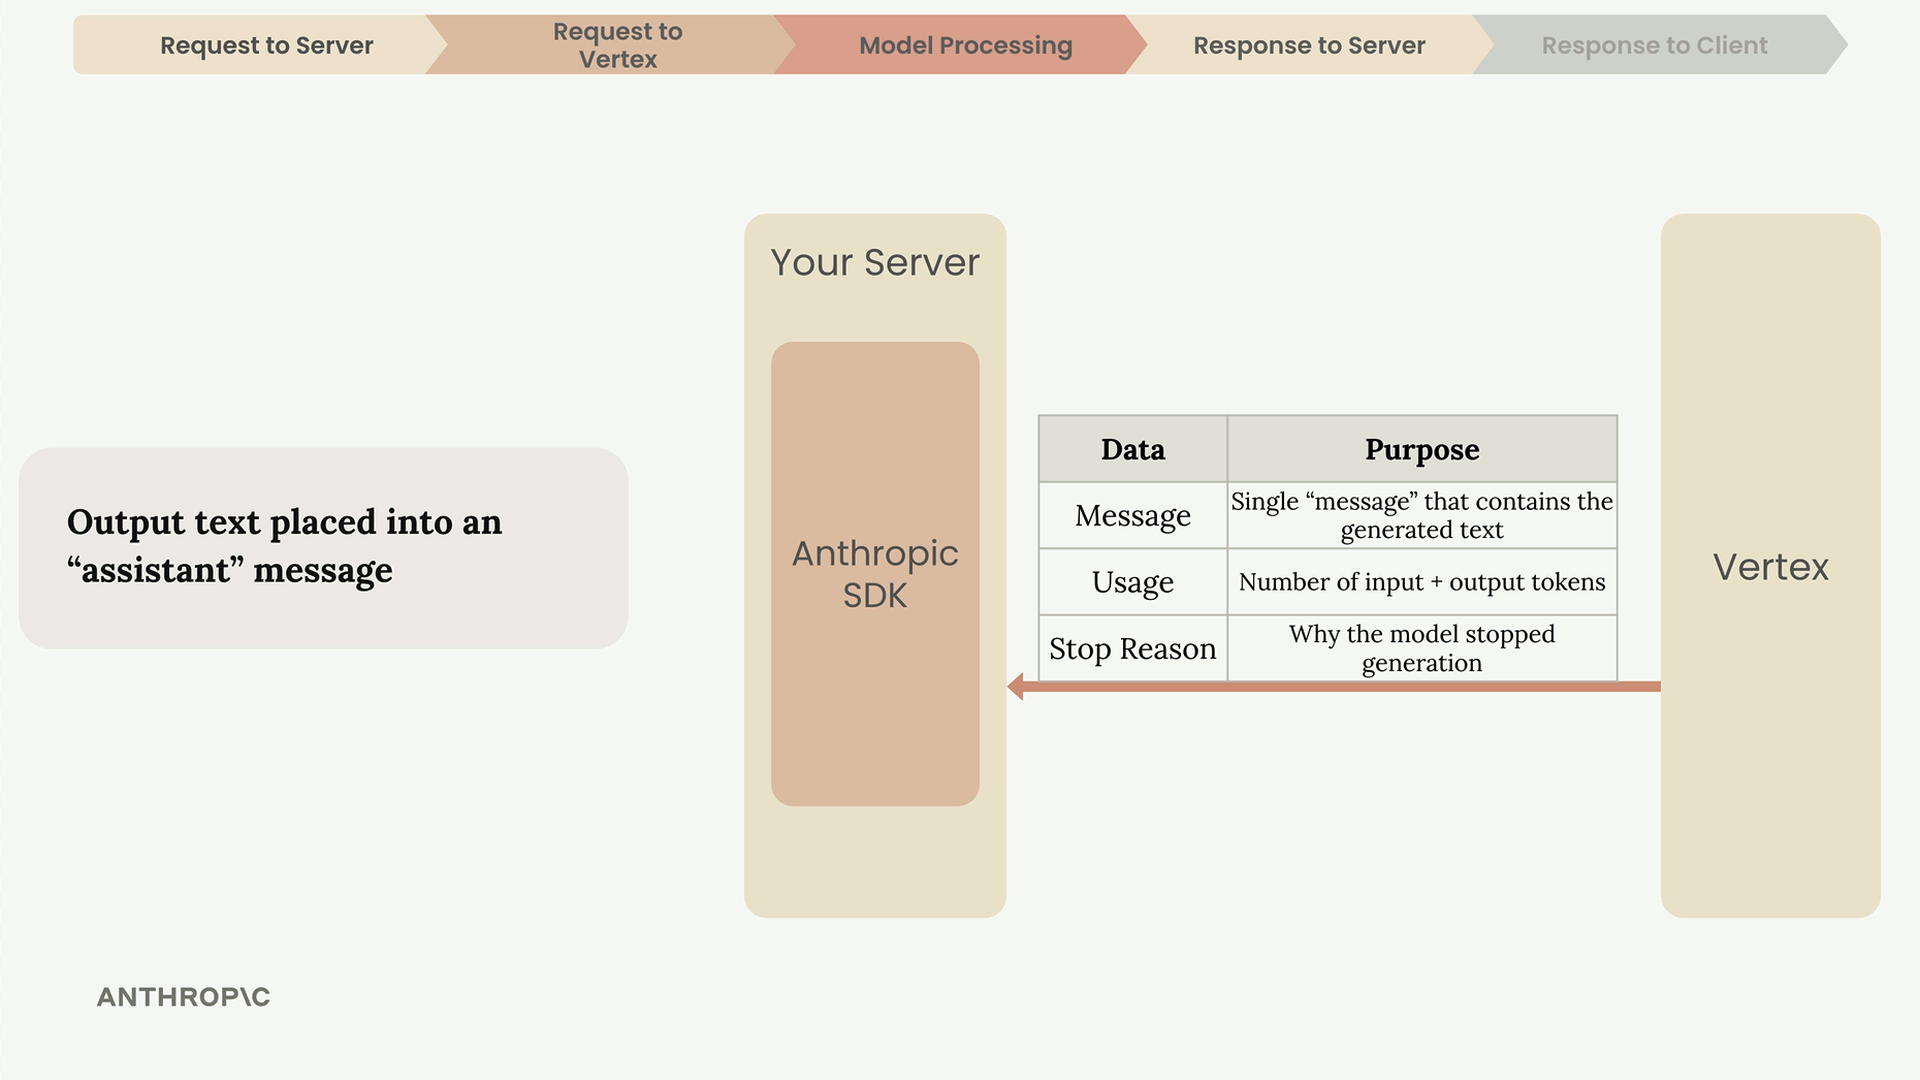
- Message - 생성된 텍스트
- Usage - 입력 및 출력 토큰 수
- Stop Reason - 모델이 생성을 멈춘 이유
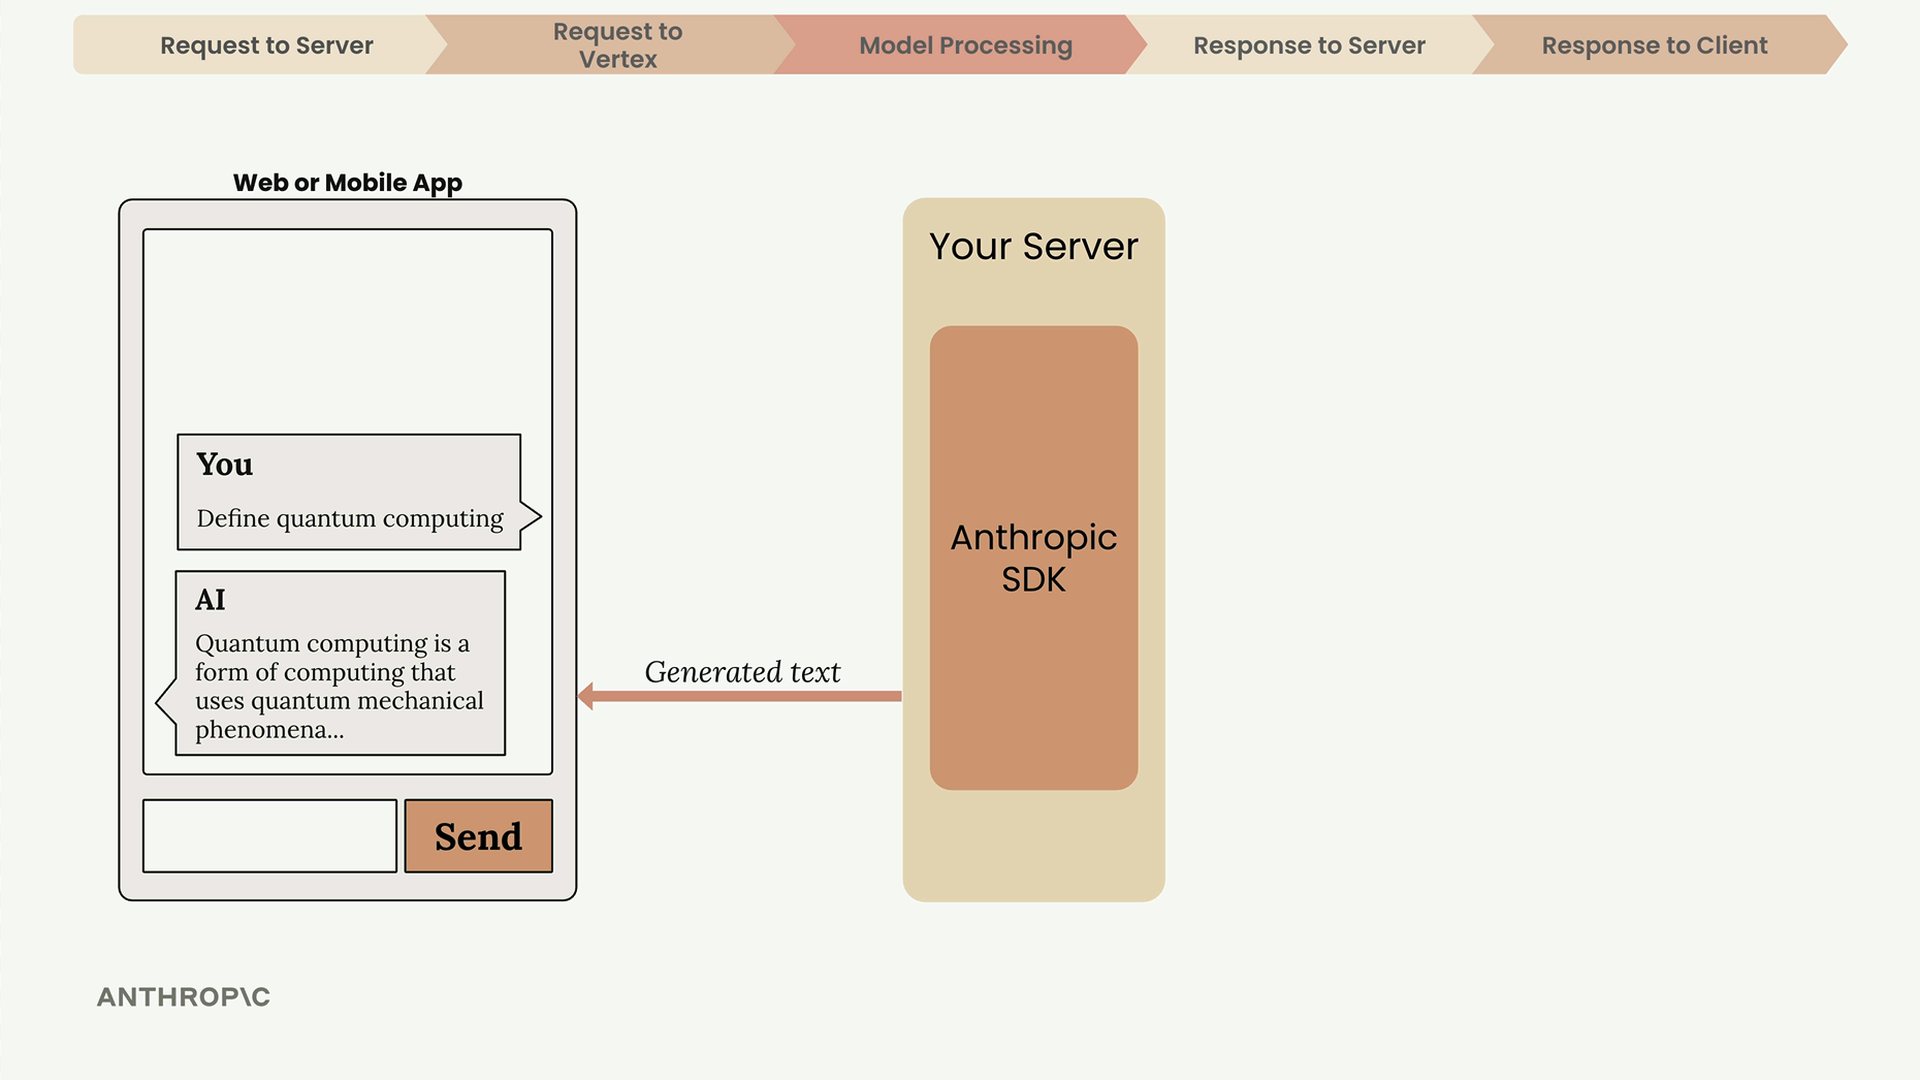
그런 다음 서버는 생성된 텍스트를 클라이언트 애플리케이션으로 전달하며, 그곳에서 채팅 인터페이스에 표시됩니다.
전체 그림
이 전체 과정 - 사용자 입력에서 시작해 토큰화, 임베딩, 맥락화, 생성을 거쳐 다시 사용자에게 돌아가는 과정 - 은 몇 초 만에 일어납니다. 이 흐름을 이해하면 더 견고한 애플리케이션을 구축하고 문제가 발생했을 때 이를 해결하는 데 도움이 됩니다.
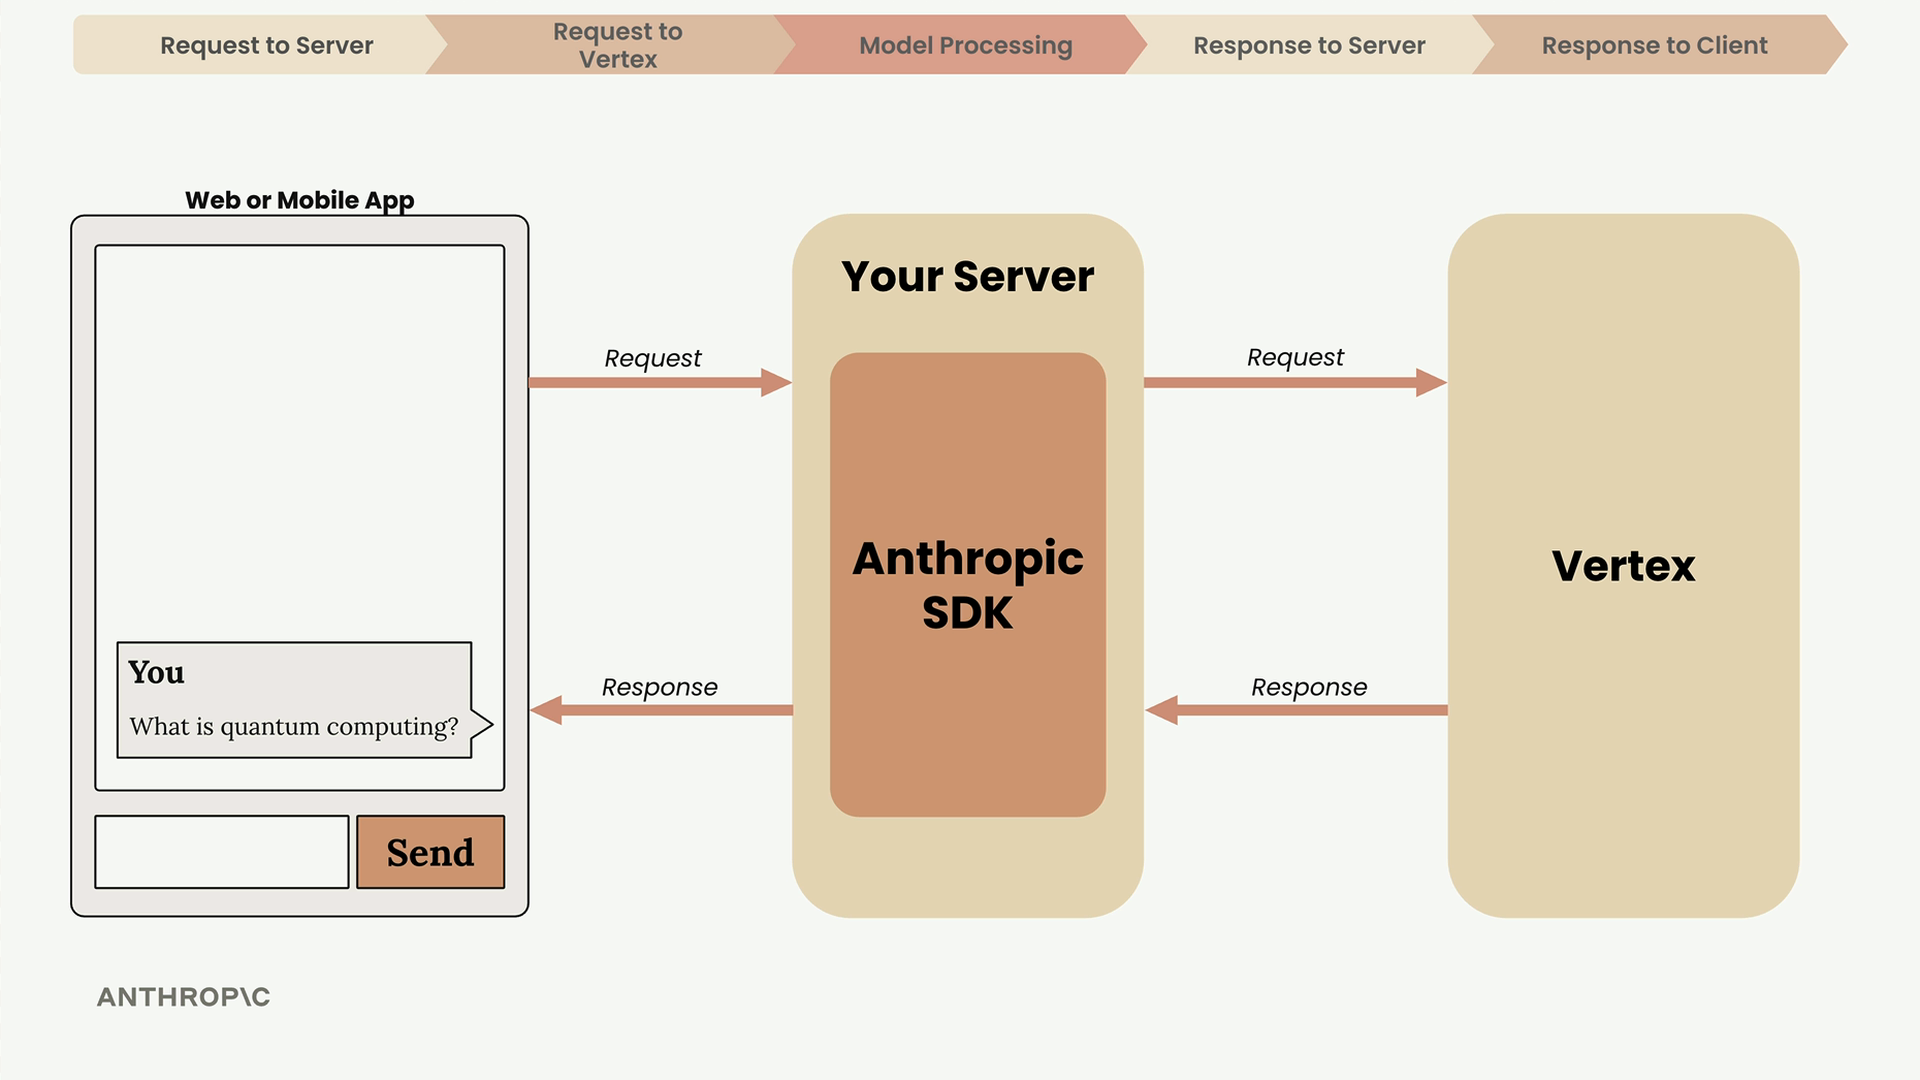
핵심 요점은 다음과 같습니다: 항상 서버를 중개자로 사용하고, 텍스트 생성이 반복적인 과정임을 이해하며, 사용량을 모니터링하고 모델 동작을 이해하기 위해 응답 메타데이터에 주의를 기울이세요.